【无线电控制与数据链探测系统】第7章 发射源定位与追踪

实战指南:如何用Python模拟多雷达协同探测系统(附代码示例) 本文提供了一份使用Python模拟多雷达协同探测系统的实战指南。通过构建雷达节点模型、实现信息融合架构(集中式与分布式)并集成资源调度算法(如基于PCRLB的优化),文章详细展示了从仿真环境搭建到系统集成的完整闭环流程,并附有可运行的代码示例,帮助开发者快速验证协同探测与资源调度策略。 阅读详情

本章系统推导基于到达时间(TOA/TDOA)、到达角(AOA)与接收信号强度(RSS)的定位原理,严格分析各类误差来源并给出几何与统计推导。基于这些测量构建的多站协同定位、基于随机动态模型的跟踪滤波(卡尔曼、粒子滤波)与多假设/多目标关联方法也给出完整推导与实现细节。被动定位中的时钟同步问题、时延估计精度的 Cramér–Rao 下界(CRLB)推导以及移动目标的轨迹拼接与多站关联规则均在本章以教材级别的完整步骤展开。


7.1 TOA/TDOA、AOA、RSS 原理与误差来源(含几何推导)

7.1.1 基本几何模型与符号
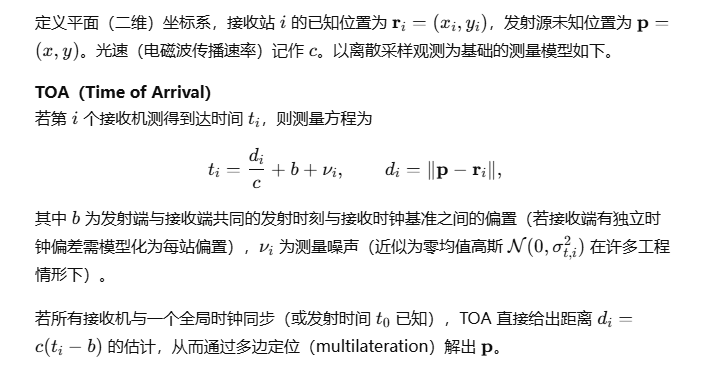

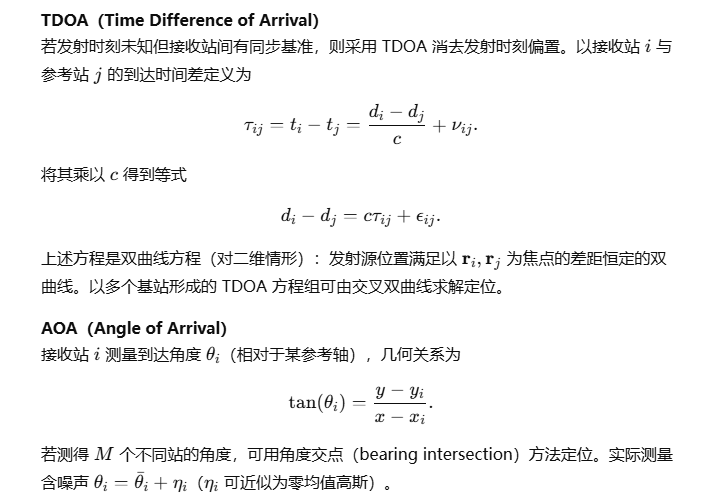
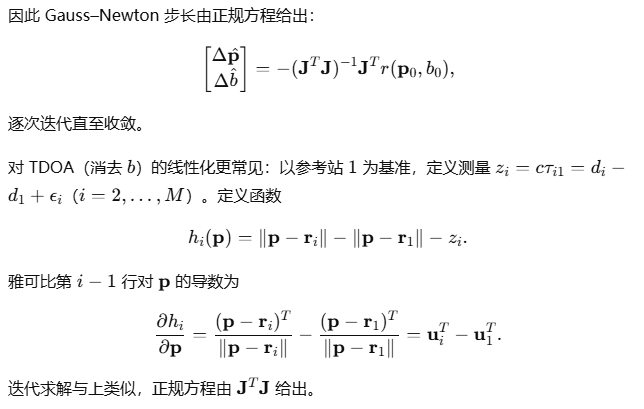
7.1.2 TOA / TDOA 的几何推导与線性化解法

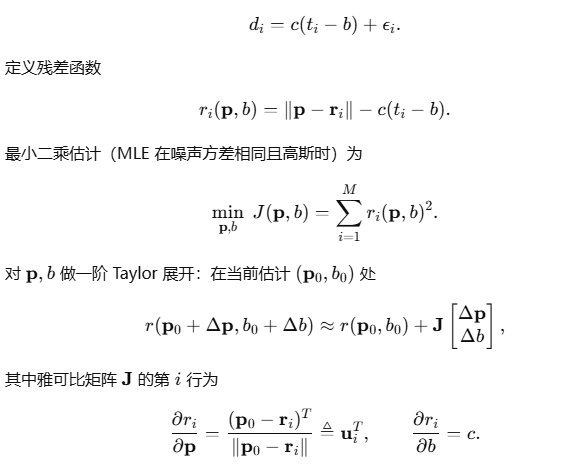
求解方程组的直接非线性方法或通过线性化(Taylor expansion)导出迭代最小二乘(Gauss–Newton)解。

以 TOA(已知发射时刻或同步接收)为例,测量方程(去掉常数):

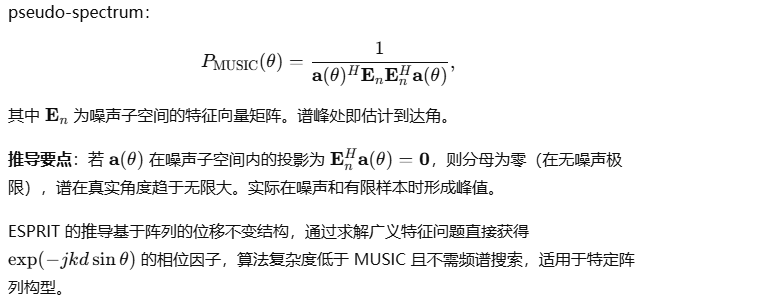
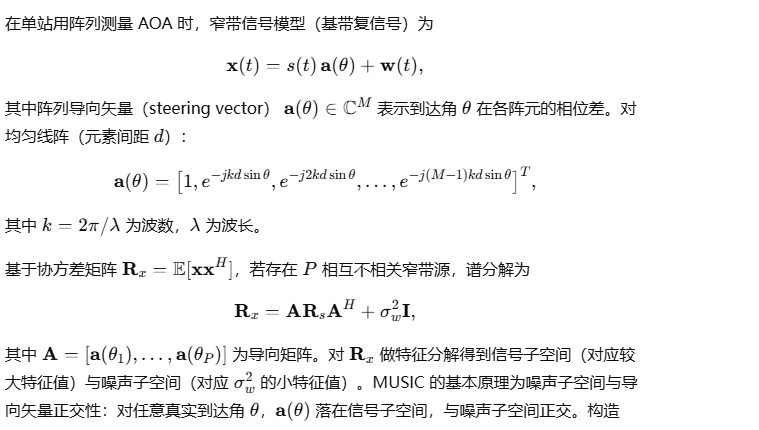
7.1.3 AOA 的阵列与角度估计(包括 MUSIC 的推导)

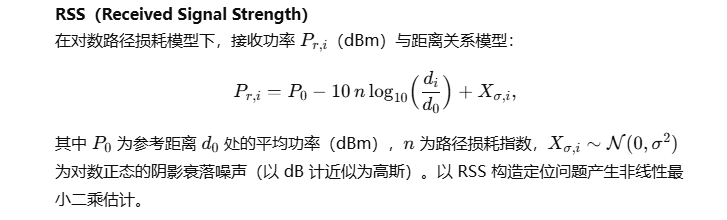
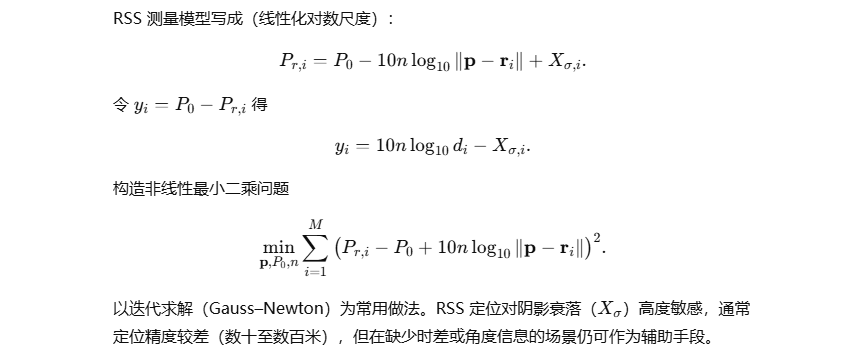
7.1.4 RSS 定位的统计推导

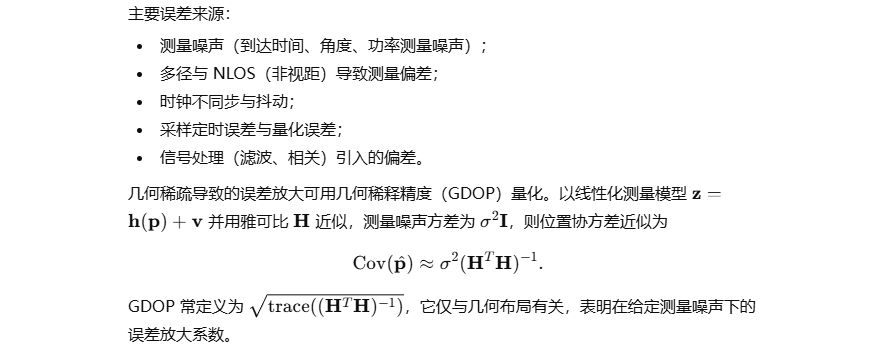
7.1.5 误差来源与几何因子(GDOP)

7.2 多站协同定位与数据融合(卡尔曼滤波、粒子滤波实现细节)

7.2.1 动态定位的状态空间建模
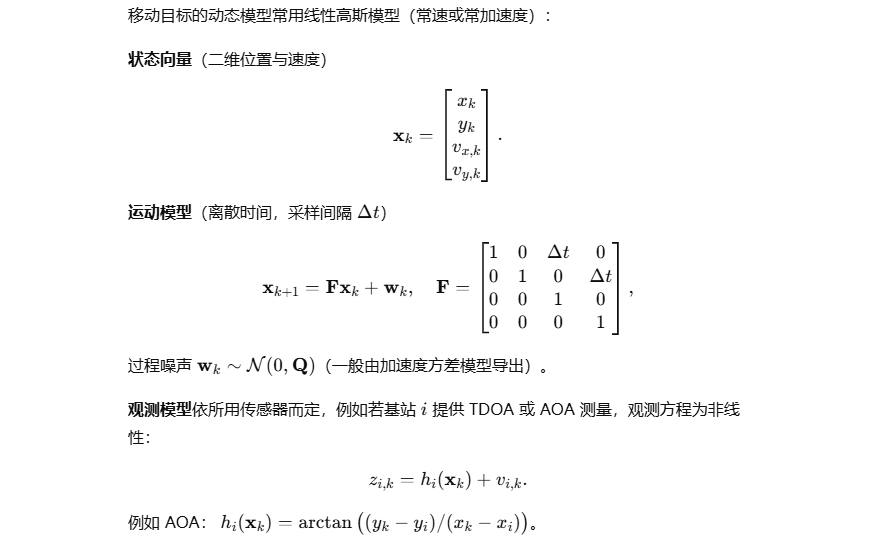
7.2.2 卡尔曼滤波(线性-Gaussian 最优滤波器)推导
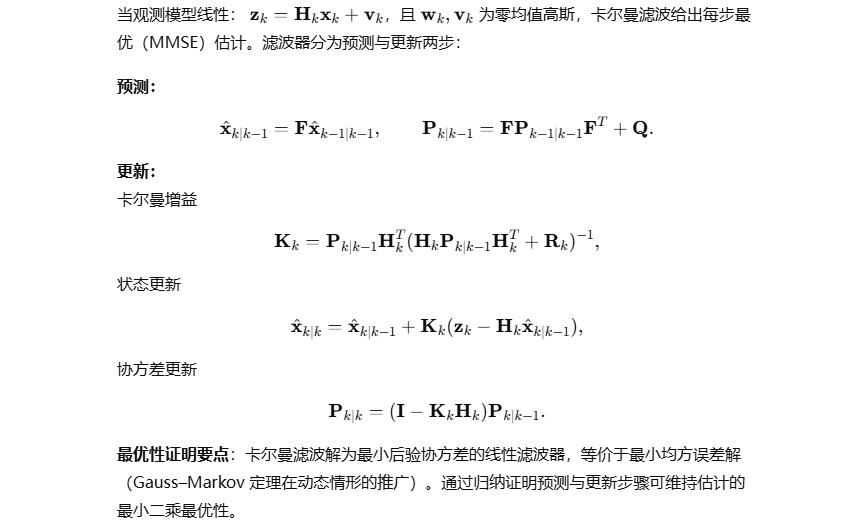
7.2.3 扩展卡尔曼滤波(EKF)与无迹卡尔曼滤波(UKF)
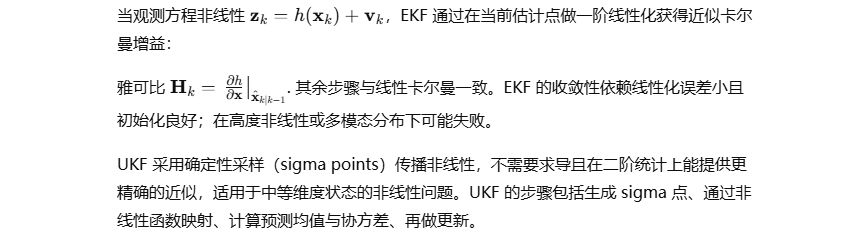
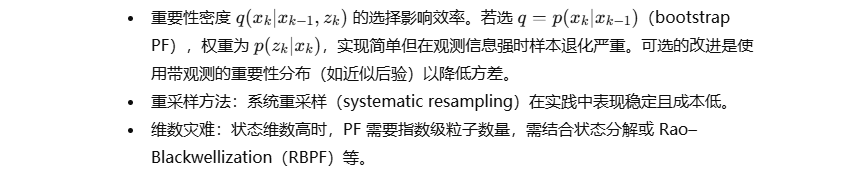
7.2.4 粒子滤波(Sequential Monte Carlo)详解与伪码

输入: N_particles, initial particles {x_k^{(i)}}_{i=1}^N ~ p(x_0), weights w^{(i)}=1/N
for each time k:
   1. 预测: for i=1..N: x_{k|k-1}^{(i)} ~ p(x_k | x_{k-1}^{(i)})
   2. 重要性权重: w_k^{(i)} ∝ w_{k-1}^{(i)} * p(z_k | x_{k|k-1}^{(i)})
   3. 归一化权重: w_k^{(i)} = w_k^{(i)} / sum_j w_k^{(j)}
   4. 计算有效粒子数: N_eff = 1 / sum_i (w_k^{(i)})^2
   5. 若 N_eff < threshold: 重采样 (systematic/residual) 得均匀权重后置
   6. 输出估计: e.g., \hat{x}_k = sum_i w_k^{(i)} x_{k|k-1}^{(i)}

细节与实现要点:
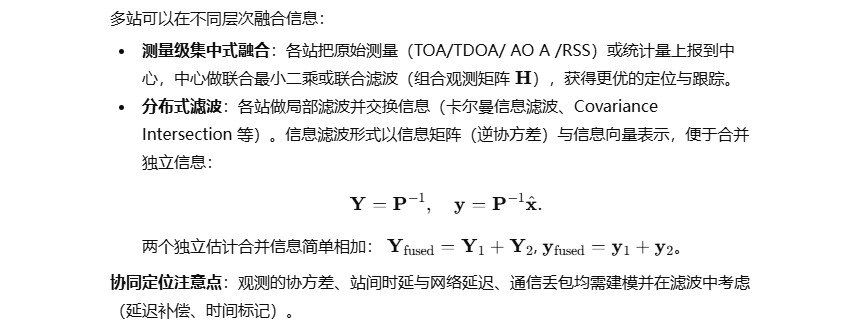
7.2.5 多站协同数据融合架构

7.3 被动定位系统设计(时钟同步、时延估计精度分析)

7.3.1 时钟同步:双向时间传输的数学解法

被动系统的接收站若无全局 GPS 等同步手段,可采用两站间的双向时间传输(Two-Way Time Transfer, TWTT)来估计时钟偏差与传播延迟。两站 A 与 B 交换时间戳并记录发送/接收时间:
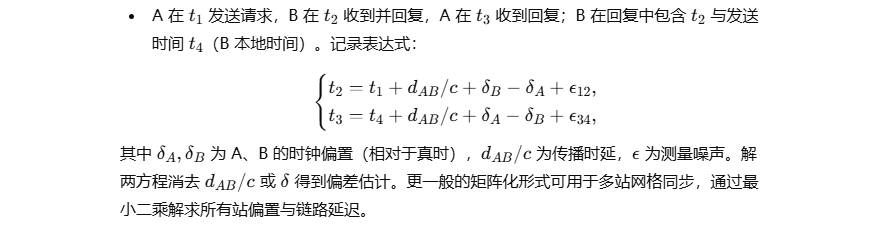
若考虑非对称延迟与丢包,则需采用更复杂的统计估计(最小二乘或最大似然)并在协议层做可靠传输保障。

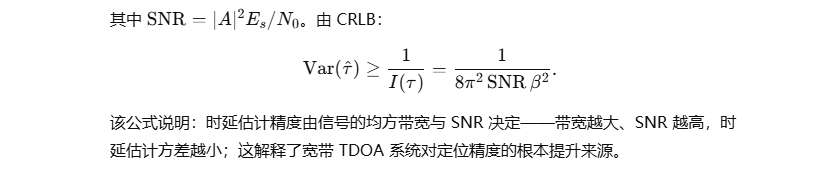
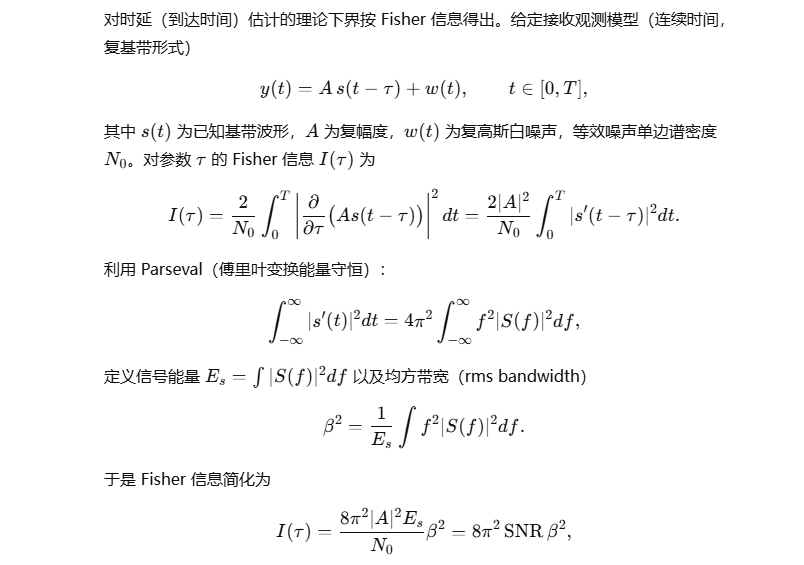
7.3.2 时延估计的精度(CRLB)推导
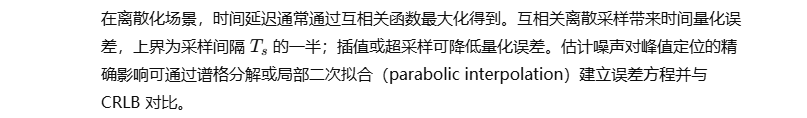
7.3.3 采样、量化与相关峰值定位误差

7.4 移动目标追踪与跨站关联(多假设追踪、轨迹拼接)

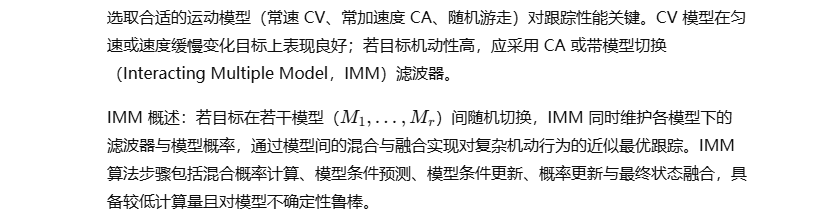
7.4.1 目标运动模型与滤波器的选择
7.4.2 数据关联:Gating、JPDA 与 MHT
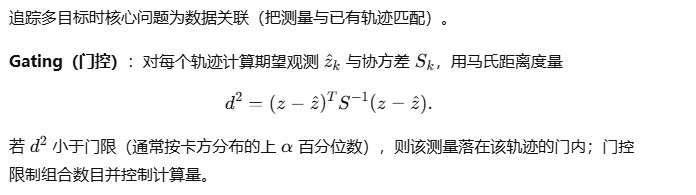
JPDA(Joint Probabilistic Data Association):针对每轨迹在每时刻计算测量归属的概率(考虑门控集合内的所有可能测量),并将所有测量以加权方式更新滤波器,避免硬分配导致的误关联。JPDA 的权重计算基于测量到轨迹的似然比并包含虚警率与漏检概率参数。

MHT(Multi-Hypothesis Tracking):维护关联假设树,延迟决策以考虑多时刻的数据。MHT 的基本思想是在事件不确定时保持多个可能的关联路径并随着时间推进和新测量到来逐步剔除低概率假设。伪码(高层):

初始化: 空假设树
for each time k:
   1. 生成所有可能的测量-轨迹关联组合(受门控限制)
   2. 对每个假设计算似然并更新轨迹状态与权重
   3. 合并同质假设并修剪低权重假设以控制指数增长
   4. 输出高权重轨迹与其概率

MHT 给出近似最优的数据关联但计算复杂度高,通常结合启发式剪枝与窗口化策略。

7.4.3 轨迹拼接(跨站 / 跨段关联)

在分布式观测场景下,单站或子网可能对同一目标获得片段轨迹,需在时空上拼接成完整轨迹。拼接的核心为度量两个轨迹段在时间交接处的相容性,包括位置、速度与加速度的一致性及轨迹段间时间重叠/间隔的合理性。可构造拼接代价函数

在阈值下选择最小代价配对(匈牙利算法用于多对多最优匹配),或者把拼接作为 MHT 的一部分处理时间间隔。

7.4.4 平滑与后验轨迹优化(Rauch–Tung–Striebel 平滑)

得到滤波器在线估计后,可以用平滑算法获得更好的后验轨迹(利用未来观测信息)。Rauch–Tung–Striebel (RTS) 平滑为线性高斯模型的最优固定间隔平滑器:
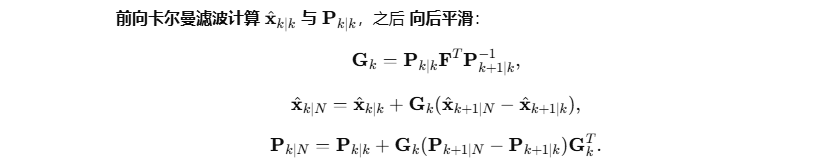
RTS 平滑可显著降低轨迹抖动并改进位置精度(使用全段观测)。


7.5 本章小结与工程实践要点

  1. TOA/TDOA/AOA/RSS 各有优缺点:TOA(需发射时刻或接收同步)、TDOA(可消除发射时刻但需站间同步)、AOA(阵列硬件复杂但在几何好时精度高)、RSS(实现简单但精度低)。

  2. 定位问题本质为非线性最小二乘或最大似然问题,常用线性化(Gauss–Newton)、代数闭式解(在特殊几何下)或数值优化求解。

  3. 定位精度的根本限制来自时延估计的 CRLB,CRLB 与信号带宽与 SNR 成正比——宽带系统对精度的提升具有理论支持。

  4. 多站协同与动态跟踪通过状态空间模型(卡尔曼、EKF、UKF、PF)在不同非线性与噪声假设下提供可行的滤波器选择;数据关联问题(JPDA、MHT)是多目标跟踪的核心挑战。

  5. 被动系统的时钟同步与测量延迟估计至关重要,双向时间传输与网络时钟同步算法为工程实现提供可行路径。

  6. 在工程实现中必须把几何 GDOP、NLOS 偏差与多路径、采样定时抖动、ADC/量化误差、时钟相位噪声等系统性误差建模到估计流程中,通过模型校正、鲁棒滤波(如 Huber 损失)、和数据驱动(机器学习/统计)方法减轻偏差影响。

【无线电控制与数据链探测系统】第1章 理论基础:定义、模型与基本推导 侧重统计推导、算法改进、深度学习与评估(参照第3–6、10章)。:侧重链路预算、算法复杂度、实时实现与优化(参照第5、13章)。:关注指标定义、可测性、数据集与基准(参照第11、14章)。这是天线理论的基本关系(来自天线辐射与接收对偶性)。 阅读详情

相关推荐

ASM 版本矩阵与 JDK 差异:ASM9 读到 JDK 21 类会发生什么

ASM 里有两个同名不同义的「版本」:ASM API 版本和 class 文件版本。前者低了报。

PaoHaiJiao的博客 31

【滤波】扩展卡尔曼滤波器(EKF)

%matplotlib inline #format the book import book_format book_format.set_style() 我们发展了线性卡尔曼滤波器的理论。然后在上两章中,我们提出了使用卡尔曼滤波器解决非线性问题的主题。在本章中,我们将学习扩展卡尔曼滤波器(EKF)。EKF通过在当前估计点对系统进行线性化来处理非线性,然后使用线性卡尔曼滤波器对该线性化系统进行滤波。这是最早用于非线性问题的技术之一,也是最常用的技术。 EKF为滤波器的设计者设置了较大的数学挑战,因此我

Yngz_Miao的博客 2万+

EV1527 vs HS1527:固定码芯片的STM32解码避坑指南

本文深入解析EV1527与HS1527固定码芯片的技术差异,提供基于STM32的完整解码方案与稳定性优化策略。通过硬件接口配置、状态机实现及示波器诊断,解决工业遥控、安防报警等场景中的解码难题,特别针对时序差异和干扰问题给出实用解决方案。

o0p1q2r3的博客 334

目标跟踪常用算法——EKF篇

介绍了目标跟踪中常用的扩展卡尔曼滤波算法(EKF),大体给出了滤波算法流程以及仿真分析

zya1223的博客 2073

vscode中创建vue快捷键

1.安装Vetur插件(扩展里面直接搜) 2.vscode 界面里面左上角选则 文件=> 首选项=> 用户代码片段=>新建全局代码片段=>在输入框中新建名称为vue.json 3.删除里面的注释,当然你也可以留着,把下面的代码粘贴进去! { // Place your 全局 snippets here. Each snippet is defined under a snippet name and has a scope, prefix, body and // descri

Leon_940002463的博客 3209

高通camx ThreadManager

m_pCore->AcceptNewJob是将一个Job或者任务插入一个Queue,有一个工作线程循环从Queue中取Job任务执行,执行任务就是回调任务中的callback函数,AcceptNewJob实现。调用AddToPriorityQueue将任务添加到queue任务队列,那么什么时候从这个queue中取任务执行呢?有个线程循环执行DoWork,最终调用checkAndDequeue取任务执行。

GetnextWindow的专栏 439

基于EKF的单站相位差变化率定位实现

该方法已在MATLAB R2024a环境下验证,建议配合Parallel Computing Toolbox加速大规模计算。对于超密集部署场景(>100锚点),推荐采用GPU并行化方案(CUDA内核)。

yugi987838的博客 433

STM32F103C8T6实战:从零搭建三相SPWM逆变器(附MATLAB仿真、PCB、源码)

本文详细介绍了如何使用STM32F103C8T6单片机从零搭建三相SPWM逆变器,涵盖硬件选型、PCB设计、SPWM算法实现及MATLAB仿真。项目提供完整的工程文件,包括源码、PCB设计和仿真模型,适合电子工程师和学生进行实践学习。通过本教程,读者可以掌握逆变器设计的核心技术和调试方法。

weixin_30458043的博客 455

Particle Filter Tutorial 粒子滤波:从推导到应用(一)到( 四 )

博主在自主学习粒子滤波的过程中,看了很多文献或博客,不知道是看文献时粗心大意还是悟性太低,看着那么多公式,总是无法把握住粒子滤波的思路,也无法将理论和实践对应起来。比如:理论推导过程中那么多概率公式,概率怎么和系统的状态变量对应上了?状态粒子是怎么一步步采样出来的,为什么程序里面都是直接用状态方程来计算?粒子的权重是怎么来的?经过一段时间的理解,总算理清了它的脉络。同时也觉得,只有对理论的推导心中有数了,才能知道什么样的地方可以用这个算法,以及这个算法有什么不足。因此,本文将结合实际程序给出粒子滤波的详细推

CodeMing's Blog 2万+

[医学图像分割综述] Medical Image Segmentation Using Deep Learning: A Survey

本综述有两个独创之处,首先,与传统的调查方法直接将医学图像分割的文献划分为多个组,并对每个组详细介绍文献的方法相比,我们将目前流行的文献按照从粗到细的多层次结构进行分类。其次,本文重点研究了监督学习和弱监督学习方法,但未包括无监督方法,这种方法目前在医学图像领域并不流行。对于监督学习方法,我们从骨干网络的选择、网络块的设计和损失函数的改进三个方面对文献进行了分析。对于弱监督学习方法,我们分别根据数据增强,迁移学习和交互式分割研究文献。与已有的调查相比,本次调查的文献分类与以往有很大的不同,更便于读者了解相关

qq_38932073的博客 4万+

GEE聚类分析:基于sentinel-2 影像进行 K-Means 聚类分析

这篇博客介绍了如何使用 Google Earth Engine (GEE) 进行 K-Means 聚类分析,以识别感兴趣区域(ROI)内的不同地表覆盖类型。文章详细说明了从定义用户参数、准备参考区域、加载和预处理 Sentinel-2 图像,到训练 K-Means 聚类器并对图像进行聚类的完整流程。代码示例展示了如何设置参数、采样像素数据、训练聚类器,并将结果可视化。最后,还提供了将聚类结果导出到 Google Drive 的选项。通过该教程,用户可以掌握在 GEE 平台上进行地理数据聚类分析的基本方法。

此星光明博客 263

粒子滤波(Particle Filter)

在完成这篇博文时,参考了以下网站: http://blog.163.com/jw_67/blog/static/136199256201031310142614/ http://blog.youkuaiyun.com/gnuhpc/article/category/549384/2 http://blog.youkuaiyun.com/karen99/article/details/7771743 h

叶子结点的专栏 1万+

mapbox进阶,dem数据转为等高面,加载转换后的等高面到地图

本文详细介绍如何基于mapbox-gl v3.*.* 版本,使用dem数据转为等高面,加载转换后的等高面到地图,亲测可用。希望能帮助到您。一起学习,加油!加油!

我哎GIS博客 408

PCA 把数据压扁之前,先请了一台隐形的机器——奇异值分解的三段式

任意m×nm \times nm×n实矩阵AAAAUΣVTAUΣVTUUU是m×mm \times mm×m的正交矩阵,列是左奇异向量;VVV是n×nn \times nn×n的正交矩阵,列是右奇异向量;Σ\SigmaΣ是m×nm \times nm×n的对角矩阵,对角线上是奇异值σ1≥σ2≥⋯≥σr0σ1​≥σ2​≥⋯≥σr​0,其余位置全是 0。

计算机科学、人工智能、数据分析和大数据方向的研发和教学。 270

cesium加载geotiff的 四种方法

本文介绍了在Cesium中加载GeoTIFF数据的两种主要方法。首先解析了核心前置知识,包括坐标系匹配、数据类型区分和性能优化。方法1详细演示了如何将RGB影像GeoTIFF转换为Cesium影像图层,包含从数据解析到Canvas转换的完整代码流程。方法2则针对高程数据(DEM)处理,展示了前端直接解析构建地形网格的方案。文章提供了完整的代码示例和关键实现要点,适用于卫星影像、专题图和数字高程模型等多种GeoTIFF数据类型在三维场景中的可视化需求。

大剑师兰特的GIS世界 397

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

专转本-线性代数复习

复习线性方程组 解得情况判别 一、 AX=β 唯一解 无穷多解 无解 二、AX=0 A列满秩⇔\Leftrightarrow⇔AX=0只有0解 A列满秩⇐\Leftarrow⇐R(AB)=R(B) 通解的构造 一、AX=0 解的性质:任何一组解的任意线性组合还是解 基础解析:解集的最大线性无关组 通解: 解集的秩:n-R(A) 应用与连续 ...

大今野 194

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

多人协作运营矩阵,怎么管控环境不串号?

团队账号矩阵运营中,串号问题源于多人共用设备导致的环境数据交叉。中屹指纹浏览器通过“一号一环境”实现底层隔离,结合权限分级管理与标准化SOP流程,确保账号独立、操作可追溯。配套日志留痕与定期巡检机制,有效防范人为失误与权限滥用,构建安全可控的协作体系,是多账号矩阵高效运营的核心解决方案。

siyetianp的博客 325

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

python题目练习23-同行列对角线的格// 计算矩阵边缘元素之和//计算鞍点

以上代码可供大家参考,如果大家有更好的方法也可以分享出来哈。

2201_76061075的博客 249

蓝桥杯·全国青少年信息素养大赛·电子学会软件编程考级:二维前缀和(子矩阵快速求和)解析

在软件赛(C/C++·Python 程序设计)、全国青少年信息素养大赛算法应用主题赛,以及中国电子学会软件编程(C/C++、Python)等级考试的真题里,矩阵、网格统计类题目几乎年年出现:给你一张成绩单矩阵,反复询问「某一块矩形区域的总分是多少」。如果每次询问都暴力求和,数据一大就超时;而能用一次预处理,把任意子矩阵的求和压到。本文用一道原创题讲透它的原理、代码(C++ / Python 双版)、七个易错点和进阶变形。

IT_Scratch的博客 244

随机 矩阵

这里的震撼之处在于:它不是"越弱越难检测"的渐进困难,而是一个离散的、有一刀之隔的相变——低于阈值,信号在谱里实际上是"消失"的,你从观测数据里根本拿不到它;越过阈值,它就清晰可见。取一个纯粹随机的、元素独立同分布的矩阵,在行数与列数同时趋向无穷、且它们的比值收敛到一个固定常数的极限情形下,这个矩阵的样本协方差矩阵的特征值,会收敛到一个确定的概率分布:它落在一个由该行列比决定的、有明确上下界的区间内,密度函数形状极其具体(像一条边缘被截断的抛物型曲线),而且它有一个关键性质——所有特征值都被。

2602_95606446的博客 183

OpenCV 5.1.0正式发布:核心矩阵、图像处理、DNN推理全面升级,性能与稳定性大幅增强

与此同时,OpenCV 5.1.0 还在 AVX-512、NEON、RISC-V RVV、IPP、OpenCL、CUDA、ArmPL 等多个后端持续优化,并对大量精度、内存、越界、异常输入和跨平台问题进行了修复。DNN 模块则完成新引擎统一,强化了 CUDA、cuDNN JIT、ONNX、TFLite、注意力机制、KV 缓存和量化推理能力。另一方面在 SIMD、AVX-512、RISC-V RVV、CUDA、OpenCL、IPP、ArmPL 等后端上进行了大量性能优化。DNN 模块迎来重要架构调整。

福大大架构师每日一题 827

AI自媒体矩阵管理软件有哪些及如何实现多平台内容创作与发布自动化

本文探讨AI自媒体矩阵管理软件的核心能力模块与技术实现逻辑。软件通常包含内容生成、风格约束、渠道分发与效果监测四大模块,依赖结构化品牌资料、明确创作规则与任务计划三大前置条件,实现多平台内容自动化生产与发布。技术链路涵盖账号授权、格式适配、调度执行与结果回传,需确保权限有效、规则清晰、数据可查。监测数据应作为反馈闭环的观察依据,而非单一结论。选型关键在于链路闭合性与可排查性,而非功能数量。使用中需注意:自动化不等于无人值守,生成内容须人工复核,监测波动需结合多因素判断,数据对接常需自行开发。

2603_96364115的博客 167

混合方法文献矩阵:先拆字段,再确定分类

文献矩阵中的“方法”如果只有一个字符串字段,很容易把研究设计、数据来源、分析过程和软件名称混在一起。对同时包含问卷、访谈或观察资料的论文,先拆模型,再判断项目归类,比直接填写“定量、定性、混合”更可复核。一篇文章可以报告多项研究,同一研究也可能在多篇文章出现。建议保留文献ID、研究ID与数据关联,必要时一篇文件对应多条研究记录。不能因为只下载了一个PDF就把其中所有过程压成一行,也不能把同数据的不同论文自动统计成独立证据。项目开始时明确编码用途:比较研究设

weixin_51988539的博客 162

力扣73 矩阵置零

该解法通过标记含0的行和列来实现矩阵置零。遍历矩阵,用布尔数组记录有0的行和列;再遍历一次,若当前行或列被标记,则置为0。时间复杂度O(mn),空间复杂度O(m+n)。

Pniubi的博客 37

力扣240搜索二维矩阵(二分查找)

本文介绍在力扣240题“搜索二维矩阵II”中,对每一行独立使用二分查找的解法。通过遍历每行并调用二分查找函数判断目标值是否存在,若找到则返回true,否则最终返回false。该方法利用了每行有序的特性,时间复杂度为O(m log n),其中m为行数,n为列数。具体二分查找逻辑可参考作者主页中关于力扣35题“搜索插入位置”的实现。

Pniubi的博客 91
上一篇: 【无线电控制与数据链探测系统】第6章 无线电指纹(RF Fingerprinting)与抗欺骗
下一篇: 【无线电控制与数据链探测系统】第9章 对抗、欺骗与安全防护(电子对抗)
VectorShift
博客等级 码龄1年 1840粉丝 1109原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

VectorShift

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值