Deep Reinforcement Learning-3D Point Scene Completion from a Single Depth Image

CVPR2026l论文整理 来源:筛选日期: 2026-06-13说明: 按标题关键词自动筛选, 同一论文可能命中多个分类。共 511 篇。 阅读详情

论文链接

摘要

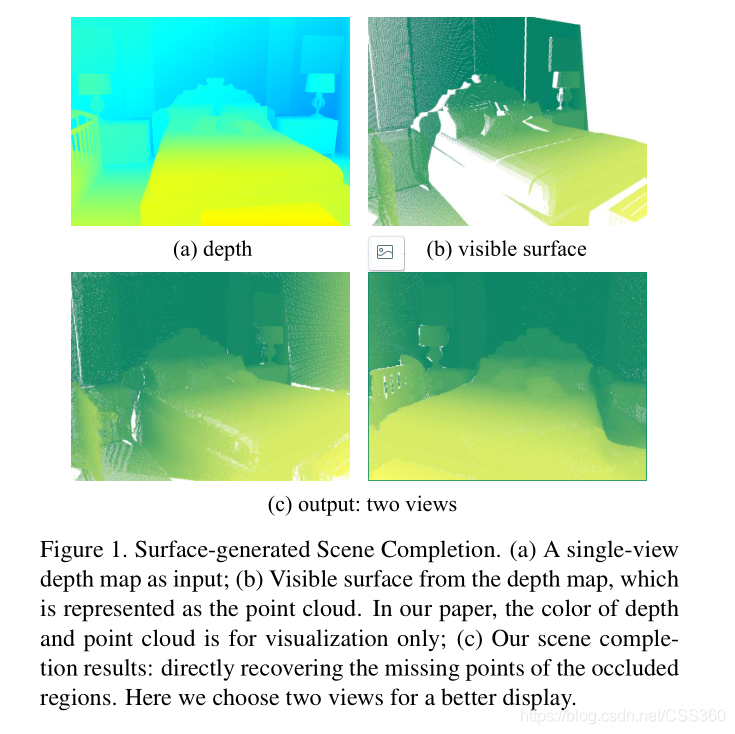
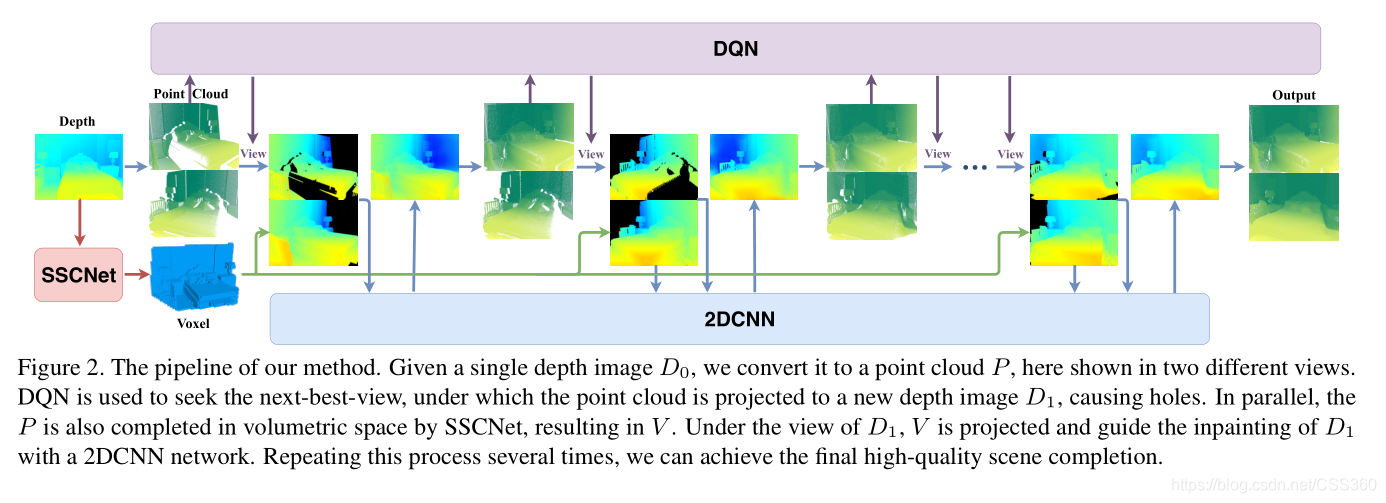
       我们展示了一个深度强化学习方法对先进的视觉恢复3D点场景在立体向导,实现高质量场景重建从一个深度图像使用严格闭合。我们的方法是端到端,由3部分组成:3D场景立体重建,2D深度图恢复,以及多视点选择完成。给定一个单张深度图,我们的方法首先通过3D立体分支得到一个立体场景重建,作为导向下一个视觉恢复步骤,来帮助获得错过的信息;第三步涉及投影立体在相同视角输入,串联它们来完成当前视角深度,融合所有深度到点云。因为闭合的区域未被使用,我们使用一个深度强化网络来环视周围以及选取下一个最好的视角对大空洞完成处理直到一个场景满足重建来保证有效性。所有步骤被学习加入来完成鲁棒和一致的结果。我们展示了高质量和高性能的评估在外部实验数据集SUNCG,获得较好的结果比当前最优的性能。
系统架构
主要工作

(1)第一个提出并实现从单张深度图得到3D场景表面生成的方法;

(2)使用多视点深度图来填补丢失的3D点;

(3)提出一个立体向导视角恢复网络来保证高精度和一致的输出结果;

(4)提出一个深度强化学习网络来寻找最优的视角

未来的研究方向

(1)如何从RGBD图像中得到纹理信息来实现高精度的深度恢复;

(2)如何将纹理和深度修补结合在一起,输出一个完成的3D场景;

(3)如何保证一个稠密的完成;

了解更多关于《计算机视觉与图形学》相关知识,请关注公众号:

下载我们视频中代码和相关讲义,请在公众号回复:计算机视觉课程资料

具身智能【2026-01】:Being-H0.5【VLA + Flow Matching】【MoT+MoE架构】【UniHand2.0数据集:4 亿个样本/35000小时 】 BeingBeyond Teamhttps://research.beingbeyond.com/being-h05Real-World Deployment Figure 1: Being-H0.5 at a Glance. We scale human-centric robot learning with Being-H0.5 toward cross-embodiment generalization. We introduce UniHand-2.0, a large-scale corpus 阅读详情

相关推荐

Kaamel白皮书:Agent-to-Agent(A2A)隐私安全最佳实践

随着AI智能体架构从单体模型演化为多Agent协同系统,A2A协议为智能生态提供了强大的互操作能力。然而,能力越大,责任亦重。若无完备的隐私保护和安全防护体系,A2A将沦为数据泄露、滥权执行的温床。Kaamel作为专注于泛安全方向的Agent基础设施构建者,呼吁业界将“隐私工程”与“安全编排”作为A2A系统设计的核心前提,共建可信Agent生态,守护智能协同时代的数据主权与系统安全。未来,Kaamel计划发布一套“可信Agent协同蓝图”,涵盖:A2A协议适配Agent SDK工具集;

kaamelai的博客 1600

InFusion:通过从扩散先验学习深度完成来修复3D高斯

3D Gaussians have recently emerged as an efficient representation for novel view synthesis. This work studies its editability with a particular focus on the inpainting task, which aims to supplement an incomplete set of 3D Gaussians with additional points

2159

Ansys Lumerical 启动时出现 Error: Could not connect to Ansys license server specified at 1055@ 的另一种解决办法

昨天在关闭了中之后 就能正常打开 FDTD 了,结果今天想开启出现了同样的报错:我猜测昨天能启动的原因在于关闭之后要重启电脑,并且在重启之后我第一时间打开 lumerical 测试因此端口没有被占用,今天是在电脑启动之后一段时间才打开所以又遇到了端口占用的问题。

qq_51404184的博客 9562

InFusion:通过从扩散先验学习深度补全来进行图像 3D 高斯修复

更准确的深度补全,我们的方法(称为 InFusion)在各种复杂场景下以更好的保真度和效率超越了现有的替代方案。与 2D 修复相比,3D 高斯修复的关键是找出引入点的渲染相关属性,其优化很大程度上受益于它们的初始 3D 位置。3D 高斯最近作为新颖视图合成的有效表示而出现。这项工作研究了InFusion的可编辑性,特别关注修复任务,旨在通过额外的点来补充不完整的 3D 高斯集,以实现视觉和谐的渲染。这样的设计使我们的模型能够以与原始深度对齐的比例填充深度值,并且还可以利用大规模扩散先验的强大概括性。

heehelcom的博客 844

Apache-Plc4x-Modbus-Tcp学习记录(一)

Apache-Plc4x-Modbus-Tcp学习记录(一)

weixin_45325423的博客 6989

手把手教你接入京东购物小程序:从领券到下单的全流程解析

本文详细解析了如何从API申请到领券下单,手把手教你接入京东购物小程序的全流程。涵盖京东联盟账号注册、商品信息获取、优惠券链接转换等关键技术实践,帮助开发者高效实现电商功能集成,提升用户购物体验。

g5h6i的博客 912

4.19-4.26周报

将编码后的深度图加噪得到的近高斯噪声,将1.掩码区域设置为0的编码后的深度图,2.编码后的RGB指导图像,以及3.掩码图像,在channel维度进行连接,输入到U-Net网络进行去噪,逐步从噪声中恢复出干净的深度潜在表示。现有方法对3D高斯补全的初步探索通常是使用对不同角度的渲染图象进行图像层次的补全,迭代的使用修复后的2D多视图图像作为新的训练数据。3D点云构建:使用补全后的深度图和对应的彩色图像,通过3D空间中的反投影操作,将2D图像点转换为3D点云,这些点云随后与原始的3D高斯体集合合并。

abaabahh的博客 1029

Allegro16.6详细教程(二)

3-D Viewer,可以直接在allegro中看到board file的3-D顯示效果。3-D Viewer對於PCB Editor Products,只有環境變數中的OpenGL顯示功能開啟後才有效,而對於APD/SiP是無效的。2.3-D viewer是在一個獨立的視窗中打開的。3-D environment環境支援多種顯示內容的過濾,取景視角和顯示效果的選項,透過遊標可以直接控制放大,移動,翻轉等操作。

axingxiansen的博客 1923

【深度修复新纪元】—— InFusion: 通过学习扩散先验完成深度图的三维高斯修复

????【深度修复新纪元】—— InFusion: 通过学习扩散先验完成深度图的三维高斯修复 InfusionOfficial implementations for paper: InFusion: Inpainting 3D Gaussians via Learning Depth Completion from Diffusion Prior项目地址:https://gitcode.com/gh...

gitblog_00048的博客 677

SCADA|KingSCADA实现有新报警时声音报警提示

在SCADA项目中有的现场系统比较多,每个调度员可能会一个人盯好多个系统,因此不会一直盯着一个系统,这时候就需要当有新的报警产生时,有报警声音提示,提示调度员查看报警,进行处理。$NewAlarm是一个离散型的变量,是新报警的意思,即当前系统中有新的报警信息产生时,该变量会自动置为1;以上为一最简单的报警提示的实现,实际中可能还会要求语音播报啥啥报警的声音,具体有时间再进行测试。通过创建测试界面,创建一个内存变量,内存变量,配置报警,界面按钮制造报警,测试效果。

做有价值的事,积累有价值的笔记! 1409

番外篇 | 关于YOLO11算法的改进点总结

关于YOLO11算法的改进点总结。🌈

小哥谈 2314

Infusion 项目使用教程

Infusion 项目使用教程 1. 项目目录结构及介绍 Infusion 项目的目录结构如下: Infusion/ ├── assets/ │ ├── Figures/ │ └── ... ├── depth_inpainting/ │ ├── run/ │ └── ... ├── gaussian_splatting/ │ ├── train.py │ ├── rend...

gitblog_00408的博客 861

OpenClaw第2章:快速安装

本章将手把手教你安装 OpenClaw。

Maynor的博客 3237

PointWorld: 动作条件的全场景3D点flow 预测(用同一种3D物理空间模态来表示状态和动作)

PointWorld: Scaling 3D World Models for In-The-Wild Robotic Manipulation

u013250861的博客 332

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

基于RGB-D图像的语义场景补全研究进展综述

作者丨张康,安泊舟,李捷,袁夏,赵春霞(软件学报)来源丨https://zhuanlan.zhihu.com/p/432968137(一点人工一点智能)编辑丨3D视觉工坊近年来随着计算机视...

3D视觉工坊 3087

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

深度学习(12):SemanticKITTI论文翻译与学习

SemanticKITTI论文是发表在CVPR 2019上的一篇在KITTI Vision Odometry Benchmark数据集上制作语义分割数据集SemanticKITTI的文章,为基于车载激光雷达语义分割提供了大量的数据;作者单位是德国波恩大学;这里是文章的翻译和部分学习笔记

biter0088的博客 1万+

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Semantic Scene Completion from a Single Depth Image

Semantic Scene Completion from a Single Depth Image Princeton University(普林斯顿大学)1.论文简介 1.1摘要 论文解决的问题是semantic scene completion(语义场景补全),之前的方法是将分为两个问题:1.场景补全(scene completion),也就是预测体积占用,一般是用体素 (vo

wydbyxr的博客 3180

3D人体重建从单张图中-DeepHuman: 3D Human Reconstruction from a Single Image

论文链接:http://www.liuyebin.com/deephuman/assets/DeepHuman.pdf 摘要 我们提出深度人体,一个图像导向立体到立体的转换CNN对3D人体重建从一个单张RGB图像。为减少干扰涉及在表面几何重建,即使对不可见的区域也可以进行重建,我们提出和利用一个稠密的语义展示形成从SMPL模型作为一个外部的输入。一个关键特征在我们的网络融合不同...

CSS360的博客 5382

单张图人体重建Convolutional Mesh Regression for Single-Image Human Shape Reconstruction

论文地址:https://arxiv.org/pdf/1905.03244.pdf 工程地址:https://www.seas.upenn.edu/~nkolot/projects/cmr/ 摘要 这篇文章目的解决问题3D人体姿态和形状估计从单张图像上。先前的方法考虑一个参数模型的人体框架,SMPL以及使用回归模型参数给上升到mesh一致图像证明。这个参数回归是一个非常具有挑...

CSS360的博客 2764

图像三维重建第六期-Scan2CAD: Learning CAD Model Alignment in RGB-D Scans

论文地址 项目地址 摘要 我们展示Scan2CAD,一个新颖数据驱动方法学习一个对准的3D CAD模型从一个基础数据对噪声和不完整几何的RGB-D扫描。对于一个3D重建一个室内场景,我们的输入一系列的CAD模型,和预测一个9维姿态能够对齐每个模型的基本扫描几何。为解决这个问题,我们创建一个新的扫描到CAD对齐数据集基于1506扫描网络扫描97607来注释关键点对在14224C...

CSS360的博客 1506

AI论文探讨室·A+·第10期 DeepStereo: Learning to Predict New Views from the World’s Imagery

《DeepStereo: Learning to Predict New Views from the World’s Imagery》 论文链接 主要解决的问题:首次使用神经网络预测新的视点图 主要描述 新视点的像素生成是使用将临近视点的图像输入到卷积神经网络中,最后生成新视点的图像。它的有优势主要在,只需要一系列的不同位姿下的图像,然后就可以在不同场景下生成新的视点。 ...

CSS360的博客 1473

PVNet: A Joint Convolutional Network of Point Cloud and Multi-View for 3D Shape Recognition

论文链接:http://gaoyue.org/paper/PVNet.pdf 摘要 3D目标识别已经吸引研究者们的注意在领域多媒体和计算机视觉。随着最近涌入的深度学习,各种深度模型使用不同的展示形式实现先进的表现。大部分它们,点云和多视点基于3D模型展示正在引进在最近,它们对应的深度模型已经展示出重要性在3D模型识别。然而,有较少集中在点云数据和多视点数据对于3D模型展示,在我们...

CSS360的博客 1393

AI论文探讨室·A+·第17期 Motion2Fusion: Real-time Volumetric Performance Capture

欢迎志同道合的朋友,在下方留言,大家相互学习。 论文链接 摘要 这是一个360度实时的对非刚性进行三维重建的系统Motion2Fusion。作者主要贡献:(1)提出一个新的非刚性融合系统能够实现高精度立体细节融合,来避免先前的过度平滑和视觉效果;(2)使用机器学习对3D对应区域进行估计来减少跟踪错误来自快速运动造成的结果;(3)一个反向和前向对齐策略能够鲁棒处理拓扑结构改变...

CSS360的博客 1273

AI论文探讨室·A+·第11期 DeepMVS: Learning Multi-view Stereopsis

《DeepMVS: Learning Multi-view Stereopsis》 主要解决的问题:输入任意数量的姿态图像来预测高质量的视差图 主要描述 主要包含三部分:(1)在真实统一数据集上进行有监督的预训练;(2)提出一个有效的方法在无序的图像数据集中收集信息;(3)使用预训练的VGG-19网络来融入多层的特征。通过在ETH3D数据集上对论文中提出的DeepMVS网络,...

CSS360的博客 1090

基于图像的3D目标重建 State-of-the-Art and Trends in the Deep Learning Era

论文地址:https://arxiv.org/pdf/1906.06543.pdf 摘要 先进的3D目标重建使用深度学习的分类 编码阶段分类

CSS360的博客 1040

AI论文探讨室·A+·第2期 DISN: Deep Implicit Surface Network for High-quality Single-view 3D Reconstruction

NeurIPS2019 《DISN: Deep Implicit Surface Network for High-quality Single-view 3D Reconstruction》 论文链接 代码链接 主要解决的问题:从单张图像中重建3D模型,即给定一张图像预测有符号距离域 具体描述 除了使用全局图像特征,DISN也预测局部块的每个3D点投影和提取局部特征从...

CSS360的博客 800
上一篇: 图像三维重建第七期-Real-time Non-rigid Reconstruction using an RGB-D Camera
下一篇: PointRCNN
元宇宙MetaAI
博客等级 码龄10年 331粉丝 333原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值