基于深度学习的共享单车再平衡

基于深度序列学习的共享单车系统再平衡

摘要

共享单车系统(BSS)作为一种绿色便捷的交通方式,已在全球范围内受到广泛关注并快速发展。然而,由于用户需求在时间和空间上的变化,BSS的自行车站点容易出现空置或满载状态,从而影响系统的运行效率和用户体验。为解决这一问题并高效地实现自行车再平衡,研究人员提出了大量方法,尤其是来自运筹学领域的方案。然而,该问题本质上是一个NP难问题,大多数已有方法难以应用于大规模的共享单车系统(BSS)。本文受人工智能领域最新进展的启发,注意到对于特定的共享单车系统,类似的重新平衡问题每天都在重复发生。因此,有望从历史问题实例中学习有用的知识,并将其应用于未来的问题。本文采用序列到序列学习技术进行知识学习,并将其用于新问题的求解。在真实世界数据集上的评估结果表明,我们的方法显著优于现有的平衡方案。

引言

近年来,在物联网技术[1],[2]进步的推动下,共享单车系统已在全球范围内成为主流。在遍布五大洲600多座城市部署的共享单车系统(BSS)为城市地区提供了一种便捷、灵活且环保的交通方式[3]。全球共享单车的兴起带来了许多运营挑战,其中最主要的是车站之间的车辆失衡问题。例如,大量自行车在早晨从住宅区转移到商业区,而在晚上则相反。还车和取车需求的变化导致部分车站自行车积压,而其他车站则缺乏自行车,常常造成无法取车或无法还车的情况。我们通过分析杭州共享单车系统(Hangzhou’s BSS)的使用数据发现,该系统很容易进入失衡状态。杭州共享单车系统是全球规模最大的自行车共享系统之一,包含超过3000个站点。根据我们的统计,17%的车站在一个月内从未出现满车或空车状态,19%的车站空车状态持续超过200小时,27%的所有车站满车状态持续同样时长。

为解决此问题,系统运营商通常使用容量有限的卡车或拖车在各站点之间重新分配自行车。然而,车辆再分配并非易事,可分解为两个步骤:1)确定每个站点应取走或投放多少辆自行车;2)设计卡车的最优路径方案。对于步骤1,Liu et al. 提出搜索一个合适的数量,以最大化每个站点的运行寿命[4]。对于步骤2,从操作与优化角度出发的建模方法及求解方案见于[5]–[7];Liu et al. 设计了一种聚类后路径规划的方法[4];Li et al. 从强化学习的角度研究了该问题[8]。然而,现有求解路径规划问题的方法尚不理想。精确方法(如[5],[7])求解大规模组合优化问题耗时较长,在实际中难以应用;近似方法(如[4],[9])通常依赖手工设计的启发式方法,但未考虑每个共享单车系统的独特特征,从而影响了其性能。

我们注意到,尽管重新平衡问题是一个NP难问题,但对于特定的自行车共享系统,不同日期的重新平衡问题具有一些共同的设置和结构。例如,每天靠近商业区的站点都面临相似的流入量,因此需要运走相似数量的自行车。这一特性促使我们使用神经网络模型来学习以往的经验,并设计一个端到端的系统以预测最优再平衡方案。所提出的方法可以:1)利用以往数据训练模型以进行未来预测;2)使用小规模实例训练模型,并将其应用于大规模实例。

在我们的系统中,我们首先预测每个站点在未来近期的还车和取车需求。基于此预测,我们确定所有站点的最优平衡间隔。接下来,我们训练一个神经网络,以根据再平衡区间和站点位置来预测平衡运输车的行驶路线。最后,提出一种后处理算法,将预测的路线转换为可行解,并确定每个站点的具体平衡数量。

本文的主要贡献如下:
■ 我们设计了一个端到端的人工智能辅助的大型自行车共享系统再平衡系统。
■ 我们提出了一种基于预测结果计算最优平衡间隔的算法,从而提高了问题的灵活性。
■ 我们改进了指针网络并设计了一种后处理算法,使得重新平衡问题能够被恰当地视为一个有监督学习问题。
■ 我们使用全球最大的自行车共享系统之一的真实世界数据进行了广泛的评估。评估结果表明,我们的方法优于现有的再平衡方案。

本文其余部分组织如下:我们在第二节介绍背景和设计细节。第三节展示了在真实世界数据集上的评估。最后,在第四节中,我们总结了本文,并讨论了局限性和未来工作。

设计

背景与问题描述

如第 I 节所述,自行车共享系统(BSS)通常由多个自行车站点组成。用户可以从其出发地附近的站点取车,并在目的地附近的站点还车。这些站点通常具有有限数量的车桩(即站点容量,通常为 20 到 30 个),这意味着由于借车流量过大,可能会出现无车可借的情况,反之也可能出现车桩满载无法还车的情况。为了防止站点出现空置或满载的情况,运营商通常使用卡车将自行车从满载的站点运送到空闲的站点。卡车从区域仓库出发,依次访问一系列站点,最后返回仓库。该仓库用于维修自行车和存放备用自行车,因此卡车在离开仓库时可以携带一些自行车,返回时也可以卸下部分自行车。

本文研究早高峰时段前的自行车再平衡问题,目标是最小化在特定时间段内站点空置或满溢的时间。我们考虑使用一辆卡车进行再平衡,并允许其多次返回车场以装载或卸载额外的自行车。设计车辆路径方案的目标是最小化总距离。

再平衡区间预测

在此步骤中,我们首先确定每个站点的最优平衡间隔。通过考虑再平衡区间而非强制性数值,路径规划算法可以根据其路由设计选择合适的数值,从而提高问题的灵活性。

借助自行车共享系统的细粒度预测模型[10],我们可以预测未来一段时间内的还车和取车数量。该模型针对每个 30分钟时间窗口提供预测结果,取车和还车的均方对数误差分别为0.4287和0.4736。在本问题中,我们首先预测从早上6:00到14:00的取车/还车数量,并以滚动方式累加预测结果,从而获得每个站点的库存曲线。该曲线如图1中实心黑线所示,我们的优化成本是站点处于满仓/空仓状态的时间。

通过利用主动再平衡与用户行为之间的独立性,我们可以将再平衡视为在垂直方向上移动曲线。如图1中的虚线所示,我们可以看到将曲线移动到不同位置(即取走不同数量的自行车)具有相同的成本。换句话说,所有这些再平衡数量都将导致相同的站点性能。

因此,在这一步中,我们使用一个再平衡区间来记录导致相同最优性能的数值,并将此区间表示为 $[l_i, u_i]$,其中 $l_i$ 和 $u_i$ 分别是站点i所需的最小和最大初始库存(如图1所示)。换句话说,如果站点i在再平衡前的初始库存为 $c_i$,且再平衡数量为 $x_i$,我们应确保 $l_i \leq c_i + x_i \leq u_i$。
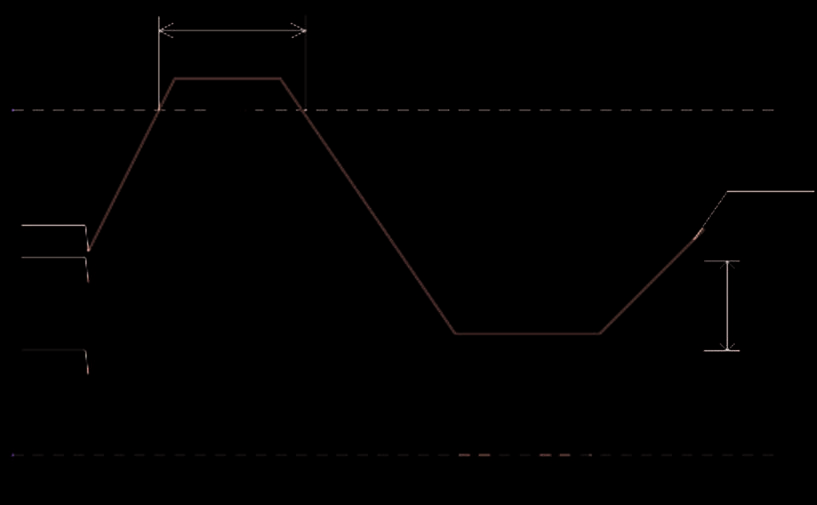
示意图0

访问顺序预测

在此步骤中,我们使用神经网络生成卡车的访问序列,以最小化行驶距离。

模型描述

我们使用了一个类似于指针网络[11]的网络,但我们修改了输入信息,并为自行车共享系统中的重新平衡问题增加了一个额外的后处理过程(见第二节-D小节)。

我们的路径预测模型如图2所示。该模型由两个 LSTM(长短期记忆网络)组成。对于编码器网络,每一步我们输入一个元组 $(l_i - c_i, u_i - c_i, \text{lat}_i, \text{lon}_i)$,其中 $l_i, u_i$ 和 $c_i$ 分别是再平衡区间和初始库存,$\text{lat}_i$ 和 $\text{lon}_i$ 是站点i的纬度和经度。在解码器网络中,我们使用注意力机制计算每个站点被选为访问序列中下一个站点的概率,并选择概率最高的站点。我们使用交叉熵作为损失函数。
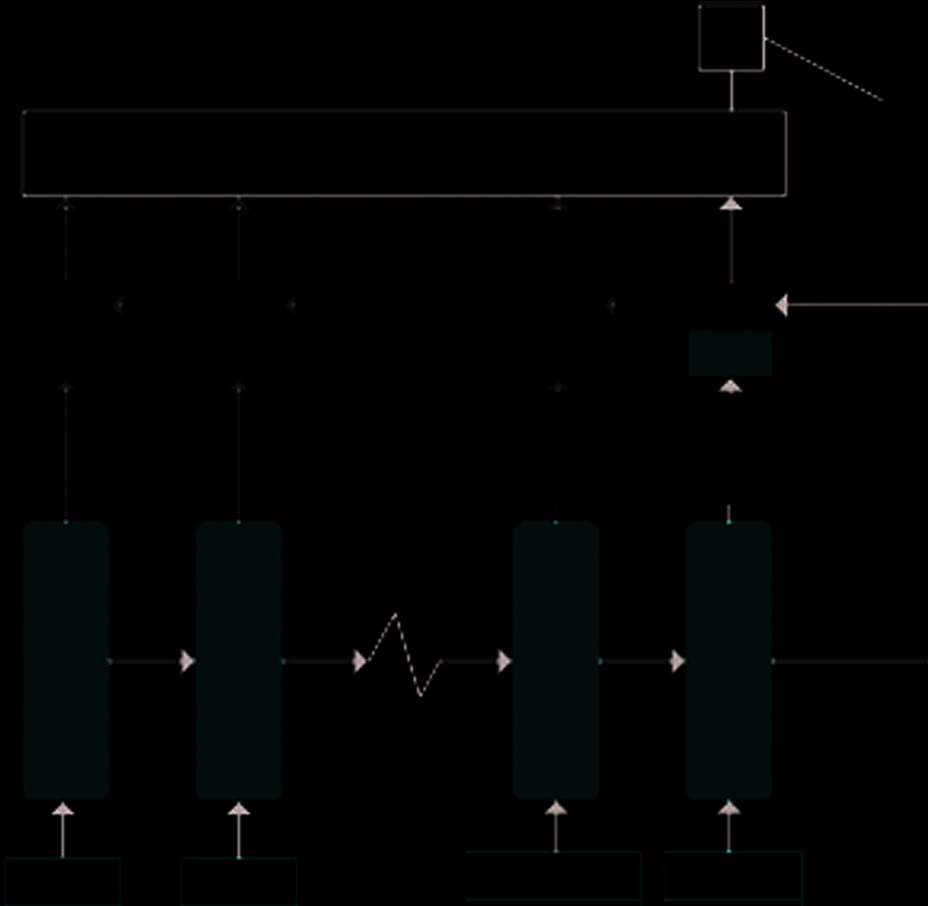
示意图1

模型训练

在本部分中,我们介绍如何准备训练数据,特别是真实访问序列,用于训练神经网络。自行车共享系统(BSS)中的路径规划问题类似于运筹学文献中的取送货问题(PDP)[6]。尽管该类问题在以往研究中已被广泛探讨,但由于其 NP难特性,求解仍具有较大难度。商业优化求解器(如 Gurobi)通常能够求解站点数量较少的问题,但在大规模场景下则难以奏效。

在训练数据准备过程中,我们首先预测训练日期内各站点的再平衡区间。然后,在每一天中随机选取k个站点,并借助Gurobi求解这个小型取送货问题(PDP)。我们求解器的输出结果是这k个站点的最优访问序列,该序列可最小化卡车的行驶距离。我们将此序列作为标签数据,而将站点的位置和再平衡区间视为特征。本文中,我们生成了 5000条记录用于模型训练。

模型推理

对于推理过程,得益于循环神经网络的特性,我们首先输入所有候选站点的信息(可能多于k个)。然后使用该网络预测前k个站点(可能包含重复的站点)。我们将已访问站点从候选集中移除,输入剩余的站点并获得接下来的k个预测结果。此过程重复进行,直到所有站点均出现在序列中。

构造可行解

在此步骤中,基于预测序列,我们构建一个可行解(确保卡车和站点的容量约束均得到满足),并确定在每个站点需要取走或投放的具体自行车数量。此步骤中的挑战有两方面。首先,从一个站点取走的自行车数量不仅与该站点之前的站点有关,还与其后续站点相关。例如,如果后续站点也需要自行车,则当前站点不应从卡车上取走过多自行车。因此,我们必须考虑完整的序列以确定某个站点的再平衡数量。其次,卡车可能需要返回车场以获取或存放额外的自行车,但车场并未包含在序列中。
示意图2

评估

在本节中,我们基于大规模真实世界的自行车共享系统交易数据——杭州的数据进行评估。杭州系统被划分为多个行政区,我们重点关注下沙区,该区包含149个站点和一辆调运卡车。我们基于2015年6月至2015年8月的真实使用记录进行模拟。

评估设置

在我们的评估中,我们使用前80天的数据来训练使用预测模型和序列模型。剩余的12天用于测试。在每个测试日,我们首先预测从8:00到14:00的用户需求。该需求用于计算每个站点的再平衡间隔。此预测结果提供给我们的路由模型以及其他基线方法。为了在合理时间内获得最优解以进行性能比较,我们仅考虑成本最高的前20个站点。最后,我们使用真实用户还车/取车事件记录来测试系统性能。然而,评估特定再平衡方法的性能并非易事,因为我们无法确定当没有自行车可供取车或没有空闲车桩可供还车时用户的行为。因此,在本模拟中,我们假设用户在取车时最多等待p秒,而在还车时将一直等待直至有可用的车桩。p在我们的模拟中被视为一个参数。

我们在评估中比较了以下算法。
■ 顺序学习再平衡(SR) :“SR”是本文提出的方法。我们在三种不同设置下测试“SR”:“SR‐10”、“SR‐15”和“SR‐随机”分别表示站点数量 k 设置为10、15和一个随机数(从10到15)。
■ 容量约束K中心聚类(CKCC) :CKCC 在 [4] 中被提出,是当前最先进的自行车再平衡方法。该方法中,作者提出了一种先聚类后路径规划的再平衡算法。为了与我们的方法进行比较,我们使用大量聚类,以确保每个站点都会被访问。
■ 基于经验的再平衡(EBR) :“EBR”是另一个基线方法,代表系统运营商根据其以往经验和知识进行的实际再平衡操作。这些现实世界中的再平衡操作是从操作记录数据中推断得出的。
■ 最优路径再平衡(ORR) :在“ORR”中,路径规划方案和再平衡数量由优化器求解,而不是使用机器学习方法。

为了评估性能,我们从系统和用户两个角度采用两个指标:1)“服务中断时间”是指站点空置或满载的时间;2)“被拒绝用户数量”是指未能成功借到自行车的用户平均数量。这两个指标均在测试日之间取平均值,且应尽可能小。
示意图3

示意图4

示意图5

重新平衡性能

我们首先在图4中展示关于系统效用的整体性能。系统性能反映了系统服务用户以及避免站点空置或满溢的能力。从图中可以看出,“SR‐10”、“SR‐15”、“SR‐随机”、“CKCC”和“OOR”的性能非常接近,这是因为它们基于相同的预测结果进行再平衡,对用户的服务效果相当。细微的差异是由三种方法选择的不同再平衡数量引起的(预测结果仅提供再平衡区间)。此外,这三种方法均明显优于仅依赖运营人员经验且无预测支持的再平衡方式。

关于用户体验的评估,被拒绝用户数量如图5所示。结果与服务中断性能相似。具体而言,当用户耐心设置为150秒时,EBR与SR‐15相比,被拒绝用户数量从223减少到103。

接下来,我们计算并比较每种算法所需的卡车移动距离。结果如图6所示。可以看出,“OOR”计算出的路径规划方案距离最短,因为其为最优解。“SR‐15”始终优于“CKCC”。平均结果和计算时间如表I所示。“SR‐15”的距离约为“OOR”的2.5倍,但仍明显优于“CKCC”。这表明基于人工智能的方法优于手工设计的启发式方法。我们注意到,更多的站点数量能够带来更好的性能。如表I所示,当站点数量从10增加到15时,平均距离从134.76减少到130.98。然而,更多的站点数量也意味着需要更长的时间来准备训练数据。在计算时间方面,两种启发式方法均远快于精确方法。具体而言,“SR‐15”比“OOR”快约400倍。可以预见,随着站点数量的增加,这种差异将进一步扩大,因为“SR‐15”的计算时间线性增长,而“OOR”的计算时间指数增长。

方法 距离(公里) 计算时间(秒)
OOR 51.30 47.93
CKCC 188.23 0.3573
SR‐15 130.98 0.1161
SR‐10 134.76 0.093
SR‐随机 134.20 0.096

表I. 平均移动距离和计算时间。

结论

本文提出了一种实用的端到端系统,用于解决大规模自行车共享系统中的重新平衡问题。我们首先使用细粒度预测模型来预测未来需求,并计算重新平衡区间。接着,利用神经网络从过去的、小规模的路径规划结果中学习,并将其应用于大规模问题。我们还设计了一种后处理算法,将预测序列转换为可行解。在真实世界数据集上的评估结果显示,我们的方法优于其他基线方法,并提升了用户体验。

尽管我们的模型是在较少数量的站点上进行训练却能适用于大规模系统,这看似违反直觉。部分原因在于我们在同一个自行车共享系统(但不同日期)上进行模型的训练与测试。因此,这一限制使得模型容易受到环境变化或用户模式变化的影响。对于未来的工作,我们希望利用迁移学习技术,以便我们可以在一个地方训练模型,并将其应用于不同地区。

相关推荐

2、共享单车系统网络再平衡与传感器个人活动识别研究

本文研究了共享单车系统网络再平衡与传感器基于个人活动识别两大主题。在共享单车方面,通过对智利圣地亚哥、阿根廷布宜诺斯艾利斯、法国巴黎和英国伦敦的案例分析,验证了优化模型在不同城市站点分布和库存配置下的有效性,并探讨了成本函数与站点布局的关系;未来方向包括整合用户行为、车辆路由优化及大规模实例评估。在个人活动识别方面,分析了基于可穿戴传感器的PAR技术,比较了传统机器学习与现代深度学习方法(如LSTM、CNN-LSTM)的性能差异,强调了多传感器融合与实时反馈的重要性,并提出了向个性化模型和跨设备兼容性发展的

yhn45678901的博客 41

计算机毕业设计hadoop+spark+hive共享单车可视化 共享单车数据分析 共享单车爬虫 共享单车大数据 大数据毕业设计 大数据毕设

计算机毕业设计hadoop+spark+hive共享单车可视化 共享单车数据分析 共享单车爬虫 共享单车大数据 大数据毕业设计 大数据毕设

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 1882

52、共享单车系统平衡与多居民活动识别技术解析

本文探讨了共享单车系统(BSS)的平衡优化与多居民活动识别技术。在BSS方面,提出基于模型预测控制(MPC)的再平衡算法,通过系统动力学建模与约束优化,显著提升运行效率和收敛速度,实验显示其平衡率高达98.87%,优于传统反馈方法。在多居民活动识别领域,引入TSC-MRAR框架,利用树结构卷积网络自动生成时间特征,避免手动分割数据带来的信息损失,实现更精准的活动识别。两项技术分别在智慧出行与智能家居场景中展现出广泛应用前景,并为未来系统优化与智能服务提供技术支持。

fire9的博客 71

【优化求解】动态定价优化的共享单车系统再平衡(模型DSDRO联合优化了动态定价分配和车辆路由)【含Matlab源码 15178期】

动态定价优化的共享单车系统再平衡 完整代码,包运行;可提供讲解和运行操作视频!适合小白!

订阅付费专栏Matlab(奶茶价版)或下载付费资源,可赠送奶茶价版付费专栏指定代码1份; 149

基于LSTM的共享单车需求预测与调度策略实战

时间序列预测是深度学习在智能交通领域的典型应用,其核心价值在于从历史数据中捕捉动态变化规律。共享单车系统作为城市短途出行的关键载体,站点借还需求受天气、节假日、通勤潮汐等多因素影响,传统统计模型难以融合异构特征。循环神经网络(RNN)及其变体LSTM通过门控机制有效建模长期依赖,可学习序列中不同时段间的关联,为站点级需求预测提供可靠方案。预测结果进一步支撑运力调度,借助贪心策略或模拟退火算法优化车辆分配,降低缺车与爆仓风险。本文以公开订单数据为例,完整展示了特征工程、LSTM模型训练、调度模拟与代码工程化组

weixin_29053695的博客 334

机器人视觉实战:用OpenCV搞定手眼标定(附完整C++代码)

本文详细介绍了使用OpenCV实现机器人视觉中的手眼标定技术,包括核心算法、工业场景优化及完整C++代码示例。通过解析坐标系转换问题,提供从数据采集到标定验证的全流程解决方案,帮助开发者在复杂工业环境中实现高精度机械臂与视觉系统的协同作业。

weixin_29306571的博客 484

【优化求解】基于matlab动态定价优化的共享单车系统再平衡(模型DSDRO联合优化了动态定价分配和车辆路由)【含Matlab源码 15178期】

动态定价优化的共享单车系统再平衡 完整代码,包运行;可提供讲解和运行操作视频!适合小白!

订阅付费专栏Matlab(奶茶价版),可赠送奶茶价版付费专栏指定代码1份; 173

机器人抓取(一)—— ROS MoveIt! 程序控制真实UR5机器人运动(python)

接上篇:ubuntu18.04 ros-melodic 安装 ur_robot_driver,驱动真实的 ur5 机器人 上文在 ubuntu 系统中配置了ur 机器人ros功能包 universal_robot 和驱动 Universal_Robots_ROS_Driver,并实现了用 moveit_rviz 拖动机器人运动。本文旨在学习如何使用 moveit python 用户接口moveit_commander,实现真实的ur5 机器人轨迹规划与控制。 1. ur5 机器人控制 参考:MoveIt »

zxxRobot的博客 1万+

2024美赛C题解析:共享单车需求预测与调度优化的数据建模实战

数据驱动建模是现代数据分析与运筹优化的核心方法,它通过从历史数据中提取模式来构建预测模型,并基于预测结果进行决策优化。其原理在于利用机器学习算法(如LightGBM、XGBoost)学习特征与目标变量间的复杂关系,或运用运筹学方法(如车辆路径问题VRP)求解资源分配最优解。该技术的价值在于能将业务问题转化为可量化、可求解的计算模型,从而提升决策的科学性与效率。其典型应用场景包括供应链管理、交通物流、库存控制等需要精准预测和资源调度的领域。本文以2024年美国大学生数学建模竞赛(MCM/ICM)C题——共享单

weixin_33908217的博客 412

VirusTotal API密钥获取与Python实战:从注册到自动化威胁分析

在网络安全和自动化运维领域,API(应用程序编程接口)是实现系统间数据交互与功能集成的核心技术。其工作原理是通过预定义的协议和端点,允许程序化访问特定服务的数据与功能。对于安全工程师和威胁分析师而言,API的价值在于能够将手动、重复的安全操作(如文件扫描、情报查询)转化为自动化工作流,从而极大提升威胁检测与响应的效率。一个典型的应用场景是集成第三方威胁情报平台,以实现对可疑文件、URL或哈希值的批量与实时分析。本文聚焦于全球知名的威胁情报服务VirusTotal,详细解析其API密钥的注册流程、安全配置要点

weixin_28707739的博客 424

【Oracle数据库】Oracle11g数据库下载与安装教程(超详细安装图解)

Oracle11g是Oracle公司出的一个比较轻量版的数据库,这里重点说一下在window系统上如何安装Oracle11g, Oracle11g是很早之前的安装包,win7 系统安装时不会遇到环境不满足最低要求的提示,win11系统安装时会提醒环境不满足,修改配置文件即可(注意:先安装oracle服务端/oracle客户端,再安装第三方工具(PL/ SQL Developer,DBeaver等)服务器端环境概述:ORACLE数据库版本:Oracle 11g 64位(11.2.0)

qq_34463511的博客 1万+

【优化调度】遗传算法的共享自行车混合调度优化系统实现运营商调度与用户众包激励调度相结合的混合模型(目标函数总成本)【含Matlab源码 15588期】

遗传算法的共享自行车混合调度优化系统实现运营商调度与用户众包激励调度相结合的混合模型 完整代码,包运行;可提供讲解和运行操作视频!适合小白!

订阅付费专栏Matlab(奶茶价版),可赠送奶茶价版付费专栏指定代码1份; 50

华为OD机考双机位C卷 - 斗地主之顺子 (Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 斗地主之顺子(OD上机考试双机位C卷)。提供在线OJ刷题。Java、C++、Python、GO语言、C语言、JavaScript题解,并提供完整思路讲解。

算法大师! 9695

[论]Bike Flow Prediction with Multi-Graph Convolutional Networks基于多图卷积网络的自行车流量预测

2018年第26届ACM空间地理信息系统进展国际会议论文集 论文链接:见这里 作者: Di Chai, Leye Wang, Qiang Yang 出版:ACM 关键字:多卷积GCN,自行车流量预测管理自行车共享系统的一个基本问题是自行车流量预测。由于单站流量预测的困难,最近的研究经常在集群水平上预测流量。但是,它们不能直接指导站点级别的细粒度系统管理问题。在本文中,我们回顾了车站级自行车流量预测的问题,旨在利用深度学习技术的突破来提高预测精度。我们提出了一个多图卷积神经网络模型来预测站点级别的流量,其中的

panbaoran913的博客 1442

Python爬虫实战:利用Scrapy+Playwright高效爬取TED演讲数据

在当今信息爆炸的时代,TED演讲作为全球知名的思想传播平台,汇聚了各领域顶尖人才的精彩分享。对于数据分析师、研究人员或内容创作者来说,获取TED演讲的完整数据集具有重要价值。本文将详细介绍如何使用Python中最先进的爬虫技术组合——Scrapy框架配合Playwright浏览器自动化工具,高效爬取TED演讲的完整数据。传统爬虫技术在处理现代动态网页时面临诸多挑战,而本文将展示如何利用最新工具解决这些问题。

2201_76125261的博客 207

T型三电平逆变器中点电位平衡详解

T型三电平逆变器(T-type Three-Level Inverter)是一种高效的多电平拓扑,相比传统NPC(Neutral Point Clamped)三电平逆变器,具有更低的开关损耗、更高效率和更简单的结构,尤其适用于中功率应用(如光伏逆变器、风电变换器和工业驱动)。(T-type Three-Level Inverter)中的应用已成为当前中高压功率变换领域(如光伏逆变器、储能PCS、电动汽车充电桩、风电并网和工业驱动)的热门方案。针对 T型逆变器,类似 NPC 的零序注入法适用。

专注于前沿技术的探索与实践,热衷于从代码逻辑、架构设计到行业应用等多维度深挖技术本质。期待在技术之路上与你共同成长~ 550

数学建模竞赛实战:从数据预处理到优化求解的完整框架解析

数学建模是将现实世界复杂问题转化为可计算数学模型的过程,其核心在于通过数学语言描述系统行为并寻求最优解。建模通常遵循从数据出发、构建模型、求解验证的逻辑链条,涉及数据预处理、特征工程、算法选型与优化求解等关键技术环节。在工程实践中,数学建模的价值在于为决策提供量化依据,广泛应用于资源调度、需求预测、路径规划等场景,例如共享单车再平衡、物流配送优化等问题。本文以2024年美赛B题为案例,深入剖析了**数据驱动建模**的全流程,重点阐述了如何通过**时空聚类**与分层优化框架,将复杂的车辆路径问题分解为可求解的

weixin_34101784的博客 325

让 Claude Code 接管 SAP 事务流, 用 Python 和 SAP GUI Scripting 做一个真正能干活的 AI Agent

摘要:SAP系统自动化面临的核心瓶颈在于繁琐的GUI操作而非分析能力不足。通过整合Claude AI、Python和SAP GUI Scripting技术,可构建能直接操作SAP界面的智能代理。该方案利用SAP官方提供的脚本接口,实现事务码执行、界面导航、数据提取等自动化操作,特别适用于DMLT过账引擎等复杂错误分析场景。相比传统SQL导出方案,这种GUI级自动化能处理树控件、ALV表格等复杂界面元素,且无需额外API开发,直接在现有SAP GUI会话上工作,在保持原有权限体系的同时显著提升效率。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 325

城市交通调度闭环方案:从刷卡数据到可执行指令

城市交通调度本质上是时空资源动态再平衡问题,其核心在于将原始出行行为数据转化为可解释、可执行、可验证的调度决策。本文基于真实建模赛事案例,系统阐释如何通过统计规律建模替代黑箱预测,以净流出量、潮汐强度、用户粘性系数等业务驱动型指标构建调度逻辑,并依托Python轻量化技术栈(Pandas/NumPy/Flask)实现从IC卡刷卡记录清洗、时空特征提取到可视化调度指令输出的全链路闭环。方案强调规则引擎优先、人机协同干预与地理-时间-行为三重坐标系对齐,适用于共享单车调度、小程序后台开发及多源交通协同优化等工程

weixin_29061531的博客 325

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Drive.ai无人驾驶叫车服务:从技术演示到商业运营的临界点

自动驾驶技术通过深度学习、传感器融合等核心技术,实现了从感知、决策到控制的闭环。其技术价值在于提升交通效率与安全性,通过工程化落地解决复杂场景的适应性难题。当前,以Drive.ai为代表的公司正将技术应用于商业运营,在特定地理围栏内提供无人驾驶叫车服务,这标志着自动驾驶从路测迈向真实商业场景的关键一步。该实践融合了深度学习优先的端到端思维与地理围栏策略,为行业提供了从技术验证到用户体验闭环的可行路径。

weixin_30570101的博客 326

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

AI 在金融:重塑金融服务的智能革命

AI 在金融领域的应用,本质是通过技术创新解决传统金融的痛点 —— 效率低下、服务不均、风险难控。从 5 分钟完成贷款审批,到为 “信用白户” 提供首次信贷,从实时拦截欺诈交易,到让普通人享受专业理财服务,AI 正在重塑金融的核心功能。但技术是双刃剑,金融 AI 在提升效率的同时,也带来了数据隐私、算法偏见、监管挑战等风险。未来的发展关键在于 “平衡”—— 在创新与安全、效率与公平、技术与监管之间找到平衡点。

分享各类实战项目,提供源码与教程,供大家学习参考。 2132

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

美赛D题实战解法:数据清洗、MILP建模与韧性评估全链路

数学建模中的约束驱动型决策问题,本质是将现实业务规则转化为可计算的优化模型。其核心原理在于以硬性约束(如容量、时效、预算)为边界,在不确定性下生成可执行方案,技术价值体现在可解释性、鲁棒性与工程落地性三者的平衡。典型应用场景包括供应链库存协同、应急资源调度、多级物流网络优化等,尤其依赖高质量数据预处理、模块化建模框架与面向决策的成果表达。本文聚焦2024年美赛D题‘全球供应链韧性评估’,深入解析数据清洗中的单位转换与业务校验、混合整数线性规划(MILP)建模的约束设计与求解策略,并结合蒙特卡洛模拟实现韧性量

weixin_33324197的博客 302

深地防御战略:应对未来生存威胁的关键路径研究报告

地表机器人作战 + 地下人类指挥” 的分离体系:地表部署无人装备集群执行作战任务,地下网络保障指挥中枢、人员与物资的安全存续,实现 “以生存优势转化为作战优势”。管道网络呈立体分层布局,横向覆盖城市及区域间连接,纵向延伸至不同深度功能区(如生存保障层、交通枢纽层、能源储备层),解决地表空间立体化发展与平面交通的矛盾。本研究提出的地下战略体系,通过“技术创新 + 系统集成”,为应对核威胁、小行星撞击等生存危机提供了可行方案。“安全盾牌”,也是开启深地文明的 “钥匙”,具有深远的军事、科技与文明传承意义。

人机与认知实验室 310

MathorCup数学建模竞赛:从破题到论文的实战指南与资源全攻略

数学建模是运用数学语言和方法,通过抽象、简化建立模型,以解决实际问题的过程。其核心原理在于将复杂现象转化为可量化、可计算的数学结构,并通过算法进行求解与分析。这一技术价值在于为决策提供科学依据,优化资源配置,并揭示数据背后的规律。在工程实践和学术研究中,数学建模广泛应用于运筹优化、数据分析、预测评估等场景。本文聚焦于数学建模竞赛这一典型应用,深入探讨了如何高效检索和利用学术文献与开源代码资源,构建了从问题分析、模型选择到团队协作与论文撰写的完整实战框架,旨在帮助参赛者在有限时间内系统性地提升建模效率与成果质

weixin_29055699的博客 315
上一篇: 13、容器数据存储的实现与管理
下一篇: 81、图域中的大样本统计
gitlab7runner
博客等级 码龄4年 78粉丝 1747原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值