扒开大模型外衣:手搓一个Qwen3

在 ChatGPT中 使用 MCP【chrome浏览器中】 本文介绍了如何在Chrome浏览器中通过安装MCP SuperAssistant插件、配置本地代理服务器及设置JSON参数文件,实现ChatGPT与Notion、Gmail等外部服务的集成调用功能。 阅读详情

阿里千问团队发布最新Qwen3大语言模型,旗舰模型在多项基准测试中表现优异。本文详细解析Qwen3模型架构,包括输入处理、Transformer块、GQA注意力机制、前馈网络和RMSNorm归一化,并提供完整PyTorch代码实现,帮助开发者从零理解并构建大模型,适合初学者和进阶开发者收藏学习。


引言

2025年4月29号,阿里千问团队发表了Qwen3模型,这是 Qwen 系列大型语言模型的最新成员。他们的旗舰模型 Qwen3-235B-A22B 在代码、数学、通用能力等基准测试中,与 DeepSeek-R1、o1、o3-mini、Grok-3 和 Gemini-2.5-Pro 等顶级模型相比,表现出极具竞争力的结果。此外,小型 MoE 模型 Qwen3-30B-A3B 的激活参数数量是 QwQ-32B 的 10%,表现更胜一筹,甚至像 Qwen3-4B 这样的小模型也能匹敌 Qwen2.5-72B-Instruct 的性能。

Qwen3模型结构

1、输入处理:输入的文本首先被转换为token ID序列,通过嵌入层将token转换为向量表示。

2、核心Transformer块:Qwen3由多个相同的Transformer块堆叠而成,每个块包含以下组件:

3、自注意力机制:使用多头自注意力机制,能够捕捉输入序列中各个token之间的关系。

4、归一化层:采用RMSNorm替代LayerNorm,在每个自注意力层和前馈网络之后进行归一化处理。

5、前馈网络:使用GEGLU或SwiGLU激活函数,增强模型的表达能力。

输出层:通过RMSNorm后,使用QWenLMHead生成下一个token的预测概率分布。

模型结构如下图所示:

整体实现

根据上面的五个组成部分,我们分别来进行一个实现。

1、数据输入处理,通过加载tokenizer,将输入的input text转为token_ids

device = torch.device("gpu")   # 这里根据实际情况选择,可以是cpu,也可以是gpu

接下来我们进行第二步,Qwen3网络结构整体编码。

2、Qwen3网络结构编码

classQwen3Model(nn.Module):

这部分代码就是整个Qwen3 核心所在:

第一步:完成了了input text 到token ids的过程;

第二步(看结构图): Token embedding layer ,通过nn.embedding将token ids 转为embedding

第三步(看图,红色块): Transfomer Block,通过trf_blocks封装包含RMSNorm、GQA、FFN

第四步:Final RMSNorm , 对应代码中的 self.final_norm(x)

最后:Linear output layer, 对应 self.out_head

3、Transformer Block 编码

classTransformerBlock(nn.Module):

这部分代码是Transformer Block核心(看途中红色或蓝色框):

第一步: self.norm1(x) 参数归一化,后面紧跟着GQA

第二步:GQA,GQA是什么结构,可以参考下图

第三步:shortcut connnection

第四步: self.norm2(x)

第五步:self.ff(x)

第六步:shortcut connnection

4、GQA的编码

很多模型都会在这个基础去创新,比如最开始的MHA–>GQA–>MQA–>MLA,通过上图可以看到GQA核心是将KV进行分组,多个Q给到分组的KV(核心参数:num_kv_groups),从而减少计算和内存开销。

classGroupedQueryAttention(nn.Module):

这里整个代码就是GQA的实现逻辑,核心还是QKV分组、维度对齐、计算的过程。接下来我们看看FFN

5、FFN实现

classFeedForward(nn.Module):

FFN实现相对简单,一个多层感知机,通过三个线性层以及激活函数完成,

6、RMSNorm归一化

归一化是为了让参数在某一个范围内,以致模型训练过程比较稳定

classRMSNorm(nn.Module):

具体公式可参考:

整体的一个Qwen3的网络结构代码完成了,至于更深层次的一些隐藏原理和训练过程,后续可以一起探讨。

零基础如何高效学习大模型?

为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

在这里插入图片描述

【大模型全套视频教程】

教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。

从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。

同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
在这里插入图片描述

深耕 AI 领域技术专家带你快速入门大模型

跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

在这里插入图片描述

【精选AI大模型权威PDF书籍/教程】

精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
在这里插入图片描述

【AI 大模型面试题 】

除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。

【大厂 AI 岗位面经分享(92份)】
图片

【AI 大模型面试真题(102 道)】

图片

【LLMs 面试真题(97 道)】

图片

【640套 AI 大模型行业研究报告】

在这里插入图片描述

【AI大模型完整版学习路线图(2025版)】

明确学习方向,2025年 AI 要学什么,这一张图就够了!
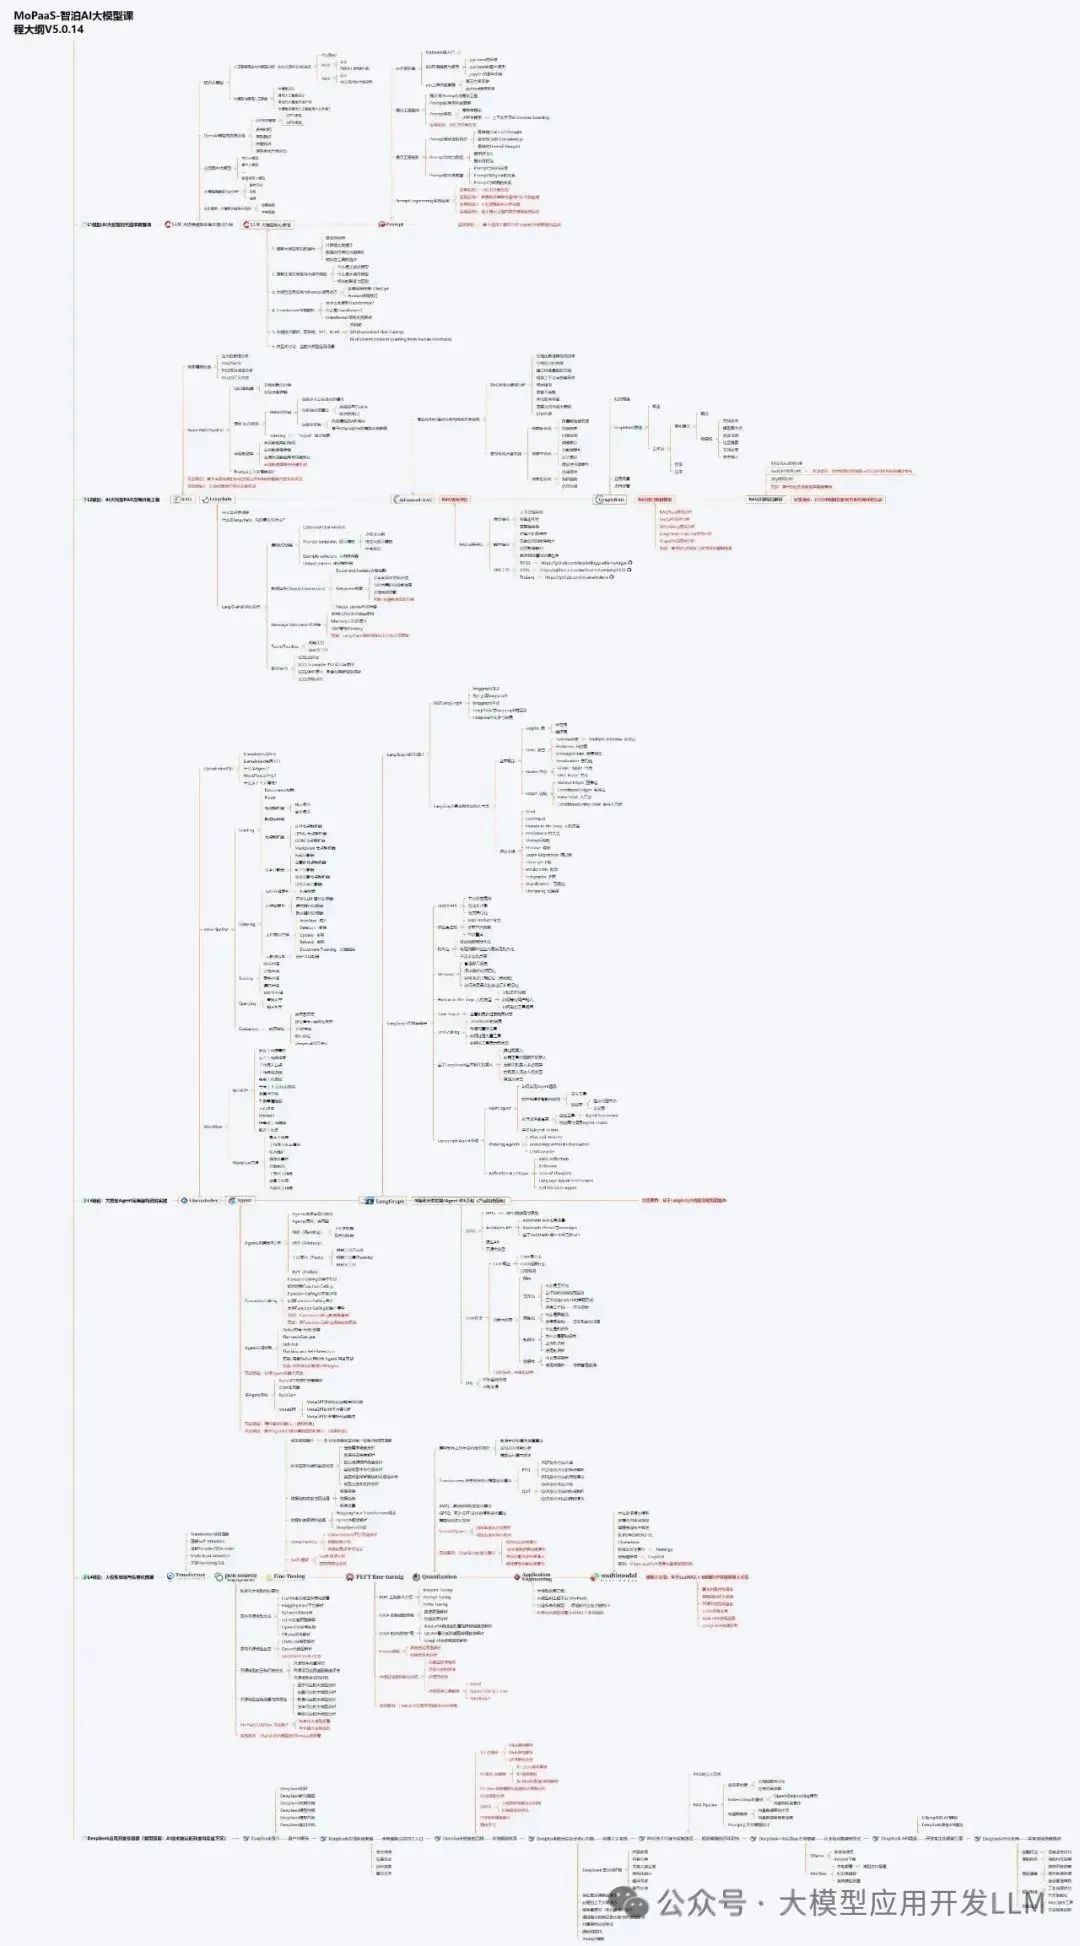
img

👇👇点击下方卡片链接免费领取全部内容👇👇

在这里插入图片描述

抓住AI浪潮,重塑职业未来!

科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。

行业趋势洞察:

  • 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
  • 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
  • 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。

与其观望,不如行动!

面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
在这里插入图片描述

01 为什么分享这份学习资料?

当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。

因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!

我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。

*02 这份资料的价值在哪里?*

专业背书,系统构建:

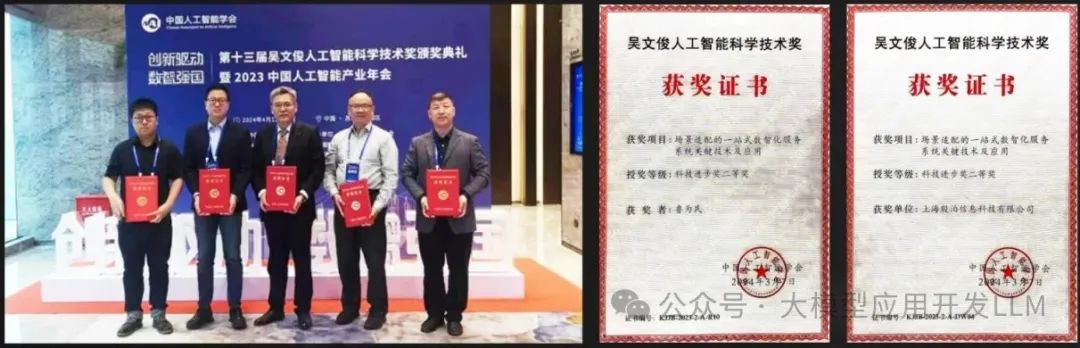
  • 本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:

    • 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
    • 拥有多项中美发明专利。
    • 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
  • 目前,我有幸与鲁博士共同进行人工智能相关研究。

在这里插入图片描述

内容实用,循序渐进:

  • 资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。

  • 包含丰富的视频教程与实战项目案例,强调动手实践能力。

  • 无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
    在这里插入图片描述在这里插入图片描述在这里插入图片描述

抓住机遇,开启你的AI学习之旅!

在这里插入图片描述

探索CherryStudio:解锁AI多模型服务新境界 在当今数字化时代,AI 技术已成为推动各行业发展的核心驱动力。从智能语音助手到图像识别系统,从自动化流程到智能决策支持,AI 的应用无处不在,深刻地改变着我们的工作和生活方式。随着技术的不断进步,各种 AI 工具如雨后春笋般涌现,为我们提供了更高效、更智能的解决方案。在众多 AI 工具中,CherryStudio 脱颖而出,它以其强大的功能和卓越的性能,成为了众多专业人士和普通用户的得力助手。CherryStudio 不仅支持多种主流的大型语言模型,还具备丰富的 AI 助手和实用工具,能够满足不同用户在不同 阅读详情

相关推荐

Cherry studio搭建deep seek 知识库

cherry studio deep seek

weixin_74996259的博客 6627

真心建议每一个人去安装CherryStudio,大有用处!(附配置教程)

大家好!今天要安利一个普通人也能秒上手的AI最强客户端——CherryStudio!该客户是一款多功能的AI桌面助手,内置多行业功能,覆盖编程、设计等功能。说实话,我真的非常喜欢这个界面,十分的简洁易用,还可以快速的切换不同的模型,也可以实现对话的记录保存、知识库分类等。

2502_91140257的博客 3万+

OpenPnP/Arduino - 二手西门子电动飞达的通讯协议解析与实战

本文详细解析了二手西门子电动飞达的通讯协议,并通过Arduino控制板实现与开源贴片平台OpenPnP的集成。文章涵盖了硬件接口定义、协议帧结构分析、Arduino控制实战、OpenPnP集成技巧以及二手飞达翻新指南,为开发者提供了全面的技术指导和实战经验。

weixin_30411819的博客 201

Cherry Studio搭建本地知识库,让DeepSeek R1发挥最大实力,彻底告别硬件限制!

今天我们——借助硅基流动的 API 接口,让你轻松接入DeepSeek R1模型,体验满血复活版R1的强大功能。今天给大家介绍一个新的工具,Cherry Studio,一款聚合主流大语言模型服务的桌面工具。它通过直观的可视化界面和远程API接口,实现了跨平台调用各类模型,既降低了对本地硬件的依赖,又大幅提升了使用效率,为大家搭建高效知识库提供了全新思路。打开Cherry官网:https://cherry-ai.com/download选择适配自己操作系统的版本进行下载。

m0_59164304的博客 5万+

详细了解sklearn中的CountVectorizer

CountVectorizer 是 scikit-learn(一个流行的 Python 机器学习库)中的一个文本特征提取类,其核心功能是将一系列原始文本(如句子、文档)转换为基于词频(word count)的数值矩阵。它基于词袋模型(Bag of Words, BoW)思想,忽略文本的语法结构和词序,仅关注词汇在文本中出现的频率,从而将文本转化为机器可理解的数字形式。文本 1:"I love machine learning"

2302_76568160的博客 1119

手把手教你用Arduino IDE玩转ESP32-S3-wroom(附串口调试技巧)

本文详细介绍了如何在Arduino IDE环境下配置和使用ESP32-S3-WROOM模块,包括开发环境搭建、硬件连接、程序烧录及高级调试技巧。通过实战步骤和常见问题解决方案,帮助开发者快速上手这一高性能Wi-Fi/蓝牙双模模组,提升物联网开发效率。

weixin_30487201的博客 292

【必收藏】深度解析阿里Qwen3模型:扒开大模型外衣,手搓一个Qwen3

本文详细介绍了阿里千问团队最新发布的Qwen3大型语言模型的结构与实现。文章从模型架构入手,解析了输入处理、Transformer块、自注意力机制、归一化层和前馈网络等核心组件,并提供了完整的Python代码实现,包括Qwen3Model、TransformerBlock、GroupedQueryAttention等关键模块的实现细节。文章不仅适合了解Qwen3的技术特点,也为大模型开发者提供了可参考的实现框架。

2401_85325557的博客 1281

HX720数据采集实战:从硬件连接到姿态解析(含避坑指南)

本文详细介绍了HX720高精度ADC芯片在数据采集与姿态解析项目中的实战应用。内容涵盖从硬件电路设计、驱动源码编写与优化,到原始数据处理、校准以及最终姿态角度计算的完整流程,并提供了关键的避坑指南和调试技巧,帮助开发者高效完成从传感器信号到可用姿态数据的转换。

i8j9k0l1的博客 488

扒开大模型外衣:手搓一个Qwen3,大模型入门到精通,收藏这篇就足够了!

小型 MoE 模型 Qwen3-30B-A3B 的激活参数数量是 QwQ-32B 的 10%,表现更胜一筹,甚至像 Qwen3-4B 这样的小模型也能匹敌 Qwen2.5-72B-Instruct 的性能。

瓦罗兰特顶级C位的博客 1176

RH850从0搭建Autosar开发环境【3X】- Davinci Configurator之OS模块配置详解(中)

RH850从0搭建Autosar开发环境【3X】- Davinci Configurator之OS模块配置详解(中)

weixin_42412049的博客 1515

如何在MacBook上安装部署原生openclaw

本文介绍了在MacBook上安装OpenClaw的详细步骤:首先通过curl或国内镜像源安装nvm和Node.js(版本≥22),然后使用nvm安装Node.js 24并验证安装。接着通过脚本快速安装OpenClaw,完成安装后选择Qwen作为AI模型并进行OAuth认证。配置过程中可跳过联网搜索和Agent技能设置,最后选择Web界面作为呈现方式。安装完成后,系统会启动openclaw-gateway进程并打开Web界面,用户可通过简单的"hello"指令开始与AI对话。目前基础功能已

木简熙的博客 810

【AI大模型实战】扒开大模型外衣:手搓一个Qwen3,全程干货,小白也能轻松学会!!

阿里Qwen3是最新大型语言模型系列,包含旗舰模型和小型MoE模型。文章详细解析其模型结构,包括输入处理、Transformer块、自注意力机制、RMSNorm归一化和前馈网络,并提供完整PyTorch代码实现。通过Qwen3Model、TransformerBlock、GroupedQueryAttention等核心组件的代码展示,帮助开发者理解如何构建高效大语言模型,特别是GQA的创新应用。

2401_85325557的博客 723

【C语言】初识C语言(上篇)

初识C语言第一部分

StackFrame 4014

Qwen3-VL-30B深度评测:为什么它是当前最强的中文多模态大模型?

Qwen3-VL-30B凭借300亿参数与稀疏激活技术,在中文多模态理解、图文推理与本地化应用上实现突破,支持私有化部署,适用于财报分析、医疗辅助、AI Agent等高价值场景,是当前最强的中文视觉语言模型。

weixin_29867767的博客 824

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

Qwen3-VL遗嘱公证辅助:书写笔迹图像真伪鉴定

借助Qwen3-VL多模态大模型,实现手写遗嘱的笔迹真伪智能辅助判断。系统融合视觉感知与语义推理,可识别签名描摹、文本拼接及书写不一致等异常,支持本地部署与快速筛查,在提升鉴定效率的同时保障隐私与司法公正。

weixin_42372837的博客 612

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

本地跑大模型的显存计算指南:从Qwen3.5到72B的硬件决策逻辑

大语言模型本地部署的本质是显存资源管理,而非单纯追求高参数或顶配硬件。其核心原理在于:模型权重经量化压缩后仅占静态空间,真实推理需叠加KV缓存、中间激活值与框架开销,形成动态显存需求;而显存带宽与容量的比值,直接决定数据吞吐效率。这一技术逻辑使Qwen3.5等主流模型在不同量化级别(如Q4_K_M)下,可在16GB至48GB显存平台实现从边缘设备到AI工作站的四级跃迁。典型应用场景包括CPU直推轻量任务、单卡16G日常编程辅助、双卡协同运行27B高质量模型,以及48G+专业卡支撑72B长文本与多模态处理。理

weixin_33525298的博客 552

Qwen3-VL:30B模型微调实战:定制专属飞书智能助手

本文介绍了如何在星图GPU平台上,自动化部署“星图平台快速搭建 Clawdbot:私有化本地 Qwen3-VL:30B 并接入飞书(上篇)”镜像,以微调Qwen3-VL:30B多模态大模型。通过该平台,企业可快速构建私有化智能助手,并将其接入飞书,实现诸如自动识别产品图片并生成详细描述等核心业务场景的应用。

weixin_35982453的博客 301

Qwen3-32B 模型 API 接口封装与服务化部署

本文详细介绍如何将Qwen3-32B大模型封装为API并实现生产级服务化部署,涵盖FastAPI接口开发、Docker容器化、Kubernetes编排、显存优化与高并发应对策略,适用于对数据安全和长上下文处理有高要求的企业AI应用。

weixin_33557333的博客 654

【手搓 AI Agent 从 0 到 1】第二课:一句话让 AI 变身任何角色

摘要: 本文讲解如何通过系统提示词(System Prompt)控制AI模型的行为风格,使其扮演不同角色。核心原理是利用messages参数传递角色设定(system角色)和用户问题(user角色),同一模型可切换为编程老师、通俗讲解员或极简回答者等模式。文章提供Python代码示例,展示三种角色对同一问题的差异化回复,并总结4种System Prompt设计模式。配套资源包含10种预设角色模板和进阶调试技巧,帮助开发者快速构建多角色AI助手。(149字) 关键词: 系统提示词、角色切换、AI行为控制、Ol

weixin_37688407的博客 707

Qwen3-8B结合Docker部署的最佳实践

本文介绍如何结合Qwen3-8B大模型与Docker实现高效、可复用的AI服务部署。涵盖环境配置、镜像使用、FastAPI接口开发及生产架构设计,解决依赖冲突、资源隔离和横向扩展难题,助力快速落地中文大模型应用。

weixin_30674431的博客 460

开源大模型落地入门必看:Qwen3-14B支持JSON调用实战指南

本文介绍了如何在星图GPU平台上自动化部署通义千问3-14B镜像,充分发挥其原生JSON Schema调用能力,实现客服对话到结构化工单(如订单号、问题类型、解决方案)的精准提取,适用于电商售后、智能表单等需程序直解析的业务场景。

weixin_42300144的博客 192

为什么我推荐用Qwen3Guard-Gen-WEB做AI安全前置?

本文介绍了基于星图GPU平台自动化部署Qwen3Guard-Gen-WEB镜像的实践方案。该平台支持高效集成这一生成型安全判别模型,适用于AI内容安全前置审核场景,可精准识别多语言风险内容并输出可解释判定结果,助力企业快速构建合规、可信的全球化AI应用。

weixin_42502040的博客 942

开发者必看:Qwen3-14B API接口封装与调用详解

本文详解如何将Qwen3-14B大模型通过API封装,实现函数调用、数据库查询等实际业务集成。基于FastAPI构建兼容OpenAI格式的接口,支持上下文管理、工具执行与流式输出,助力企业快速落地私有化AI能力。

weixin_35972981的博客 818
上一篇: Agent三大痛点:知识库+工作流+Prompt工程
下一篇: 基于DeepSeek手搓一个Rag知识库(手把手,个人电脑也能玩哦)
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值