ollama 本地安装 embedding 模型

Ollama 下载Embedding模型并配置到Dify中(亲测) Embedding 模型的主要任务是将文本转换为数值向量表示。这些向量可以用于计算文本之间的相似度、进行信息检索和聚类分析。 阅读详情
AI摘要

本文介绍了人工智能领域中大型语言模型和嵌入模型的差异,阐述了Embedding模型将文本转换为向量的作用及应用场景。还给出了大模型知识库中Embedding模型的典型应用流程、推荐模型,以及本地安装Ollama提供的embedding模型的方法,最后分享了大模型学习资料和收获。

知识库领域的 LLM 大模型和 Embedding 大模型有区别么?为什么在 RAG 领域,需要单独设置 embedding 大模型?

在人工智能领域,大型语言模型(LLM)和嵌入模型(Embedding Model)是自然语言处理(NLP)中的两大关键技术,尤其在知识库构建和信息检索中发挥着重要作用。

尽管它们都属于 NLP 范畴,但它们在功能、应用场景和资源需求上存在显著差异。

Embedding 模型的主要任务是将文本转换为数值向量表示。这些向量可以用于计算文本之间的相似度、进行信息检索和聚类分析。

Embedding 模型的输出是数值向量。计算机在理解词句含义的时候,是不具备能力的,计算机只能看到一段 01010111 这样的结果。然而,人类看到的词句,是赋予了内部的含义,还带了大量的普世认知。

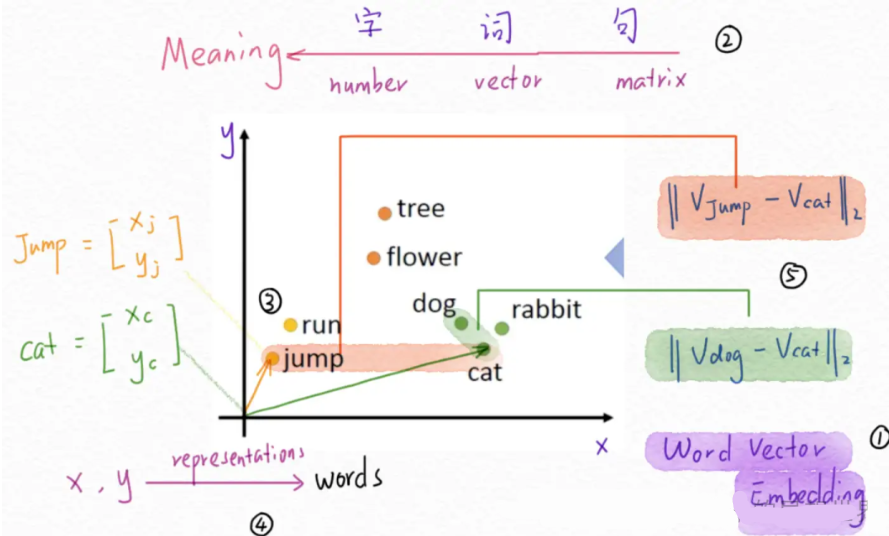
参考台大李宏毅老师的一张图,做一下说明。

当我们人类理解 猫 vs 狗 和 狗 vs 花的差异的时候,能自然的理解,觉得猫和狗是更加相近的物种;而狗和花,一个是动物,另一个是植物,偏差会更多。
在这里插入图片描述

那么,如何让计算机能理解这些词背后的含义呢。所使用的技术就是 Embedding。一句话简单说,embedding 就是把计算机无法理解的字词,转换成一个向量矩阵。

比较相似,或者含意比较接近的词向量之间的距离,是更加接近的。比如 dog 和 cat,dog 和 rabbit; 然而,flower 和 dog,就会隔得比较远。

Embedding 模型广泛应用于文本相似度计算、信息检索、聚类和推荐系统。

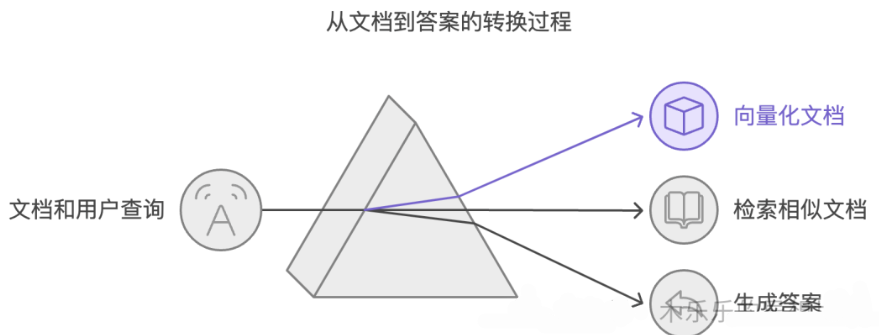
在大模型知识库领域中,单独设置 Embedding 模型可以降低系统资源占用和响应延迟,特别是在大规模知识库构建和信息检索中,可以极大程度提升经济型和效率。一般的应用包含以下几个部分:

典型应用流程
在这里插入图片描述

\1. 知识库构建阶段

  • 使用Embedding模型将文档转换为向量,存储向量到向量数据库(如FAISS、Milvus)

\2. 检索阶段

  • 用相同的Embedding模型将用户问题转换为向量,在向量数据库中快速检索相似文档

\3. 回答生成阶段

  • 将检索到的相关文档作为上下文,使用LLM生成最终答案

推荐的Embedding模型

Crew.ai 官方组件支持的 Embedding 模型有:

  • openai:OpenAI 的嵌入模型
  • google:Google 的文本嵌入模型
  • azure:Azure OpenAI 嵌入
  • ollama:使用 Ollama 进行局部嵌入
  • vertexai:Google Cloud VertexAI 嵌入
  • cohere:Cohere 的嵌入模型
  • 基岩版:AWS Bedrock 嵌入
  • huggingface: Hugging Face 模特
  • watson:IBM Watson 嵌入

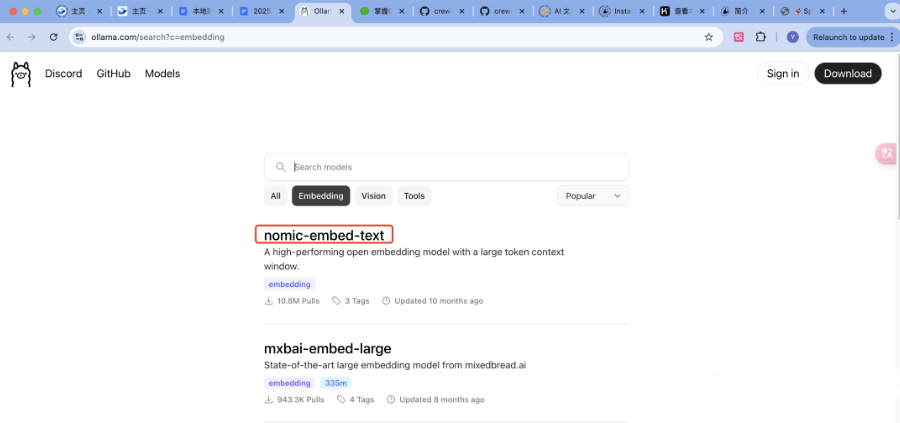
接下来,我们看一下如何在本地安装 Ollama 提供的 embedding 模型。本案例选用的是 nomic-embed-text。

项目参考链接:https://ollama.com/search?c=embedding
在这里插入图片描述

先激活对应的工作环境。

source crewai-env/bin/activate

每次开始新的终端会话时,都需要重新激活虚拟环境。如果您看到命令提示符前面有 (crewai) 这样的标识,说明环境已经正确激活。
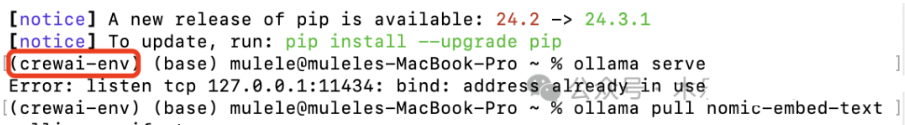
在这里插入图片描述

安装依赖

pip install crewai ollama

看到这个代表已经激活
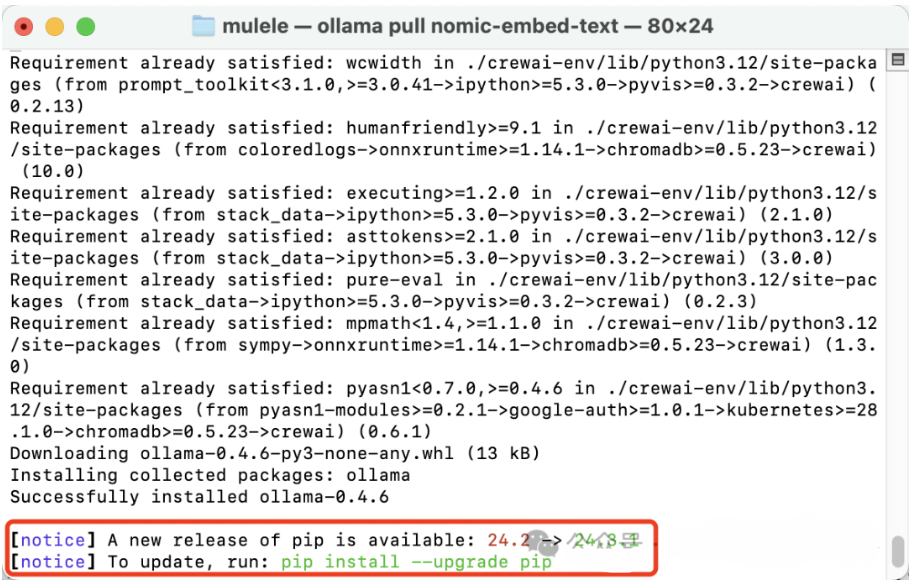
在这里插入图片描述

启动 ollama

ollama serve

安装 embedding 模型

ollama pull nomic-embed-text

因为要配置给其他的服务用,所以需要解决 Ollama 的 embedding host获取问题。

要获取 Ollama 的 embedding host,有以下几种方法:

默认地址:

Ollama 默认运行在 http://localhost:11434。如果您是在本地机器上安装的 Ollama,通常不需要更改这个地址。

如果不确定是否这个端口,验证 Ollama 服务是否运行及其地址,可以按照这个方法执行。

# 检查 Ollama 服务状态curl http://localhost:11434/api/version
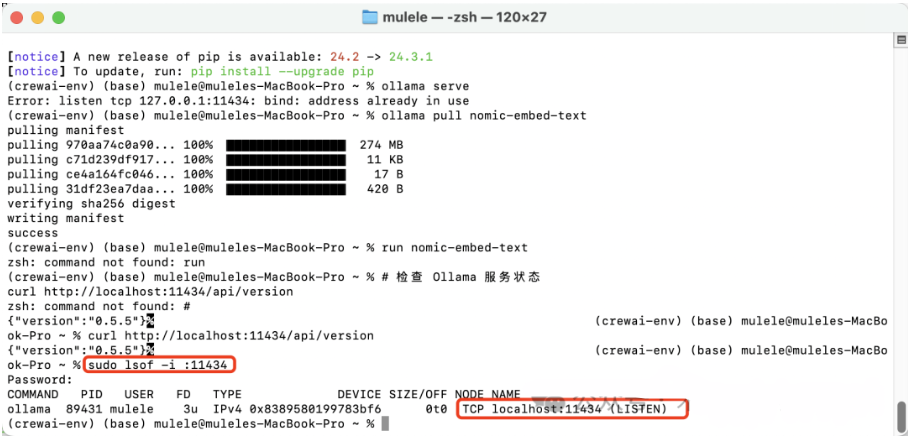
在这里插入图片描述

看到 11434 的监听结果,说明这个端口就是 ollama 的embedding 模型开放的端口。

到这一步,就代表着 ollama 的embedding 模型已经安装成功。可以对接给其他的应用和服务了。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍!

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

四、AI大模型各大场景实战案例

在这里插入图片描述

五、AI大模型面试题库
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

探索Ollama嵌入模型:从安装到实际应用的全面指南 通过本文,您应该对Ollama嵌入模型的安装、设置和使用有了初步了解。Ollama 官方文档嵌入模型概念指南嵌入模型使用指南。 阅读详情

相关推荐

graphrag ollama在windows端上的本地部署(纯小白版)

用于新手计算机小白通过ollama在windows系统上的本地部署graphrag (不需要chatgpt的apikey,完全免费)

m0_74852598的博客 2640

Ollama 运行 Embedding 模型

Ollama 运行 Embedding 模型

engchina的专栏 1万+

GraphRAG如何使用ollama提供的llm model 和Embedding model服务构建本地知识库

在GraphRAG的使用过程中将需要踩的坑都踩了一遍(不得不吐槽下,官方代码有很多遗留问题,他们自己也承认工作重心在算法的优化而不是各种模型和框架的兼容性适配性上),经过了大量的查阅各种资料以及debug过程(Indexing的过程有点费机器),最终成功运行了GraphRAG项目。之所以要使用ollama同时提供llm和Embedding模型服务,是因为,使用超级简单,响应速度也超级快。

m0_74825285的博客 1401

使用Ollama从头构建Embedding和RAG系统

检索增强生成(RAG)赋予大型语言模型新的能力,使其能够与任何大小的文档或数据集进行互动。接下来,请跟随我一起了解如何解析和操作文档,探讨如何利用嵌入向量来描述抽象概念,实现一种简单而强大的方法,以找出文档中与特定查询最相关的部分,并最终构建一个脚本,使本地托管的大型语言模型能够处理您自己的文档。

年少的勇气已经用完,剩下的就是三思而后行 7631

langchain学习笔记——Ollama大模型本地部署

大模型本地部署、大模型网关部署、快速构建一个带有知识库的问答系统

1624

Embedding models

嵌入模型是专门训练以生成向量嵌入的模型:这些是代表给定文本序列语义含义的长数组:生成的向量嵌入数组可以存储在数据库中,该数据库会进行比较以搜索语义相似的数据。

数字人生 2056

Ollama本地安装与Embedding模型配置指南!

知识库领域的 LLM 大模型和 Embedding 大模型有区别么?为什么在 RAG 领域,需要单独设置 embedding 大模型?在人工智能领域,大型语言模型(LLM)和嵌入模型(Embedding Model)是自然语言处理(NLP)中的两大关键技术,尤其在知识库构建和信息检索中发挥着重要作用。尽管它们都属于 NLP 范畴,但它们在功能、应用场景和资源需求上存在显著差异。Embedding 模型的主要任务是将文本转换为数值向量表示。这些向量可以用于计算文本之间的相似度、进行信息检索和聚类分析。

2401_84204207的博客 1万+

RagFlow专题五、基于Ollama搭建本地RAG知识库

首先,确保你的系统已经安装了 Ollama。如果返回结果,说明 Ollama 已经可以正常运行。这样,一个本地知识库就搭建完成了。如果你想进一步扩展,我可以指导你。,让它能在 Web 上被访问!作为本地向量数据库。

xiaoqi270620903的专栏 1352

ollama 本地安装 embedding 模型_nomic-embed-text本地安装

LLM大模型与Embedding模型的区别及RAG应用 大型语言模型(LLM)和嵌入模型(Embedding)是NLP的两大核心技术,但存在显著差异: 功能差异:LLM用于文本生成和理解,Embedding模型专注于将文本转换为数值向量表示 应用场景:Embedding模型适用于文本相似度计算、信息检索和聚类分析 资源效率:在RAG(检索增强生成)架构中,单独设置Embedding模型可降低资源占用和响应延迟 典型RAG流程: 知识库构建阶段:用Embedding模型将文档转换为向量存储 检索阶段:将用户问

2401_85373396的博客 1388

VMware + ubuntu20.04 + qemu安装

遇到报错可参考:(从ubuntu裸系统开始安装)

NosONE 3230

(Linux)DHCP 超级作用域和中继代理(超难受做了超久)

DHCP服务器在192.168.159.0 可以实现分配IP的功能,现在要跨网段分配IP 就需要用到DHCP中继代理。中继代理有两张网卡分别eth0:IP 192.168.159.2 ;eth1: IP:192.168.200.2 。现在要实现192.168.200.0网段的客户机可以获取DHCP服务器的IP。中继代理其实是相当于一个路由器的作用 DHCP服务器的IP地址 :192.168.159...

DJ_joker的博客 2225

如何使用Ollama本地部署模型?

这章将从零介绍如何使用我们本地电脑去部署一个无需使用云厂商服务的本地模型。

2603_96522157的博客 180

数据处理和分析之数据聚类:层次聚类(Hierarchical Clustering):单链接层次聚类方法

单链接层次聚类(Single-Linkage Hierarchical Clustering)是凝聚型层次聚类的一种,它基于数据点之间的最小距离来定义聚类间的相似性。在单链接层次聚类中,两个聚类之间的距离定义为这两个聚类中任意两个数据点之间的最短距离。这种聚类方法倾向于形成链状或线性的聚类,因为聚类的边界是由最远的数据点决定的,而不是聚类的平均或中心位置。单链接层次聚类通过计算簇间最近点的距离来决定簇的合并,这种方法简单直观,但可能导致簇的形状不规则,尤其是在数据点分布不均匀的情况下。

2401_87715305的博客 1443

第一步:安装ollama并运行大模型

其中 gpus 是使用gpu运行ollama,-e OLLAMA_KEEP_ALIVE=-1 是为了让大模型始终保持在内存中,不会用着用着 模型就得重新加载。这里会报错:Error: "shaw/dmeta-embedding-zh" does not support generate。将下方文档保存到 dockerYml文件夹下,名称为:docker-compose.yml。本文档所使用的FastGPT为本地开源版,没有使用docker安装。5.安装mongoDB、pg等docker命令在下面。

qq_41749069的博客 3887

零基础实战:用 Docker 和 vLLM 本地部署 bge-reranker-v2-m3 重排序模型

本文介绍了如何利用Docker容器和vLLM推理框架在本地部署BAAI开发的bge-reranker-v2-m3文本排序模型。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 5971

uniapp - 如何跟内嵌 web-view 组件内的网页交互,与 web-view 内嵌网页进行双向通信(uniapp 与 webview 网页之间的 “相互“ 传值)提供详细的示例代码及解决方案

uni-app如何实现在H5环境中与web-view中的网页交互通讯uniappuni-app 与 web-view内嵌网页 双向通信 如何跟内嵌web-view交互uniappAPP与webview子页面交互uniappAPP与webview子页面交互关于uni-app 使用 web-view 页面之间互相跳转、通信等问题uniapp的web-view嵌入网页,网页与uniapp通信webview如何与uniapp写的H5页面交互嵌套webview调用uniapp各种API组件实现H5和app通讯和交互

✅ 精选推荐文章 1万+

Spring AI 使用本地 Ollama Embeddings

通过 Ollama 的扩展方式,还可以方便我们导入官方仓库不存在的其他模型,后续文章会以。使用 OpenAI 的 Embeddings 接口是有费用的,如果想对大量文档进行测试,使用本地部署的 Embeddings 就能省去大量的费用,所以我们尝试使用本地的 Ollama Embeddings。这个模型包含几个不同的版本,默认为 7b 的版本,可以先试试 7b,如果速度太慢可以换 2b 试试,执行命令。中的参数即可使用其他模型,如果本地下载过 llama2 模型,就可以直接改这里的参数,不需要重新执行。

偶尔记一下 - mybatis.io 7799

CodeQL查询时遇到报错:A fatal error occurred: Could not process query metadata for...如何解决?

🏆本文收录于 《全栈Bug调优(实战版)》 专栏,该专栏专注于分享我在真实项目开发中遇到的各类疑难Bug及其深层成因,并系统提供高效、可复现的解决思路和实操方案。无论你是刚入行的新手开发者,还是拥有多年项目经验的资深工程师,本专栏都将为你提供一条系统化、高质量的问题排查与优化路径,助力你加速成长,攻克技术壁垒,迈向技术价值最大化与职业发展的更高峰🚀!

**My Coding Family** 1084

大模型相关学习(本地部署deepseek)

检索(Retrieval)的详细过程准备外部知识库:外部知识库可能来自本地的文件、搜索引擎结果、API 等。通过 Embedding(嵌入)模型,对知识文件进行解析:Embedding 的主要作用是将自然语言转化为机器理解的高维向量,并且通过这一过程捕获到文本背后的语义信息(比如不同文本之间的相似关系)。通过 Embedding(嵌入)模型,对用户的提问进行处理:用户的输入同样会经过嵌入(Embedding)处理,生成一个高维向量。拿用户的提问去匹配本地知识库。

qq_64376339的博客 1248

docker安装部署openclaw详细教程(安装、卸载、问题处理)

摘要: 本文详细介绍了使用Docker部署OpenClaw本地AI智能体框架的全流程,包括代码下载、容器化安装、交互式配置及Token设置。Docker方案解决了环境配置复杂、依赖冲突等痛点,提供开箱即用的隔离环境。教程涵盖常见错误(如EACCES权限问题、网关启动失败、设备配对需求)的解决方案,并提供了完整的卸载指南。通过Docker部署,用户可快速构建安全、一致的AI智能体开发环境,实现大模型与本地工具的高效连接。

少说,多做 4004

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

从零开始用 Ollama 本地跑大模型、Embedding 与 Rerank

这篇文章介绍了如何利用Ollama在本地运行大模型、Embedding和Rerank,适合企业知识库、内部问答等需要数据不出内网的RAG项目。文章首先区分了LLM、Embedding和Rerank三种模型的不同作用,详细说明了Ollama的安装方法和基础命令,并推荐从qwen3系列开始体验本地大模型。重点讲解了Embedding模型在RAG中的关键作用及其下载方法,包括qwen3-embedding和nomic-embed-text等选择。文章特别强调了初学者容易混淆的概念和常见误区,为想要实现本地AI应用

像风一样自由的博客 3246

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: AI大模型标注:你看不上的数据标注正在成为高薪工作
下一篇: 一书速通LLM《从头开始构建大型语言模型》免费pdf分享
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值