【必学】从零开始学LoRA:大模型微调成本暴降99%的原理

告别 RPA 和 Selenium,MCP + Playwright 成为自动化开发新宠! 摘要: 随着数字化转型加速,传统自动化工具(如RPA和Selenium)在复杂场景中暴露出开发成本高、灵活性不足等问题。新一代解决方案MCP(Model Context Protocol)与Playwright的结合,通过AI与自动化的无缝对接,实现了智能化的任务处理。MCP支持自然语言交互和上下文感知,开发者无需编写复杂代码即可生成自动化脚本;Playwright则提供多浏览器支持、高性能和易用性。二者结合显著提升开发效率,使自动化更智能、灵活。文章还对比了VS Code与Trae中配置Playwrigh 阅读详情

大模型微调太贵?LoRA技术帮你降低99%成本,一篇搞定,建议收藏

本文介绍LoRA技术如何通过低秩分解原理解决传统大模型微调高成本问题。LoRA冻结原始模型,只训练两个小矩阵近似权重变化,将微调成本降低99%。其三大创新包括梯度流动"开关设计"(降显存80%)、缩放因子α(配置公平对比)和即插即拔"乐高积木"设计(降部署成本90%),使企业能以低成本、高灵活方式定制大模型应用。


本文介绍传统大模型微调的高成本问题,以及LoRA技术如何通过低秩分解原理大幅降低微调成本。LoRA冻结原始模型,只训练两个小矩阵近似表示权重变化,降低显存占用和计算量。其三大技术创新包括梯度流动"开关设计"、缩放因子α和即插即拔"乐高积木"设计,使微调成本降低99%,部署更灵活,为企业节省大量资源。

(1)传统微调为什么让90%的团队直接放弃?

某创业公司想微调70B模型做客服,一算账直接懵了:

  • 存储成本:每个任务存一份完整模型,280GB × 10个任务 = 2.8TB
  • 训练成本:8张A100跑一周,2万美元起步
  • 部署噩梦:切换任务要重新加载模型,用户等30秒

最终选择:放弃微调,直接用通用模型凑合。

(2)LoRA如何让微调成本暴降99%?

专业解释:模型微调时,权重变化矩阵通常是低秩的。

说人话:一个巨大的矩阵更新,其实可以用两个小矩阵相乘近似替代。

LoRA微调具体做法如下:

  • 冻结原模型(175B参数一个不动)
  • 只训练两个小矩阵 A 和 B(加起来几百万参数)
  • 推理时:输出 = 原权重 × 输入 + A × B × 输入

数学表达:rank r = 8时,参数量从 d×k 降到 (d+k)×8

一、LoRA的低秩分解

核心数学原理是什么?什么是低秩分解?

想象你要搬家,有一堆大箱子要搬运。传统微调就像把每个箱子里的东西全倒出来重新整理,费时费力。而LoRA的做法更聪明:它发现大部分箱子其实不需要动,只需要在上面贴几张标签就够了。

矩阵的秩是什么?

矩阵的秩(rank)是线性代数中的一个重要概念。简单来说,矩阵的秩是矩阵中线性无关的行(或列)的最大数目。假如你是一个老师,你的学生是一个团队。矩阵的秩,相当于这个团队的 “独立意见” 或 “独特技能” 的数量。

为什么低秩分解是信息的"压缩密码"?

在深度学习中,模型的每一层都是一个巨大的权重矩阵 W。比如一个典型的注意力层,W 可能是 4096×4096,包含1600万个参数。全量微调意味着要更新这1600万个数字。

但LoRA团队发现了一个惊人的事实:微调时,这个矩阵的变化量 ΔW 其实非常"规整"——用数学语言说,它是低秩的。

这样原本需要的更新:ΔW (4096×4096 = 16,777,216个参数),实际可以表示为:ΔW = A × B,其中A是4096×8的矩阵,B是8×4096的矩阵,参数总量:32,768 + 32,768 = 65,536个参数,LoRA低秩分解压缩比为256倍!

为什么微调的变化是低秩的?

(1)预训练已经打好了基础:就像一个学会了开车的人,再学开卡车,只需要掌握"方向盘更重"、"刹车距离更长"等几个关键差异,不需要重新学习什么是油门、刹车。

(2)微调任务的本质是少量调整:把通用语言模型改造成客服助手,本质上只是学会"更礼貌的表达"+“更结构化的回答”,这些改变都只用少量调整模型参数。

(3)丰富的实验数据支撑:研究人员测试了从 r=1 到 r=64 的不同秩值,发现 r=8 时就能恢复全量微调95%的效果。

这说明微调的有效信息确实集中在一个很小的子空间里。

二、LoRA的技术创新

LoRA的技术创新是什么?

光有数学原理还不够,LoRA真正的工程价值在于三个技术创新。

创新1:梯度流动的"开关设计"——显存占用降低80%

传统微调像装修房子要把所有房间重新粉刷一遍,LoRA更聪明:只在墙上挂几幅画,原墙面一点不动。

具体来说,LoRA把原始权重W₀完全冻结,只让梯度流经新增的小矩阵B和A。反向传播时,原本需要为1600万个参数存储梯度,现在只需要为6.5万个参数存储,显存占用直接降低256倍。

这带来三个直接好处:(1)显存暴降让硬件成本大幅下降,(2)计算量减少让训练速度提升数倍,(3)小矩阵更稳定不易梯度爆炸。

某创业公司的案例:原本需要8张A100(12万美元)才能训练的70B模型,用LoRA后2张就够,硬件成本省75%。

创新2:缩放因子α——让不同配置可以公平对比

LoRA在计算时会用缩放因子α除以秩r,形成最终更新量。

为什么需要这个?假设你用秩8训练效果刚好,现在想试试秩16会不会更好。

这时候问题来了:秩越大矩阵越大,同样学习率下更新力度越强,就像换了更大马力的发动机。这样不同秩的结果就没法公平对比了。α除以r就是为了归一化这个力度。

实战价值很直接:从秩8切换到秩16时不需要重新调参,不同配置的实验结果可以科学对比,小模型上的配置可以直接用到大模型。经验上α设为16或32最优。

创新3:即插即拔的"乐高积木"设计——部署成本降低90%

这是LoRA最具商业价值的特性。看一个电商公司的真实案例:

需要为10个商品类目(服装、数码、美妆等)分别定制描述生成模型。传统方案下,每个类目存一个280GB完整模型,10个类目2.8TB存储,10个GPU实例部署,月成本28000美元。

改用LoRA后,只需一个280GB共享基座模型,加10个50MB小适配器。总存储280.5GB,1个GPU实例动态加载适配器,月成本2800美元,节省90%。

响应速度也有质的飞跃:传统方案切换类目要重新加载280GB模型,用户等30秒;LoRA只需换50MB适配器,等0.5秒。

回到最初的问题:为什么大厂都在用LoRA?

因为它用一个优雅的数学原理(低秩分解),解决了三个工程痛点:

(1)成本痛点:从"百万美元起步"到"千元也能玩"

(2)部署痛点:从"一个任务一个模型"到"一个基座配万千适配器"

(3)风险痛点:从"微调即遗忘"到"增量不覆盖"

日拱一卒,让大脑不断构建深度学习和大模型的神经网络连接。

那么,如何系统的去学习大模型LLM?

如果你也想系统学习AI大模型技术,想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习*_,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

在这里插入图片描述

【大模型全套视频教程】

教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。

从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。

同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
在这里插入图片描述

深耕 AI 领域技术专家带你快速入门大模型

跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

在这里插入图片描述

【精选AI大模型权威PDF书籍/教程】

精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
在这里插入图片描述

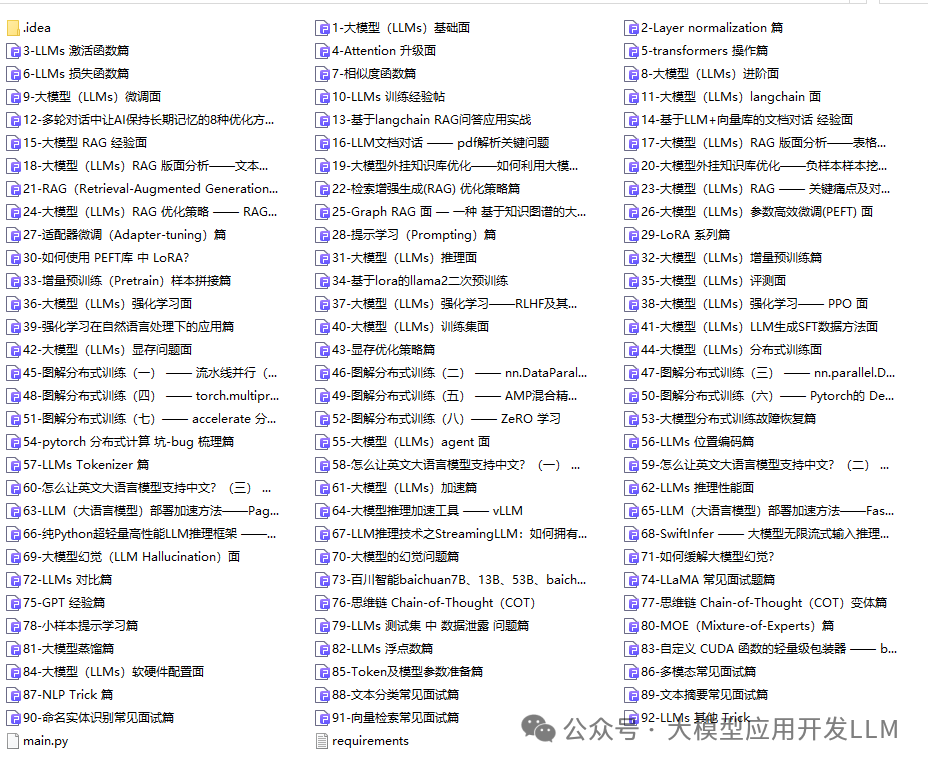
【AI 大模型面试题 】

除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。

【大厂 AI 岗位面经分享(92份)】
图片

【AI 大模型面试真题(102 道)】

图片

【LLMs 面试真题(97 道)】

图片

【640套 AI 大模型行业研究报告】

在这里插入图片描述

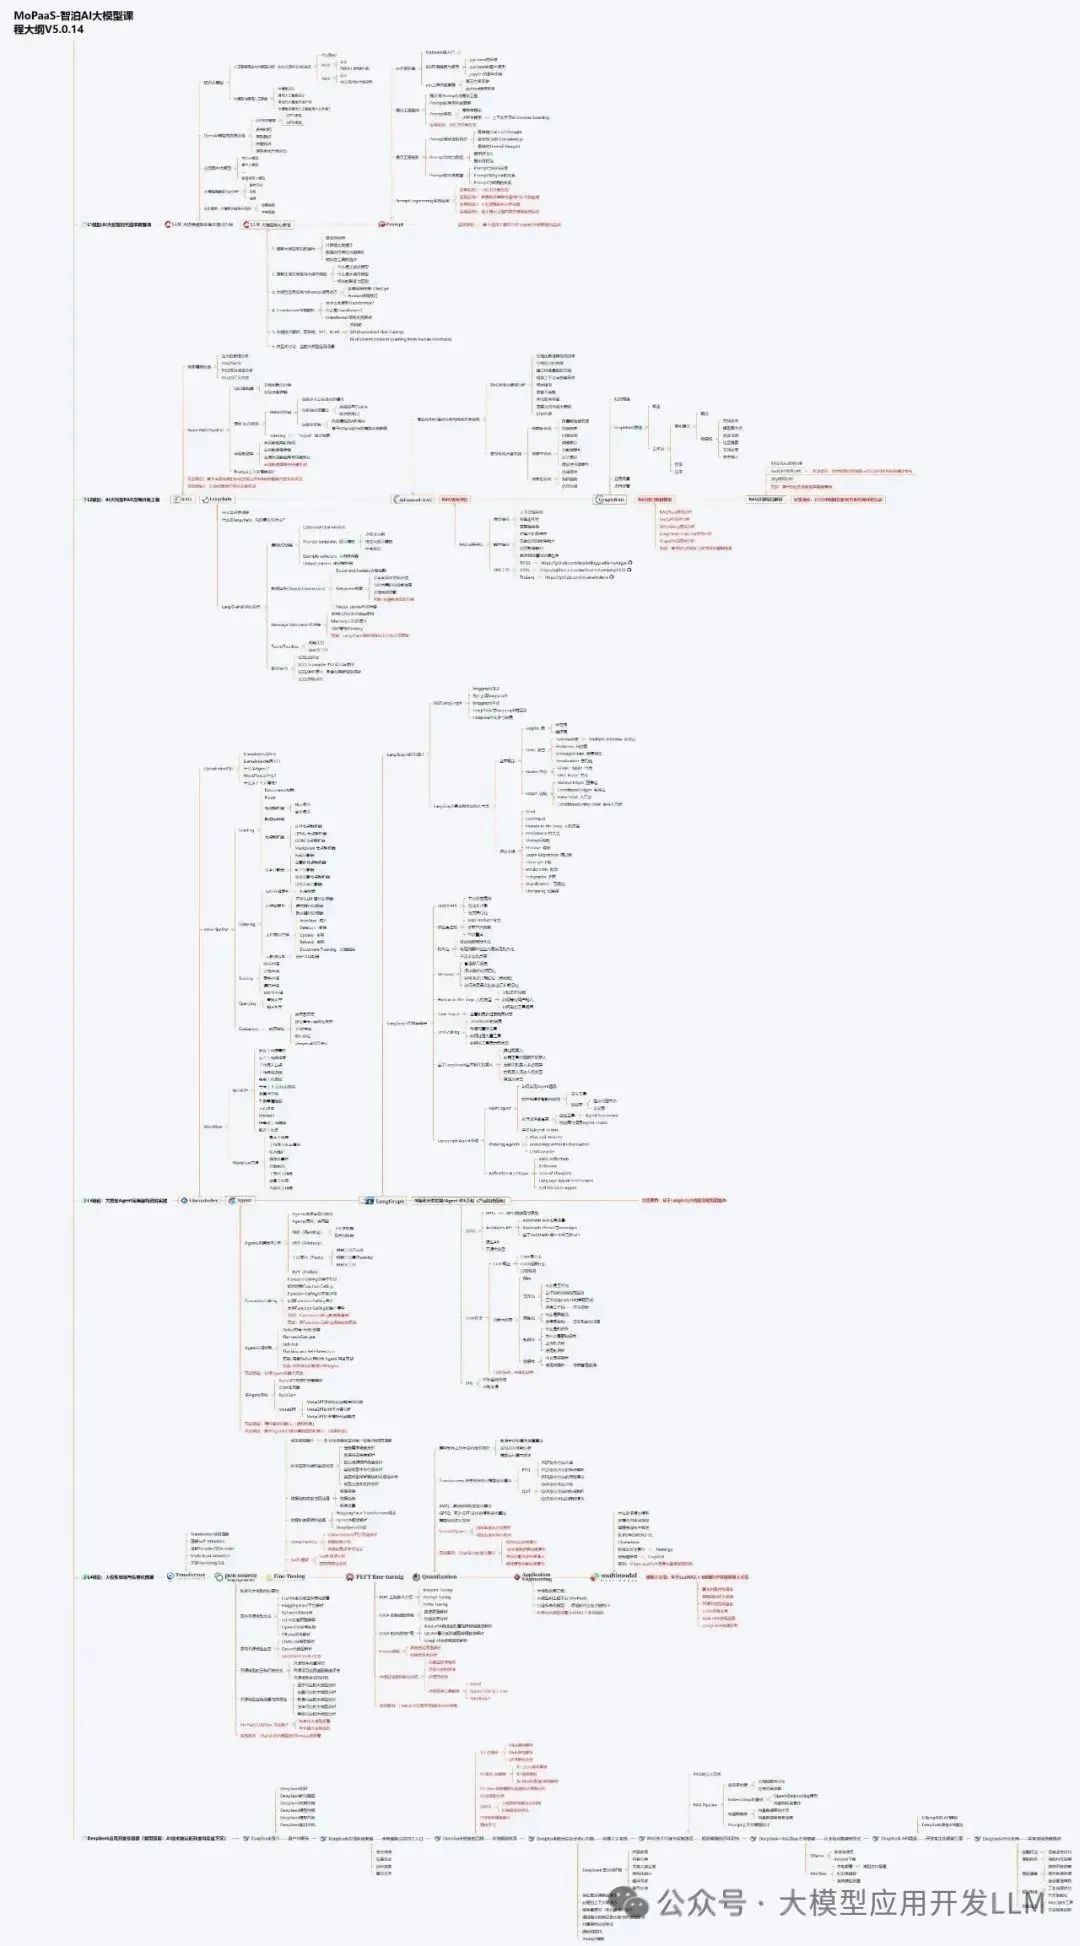
【AI大模型完整版学习路线图(2025版)】

明确学习方向,2025年 AI 要学什么,这一张图就够了!
img

👇👇点击下方卡片链接免费领取全部内容👇👇

在这里插入图片描述

抓住AI浪潮,重塑职业未来!

科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。

行业趋势洞察:

  • 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
  • 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
  • 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。

与其观望,不如行动!

面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
在这里插入图片描述

01 为什么分享这份学习资料?

当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。

因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!

我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。

*02 这份资料的价值在哪里?*

专业背书,系统构建:

  • 本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:

    • 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
    • 拥有多项中美发明专利。
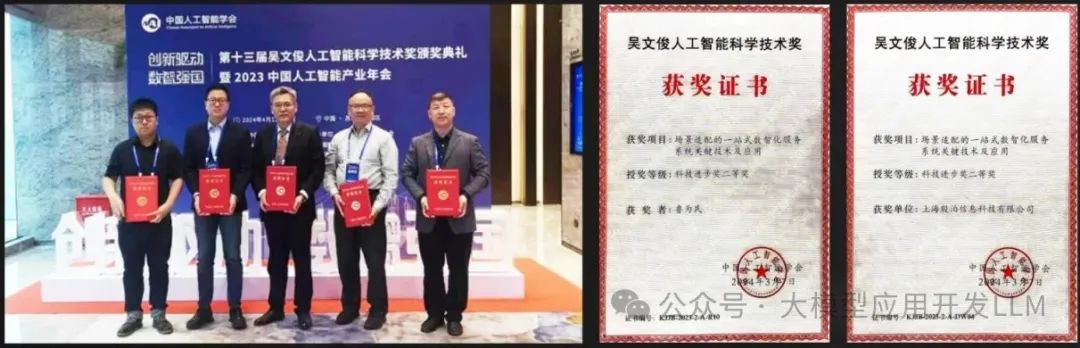
    • 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
  • 目前,我有幸与鲁博士共同进行人工智能相关研究。

在这里插入图片描述

内容实用,循序渐进:

  • 资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。

  • 包含丰富的视频教程与实战项目案例,强调动手实践能力。

  • 无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
    在这里插入图片描述在这里插入图片描述在这里插入图片描述

抓住机遇,开启你的AI学习之旅!

在这里插入图片描述

S7-200SMART 中如何实现单按钮启停功能(两种方法)? S7-200SMART 中如何实现单按钮启停功能(两种方法),Toggle库指令,状态翻转 阅读详情

相关推荐

用Linkboy玩转Arduino:3小时搞定智能倒车雷达(附仿真文件下载)

本文详细介绍了如何利用Linkboy图形化编程工具,在3小时内快速搭建一个基于Arduino的智能倒车雷达项目。通过仿真环境,初学者无需硬件即可学习超声波测距原理、报警逻辑设计,并完成从虚拟仿真到实体硬件的完整流程。文章提供了清晰的步骤、调试技巧及功能扩展思路,并附有仿真文件,是入门Arduino和智能硬件制作的绝佳实践指南。

weixin_29159441的博客 403

【AI学习】LLaMA模型的微调成本有几何?

以LLaMa 7B模型的训练来说,总训练时长=2710,按照前面“在8个80GB A100 上训练了3个小时,不到100美元”的成本折算,成本应该小于11300美金 13B模型,总训练时长=5100,成本应该小于21250美金 70B模型,总训练时长=21340,成本应该小于88920美金

bylander的博客 1772

Java 简易版 UDP 多人聊天室

【代码】Java 简易版 UDP 多人聊天室。

nmy15570188135的博客 1187

一文搞懂:大模型为什么要设计成预训练和微调两个阶段?

我们知道在训练大模型时与传统 AI 表现出显著的不同–大模型训练分为预训练和微调的阶段,那么为什么会分为两个阶段呢?笔者认为主要出于两个目的:提升大模型泛化能力,降低大模型训练成本。具体原因请见下文。

2401_85373691的博客 2029

信息安全与技术——(十一)恶意代码检测与防范技术

恶意代码(Malicious Code )或恶意软件(Malware )主要是指以危害信息的安全等不良意图为目的的程序,它们一般潜伏在受害计算机系统中实施破坏或窃取信息。

m0_63853448的博客 5991

华为擎云W515 PGUV-WBY0安装银河麒麟V10全流程解析

本文详细解析了华为擎云W515 PGUV-WBY0安装银河麒麟V10系统的全流程,包括准备工作、镜像下载与校验、启动盘制作、BIOS设置、安装过程关键选择、系统初始化及常见问题排查。特别针对ARM架构设备提供了实用技巧,帮助用户顺利完成国产化系统的部署与优化。

weixin_28725949的博客 698

从原理到落地!LoRA微调全解析:用百川智能实战,让大模型轻量化适配成本直降90%

文章摘要: LoRA技术通过低秩矩阵分解(如r=8时参数量降至0.39%),实现大模型轻量化微调,显著降低算力需求(单张RTX 3090可运行Baichuan2-7B)。其核心优势包括:1)仅更新局部权重,保留预训练通用知识;2)结合知识蒸馏避免任务过拟合。实战部分以百川Baichuan2为例,详细演示了从环境配置、数据格式(JSON多轮对话)到LoRA参数注入(peft库)的全流程,关键参数如秩r、学习率(2e-5)需按任务调整。该技术使垂直领域适配成本降低90%,成为中小团队落地AI的高效方案。

weixin_52610848的博客 1990

模型实战(16)之StrongSort (OSNET)配合YOLOv5、v7、v8 实现多目标跟踪详解

StrongSort (OSNET)配合YOLOv5、v7、v8 实现多目标跟踪详解

yohnyang的博客 1770

【必学】从零开始学LoRA:大模型微调成本暴降99%的原理与实践

想象你要搬家,有一堆大箱子要搬运。传统微调就像把每个箱子里的东西全倒出来重新整理,费时费力。而LoRA的做法更聪明:它发现大部分箱子其实不需要动,只需要在上面贴几张标签就够了。

python12345_的博客 1088

条件DDPM:Diffusion model的第三个巅峰之作

前言:DDPM从2020年诞生,短短一年的时间,模型上有两个巨大的改进,其中一个就是condition的引入,最近大部分DDPM相关的论文都会讨论这一点,有些文章称之为latent variable。和当年GAN的发展类似,CGAN和DCGAN的出现极大程度上促进了GAN的发扬光大,意义重大。本文基于前面几篇文章继续聊一聊: 从VAE到Diffusion Model_沉迷单车的追风少年-优快云博客 为什么diffusion model扩散模型可以称为score-based models?_沉迷单车的.

沉迷单车的追风少年 1万+

Agisoft Metashape 基于RTK技术的无人机航测免像控技术流程

利用无人机进行航空摄影测量,其使用方便、快速获得成果,已经是测绘行业外业生产的主要方式。RTK定位系统的出现,其厘米级的定位系统,使得航测无人机在作业时,能够准确获取拍照时的GPS位置,能够大量减少像控点,即使不使用像控点也能满足规范对精度的要求。可以有效解决特殊地形(如山川、峡谷、河流、沼泽、水库等)外业人员很难布设像控点的情况。

penglu366366的博客 2188

大模型微调神器:QLoRA、QA-LoRA、S-LoRA技术详解 | 程序员必学收藏

文章介绍了三种大型语言模型高效微调技术:QLoRA实现在单GPU上微调650亿参数模型;QA-LoRA通过量化感知算法提高计算效率且不损失精度;S-LoRA实现数千个LoRA适配器的可扩展服务。这些技术显著降低显存消耗,提高微调效率,为大规模定制化模型服务提供可能。

嘴巴吃糖了 1105

论文阅读: SIGIR 2025 ID-Free Not Risk-Free: LLM-Powered Agents Unveil Risks in ID-Free Recommender Syste

咱们平时用的推荐系统(比如购物APP推商品、视频APP推剧),大多是“有ID”的——每个用户、每个商品都有个专属ID,系统靠这些ID记录你的浏览、购买历史,再给你推喜欢的东西。但这种方式有个大问题:新用户、新商品刚上线时没有ID历史数据,系统没法精准推荐,这就是“冷启动”难题。后来人们搞出了“无ID推荐系统”:不用ID了,改成直接分析商品的文字信息(比如商品标题、描述),靠大语言模型(LLM,类似ChatGPT的技术)把文字转成“语义代码”,再通过这些“代码”判断你可能喜欢什么。

CSPhD-winston的博客 977

2026年AI入门指南:如果不掌握这3种“极速微调”技巧,你将落后同龄人10倍

各位AI圈的小伙伴们,是不是还在为大模型微调头疼?🤔 想给模型做个“个性化培训”,结果一看需要几十G显存、跑几天几夜,电脑直接罢工;好不容易调完了,模型还忘了老本行(灾难性遗忘),通用知识一问三不知——这说的是不是你?2026年的AI圈早就变天啦!全参数微调那套“大力出奇迹”的玩法,早就成了大厂专属的“奢侈品”。现在圈内流行的是“极速微调”技术,不用顶级显卡,不用海量数据,普通笔记本都能跑,调出来的模型还精准适配场景需求!

人工智能AI技术 800

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【强烈推荐】MiniMind:用25.8M参数和3元成本,零门槛打造你的大语言模型(必学收藏)

当大语言模型还在比拼千亿参数、百亿算力时,一个反其道而行之的项目悄然走红——MiniMind用25.8M参数(仅为GPT-3的1/7000)、3元服务器成本和2小时训练时间,实现了从0到1构建可对话的语言模型。这个完全开源的项目,正在重新定义普通人接触大模型的门槛。

2401_85327249的博客 1640

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

2026年AI大模型必学路线图:技术小白也能逆袭成专家!

我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。✅从入门到精通的全套视频教程✅AI大模型学习路线图(0基础到项目实战仅需90天)✅大模型书籍与技术文档PDF✅各大厂大模型面试题目详解✅640套AI大模型报告合集✅大模型入门实战训练。

libaiup的博客 313

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

2026年AI大模型必学!技术小白也能看懂的大模型进阶路线图

我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。✅从入门到精通的全套视频教程✅AI大模型学习路线图(0基础到项目实战仅需90天)✅大模型书籍与技术文档PDF✅各大厂大模型面试题目详解✅640套AI大模型报告合集✅大模型入门实战训练。

m0_74942241的博客 200

全新GPT-4o mini发布,多模态大模型仍是最大赢家!

OpenAI再进化!全新GPT-4o mini发布,多模态AI更强大,在5月中旬,OpenAI向世界揭开了GPT-4o的神秘面纱,这个全能的多模态巨人站在了GPT-4的肩膀上,将人工智能的边界推向了新的高度。为了让大家更好的抓紧大模型机遇,这次我整理了1-4月最新600篇大模型论文、99个大模型微调工具、特邀QS前50博导、大厂算法研究员等多位大牛打造了大模型系列课程,附论文代码讲解,原价666元...

我爱计算机视觉 160

行业现状:工业界如何用Transformer/BERT?​

就像开车不需要会造发动机,但顶级赛车手一定懂引擎原理。✅ 算法负责人更多做方案选型而非从头造轮子。✅ 工业界确实大量使用现成模型。

mayaohao的博客 750

自学AI制作小游戏

使用AI制作小游戏零基础知识点大纲

m0_73165198的博客 1381

GPT-4o颠覆世界,700篇大模型论文首次公开!

5月中旬,OpenAI向世界揭开了GPT-4o的神秘面纱,这个全能的多模态巨人站在了GPT-4的肩膀上,将人工智能的边界推向了新的高度。为了让大家更好的抓紧大模型机遇,这次我整理了1-4月最新600篇大模型论文、99个大模型微调工具、特邀QS前50博导、大厂算法研究员等多位大牛打造了大模型系列课程,附论文代码讲解,原价666元,现在全部免费领。扫码回复“GPT”领最新600篇GPT论文合集部分授课...

我爱计算机视觉 368

年薪百万的突围战:产品经理杀入AI大模型的黄金指南

《AI人才争夺战:大模型时代下的职业革命》 摘要:2025年,AI大模型领域正掀起一场职业革命。阿里、腾讯等大厂将60%岗位留给AI人才,云南事业单位甚至公开招聘不限专业的AI训练师,月薪轻松过万。数据显示,大模型岗位增速达470%,薪资溢价40%,与传统岗位形成鲜明对比。这场变革背后是三大行业铁律:技术代差使传统AI面临淘汰,能力断层要求产品经理掌握Prompt工程等新技能,而政策支持与人才缺口则创造了最后的上车机会。转型者需完成从功能经理到AI架构师的五维跃迁,包括技术认知升级、数据工程改造等。值得注意

weixin_55154866的博客 1726

全新GPT-4o mini惊天问世!最强多模态!

OpenAI再进化!全新GPT-4o mini发布,多模态AI更强大!在5月中旬,OpenAI向世界揭开了GPT-4o的神秘面纱,这个全能的多模态巨人站在了GPT-4的肩膀上,将人工智能的边界推向了新的高度。7月中旬OpenAI突然上线GPT-4o mini,更小也更强!为了让大家更好的抓紧大模型机遇,这次我整理了1月-7月最新600篇大模型论文、99个大模型微调工具、特邀QS前50博导、大厂算法...

阿木寺的博客 355

2026!AI时代产品经理转型秘籍:从传统到AI,年薪百万的AI大模型升级之路!

AI大模型时代产品经理的转型指南 随着AI大模型技术爆发式发展,传统产品经理面临严峻挑战。本文揭示三大行业铁律:技术代差导致传统AI产品思维被降维打击;能力断层要求PRD文档升级为技术架构图+Prompt设计库+伦理审查项;2030年全球AI人才缺口将达500万。产品经理需完成五维能力跃迁,包括技术认知、数据工程、产品设计等转型。文章提供三类背景产品经理的突围路线图,并指出求职中的关键陷阱与解决方案。当前AI岗位薪资溢价达40%,掌握大模型技术将成为职业发展的分水岭。

bugyinyin的博客 1407

GPT-4o引爆多模态!技术细节全拆解!

5月中旬,OpenAI向世界揭开了GPT-4o的神秘面纱,这个全能的多模态巨人站在了GPT-4的肩膀上,将人工智能的边界推向了新的高度。为了让大家更好的抓紧大模型机遇,这次我整理了1-4月最新600篇大模型论文、99个大模型微调工具、特邀QS前50博导、大厂算法研究员等多位大牛打造了大模型系列课程,附论文代码讲解,原价666元,现在全部免费领。扫码回复“GPT”领最新600篇GPT论文合集部分授课...

阿木寺的博客 1019

AI时代转型攻略:传统产品经理升级AI产品经理,年薪百万的AI大模型黄金指南!

AI大模型时代的产品经理转型指南:从功能设计师到百万年薪AI架构师的突围路径 核心要点: 行业变革:传统产品经理面临淘汰,大模型人才缺口达500万,头部企业资深专家年薪百万成常态 能力跃迁:需掌握Transformer架构、Prompt工程、伦理风控等五大维度,实现从功能经理到AI架构师的转型 实战路径:三类背景转型方案+求职利器(关键词狙击/项目包装/证书杠杆),避免技术至上等三大陷阱 学习体系:7阶段进阶路径,覆盖系统设计、提示词工程到行业应用开发,配套免费学习资源包

m0_59162248的博客 1108
上一篇: 程序员转行为什么这么难,2025年强烈建议程序员转行大模型试试_程序员转行机会成本太高_程序员转行为什么这么难,2025 年强烈建议程序员转行大模型试试
下一篇: 大模型微调知识与实践分享
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值