LoRA微调deepseek R1(7B)

llama factory LoRA微调qwen大模型 | 新手炼丹记录(1) 在本地机器微调Qwen大模型遇到显存不足的问题,尝试使用AutoDL算力云进行微调。租用24GB显存的计算资源后,通过LoRA方法微调了Qwen1.5:7b模型,并将微调、转换、量化后的gguf模型下载到本地进行部署。过程中详细介绍了算力租赁、环境搭建、数据集准备、模型微调和导出的步骤,最终成功完成模型的微调与部署。 阅读详情
AI摘要

本文介绍了如何使用LoRA技术对DeepSeek R1(7B)模型进行微调。内容包括数据集格式转换、模型下载、LoRA适配器添加、微调训练和推理过程。详细说明了不同微调方法的优缺点,如全参数微调、LoRA、QLoRA等,并提供了医学数据集的使用示例和格式转换细节。

deepseek今年很火热,既然开源了,那就来试试微调吧。
用一个医学数据集微调推理模型R1系列。
后面会涉及数据集的准备,模型加载,LoRA加载,微调训练和推理过程。
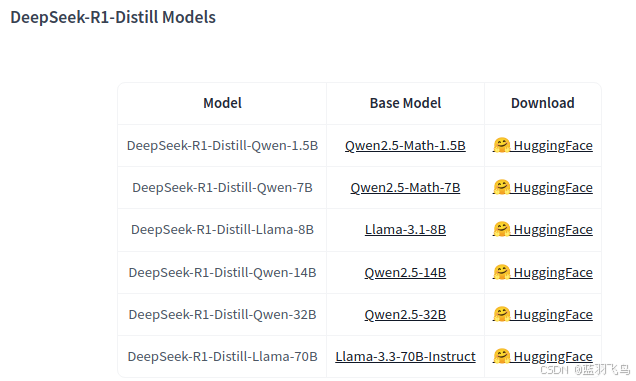
在这里插入图片描述

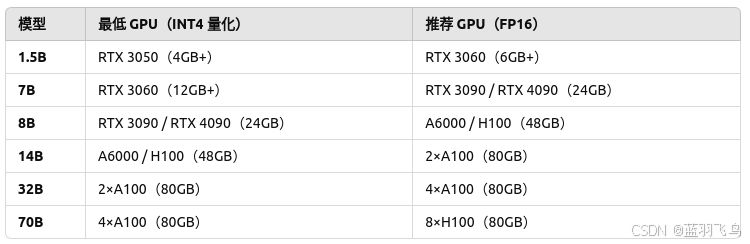
可以看到它有不同的尺寸,模型的硬件需求取决于它们的大小(参数量)以及加载方式(FP16、INT8、INT4等)。
GPU需求如下:
在这里插入图片描述

我们这里用3090微调一个7B的R1模型。

微调(Fine-Tuning)是对已经训练好的大模型进行特定任务的优化,以提高其在特定数据上的表现。
那么微调有哪些方法呢?

  1. 全参数微调(Full Fine-Tuning)
    最标准的微调方式:对模型的 所有参数 进行训练
    适用于:计算资源充足,任务与原始训练数据差异较大(如医学、法律)
    缺点:
    计算成本高(7B 需要 100GB+ GPU 内存)
    训练数据量需要足够大(否则容易过拟合)
    适用于少量任务,不能灵活切换任务

  2. LoRA(Low-Rank Adaptation)
    只在模型的 部分权重(如 QKV 矩阵) 上 添加可训练参数
    通过 低秩矩阵(A×B) 来优化参数更新
    优点:
    极大降低显存消耗(7B 只需 10GB)
    适用于多任务 LoRA 适配器切换
    训练速度快

  3. QLoRA(Quantized LoRA)
    LoRA + INT4 量化,让 LoRA 微调时占用更少显存
    允许 在 INT4 量化模型上训练 LoRA
    比普通 LoRA 省 50% 显存
    7B 只需 6GB 显存即可微调

另外还有Prefix Tuning(前缀微调),Adapter Tuning(适配器微调),BitFit(偏置微调),Adapter Fusion(适配器融合)。3090的话推荐LoRA或QLoRA。

Lora原理参考这里

数据集格式转换

使用医学数据集:medical-o1-reasoning-SFT
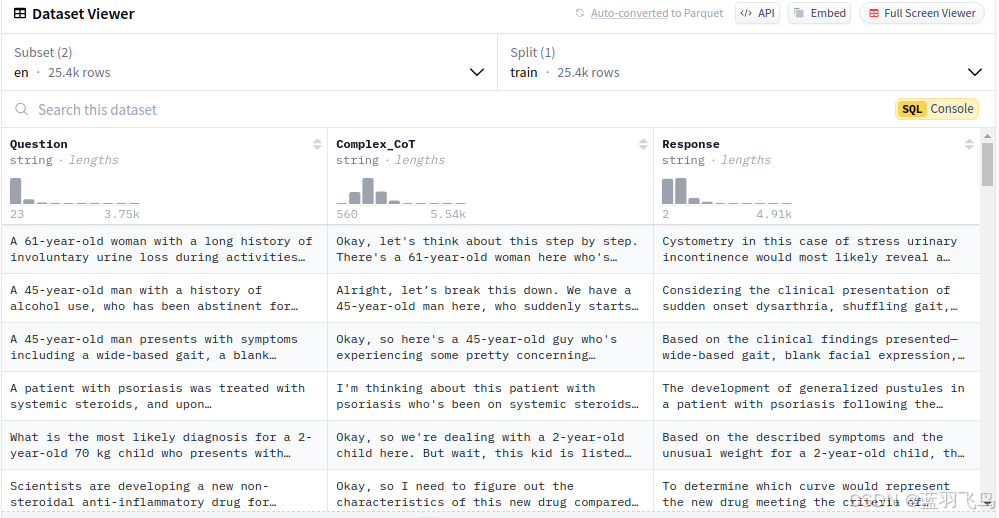
它长这个样子,有英文和中文两个子集,我们这里用中文(zh)的。
在这里插入图片描述

这里可以看到数据集有3列,“Question”,“Complex_CoT”, “Response”,
其中Question是对话时的问题,CoT是思维链,是思考过程的描述,Response是最后的回答。
不过大模型需要的数据格式是这样的,需要把上面的数据转为下面这样的格式:

train_prompt_style = """
以下是一个任务说明,配有提供更多背景信息的输入。
请写出一个恰当的回答来完成该任务。
在回答之前,请仔细思考问题,并按步骤进行推理,确保回答逻辑清晰且准确。

### Instruction:
你是一位具有高级临床推理,诊断和治疗规划知识的医学专家。
请回答以下医学问题。

### Question:
{}

### Response:
<think>
{}
</think>
{}
"""

def formatting_prompts_func(examples):
    inputs = examples["Question"]
    cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for input, cot, output in zip(inputs, cots, outputs):
        text = train_prompt_style.format(input, cot, output) + EOS_TOKEN
        texts.append(text)
    return {
   
   
        "text" : texts,
    }
    
dataset = load_dataset("FreedomIntelligence/medical-o1-reasoning-SFT", "zh", split="train")
dataset = dataset.map(formatting_prompts_func, batched=True)

我们来说明一下这段代码做了什么,
如果把数据集的3列写成提示词的形式,是这样的

### Question:
什么是心房颤动?

### Complex CoT:
心房颤动是一种常见的心律失常,可导致血栓形成和中风风险增加。

### Response:
心房颤动(Atrial fibrillation,AF)是一种快速、无规律的心跳状态,通常需要抗凝治疗。
<eos>

那现在大模型不需要Complex CoT,而是用Response里的 < think > < /think >代替,所以把Complex CoT的内容移到think里面, think结束后直接接上Response的内容。把Question对应的内容放到#Question下面,这就是train_prompt_style.format(input, cot, output)做的事情。
这是训练过程,< think >里面和“ ### Response”后面是有数据的,推理时只给到开头的< think >, 后面的部分让模型预测输出。
注:不要以为模型回答就是往Response里面填答案,不是填答案的。模型的预训练是根据前文预测下一个token, 那么这里也是一样,根据前文(到Response为止)预测后面的token。

其他数据部分的细节问题:
在每行数据的结尾加上一个EOS,为什么一定要加EOS?
如果 不加 EOS_TOKEN,训练时可能会把多个样本拼接成一个 连续文本,导致模型在推理时无法区分不同对话:
模型可能无法区分 一个问题的结束和下一个问题的开始,导致 输出混乱。

### Question:
什么是心房颤动?
### Response:
心房颤动是一种快速无规律的心跳状态,通常需要

开源模型应用落地-DeepSeek-R1-Distill-Qwen-7B-LoRA微调-LLaMA-Factory-单机单卡-V100(一) 使用LLaMA-Factory高效微调qwen2.5-7b-instruct 阅读详情

相关推荐

LoRA微调进阶:如何用LLaMA-Factory定制你的DeepSeek-R1-Distill-Qwen-7B模型

本文详细介绍了如何使用LLaMA-Factory工具对DeepSeek-R1-Distill-Qwen-7B模型进行LoRA微调,包括技术原理、环境配置、数据准备、实战训练及生产部署优化。通过LoRA微调技术,可在单张V100显卡上高效完成模型定制,显著提升特定场景下的性能表现。

weixin_29054195的博客 120

开源模型实践指南-DeepSeek-R1-Distill-Qwen-7B的LoRA微调与LLaMA-Factory单卡V100部署

本文详细介绍了在单卡V100上使用LLaMA-Factory对DeepSeek-R1-Distill-Qwen-7B进行LoRA微调的完整实践指南。内容涵盖从环境搭建、数据准备、参数配置到训练部署的全流程,重点解析了如何在有限算力下高效完成模型微调,并提供了显存优化、问题排查等实用技巧,为开发者提供了低成本、高效率的开源模型定制方案。

weixin_29079671的博客 323

如何使用 LoRA 对 DeepSeek R1 进行微调

LLM 的全面微调可能非常耗费资源。PEFT 技术(例如 LoRA)通过仅调整一小部分参数提供了一种优雅的解决方案。LoRA 的工作原理是冻结模型的权重并将可训练的低秩矩阵注入关键层。考虑 Transformer 层中的权重矩阵 (W)。我们不会直接更新 (W),而是将其更新为:这里,(A)和(B)是低秩矩阵,是被注入的可训练权重。在实践中,你可以定义一个秩r,使得(A)具有形状(N, r),(B)具有形状(r, M),乘法结果为具有相同形状的矩阵a(W)(N, M)。

iCloudEnd的博客 2508

15、DeepSeek R1高效微调实战

将 重点介绍如何使用主流微调框架unsloth,围绕DeepSeek R1 Distill 7B模型进行高效微调,并详细 介绍专门用于推理大模型高效微调的COT数据集的创建和使用方法,并在一个医学数据集上完成高效微 调实战,并最终达到问答风格优化+知识灌注目的,让模型在微调过程中掌握复杂医学问题的专业推理过 程,并提高疾病诊断的准确率。尽管全量微调可以对模型的能力进行深度改造,但要带入模型全部参数进行训练,需要消耗大量的 算力,且有一定的技术门槛。而该数据集也是可以用于推理模型微调的数据集。

Andy_shenzl的博客 2166

DeepSeek R1-7B 医疗大模型微调实战全流程分析(全码版)

本指南完整覆盖医疗大模型微调的15大核心环节,提供从数据准备到伦理合规的全链路解决方案。

AllenLV的博客 1195

DeepSeek-R1 7B LoRA微调实战:单卡12GB显存落地指南

大语言模型微调是指在预训练模型基础上,通过领域数据适配下游任务的关键技术。其原理是利用低秩适配(LoRA)等参数高效方法,仅训练少量新增参数,大幅降低显存占用与计算成本。技术价值在于让通用推理模型快速对齐业务输出格式与术语规范,同时保留原有能力。典型应用场景包括行业问答、工具调用协议定制和结构化输出生成。以DeepSeek-R1蒸馏版为例,7B模型在LoRA配置下仅需12GB显存即可完成领域适配,结合Unsloth加速与4bit量化,单卡微调门槛进一步降低。

weixin_29061465的博客 169

Windows应急响应实战:灰鸽子木马检测与清除全流程解析

远程控制木马(RAT)是一种基于客户端/服务器(C/S)架构的恶意软件,攻击者通过它能够远程操控受害主机,实现屏幕监控、文件窃取、键盘记录等操作,对个人隐私与企业数据安全构成严重威胁。其技术原理通常涉及进程注入、网络通信、持久化机制等核心环节,在应急响应中具有极高的分析价值。掌握此类木马的检测与清除方法,是Windows系统安全防护与事件处置的基本功。本文以经典的灰鸽子木马为例,结合进程分析、网络排查、注册表检查等实战技术,系统讲解从行为识别、痕迹取证到彻底清除的完整操作流程,并涵盖Rootkit对抗、无文

weixin_30521161的博客 413

Geant4 案例分析(一): B1

本文是对Geant4 B1的案例分析,其中特定的功能不做介绍,而注重于各个文件的主要功能,以及它们组织的方式。

m0_51809467的博客 1579

集成电路设计笔记(七)UVLO设计

1. 什么是UVLO 欠压锁定(Undervoltage-Lockout)简称UVLO,是电子设备中在电源电压低于正常工程准位时,切断电源的电路。在嵌入式系统中常会用UVLO监控电池电压,若电压低于一定值,会直接切断电源,保护嵌入式系统的电路。 许多电子设备中都有UVLO的功能,例如在镇流器中就有UVLO电路,若电压过低时直接切断电源。 UVLO就是低电压锁定; 低压关断. 欠压关断模式是当供电电压低于IC的开启门限电压时的一种保护模式。欠压关断模式可保证IC在供电电压不足时不致于被损坏。一个低电压锁定(

ccbirds 2万+

基于STM32的可穿戴式多生理参数实时监测与预警系统

针对传统可穿戴健康设备存在的生理参数监测种类单一、数据处理依赖云端导致响应滞后、续航能力弱等问题,设计一种基于STM32的可穿戴式多生理参数实时监测与预警系统。系统以STM32L476RG低功耗微控制器为核心,集成心率血氧传感器、体温传感器、血压传感器,实现人体心率、血氧饱和度、体温、收缩压/舒张压的同步采集;通过边缘端轻量化数据处理算法完成参数异常判定,结合低功耗硬件设计与软件休眠策略,在保证监测精度的同时延长续航。测试结果表明,系统心率监测误差≤2次/分钟,血氧饱和度误差≤2%,体温误差≤±0.2℃,血

m0_74026776的博客 2039

新手必看!无人机定高PID调参避坑指南:从理论到实战的完整流程

本文为无人机新手提供定高PID调参的完整指南,从传感器融合到抗风策略,详细解析多传感器融合、PID控制参数调试及环境干扰应对。通过实战案例和代码示例,帮助开发者快速掌握无人机定高技术,避免常见调参陷阱,提升飞行稳定性。

spark7igniter的博客 221

ARM 之十六 详解 CMSIS 版本变迁、各组件使用示例

目前,CMSIS 已经发展到了第六版,其目录结构也发生了重大的变化。在不断发展中,很多原来 CMSIS 的组件被不断独立出去,并因此成立了很多开源社区,今天就来学习一下!由于 CMSIS 已经包含了相当丰富的文档,因此,本文重点学习版本之间的变化以及一些实际使用示例。

技术干货 1954

数仓建模—数据语义层

如今,企业产生大量数据,需要以正确的方式进行分析才能做出重要决策。数据可能来自多个来源并采用不同的格式,这使得清楚地了解其含义和重要性成为一项挑战。这就是语义层的用武之地。语义层存在于数据仓库和最终用户使用的应用程序之间。它为用户提供了简化且一致的数据视图,无论其基础数据源的复杂性如何。该逻辑层有助于映射物理数据结构以创建概念数据模型。它定义了数据元素之间的所有规则和关系,并以业务术语提供了数据的通用词汇表。然后,用户可以轻松地与数据进行交互,而无需了解其数据源的技术知识。

7万+

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

上一篇: 什么是LoRA微调
下一篇: Transformers without Normalization paper笔记
蓝羽飞鸟
博客等级 码龄8年 1万+粉丝 727原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝羽飞鸟

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值