Transformers without Normalization paper笔记

WAM-202601:LingBot-VA(用于机器人控制的因果世界建模)【自回归扩散框架:利用双流MoT架构将视频与动作统一到单个交错序列中(先预测视频再逆动力解动作)】【基于Wan2.2-5B】 Causal World Modeling for Robot Control用于机器人控制的因果世界建模摘要This work highlights that video world modeling, alongside vision-language pre-training, establishes a fresh and independent foundation for robot learning. Intuitively, video world models provide the ab 阅读详情

paper主要提出了在transformer中替代layer norm的方案,dynamic tanh函数,它是逐元素计算的,避免了layer norm在计算中需要计算channel整体的均值,方差,进行reduce和broad cast计算,天然并行,且硬件友好。
这篇论文专注于 Transformer 中的 LayerNorm 替代,不涉及 CNN 中使用的 BatchNorm 或其他归一化方法。DyT 的设计完全围绕“token 向量级别的标准化”,所以在 CNN 上并不适用。

先复习一下什么是layer norm.

Transformer 中输入通常是:[B, T, C]
B: batch size (样本数)
T: token个数(LLM中是词数,图像中是patch数)
C: channel, 在token中指的是向量维度,也就是embedding dim.

layer norm是对每个 token 的向量 [C] 做归一化,即对最后一个维度做均值/方差计算。

输入形状: [B, T, C]
LayerNorm 就是对每个 [x_t1, x_t2, ..., x_tC] 做归一化
                            ↑
                          每个 token 的 channel 向量

layer norm原理:
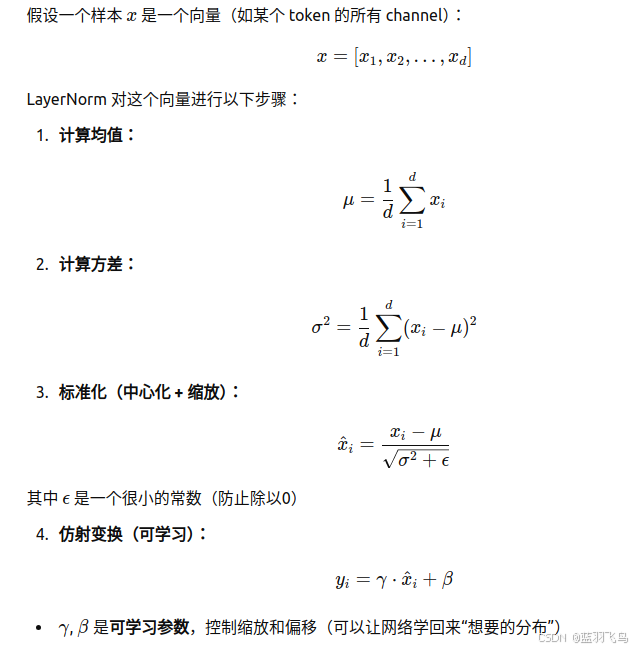
在这里插入图片描述
下面进入DyT的介绍,也就是paper部分,然后讨论为什么DyT比layer norm更快。

Abstract

归一化层在现代神经网络中无处不在,长期以来被认为是不可或缺的。
本研究表明,即使不使用归一化层,Transformer 也能通过一种非常简单的技术达到相同甚至更好的性能。
我们提出了一种逐元素操作,称为 Dynamic Tanh(DyT),其形式为:
DyT(x)=tanh(αx)
它可直接替代 Transformer 中的归一化层。

DyT 的灵感来自这样一个观察:在 Transformer 中,LayerNorm 的输入输出关系常常呈现类似 tanh 的 S 形曲线。通过使用 DyT,不含归一化层的 Transformer 模型在各种任务和设置下都能达到甚至超越原有性能,且几乎无需调参。

Introduction

在过去十年中,归一化层已经成为现代神经网络中最基础的组成部分之一。这一切始于 2015 年提出的 Batch Normalization(BN),它显著加快并稳定了视觉识别模型的收敛,并迅速被各类模型采纳。此后,针对不同架构和领域,研究者又提出了许多归一化层的变体,比如:

LayerNorm(LN)
InstanceNorm
GroupNorm
RMSNorm 等

尤其是在 Transformer 架构中,LayerNorm 几乎成为了默认标准,广泛应用于 NLP、CV 和多模态任务中。

归一化层之所以被广泛使用,是因为它们在优化过程中带来了非常显著的经验性好处,比如:

更快收敛
更稳定训练过程
更高的最终性能

随着网络变得越来越深、越来越宽,归一化层显得尤为关键。几乎所有新提出的架构虽然不断尝试替代注意力机制或卷积层,但都保留了归一化层,这本身就说明了社区对其“不可替代性”的默认共识。

本研究提出:这个共识可能是 不必要的。

我们从一个直观出发:LN 层的输入输出之间的关系,常常像一个 tanh 函数——它将输入按比例缩放,并“压缩”那些极端的数值。

受此启发,我们提出了一个简单的替代方案:

Dynamic Tanh(DyT)

形式为:

DyT(x)=tanh(αx)
其中 α 是一个可学习的缩放参数

这个函数具备两个目标:

1.通过 α 学习合适的缩放比例(类似 LN 的标准差归一化)
2.通过 tanh 的有界性压缩极端值(类似 LN 对极值的处理)

它和传统归一化层最大的区别是:DyT 完全不依赖均值或方差的计算,因此也不需要统计操作。
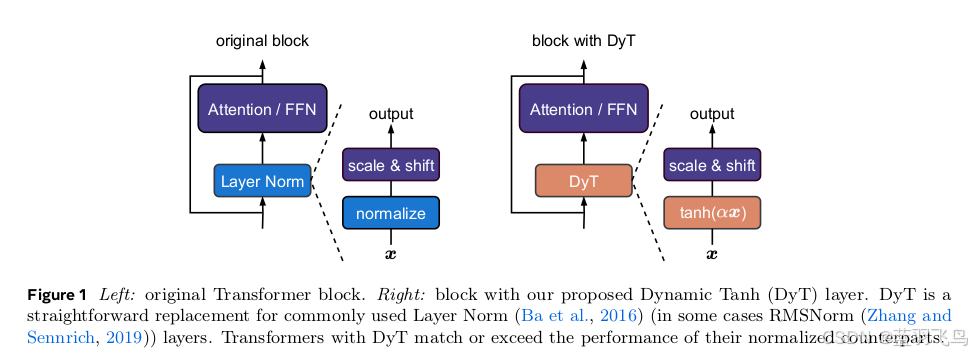
在这里插入图片描述

如图所示(图1):我们只需在 Transformer 架构中直接将 LayerNorm 或 RMSNorm 替换为 DyT,即可构建新的网络。

实验表明,使用 DyT 的 Transformer 在各种设置下都能:

稳定训练
达到和原模型类似甚至更好的最终性能
几乎不需要调超参数

归一化层为何看起来像 Tanh?

作者设计了一个实验:
在 ViT-Small(ViT-S)模型 上进行了训练,并在 ImageNet 上进行了标准训练流程(使用 LayerNorm)。

训练完成后,我们收集了训练集图像通过某一层 LayerNorm 的输入张量 x 和输出张量
y=LayerNorm(x)。

然后绘制了 x 与 y 的关系图。
想要看看 LN 的输入输出是否存在某种函数关系,特别是是否具有像 tanh 那样的 S 形结构。

从多个样本中提取出来的成千上万个 (x,y) 对进行绘图。

结果发现:
输出值整体分布在 [−2,2] 之间
和输入 x 的值形成一条平滑的 S 形曲线
随着 x 的绝对值增大,输出 y 趋于饱和(即边界附近变化不大)
和 tanh 曲线非常相似
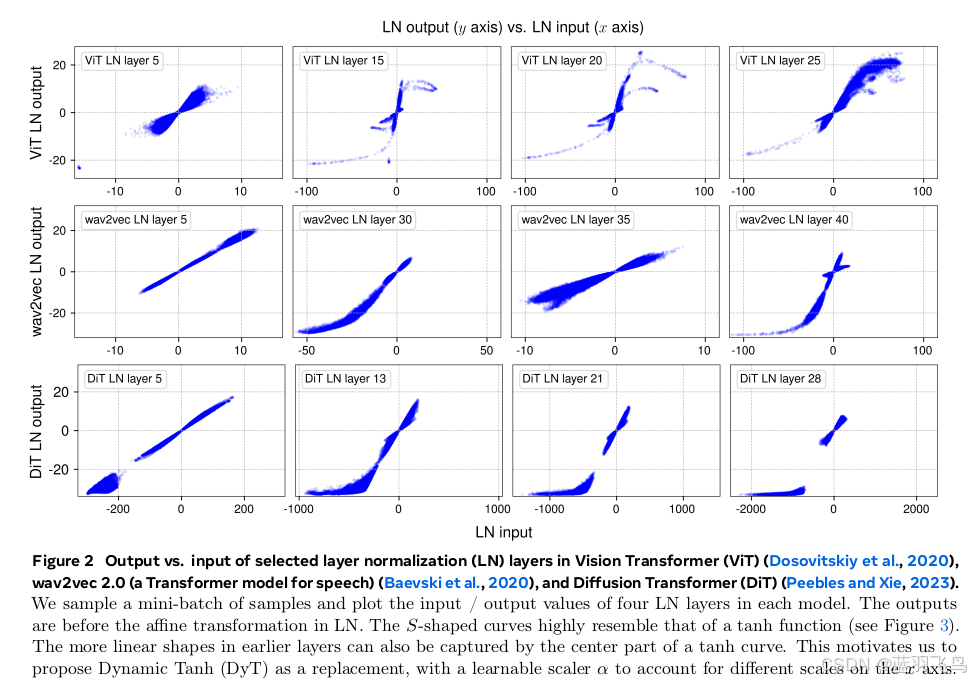
在这里插入图片描述
图中可以看到layer norm的输出不像ReLU那样是线性的,更像一种非线性压缩函数。

这个压缩行为可以通过 LayerNorm 的数学公式来解释:
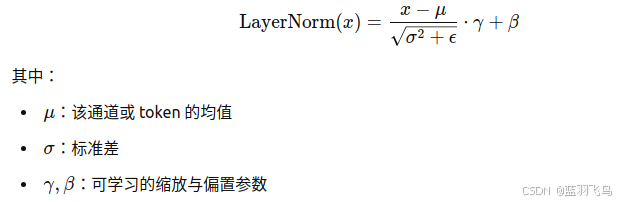
在这里插入图片描述

即使没有可学习参数(即 γ=1,β=0),LayerNorm 的标准化部分也会将输入 x 压缩到标准正态分布附近。

这相当于一种“柔性”形式的值域限制,像 tanh 一样,将极值控制在一个有限范围内。

既然 LayerNorm 的作用和 tanh 的输出形态如此相似,我们是否可以用一个可学习参数 α 来控制 tanh 的缩放程度,从而近似模拟 LayerNorm 的作用?

于是我们提出:
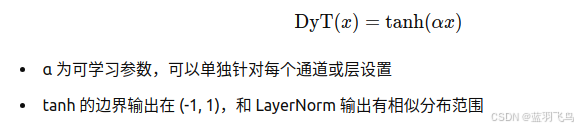
在这里插入图片描述
结果发现,这个简单的函数就可以稳定训练 Transformer,而且在多个任务上能达到与 LayerNorm 相当甚至更好的效果。

在这里插入图片描述

当 α 较小时,tanh 函数近似于线性函数(保持信息流畅);
当 α 较大时,tanh 函数输出趋于饱和(起到“压缩极值”的作用);
因此,通过学习合适的 α,DyT 可以模仿 LayerNorm 的“柔性标准化”效果。

论文中默认使用的是 通道级 α(向量),即每个通道都有一个独立的可学习 α。

DyT 可以直接用于替代 Transformer 中所有的归一化层。

看下面的图:
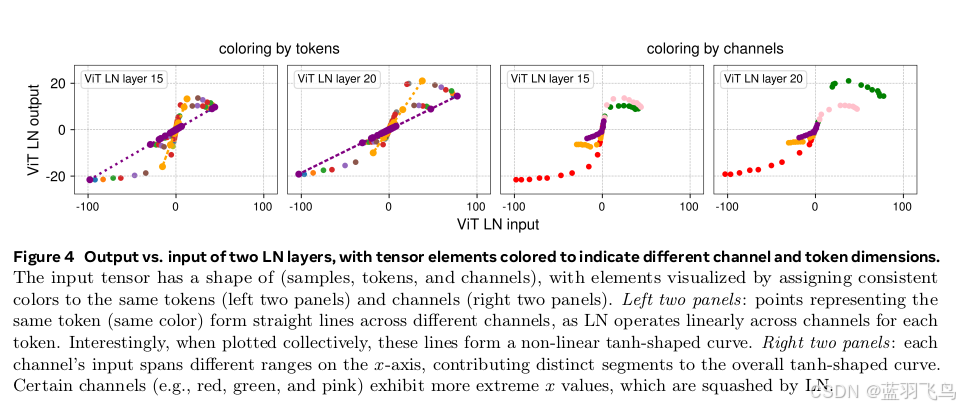
在这里插入图片描述
这4个小图是ViT 第 15 层 & 20 层 LayerNorm 输出 vs 输入。
左边两个小图是按token着色,每个颜色是一组 token,展示它在不同 channel 上的表现。
右边两个小图是按channel着色,每种颜色表示一个 channel(特征维度)。

横轴是输入 x,纵轴是输出 y=LayerNorm(x)

可以看到按token着色的情况是:

每个颜色的点 沿着一条直线排列,
因为 LayerNorm 是对每个 token(一个向量)做归一化 → 对该 token 的所有 channel 线性变换,
所以每个 token 被映射成一条直线。

但多个 token 的线条拼在一起时:
整体形成了一条弯曲的 “S 形”——类似 tanh 曲线,
说明 LayerNorm 整体的作用就像一个 “对不同 token 的线性函数集合”,它们一起构成非线性

按channel着色:

每个颜色是一个 channel
同一个 channel 会跨不同 token 取值

某些颜色(比如红、绿、粉)分布在输入值的极端位置(x 值很大)
但经过 LayerNorm 后,这些极端值都被压缩在 [-10, 10] 甚至更窄范围内
LayerNorm 起到了压缩极端值的作用

α\alphaα的初始化

我们发现,对 α 的初始值(记为 α₀)进行调节,在大多数任务中对性能影响不大。唯一的例外是大模型(LLM)训练,在这种情况下,精细调节 α₀ 会显著提升性能。

1.非LLM模型中α\alphaα的初始化

非LLM模型对 α₀ 的设置不敏感。图9展示了在多个任务上调整 α₀ 的验证表现。所有实验都遵循各自公开训练配方中的原始超参数。我们观察到,在 α₀ ∈ [0.5, 1.2] 的范围内,模型性能都比较稳定。

调节 α₀ 通常只影响训练初期的收敛曲线。唯一的例外是 ViT-L 的有监督训练,当 α₀ > 0.6 时,训练变得不稳定甚至发散。在这种情况下,降低学习率可以恢复稳定性。

此外,我们进一步发现:

较小的 α₀ 更容易获得稳定训练

当模型尺寸变大,或者学习率变大时,也需要适当降低 α₀来避免不稳定

图10展示了在 ImageNet-1K 上训练 ViT 模型时,调节模型大小、学习率、α₀ 的稳定性表现。可以看到,模型越大越容易发散,需要较小的 α₀ 或学习率才能稳定训练。

2.LLM中的α\alphaα的初始化
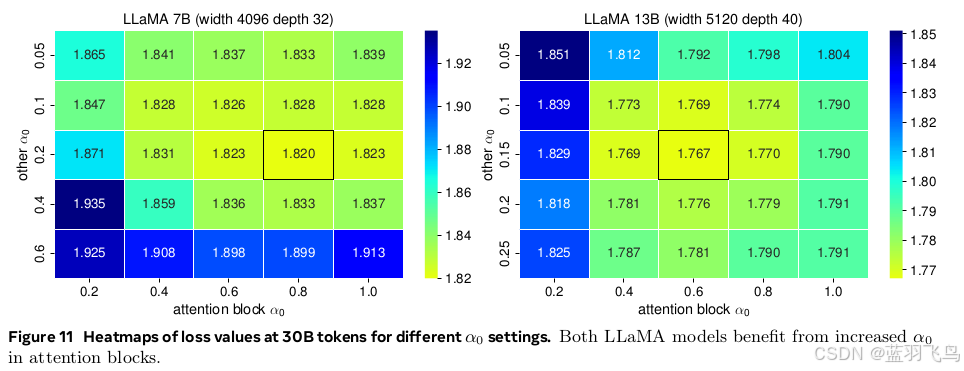
调节 α₀ 能显著提升性能。我们以 LLaMA 系列模型为例,在每个模型上用 30B token 做预训练,比较不同 α₀ 的训练损失,并得出两条核心结论:
1.模型越大,α₀ 越小
在这里插入图片描述

2.注意力层的 α₀ 应该更高

图11是热力图,展示了不同 α₀ 设置下 LLaMA 7B 和 13B 模型在训练30B token后的 loss。可以看到,在 attention 层设置较高 α₀,确实能显著降低训练损失。
在这里插入图片描述

DyT 的计算效率

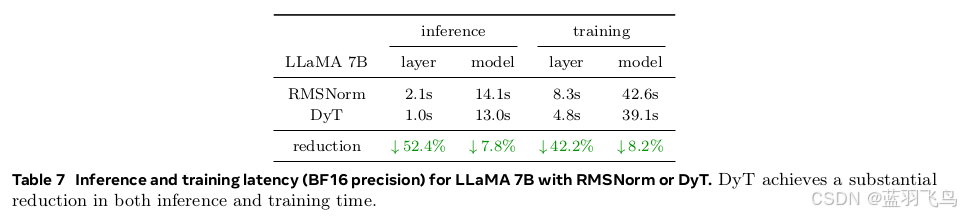
分别使用 RMSNorm 和 DyT,测量其在 推理(inference)和训练(training)阶段运行 100 次所需时间。
输入序列长度:4096

设备:NVIDIA H100 GPU,使用 BF16 精度

DyT 显著减少了单层计算时间,推理和训练整体也有明显加速,尤其适合效率导向的网络设计
在这里插入图片描述

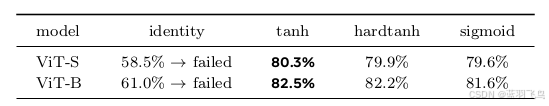
替换或移除 tanh 的影响

在这里插入图片描述

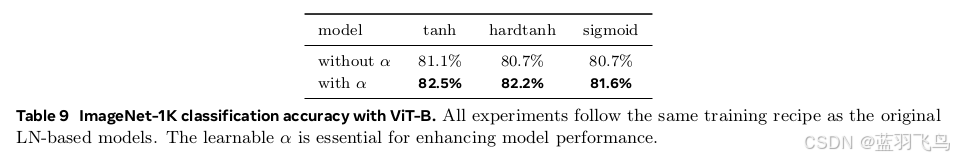
移除 α 的影响

在这里插入图片描述

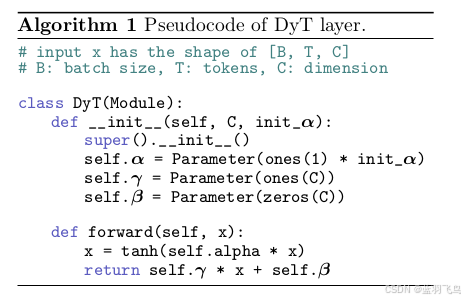
DyT伪代码

在这里插入图片描述

推荐系统工程师的个人学术知识中枢构建指南 学术文献管理本质上是知识组织问题,其核心在于将非结构化论文内容转化为可检索、可关联、可推理的结构化认知资产。基于推荐系统技术范式,通过用户画像→研究者认知画像、物品画像→论文多维表征、召回排序→知识路径调度等原理迁移,实现从‘读论文’到‘用知识’的范式跃迁。该方法显著提升信息过载场景下的认知效率与创新响应速度,在推荐系统领域因数据标准化、演进路径清晰、工业反馈闭环紧密而具备极高落地价值。本文聚焦于轻量级本地化Monolith架构实践,覆盖PDF解析、笔记结构化、实验指标对齐与认知推荐引擎等关键环节。 阅读详情

相关推荐

视觉特征-自监督-同源不同crop视图一致性【2021-04】:DINOv1【全局裁剪(覆盖原图较大区域)➜教师;全局&局部(覆盖原图较小区域)裁剪➜学生】【EMA学生来构建教师】【中心化&锐化】

在本文中,我们探讨 自 监督学习是否为 Vision Transformer (ViT) [19] 提供了区别于卷积 网 络(convnets)的新特性。除了将自监督方法适配到该架构后效果尤为出色这一事实之外,我们还提出以下观察:首先,自监督ViT特征包含有关图像语义分割的显式信息,而这种信息在有监督ViT和convnets中均不会如此清晰地出现。其次,这些特征也是出色的 k-NN 分类器,使用小型 ViT 在 ImageNet 上达到78.3%的top-1准确率。

u013250861的博客 299

Transformers without Normalization解读

2025年3月13日,由何凯明和Yann LeCun领衔的论文Transformers without Normalization挂载Arxiv上,大佬论文必须读一下。本文就该论文进行一个简单总结。

寸先生的AI道路 1238

TransGAN:纯Transformer架构的生成对抗网络原理与实战

生成对抗网络(GAN)是深度学习中图像生成的核心范式,其性能高度依赖特征提取器的归纳偏置。传统CNN-GAN虽效果稳定,但受限于局部感受野,难以建模长程空间关系;而纯Transformer生成模型则面临训练不稳定、小数据易坍塌等挑战。TransGAN提出一种结构对称的双Transformer设计——Generator与Discriminator均摒弃卷积,通过patch embedding、可学习位置编码、Pre-LN归一化及特征空间梯度惩罚等关键技术,在无局部先验前提下实现稳定对抗训练。该方案不仅验证了T

weixin_30800987的博客 406

文献总结:Transformers without Normalization

今天给大家分享一篇来自Meta FAIR实验室的作品DyT,作者中包含了何恺明(Kaiming He)和杨立坤(Yann Lecun)两位深度学习领域大佬!

m0_47211450的博客 1757

Azure Document Intelligence + Phi-3 Mini 构建高可靠PDF结构化提取系统

PDF文档结构化提取是企业级AI应用的核心基础能力,其本质是将非结构化扫描件或电子PDF转化为可编程处理的JSON数据。技术原理上需协同OCR文本识别与语言模型语义理解:前者提供带空间坐标的原始文本,后者基于领域知识完成字段映射与上下文消歧。Phi-3 mini凭借128K长上下文、4GB低显存占用和多语言技术文档预训练优势,成为Azure云内轻量级推理的理想选择;而Document Intelligence则提供高精度布局分析与合规可控的数据处理边界。该组合在发票解析、医疗报告、报关单等场景中实现99.2

weixin_33834910的博客 458

视觉特征-自监督-掩码特征预测【2024-11】:D-JEPA·T2I(通过下一词元预测实现高分辨率图像合成)【相对于D-JEPA的优化:文本条件、流匹配损失、VoPE】

近年来,自回归模型在类别条件图像生成方面展现了卓越的性能。然而,将下一词元预测应用于高分辨率文本到图像生成仍未得到充分探索。在本文中,我们提出了基于连续词元的自回归模型D-JEPA·T2I,该模型在架构和训练策略上均进行了创新,能够在高达4K的任意分辨率下生成高质量、照片级真实感的图像。在架构方面,我们采用去噪联合嵌入预测架构(D-JEPA),同时利用多模态视觉Transformer有效融合文本和视觉特征。此外,我们引入流匹配损失以及所提出的视觉旋转位置编码(VoPE),以实现连续分辨率学习。

u013250861的博客 171

【Transformer】Transformers without Normalization

在深度学习里,数据就像水流一样,在网络的各层之间流动。但每层网络的参数不一样,处理数据的“口味”也不同。这就会导致一个问题:数据在流经每一层时,分布会发生变化,变得越来越“歪”。这不仅会让网络学习效率变低,还可能导致梯度爆炸或消失,让训练直接“崩掉”。归一化层就像一个“水质净化器”,把每层输出的数据“过滤”一下,调整到合适的分布,让网络训练更稳定、更快。常见的归一化方法有 batch Normalization或Layer Normalization,等等。

weixin_54607024的博客 892

视觉特征-自监督-掩码像素预测【2021-11】:MAE【随机遮挡75%块】【编码器仅处理可见块+轻量解码器重建像素】【以MSE计算重建结果与原图差异】【高掩码率提效】

本文表明,掩码自编码器(MAE)是适用于计算机视觉的可扩展自监督学习器。我们的 MAE 方法很简单:我们对输入图像的随机图像块进行掩码,并重建缺失的像素。它基于两项核心设计。首先,我们开发了一种非对称编码器-解码器架构,其中编码器仅处理可见的图像块子集(不使用掩码 Tokens),同时配备一个轻量级解码器,根据潜在表示和掩码 Tokens 重建原始图像。其次,我们发现,对输入图像进行高比例掩码,例如 75%,能够产生一项非平凡且有意义的自监督任务。

u013250861的博客 162

[论文阅读]Transformers without Normalization

在过去的十年里,归一化层已经巩固了它们作为现代神经网络最基本组成部分之一的地位。所有这些都可以追溯到2015年批归一化的发明(Ioffe和Szegedy,2015),这使得视觉识别模型的收敛速度更快、更好,并在随后几年迅速取得发展。从那以后,针对不同的网络架构或领域提出了许多归一化层的变体。今天,几乎所有的现代网络都使用规范化层,层归一化(layer Norm,或LN) (Ba et al., 2016)是最流行的一种,特别是在占主导地位的Transformer架构中。

qq_41776136的博客 1442

视觉特征-自监督-掩码特征预测【2024-10】:D-JEPA【生成模型:下一Token组自回归预测(组内并行去噪),自回归合成图像】【JEPA、Diffusion损失均针对Mask处Token计算】

Dengsheng Chen1 Jie Hu2 Xiaoming Wei1 Enhua Wu2∗1Meituan 2Key Laboratory of System Software (Chinese Academy of Sciences) and State Key Laboratory of Computer Science, Institute of Software, Chinese Academy of Sciences {chendengsheng, weixiaoming}@meituan.

u013250861的博客 181

视觉特征-自监督-掩码像素预测【2021-11】:SimMIM【一种用于掩码图像建模的简单框架】

¹ 清华大学²微软亚洲研究院⁸ 西安交通大学Abstract摘要本文提出了SimMIM,一个用于掩码图像建模的简单框架。我们简化了最近提出的相关方法,无需采用特殊设计,例如按块掩码以及通过离散VAE或聚类进行 tokenization。为了研究是什么使掩码图像建模任务能够学习到良好的表征,我们系统地研究了框架中的主要组件,并发现每个组件的简单设计都展现出非常强的表征学习性能:1)以适度较大的掩码 patch大小(例如32)对输入图像进行随机掩码,可构成一个强大的 pre-text 任务;

u013250861的博客 90

Transformers without Normalization:归一化层在 Transformer 架构中必要性讨论

2025年3月14日何凯明大神发表新作Transformers without Normalization,讨论了归一化层(Normalization layers)在Transformer架构模型中的必要性。

weixin_44729653的博客 2539

CV-骨架02:Swin Transformer V2: Scaling Up Capacity and Resolution【2021-11】

Ze Liu* Han Hu*† Yutong Lin Zhuliang Yao Zhenda Xie Yixuan Wei Jia Ning Yue Cao Zheng Zhang Li Dong Furu Wei Baining Guo Microsoft Research Asia{v-zeliu1,hanhu,t-yutonglin,t-zhuyao,t-zhxie,t-yixuanwei,v-jianing}@microsoft.com {yuecao,zhez,lidong1,fuwei,bai

u013250861的博客 80

早起读论文,当Transformers 不再需要归一化

听起来十分的不可思议,听起来好像不太可能,归一化在所有的深度学习框架里都出现过,算是基石一般的存在,在 Transformer 模型中,归一化层主要是指层归一化(Layer Normalization)。我们的工作挑战了归一化层对于训练现代神经网络是不可或缺的这一概念,并提供了对归一化层属性的经验性见解。喔,这个发现真是太关键了,想想看如果归一化层最后干的活和Tanh函数差不多,那为什么不直接用Tanh 呢,但是普通的Tanh不够灵活,所以论文团队搞出了一个升级版的Tanh函数, 动态Tanh(DyT)

陈锐的技术笔记 1179

AgentVerse实战:构建多智能体协作系统的关键技术与应用场景

本文深入探讨了AgentVerse框架在构建多智能体协作系统中的关键技术及应用场景。通过分析智能体通信协议、环境交互机制和任务分解算法,展示了如何利用大型语言模型(LLM)实现智能体间的专业化分工与动态协作。文章还提供了智能软件开发团队和智能客服系统等典型应用案例,以及部署优化实践,为开发者构建高效的多智能体系统提供实用指导。

weixin_29254029的博客 361

音乐频谱灯的硬件艺术:从STM32到SK9822LED的工程美学

本文探讨了基于STM32微控制器和SK9822 LED的音乐频谱灯硬件设计与实现。通过ADC采集音频信号,利用FFT算法进行频谱分析,并驱动LED阵列呈现动态视觉效果,展现了硬件工程与艺术美学的完美融合。

Pepper的专栏 212

ViT:An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale

尽管 Transformer 架构已成为自然语言处理任务事实上的标准,但其在计算机视觉中的应用仍然有限。在视觉领域,注意力机制要么与卷积网络结合应用,要么用于替代卷积网络的某些组件,同时保留其整体结构。我们表明,这种对 CNN 的依赖并非必要,直接应用于图像块序列的纯 Transformer 在图像分类任务上也能表现出色。

u013250861的博客 78

String+CytoScape构建PPI网络

1.下载CytoScape Cytoscape是一款专业强大好用的物生信息分析软件,主要达用于专业的研究人员使用,软件主要适用于整合模块化网络和生物科学联系网络图的绘制,支持多种文件格式,导入后就可以直接进行编辑或者分析等操作了,除此之外,软件还提供了强大的编辑工具,支持添加相应的注释信息,软件基于java环境组件打造。 下载地址:https://cytoscape.org/ 因为软件基于java...

xiaobai1_1的博客 1万+

深度学习:transformer模型

Google于2017年6月发布在arxiv上的一篇文章《Attention is all you need》,提出解决sequence to sequence问题的transformer模型,用全attention的结构代替了lstm,抛弃了之前传统的encoder-decoder模型必须结合cnn或者rnn的固有模式,只用attention,可谓大道至简。文章的主要目的是在减少...

皮皮blog 6万+

手把手搭建你的第一个OCT仿真模型:用Python和光学仿真库重现A-SCAN信号

本文详细介绍了如何使用Python和光学仿真库搭建OCT仿真模型,重现A-SCAN信号。从环境配置、干涉仪建模到信号处理全流程,手把手教你实现光学相干层析成像的核心技术。通过代码示例和性能优化技巧,帮助开发者深入理解OCT原理并应用于医疗诊断等领域。

weixin_42562079的博客 240

uniapp开发小程序保存图片权限获取失败一直走fail?本地能保存,线上版就不行! 原来是这个问题!

通过这次经历,我发现线上版小程序和开发版、体验版的权限控制差异较大。如果你也遇到类似的问题,首先要检查是否已勾选“采集用户隐私”,并确保在提交审核时配置了隐私条款。这个设置非常关键,避免像我一样浪费了不少时间和版本。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 1077

Transformer 时代的语言模型:大规模语言模型的发展脉络与技术演化

本文梳理了Transformer时代大规模语言模型(LLMs)的技术演进脉络。从2017年Transformer架构的提出开始,重点分析了关键技术创新:双向编码器BERT通过掩码语言建模实现深度理解;GPT-3证明模型规模与提示工程的协同效应;InstructGPT引入人类反馈强化学习(RLHF)实现指令对齐;LLaMA通过数据规模优化突破参数量限制;FlashAttention通过IO感知优化解决长序列处理瓶颈;LoRA和量化技术实现模型高效微调与部署;RAG架构扩展模型知识边界;智能体技术从工具调用发展

qq_44768937的博客 608

AutoSAR MemMap模块概述及配置参数详解

这个模块是干啥的?它是用来配置Memory Mapping and Compiler Abstraction module。

4508

生成模型(四):扩散模型02【第一单元:扩散模型简介】

欢迎来到 Hugging Face 扩散模型课程第一单元!在本单元中,你将学习有关扩散模型如何工作的基础知识,以及如何使用 🤗 diffusers 库。扩散模型是「生成模型」算法家族的新成员通过学习给定的训练样本,生成模型可以学会如何生成数据,比如生成图片或者声音。一个好的生成模型能生成一组样式不同的输出。这些输出会与训练数据相似,但不是一模一样的副本。扩散模型如何实现这一点?为了便于说明,让我们先看看图像生成的案例。

u013250861的博客 4320

【AI工具】Browser use搭建及使用的保姆级教程:让AI帮你自动操作浏览器

【AI工具】Browser use搭建及使用的保姆级教程:让AI帮你自动操作浏览器

funfan的博客 2534

uniapp [安卓苹果App端] - 实现获取请求手机位置权限+开启定位获取经纬度/省市区地址等,检测权限手机定位是否开启并引导用户同意授权,uniApp app端调用本机开启本机定位权限及IP属地

uni-app,手机定位权限,安卓Android,苹果ios,uniapp获取本机位置权限,uni-app获取用户定位数据,uniapp APP获取用户IP属地定位,判断权限,权限被拒绝了怎么办,苹果ios系统无法开启定位,获取定位权限报错,uniapp定位获取省市区,UNI-APP如何开启手机定位功能并获取经纬度,不依赖地图第三方插件组件,打包上架后如何获取,真机运行无法获取定位,安卓和ios权限获取,判断权限检查,正式打包,详细教程,根据获取当前经纬度,再根据经纬度去定位具体省市区,自定义基座打包能成功

🏆 前端领域优质创作者 1万+
上一篇: LoRA微调deepseek R1(7B)
下一篇: 论文翻译:Position Paper: Agent AI Towards a Holistic Intelligence
蓝羽飞鸟
博客等级 码龄8年 1万+粉丝 727原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝羽飞鸟

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值