ESANet语义分割与realsense D455的结合

RGB与Depth融合方法总结 RGB与Depth融合方法汇总 阅读详情

paper:Efficient RGB-D Semantic Segmentation for Indoor Scene Analysis

网络结构如下,相比于基于RGB图像的语义分割,该网络用了RGB与深度图结合。
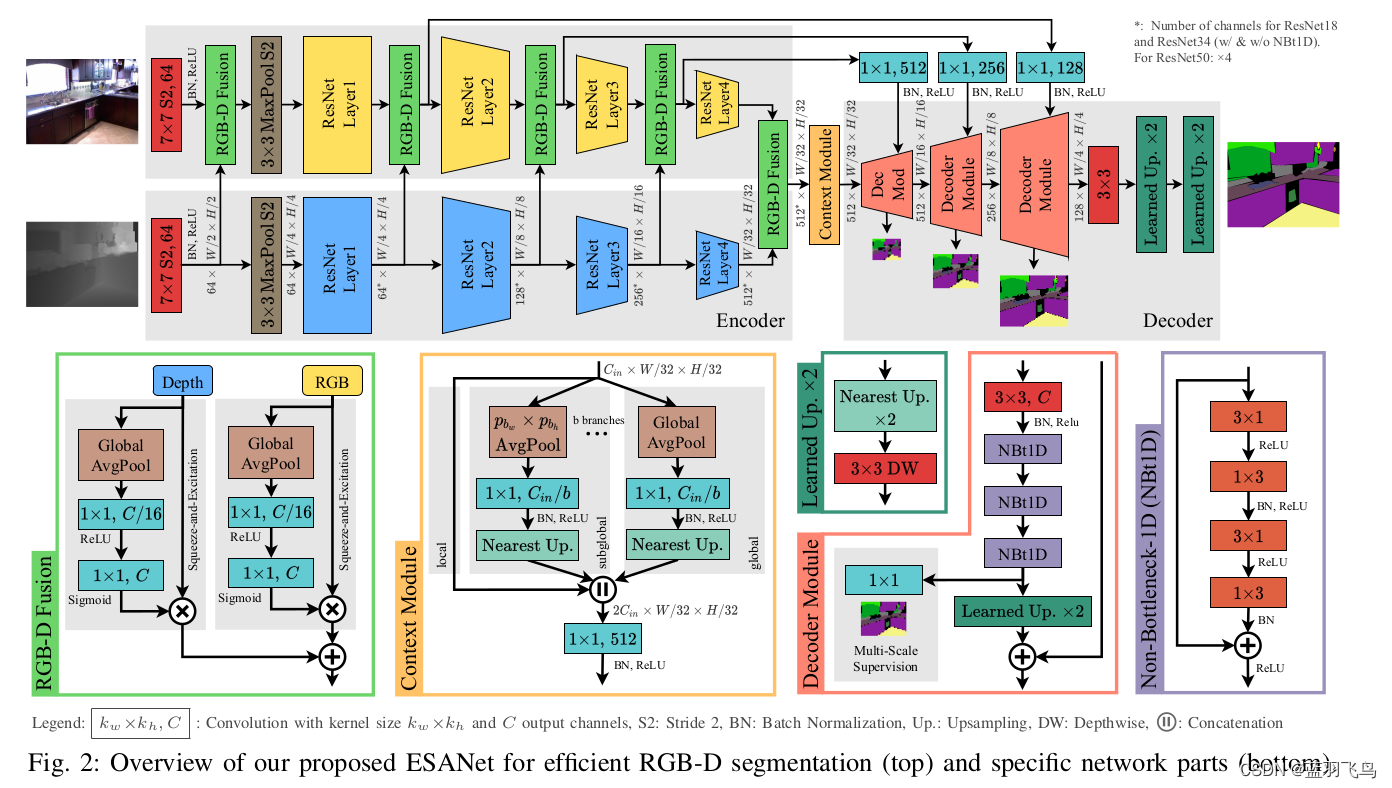
在这里插入图片描述
既然是RGBD,就可以用RGBD相机来测试了,选择realsense d455相机。

用ROS接口读入RGB图像与深度图。

这里要注意图像需要经过预处理,通过ESANet的源码,得知在validate阶段需要做以下预处理。

transform_list = [Rescale(height=height, width=width)]
transform_list.extend([
    ToTensor(),
    Normalize(depth_mean=depth_mean,
              depth_std=depth_std,
              depth_mode=depth_mode)
])

包含了Rescale, toTensor和normalize,
Rescale如下:

image = cv2.resize(image, (self.width, self.height),
                           interpolation=cv2.INTER_LINEAR)
depth = cv2.resize(depth, (self.width, self.height),
                   interpolation=cv2.INTER_NEAREST)

toTensor就是把RGB和深度图变为torch.tensor

image = image.transpose((2, 0, 1))
depth = np.expand_dims(depth, 0).astype('float32')

image = torch.from_numpy(image).float()
depth = torch.from_numpy(depth).float()

然后是Normalize,RGB图要做归一化处理,均值方差可能是根据训练集图像来的,可以根据自己的数据进行修改,
深度图的mean, std要根据自己的数据计算,直接用代码里面的效果不好。
有时候深度图会有nan值的情况,需要用到np.nan_to_num函数,d455相机没有nan值。
normalize之后一定要把之前0处的值置为0。

image = image / 255
image = torchvision.transforms.Normalize(
    mean=根据数据, std=根据数据)(image)
if self._depth_mode == 'raw':
    depth_0 = depth == 0

    depth = torchvision.transforms.Normalize(
        mean=根据数据, std=根据数据)(depth)

    # set invalid values back to zero again
    depth[depth_0] = 0

剩下就是过模型,input size可以选的,这里选的是(640, 480)

# Do inference
outputs = self.model(img, depth) #N,C,W,H

对于不复杂的场景,效果还是不错的,尤其是轮廓比较整齐,
下图场景中墙上的画,椅子,台灯轮廓都很清楚
在这里插入图片描述
但是对于复杂的场景(ex.桌子上乱七八糟的小零碎),移动的相机效果不是很好。
一来跟训练数据集有关,这里用的是sun-rgbd数据集训练的权重。
移动中的相机分割不是很稳,类别频繁变动,可能跟场景比较复杂有关,或者参数还需要进一步调整。
下面这个场景就有点乱了
在这里插入图片描述
这是对一个房间的分割建图在这里插入图片描述

【ESANet2021】Efficient RGB-D Semantic Segmentation for Indoor Scene Analysis 对移动机器人在不同环境下的动作进行深入的场景分析是至关重要的。语义分割可以增强各种后续任务,如(语义辅助的)人感知、(语义辅助的)自由空间检测、(语义辅助的)映射和(语义辅助的)导航。在本文中,我们提出了一种高效、鲁棒的RGB-D分割方法,该方法可以使用NVIDIA TensorRT进行高度优化,因此非常适合作为移动机器人场景分析复杂系统中的常见初始处理步骤。我们表明,RGB- D分割优于单独处理RGB图像,如果精心设计网络架构,它仍然可以实时执行。我们在公共室内数据集NYUv2和SUNRGB-D上评估了我 阅读详情

相关推荐

ESANet: 高效的RGB-D语义分割网络用于室内场景分析

是由德国伊尔默瑙工业大学的研究人员开发的一个高效的RGB-D语义分割网络。它的主要目标是在保证分割精度的同时,实现实时的推理速度,使其能够应用于移动机器人等资源受限的场景中。ESANet的设计理念是:通过精心设计的网络架构,在RGB-D数据上实现比单纯使用RGB图像更好的分割效果,同时保证在嵌入式设备上的实时性能。研究人员在论文中展示了ESANet在NYUv2、SUNRGB-D等常用室内数据集上达到了当前最好的性能,同时在NVIDIA Jetson AGX Xavier上能够达到近30FPS的帧率。

helloaiworld的博客 904

ESANet的encoder代码和参数对比

ESANet参数对比

qq_43733107的博客 1331

基于强化空间注意力的视网膜网络(ESA-Unet)

ESA-Unet

m0_61356812的博客 4470

【亲测免费】 ESANet:高效RGB-D语义分割助力室内场景分析

ESANet:高效RGB-D语义分割助力室内场景分析 项目介绍 ESANet(Efficient RGB-D Semantic Segmentation for Indoor Scene Analysis)是一个专为室内场景分析设计的高效RGB-D语义分割网络。该项目基于深度学习技术,能够在NVIDIA Jetson AGX Xavier等嵌入式设备上实现实时语义分割,适用于移动机器人等复杂系统的...

gitblog_00796的博客 676

RealSense D435深度相机开发(三)----基于距离的图像分割(下)

 这次演示的demo是基于OpenCV grabcut分割算法+深度信息去除背景。 基于RGB相机的grabcut分割算法需要鼠标去框选指定的object,实现分割的目的,类似下图所示:  而下图是基于rgb-d相机的grabcut分割算法,它能够根据Z轴的深度信息,自动的分割背景,达到下图的效果,但是缺点在于鲁棒性很差,很难做到正确分割。。 这是源码: // License: ...

SFM2020的博客 9257

RealSense D435深度相机开发(二)----基于距离的图像分割(上)

       RGB-D相机,对比传统的RGB相机,我们很快就能找到不同之处---深度。那么有了深度信息,我们能够做什么呢?        在做背景分割的时候,RGB相机只能通过帧间差分、特定颜色提取、基于混合高斯模型去除背景等方法,做到前景背景分离,有了RGB-D相机的深度信息,那我们就可以通过Z方向的距离来剔除背景了。先看看vs2015中跑的效果图:        下面三张图分别表示只显示...

SFM2020的博客 1万+

【论文阅读】——RGBD分割也能实时?Efficient RGB-D Semantic Segmentation for Indoor Scene Analysis

code:https://github.com/TUI-NICR/ESANet#time-inference 摘要: 摘要—全面分析场景对于在不同环境中行动的机器人至关重要。语义分割可以增强各种后续任务,例如(语义辅助)人的感知,(语义)自由空间检测,(语义)映射和(语义)导航。在本文中,我们提出了一种高效且强大的RGB-D分割方法,该方法可以使用NVIDIA TensorRT进行高度优化。我们表明RGB-D分割优于处理RGB仅用于图像,并且如果仍然可以实时执行网络架构是经过精心设计的。 1. 简介 .

怡宝2号 3844

RGB+深度图像 语义分割paper阅读笔记(ICRA2021)

RGBD语义分割

蓝羽飞鸟的博客 3578

ESANet前半部分代码解析

ESANet前半部分代码解析

qq_43733107的博客 614

手把手教你用LTspice仿真TVS二极管:从选型验证到波形分析全流程

本文详细介绍了如何使用LTspice仿真TVS二极管,从选型验证到波形分析的全流程。通过搭建仿真环境、核心参数验证和系统级防护策略,帮助工程师低成本评估TVS性能,优化电路设计。特别适用于电源设计和接口防护领域,提升工作效率和设计准确性。

weixin_29234239的博客 643

Android真机调试——ADB调试(含华为手机无法找到设备)

本文以Huawei Nova7为例。

lianqi2003的博客 7854

【亲测免费】 ESANet 开源项目使用教程

ESANet 开源项目使用教程 1、项目介绍 ESANet 是一个用于室内场景分析的高效 RGB-D 语义分割网络。该项目由 TUI-NICR 开发,旨在为移动机器人等设备提供实时的语义分割功能。ESANet 的设计使其能够在 NVIDIA Jetson AGX Xavier 等嵌入式设备上实现实时处理,适用于复杂的实时场景分析系统。 ESANet 的主要特点包括: 高效的网络架构,支持实时语义...

gitblog_00791的博客 802

OpenBmc开发2:构建开发环境

编译环境VMware + ubuntu 18.04 编译环境构建:参考OpenBmc开发1:构建开发环境 1、打开一个Ternimal,进入openbmc目录下 2、查看有哪些不同的编译配置 find meta-* -name local.conf.sample 可以看到如下编译配置 3、生成编译配置 插入TEMPLATECONF,上边查询到的配置有很多,但是有一些...

master 2万+

ESANet TensorRT + ROS加速版实时室内场景分割Demo

ZED2 ESANet TensorRT加速版Demo

sinat_24424445的博客 1230

VS2015编译配置GDAL(图文并茂、超详细!!!)

文章目录一、GDAL介绍二、下载GDAL三、修改源代码四、工具命令提示符操作五、编译GDAL六、安装GDAL七、在VS2015的项目中配置GDAL八、添加环境变量九、测试是否配置成功 一、GDAL介绍 GDAL(Geospatial Data Abstraction Library)是一个在XMIT许可协议下的开源栅格空间数据转换库。它利用抽象数据模型来表达所支持的各种文件格式。它还有一系列命令行工具来进行数据转换和处理。OGR是GDAL项目的一个分支,功能与GDAL类似,只不过它提供对矢量数据的支持。因此

weixin_46196863的博客 3756

中兴畅行60 ZTE 7552N 深度改造指南:从解锁BL到Magisk Root与IMEI硬改全流程

本文详细介绍了中兴畅行60(ZTE 7552N)的深度改造全流程,包括解锁BL、刷入Magisk获取Root权限以及IMEI硬改等关键步骤。通过专业的操作指南和实用技巧,帮助用户安全完成设备改造,同时提醒注意法律风险和技术难点。

weixin_33670786的博客 1882

【EMSANet2022】Efficient Multi-Task RGB-D Scene Analysis for Indoor Environments

语义场景理解对于在各种环境中行动的移动代理至关重要。尽管语义分割已经提供了很多信息,但关于单个物体以及一般场景的细节还是缺失的,但对于许多现实世界的应用来说是需要的。然而,鉴于移动平台上有限的计算和电池能力,单独解决多个任务是昂贵的,而且不能实时完成。在本文中,我们提出了一种高效的RGB-D场景分析的多任务方法(EMSANet),它同时进行语义和实例分割(全景分割)、实例方向估计和场景分类。我们表明,所有的任务都可以在移动平台上使用单一的神经网络实时完成,而不会降低性能–相比之下,各个任务之间能够相互受益。

我的博客 1074

激光除草技术原理与应用全解析

激光除草技术通过光热、光化学等效应精准破坏杂草组织,核心参数包括功率(20-6000W)、波长(400nm-10.6μm)和脉冲宽度。主要应用于大田作物(如玉米、棉花)、经济作物(烟草、果树)及城市绿化,具有环保(无化学污染)、高效(识别率≥95%)和非接触等优势,但存在设备成本高(20-50万元)、技术门槛高等局限。当前技术融合AI识别、多光谱协同等创新,国产设备如华工智耘已实现95.3%识别精度。虽短期投入较高,但长期可降低30%除草成本,并带来环境效益(每亩减排1.2吨CO₂)

start_up_go的博客 556

ROS图像的Deeplab v3+实时语义分割(ROS+Pytorch)

目录写在前面测试环境主要思路正式开始代码获取代码编译代码使用结果展示 写在前面 做机器人的同学们应该都知道,ROS是最常用的系统。一般搭载在机器人上的传感器也通过ROS话题消息机制进行发布,从而可以被其他结点所用。 最近要做一个机器人图像的实时语义分割任务,但是没有找到相关的教程。 其中的难点在于一般的语义分割网络都是离线的,对某个文件夹的图像进行分割并保存结果,而且一般需要用到深度学习环境(如Pytorch)。如何为其配置ROS接口是个难题。 这一篇文章就是旨在实现实时的ROS图像的实时语义分割,用的是D

weixin_43807148的博客 1万+

Qt/C++音视频开发1-vlc解码播放

一、前言 最开始接触视频监控这块的时候,用的就是vlc作为解码的内核,主要是因为vlc使用简单方便,直接传入一个句柄即可,简单几行代码就可以实现一个视频流播放,很适合初学者使用,也推荐初学者用qt+vlc来做播放器,提供的接口还是非常友好的,而且门类特别多,想要获取媒体文件的各种信息比如宽高,设置宽高比等,直接调用接口函数传入参数就能设置。 所有用vlc做视频监控解码的人都会遇到一个问题,那就是鼠标事件被接管拦截了,不能识别鼠标事件,比如双击最大化等,这就很憋屈了,明明很好用的一个东西,怎么突然之间鼠标事件

Qt/C++视频监控/推流/物联网/大屏系统/自定义控件/UI定制/输入法 4937

嵌入式系统开发笔记101:STM32CubeIDE安装过程中的2个错误及其解决方法

STM32CubeIDE在安装过程中,遇到了2个错误,本文阐述其解决方法。产生上述错误的原因,都在于中文。STM32CubeIDE不能很好的支持中文,所以在使用STM32CubeIDE进行项目设计的过程中,不要使用中文,包括项目所在的路径。

snmplink的博客 8550

RGBD-VOT

我们介绍了一种新的RGB-D跟踪基线,将框和像素级目标跟踪统一起来。与现有的主要探索深度图像外观线索的RGB-D跟踪方法不同,我们从BEV视角建模三维场景几何形态,并进行跨视角融合,以整合外观和几何表示,实现强大的RGB-D跟踪。如图3所示,整套算法流程包括图像编码器、BEV转换器、跨视角融合模块和任务特定的推理头。图像编码:我们首先使用ViT模型提取图像特征图I,它以模板-搜索图像对作为输入联合提取图像特征。whaosoft aiot http://143ai.com

whaosoft143ai的博客 1080

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Towards Real-time Semantic RGB-D SLAM in Dynamic Environments(动态语义SLAM)

动态环境下的实时语义SLAM简介摘要系统流程实验结果总结 简介    在ICRA 2021上看到这样一篇论文:Towards Real-time Semantic RGB-D SLAM in Dynamic Environments,发现它也是使用的语义网络+基于深度图的多视图几何方法来去除图片中的动态对象的。这一方法和之前看到的DynaSLAM类似,所以俺就去看看了,顺便再写一篇“时隔多年”的博客。(希望以后面试官能够从博客中看到我的勤劳特质!) 摘要  &nbsp

Armergg的博客 1755

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

ESANet validation代码

验证代码浅析

qq_43733107的博客 484

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Robust Double-Encoder Network for RGB-D Panoptic Segmentation

感知对于在现实环境中行动的机器人来说至关重要,因为自主系统需要看到并理解周围的世界,才能适当地行动。全景分割通过计算像素级语义标签和实例ID来提供对场景的解释。本文利用RGB-D数据对室内场景进行全景分割。我们提出了一种新的编码器-解码器神经网络,它通过两个编码器分别处理RGB和Depth。各个编码器的特征在不同的分辨率下逐步融合,这样RGB特征就可以使用互补的深度信息来增强。我们提出了一种新的融合方法,称为ResidualExcite,它根据特征图的重要性重新评估每个条目。使用我们的双编码器架构,我们可以

我的博客 1621

论文翻译(五):SegNet: A Deep Convolutional Encoder-Decoder Architecture for Image Segmentation

【论文翻译】:SegNet: A Deep Convolutional Encoder-Decoder Architecture for Image Segmentation

ting的博客 2692
上一篇: leetcode 13. Roman to Integer(罗马字母转数字)
下一篇: leetcode 387. First Unique Character in a String(字符串中第一个独一无二的字母)
蓝羽飞鸟
博客等级 码龄8年 1万+粉丝 727原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝羽飞鸟

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
