【姿态估计文章阅读】Joint Training of a Convolutional Network and a Graphical Model for Human Pose Estimation

姿态估计之2D人体姿态估计(1)(仅供个人参考) 参考 1、自顶向下的 2D 人体姿态估计 - 知乎 2、人体姿态估计(Human Pose Estimation)经典方法整理 - 知乎 3、2D人体姿态估计浅析 - 知乎 4、人体姿态估计中回归出了heatmap如何去计算关键点的坐标位置? - 知乎 5、论文阅读 - Deep High-Resolution Representation Learning for Human Pose Estimation 6、【HRNet】《Deep High-Resolution Represen.... 阅读详情

一、这是毫无疑问的大佬们的文章,2014年出就发布了第一版本,代码:https://github.com/max-andr/joint-cnn-mrf

二、文章的核心思想

       1、利用CNN做姿态估计,采用heatmap的方式来回归出关键点

       2、利用人体关键点之间的结构关系,结合马尔科夫随机场的思想来优化预测结果,主要针对于网络预测的false postive。

三、这是早期的deep learning应用到姿态估计文章,所以有比较大篇幅网络模型设计,但是这部分的设计过程依然非常值得学习和思考,每一步都有讲究,不是说说的那种,是理论结合实际出发提出的改进。

       先来看看模型迭代的过程:
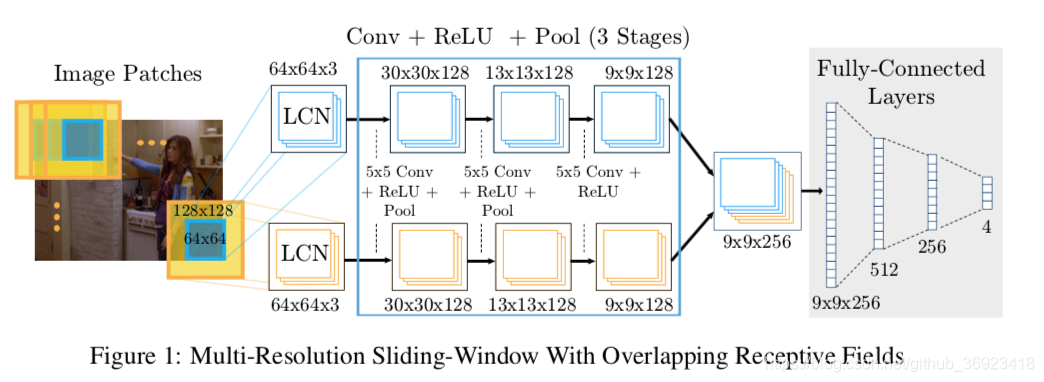
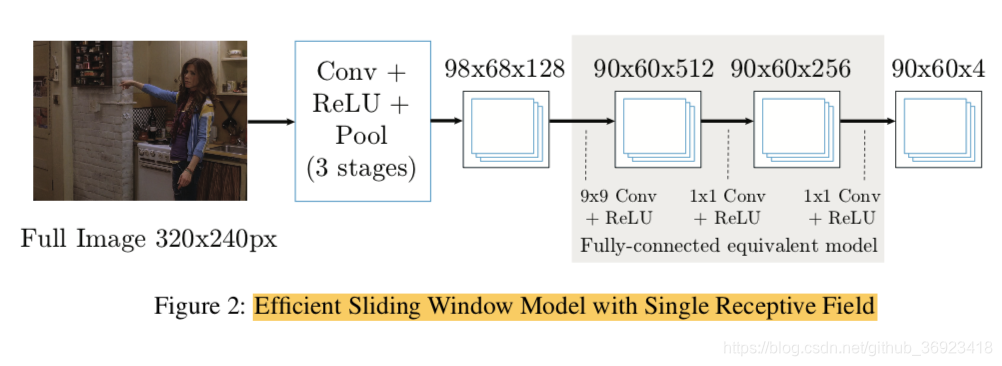
    1号模型:想要采用滑动窗口的方式,结合上多尺度(pyramid),这里的LCN是local contrast normalized,这种拉普拉斯金字塔可以让卷积核non-overlapping spectral content,从而降低网络的redundancy(字打不出来了)。这种over-lapping的滑动窗口方式可以保留更多的内容,同时拥有“平移不变性”。

    2号模型:解决了1号模型利用滑动窗口计算上会比较慢的缺点,因为巨大的redundant 卷积,而且同时期的一些研究工作证明了2号模型这种方式可以产生有效的dense feature map。

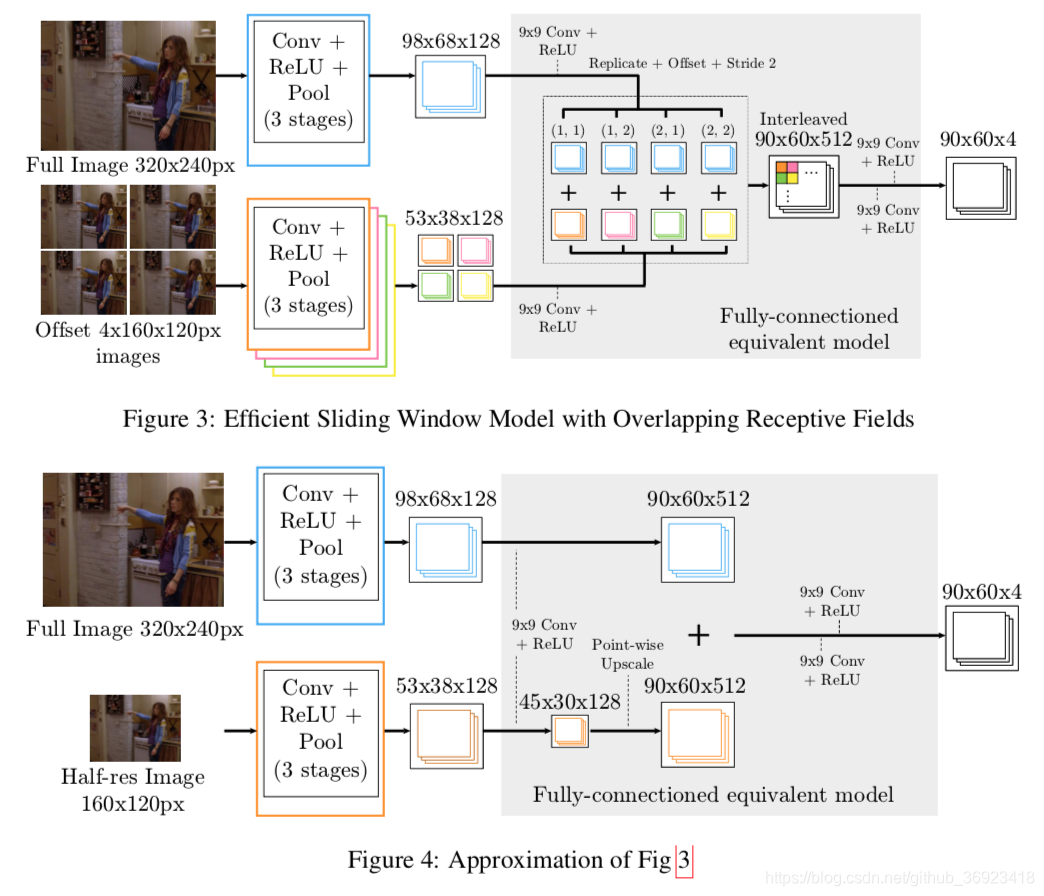
    3号模型:结合了1、2模型,3号模型的下半部分的步长直接等于1/2的原始大小,其他部分比较好理解,着重看“Interleaved”这部分,其实和另一个idea很像“pixel shuffle”,注意上面的每个颜色块对应到前面的4个部分(1,1),(1,2),(2,1),(2,2),这样可以提高空间上的精度吧。

    4号模型:依然是取代了滑动窗口,同时利用upscale把feature map大小提上来(对比与3号模型,在两个分支的feature 融合之前)3号模型利用了类似“pixel shuffle”的方式来upscale,4号模型应该是直接上采样,比如双线性插值(这里具体用的什么方式,有人知道的话告诉我下)。

   大致的模型构建过程,在这里就结束了。

四、第二大核心内容“Higher-Level Spatial-Model”

   这里作者,通过验证集发现,网络预测heatmap存在着很多的false positive,而且姿态是不正确的(anatomically incorrect),这里就是说,检测器只是在检测一个图中相似的目标,没有理解人的姿态这个核心思想,不懂什么是姿态。但是并不能说,CNN在回归的过程中没有参考“相关的关键点之间的联系”,因为网络的复杂结构,在拟合过程中很可能存在着比较弱的关联性体现,对这部分的学习也比较弱,毕竟我们的label对于每个人都是一对点,没有给出关联性的体现。

   我们也不难发现,头部预测的peak出现在heatmap中的时候,其实肩部也会在附近。但是目前CNN可能对这部分没有那么好的直接进行学习,所以建立了“spatial model”进行优化,对于那部分false positive 进行移除。

   we start by connecting every body part to itself and to every other body part in a pair-wise fashion in the spatial model to create a fully connected graph.也就是说,构建的是全联接的图,同时每个点还有个自链接。

   那么CNN直接回归出heatmap,可以看成一堆的先验概率,以及条件概率(因为CNN预测的时候是一次性“同时”预测出n个关键点的概率,因此可以当成是条件概率,也就是在B出现的条件下A出现的概率)
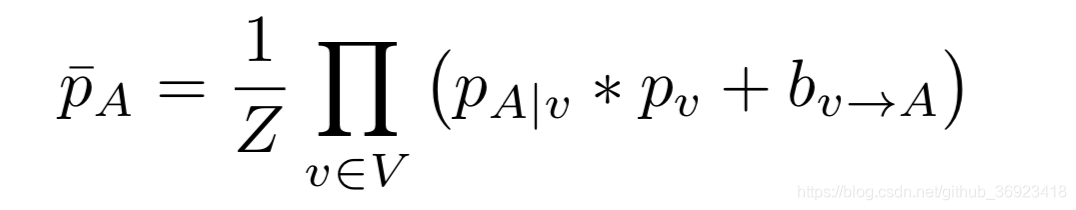
                    

    上面这个公式是最终的概率。文章说了,对于FLIC这个数据集是来自于好莱坞的所以很多是正面的镜头,而且是站立的,因此能够得到比较稳定的结构信息,空间概率推测信息,比如头的左下部会出现右肩。但是对于LSP这个数据集变化较大,因此这个模型的效果也会相应被减弱。

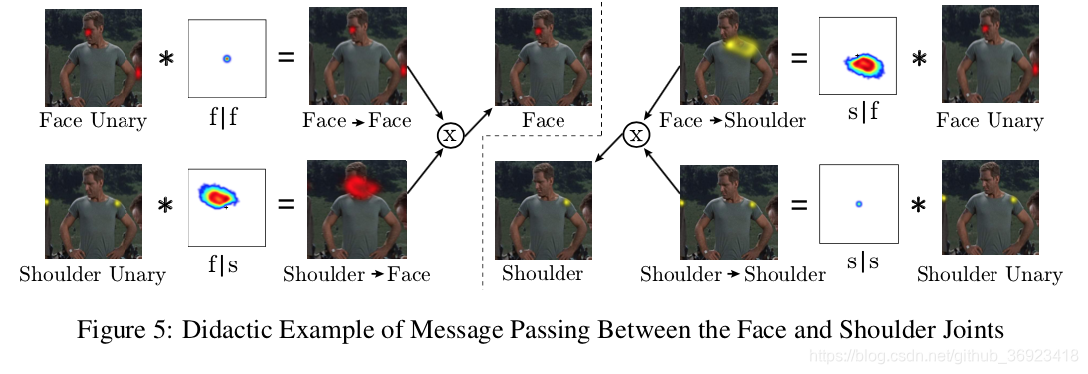
   在实际应用中作者把大Z去掉了,有以下几个原因:1、我们只关注heatmap上的极大值点,或者最大值点,这一个点,在预测过程中heatmap我们只是希望能够更加接近标准正态分布就行了;2、反向传播的时候这个Z只会相当于在这部分的梯度上乘了一个系数而已;3、每个人并不是一定是完整的,所以也是无法规范化的。下面是改进后的公式(虽然不再是标准的马尔可夫随机场了,但是依然对于适合用于空间限制的编码):

     the addition in log space means that the partial derivative of the loss function with respect to the convolution output is not dependent on the output of any other stages。这里很多取巧的地方避免的训练和回传时候的梯度问题,保证空间连续可导,防止出现0之类。而且整个计算过程可以很方便的嵌入到深度学习框架中:
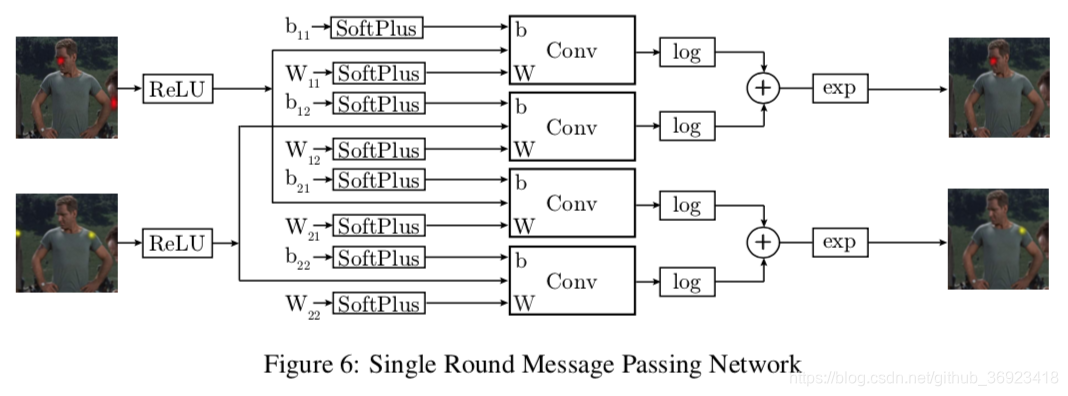
    这张图也回答了我们,条件概率(e A|v),background 概率(b v->A)这两部分是来自于网络学习的,一开始看的时候以为是通过统计得到的,后来发现这些全部都是通过网络自己学习得到的。这里卷积核也是非常大的,需要能够去覆盖“最大的两个关键点之间的距离”,因此对于90x60的输出,卷积核达到了128x128,这样能覆盖64个像素之内的关键点偏移,比如手腕到手肘(这里卷积核为什么是偶数,我也不知道,当然是需要padding的,而且要用FFT的方式进行卷积计算,初始化也比较特别,The convolution weights are initialized using the empirical histogram of joint displacements created from the training examples.)。

 六、训练

    先单独训练(单独训练,先训练回归模型,然后再基于回归模型训练空间模型),然后一起再微调。   Unified training of both models (after independent pre-training) adds an additional 4-5% detection rate for large radii thresholds.
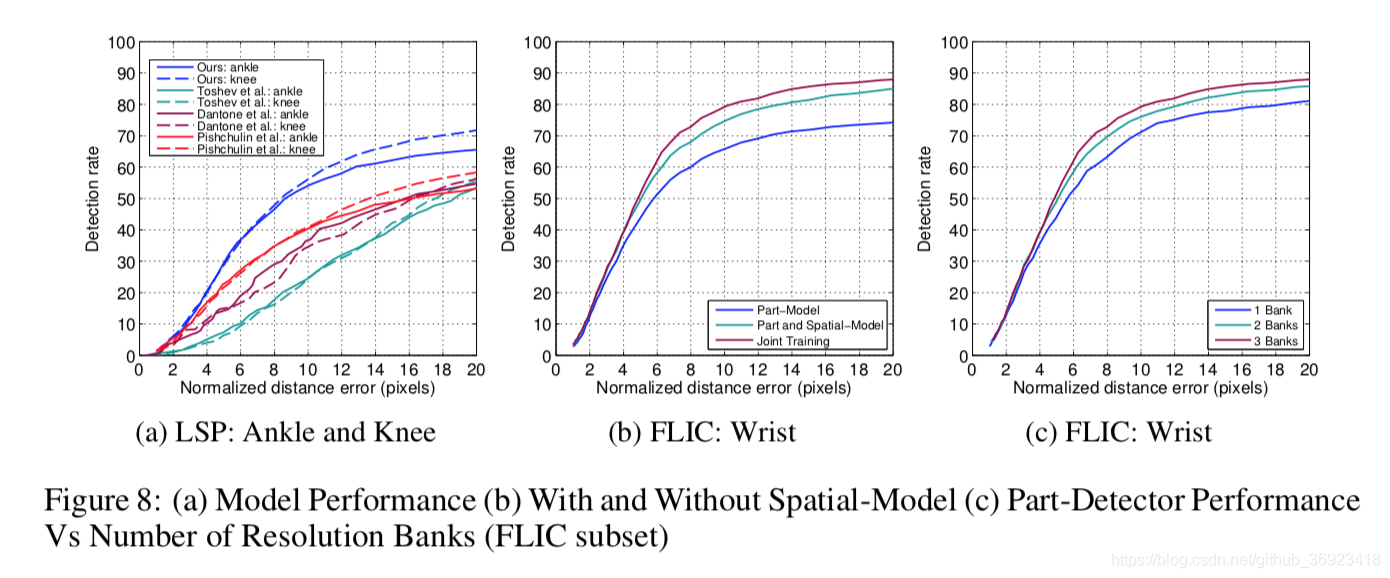
   从这张图,可以发现,空间模型,在eval的时候,阈值越小(要求离groundtruth越近)时,效果不明显,这也和文章一开始预料的一样,这个方法不是用来提升“本身以及比较好的那部分结果的”,而是用于纠正那部分“错的比较明显的那部分”。


Efficient Object Localization Using Convolutional Networks 论文解读 paper title: Efficient Object Localization Using Convolutional Networks paper link: https://arxiv.org/pdf/1411.4280.pdf oral or demo video:- project: - github: - conf & anthor: CVPR15, Jonathan ... 阅读详情

相关推荐

Cocos Creator发布微信小游戏:深度定制与去除默认加载页面的实践指南

本文详细介绍了如何使用Cocos Creator发布微信小游戏时去除默认加载页面的实践方法。通过修改构建配置和重写启动逻辑,开发者可以自定义加载体验,提升品牌一致性。文章还提供了进阶优化方案和常见问题解决方案,帮助开发者实现更专业的微信小游戏发布流程。

weixin_27972919的博客 568

【姿态估计】Joint Training of CNN and a Graphical Model for Human Pose Estimation用于姿态估计的CNN和图模型的联合训练

用于人体姿态估计的CNN和图模型的联合训练 Jonathan Tompson,Arjun Jain,Yann LeCun,Christoph Bregler 纽约大学 {tompson,ajain,yann,bregler} @ cs.nyu.edu 摘要 本文提出了一种新的混合架构,包括深度卷积网络和马尔可夫随机场。 作者展示了该架构如何成功应用于单目图像中人体关节姿态估计的挑战性问题。 ...

hyczkg的博客 5290

华硕ROG枪神双系统实战:Ubuntu安装避坑指南

本文是华硕ROG枪神笔记本安装Ubuntu双系统的详细避坑指南。针对其独特的硬件与BIOS设计,文章核心解决了VMD控制器导致硬盘无法识别、驱动兼容性等关键难题,并提供了从BIOS设置、分区方案到安装后驱动配置与性能调优的一站式解决方案,帮助用户实现稳定的双系统体验。

raspberrypi5的博客 545

2D人体姿态估计 - Stakced Hourglass Network(SHN)个人理解

Stacked Hourglass Networks for Human Pose Estimation 中文翻译 An Intuitive Explanation of Convolutional Neural Networks – the data science blog 为了进行人体姿态估计,我们使用一种特殊类型的全卷积网络,称为hourglass网络。网络的编解码器结构使它看起来像一个沙漏,因此被称为“hourglass networks” Hourglass网络图 个人理解: .

light169的专栏 2108

新手小白 必须精进的 “ FLASH分区管理Code and Data ” !!!最强文章解析!!!

FLASH“代码区”和“数据区”不是每个项目都必须显式管理,但只要你的产品功能越来越丰富,对可靠性和扩展性要求提高,就一定要学会科学划分和使用。这也是嵌入式工程师进阶路上的必修课!

qq_75157958的博客 932

为什么你的Nginx配置SM2国密SSL证书失败?这些坑我都帮你踩过了

本文针对Nginx配置SM2国密SSL证书的常见失败原因,提供了详细的排查与解决方案。核心在于使用支持国密算法的Nginx版本(如集成Tongsuo库),正确处理从阿里云等平台获取的证书格式,并正确配置ssl_ciphers等关键参数。文章还解释了浏览器兼容性差异及双证书部署等进阶场景,帮助运维和开发人员高效完成国密合规改造。

weixin_29228203的博客 385

【Simple Baselines】《Simple Baselines for Human Pose Estimation and Tracking》

ECCV-2018 文章目录1 Background and Motivation2 Advantages / Contributions3 Method3.1 Pose Estimation Using A Deconvolution Head Network3.2 Pose Tracking Based on Optical Flow4 Experiments4.1 Datasets4.2 Pose Estimation on COCO4.3 Pose Estimation and Trackin.

bryant_meng 1664

processing与arduino互动编程

Arduino开发板对AVR单片机二次编译封装,无需考虑单片机编程寄存器、地址指针等复杂细节processing借助arduino读取各种传感器的数值,控制各种机电装置。

weixin_45679408的博客 823

Simple Baselines for Human Pose Estimation 阅读笔记

近年来,姿态估计在取得重大进展的同时,总体算法和系统复杂性也日益增加,加剧了算法分析和比较的难度,本项工作提供了一个简单有效的baseline,来帮助激发并评估该领域的新想法。

AnZhiJiaShu's blog 1119

《中国电信运营商骨干网:历史、现状与未来演进》系列 第一篇:中国骨干网全景图:一级运营商与专用网络的演进

揭秘国家信息高速公路!一文读懂什么是骨干网,它如何支撑我们的数字生活,以及电信、联通、移动、广电等巨头如何构建这张“国家级动脉”。

maqh_csdn的博客 2036

MGC3130 3D手势识别传感器原理图设计,已量产(交互传感器)

最近在落地一款互动艺术装置的控制模块,选了 Microchip 的 MGC3130 做核心 —— 这颗芯片算是 GestIC® 近场传感技术的 “熟面孔” 了,把 3D 手势识别、运动跟踪的信号处理都集成在一颗芯片里,0-10cm 的检测距离刚好适配桌面级互动场景,挥挥手就能控设备的体验,放在艺术装置里确实很出效果。今天扒一下实际跑通的原理图,聊聊每个模块的设计思路。

不脱发的程序猿 367

2.翻译和笔记Multi-Task Attention-Based Semi-Supervised Learning for Medical Image Segmentation

Multi-Task Attention-Based Semi-Supervised Learning for Medical Image Segmentation的翻译与笔记

weixin_44846755的博客 1530

【ZYNQ】OV5640 图像采集与显示

OV5640 是豪威(OmniVision)半导体公司推出的高性能的 CMOS 数字图像传感器,支持最高 500 万像素图像采集,支持 RAW RGB、RGB565、YCbCr422 等图像格式输出,可应用于手机、平板等电子设备。本文主要介绍如何使用 Zynq 驱动 OV5640 摄像头进行图像采集,并通过 HDMI 实时显示。

洋洋Young的博客 1433

推荐系统中的常用算法——Wide & Deep

这篇文章是阅读《Wide & Deep Learning for Recommender Systems》后的总结,该文章中提出结合Wide模型和Deep模型的组合方法,对于提升推荐系统(Recommendation System)的性能有很重要的作用。 1、背景 本文提出Wide & Deep模型,旨在使得训练得到的模型能够同时获得记忆(memorization)...

null的专栏 3万+

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

AI核心知识77——大语言模型之Joint Training(简洁且通俗易懂版)

联合训练(Joint Training)是一种让AI系统各模块协同优化的先进策略。以RAG系统为例,传统方法独立训练检索器和生成器,导致模块间配合不佳;而联合训练通过端到端梯度传播,使各模块共享损失函数,实现整体优化。这种"一体化"训练方式让检索器学会寻找真正有用的证据,生成器获得更准确依据,从而减少幻觉、提升最终回答质量。联合训练已成为RAG 2.0和多模态模型实现流畅体验的关键技术,使各模块从"各自为政"转变为"协同进化"。

学习AI中... 800

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

推荐算法deep & wide 原理

ss

Black eyes的博客 1780

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

从经典到最新前沿,一文概览2D人体姿态估计

点击上方“小白学视觉”,选择加"星标"或“置顶”重磅干货,第一时间送达 来自 | 知乎 作者| 谢一宾0. 前言本文主要讨论2D的人体姿态估计,内容主要包括:基...

小白学视觉 5957

计算机视觉论文整理

本文梳理了2012到2017年计算机视觉领域的大事件:以论文和其他干货资源为主,并附上资源地址。囊括上百篇论文,分ImageNet 分类、物体检测、物体追踪、物体识别、图像与语言和图像生成等多个方向进行介绍。 上述的深度学习被引用最多的100篇论文是Github上的一个开源项目,社区的成员都可以参与。

snailme的博客 1万+

四篇早期人体姿态的论文

1、Learning Human Pose Estimation Features with Convolutional Networks 前面的网络回归人体关键点,重点讲一下手工的MRF和下文做对比 作者在做元统计的时候,采用直方图统计的方法来确定关节对之间的条件概率,如下图所示 如a)将fac规划到0的方向向量,统计sho出现位置,从而对sho的位置起到修正作用,最后作者

u013548568的博客 2296

一文概览2D人体姿态估计

点击上方“小白学视觉”,选择加"星标"或“置顶”重磅干货,第一时间送达来自 | 知乎 作者| 谢一宾链接|https://zhuanlan.zhihu.com/p/140060196编辑 | 深度学习这件小事公众号本文经作者授权转载,请勿二次转发0. 前言本文主要讨论2D的人体姿态估计,内容主要包括:基本任务介绍、存在的主要困难、方法以及个人对这个问题...

小白学视觉 1721

对话系统中的NLU 3.1 学术界中的方法(联合训练)

每天给你送来NLP技术干货!来自:看个通俗理解吧对话系统中的中文自然语言理解(NLU)(3.1)学术界中的方法(联合训练)Chinese Natural Language Understanding (NLU) in Dialogue Systems3.1 Academic Methods (Joint Training)目录:自然语言理解任务介绍自然语言处理中英文的区别学术界中的方法(上,联合训...

zenRRan的博客 537

Joint Training of Candidate Extraction and Answer Selection for Reading Comprehension 论文阅读笔记

Joint Training of Candidate Extraction and Answer Selection for Reading Comprehension 原文链接:http://cn.arxiv.org/pdf/1805.06145         本文是百度发表于 ACL 2018 的工作,论文利用强化学习的方法对串行的多文档阅读理解模块进行联合训练。作者提出了一种新的答案...

maka_uir的博客 1159

【人体骨骼点】算法综述

人体骨骼点综述

JNing 1917

人体姿态估计2014-2017

一、常用数据集Pose Estimation/keypoint常用数据集1. Posetrack:https://posetrack.net/> 500 video sequences> 20K frames> 150K body pose annotations3 challenges2. LSP:http://sam.johnson.io/research/lsp.htm...

hk121的博客 1413

Beyond Tree Structure Models: A New Occlusion Aware Graphical Model for Human Pose Estimation论文小摘

一、介绍      这篇文章是2015年的ICCV的文章,当时还是非常流行使用“树结构”以及“图模型”来解决“姿态估计”问题的。这篇文章的核心内容是要去解决,姿态估计过程中面临的一个挑战“遮挡”问题。文章中将遮挡分为了两类进行讨论,第一类是自遮挡,第二类是其他目标遮挡。文章提出了一个“遮挡感知图模型(occlusion aware graphical model)”二、主要内容        ...

小欧欧的博客 458

Stacked Hourglass Networks for Human Pose Estimation 文献阅读

2016EECV论文Stacked Hourglass Networks for Human Pose Estimation 文献阅读。本文亮点是使用一种沙漏状的卷积神经网络进行人体姿态估计。

arbitrator_yue的博客 571
上一篇: 【姿态估计文章阅读】Human Pose Estimation with Iterative Error Feedback【这篇文章看的虽然有点迷糊,但是最后有一点很重要,自适应scale】
下一篇: 【姿态估计文章阅读】Single-Stage Multi-Person Pose Machines【依图科技】
Jie Ou
博客等级 码龄10年 176粉丝 111原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值