slam14讲-第7讲记录-VO视觉里程记-2D,3D

TurtleBot3高质量全景图实战:从SLAM建图到可交付地图的完整工程指南 在ROS机器人开发中,SLAM建图是实现自主导航的基础能力,而‘全景图’并非简单图像输出,而是融合激光雷达、IMU、里程计等多源数据,具备几何一致性、拓扑完整性与时间稳定性的高保真环境表征。其核心依赖于TF坐标系对齐、传感器标定精度与实时性保障,直接决定TurtleBot3在真实场景中的定位可靠性与路径规划鲁棒性。本文围绕Gmapping与Cartographer两大主流方案,解析参数调优逻辑、硬件约束适配(如Burger/Waffle Pi差异)、典型环境干扰(光照、地毯、动态物体)应对策略,并提供可量化 阅读详情

slam14讲- 第7讲 视觉里程记

1.特征点提取+特征匹配

重点是通过特征点提取+特征匹配的手段获取两幅图像的相似特征点,为了后续转换关系的准确,使用了简单的粗差剔除

2. 2D-2D

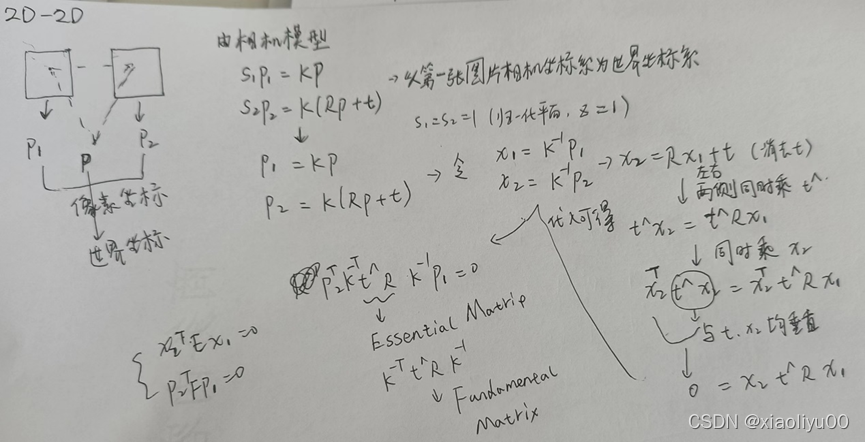
2D简单来说就是图像,有了上述两组特征点,就可以进行几何模型解算,理论上两幅图像的几何变换关系为仿射变换(特殊的非刚体变换),RANSAC粗差剔除算法本质上也是求一个最佳的几何变换模型,八点法求解是用四组点,每幅图像四个点,利用两幅图像特征匹配相互对应,可以取出四组,然后求解方程。每个点是由2维坐标写成齐次3维坐标,(u1,v1,1) = T *(u2,v2,1),已知T(3,3)=1,待求未知数为8个(9-1),需要8个方程,八个点,这样就可以求的2D-2D的几何变换关系
在这里插入图片描述

3. 3D-2D

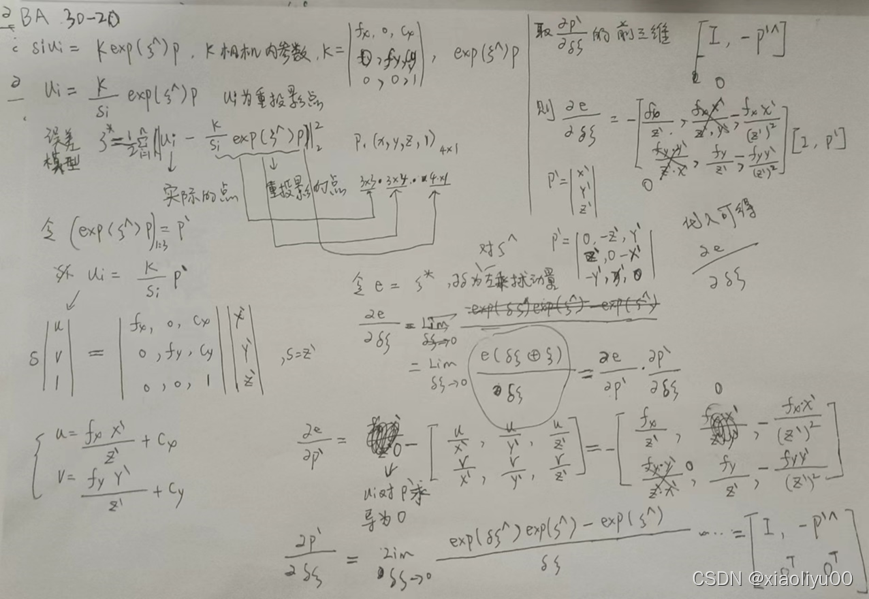
3D是三维空间点,3D-2D同样也是求解几何变换关系,3D点坐标方法包括直接变换,p3p,BA,注意这里默认第一幅图像的相机坐标系就是世界坐标系,即相机坐标系到世界坐标系的旋转矩阵为I,同样的有了对应的特征点对(对应的像素坐标),而且第一幅图像的深度已知,我们将第一幅图像的像素坐标转换为相机坐标再转换到世界坐标系,便可以得到第一幅图像对应特征点的世界坐标(Xi,Yi,Zi),直接变换方法就是假设第二幅图像对应特征点的像素坐标(ui,vi)经过转换既可得到第一幅图像对应特征点的世界坐标(Xi,Yi,Zi),同样的构造仿射变换模型求解两者的几何变换关系;p3p,类似于直接变换,借助于三对匹配点构建相似变换求解求解两者的几何变换关系;这两种方法本身不具有优化,选点后然后直接计算出3D-2D的几何变换关系,可以借鉴RANSAC粗差剔除算法中随机一致性原理,不断选点,评价模型,对模型进一步优化;***BA(Bundle Adjustment)***本身就具有优化能力,将第一幅图像对应特征点的世界坐标(Xi,Yi,Zi)转换到第二幅图像中第一幅图像对应特征点的像素坐标(u‘i,v‘i)(重投影),利用最小二乘法构造(ui,vi)和(u‘i,v‘i)的误差函数(重投影误差),通过最小化误差函数,利用李代数,不直接求旋转矩阵,求旋转变量,结算出(Xi,Yi,Zi)到(u‘i,v‘i) 几何变换关系
在这里插入图片描述

4. 3D-3D

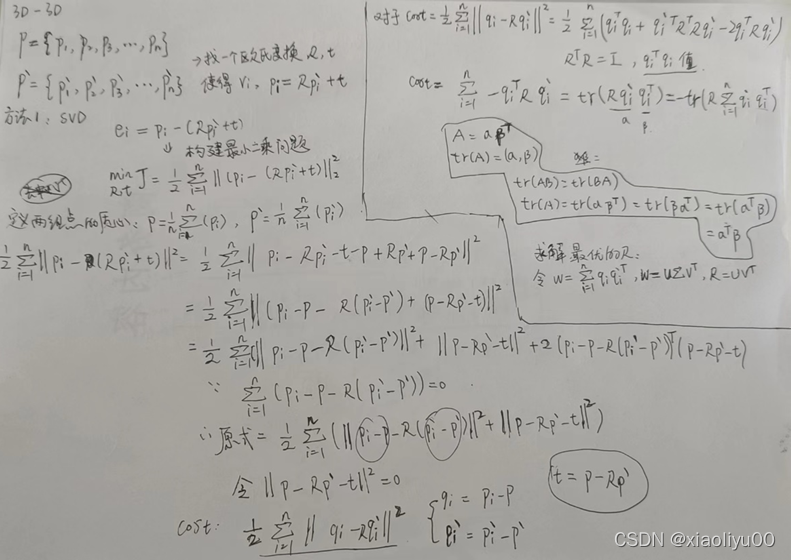
这里默认第一幅图像和第二幅图像的相机坐标系到世界坐标系的旋转矩阵均为I,注意这是两个世界坐标系,为了方便使用,相当于都设置成本身了,然后我们通过两幅图像对应的特征点对(对应的像素坐标)转换为各自的世界坐标,(X1,Y1,Z1)和(X2,Y2,Z2),那么3D-3D的几何变换关系(X1,Y1,Z1)= R*(X2,Y2,Z2)+t,仍然是仿射变换,旋转和平移,然后构建最小二乘问题,求使误差平方和达到极小的 R, t,可以是使用SVD方法和非线性优化方法,SVD方法直接求R,t,非线性优化方法利用李代数。

在这里插入图片描述

3D高斯泼溅驱动的具身导航训练方法 具身导航是让AI智能体在三维环境中理解空间、规划路径并执行动作的核心能力。其技术基础依赖于高保真、实时、可微分的3D场景表征——传统NeRF因渲染慢、不可微而难以支撑在线策略优化,而3D Gaussian Splatting(3DGS)以显式点云+高斯椭球建模,实现照片级重建与毫秒级渲染,天然适配强化学习中的世界模型需求。该技术显著降低仿真-现实鸿沟,使低成本手机图像即可构建光学一致的视觉沙盒,支撑策略网络在逼真光影、遮挡与几何约束下完成端到端训练。典型应用场景包括高校机器人算法验证、轻量级具身AI开发及S 阅读详情

相关推荐

VGGT:面向三维几何理解的前馈式视觉基础模型

视觉Transformer(ViT)虽在图像识别中广泛应用,但其基于自注意力的全局建模机制缺乏对三维空间结构的显式建模能力,导致在深度估计、位姿回归等几何敏感任务中存在归纳偏置错配。VGGT并非VGG与Transformer的简单组合,而是一种以可微分几何算子(如重投影、法向量聚合、极线约束)替代传统注意力的新型架构,将视觉理解重新锚定于物理世界的几何先验。它不依赖QKV投影或残差连接,而是通过前馈式、确定性的空间运算直接输出深度、法向量等三维几何量,显著提升单目3D重建、AR平面拟合与工业精密测量等场景的

306

视觉slam14讲 ch7 / pose_estimation_3d2d.cpp 实现过程

【代码】视觉slam14讲 ch7 / pose_estimation_3d2d.cpp 实现过程。

weixin_62952541的博客 666

四足机器人图书馆自主导航:LiDAR与深度相机融合方案

自主导航是服务机器人落地的核心能力,其本质是在未知环境中实现高精度定位、动态建图与安全路径规划。在弱纹理、高动态、多障碍的室内场景中,单一传感器往往面临点云稀疏、深度失效或语义缺失等瓶颈。LiDAR凭借毫米级测距稳定性成为几何感知基石,而深度相机则提供稠密空间信息与目标语义理解能力——二者融合并非简单叠加,而是通过时空同步、因子图优化与语义-几何逻辑校验,构建鲁棒的环境认知闭环。该技术路线已广泛应用于图书馆、医院、档案馆等对安全性、厘米级贴边行驶与实时避障要求严苛的公共服务场景,为特种机器人从实验室走向真实

ainixi7099的博客 340

【视觉SLAM十四讲】第7讲 视觉里程计1

第7讲 视觉里程计1

博客标题不能为空我也没办法 2943

视觉slam十四讲第ch7-PNP-3d2d手写位姿估计代码详解

视觉slam十四讲第ch7 PNP 3d2d手写位姿估计代码详解 最近在学习视觉slam十四讲,不管是书上内容还是高博视频,描述的都很细致。关于此书的资料博客也可以比较方便的在网上找到。但是因为此书除了第二版,一些代码什么的是第二版独有的,网上资料还没那么丰富。 今天在学到手写位姿估计的内容时就发现内容和代码都似懂非懂,网上的资料又不充分,因此花了很多时间去解决,现把pose_estimation_3d2d.cpp的代码手写高斯牛顿法片段和我的注释版附上,不一定对,但是应该会对初学者有一些帮助。 void

jiny_yang的博客 1889

DAVIS第五课: 基于事件相机的一种几何实时3DSLAM算法

对论文A geometric approach to event-based 6-DOF parallel tracking and mapping in real-time的解读和记录 1. 摘要 提出一种基于事件相机的VO算法, 我们的算法充分体现了事件相机的杰出属性,它能够在获取3D稠密地图的同时追踪相机的快速运动。 由于事件相机的特性, 我们的算法不受运动模糊的影响,且能够在很多高挑战...

Ian的博客 1335

SLAM精度评估—从二维到三维

点击上方“3D视觉工坊”,选择“星标”干货第一时间送达作者丨lovely_yoshino来源丨古月居简介最近在群里划水时,看到很多初学的SLAMer面对精度评估这个问题无从下手。而精度评估确实是在SLAM算法实际评估中急需一种手段和工具,本文将从2维室内和3维室外两个层面来向各位展示如何通过各种手段来对SLAM算法完成。2D评估—基于cartographer室内的评估方案...

3D视觉工坊 2355

【信息科学与工程学】【制造工程】第三十六篇 机械工程与自动化101

本系统通过多模型集成、知识增强、主动学习和持续优化等关键技术,实现了高效、高质量的自动化文本语料标注。系统采用模块化设计,支持灵活扩展,能够处理不同类型的文本数据,适应多样的标注需求。

weixin_49199313的博客 959

slam实践--(简易vo)3d-2d位姿估计

slam实践--(简易vo)3d-2d位姿估计

weixin_43151193的博客 1394

inferCNV包安装问题及解决办法

InferCNV是一个由broad研究所开发的,利用单细胞转录组数据分析肿瘤细胞拷贝数变异(CNV)的工具。基本思路是在整个基因组范围内,通过计算肿瘤细胞关于参考的“正常”细胞的相对表达,利用滑窗思想对邻近的基因相对表达,计算拷贝数。 先贴一个官方安装说明: 官方infercnv安装说明 安装infercnv包: if (!requireNamespace("BiocManager", quietly = TRUE)) install.packages("BiocManager") BiocManager:

m0_51042606的博客 6803

相机标定-机器视觉基础(理论推导、Halcon和OpenCV相机标定)

相机标定是获得目标工件精准坐标信息的基础。首先,必须进行相机内参标定,构建一个模型消除图像畸变;其次,需要对相机和机器人的映射关系进行手眼标定,构建一个模型将图像坐标系上的点映射到世界坐标系。主要分为背景知识、相机内外参模型推导、编程代码实现三个部分。

beyond951的博客 7300

视觉SLAM十四讲第二版-CH7-Ubuntu18.04-运行报错recipe for target ‘pose_estimation_3d2d‘ faile和修改CMakelists.txt解决记录

视觉SLAM十四讲第二版-CH7-Ubuntu18.04-运行报错和修改CMakelists.txt解决记录: 问题描述: 先放修改后的CMakelists.txt再解释: cmake_minimum_required(VERSION 2.8) project(vo1) set(CMAKE_BUILD_TYPE "Release") add_definitions("-DENABLE_SSE") set(CMAKE_CXX_FLAGS "-std=c++11 -O2 ${SSE_FLAGS} -msse

jes_sun的博客 2194

保姆级教程:RK3588部署yolo目标检测模型

RK3588部署yolo目标检测模型非常详细的保姆级教程

ling913的专栏 5483

slam14讲第7讲记录:VO视觉里程计2D-3D位姿估计与TaoToken调试通道

啃《视觉SLAM十四讲》第7讲VO视觉里程计时,PnP求解常卡在鉴权配置。本文用config.json管理TaoToken的Base URL与API Key,嵌入3D-2D位姿估计脚本,并排查401、local proxy failed等报错。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 提供统一调试通道。

weixin_42593130的博客 60

将3DMax编辑的动画,导入给已经绑定蒙皮好的模型给Unity使用

现在程序猿想做独立游戏,即容易,也难。 说容易,引擎越来越傻瓜化。 说难,到哪去找靠谱的美术? 好在伟大的AssetStore(还有淘宝上)有大批不赖的资源可以用。 现成的模型,是好,但是,没有配套的动作,却是一件让人头疼的事情,即使用IK动画,也不能完美的弥补这一缺陷。 虽然Unity具备 retargeting 功能,但是,也不是万能的,很多情况下,非标准的骨骼会导致

正经的时候都在打游戏 1万+

具身智能ACT模型在lerobot机械臂上的实践与优化

本文详细介绍了如何在低成本lerobot机械臂上实践与优化具身智能ACT模型。从环境搭建、数据采集到模型原理与代码实战,提供了完整的入门指南。重点分享了通过数据增强、混合开源数据集及模型微调等策略,有效提升模型在抓取放置任务中的泛化能力与鲁棒性,为机器人学习爱好者提供了宝贵的实战经验。

weixin_29081703的博客 167

视觉slam14讲——第9讲 设计前端

本系列文章是记录学习高翔所著《视觉slam14讲》的内容总结,文中的主要文字和代码、图片都是引用自课本和高翔博士的博客。代码运行效果是在自己电脑上实际运行得出。手动记录主要是为了深入理解 涉及到的主要内容如下 设计一个视觉里程计前端 理解slam软件框架的搭建 理解前端设计容易出现的问题及解决方式 [TOC] 1 搭建VO框架1.1 确定程序框架 bin用来存放可执行二进制文件 include/

leeayu的博客 4518

全国青少年信息素养大赛图形化(Scratch)编程考点总结

全国青少年信息素养大赛图形化(Scratch)编程考点总结

伶俐角少儿编程 380

《视觉SLAM十四讲》ch7视觉里程计1学习笔记(4)——实践部分:求解PnP pose_estimation_3D2D

在这篇博客中主要记录了我对《视觉SLAM十四讲》第七讲视觉里程计1中实践部分,求解PnP,3d和2d点求解相机位姿的代码的学习笔记。

weixin_70026476的博客 1050

37、OpenMP:并行编程的强大工具

本文详细介绍了 OpenMP 的核心功能和使用方法,包括执行环境例程、线程同步与协调机制,如关键区域、屏障、原子操作、归约子句、刷新构造和锁机制。此外,还提供了多个实践练习,涵盖矩阵乘法的并行实现、任务池与流水线模式的应用、读写锁的扩展与移植,以及客户端-服务器模式的实现与优化。通过这些内容,读者可以全面掌握 OpenMP 在并行编程中的实际应用与性能优化技巧。

www00的博客 101

手把手教你学AI GPU UMD驱动软件开发专栏--1.1 UMD(用户模式驱动)的定义与定位

摘要:UMD(用户模式驱动)是GPU驱动架构中的关键组件,负责连接AI应用与硬件。作为运行在用户空间的动态链接库,UMD通过减少系统调用开销显著提升AI计算性能。其核心功能包括API转换、资源管理和命令生成,同时具备安全性高(崩溃不影响系统)、开发灵活等优势。随着AI发展,UMD已从图形驱动演变为深度学习加速的关键组件,支持TensorCore等硬件特性优化。未来趋势包括深度框架集成、硬件感知增强和虚拟化支持。UMD通过性能优化和安全隔离机制,成为现代AI计算基础设施的理想选择。

MHD0815的博客 170

机器人算法岗求职攻略:视觉感知与AI决策核心考点速成

计算机视觉与人工智能决策是机器人领域的核心技术支柱。计算机视觉通过传感器(如相机)获取环境信息,涉及特征提取、目标检测与三维重建等基础任务,其核心原理在于从图像数据中解析并理解物理世界。AI决策模型则基于感知信息,通过强化学习、深度学习等方法进行规划与控制,其技术价值在于赋予机器人自主适应与决策能力。这两项技术共同构成了机器人的“眼睛”与“大脑”,广泛应用于自动驾驶、移动机器人及工业自动化等场景。本文聚焦于机器人算法岗位求职,针对视觉传感器感知层与AI决策模型两大核心模块,提供了一套系统的学习路径与实战指南

weixin_34406086的博客 415

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

激光SLAM室内无源定位实践:无人机从选型、调参到飞行测试全记录

在无GPS的室内环境中,无人机自主飞行面临定位难题。SLAM(同步定位与建图)技术通过激光雷达获取环境点云,并结合IMU数据进行位姿估计,成为当下无源定位的主流方案。这项技术无需外部基站,仅靠机载传感器即可构建栅格地图并实现厘米级定位,广泛应用于室内巡检、仓储物流与无人机航测场景。然而实际工程中,点云畸变、长廊退化、时间同步及外参标定等问题都会影响定位精度。本文基于一台中型多旋翼平台的实测经验,完整记录了从激光SLAM方案选型、Cartographer参数调试到分阶段飞行测试的过程,给出了可复现的误差数据与

weixin_34274029的博客 189

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

ROS2下通过micro XRCE-DDS实现PX4基于SLAM位姿定位操作方法详解

本文主要是介绍在ROS2下如何通过micro XRCE-DDS实现PX4基于SLAM位姿的定位,同时结合px4代码进行了详细的分析,基于micro XRCE-DDS把/fmu/in/vehicle_visual_odometry话题桥接到PX4内部的方法,相比于向mavros发送/mavros/vision_pose/pose话题的方法,个人觉得它的优点有两个,一个可以在SLAM运行时动态调整协方差,一个是有reset_counter,能够应对SLAM位姿跳变的情况(比如回环,重定位),这些都是对基于SLA

自主无人机 PX4 ROS SLAM 路径规划 MVS等技术分享 499

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

视觉SLAM十四讲 第7讲 (3) 相机运动估计 2D-2D/3D-2D/3D-3D

视觉SLAM十四讲第7讲 (3) 相机运动估计 2D-2D/3D-2D/3D-3D 理解与笔记

CSSDCC的博客 5953

视觉SLAM的二维和三维点的特征匹配,位姿估计的方法总结

视觉SLAM的二维和三维点的特征匹配,位姿估计的方法总结

啥也不懂的研究生也淦SLAM的博客 2921
上一篇: 剑指offer-刷题笔记-简单题-JZ50 第一个只出现一次的字符
下一篇: 剑指offer-刷题笔记-简单题-JZ53 数字在升序数组中出现的次数
xiaoliyu00
博客等级 码龄9年 4180粉丝 122原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值