超详细!字节公开Seedream 2.0文生图技术报告!

Python实战:5分钟搞定doubao-seedream-4.0 API图像生成(附完整代码) 本文详细介绍了如何快速使用Python和requests库调用doubao-seedream-4.0 API进行AI图像生成与编辑。通过完整的代码示例,从环境配置、基础文生图请求,到进阶的图像编辑、多图输入以及健壮的异常处理与重试机制,为开发者提供了五分钟内即可上手的实战指南,助力高效集成AI图像生成能力。 阅读详情

🌐 社群导航

🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗 点击加入➡️【2-3月CCF投稿】交流群

数源AI 最新论文解读系列

图片

论文名:Seedream 2.0: A Native Chinese-English Bilingual Image Generation Foundation Model

论文链接:https://arxiv.org/pdf/2503.07703

开源代码:https://team.doubao.com/tech/seedream
图片

导读

随着扩散模型的显著进步,图像生成领域经历了快速扩张。最近出现的强大模型,如 Flux、SD3.5 、表意文字 2.0(Ideogram 2.0)和 Midjourney 6.1 引发了广泛的商业应用浪潮。然而,尽管现有基础模型取得了显著进展,但它们仍面临一些挑战。

  • 模型偏差:现有模型倾向于特定方面,例如 Midjourney 注重美学,却牺牲了其他方面的性能,如遵循提示或结构正确性。

  • 文本渲染能力不足:在长内容或多语言(尤其是中文)中进行准确文本渲染的能力相当有限,而文本渲染是一些重要场景(如图形设计和海报设计等设计场景)的关键能力。

  • 对中文特色理解不足:缺乏对当地文化(如中国文化)独特特征的深入理解,而这对当地设计师至关重要。

简介

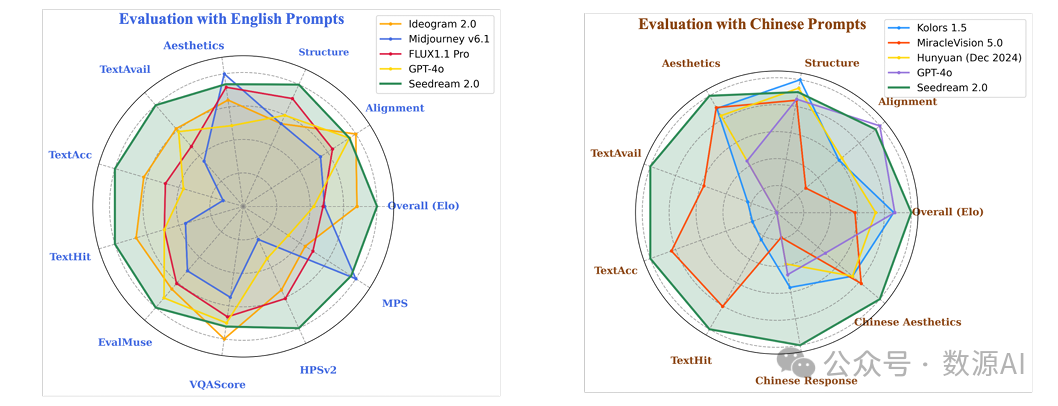
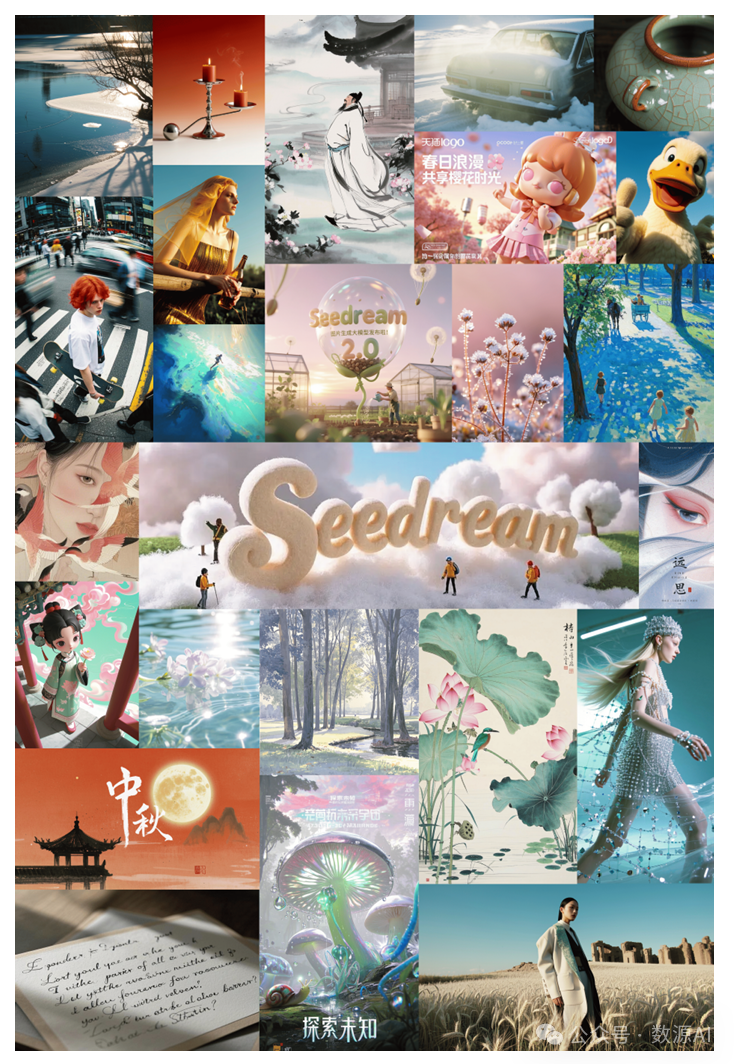
为解决这些局限性,我们推出了Seedream 2.0,这是一款原生中英双语图像生成基础模型,在多个维度表现出色,能够熟练处理中文和英文文本提示,支持双语图像生成和文本渲染。我们开发了一个强大的数据系统以促进知识整合,以及一个兼顾图像描述准确性和丰富性的字幕系统。特别地,Seedream集成了自研的双语大语言模型(LLM)作为文本编码器,使其能够直接从海量数据中学习原生知识。这使得它能够生成具有准确文化内涵和美学表达的高保真图像,无论是用中文还是英文描述。此外,应用了字形对齐的ByT5进行灵活的字符级文本渲染,同时缩放旋转位置编码(Scaled ROPE)在未训练的分辨率上也有良好的泛化能力。多阶段的后训练优化,包括有监督微调(SFT)和基于人类反馈的强化学习(RLHF)迭代,进一步提升了整体性能。通过大量实验,我们证明了Seedream 2.0在多个方面达到了最先进的性能,包括遵循提示、美学效果、文本渲染和结构正确性。此外,Seedream 2.0经过多次RLHF迭代优化,其输出与人类偏好高度一致,这从其出色的ELO得分中可见一斑。此外,它可以轻松适配基于指令的图像编辑模型,如SeedEdit [28],具有强大的编辑能力,能够兼顾遵循指令和图像一致性。
图片

数据预处理

本节详细介绍我们用于预训练的数据处理流程,包括数据构成、数据清洗和过滤、主动学习、添加字幕以及文本渲染数据等各种预处理步骤。这些过程确保最终的预训练数据集具有高质量、大规模和多样性。

1. 数据构成

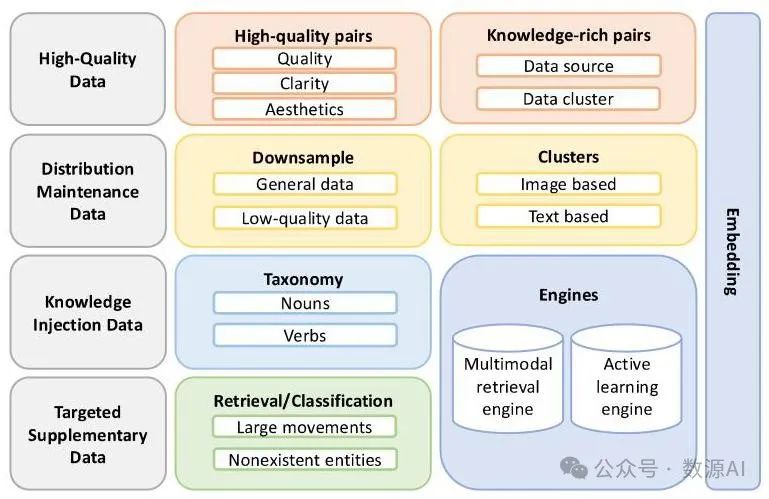
我们的预训练数据精心选自四个主要部分,确保数据集平衡且全面,如图3所示。
图片

图3 预训练数据系统。

高质量数据。这部分数据包括图像质量极高且知识内容丰富的数据,评估依据为清晰度、美感和来源分布。
图片

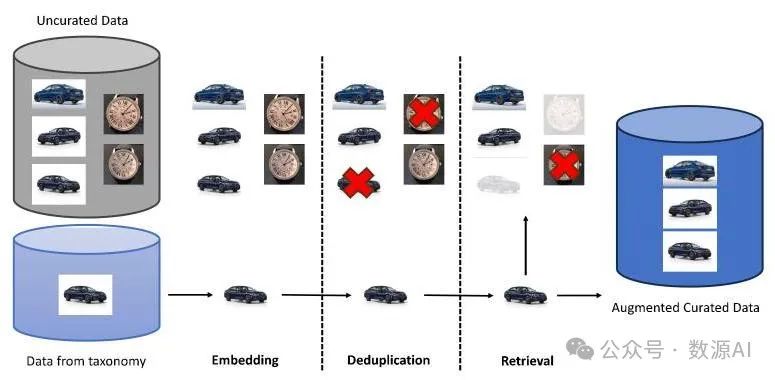
图4 我们的知识注入过程概述。

分布维护数据。这部分数据通过以下方式在减少低质量数据的同时保持原始数据的有用分布:

  • 按数据源降采样:减少过度代表的数据源的比例,同时保留它们的相对大小关系。

  • 基于聚类的采样:基于多个层次的聚类对数据进行采样,从代表更广泛语义(如视觉设计)的聚类到代表更精细语义的聚类,例如CD/书籍封面和海报。

知识注入数据。这部分使用已开发的分类法和多模态检索引擎进行知识注入,如图4所示。它包括具有独特中文语境的数据,以提高模型在特定中文场景下的性能。

此外,我们还手动收集了一小批具有独特中文语境的数据。该数据集包括与特定中文人物、动植物、美食、场景、建筑和民俗文化相关的图像 - 文本对。我们使用多模态检索引擎来扩充这些中文知识并将其融入我们的生成模型。

定向补充数据。我们用在文本到图像任务中表现欠佳的数据来补充数据集,例如面向动作的数据和反事实数据(如“脖子是气球的男人”)。我们的主动学习引擎对这些具有挑战性的数据点进行分类,并将其整合到最终的训练集中。

2. 数据清理流程

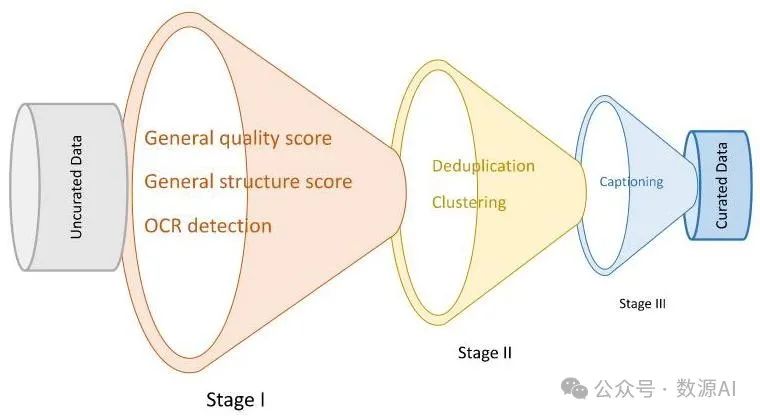
如图5所示,数据清理程序通过逐步精细的数据过滤方法来确保数据集的质量和相关性。
图片

图5 我们的数据清理流程概述。

第一阶段:总体质量评估。我们使用以下标准对整个数据库进行标注:

  • 总体质量得分:评估图像清晰度、运动模糊和无意义内容。

  • 总体结构得分:评估水印、文本覆盖、贴纸和标志等元素。

  • 光学字符识别(OCR)检测:识别并分类图像中的文本。

不符合质量标准的样本将被剔除。

第二阶段:详细质量评估。此阶段包括专业美学评分、特征嵌入提取、去重和聚类。聚类采用多层次结构,代表不同的语义类别。为每个数据点分配一个语义类别标签,以便后续调整分布。

第三阶段:添加说明和重新添加说明。我们对剩余数据进行分层,并添加说明或重新添加说明。较高级别的数据通常会获得更丰富的新说明,从不同角度进行描述。添加说明过程的详细信息见2.4节。

3. 主动学习引擎

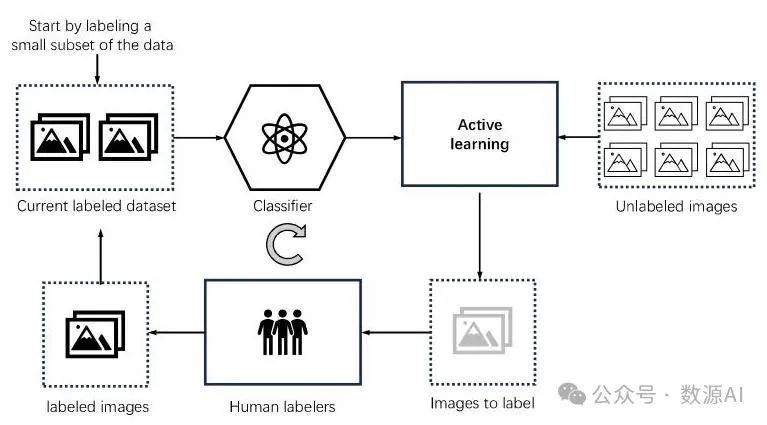
如图6所示,我们开发了一个主动学习系统来改进我们的图像分类器。这是一个迭代过程,逐步优化我们的分类器,确保为训练提供高质量的数据集。
图片

图6 主动学习生命周期流程图。

4. 图像说明添加

添加说明的过程为每张图像提供有意义且上下文准确的描述,生成通用说明和专业说明。

4.1. 通用说明文字

我们用中文和英文编写了简短和详细的说明文字,以确保描述准确且详尽:

  • 简短说明文字:准确描述图像的主要

Seedream 2.0技术解析:中文文生图的语义-字形双编码与全链路工程实践 文生图模型的核心挑战在于文本理解与视觉生成的精准对齐,尤其在中文场景下,需同时攻克语义建模、文字渲染、文化适配三大难题。其原理依赖于文本编码器对汉字语义的深度捕捉与字符级字形表征的协同建模,并通过DiT架构、多阶段数据清洗、VMix美学注入及三reward RLHF等系统性工程手段提升生成质量。该技术路径显著提升了中文提示词响应能力与生产级稳定性,广泛适用于AIGC内容创作、古籍数字化、电商设计及中国文化IP生成等场景。Seedream 2.0正是这一思路的典型落地,其Glyph-ByT5字符编码与自研双语 阅读详情

相关推荐

即梦4.0(doubao-seedream-4-0-250828)API实战:从零构建多模态图像生成应用

本文详细介绍了如何利用即梦4.0(doubao-seedream-4-0-250828)API从零构建多模态图像生成应用。内容涵盖API核心功能、开发环境配置、基础文生图调用,并深入实战电商背景替换与多图融合等高级技巧,同时提供提示词撰写与性能优化等避坑指南,帮助开发者高效集成一站式AI绘画能力。

weixin_29041767的博客 567

AI免费工具-图像生成模型:豆包图像生成seedream使用

参考:技术模型。

weixin_42357472的博客 5737

### Seedream 2.0:一个原生中文-英文双语图像生成基础模型

内容概要:Seedream 2.0 是一个先进的原生中英文双语图像生成基础模型,旨在解决现有图像生成系统中的模型偏差、文本渲染能力不足以及对文化细微提示理解缺陷等问题。该模型通过自研的双语大语言模型(LLM)作为文本编码器,学习中英文中的本土知识,从而能够高保真地生成与文化相关的内容。模型采用 Glyph-Aligned ByT5 进行字符级文本渲染,并通过 Scaled ROPE 实现分辨率泛化。通过多阶段的监督微调(SFT)和人类反馈对齐(RLHF)迭代优化,Seedream 2.0 在提示遵循、美学质量、结构正确性和人类偏好对齐方面表现出色,特别是在中文文本渲染和文化特定场景生成方面表现尤为突出。 适合人群:对图像生成技术感兴趣的开发者、设计师、研究人员以及需要高质量图像生成工具的企业和个人。 使用场景及目标:① 支持双语图像生成和文本渲染任务,适用于平面设计、海报设计等场景;② 提供高保真的图像生成能力,支持复杂提示和文化细微差别的处理;③ 适应基于指令的图像编辑模型,具有强大的编辑能力,能够平衡指令跟随与图像一致性。 其他说明:Seedream 2.0 已被整合到多个平台,如Doubao(豆包)和Dreamina(即梦),并赢得了广泛赞誉。该模型不仅在技术上进行了创新,还在实际应用中展示了卓越的性能和潜力,希望成为提高工作和日常生活生产力的有效工具。

开源豆包Seedream 4.0文生图工具[代码]

作者Maynor开源了一款基于字节跳动豆包大模型Seedream 4.0的文生图Web应用,旨在让用户无需复杂配置即可免费体验AI绘画。该工具支持文生图和图生图功能,用户只需通过浏览器访问即可使用。项目完全开源,前端采用HTML、CSS和JavaScript实现,部署在GitHub Pages上。作者提醒用户注意API密钥的安全问题,建议二次开发时搭建后端服务管理密钥。项目旨在让更多人体验AI技术的魅力,欢迎用户反馈和建议。

DCDC--控制方式(Control Mode)

DCDC反馈控制方式

网始如芯个人博客 1万+

【论文阅读|小目标分割算法ASF-YOLO】

论文题目:ASF-YOLO: A novel YOLO model with attentional scale sequence fusion for cell instance segmentation 论文链接: https://arxiv.org/abs/2312.06458 代码链接:https://github.com/mkang315/ASF-YOLO 摘要(Abstract) 作者提出了一种新颖的基于 "You Only Look Once"(YOLO)的注意力尺度序列融合框架(ASF-YO

dally2的博客 8118

概率论与数理统计基础概念与重要定义汇总

文章目录一、随机事件和概率1:互斥,对立,独立事件的定义和性质。2:概率,条件概率和五大概率公式3:古典型,几何型概率和伯努利试验 一、随机事件和概率 1:互斥,对立,独立事件的定义和性质。 互斥事件\color{red}\textbf{互斥事件}互斥事件 事件A和B的交集为空,A与B就是互斥事件,也叫互不相容事件。也可叙述为:不可能同时发生的事件。如A∩B为不可能事件(A∩B=Φ),那么称事件A与事件B互斥,其含义是:事件A与事件B在任何一次试验中不会同时发生。 则P(A+B)=P(A)+P(B)(这个公

csyifanZhang的博客 1万+

安卓-折叠屏平行视界适配(多厂商兼容与优先级实战)

本文详细解析了安卓折叠屏平行视界适配的现状与挑战,重点探讨了多厂商兼容性策略和优先级冲突的实战解决方案。通过对比Google的Embedding方案和国内厂商的EasyGo标准,提供了检测设备支持方案、处理优先级冲突及双方案共存的最佳实践,帮助开发者高效完成折叠屏适配。

weixin_29190169的博客 165

声音源定位:利用YOLO与麦克风阵列定位声音来源YOLOv5、YOLOv8、YOLOv10

YOLO(You Only Look Once)是一个用于目标检测的深度学习模型。YOLO的最大特点是其通过一次前向传播即可完成多个目标的检测,速度和精度相对其他目标检测算法具有显著优势。YOLO模型的版本不断更新,从YOLOv1到YOLOv10,算法精度和速度都有了显著的提升。声音源定位是利用多个麦克风阵列收集的声音信号,通过算法计算声音源的位置。声音源定位的关键在于准确估计每个麦克风的声音到达时间,从而确定声音源的空间坐标。基于时延估计(TDOA)

YOLO 673

大疆A型板使用经验分享(四)—— PWM和舵机SG996的控制

一. j

weixin_43361652的博客 3881

【实验必备】对AffectNet数据集进行人脸对齐的小Demo

本文首先简单介绍了AffectNet数据集,及人脸关键点等背景知识,接着Po出了人脸对齐的代码及效果展示。注:本文代码参考自FG2021的Emotion-GCN的开源代码,具有一定的可靠性,欢迎大家学习!

信小海 2673

基于唤醒音频的目标说话人语音识别系统设计报告

摘要 本报告设计了一套基于唤醒音频的目标说话人语音识别系统,通过五级流水线架构(唤醒检测→声纹注册→语音分离→目标ASR→拒识决策)解决复杂声学场景下的目标说话人识别问题。系统整合ECAPA-TDNN声纹模型、Conv-TasNet语音分离网络和Whisper ASR引擎,在L20 GPU上实现高效端到端推理,支持-5dB~5dB SNR范围和0~100%重叠率的双人语音场景处理。系统在目标说话人CER、拒识率和推理效率等关键指标上均达到设计目标,为智能语音交互提供了有效的身份感知解决方案。

huanghm88的专栏 73

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

上一篇: 浙大联合上海AI Lab提出Astrea!基于MoE的MLLM新框架!
下一篇: 港中文联合字节提出CameraCtrl II!Camera-Control视频生成模型实现大规模动态场景!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值