实时识别任何物体!清华提出YOLOE!高效开放场景的开放提示检测和分割!

清华大学团队YOLOE的基础理论知识 该模型支持文本提示、视觉提示及全自动检测三种模式,在保留YOLO系列骨干网络、特征金字塔和分割/回归头的基础上,创新性地优化了视觉-文本语义对齐机制,通过轻量级辅助网络提升开放场景下目标识别的泛化能力,同时采用解耦式视觉提示编码降低计算复杂度,兼顾检测精度与实时性,成功打破传统模型对预定义类别的依赖,为自动驾驶、机器人视觉等动态开放环境提供灵活可靠的视觉理解解决方案。PAN的核心思想是在FPN的基础上增加一个从深层特征到浅层特征的传播路径,以增强低层特征的定位能力,同时保留高层特征的语义信息。 阅读详情
AI摘要

本文介绍了清华提出的YOLOE模型,它集成了跨多种开放提示机制的检测和分割功能,可实时识别任何物体。文中详细阐述了其模型架构、支持不同提示的策略及训练目标,通过大量实验表明,YOLOE具有卓越的零样本性能、可迁移性,推理效率高且训练成本低。

🌐 社群导航

🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗 点击加入➡️【2-3月CCF投稿】交流群

数源AI 最新论文解读系列

论文名:YOLOE:Real-Time Seeing Anything

论文链接:https://arxiv.org/pdf/2503.07465

开源代码:https://github.com/THU-MIG/yoloe
导读

目标检测和分割是计算机视觉中的基础任务,广泛应用于自动驾驶、医学分析和机器人技术等领域。像YOLO系列这样的传统方法利用卷积神经网络实现了卓越的实时性能。然而,它们对预定义目标类别的依赖限制了在实际开放场景中的灵活性。此类场景越来越需要能够在文本、视觉线索等多种提示机制引导下,甚至无需提示就能检测和分割任意目标的模型。

简介

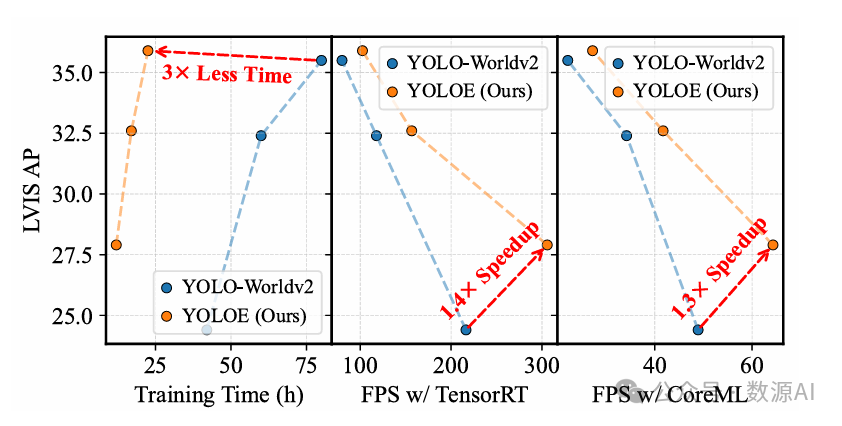
目标检测和分割在计算机视觉应用中被广泛采用,然而像YOLO系列这样的传统模型虽然高效且准确,但受限于预定义的类别,在开放场景中的适应性受到阻碍。近期的开放集方法利用文本提示、视觉线索或无提示范式来克服这一问题,但由于高计算需求或部署复杂性,往往在性能和效率之间进行折衷。在这项工作中,我们推出了YOLOE,它在一个高效的单一模型中集成了跨多种开放提示机制的检测和分割功能,实现了实时识别任何物体。对于文本提示,我们提出了可重参数化区域 - 文本对齐(Re - parameterizable Region - Text Alignment,RepRTA)策略。该策略通过一个可重参数化的轻量级辅助网络优化预训练的文本嵌入,并以零推理和迁移开销增强视觉 - 文本对齐。对于视觉提示,我们提出了语义激活视觉提示编码器(Semantic - Activated Visual Prompt Encoder,SAVPE)。它采用解耦的语义和激活分支,以最小的复杂度带来改进的视觉嵌入和准确性。对于无提示场景,我们引入了惰性区域 - 提示对比(Lazy Region - Prompt Contrast,LRPC)策略。它利用内置的大词汇表和专门的嵌入来识别所有物体,避免了对高成本语言模型的依赖。大量实验表明,YOLOE具有卓越的零样本性能和可迁移性,推理效率高且训练成本低。值得注意的是,在LVIS数据集上,YOLOE - v8 - S以更低的训练成本和的推理加速,比YOLO - Worldv2 - S的平均精度(AP)高出3.5。当迁移到时,与封闭集的YOLOv8 - L相比,在训练时间减少近的情况下,实现了的提升和0.4的提升。

方法与模型

在本节中,我们详细介绍YOLOE的设计。基于YOLO系列(3.1节),YOLOE通过RepRTA(3.2节)支持文本提示,通过SAVPE(3.3节)支持视觉提示,并通过LRPC(3.4节)支持无提示场景。
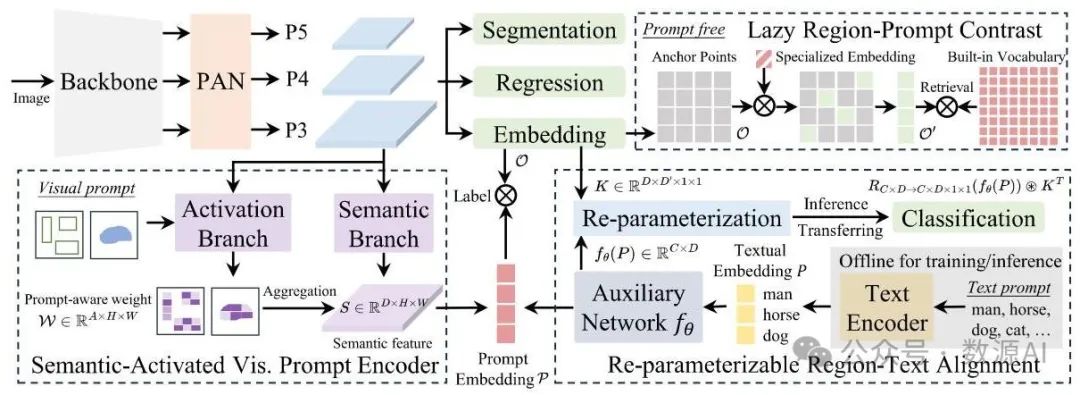
图2. YOLOE(一种目标检测和分割模型)概述,它支持多种开放提示机制下的检测和分割任务。对于文本提示,我们设计了一种可重新参数化的区域 - 文本对齐策略,以在零推理和迁移开销的情况下提高性能。对于视觉提示,采用SAVPE(一种视觉提示编码方法)以最小的成


【多模态目标检测】yoloe(“ye“)文章翻译 对于文本提示,我们提出了可重参数化区域 - 文本对齐(RepRTA)策略。该策略通过一个可重参数化的轻量级辅助网络对预训练的文本嵌入进行优化,并在零推理和迁移开销的情况下,增强了视觉与文本的对齐。该策略使用一个轻量级辅助网络来改进预训练的文本嵌入,以实现更好的视觉 - 语义对齐。在训练过程中,预先缓存的文本嵌入仅需辅助网络来处理文本提示,与封闭集训练相比,产生的额外成本较低。在推理和迁移过程中,辅助网络可无缝地重参数化为分类头,得到与 YOLO 模型相同的架构,且零开销。 阅读详情

相关推荐

YOLO-E:详细信息

YOLO-E 的出现,是一项突破性的进步,有望彻底改变机器观察和理解周围世界的方式。通过处理较低维度(A=16 vs. D=通常为 256 或 512)的视觉提示,SAVPE 在保持模型轻量级的同时实现了强大的性能。虽然其他模型也尝试过类似的功能,但 YOLO-E 却以卓越的效率实现了这一目标——与 YOLO-World 等同类模型相比,训练速度提高了 3 倍,运行速度提高了 1.4 倍。实时检测和分割任意物体的能力为需要快速适应不断变化的环境或用户需求的应用程序开辟了新的可能性。

2501_91623519的博客 1852

yoloe 超过yolox和yolov5

PP-YoLoE | PP-YoLov2全面升级Anchor-Free,速度精度完美超越YoLoX和YoLov5 PP-YOLOE是基于PP-YOLOv2的卓越的单阶段Anchor-free模型,超越了多种流行的yolo模型。PP-YOLOE有一系列的模型,即s/m/l/x,可以通过width multiplier和depth multiplier配置。PP-YOLOE避免使用诸如deformable convolution或者matrix nms之类的特殊算子,以使其能轻松地部署在多种多样的硬件上..

jacke121的专栏 6185

YOLOE:清华开源!实时感知一切的统一开放视觉检测模型

YOLOE是清华大学团队为开放集视觉检测带来的颠覆性成果,通过RepRTA、SAVPE、LRPC三大原创策略,首次实现了多范式开放提示、检测+分割、实时高效、训练轻量的四重统一。相比现有SOTA模型,YOLOE在性能、效率、成本上全面领先,且能无缝兼容传统封闭集检测,真正做到“一个模型,看见一切”。作为开源项目,YOLOE的代码和预训练模型已全部开放,为计算机视觉研究者和工程师提供了全新的开放检测基线,也为YOLO系列的未来发展指明了开放集的方向。

weixin_43745234的博客 125

【PyTorch项目实战】YOLOE(实时感知一切)

摘要: Ultralytics YOLO 生态系统提供多任务支持,包括目标检测、实例分割、图像分类等。YOLOE是新一代视觉感知模型,统一了目标检测、实例分割等任务,具备实时性、多任务处理能力,支持文本/视觉提示和内部词汇表三种交互方式。其架构包含Backbone、Neck和Head三个模块,提供不同规模的模型(S/M/L等)以适应速度与精度需求。视觉提示分割(VPSeg)通过矩形框、掩码或类别ID引导模型关注特定区域,但对不封闭目标或未训练数据表现受限。YOLOE支持自动下载预训练权重,简化部署流程。

📷 图像处理践行者 | 传统算法 · 深度学习 · 多模态 | 分享实战经验与技术洞见,探索从像素到智能的无限可能。 1238

YOLOE详解[源码]

YOLOE是一种针对新类别或开放世界场景的模型,支持零样本推理和定制化文本提示。其架构在YOLO基础上进行了多项创新:1. 通过RepRTA支持文本提示,利用重参数化技术提升学习表达能力;2. 通过SAVPE支持视觉提示,将视觉特征转换为语义感知的视觉prompt嵌入;3. 使用LRPC支持无提示场景,通过对比机制实现零样本类别分配。此外,YOLOE在实例分割部分也有关键设计,如Prompt-aware分割增强、可重参数化区域-文本对齐对分割的加持,以及Lazy Region-Prompt Contrast的Prompt-Free分割机制,这些设计显著提升了分割质量和语义一致性。

MATLAB仿真实战:双有源桥(DAB)变换器的扩展移相调制(EPS)全流程解析

本文提供了一份详细的MATLAB/Simulink仿真实战指南,手把手解析双有源桥(DAB)变换器在扩展移相调制(EPS)下的全流程建模。内容涵盖从核心原理、主功率电路搭建、EPS驱动信号生成,到仿真运行、波形分析及模型优化的完整步骤,旨在帮助工程师和研究者快速掌握DAB变换器的仿真与性能验证方法。

o4p5q6r7s的博客 504

Marin说PCB之LPDDR5的布线注意事项--01

以上就是本期所有内容了,有些是通用的LPDDR5的设计准则,有的是针对单板的设计规则,严格意义说是没有哪一种规则是完全适用的LPDDR5的 通用规则的,不同的单板可能板厚,板材,层数,SOC以及DDR的型号都是不同的,一般的做法就是严格按照SOC手册上的LPDDR5的要求加上仿真同事给的建议修改优化就好了,我们下期文章不见不散。我们知道想要做好一个LPDDR颗粒,需要考虑的是因素有很多例如,电源完整性,信号完整性,层叠的设计,布局的摆放,布线的合理规划,去耦电容的摆放等等。

weixin_45223454的博客 3164

PCB工艺-SI9000-模型选择

本文介绍了PCB设计中常用的阻抗计算模型,主要包括外层、内层和嵌入式三类共12种计算模型,涵盖单端/差分、共面等不同场景。针对阻抗计算中的关键参数,文章提供了经验值参考:表层走线厚度0.035mm(1.4mil),内层0.0152mm(0.6mil);并列出常见PP材料的介电常数(3.8-4.5)和成品厚度(3-7.5mil)。作者建议90%的设计问题可通过上述模型解决,层叠参数建议咨询PCB厂家获取。

weixin_50120208的博客 1389

用Python+OpenCV搞定线激光相机标定:从棋盘格到3D点云的保姆级实战

本文详细介绍了使用Python和OpenCV进行线激光相机标定的全流程实战,从硬件准备到3D点云重建。涵盖相机内参标定、激光平面方程拟合、三维重建等关键技术,提供完整的代码实现和工程优化建议,帮助开发者实现毫米级精度的工业检测和三维测量系统。

weixin_29227425的博客 287

PCIe中ACS知识小记

虚拟机内部的访问数据显而易见是带的GPA地址。而目前几乎所有的PCIe 设备都带ACS control,所以它们可以单独assign给不同的VM,但是随之而来的就是即使两个GPU同时assign给同一个VM,由于ACS的存在,他们之间也不会有真正的物理层面的P2P访问。每一个TLP都自带一个address(寻址类TLP),同时每一个endpoint,PCIe switch都自带一段BIOS配置的地址空间范围,一旦这个TLP的address落入某个设备的地址范围,那么这个TLP就属于这个设备并消费。

Summer的博客 5078

Vue - 超强实现网页禁止浏览器缩放功能,浏览器缩放时保持网页不变形、元素不会被挤压等,屏蔽浏览器鼠标滚轮缩放页面(提供详细示例代码,一次引入整个网站无人可以搞乱你的页面布局及样式)

vue,nuxt,禁止浏览器缩放,如何用户缩放浏览器导致页面变形,网页缩放后页面变形了怎么办,怎么解决网站被缩放后元素乱套错乱,vue怎么禁止网页不被缩放,vue如何禁止浏览器缩放,vue缩放网页变形影响布局怎么办,vue电脑分辨率及缩放导致页面变形的问题,前端页面解决浏览器或者系统被放大和缩小导致的显示问题,Vue中页面自适应缩放,如何防止Vue页面缩放时变形/调整大小,Vue项目中,防止页面被缩放和放大,vue等比例缩放网页,网页缩放后界面变形咋办,禁止页面缩放,vue禁止浏览器改变窗口大小,Vue项目

🏆 前端领域优质创作者 1万+

YOLOv8改进策略【卷积层】| CVPR-2023 部分卷积 PConv 轻量化卷积,降低内存占用

本文记录的是利用优化的目标检测方法研究。深度可分离卷积可以减少FLOPs,但会导致更高的内存访问,引起延迟并减慢整体计算。部分卷积利用逐点卷积处理通道冗余,减少模型计算量和内存访问量。Run, Don’t Walk: Chasing Higher FLOPS for Faster Neural Networks及其改进的实现代码如下: 四、创新模块 4.1 改进点⭐ 模块改进方法:直接加入(第五节讲解添加步骤)。模块加入如下:模块改进方法:基于的(第五节讲解添加步骤)。第二种改进方法是对中的进行改进,并将

Limiiiing的博客 1016

VEML7700环境光传感器原理图设计,已量产(光线传感器)

最近做便携显示设备的自动亮度调节模块,最终敲定了 VEML7700 这款数字光传感器 —— 一是它 0~120klx 的宽量程刚好覆盖 “暗室→户外强光” 的全场景,二是 Filtron™技术让它的光谱响应和人眼高度贴合,测出来的 “亮度” 更符合实际视觉感受,加上 O-Trim™技术把输出公差压到 10% 以内,省了不少后期校准的功夫。搭好电路后串口直接读 lx 数值,稳定性和精度都够,这篇聊聊这个模块的硬件设计细节。

不脱发的程序猿 605

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

上一篇: 太赞了!阿里通义Lab提出VACE!视频创作与编辑统一模型!
下一篇: 中科大提出SPEED!5秒消除100个概念,高保真+高效,AI内容安全新标杆!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值