太赞了!阿里通义Lab提出VACE!视频创作与编辑统一模型!

【202503】Wan:开放且先进的大规模视频生成模型【1.3B、14B】【支持对无限长度视频进行稳定的Inference】【Wan中的主要计算开销来自注意力机制】 wan: Open and Advanced Large-Scale Video Generative ModelsWan:开放且先进的大规模视频生成模型Wan Team, Alibaba Group Wan 团队,Alibaba GroupThis report presents Wan, a comprehensive and open suite of video foundation models designed to push the boundaries of video generation 阅读详情
AI摘要

近年来视觉生成任务领域发展显著,阿里通义Lab推出VACE。它是集创作与编辑功能于一体的框架,将多模态输入整合为统一条件输入,通过视频条件单元和上下文适配器结构处理任务。大量实验表明,VACE在各子任务表现与特定任务模型相当,还能实现多样化应用。

🌐 社群导航

🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗 点击加入➡️【2-3月CCF投稿】交流群

数源AI 最新论文解读系列

论文名:VACE: All-in-One Video Creation and Editing

论文链接:https://arxiv.org/pdf/2503.07598

开源代码:https://ali-vilab.github.io/VACE-Page/
导读

近年来,视觉生成任务领域取得了显著进展,这尤其得益于扩散模型的快速发展。除了该领域早期用于文本到图像或文本到视频生成的基础预训练模型之外,下游任务和应用不断涌现,例如重绘、编辑 、可控生成、帧参考生成以及基于身份参考的视频合成。这一系列的发展凸显了视觉生成领域的动态性和复杂性。

简介

扩散变换器(Diffusion Transformer)在生成高质量图像和视频方面展现出了强大的能力和可扩展性。进一步追求生成和编辑任务的统一,在图像内容创作领域取得了显著进展。然而,由于对时间和空间动态一致性的内在要求,实现视频合成的统一方法仍然具有挑战性。我们推出了VACE,它使用户能够在一个集创作与编辑功能于一体的框架内执行视频任务。这些任务包括参考到视频生成、视频到视频编辑以及掩码视频到视频编辑。具体而言,我们通过将视频任务输入(如编辑、参考和掩码)组织成一个统一的接口,即视频条件单元(Video Condition Unit,VCU),有效地整合了各种任务的需求。此外,通过使用上下文适配器(Context Adapter)结构,我们利用时间和空间维度的形式化表示将不同的任务概念注入到模型中,使其能够灵活处理任意视频合成任务。大量实验表明,VACE的统一模型在各种子任务上的表现与特定任务模型相当。同时,它通过多功能的任务组合实现了多样化的应用。

方法与模型

VACE被设计为一个多模态到视频的生成模型,其中文本、图像、视频和掩码被整合为统一的条件输入。为了涵盖尽可能多的视频生成和编辑任务,我们对现有任务进行了深入研究,然后根据它们对多模态输入的各自要求将其分为4类。在不失一般性的前提下,我们特别为视频条件单元(Video Condition Unit,VCU)范式下的每个类别设计了一种新颖的多模态输入格式。最后,我们为VCU输入重构了DiT模型,使其成为适用于广泛视频任务的通用模型。
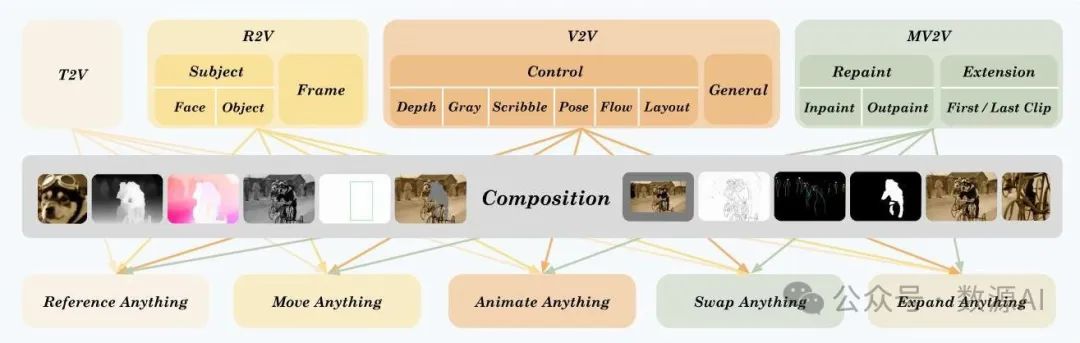
图2. VACE(视频生成与编辑框架)涵盖的任务类别。四个基本任务可以组合出大量的可能性。

1. 多模态输入与视频任务

尽管现有的视频任务在复杂的用户输入和宏大的创意目标方面各不相同,但我们发现它们的大多数输入可以用4种模态完全表示:文本、图像、视频和掩码。总体而言,如图2所示,我们根据这些视频任务对这四种多模态输入的要求将其分为5类。

  • 文本到视频生成(Text-to-Video Generation,T2V)是一项基础的视频创作任务,且文本是唯一的输入。

  • 参考到视频生成(Reference-to-Video Generation,R2V)需要额外的图像作为参考输入,以确保指定内容,如人脸、动物和其他物体的主体,或视频帧,出现在生成的视频中。

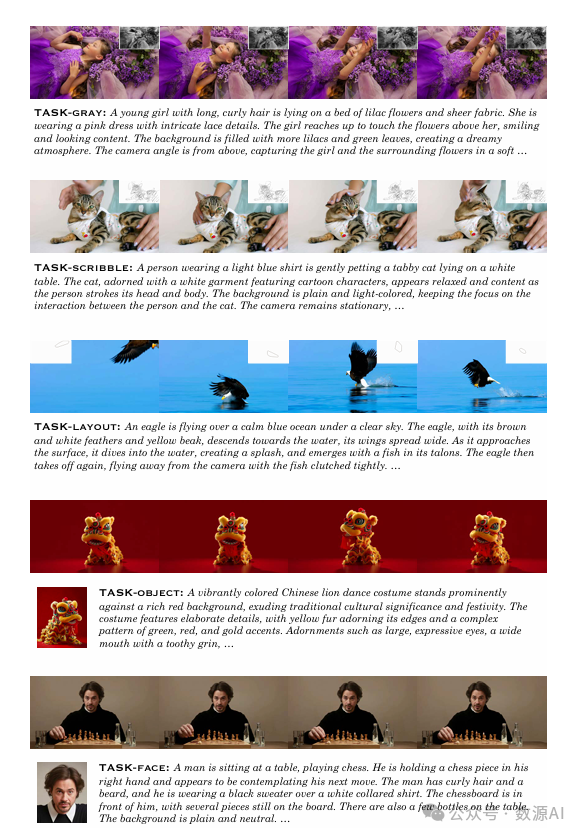
  • 视频到视频编辑(Video-to-Video Editing,V2V)会对给定视频进行全面修改,如上色、风格化、可控生成等。我们使用视频控制类型,其控制信号可以表示并存储为RGB视频,包括深度、灰度、姿态、涂鸦、光流和布局;然而,该方法本身并不局限于此。

  • 掩码视频到视频编辑(Masked Video-to-Video Editing,MV2V)仅在提供的感兴趣区域(3D ROI)内对输入视频进行修改,并与其他未修改区域无缝融合,如内补、外补、视频扩展等。我们使用额外的时空掩码来表示3D ROI。

  • 任务组合包括上述4种视频任务的所有组合可能性。

2. 视频条件单元

我们提出了一种输入范式,即视频条件单元(Video Condition Unit,VCU),用于将各种不同的输入条件统一为文本输入、帧序列和掩码序列。一个VCU可以表示为

其中  是一个文本提示,而  和  分别是上下文视频帧序列  和掩码序列 。这里, 处于 RGB 空间,归一化到 ,并且  是二进制的,其中“1”和“0”分别表示要编辑和不编辑的位置。 和  在空间尺寸  和时间尺寸  上均对齐。在文本到视频(T2V)任务中,不需要上下文帧或掩码。为保持通用性,我们为每个  分配默认值  表示空输入,并将每个  设置为 ,这意味着所有这些值为 0 的像素都将被重新生成。对于 ,在默认帧序列前面插入额外的参考帧 ,同时在掩码序列前面插入全零掩码 。这些全零掩码表示相应的帧应保持不变。在视频到视频(V2V)任务中,上下文帧序列是输入视频帧,上下文掩码是  的序列。在多视频到视频(MV2V)任务中,上下文视频和掩码都是必需的。正式的数学表示如表 1 所示。

弗吉尼亚联邦大学(VCU)还支持任务组合。例如,参考图像修复任务的上下文帧为,上下文掩码为。在这种情况下,用户可以修改视频中的对象,并根据提供的参考图像进行重新生成。再例如,用户只有一幅草图图像,并希望生成一个以该草图图像所描述内容开头的视频,这是一个基于草图的视频扩展任务。上下文帧为,上下文掩码为。通过这种方式,我们可以实现长视频的多条件和参考控制生成。

3. 架构(Arichitecture)

我们为视频自适应上下文编码(VACE)重新构建了扩散变压器(DiT)模型,如图3所示,旨在支持多模态视频上下文单元(VCU)输入。由于已有文本分词的流程,我们仅考虑上下文帧和掩码的分词。分词后,将上下文标记与含噪视频标记相结合,并对DiT模型进行微调。与此不同的是,我们还提出了一种上下文适配器调优策略,该策略允许上下文标记通过上下文块,并重新添加到原始的DiT块中。
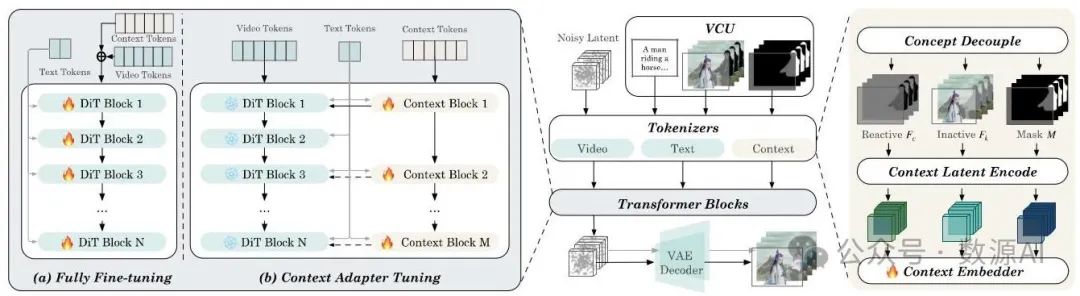
图3. VACE框架概述。通过概念解耦、上下文潜在编码和上下文嵌入器对帧和掩码进行分词处理。为了实现以VCU为输入的训练,我们采用了两种策略,(a) 全量微调,(b) 上下文适配器微调。后者收敛速度更快,并且支持可插拔特性。

3.1. 上下文分词

概念解耦。自然视频和深度、姿态等控制信号这两种不同的视觉概念同时被编码在中。我们认为,明确分离这些不同模态和分布的数据对于模型收敛至关重要。概念解耦基于掩码,并生成两个形状相同的帧序列:和,其中被称为反应帧(reactive frames),包含所有待更改的像素,而所有待保留的像素则存储在中,称为非活动帧(inactive frames)。具体而言,参考图像以及和的未更改部分进入,而控制信号和那些即将更改的像素(如灰色像素)则被收集到中。

上下文潜在编码。一个典型的扩散变压器(DiT)处理含噪视频潜在特征 ,其中  和  分别是潜在空间的时间和空间形状。与  类似, 需要被编码到一个高维特征空间中,以确保显著的时空相关性。因此,我们将它们与  一起重新组织成层次化且时空对齐的视觉特征。 经过视频变分自编码器(VAE)处理,并映射到与  相同的潜在空间中,以保持它们的时空一致性。为避免图像和视频出现意外的混杂,参考图像由变分自编码器(VAE)编码器单独编码,并沿时间维度重新拼接回去,而在解码过程中需要移除相应部分。 直接进行重塑和插值处理。之后, 和  都被映射到潜在空间中,并以  的形状与  实现时空对齐。

上下文嵌入器。我们通过在通道维度上连接和并将它们标记化为上下文标记来扩展嵌入器层,我们将其称为上下文嵌入器。对和进行标记化的相应权重直接从原始视频嵌入器复制而来,而对进行标记化的权重初始化为零。

3.2. 全量微调与上下文适配器微调

为了实现以VCU(视频上下文单元,Video Context Unit)作为输入进行训练,一种简单的方法是对整个DiT(扩散变压器,Diffusion Transformer)模型进行全量微调,如图3a所示。上下文标记(Context tokens)会与噪声标记  一起添加,并且在训练期间,DiT中的所有参数以及新引入的上下文嵌入器(Context Embedder)的参数都将被更新。为了避免全量微调、实现更快的收敛,以及为基础模型建立可插拔的特性,我们还提出了另一种以残差微调(Res - Tuning)[29] 方式处理上下文标记的方法,如图3b所示。具体而言,我们从原始的DiT中选择并复制几个Transformer块,形成分布式级联类型的上下文块(Context Blocks)。原始的DiT处理视频标记和文本标记,而新添加的Transformer块处理上下文标记和文本标记。每个上下文块的输出作为附加信号插回到DiT块中,以协助主分支执行生成和编辑任务。通过这种方式,DiT的参数被冻结,只有上下文嵌入器和上下文块是可训练的。

实验与结果

1. 实验设置

实现细节。VACE(视频自适应条件引擎)基于扩散变压器(Diffusion Transformers)在不同规模下进行文本到视频生成的训练。它利用LTX - 视频 - 2B模型 [22] 实现更快的生成速度,而Wan - T2V - 14B模型 [64] 则专门用于生成更高质量的输出,支持最高720p的分辨率。训练采用分阶段的方法。最初,我们专注于诸如图像修复和扩展等基础任务,这些任务被认为与预训练的文本到视频模型具有模态互补性。这包括引入掩码以及学习在空间和时间维度上的上下文生成。接下来,从任务扩展的角度来看,我们逐步从单输入参考帧过渡到多输入参考帧,从单一任务过渡到复合任务。最后,我们使用更高质量的数据和更长的序列对模型质量进行微调。模型训练的输入支持任意分辨率、动态时长和可变帧率,以满足用户多样化的输入需求。

基线。我们的目标是实现视频创作和编辑任务的统一,目前,尚无类似的一体化视频生成模型,因此我们将评估重点放在将我们的通用模型与专有特定任务模型进行比较上。此外,由于涉及众多任务,且其中许多任务缺乏开源方法,我们对离线或在线可用的模型进行比较。具体针对这些任务,我们进行以下比较:1) 对于图像转视频(I2V)任务,我们考察了I2VGenXL [77]、CogVideoX - I2V [73]和LTX - Video - I2V [22];2) 在重绘任务中,对于去除式内绘,我们比较了ProPainter [82],对于外绘,我们比较了Follow - Your - Canvas [8]和M3DDM [17];3) 对于可控任务,在深度条件下,我们使用Control - A - Video [10]、VideoComposer [68]和ControlVideo [79],在姿态条件下,我们比较Text2Video - Zero [31]、ControlVideo [79]和Follow - Your - Pose [40],以及FLAT -

TEN [14]在光流条件下;4) 在参考生成方面,由于缺乏开源模型,我们比较了商业产品科灵1.6(Keling1.6) [1]、皮卡2.2(Pika2.2) [49]和维杜2.0(Vidu2.0) [66]。

评估。为了全面评估各种任务的性能,我们采用VACE基准进行评估。具体而言,我们将评估分为自动评分和用户研究手动评估。对于自动评分,我们使用VBench [27]中的部分指标来评估视频质量和视频一致性,包括八个指标:美学质量、背景一致性、动态程度、成像质量、运动平滑度、整体一致性、主体一致性和时间闪烁。对于手动评估,我们使用平均意见得分(MOS)作为评估指标,重点关注三个方面:遵循提示程度、时间一致性和视频质量。在实践中,我们对生成的数据进行匿名处理,并随机分发给不同的参与者,让他们在1到5的范围内进行评分。

2. 主要结果

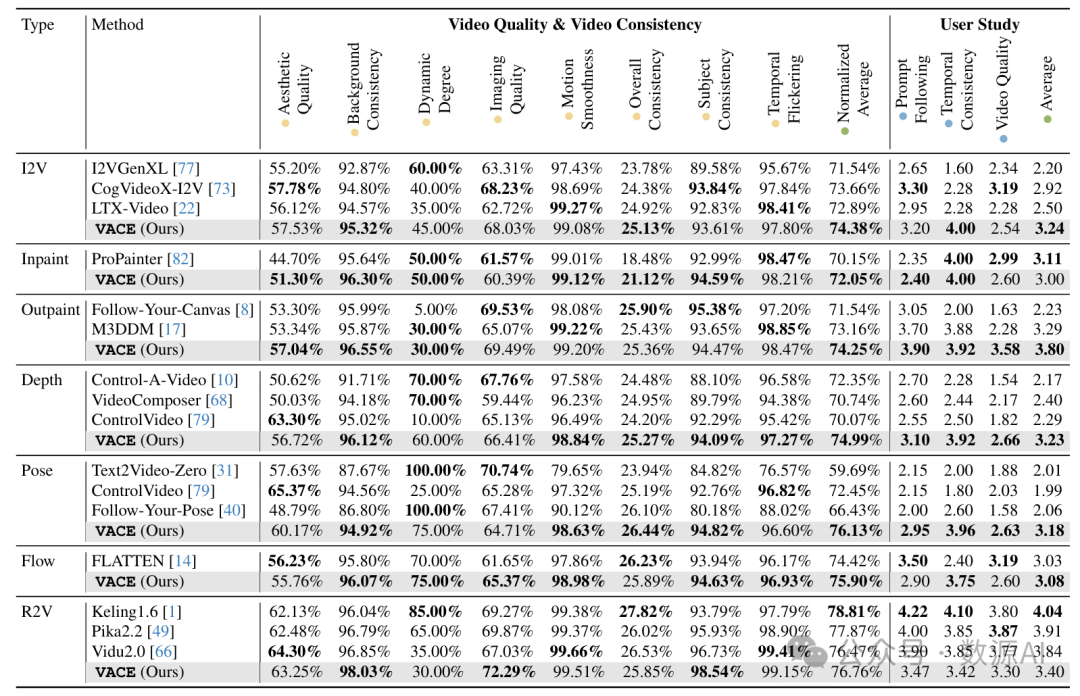
定量评估。我们在VACE基准测试(VACE-Benchmark)上将基于LTX视频(LTX-Video)的VACE综合模型与特定任务的专有方法进行了比较。对于某些任务,我们遵循现有方法;例如,尽管我们支持基于任意帧进行生成,但为确保公平性,我们采用当前开源方法中的第一帧参考方法进行比较。从表2中可以看出,对于图像转视频(I2V)、图像修复、图像扩展、深度估计、姿态估计和光流估计等任务,我们的方法在视频质量和视频一致性的八项指标上均优于其他开源方法,归一化平均指标显示出更优的结果。一些竞争方法只能以256的分辨率进行生成,生成时长非常短,并且在时间连贯性上表现不稳定,导致在自动指标计算中的性能较差。对于参考图像转视频(R2V)任务,对于一个旨在快速生成的小规模模型而言,其指标与商业模型仍存在一定差距,但与Vidu 2.0的指标相当。根据用户研究结果,我们的方法在多个任务的评估指标中始终表现更好,与用户偏好高度一致。
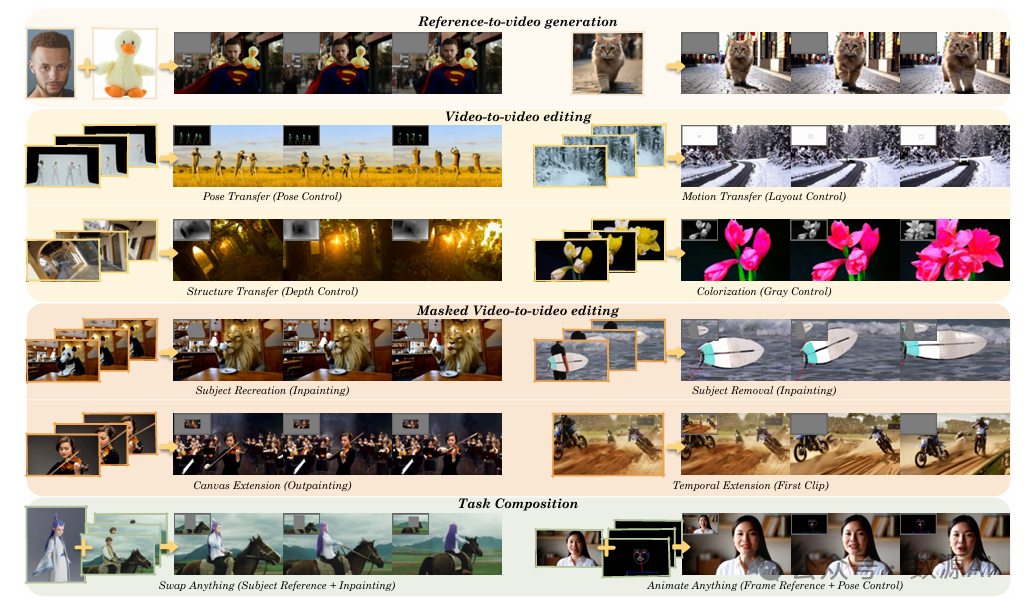
定性结果。在图1中,我们展示了VACE单一模型在各种任务中的结果。显然,该模型在视频质量和时间一致性方面达到了较高的性能水平。此外,在图4所示的合成任务中,我们的模型展现出了令人印象深刻的能力,能够有效地整合不同的模态和任务,生成现有单一或多个模型无法生成的结果,从而证明了其在视频生成和编辑领域的强大潜力。例如,在“移动任意物体”的案例中,通过提供单张输入图像和移动轨迹,我们能够在保持连贯性和叙事一致性的同时,精确地按照指定方向移动场景中的人物。
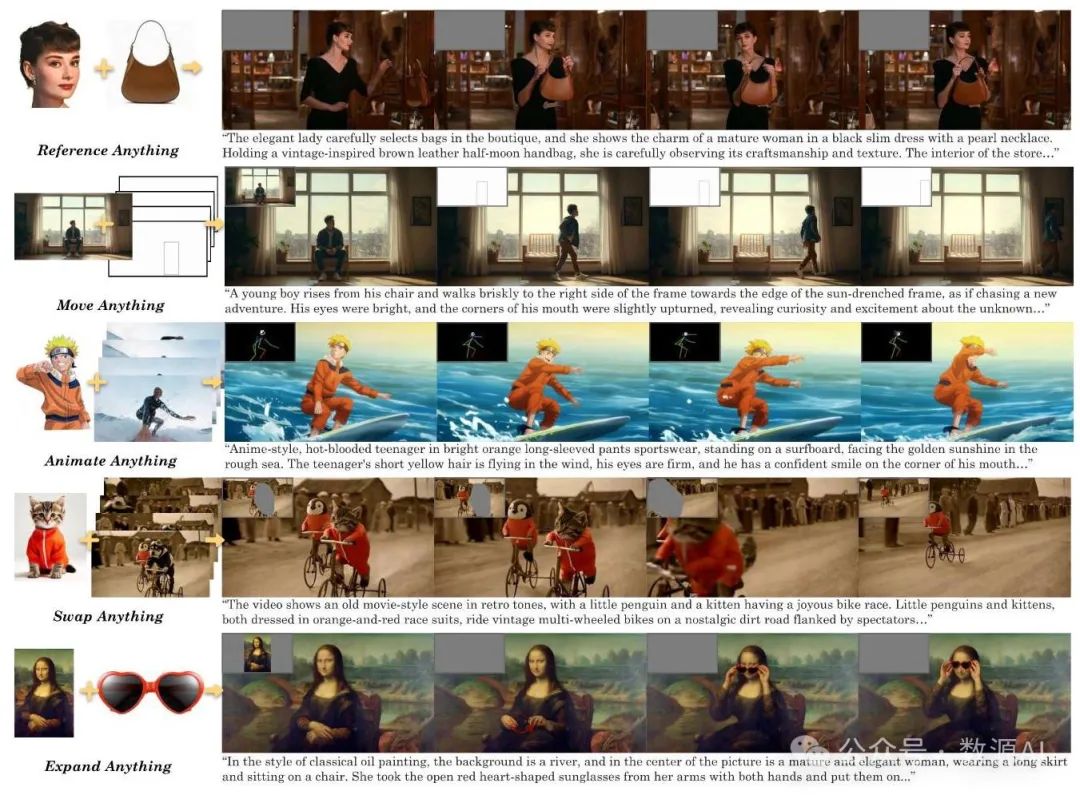
图4. 组合任务的可视化结果。VACE创造性地支持参考任意内容、移动任意内容、使任意内容动起来、交换任意内容和扩展任意内容。

3. 消融研究

为了更好地理解不同独立模块对统一视频生成框架的影响,我们基于LTX - 视频模型进行了一系列系统的对比实验,以获得更好的模型结构和配置。为了准确评估不同的实验设置,我们为每个任务采样250个数据点作为验证集,并计算训练损失,通过不同任务的平均曲线变化来反映模型的训练进度。

基础结构。文本引导的图像或视频生成模型仅将噪声作为推理输入。当扩展到我们的统一输入范式VCU(统一输入范式)时,我们可以使用全量微调或结合额外参数微调的方式进行训练。具体而言,如图5a所示,我们比较了沿通道维度拼接不同输入的情况,并修改了块化投影层的输入维度,以实现预训练模型的加载和全量微调。此外,我们以残差调优(Res-Tuning)[29]的形式引入了一些额外的训练参数,该方法在旁路分支中对VCU进行序列化处理,并将信息注入到主分支中。结果表明,这两种方法产生的效果相似;然而,由于额外参数微调的收敛速度更快,我们后续的实验将基于此方法进行。如图5b所示,我们进一步基于此结构进行了超参数实验,重点关注加权方案、时间戳偏移和p零等方面。
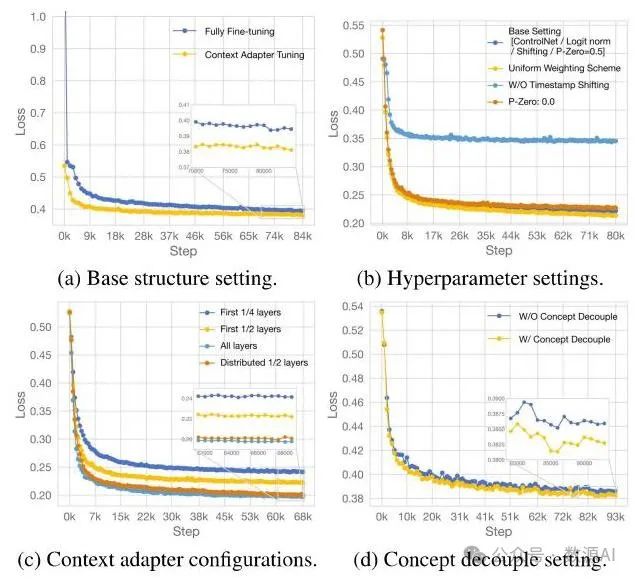
图5. VACE在结构、超参数和模块配置方面的消融研究。

上下文适配器。由于上下文块的数量会显著影响模型大小和推理时间消耗,我们试图找到上下文块的最佳数量和分布。我们从在输入侧选择连续的块开始,并对前个块、个块和所有块进行比较。受残差调优(Res-Tuning)[29]方法的启发,我们还尝试均匀分布注入块,而不是选择连续的块序列。如图5c所示,我们可以看到,当使用相同数量的块时,在浅层块中,块的分布式排列优于连续排列。此外,更多数量的块通常会产生更好的结果,但由于效果提升有限以及训练资源的限制,我们采用块的部分分布式排列。

概念解耦。在训练过程中,我们引入了一个概念解耦处理模块,以进一步拆解视觉单元,明确模型需要学习修改或保留哪些内容。如图5d所示,使用该模块可使损失有更显著的降低。
结论

本文介绍了VACE(一体化视频生成与编辑框架),这是一个集视频生成与编辑功能于一体的框架。它整合了各类视频任务所需的多样且复杂的多模态输入,弥合了针对各个单独任务的专用模型之间的差距。这使得大多数视频人工智能创作任务能够通过单个模型的单次推理完成。在广泛涵盖各种视频任务的同时,VACE还支持这些任务的灵活自由组合,极大地拓展了视频生成模型的应用场景,满足了用户广泛的创意需求。VACE框架为具有多模态输入的统一视觉生成模型的发展铺平了道路,是视觉生成领域的一个重要里程碑。

论文阅读VACE: All-in-One Video Creation and Editing 主要是统一了多个不同的视频任务,使得单一模型拥有复杂的能力。创新点注意围绕着接口设计、训练设计。模型核心结构未变。 阅读详情

相关推荐

VACE:All-in-One Video Creation and Editing

Vace在构建过程中考虑了不同任务的需求,并设计了一个统一的接口,称为视频条件单元,该单元整合了多种模态,为了区分编辑和参考任务中的视觉模态信息,我们引入了解耦策略,使模型能够理解需要保留哪些方面以及需要修改哪些方面,同时,通过采用可插拔的上下文适配器结构,不同任务的概念通过协同时空表征注入到模型中,使其具备适应性处理统一任务的能力。我觉得还是比较好理解的,也就说对四个任务,输入都被统一为文本输入,帧序列和mask输入,其中帧序列是RGB的,mask是0/1的,是二进制的,两者是对齐的。

liguandong 204

【云馨AI-大模型】阿里开源万相Wan2.1-VACE:开启视频生成大模型平民化时代

2025年5月14日,阿里云推出的Wan2.1 VACE模型套件标志着AI视频生成领域的重大突破。该套件通过Apache2.0协议开源,集成了文生视频、图生视频、视频编辑等六大核心功能,重新定义了行业标准。Wan2.1采用创新的动态图变换器架构和线性噪声轨迹FlowMatching范式,实现了1080P无限长视频的高效编解码,并在VBench评测中以86.22%的总分超越商业方案。此外,T2V-1.3B模型使得个人开发者也能在普通硬件上创作专业级视频内容。Wan2.1还特别优化了中文场景处理,支持文化元素和

起而行动,方能平定心中的惶恐 1093

阿里巴巴推出一体化视频创作与编辑模型VACE

在2025年的今天,随着技术的不断进步,阿里巴巴即将发布一款名为VACE的一体化视频创作与编辑模型。这款创新工具旨在为用户提供前所未有的视频生成和编辑体验,不仅能够支持从零开始创建各种场景、角色及风格的视频内容,还能进行高级编辑操作,并实现对原视频内容的智能重新渲染。

这里汇聚了前沿的技术分享与实用的开发技巧,带你探索从创意到企业的技术创业之路。 465

Wan系列模型解析--VACE

DiT在生成高质量图像和视频方面已展现出强大的能力与可扩展性,进一步追求生成与编辑任务的统一需求也越来越明显,但由于视频合成对时空动态一致性存在内在需求,实现视频合成的统一方法仍面临挑战。本文提出 VACE,即一体化视频创作与编辑框架,该框架支持用户在单一平台内完成多种视频任务,包括图片生视频、视频编辑以及掩码引导的视频编辑。

zzfive的博客 1428

鸿蒙设备部署轻量级Web服务器NexServer实践

Web服务器作为互联网基础设施的核心组件,其轻量化部署在移动终端领域具有重要实践价值。本文以鸿蒙操作系统为技术载体,深入解析微内核架构如何通过资源隔离和分布式软总线实现服务高可用。重点探讨NexServer这一专为嵌入式场景设计的轻量级服务器,其ARM原生支持特性与15MB级内存占用,在HTTP/2协议处理与WebSocket通信中展现出独特优势。在智能家居控制面板、边缘计算节点等物联网典型场景中,鸿蒙设备结合NexServer的方案相比传统Nginx部署可降低60%资源消耗。通过实测数据对比,该组合在50

weixin_30411239的博客 483

maya权重拷贝一对一,一对多

是不是有时候盔甲很多很碎头很大,用代理一个个拷贝很麻烦吧 用下面代码直接运行进行一对多或者一对一拷贝 第一个先选择参考物体,加选其他一堆有的没的有权重或没权重的物体执行一键拷贝,就可以啦 以下是源码送上,带走吧 ------------------------ #! -*- coding:utf -8 -*- #author:liubingdong #date:20...

weixin_30852367的博客 1534

【ICCV 2025】VACE:统一视频创作与编辑的全能框架|从视频生成统一范式视角

【ICCV 2025】VACE 论文解读:用一个视频 DiT 模型统一创作与编辑。VCU 把文本/图像/视频/掩码折叠进同一接口,单模型覆盖 12 类任务,VACE-Benchmark 上 I2V 归一化平均 74.38%,全面超越开源专用模型。

白拾的博客 300

Ubuntu22.04 网络图标消失与连接故障排查指南(附实战修复流程)

本文详细介绍了Ubuntu22.04系统中网络图标消失与连接故障的排查与修复方法。通过ifconfig、dhclient等命令诊断问题,提供从紧急恢复网络连接到深度排查的完整解决方案,帮助用户快速恢复网络功能并预防类似问题再次发生。

weixin_28481133的博客 289

阿里发布扩散模型Wan VACE,全面支持生图、生视频、图像编辑,适配低显存~

Wan2.1-VACE 是一款于2025年5月14日发布的综合视频生成与编辑模型,旨在统一处理视频生成和编辑任务,解决时间和空间维度上的一致性问题。该模型支持多种任务,如参考到视频生成(R2V)、视频到视频编辑(V2V)和遮罩视频到视频编辑(MV2V),并提供如Move-Anything、Swap-Anything等功能。其创新特点包括多语言文本生成、高效视频处理、硬件兼容性以及开源与社区支持。模型提供1.3B和14B两个版本,分别适用于480P和720P分辨率,核心架构基于扩散变换器和T5编码器,支持多语

CherryXieのblog 2467

使用循环神经网络预测温度

简介 本文以天气时间序列数据集为例,讨论如何使用深度学习模型预测未来天气温度。 使用的是由德国耶拿马克思普朗克生物地球化学研究所的气象站记录。 数据每10分钟记录一次,共记录14种不同的量,如气温、气压、湿度、风向等,原始数据可追溯到2003年,本例只使用2009-2016年的数据。 数据 下载并解压数据略。 加载数据: data_dir = r'E:\practice\tf2\temperature' fname = os.path.join(data_dir, 'jena_climate_2009_

guotianqing的博客 5282

EEGLAB+ERPLAB实战:从.cnt文件到情绪ERP差异波,一份避坑指南

本文详细介绍了使用EEGLAB和ERPLAB处理Neuroscan的.cnt格式脑电数据的全流程,从数据导入、预处理到情绪ERP差异波生成。重点解决了采样率验证、事件标记检查、重参考选择、滤波策略与ICA组合等实操难题,并提供了情绪图片ERP研究中P1、EPN和LPP成分的分析技巧,帮助研究者避免常见错误,提升数据处理效率。

weixin_26795617的博客 266

VACE:视频创作与编辑的一体化解决方案

VACE是一个集视频生成和编辑于一体的开源模型,它支持参考到视频生成(R2V)、视频到视频编辑(V2V)以及遮罩视频到视频编辑(MV2V)等多种任务。用户可以根据需要灵活组合这些任务,探索多样化的创作可能,极大地简化了工作流程,提供了如Move-Anything、Swap-Anything、Reference-Anything、Expand-Anything、Animate-Anything等丰富...

gitblog_01009的博客 1051

【CODESYS】-软件Bug与处理方法(20240710更)

【CODESYS】-软件Bug与处理方法(不定期更新)

qq_35316470的博客 5188

VACE:AI 驱动的一站式视频创作与编辑平台

VACE(Video Creation and Editing Framework)是由阿里巴巴集团通义实验室开发的一种创新的视频创作和编辑框架,它将多种视频任务整合到一个统一的平台中,实现了从文本到视频生成、视频编辑到复杂任务组合的全面覆盖。

weixin_41446370的博客 1609

用Excel或WPS做两独立样本的T检验

一般情况下收集数据时常用的是Excel或者WPS,但统计时却用SPSS等软件进行统计学分析,经常很多人找不到SPSS的安装包,或者苦于正版激活或忘记教程,其实Excel或WPS自带函数就足够了,均数、标准差以及统计检验都是一个函数而已。解释:先做F检验,如果F>0.05就做T检验,Ttset里的数据为两组的数据的比较,结果如下。A组的均数计算 =AVERAGE(B2:B6)A组的标准差计算 =STDEV(B2:B6)B组的标准差计算=STDEV(B7:B19)分组 数值 A组均数 A组标准差 p值。

Mrrunsen的博客 6754

ABAP 系统里使用 SAP Joule 辅助编程的前提条件

只是说这些大语言模型是针对互联网上能够挖掘到的所有数据进行训练,不像 SAP Joule 那样术业有专攻,仅仅深耕 SAP 技术和业务领域,因此大伙儿对 SAP Joule 的期望值,也远远高于通过大语言模型。SAP Joule 从 ABAP Development Tool 的 Chat 窗口中接收到的对话请求,都会路由到 SAP BTP 上的 AI Foundation.在上述 ABAP 环境中启用 SAP Joule,需要购买额外的 license:8019124.

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 799

【GitHub项目推荐--VACE:一体化视频创作与编辑框架完全指南】

​VACE​(Video Creation and Editing)是由阿里巴巴视觉智能实验室开发的开源一体化视频生成与编辑框架。该项目基于先进的Wan2.1和LTX-Video模型,提供了全面的视频创作和编辑能力,支持参考视频生成、视频到视频编辑、掩码视频编辑等多种任务,为用户提供了前所未有的视频创作自由度。🔗 ​GitHub地址⚡ ​核心价值​:视频生成 · 视频编辑 · 多任务一体化 · 开源创新​项目背景​:​技术基础​:基于Wan2.1和LTX-Video等先进视频生成模型​创新理念。

j8267643的博客 1518

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

阿里开源全能视频大模型:程序员如何用Wan2.1-VACE重构视频创作范式?

在视频创作领域,传统流程往往需要多个工具串联:文生图→图生视频→局部编辑→背景延展→特效合成。Wan2.1-VACE代表了一种全新的视频生成范式——通过单一模型重构全流程创作。从今天起,尝试用Wan2.1生成你的第一个视频:用代码定义创意,让AI驱动视觉革命。彻底颠覆了这一模式——单一模型即可完成从文本到视频、图像参考生成、局部编辑等全链条操作,甚至能让《蒙娜丽莎》戴上墨镜并横屏耍酷。如今,该模型已全面开放下载(支持消费级显卡),程序员终于可以用一个工具解决所有视频创作需求。:生成长视频时角色特征漂移?

like21a的博客 1218

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

阿里开源视频生成巅峰之作!Wan2.1-VACE-14B实战全解析:从动作迁移到多图融合

上传动作参考视频与目标图像,调整frame_num(帧数)与sample_guide_scale(动作强度),生成动态一致的新视频。划定编辑区域,调整参数--sample_shift(噪声调度)与guide_scale(提示词权重),生成局部修改后的连贯视频。,模型通过捕捉源动作的时空特征,结合目标主体的外观一致性约束(如RefAdapter模块),实现自然迁移。,通过时空压缩与长时程依赖建模,实现无限时长1080P视频编解码,压缩效率提升40%。:在沙滩边走路的视频中,仅修改人物,背景动态保持自然过。

OneThingAI的博客 3877

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

阿里通义万相 Wan2.1-VACE:开启视频创作新境界

2025 年 5 月 14 日,阿里巴巴为视频创作领域带来了重磅惊喜 —— 开源通义万相 Wan2.1-VACE。这一模型堪称视频生成与编辑领域的集大成者,凭借其全面且强大的功能,为广大创作者、开发者以及企业用户开辟了全新的视频创作天地。它打破了以往视频创作中需依赖多种工具和模型的局限,以单一模型之力,将视频生成与编辑的众多关键环节整合,极大地简化了创作流程,提升了创作效率。接下来,让我们深入探索通义万相 Wan2.1-VACE 的神奇世界。

qq_29768197的博客 2238

阿里开源通义万相 Wan2.1-VACE,开启视频创作新时代

2025 年 5 月 14 日,阿里巴巴开源通义万相 Wan2.1-VACE 模型,支持文生视频等多任务。其具全面可控生成、局部与全局编辑等能力,通过多模态输入处理实现高效信息交互。文中还介绍了在魔搭社区的部署及推理测试情况。

个人技术 2954

论文阅读:VACE: All-in-One Video Creation and Editing

论文地址:https://arxiv.org/pdf/2503.07598开源时间:2025年3月11日代码地址:https://github.com/ali-vilab/VACE项目地址:https://ali-vilab.github.io/VACE-Page/DIT在生成高质量图像和视频方面展示了强大的能力和可扩展性。进一步追求生成和编辑任务的统一,在图像内容创建领域取得了显著进展。然而,由于在时间和空间动态上保持一致性的内在需求,实现视频合成的统一方法仍然具有挑战性。

a486259的博客 1773

VACE项目全功能视频生成与编辑技术指南

VACE作为一款创新的视频生成与编辑解决方案,通过统一框架实现了从文本到视频生成、视频编辑到复杂组合任务的全方位支持。本文将深入解析VACE的核心功能、使用流程以及技术细节,帮助开发者全面掌握这一强大的视频处理工具。 ## 一、VACE核心功能概述 VACE系统主要支持三大类视频处理任务: 1. **视频生成类任务** - 文本到视频(T2V):仅需文本描述即可生成视频 - 参考...

gitblog_00880的博客 609

字节开源MegaTTS3-轻量高效语音合成模型;Wan 团队开源 All-in-One 视频编辑框架 VACE

VACE是一个一体化的视频创作和编辑模型,集成了多种任务,包括参考视频生成(R2V)、视频到视频编辑(V2V)和遮罩视频到视频编辑(MV2V)。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

m0_59235945的博客 1734

指纹识别综述(6): 现场指纹识别

现场指纹识别是最具挑战的指纹识别问题,近年来激发了许多创新。本文全面介绍了现场指纹的人工识别方法、自动特征提取方法、自动匹配方法以及技术评测。对于现场指纹识别的各个子方向,选取了部分代表性工作进行介绍。最后进行了总结和展望。

minutiae的专栏 4584

VACE数据集介绍,官网编号LDC2011V01、LDC2011V02、LDC2012V01

这个数据集主要用于探索和开发语音增强技术,特别是通过视觉信息(例如嘴部运动)或视听信息(同时使用音频和视频)来提升语音信号的质量和清晰度。: 数据集结合了视觉信息(如嘴部运动)和音频信息,以便研究如何利用这些信息来改善语音增强的效果。: VACE数据集为研究人员提供了一个用于开发和评估语音增强算法的基准。: 这种类型的数据集在智能语音助手、远程会议系统、语音识别等领域具有广泛的应用潜力。总体来说,VACE数据集为视觉和视听语音增强技术的研究提供了一个重要的资源,促进了在多模态语音处理领域的进步和创新。

2401_82807541的博客 645
上一篇: 北邮提出StickMotion:简笔画驱动的文本到动作生成技术,精准捕捉你的每一个动作想象!
下一篇: 实时识别任何物体!清华提出YOLOE!高效开放场景的开放提示检测和分割!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值