AI论文探讨室·A+·第5期 Human Synthesis and Scene Compositing

【AI视野·今日CV 计算机视觉论文速览 第159期】Tue, 24 Sep 2019 AI视野·今日CV 第159期视觉论文速览 --- 基于点特征与边特征交互的点云分析 --- 更宽的组卷积特征网络 --- 场景重光照 --- 无解码器的图像任务方法 --- 场景人体合成 阅读详情

《Human Synthesis and Scene Compositing》

论文链接

主要解决的问题:参数化控制人体姿态和形状,并将生成的人体嵌入到3D背景中

主要描述

       本论文提出的框架主要包含三部分:(1)一个人像图像统一模型在控制姿态和外观,基于一个参数的展示;(2)一个人像插入处理,利用几何和语义的3D场景;(3)一个现实组成处理来创造一个无缝的融合在场景颜色和生成人体图像,以及避免视觉伪影。并在DeepFashion数据集上进行测试,得到比较好的结果。

系统框架

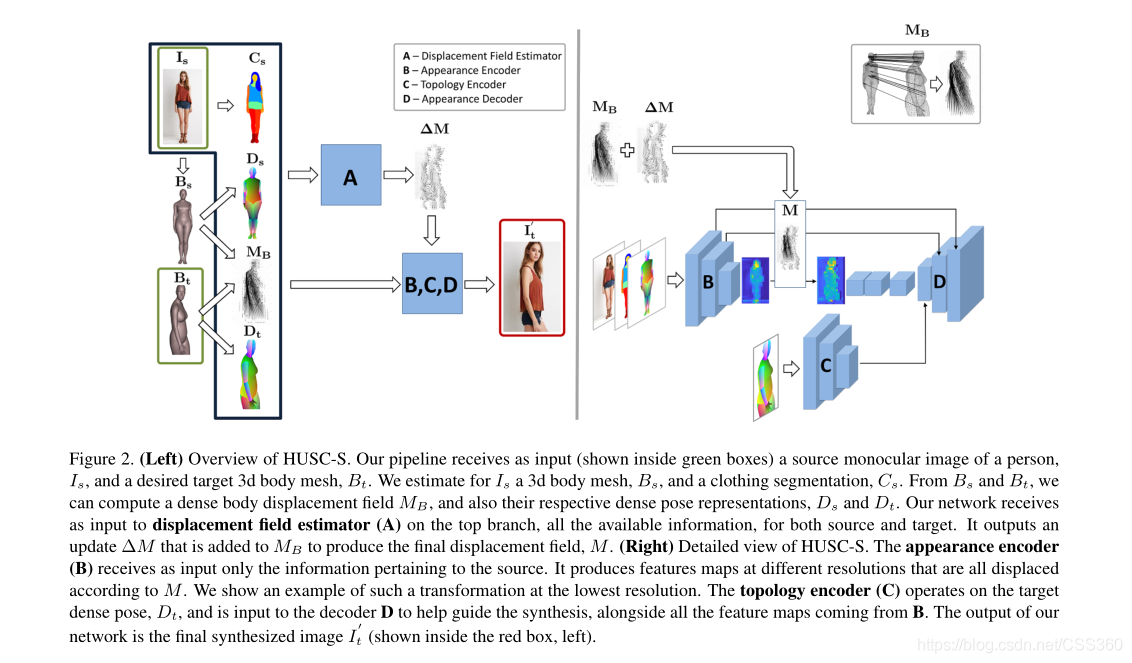
框架流程:输入一张人体的前景图,一个背景场景包含深度图和语义标签,以及一个目标的3D身体模型。首先,本论文使用北京场景来估计地面模板。在几何合成阶段,本论文给目标人体确定一个固定的3D位置,以及进行相关的视点转换,使用支持面法向进行对齐。通过HUSC-S网络,将新更新的目标人体形状和输入图像一起进行编码到目的表面。统一的前景图像结果在背景图中进行渲染,通过适当考虑深度排序约束。最后,它的外观使用论文中的外观组成网络来选择,为了得到最终的结果。

HUSC-S网络详解
指标对比

实验效果
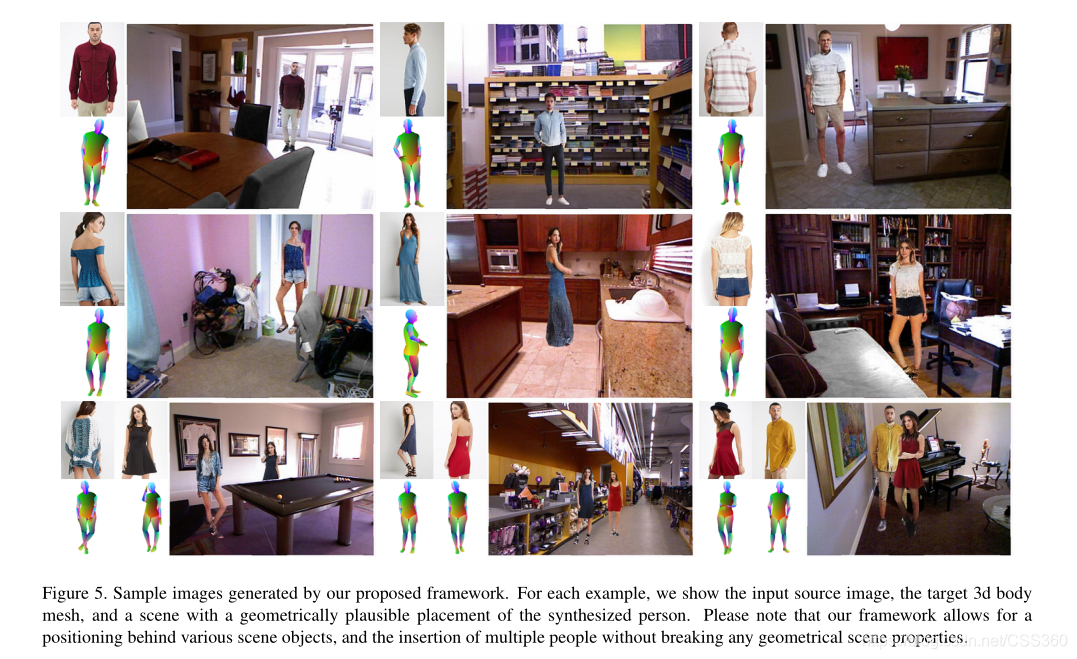
主要工作

(1)在3D背景空间进行处理和操作;

(2)为解决空间尺度和模型闭合,引入场景的语义信息;

(3)使用参数化的3D人体和稠密几何对应关系,来较好的控制外观转化处理;

了解更多关于《计算机视觉与图形学》相关知识,请关注公众号:

下载我们视频中代码和相关讲义,请在公众号回复:计算机视觉课程资料

maxwell与steady state thermal 通过workbench耦合仿真 文章目录maxwellsteady state thermal maxwell 1加入maxwell并打开 2导入模型 3选择求解器类型:涡流求解器eddy current 4修改模型名字不能带_等特殊符号 5为模型赋材料 6设立3D边界,各边电流进出方向为0其余方向300 7设置激励条件,可设置电流大小,相位,方向 8设置集肤深度,选取中间铜导体的体然后设置,如何设置看帮助文档 9求解设置 迭代步数 收敛精度 交流电频率 10验证条件满足计算 11求解 发现无法求解,删除ai 阅读详情

相关推荐

AMD Ross FPGA Agent 实战:用 AI 驱动 Vivado 开发流程

在 EDA 领域,FPGA 开发长期面临工具链重、反馈周期长、报错晦涩等痛点。AI Agent 通过自然语言交互与工具调用,将 Vivado 的 Tcl 批处理流程封装为可编排、可观测的智能体,显著降低查文档与读报告的时间成本。其核心在于 Harness 与 Agent 的协同:Harness 提供安全执行环境,Agent 负责决策与迭代。典型应用包括工程创建、约束生成、综合实现报告解读及比特流失败排查。本文以 AMD Ross 为例,拆解其架构设计与实操方法,帮助开发者理解如何将 Agent 落地到高门槛

weixin_29189363的博客 1043

机器学习概述1

机器学习概述1

m0_47099463的博客 970

物流系统集成实战:从零开始用Java对接国际快递(DHL/FedEx/UPS)

本文详细介绍了如何使用Java技术栈对接DHL、FedEx和UPS三大国际快递巨头的API,构建高效、稳定的物流集成解决方案。内容涵盖认证机制、报文标准、多语言支持等关键点,并提供实战代码示例和最佳实践,帮助开发者快速实现国际快递系统集成。

efc1234567的博客 695

机器学习的入门学习

人工智能AI is the field that studies the synthesis and analysis ofcomputational agents that act intelligently(人工智能是研究智能行为的计算代理的合成和分析的领域)AI is to use computers to analog and instead of human brain(AI就是用计算机来模拟,代替人脑)仿智 ,可以用这个词来简单地形容人工智能,其旨在帮助人们通过机器完成人类的行为和意愿。

weixin_74182458的博客 617

代码复现——SymAgent:一种用于知识图谱复杂推理的神经符号自学习Agent框架

根据《SymAgent: A Neural-Symbolic Self-Learning Agent Framework for Complex Reasoning over Knowledge Graphs》(《SymAgent:一种用于知识图谱复杂推理的神经符号自学习Agent框架》)论文思路,简单复现代码,以实现SymAgent中的Agent-Planner和Agent-Executor模块。Agent-Planner利用大语言模型的归纳推理能力从知识图谱中提取符号规则,指导高效的问题分解。

qq_60040306的博客 1607

RK3588开发板DDR频率上不去?手把手教你用ddrbin_tool降频调优(附完整配置流程)

本文详细介绍了RK3588开发板DDR频率调优的完整解决方案,重点使用ddrbin_tool工具进行降频配置。从硬件原理分析到实战操作,包括参数导出、频率调整、二进制生成及烧录验证,帮助开发者解决DDR高频不稳定问题,提升系统可靠性。适用于嵌入式开发、工业控制等场景。

weixin_42713608的博客 548

初识AI

什么是AI AI is the field that studies the synthesis and analysis of computational agents that act intelligently. AI are systems that think like humans ,act like hummans , think rationally, act ratio...

坏蛋呆呆的博客 389

ESP32与BH1750光照传感器结合使用的Web服务器案例

请注意,为了使代码正常工作,你需要将代码中的"你的WiFi网络名称"和"你的WiFi网络密码"替换为你自己的WiFi网络凭据。在代码中,我们首先导入了所需的库文件,包括Wire库用于I2C通信,BH1750库用于与光照传感器通信,WiFi库和WebServer库用于创建Web服务器。接下来,我们将编写一个Arduino代码来控制ESP32与BH1750的通信,并将读取到的光照强度值显示在Web服务器上。函数用于处理根路径的请求,其中我们读取光照传感器的值,并将其显示在返回的HTML页面中。

server_api196的博客 619

机器学习---一 基本概念及入门和线性回归

(本文结合西瓜书和机器学习极简入门而写,且本文极其不严谨,只求快,有很多错误,请温柔指出,多说敬语) 经过对线性回归的学习,一般人都会有一种普遍错误(夸张了一点,应该是很片面)的直觉认知,那就是认为 线性回归模型假设输入数据和预测结果遵循一条直线的关系 如下图所示: 自变量(特征 x)和因变量(结果 y)的关系是一条直线 对线性含义要理解的透彻需要从其定义入手: 线性函数的定义是:多元一阶(零)...

Major_S的博客 535

腾讯滑块验证码防水墙 tdc.js 补环境实录

腾讯滑块验证码破解研究摘要 本文记录了破解腾讯防水墙滑块验证码(tdc.js)的全过程。研究重点包括: 流程分析:通过抓包分析验证码完整链路,识别出关键参数collect和eks需从tdc.js虚拟机获取 环境模拟:采用渐进式补环境方法,针对字节码虚拟机特性构建完整的window对象,包括navigator、screen、canvas等API的精确模拟 核心破解:成功调用TDC.getData()和TDC.getInfo()获取关键参数,解决POW计算和滑块缺口识别问题 优化调整:针对errorCode 5

码王吴彦祖的博客 235

8.Python基础语法(五)续【光说不练假把式,上题】

Python基础语法(二) 有关于Python循环语句的几道实操,让大家理解知识点更深更透彻~

孤寒者的博客 2万+

Graphics2D的Compositing Rule

Compositing(组合的意思) Rule: 组合规则决定图形之间颜色的相互影响。 例如图片或图形的不透明度属于整个分类。以下方法可以得到组合规则: g2.setComposite(java.awt.Composite composite); Composite composite = g2.getComposite(); Java 2D允许分配透明(alpha)值,以便底层的图形可以显示出来...

python学习笔记 805

深度强化学习在足式机器人中的应用 (一):基础原理与仿真环境

我们将首先深入探讨其背后的核心挑战与技术栈,然后详细推导机器人学和强化学习的基本数学原理,特别是剖析在机器人控制领域表现卓越的PPO算法。下面的独立Python脚本展示了Isaac Gym的基本API用法,加载一个Go1机器人(假设URDF已准备好),并让它执行一个简单的预设动作(正弦波运动),以此来熟悉仿真流程。:代码的核心是直接操作GPU上的PyTorch张量,避免了CPU和GPU之间的数据拷贝,这是实现高性能的关键。:所有计算(如伪策略中的正弦波计算)都应该是向量化的,一次性为所有。

VectorShift的博客 228

人像处理的颜色

对于人像的颜色处理。自己认为比较养眼的色彩是: 人脸的肤色:#FED6BC 头发的色彩:#151515 转载于:https://www.cnblogs.com/chuanyue/archive/2012/12/07/2807005.html...

weixin_33827965的博客 108

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

AI论文探讨室·A ·第9期 MVSNet: Depth Inference for Unstructured Multi-view Stereo

《MVSNet: Depth Inference for Unstructured Multi-view Stereo》 论文链接 主要解决的问题:使用端到端到的神经网络解决从多个视点图像来推断深度图 系统架构 MVSNet网络架构:输入图像将经过2D特征提取网络和可微单应性矩阵变化到形成损失体积。最后深度图输出通过从正则化可能的体积和精炼参考图得到。 效果展示 ...

CSS360的博客 736

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

3D人体重建从单张图中-DeepHuman: 3D Human Reconstruction from a Single Image

论文链接:http://www.liuyebin.com/deephuman/assets/DeepHuman.pdf 摘要 我们提出深度人体,一个图像导向立体到立体的转换CNN对3D人体重建从一个单张RGB图像。为减少干扰涉及在表面几何重建,即使对不可见的区域也可以进行重建,我们提出和利用一个稠密的语义展示形成从SMPL模型作为一个外部的输入。一个关键特征在我们的网络融合不同...

CSS360的博客 5382

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

单张图人体重建Convolutional Mesh Regression for Single-Image Human Shape Reconstruction

论文地址:https://arxiv.org/pdf/1905.03244.pdf 工程地址:https://www.seas.upenn.edu/~nkolot/projects/cmr/ 摘要 这篇文章目的解决问题3D人体姿态和形状估计从单张图像上。先前的方法考虑一个参数模型的人体框架,SMPL以及使用回归模型参数给上升到mesh一致图像证明。这个参数回归是一个非常具有挑...

CSS360的博客 2764

图像三维重建第六期-Scan2CAD: Learning CAD Model Alignment in RGB-D Scans

论文地址 项目地址 摘要 我们展示Scan2CAD,一个新颖数据驱动方法学习一个对准的3D CAD模型从一个基础数据对噪声和不完整几何的RGB-D扫描。对于一个3D重建一个室内场景,我们的输入一系列的CAD模型,和预测一个9维姿态能够对齐每个模型的基本扫描几何。为解决这个问题,我们创建一个新的扫描到CAD对齐数据集基于1506扫描网络扫描97607来注释关键点对在14224C...

CSS360的博客 1506

AI论文探讨室·A+·第10期 DeepStereo: Learning to Predict New Views from the World’s Imagery

《DeepStereo: Learning to Predict New Views from the World’s Imagery》 论文链接 主要解决的问题:首次使用神经网络预测新的视点图 主要描述 新视点的像素生成是使用将临近视点的图像输入到卷积神经网络中,最后生成新视点的图像。它的有优势主要在,只需要一系列的不同位姿下的图像,然后就可以在不同场景下生成新的视点。 ...

CSS360的博客 1473

PVNet: A Joint Convolutional Network of Point Cloud and Multi-View for 3D Shape Recognition

论文链接:http://gaoyue.org/paper/PVNet.pdf 摘要 3D目标识别已经吸引研究者们的注意在领域多媒体和计算机视觉。随着最近涌入的深度学习,各种深度模型使用不同的展示形式实现先进的表现。大部分它们,点云和多视点基于3D模型展示正在引进在最近,它们对应的深度模型已经展示出重要性在3D模型识别。然而,有较少集中在点云数据和多视点数据对于3D模型展示,在我们...

CSS360的博客 1393

AI论文探讨室·A+·第17期 Motion2Fusion: Real-time Volumetric Performance Capture

欢迎志同道合的朋友,在下方留言,大家相互学习。 论文链接 摘要 这是一个360度实时的对非刚性进行三维重建的系统Motion2Fusion。作者主要贡献:(1)提出一个新的非刚性融合系统能够实现高精度立体细节融合,来避免先前的过度平滑和视觉效果;(2)使用机器学习对3D对应区域进行估计来减少跟踪错误来自快速运动造成的结果;(3)一个反向和前向对齐策略能够鲁棒处理拓扑结构改变...

CSS360的博客 1273

AI论文探讨室·A+·第11期 DeepMVS: Learning Multi-view Stereopsis

《DeepMVS: Learning Multi-view Stereopsis》 主要解决的问题:输入任意数量的姿态图像来预测高质量的视差图 主要描述 主要包含三部分:(1)在真实统一数据集上进行有监督的预训练;(2)提出一个有效的方法在无序的图像数据集中收集信息;(3)使用预训练的VGG-19网络来融入多层的特征。通过在ETH3D数据集上对论文中提出的DeepMVS网络,...

CSS360的博客 1090

基于图像的3D目标重建 State-of-the-Art and Trends in the Deep Learning Era

论文地址:https://arxiv.org/pdf/1906.06543.pdf 摘要 先进的3D目标重建使用深度学习的分类 编码阶段分类

CSS360的博客 1040

AI论文探讨室·A+·第2期 DISN: Deep Implicit Surface Network for High-quality Single-view 3D Reconstruction

NeurIPS2019 《DISN: Deep Implicit Surface Network for High-quality Single-view 3D Reconstruction》 论文链接 代码链接 主要解决的问题:从单张图像中重建3D模型,即给定一张图像预测有符号距离域 具体描述 除了使用全局图像特征,DISN也预测局部块的每个3D点投影和提取局部特征从...

CSS360的博客 800

图像三维重建第七期-Real-time Non-rigid Reconstruction using an RGB-D Camera

论文链接 效果图 摘要 我们展示一个结合硬件和软件来解决无标记重建非刚性形变目标,对于任意形状实时实现。我们的系统使用了一个简单自包含立体相机单元建造从成品的组成和消费 ...

CSS360的博客 786

AI论文探讨室·A+·第20期 SurfelWarp: Efficient Non-Volumetric Single View Dynamic Reconstruction

论文主页 摘要 作者贡献了一个稠密的SLAM系统,将一系列的深度图作为输入和实时的重建非刚性形变目标,没有模板和先验模型 。相对于存在的方法,本论文没有使用任何体素数据结构,例如截断符号距离函数(TSDF)区域或者非形变区域,它们是性能和内存密集型。我们的系统运行在一个平点(surfel)基于几何的展示,它能够直接从商业深度传感器获得。标准的图像流程和生成建议GPU(GPGPU)...

CSS360的博客 772
上一篇: AI论文探讨室·A+·第4期-Unsupervised Learning for Physical Interaction through Video Prediction
下一篇: AI论文探讨室·A+·第6期-Translating Visual Art into Music
元宇宙MetaAI
博客等级 码龄10年 331粉丝 333原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值