RAG系列(十一):复杂文档解析不理想?使用 TextIn xParse 轻松解析多样性 PDF 文档

TextIn ParseX文档解析参数使用指南(第一期) 本文讨论了TextIn ParseX通用文档解析这款适配多样化场景的PDF解析工具,介绍了其常用参数的作用及使用方法。关键要点包括解析页码参数、分辨率参数、加密文档参数、标题目录参数、获取JSON结果参数、页面元素参数及表格输出参数。 阅读详情

引言

在RAG系统的建设中,文档预处理是一个非常关键的环节,因为只有将文档中的图表、表格、公式以及手写批注等信息按阅读顺序还原出来,并最终解析为Markdown格式,这样才能够构建高质量的知识库和高效的信息检索系统,让LLM更好的读懂文档,最终给到用户更准确更全面的回答。

目前的文档解析工具算是百花齐放了,有很多优秀的开源工具(MinerU、Docling、Unstructured等等),在我之前的文章也有讲过。

今天给大家测评一款优秀的文档解析工具 - TextIn xParse[1] ,看下它的文档解析能力到底如何,希望通过我的测评能够给大家带来更多更好的选择。

为使本次测评能真正作为大家的选择参考,本次测评使用的数据集是由上海人工智能实验室开源的一个针对真实场景下多样性文档解析评测集 - OmniDocBench[2]。

OmniDocBench评测集涉及981个PDF页面,涵盖9种文档类型、4种排版类型和3种语言类型,文档覆盖面广,包含学术文献、财报、报纸、教材、手写笔记等,而且所有的标注都经过人工筛选,智能标注,人工标注及全量专家质检和大模型质检,数据质量较高,评测结果有很高的可信度。

TextIn xParse 简介

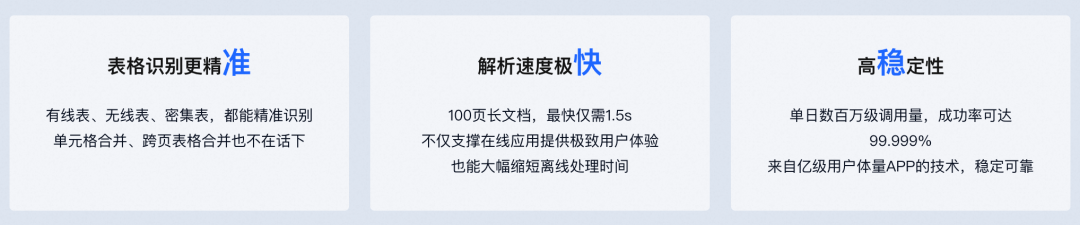
TextIn xParse是一个专为LLM下游任务设计的通用文档解析服务,具有解析速度快、稳定性高,特别是在表格识别上进行了专项优化。
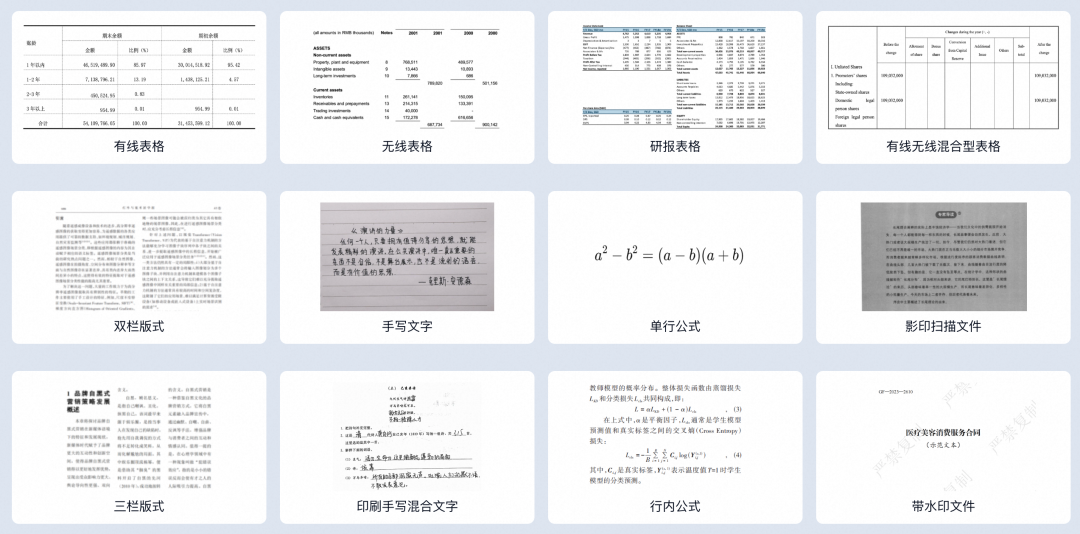
识别能力覆盖全面,具有各类常见文档的识别解析能力,支持标准的金融报告、国家标准、论文、企业招投标文件、合同、文书、工程图纸、电子书、试卷等文档内容。
TextIn xParse 测评

是否真如宣传的那样优秀,我们通过客观的测评来验证。

首先通过TextIn xParse对OmniDocBench评测集中的981个PDF页面进行解析,整体耗时1177s,平均一页的解析速度为1.2s,这个解析速度相比于开源工具(如MinerU)提供的线上服务快了将近8倍,解析速度非常的快,这个数据仅供参考,大家可以自行去体验。

接下来我们将TextIn xParse解析出来的981个Markdown文档,给到OmniDocBench提供的评测方法进行测评。

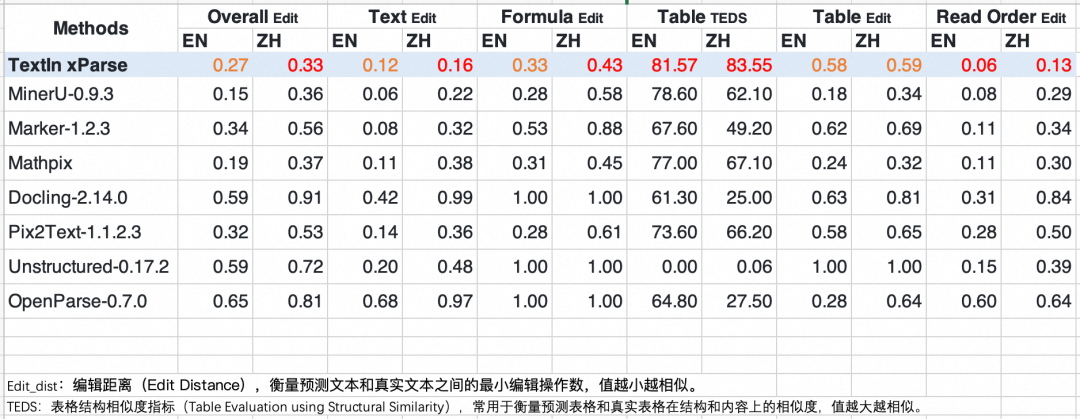
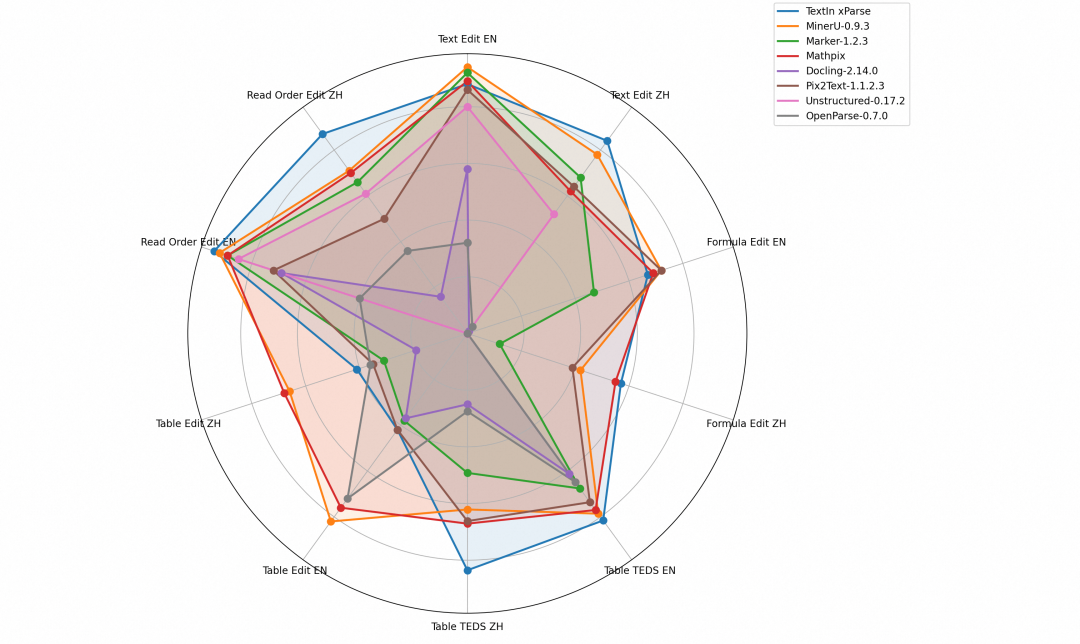
下图就是TextIn xParse和其它开源工具在文本、公式、表格以及阅读顺序这四大模块的具体表现:
指标说明:

  1. Edit Dist(编辑距离):,衡量预测文本和真实文本之间的最小编辑操作数,值越小越相似;

  2. TEDS(表格结构相似度):衡量预测表格和真实表格在结构和内容上的相似度,值越大越相似。

从整体(Overall Edit)来看,TextIn xParse不管是对英文文档(0.27)还是中文文档(0.33),都比大多数开源工具表现出色,由此可表明,TextIn xParse是一款能力较强且较为全面的文档解析工具。

下面我们看下TextIn xParse在不同模块的表现:

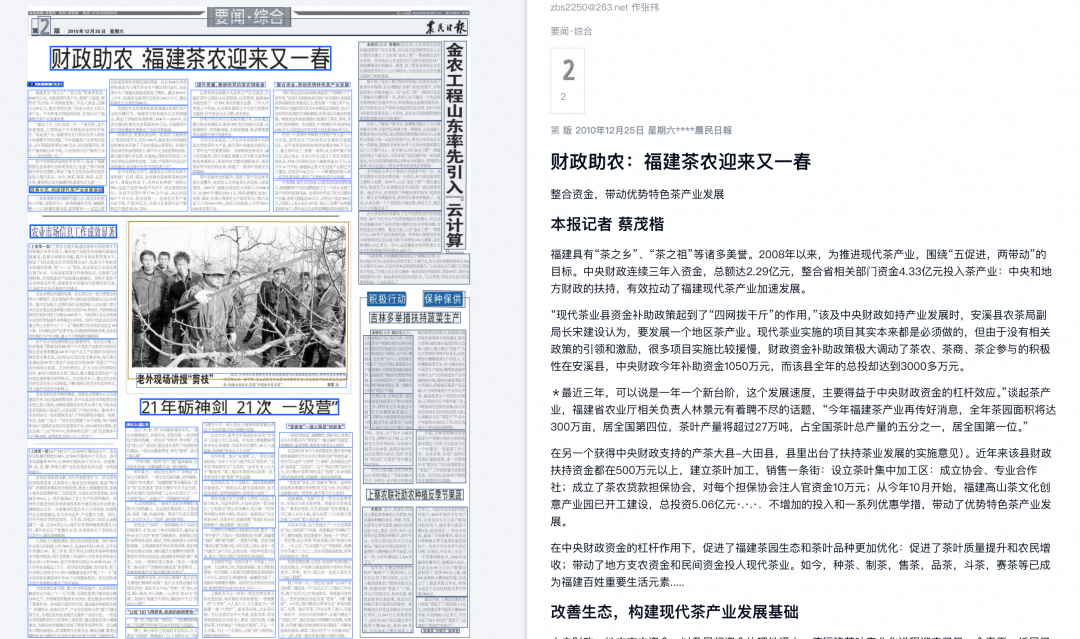
  • • 文本(Text Edit):TextIn xParse不管是对英文文档(0.12)还是中文文档(0.16)都表现出色,尤其是对于中文文档表现得最好,表明其在处理纯文本内容时具有较高的准确性;
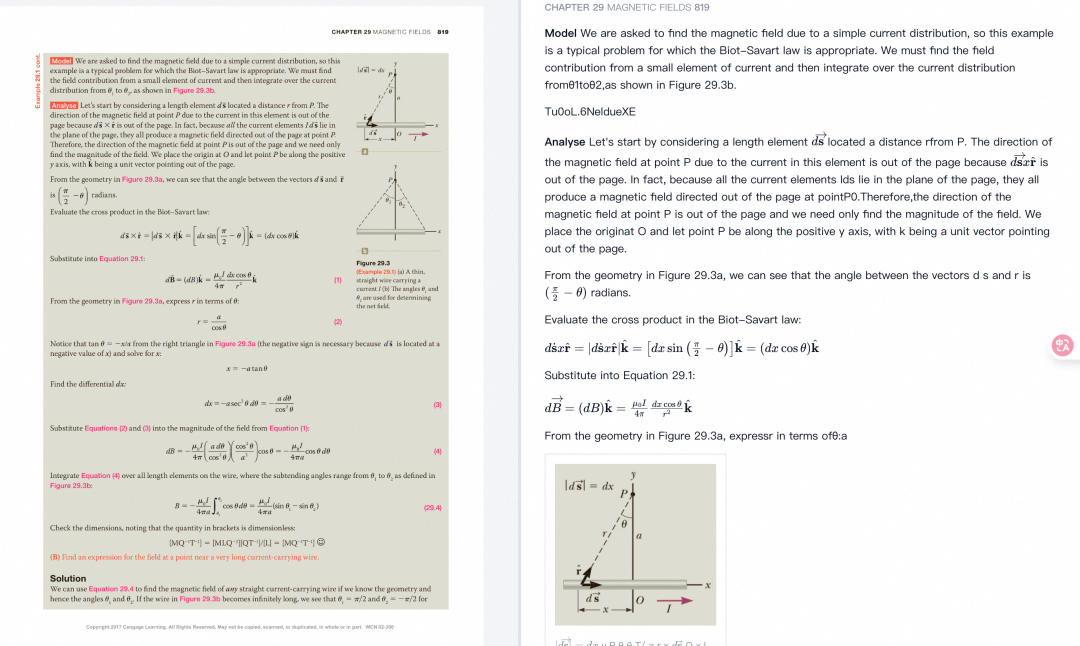
  • • 公式(Formula Edit):TextIn xParse不管是对英文文档(0.33)还是中文文档(0.43)都表现出色,尤其是对于中文文档表现依然是最好的,表明其在识别和解析公式时具有较高的准确性;
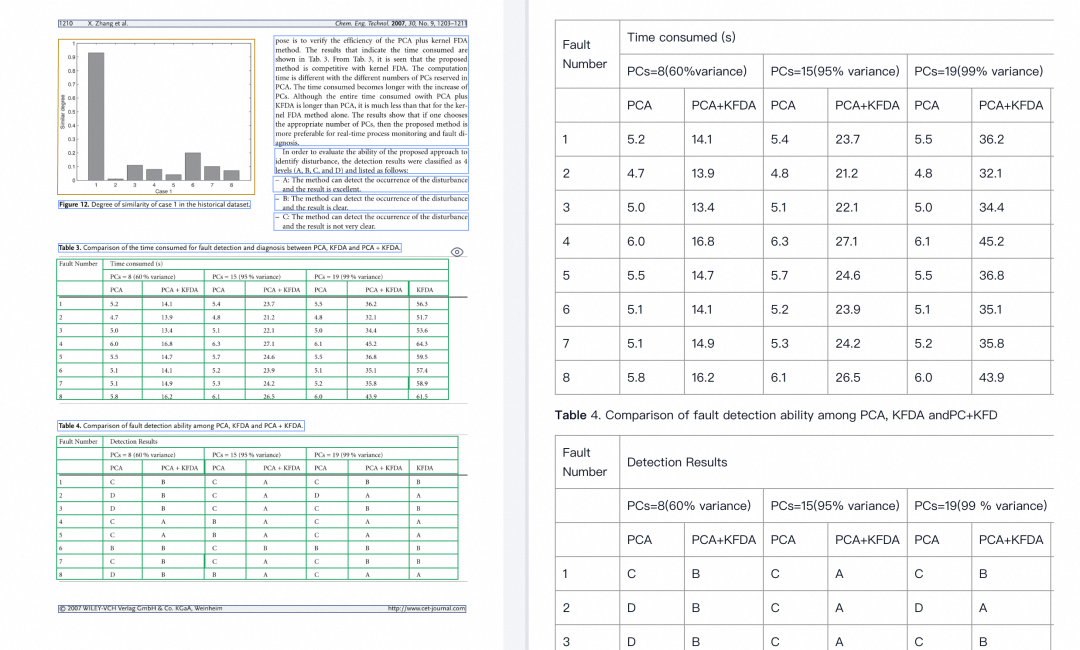
  • • 表格(Table TEDS/Edit):TextIn xParse表现优秀,其中在表格结构相似度上,无论是对英文文档(81.57)还是中文文档(83.55)都表现得最好,表明其在处理表格内容时能够很好地保持原始结构和内容,这也表明了TextIn xParse确实在表格识别上进行了专项优化;
  • • 阅读顺序:(Read Order Edit):TextIn xParse表现优秀,无论是对英文文档(0.06)还是中文文档(0.13)都表现得最好,表明其在保持文本阅读顺序方面具有很高的准确性。

TextIn xParse 集成

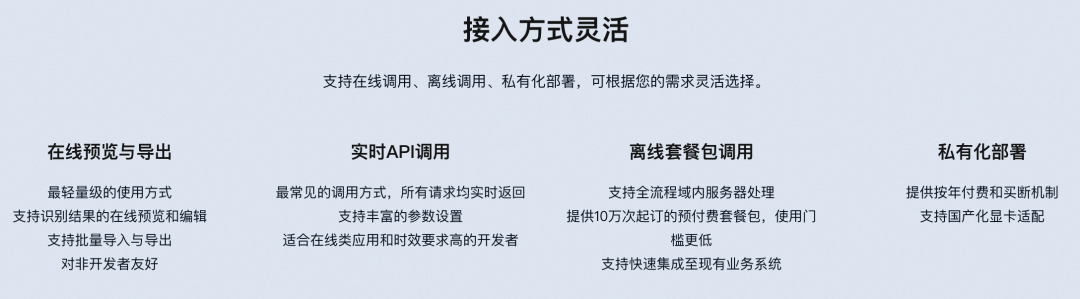
TextIn xParse提供了多种集成方式,支持在线预览与导出、实时API调用、离线调用以及私有化部署等方式,可根据您的需求灵活选择。
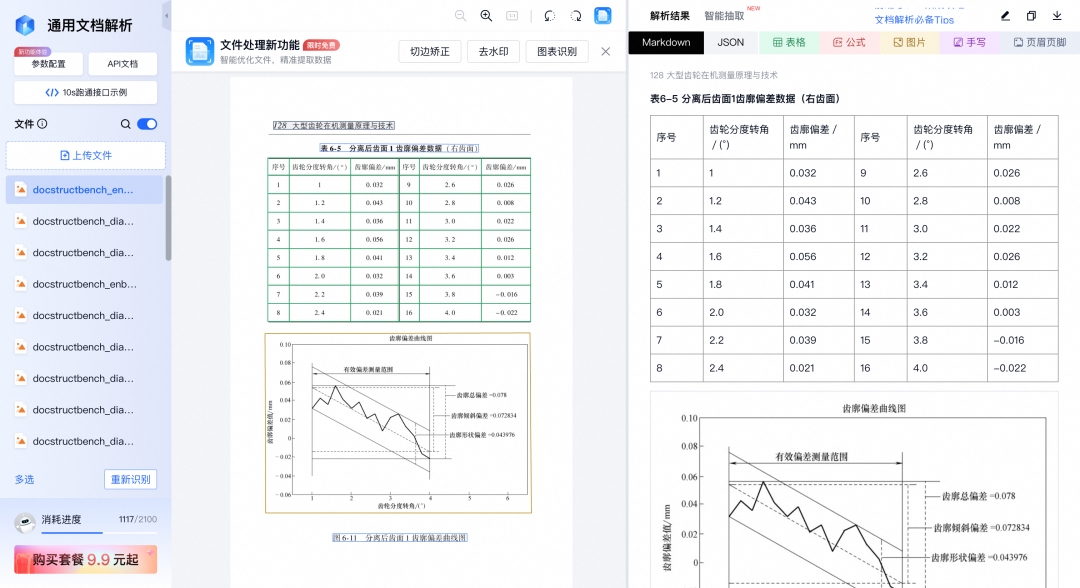
在线预览与导出

最轻量级的使用方式,支持识别结果的在线预览和编辑,支持批量导入与导出,对非开发者友好。
实时 API 调用

最常见的调用方式,所有请求均实时返回,支持丰富的参数设置,适合在线类应用和时效要求高的开发者。

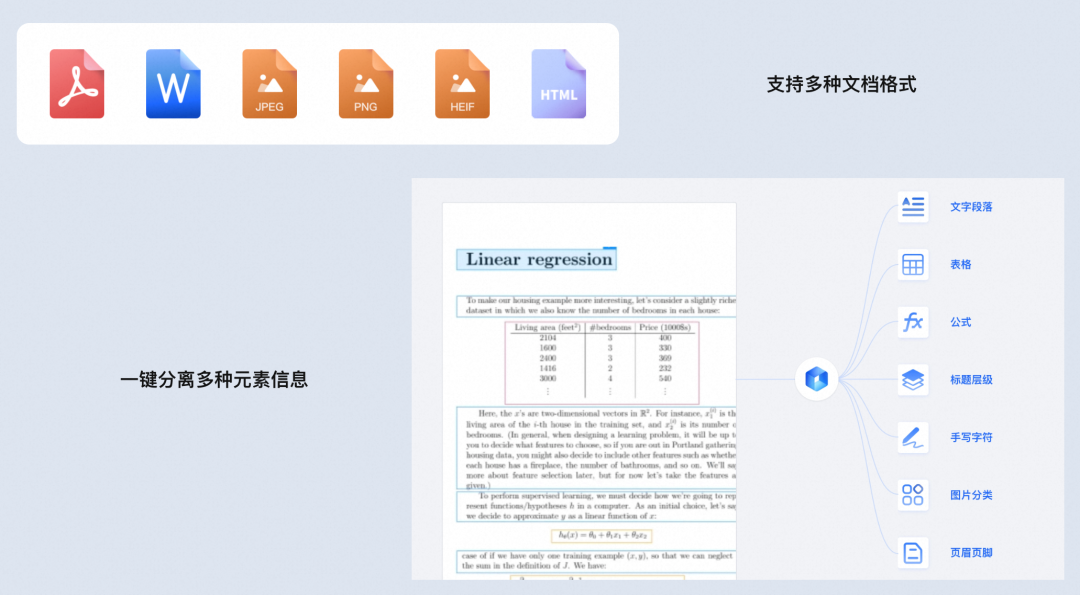
一个接口,支持PDF、Word(doc/docx)、常见图片(jpg/png/webp/tiff)、HTML等多种文件格式。一次请求,即可获取文字、表格、标题层级、公式、手写字符、图片信息。
实时API调用示例代码:

import requests
import json

def get_file_content(filePath):
withopen(filePath, 'rb') as fp:
return fp.read()

class TextinOcr(object):
def __init__(self, app_id, app_secret):
self._app_id = app_id
self._app_secret = app_secret
self.host = 'https://api.textin.com'

def recognize_pdf2md(self, image_path, options, is_url=False):
        url = self.host + '/ai/service/v1/pdf_to_markdown'
        headers = {
'x-ti-app-id': self._app_id,
'x-ti-secret-code': self._app_secret
        }
if is_url:
            image = image_path
            headers['Content-Type'] = 'text/plain'
else:
            image = get_file_content(image_path)
            headers['Content-Type'] = 'application/octet-stream'

return requests.post(url, data=image, headers=headers, params=options)

if __name__ == "__main__":
# 请登录后前往 “工作台-账号设置-开发者信息” 查看 app-id/app-secret
    textin = TextinOcr('#####c07db002663f3b085#####', '######1b1b11a9f9bcd7cc7b######')

# 示例 1:传输文件
    image = 'file/example.pdf'
    resp = textin.recognize_pdf2md(image)

# 示例 2:传输 URL
    image = 'https://example.com/example.pdf'
    resp = textin.recognize_pdf2md(image, True)

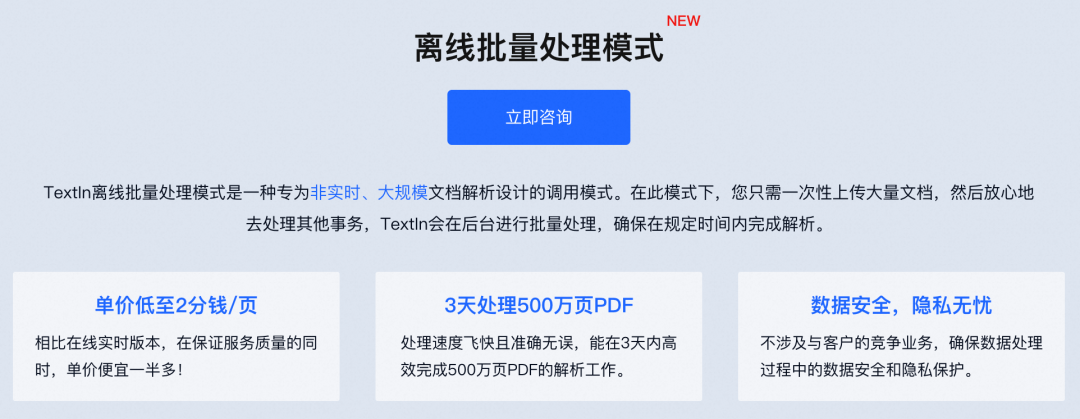
离线调用

支持全流程域内服务器处理,提供10万次起订的预付费套餐包,使用门槛更低,支持快速集成至现有业务系统。
私有化部署

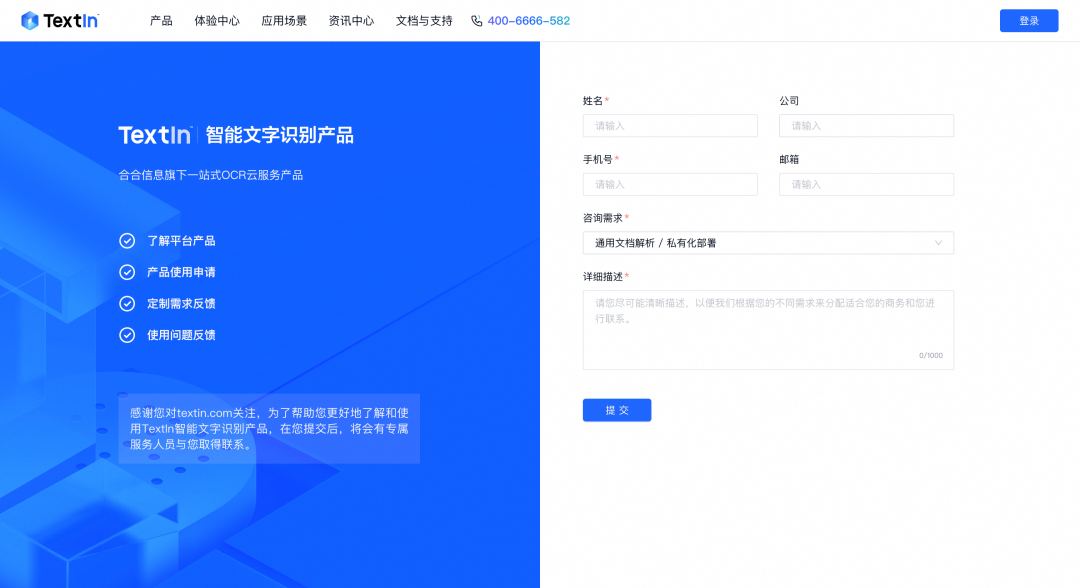
提供按年付费和买断机制,支持国产化显卡适配,让你放心处理企业内部数据,无惧数据流失。

提交私有化部署需求后,会有专属服务人员与您联系和对接。
结语

本文通过使用OmniDocBench提供的评测数据集和方法对TextIn xParse进行了客观且全面的评测,综合最终的评测结果来看,TextIn xParse确实是一款能力较强且较为全面的文档解析工具。而TextIn xParse也考虑到了不同的用户和场景,提供了多种灵活的集成方式,您可根据具体需求来灵活选择,非常的友好。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

告别碎片化输入:TextIn xParse如何为RAG打造「零损耗」知识管道 TextInxParse智能文档解析引擎是提升RAG系统效能的关键工具。它通过深度结构化解析,精准还原PDF、Word等文档的标题层级、表格数据、跨页内容等复杂元素,输出标准化的Markdown/JSON格式。相比传统OCR,该工具能显著提升检索效率30%以上,确保答案准确性,并完整保留关键信息。其核心优势包括:行业领先的表格识别能力(支持合并单元格、跨页表格等)、多语言支持、图像处理功能,以及开发者友好的API集成。典型应用场景涵盖金融报表解析、学术内容重建、医疗数据处理等领域。通过提供结构化数据输入,T 阅读详情

相关推荐

SAP采购含税价转换的底层逻辑解析:ABAP例程如何实现价税分离计算

本文深入解析SAP系统中采购含税价与不含税价的转换机制,重点介绍VOFM例程和ABAP代码实现价税分离计算的方法。通过详细讲解数学原理、税率体系及SAP定价引擎架构,为开发人员提供完整的解决方案,帮助提升采购业务中的价格处理效率和准确性。

weixin_29237635的博客 450

大模型知识库构建利器:TextIn xParse 文档解析全测评

TextIn xParse是合合信息推出的智能文档解析工具,擅长处理复杂文档(含跨页表格、合并单元格等),可将PDF、Word等转为结构化数据。相比传统OCR,它能保留标题层级、段落关系等语义信息,支持导出Markdown/JSON/Excel格式。实测显示其对无线表格、嵌套表头等复杂场景解析效果优异,适合企业知识库构建和RAG应用优化。提供在线体验、API接入等多种使用方式,是处理复杂文档的理想选择。

Trb701012的博客 1497

【学习总结】飞跨电容三电平boost拓扑发波分析与matlab仿真

正常工作时,飞跨电容的电压大约控制在输出电压的一半,降低了开关器件的耐受电压。

晞子的技术札记 1万+

复杂表格解析横评:TextIn xParse 、MinerU 、PaddleOCR,谁能让数据真正进系统?

多层表头与合并单元格密集小表字跨页长表正常✅正常✅正常✅minerU多层表头内容丢失正常✅生成两张表paddle_ocr多层表头内容丢失有好几列没识别出来,且有一列丢失正常✅。

编码世界 12万+

Agv、Rgv 车辆控制调度系统开发第一篇

Agv、Rgv 车辆控制调度系统第一篇为什么要做这个系统先看作品从头讲起算法讲解编程语言从哪里开始继续深入预告 为什么要做这个系统 说白了是为了赚钱,在一个项目中发现公司买别人家的调度系统要几十万,还只是一个项目的实施,从那天起我就决定自己写一套,用了一年的时间写出来后,才发现根本卖不掉,卖不掉就卖不掉吧,反正我现在已经吧写这套系统当成了一种乐趣,如果不让我写了我反而不适应,但是没有人欣赏我的成果我反而很难受,所以决定吧这个系统的创作过程,写下来,给后面的人一些建议,少走点弯路。 先看作品 从头讲起 在

持续分享调度系统开发过程 2万+

概率的接力:拆解大模型“预测下一个词“的底层逻辑

大模型的智能不在于它拥有了意识,而在于它用纯数学的架构,将人类语言的复杂结构压缩为可计算的向量轨迹与概率接力。当我们不再将其拟人化为"思考者",而是视作高维条件概率引擎时,才能真正驾驭它。预测下一个词,从来不是终点,而是起点。未来的核心竞争力,属于那些能洞察其统计本质、善用其模式生成能力,并以人类理性与事实为锚点的协作者。词元的轨迹终会止步于上下文窗口,但对技术底层的清醒认知,才是跨越幻觉、走向真实智能的基石。

AI浩 330

TextIn ParseX重磅功能更新:支持切换公式输出形式、表格解析优化、新增电子档PDF去印章

国际物流运输中,运单信息包含发货人和收货人的详细地址,这些地址往往包含多行信息,如门牌号、街道、城市、国家等。在解析学术论文、国标文件、试卷等文档时,精确识别并保留公式的完整结构(如上下标、积分符号、矩阵等),以便用于学术引用、智能判题使用。电子档的银行流水、银行对账单、银行回单等材料,通常都有印章,如果不去除,会影响识别结果中的数字准确率,导致下游数据处理出错。,用户可以通过参数控制不同层级的输出,支持自由切换公式输出形式,实现对公式解析的差异化需求。表格解析支持单元格内换行的处理。

TextIn智能文档云平台的官方博客 1183

基于Playwright和反爬虫规避技术的雪球股票讨论数据采集方案

随着量化投资和社交投资的兴起,雪球作为中国领先的投资社交平台,其用户讨论数据成为研究市场情绪的重要来源。本文将详细介绍如何使用最新的Playwright技术和反爬虫规避策略,构建一个高效、稳定的雪球股票讨论爬虫系统。本文详细介绍了基于Playwright的雪球股票讨论爬虫实现方案,涵盖了从基础配置到高级反爬虫策略的各个方面。AI驱动的反爬虫对抗更智能的请求调度算法区块链技术在数据溯源中的应用联邦学习在数据采集中的运用。

2201_76125261的博客 1009

【万字长文】解决RAG系统痛点:TextIn xParse智能文档解析引擎实战指南!

文章介绍了TextIn xParse智能文档解析引擎,强调文档解析质量是RAG系统和AI应用效果的关键。该引擎能将非结构化文档(PDF、Word、Excel等)转换为高度结构化的数据(Markdown/JSON),解决传统OCR工具的局限性,提供表格识别、标题层级还原、跨页段落合并等功能。通过提供高质量数据输入,TextIn xParse可提升RAG系统的检索效率、答案准确性和信息完整性,是构建高效AI应用的关键基础设施。

m0_59162248的博客 1249

计算机视觉卷积神经网络(CNN)基础:从LeNet到ResNet

计算机视觉卷积神经网络(CNN)基础:从LeNet到ResNet,在计算机视觉领域,卷积神经网络(Convolutional Neural Network,CNN)已然成为推动众多任务发展的核心力量。从早期简单的图像识别,到如今复杂的目标检测、语义分割、图像生成等任务,CNN 都展现出了卓越的性能。CNN 的发展历程见证了一系列经典模型的诞生,其中 LeNet 作为开山之作,为 CNN 的发展奠定了基础,而 ResNet 则通过创新性的设计,突破了传统神经网络的限制,使得网络能够构建得更深、性能更优。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 14万+

会计-合并-5- 增资、处置交易在合报与个报会计处理

摘要:本文系统梳理了股权投资会计处理的四种情形:从交易性金融资产转为权益法或成本法、权益法转成本法、权益法增持。核心原则是区分个报与合报处理,重点关注原投资公允/账面价值的计量差异及损益确认逻辑。对不丧失控制权的股权处置,个报确认投资收益,合报调整资本公积;丧失控制权时,个报需追溯调整权益法核算,合报计算综合投资收益。一揽子交易的特殊处理强调将过渡性差额暂记其他综合收益,最终丧失控制权时转入当期损益。文末通过典型案例演示了不同情境下的具体计算方法。

qq_34047402的博客 466

RAG系列:复杂文档解析不理想?使用 TextIn xParse 轻松解析多样性 PDF 文档

TextIn xParse是一个专为LLM下游任务设计的通用文档解析服务,具有解析速度快、稳定性高,特别是在表格识别上进行了专项优化。识别能力覆盖全面,具有各类常见文档的识别解析能力,支持标准的金融报告、国家标准、论文、企业招投标文件、合同、文书、工程图纸、电子书、试卷等文档内容。本文通过使用OmniDocBench提供的评测数据集和方法对TextIn xParse进行了客观且全面的评测,综合最终的评测结果来看,TextIn xParse确实是一款能力较强且较为全面的文档解析工具。

jike007gt的博客 559

3.PCIe协议分析1-预备知识点

PCIE协议分析1主要讲一下四方面: PCI-E配置空间 PCI-E地址映射 PCI-E Bar空间 PCI-E层级结构详谈 (1)PCIE配置空间 我们过来学习PCIE的同学应该都接触各种类型的功能芯片吧,这些功能芯片连接在电路里面我们可以认为它是一个外部设备,这些设备里面有自己独有的寄存器区域,比如SDRAM里面的ID寄存器或者其他配置寄存器。好的,其实我们PCIE板卡也相当...

一个早起的程序员 4144

低门槛实现 AI 文档解析 | TextIn xParse Dify插件使用教程

Dify平台的TextInxParse插件为开发者提供了强大的文档解析能力,支持PDF、Word、Excel等多种格式处理。该插件集成多种解析引擎,可灵活选择TextIn自研引擎(推荐)、MinerU等方案,实现文档内容的结构化提取。通过两个实战案例展示了插件的应用场景: 1)构建ChatDocument问答应用; 2)自动化批量处理文档并上传至S3存储。插件还支持RAG应用构建、信息提取Agent等更多场景,显著提升文档处理效率。 开发者可通过Dify市场获取该插件,并按指引配置APIKey使用。

INTSIG的博客 1762

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

TextIn:文档全能助手,让学习效率飙升的良心软件~

TextIn,作为一款功能强大的文档处理工具,旗下拥有众多实用功能,而 TextIn xParse 作为专为 LLM 下游任务设计的通用文档解析服务,更是其中的核心产品之一,能全方位应对不同用户在文档处理方面的各类需求,对于大学生而言,也能在学习过程中提供极大助力。TextIn xParse 主要致力于将复杂文档转变为结构化数据,让任意文档的信息都能高效准确流入数据库,将非结构化内容转化为可查询、可分析的宝贵数据资产,且兼容关系型数据库与向量数据库。

Pocker_Spades_A的博客 1万+

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

RAG精度飙升?实测TextIn xParse结构化解析,跨页表格拼接太6了!

TextInxParse智能文档解析引擎是提升RAG系统和AI应用效能的关键工具。它突破传统OCR局限,能精准解析PDF、Word等十余种格式的复杂文档,将其转化为结构化Markdown或JSON数据,完整保留标题层级、表格、图表等元素及其语义关系。该工具解决了金融报表、学术论文、法律文书等专业文档的解析难题,显著提升RAG系统的检索准确性和LLM生成质量。通过在线平台和API两种方式提供服务,支持50+语言,具备企业级部署能力,为知识管理、智能问答等场景提供高质量数据输入,是AI应用落地的关键基础设施。

TextIn智能文档云平台的官方博客 1316

解析天花板?TextIn xParse如何为RAG打造「零损耗」知识管道

文档解析是一款大模型友好的解析工具,能够精准还原pdf、word、excel、ppt、图片等十余种格式的非结构化文件,将其快速转换为Markdown或JSON格式返回,同时包含精确的页面元素和坐标信息。支持识别文本、图像、表格、公式、手写体、表单字段、页眉页脚等各种元素,并支持印章、二维码、条形码等子类型,为LLM推理、训练输入高质量数据,帮助完成数据清洗和文档问答任务,适用于各类AI应用程序,如知识库、RAG、Agent或其他自定义工作流程。

具身机器人和通用AI 765

从非结构化数据到“LLM友好”,TextIn xParse让RAG检索更准、生成更稳

TextIn xParse文档解析是一款大模型友好的解析工具,能够精准还原pdf、word、excel、ppt、图片等十余种格式的非结构化文件,将其快速转换为Markdown或JSON格式返回,同时包含精确的页面元素和坐标信息。支持识别文本、图像、表格、公式、手写体、表单字段、页眉页脚等各种元素,并支持印章、二维码、条形码等子类型,为LLM推理、训练输入高质量数据,帮助完成数据清洗和文档问答任务,适用于各类AI应用程序,如知识库、RAG、Agent或其他自定义工作流程。

终码一生 906

大模型应用潜力:高质量文档解析技术与RAG系统优化

文档解析是一款大模型友好的解析工具,能够精准还原pdf、word、excel、ppt、图片等十余种格式的非结构化文件,将其快速转换为Markdown或JSON格式返回,同时包含精确的页面元素和坐标信息。支持识别文本、图像、表格、公式、手写体、表单字段、页眉页脚等各种元素,并支持印章、二维码、条形码等子类型,为LLM推理、训练输入高质量数据,帮助完成数据清洗和文档问答任务,适用于各类AI应用程序,如知识库、RAG、Agent或其他自定义工作流程。

老皮的博客 1063

突破RAG精度瓶颈,大模型时代下必备的文档解析引擎!

在AI应用极速发展的当下,LLM(大语言模型)与RAG(检索增强生成)系统已成为构建智能问答、知识管理等高阶应用的核心引擎。

2301_81940605的博客 849

突破RAG精度瓶颈,大模型时代下必备的文档解析引擎!大模型入门到精通,收藏这篇就足够了!

在AI应用极速发展的当下,LLM(大语言模型)与RAG(检索增强生成)系统已成为构建智能问答、知识管理等高阶应用的核心引擎。

瓦罗兰特顶级C位的博客 1011

突破RAG精度瓶颈,大模型时代下必备的文档解析引擎,大模型入门到精通,收藏这篇就足够了!

在AI应用极速发展的当下,LLM(大语言模型)与RAG(检索增强生成)系统已成为构建智能问答、知识管理等高阶应用的核心引擎。

瓦罗兰特顶级C位的博客 1267

文档解析API哪个好用

在构建企业知识库或RAG系统时,文档解析质量直接决定了大模型理解的上限。市面上文档解析API众多,但真正能应对复杂场景的却屈指可数。从跨页表格到手写公式,从多栏布局到扫描件识别,每一个技术难点都可能成为项目的拦路虎。本文将基于实际测评和技术对比,为你揭示选择文档解析API时必须关注的核心要素,以及TextIn如何凭借企业级能力脱颖而出。

TextIn智能文档云平台的官方博客 581

文档解析在RAG中起什么作用?

TextIn xParse的解析能力覆盖金融报表、学术内容、企业合规文档、K12学习资料、临床医疗数据、法律条款等多类场景,能精准处理医保基金监管、企业招投标、金融投研、临床诊疗等各领域的专业文档,将非结构化的私有文档转化为可被RAG系统利用的标准化知识,助力各行业盘活核心知识资产,赋能智能监管、智能问答、知识管理等高阶AI应用。文档解析是RAG系统实现高效检索与精准生成的前置核心步骤,指将PDF报告、扫描文件、图文技术文档、跨页表格等高度非结构化的知识载体,转化为机器可理解的结构化数据的过程。

TextIn智能文档云平台的官方博客 644
上一篇: RAG系列(十二):MinerU、Docling还是Unstructured?用OmniDocBench评测开源文档解析工具
下一篇: 从0到1精通LangChain:Part 1,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值