RAG系列(十二):MinerU、Docling还是Unstructured?用OmniDocBench评测开源文档解析工具

OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations 类型:学术论文(计算机视觉领域,聚焦文档解析基准构建)作者:Linke Ouyang、Yuan Qu、Hongbin Zhou、Jiawei Zhu、Rui Zhang、Qunshu Lin、Bin Wang 等(上海 AI 实验室、Abaka AI、2077AI 等机构研究者)、年份:2025 年(预印本发布日期为 2025 年 3 月 25 日)期刊:CVPR 2025。 阅读详情

引言

从写 RAG 开发入门这一系列文章开始,特别是文档解析这个环节,有很多读者询问某个文档解析工具的能力怎么样,和其它工具对比如何,这表明开源社区虽然涌现出了很多的文档解析工具,但是它们在实际场景的表现到底如何,这在很多人中是没有太明确答案的。因而,面对众多工具的选择,我们期望能有一个统一的基准来评估其实际效果,而且对于大部分人来说是需要开箱即用的。

本文我将介绍一款由上海人工智能实验室开源的多源文档解析评测框架 - OmniDocBench[1],凭借其多样性、全面性和高质量标注数据以及配套的评测代码,是一个不错的衡量文档解析工具性能的选择。

目前OmniDocBench已被CVPR2025接受! CVPR2025是计算机视觉与模式识别领域的顶级国际学术会议,被誉为计算机视觉领域的“三大顶会”之一(与ICCV、ECCV并列)。

OmniDocBench论文[2]:

https://arxiv.org/html/2412.07626v1
高质量基准测试集

OpenDataLab下载地址:https://opendatalab.com/OpenDataLab/OmniDocBench

Hugging Face下载地址:https://huggingface.co/datasets/opendatalab/OmniDocBench

高质量基准测试集是OmniDocBench的核心价值,其特点主要包括:

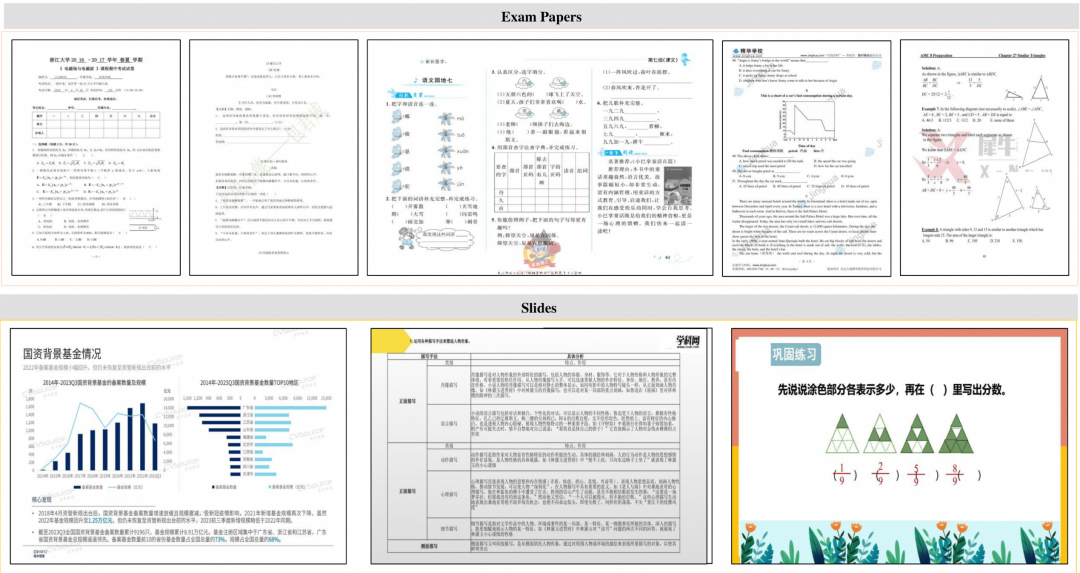
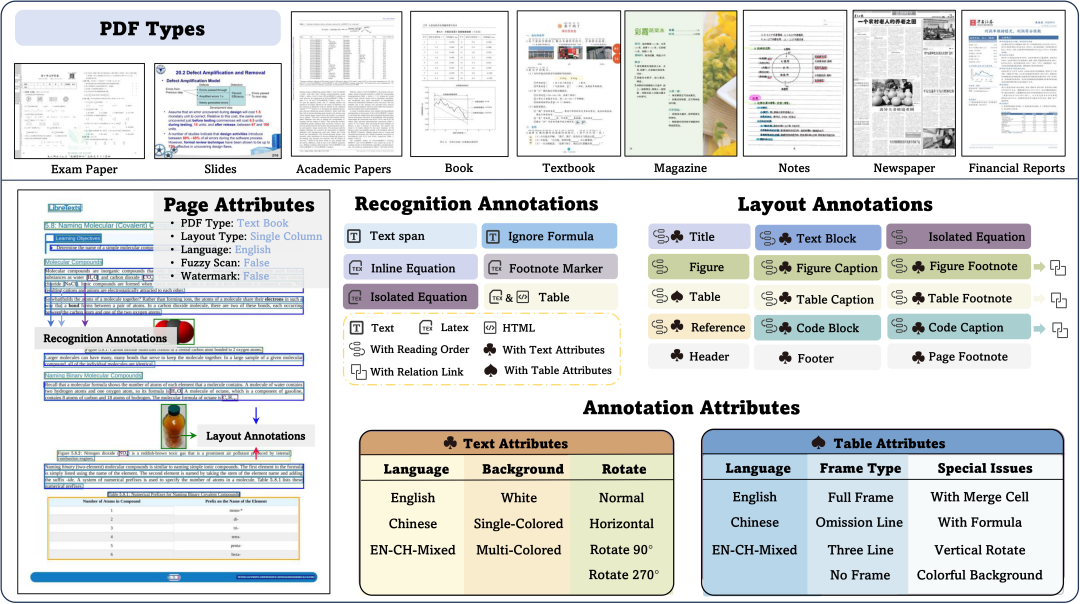
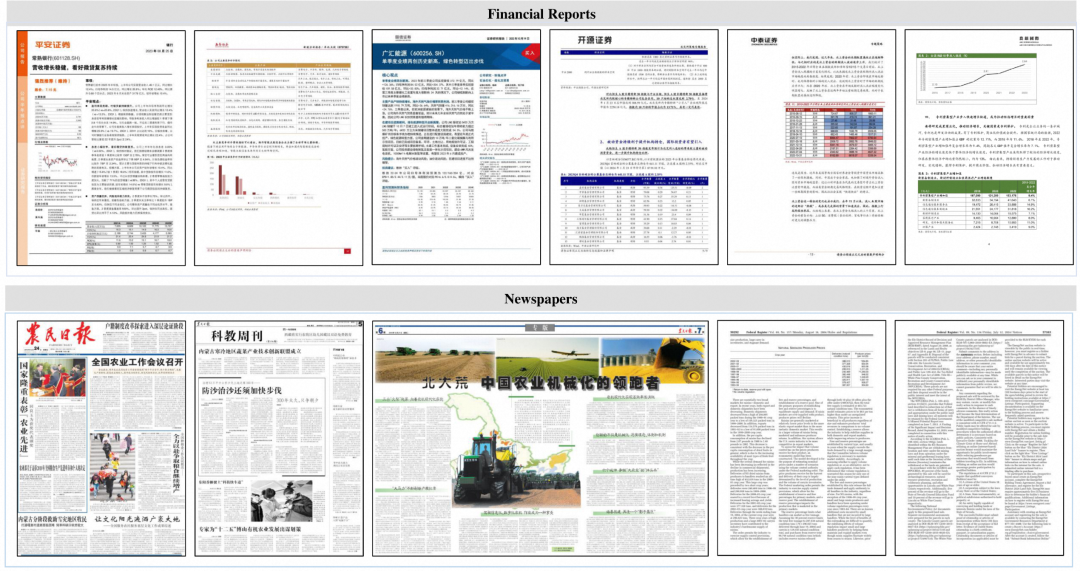
  • • 文档类型多样:该评测集涉及 981 个 PDF 页面,涵盖9 种文档类型(如学术文献、财报、报纸、教材、手写笔记等)、4 种排版类型(表格密集型、图文混合型、纯文本型等)和3 种语言类型(中文、英文、混合语种);
  • • 标注信息丰富:包含 15 个 block 级别(文本段落、标题、表格等,总量超过 20k)和 4 个 Span 级别(文本行、行内公式、角标等,总量超过 80k)的文档元素的定位信息,以及每个元素区域的识别结果(文本 Text 标注,公式 LaTeX 标注,表格包含 LaTeX 和 HTML 两种类型的标注)。OmniDocBench 还提供了各个文档组件的阅读顺序的标注。除此之外,在页面和 block 级别还包含多种属性标签,标注了 5 种页面属性标签、3 种文本属性标签和 6 种表格属性标签;
  • • 标注质量高: 经过人工筛选、智能标注、人工标注及全量专家质检和大模型质检,数据质量较高。
数据展示
支持多种衡量指标

OmniDocBench目前支持的衡量指标包括:

    1. Normalized Edit Distance(归一化编辑距离):这个指标计算两个字符串之间的最小编辑操作次数(包括插入、删除、替换),并将这个距离进行归一化处理,通常用于衡量两个字符串或文本序列之间的相似度。归一化处理是为了让结果在 0 到 1 之间,便于比较;
    1. BLEU(双语评价替补/Bilingual Evaluation Understudy):BLEU 是机器翻译领域中常用的自动评估指标,它通过比较候选译文和一组参考译文之间的 n-gram 重叠程度来计算得分,以此衡量机器翻译的质量。BLEU 分数越高,表示机器翻译的结果越接近人工翻译;
    1. METEOR(基于明确排序的翻译评估/Metric for Evaluation of Translation with Explicit ORdering):METEOR 是一个更加复杂的翻译质量评估指标,它不仅考虑了单词精确匹配,还包括词干匹配、同义词匹配等,并且会根据词序差异对得分进行调整。因此,它比 BLEU 更能反映句子间的语义相似性;
    1. TEDS(基于树编辑距离的表格相似度/Tree-based Edit Distance for Tables):TEDS 是一种专门用来评估表格结构相似度的指标。它将表格转换为树形结构,然后计算两棵树之间的编辑距离,以此来衡量表格结构上的相似度。这种指标特别适用于表格解析或者表格生成任务中的准确性评估;
    1. COCODet (mAP, mAR, etc.):COCODet 指的是使用在 COCO 数据集上定义的一系列目标检测性能评估指标,主要包括:
  • • mAP(平均精度均值/Mean Average Precision):衡量模型在不同 IoU(交并比)阈值下的平均精度;
  • • mAR(平均召回率均值/Mean Average Recall):衡量模型在不同 IoU 阈值下的平均召回率。

每个指标都有其特定的应用场景和优势,你可根据具体的应用需求和上下文配置合适的衡量指标。

开箱即用的评测方法

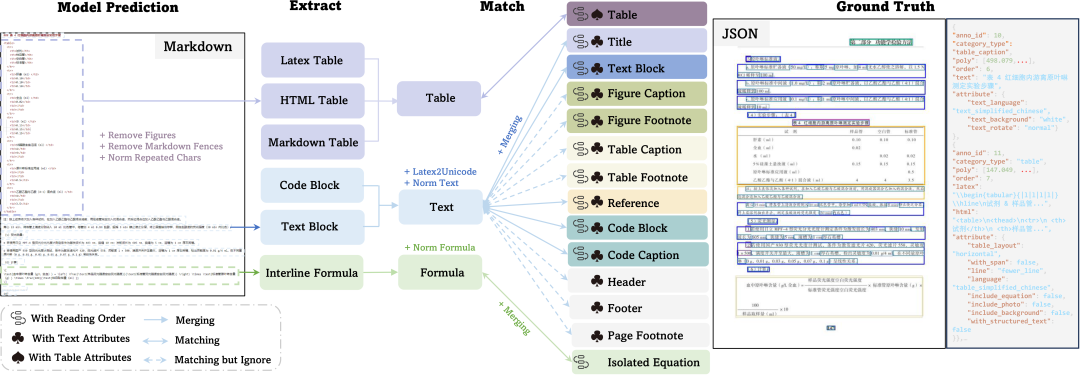
OmniDocBench开发了一套基于文档组件拆分和匹配的评测方法,对文本、表格、公式、阅读顺序这四大模块分别提供了对应的指标计算,评测结果除了整体的精度结果以外,还提供了分页面以及分属性的精细化评测结果,精准定位模型文档解析的痛点问题。
下载项目

git clone https://github.com/opendatalab/OmniDocBench.git

环境配置和运行

conda create -n omnidocbench python=3.10
conda activate omnidocbench
pip install -r requirements.txt

下载评测集

OpenDataLab下载地址:https://opendatalab.com/OpenDataLab/OmniDocBench

Hugging Face下载地址:https://huggingface.co/datasets/opendatalab/OmniDocBench

评测集的文件夹结构如下:

OmniDocBench/
├── images/     // Image files
│   ├── xxx.jpg
│   ├── ...
├── pdfs/       // Same page as images but in PDF format
│   ├── xxx.pdf
│   ├── ...
├── OmniDocBench.json // OmniDocBench ground truth

评测配置

所有的评测的输入都是通过config文件进行配置的,在configs路径下提供了各个任务的模板。

比如端到端评测,你只需要在end2end.yaml文件中的ground_truth的data_path中提供 OmniDocBench.json的路径,在prediction的data_path中提供包含推理结果的文件夹路径,如下:

# -----以下是需要修改的部分 -----
dataset:
dataset_name:end2end_dataset
ground_truth:
data_path:./OmniDocBench.json
prediction:
data_path:path/to/your/model/result/dir

配置好config文件后,只需要将config文件作为参数传入,运行以下命令即可进行评测:

python pdf_validation.py --config configs/end2end.yaml

对开源工具的评测

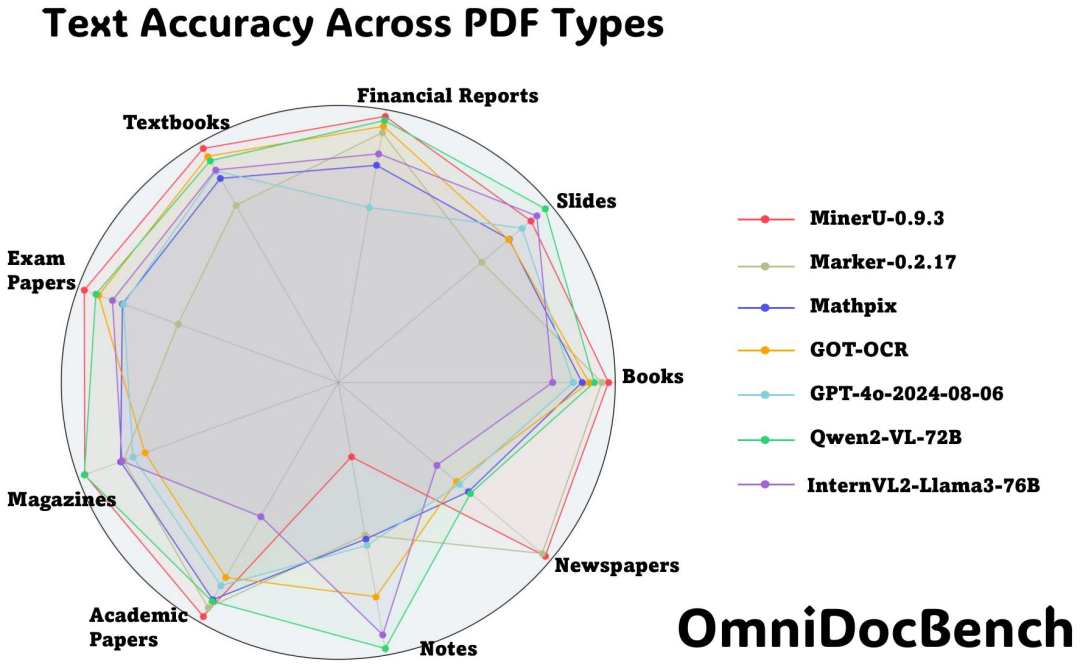
可以端对端评测综合能力,也可以分项(文本、公式、表格、布局)评测。

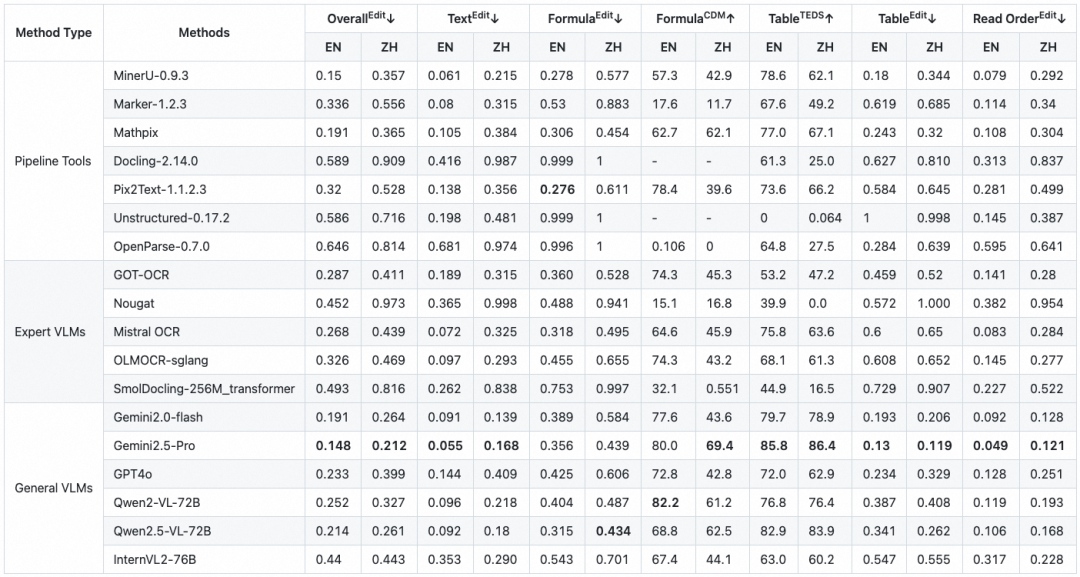
下面各个开源工具/模型的评测结果均是基于OmniDocBench的真实评测,可直接作为选择的依据。

端到端评测

端到端评测是对模型在PDF页面内容解析上的精度作出的评测。以模型输出的对整个PDF页面解析结果的Markdown作为Prediction。
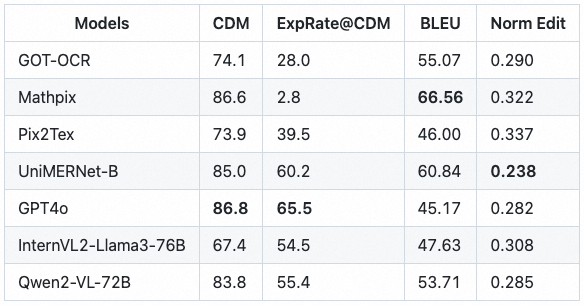
公式识别评测

OmniDocBench包含每个PDF页面的公式的bounding box信息以及对应的公式识别标注(包括行间公式equation_isolated和行内公式equation_inline),因此可以作为公式识别评测的benchmark。
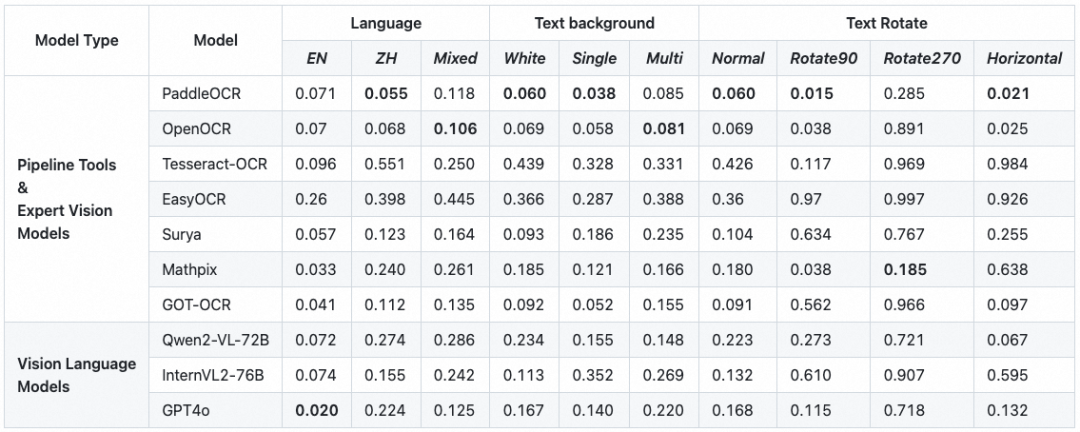
文字OCR评测

OmniDocBench包含每个PDF页面的所有文字的bounding box信息以及对应的文字识别标注(包含block_level的标注和span_level的标注),因此可以作为OCR评测的benchmark。
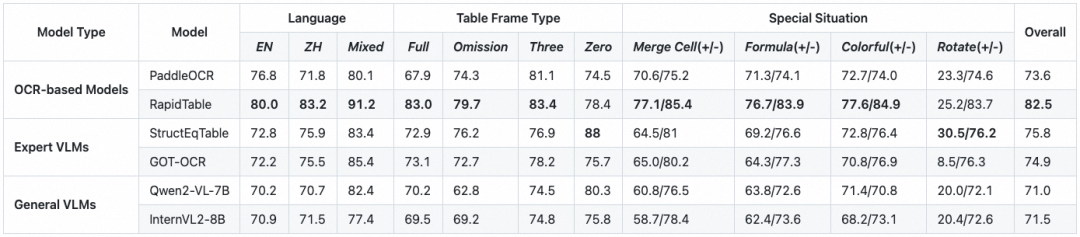
表格识别评测

OmniDocBench包含每个PDF页面的公式的bounding box信息以及对应的表格识别标注(包括HTML和LaTex两种格式),因此可以作为表格识别评测的benchmark。
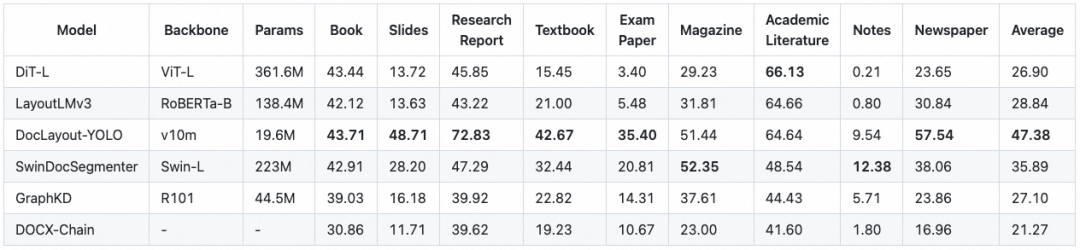
布局检测

OmniDocBench包含每个PDF页面的所有文档组件的bounding box信息,因此可以作为布局检测任务评测的benchmark。
结语

本文给大家介绍了一款由上海人工智能实验室开源的多源文档解析评测框架-OmniDocBench,希望大家通过该评测框架,可以选出适合自己实际业务场景的文档解析工具。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

C# 动态壁纸实战:7步带你从零开始制作动态壁纸 动态壁纸是指在计算机桌面上播放视频、动画或交互式内容的一种技术。与传统的静态壁纸相比,动态壁纸更加生动有趣,可以大大提升桌面的观赏性和互动性。通过本文的详细讲解和代码示例,相信你已经学会了如何使用C#实现动态壁纸。动态壁纸不仅能够提升桌面的美观度,还能展示你的编程技能。希望这篇教程对你有所帮助,期待你在C#编程中取得更大的成就!🌟✨如果你有任何问题或建议,欢迎在评论区留言交流!希望这篇教程对你有所帮助,期待你在C#编程中取得更大的成就!😊✨😊✨。 阅读详情

相关推荐

Ubuntu 24.04 搭建 Squid 代理服务器终极指南:从入门到 HTTPS 缓存AI模型

本文详细指导在Ubuntu 24.04系统部署Squid代理服务器,实现AI大模型文件的高效缓存。重点内容包括:1) 安装squid及必备的squid-openssl扩展包;2) 配置HTTPS拦截(SSL-Bumping)功能,创建CA证书和SSL数据库;3) 优化缓存策略,设置4TB存储空间并强制缓存常见大文件格式;4) 结合华为防火墙实现透明代理。文章特别强调实际部署中的关键注意事项和常见错误解决方案,如证书路径配置、权限设置等问题,帮助用户快速搭建企业级缓存代理服务。

zlt315的博客 1920

OmniDocBench:一键评测PDF解析算法

OmniDocBench应该是目前类型最丰富、标注粒度最详细的PDF解析评测数据集了,对于评估PDF解析算法,意义重大。最新的PP-StructureV3简介 - PaddleOCR 文档便给出了在OmniDocBench上的评测对比,可以详细看看。但是,某个算法想利用该benchmark来评测结果时,需要注意数据泄露的风险,尽量避免用该benchmark里的数据进行训练。

Jamence的博客 2990

大白映射 宝马Esys编程设码映射、USB设备映射

大白映射,宝马Esys设码编程、USB设备映射

denson0394的博客 4800

OmniDocBench:全面文档解析评估基准

OmniDocBench 是一个用于评估现实场景中多样化文档解析性能的基准测试工具。它包含了丰富的文档类型、布局和语言,旨在为文档解析领域的研究提供全面的评估标准和数据集。OmniDocBench 的核心功能在于其多样性和广泛的适用性,使得它成为文档解析领域的一个重要参考。 ## 项目技术分析 OmniDocBench 的技术架构体现了现代数据处理和机器学习的先进性。它包含了以下关键特点:

gitblog_00511的博客 1613

从零理解Brep:用Python玩转3D建模的边界表示法(附OpenCASCADE示例)

本文深入解析了边界表示法(Brep)在3D建模中的应用,通过Python和OpenCASCADE的实战示例,详细介绍了Brep的核心数据结构、布尔运算、网格转换及3D打印优化技巧。适合CAD设计、3D打印和计算机图形学领域的开发者学习与实践。

n4o5p6q7r的博客 427

告别Keil手动分区!用CubeMX+VS Code一键生成带Bootloader的STM32 OTA工程

本文详细介绍了如何利用STM32CubeMX和VS Code实现STM32 OTA工程的自动化构建,告别传统Keil手动分区的繁琐流程。通过图形化配置Flash分区、自动生成链接脚本以及实现Bootloader跳转逻辑,开发者可以高效完成远程升级功能开发,显著提升嵌入式开发效率。

weixin_33720956的博客 389

CVPR 2025|OmniDocBench:PDF解析能力维度的指南针,让文档解析评测更全面、更精细

从多个来源搜集了近20万个PDF,在这批数据中做了采样和聚类,筛选了6000张PDF页面,对这批数据做了页面级别的类别标签标注(包括PDF类型、布局、语种、页面特殊情况等),然后在这个标注基础上做了一个均衡采样,并且人工检查去除了敏感数据,最终筛选出了981张多样化的PDF页面,覆盖了9类文档来源的高质量标注数据,包括学术论文、教材等基础类型,以及手写笔记、密排报纸等高挑战性样本。相关的技术和工具正在蓬勃发展,引起了较多的关注,但是现有的文档解析方法在多样性和评测全面性上还存在较多局限性。

OpenDataLab的博客 2399

运放+三极管恒流源电路设计实战:从原理到仿真一步到位(附Multisim文件)

本文详细解析了运放与三极管构建恒流源电路的核心原理,重点阐述了负反馈机制如何实现精准的电流控制。通过Multisim仿真实战,从电路搭建、参数计算到负载调整率与动态响应分析,一步步指导设计过程,并提供常见故障的调试技巧与PCB设计要点,帮助工程师从理论平稳过渡到可靠实践。

7z8x2c4v6b9的博客 711

OmniDocBench:5分钟掌握全能文档解析评估工具

在数字化时代,文档解析技术已成为企业和研究机构处理海量信息的关键工具。OmniDocBench作为一款全面的文档解析评估基准,正以其强大的功能和易用性赢得广泛认可。本文将带您快速了解这一工具的核心价值和使用方法。 ## 什么是OmniDocBench? OmniDocBench是一个专门用于评估现实场景中多样化文档解析性能的基准测试工具。它包含了丰富的文档类型、布局和语言,旨在为文档解析领域的

gitblog_01002的博客 743

《FreeRTOS 入门与实战》第20章:移植到 RISC-V 平台

处理器上下文保存/恢复机制中断处理与任务切换的协同时钟源配置(通常使用 Machine Timer)平台特定的汇编代码实现// 典型RISC-V移植文件结构FreeRTOS/├── Source/portable/[编译器]/RISC-V/│ ├── port.c // 关键移植接口│ ├── portASM.s // 汇编级处理│ └── portmacro.h // 架构宏定义。

2301_79143213的博客 449

OpenClaw实战-行政与HR必备:AI驱动的办公自动化

智能会议纪要自动生成会议时间智能协调自动提醒和跟进简历智能筛选和匹配度分析面试安排自动化入职办理流程化通知公告一键发布发票识别和报销辅助资产管理数字化让AI处理繁杂的事务性工作,让您有更多时间专注于更有价值的战略和管理任务。

gaoxiang_120的专栏 219

MinerU、Docling、Unstructured 三强对峙:OmniDocBench 之后,你的 RAG 底座选谁?

RAG 系统的质量天花板,往往在进入向量库之前就被决定了。文档解析层输出的不是"文本",而是你知识库的骨架——标题层级是否可信、表格是否错行、公式是否保留、页码与来源是否可追溯,这些细节决定了检索命中率的上限。当 OmniDocBench 这类基准(覆盖 1600+ 真实页面、跨论文/财报/教材等多类文档的细粒度标注)把三家开源方案摆上同一张评测台时,社区最常问的问题却是:"分数之外,到底该怎么选

gitblog_01087的博客 11

微信小程序云开发 - 实现商家转账到零钱(微信企业付款到零钱) V3功能流程及完整实例代码,过微信云开发的云函数实现企业付款到零钱(提供详细示例源码纯云函数实现,证书、密钥、签名等各种常见问题解决方案

企业付款到零钱(微信小程序提现功能,提现到零钱)微信小程序-云函数实现微信企业付款到零钱功能,实现微信商户号中的企业付款到零钱的功能,微信小程序+云开发+商家转账至零钱+微信小程序用户提现,使用云开发环境的云函数实现微信小程序的支付功能,微信小程序实现微信企业付款到零钱功能的流程,V3 V2基于微信云开发的商家转账至零钱,小程序云函数企业付款到零钱功能实现,云开发实现微信商户支付企业付款到零钱功能,不用服务器纯云函数实现,详细示例代码demo教程,API证书错误,转账不到账怎么办,密钥生成有误,转账失败,有

🏆 前端领域优质创作者 1万+

别再把 PDF 直接塞给 Agent 了:我把 MinerU、Docling、Marker、Unstructured、PaddleOCR、LlamaParse拉到了一张表上

近期技术圈热议的三大基础概念Agent、MCP和Context Engineering,正推动文档解析技术进入新阶段。微软、OpenAI和AWS相继发布的相关产品表明:随着Agent进入生产环境,上下文质量已成为核心瓶颈,而复杂文档(如双栏论文、扫描合同、带表格财报等)的解析是最大挑战。 本文系统分析了9类主流解决方案(MinerU、Docling、Marker等),指出选型关键不是简单比较OCR准确率,而需关注: 工具定位差异(基础设施层/转换器/云服务等) 结构化输出能力(表格/公式/阅读顺序保留) 生

m0_61134850的博客 1911

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

当 MCP 与科研 Agent 开始争夺上下文质量:MinerU 为什么应该被看作“证据级上下文生产层”

当前技术热点显示文档解析正从简单OCR转向"证据级上下文生产"。MinerU作为高精度文档解析引擎,其核心价值在于将PDF/Office/图片/网页等原始文档转化为Markdown/JSON等结构化数据,服务于LLM、RAG和Agent工作流。最新评测标准如ParseBench、Dr. DocBench等强调语义正确性、跨页连续性和真实工作流可用性,MinerU通过精准OCR、公式识别、表格提取等6大能力维度,成为连接原始文档与下游系统的关键生产层。其3.3/3.4版本优化了多语言OCR和解析性能

m0_61134850的博客 349

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

OmniDocBench:全面文档解析评估基准的技术深度解析

在当今数字化时代,文档解析技术面临着前所未有的挑战。从学术论文到财务报表,从技术手册到报纸文章,文档类型的多样性使得传统解析方法难以应对。OmniDocBench作为全面的文档解析评估基准,为开发者和研究人员提供了评估模型性能的标准化平台,帮助解决9大文档类型的解析难题。 ## 技术挑战与解决方案对比 文档解析的核心挑战在于处理复杂的布局结构、多语言内容以及混合元素类型。传统方法往往针对单一文

gitblog_00145的博客 224

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

文档解析性能评估工具:OmniDocBench全方位使用指南

你是否曾经遇到过这样的困扰:面对一份复杂的PDF文档,想要提取其中的表格、公式或文本内容,却发现现有的工具效果不佳?今天我要向你介绍一个能够彻底解决这个问题的开源项目——OmniDocBench,这是一个专门用于评估文档解析性能的终极基准工具。 ## 项目亮点速览:为什么它如此特别 OmniDocBench拥有三大核心亮点,让它从众多文档解析工具中脱颖而出: **海量数据支撑**:包含981

gitblog_00243的博客 811

OmniDocBench:终极文档解析评估基准,如何一站式解决9大文档类型解析难题?

OmniDocBench 是一个全面的文档解析评估基准(A Comprehensive Benchmark for Document Parsing and Evaluation),旨在为开发者和研究人员提供一站式解决方案,轻松应对各类复杂文档的解析挑战。无论你是处理学术论文、财务报告还是技术文档,OmniDocBench 都能帮助你快速评估和优化文档解析效果,让文档处理变得简单高效。 ## 为

gitblog_00265的博客 830

OmniDocBench:终极文档解析评估工具使用指南

在当今数字化时代,文档解析技术已经成为信息处理的关键环节。OmniDocBench作为一款全面的文档解析评估基准工具,为研究人员和开发者提供了强大的评估平台。无论您是文档处理领域的新手还是专业人士,这个工具都能帮助您快速了解文档解析的性能表现。 ## 一、什么是OmniDocBench? OmniDocBench是一个专门用于评估文档解析性能的基准测试工具。它包含了981页PDF文档,涵盖学术

gitblog_01133的博客 1003

小参数大能量:PaddleOCR-VL如何在OmniDocBench夺魁?

本文介绍了如何在星图GPU平台上自动化部署PaddleOCR-VL-WEB镜像,实现高效文档解析。基于该平台,用户可快速搭建支持多语言、高精度的OCR系统,典型应用于PDF转Markdown、表格还原为Excel等场景,显著提升文档数字化效率。

weixin_35756130的博客 270

全面解读OmniDocBench:1355页PDF打造的文档解析黄金标准

OmniDocBench是一个全面的文档解析与评估基准,它通过1355页PDF构建了文档解析领域的黄金标准。该项目为文档解析技术提供了丰富的测试数据和科学的评估方法,帮助开发者和研究人员更好地评估和改进文档解析模型的性能。 ## 为什么选择OmniDocBench? 在当今信息爆炸的时代,大量的信息以文档形式存在,文档解析技术变得越来越重要。然而,由于缺乏统一的评估标准和丰富的测试数据,文档解

gitblog_00297的博客 483

3分钟快速上手OmniDocBench:从环境配置到首次评估完整教程

OmniDocBench是一款功能强大的文档解析与评估综合基准工具,能帮助开发者快速评估文档解析模型的性能。本文将带你在3分钟内完成从环境配置到首次评估的全过程,让你轻松掌握这款高效工具的使用方法。 ## 📋 准备工作:一键安装OmniDocBench 首先,我们需要获取OmniDocBench项目。打开终端,输入以下命令克隆仓库: ```bash git clone https://gi

gitblog_00382的博客 590

MinerU2.5-Pro 中文 PDF 识别准确率全解:OmniDocBench v1.6 权威基准数据

OmniDocBench v1.6基准评测报告摘要 文档解析领域长期存在评测标准碎片化问题,OmniDocBench v1.6作为统一评测平台,通过整合四大核心评估指标(文本编辑距离、表格TEDS、公式CDM和阅读顺序编辑距离),为模型性能对比提供了标准化框架。最新评测结果显示,1.2B参数的专用文档解析模型MinerU2.5-Pro以95.69的综合得分位列第一,在保持相同架构下通过数据工程优化实现2.71分的显著提升。该模型在文本识别(字符准确率98.1%)、表格还原(TEDS 91.10)和公式识别(

lingxie2512的博客 856

终极指南:如何用OmniDocBench快速评估文档解析性能

OmniDocBench是CVPR 2025收录的文档解析综合评测基准,提供一站式解决方案帮助开发者客观评估OCR、公式识别、表格提取等文档解析任务的性能。本文将带你快速掌握这个强大工具的使用方法,从环境搭建到结果分析,让你轻松搞定文档解析性能评估。 ## 📋 什么是OmniDocBench OmniDocBench作为一个全面的文档解析评测基准,旨在解决不同文档解析工具间性能难以客观比较的

gitblog_00997的博客 912

GLM-OCR效果实测:OmniDocBench基准测试SOTA,识别精度接近Gemini-3-Pro

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR轻量级专业级多模态OCR模型,实现高效文档识别与处理。该模型在OmniDocBench基准测试中表现优异,特别适用于学术文献数字化、财务报表解析等专业场景,显著提升文档处理效率与准确性。

weixin_32251525的博客 143

96.33% 新SOTA!PaddleOCR-VL-1.6 发布,大模型时代的数据基座再升级

这个流程的关键价值在于,它同时解决了“缺数据”和“数据不可靠”两个问题:既扩展了模型在边界分布上的覆盖,也提升了监督信号的可信度,更确定了数据的难度,从而为后续 继续预训练、监督微调 和 强化学习 提供更稳定的数据基础。由此,PaddleOCR-VL-1.6 的数据建设从传统的规模驱动,转向了更高效的模型弱点驱动。如果样本过难,模型无法产生有效正向轨迹;展望未来,我们将持续推动技术创新,不断拓展模型的能力边界与应用版图,以更强大、更开放的文档解析方案,助力各行各业加速智能化转型,携手迈向文档智能的新阶段。

百度大脑 1209
上一篇: RAG系列(十):切分优化 - 基于句子相似距离的语义切分
下一篇: RAG系列(十一):复杂文档解析不理想?使用 TextIn xParse 轻松解析多样性 PDF 文档
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值