SSD系列1——网络结构

ssd 详解 1.1.1 网络结构 ssd的基础网络和vgg16是一样的不过全连接层换成了conv6+relu+conv7+relu.其后的层称为extra layer以得到更多不同尺寸的feature map. 并且对网络中conv4_3, conv7,conv8_2,conv9_2,conv10_2,conv11_2这六个layer的feature map再做卷积,得到类别和位置信息. 具体操作为:分别用2组3 x 3的卷积核去做卷积,一个负责预测类别,一个负责预测位置.卷积核的个数分别为boxnum x cl 阅读详情

SSD系列:
SSD系列1——网络结构
SSD系列2——PriorBox
SSD系列3——损失计算

SSD网络结构概述

  SSD在VGGNet的基础上,增加了4个卷积模块,这些卷积模块获得的特征图具有不同的感受野,可以较好地检测不同尺度的目标。
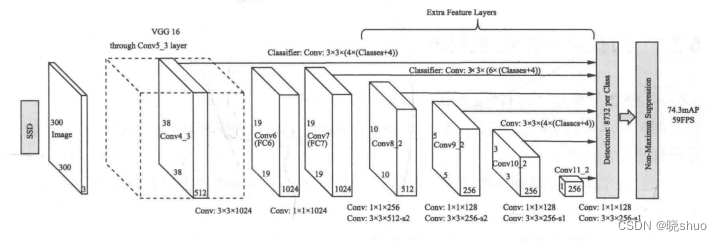
在这里插入图片描述

VGG16

  SSD网络使用VGG16作为基础网络,输入图像的尺寸为 300 × 300 × 3 300×300×3 300×300×3,首先经过VGG16网络的前13个卷积层,然后使用一个 3 × 3 3×3 3×3的卷积和一个 1 × 1 1×1 1×1的卷积代替原来的全连接网络。

在这里插入图片描述

  • 原始VGG16的池化层统一大小为 2 × 2 2×2 2×2,步长为2,而在SSD中,Conv5后接的MaxPooling层池化大小为3,步长为1。这样做可以在增加感受野的同时,维持特征图的尺寸不变。
  • Conv6中使用了空洞数为6的空洞卷积,其padding也为6。这样做也可以在增加感受野的同时,维持特征图的尺寸不变。

深层卷积层

  SSD在VGG16的基础上增加了4个卷积层,用以获取更高维度的语义信息。为了降低通道数,这4个卷积层都是先使用 1 × 1 1×1 1×1卷积降低通道数,然后再使用 3 × 3 3×3 3×3的卷积进行特征提取。


在这里插入图片描述

第四章:SSD网络详解 摘要:本文提出了一种使用单个深度神经网络在图像中检测物体的方法。我们的方法名为SSD,它将边界框的输出空间离散化为每个特征图位置上不同长宽比和尺度的一组默认框。在预测时,网络为每个默认框中每个物体类别的存在生成得分,并对框进行调整以更好地匹配物体形状。此外,网络结合了具有不同分辨率的多个特征图的预测,以自然地处理不同大小的物体。相对于需要物体提议的方法,SSD非常简单,因为它完全消除了提议生成和后续像素或特征重采样阶段,并将所有计算封装在一个网络中。 阅读详情

相关推荐

ssd网络结构_环境感知技术入门(十二) 详细解读SSD目标检测框架

SSD 的网络结构如图1所示, 包含基础四部分;图1 SSD网络结构图2 骨干网络与原始VGG16对比图从图2最中我们可以清晰的看到在以VGG16做骨干网络时,在 conv5后丢弃了VGG16中的全连接层改为了1024×3×3和1024×1×1的卷积层。其中 conv4-1卷积层前面的 maxpooling层的 ceil_model=True,使得输出特征图长宽为 38 × 38。

2401_89191834的博客 643

论文阅读:SSD

一、对网络的理解 1、SSD网络结构 这个网络主要是利用了不同层的feature map,不同层的feature map尺寸大小不一样,可以用于产生不同尺寸的先验框,再加上同一种尺寸下不同长宽比的先验框,6个feature map的情况下用可以产生8732个先验框,覆盖范围非常广。 其中,先验框的产生是利用小的卷积核去卷积feature map,所以产生先验框的同时可以预测框的坐标 大小 以及对...

j879159541的博客 836

目标检测系列4—yolo1、yolo2、yolo3和SSD的网络结构对比

yolo1、2、3和SSD网络结构对比1、yolo11.1、yolo1网络结构1.2、yolo1网络代码1.3、预测结果2、yolo22.1、yolo2网络结构2.2、yolo2解码部分代码2.3、yolo2网格部分代码2.4、预测结果3、yolo33.1、yolo3网络结构3.2、yolo3网络代码3.3、yolo3预测结果4、SSD4.1、SSD网络结构4.2、SSD网络部分代码4.3、预测结果5、总结 1、yolo1 1.1、yolo1网络结构 由图可见,其进行了二十多次卷积还有四次最大池化,其中3

Xiaobai_rabbit0的博客 1183

SSD网络介绍

目标检测(object detection)的目的就是找出图像中所有感兴趣的目标,确定他们的类别和位置。由于各类物体有不同的外观、形状和姿态,加上成像时光照、遮挡等许多因素的干扰,目标检测一直是计算机视觉领域最具有挑战性的问题。在Base Layer的基础上,作者将VGG16中的FC6,FC7改成了卷积层Conv6,Conv7,并且同时添加了Conv8,Conv9,Conv10,Conv11这几个特征层用于目标检测。:在多个尺度上进行目标检测以提高精度。:reshape后 大小为。

我の博客 1840

损失函数及特征提取网络

Faster Rcnn损失函数:https://blog.youkuaiyun.com/Mr_health/article/details/84970776 SSD损失函数:https://www.cnblogs.com/hellcat/p/9351802.html YOLOv3损失函数:这个和这个

HJjtxy的博客 1444

cv君独家视角 | AI内幕系列二十五:精选目标检测3——yolo1、yolo2、yolo3和SSD的网络结构汇总对比

学习前言 各个网络的结构图与其实现代码 1、yolo1 2、yolo2 3、yolo3 4、SSD 总结 学习前言 ……最近在学习yolo1、yolo2和yolo3,事实上它们和SSD网络有一定的相似性,我准备汇总一下,看看有什么差别。 各个网络的结构图与其实现代码 1、yolo1 在这里插入图片描述 由图可见,其进行了二十多次卷积还有四次最大池化,其中3x3卷积用于提取特征,1x1卷积用于压缩特征,最后将图像压缩到7x7xfilter的大小,相当于将整个图像划分为7x7

cv君的博客 3万+

目标检测基础、Yolo系列、SSD

目标检测、YOLO系列的介绍和训练

m0_46902739的博客 7086

多智能体强化学习MASAC算法:从原理到PyTorch实战详解

深度强化学习通过智能体与环境的交互试错来学习最优策略,是解决复杂序列决策问题的核心技术。其核心原理在于利用价值函数或策略梯度来最大化累积奖励,在机器人控制、游戏AI等领域展现出巨大技术价值。当面对多个智能体需要协同或竞争的复杂动态环境时,单智能体算法因环境非平稳性而面临挑战,多智能体强化学习应运而生。Multi-Agent Soft Actor-Critic (MASAC) 算法融合了SAC的稳定高效与中心化训练去中心化执行的范式,通过维护中心化Critic网络和独立策略网络,有效解决了多智能体协作中的信用

weixin_30080745的博客 331

论文笔记3 MobileNetV3-SSD

1 2 实践总结 2.1 运行代码 参考: [1] MobileNetV3-SSD github(已跑通) [2] 另一个 MobileNetV3-SSD github(未跑通) 2.2 svhn数据集转voc 参考: [1] svhn数据集中:matlab文件转txt格式 [2] 目标检测txt格式转voc 注意: 要查看好标注的坐标信息格式(voc数据集格式中是左上角和右下角,而sv...

RedBlack的博客 6335

深入CRSF协议数据包:手撕STM32代码,教你像调试串口一样分析ELRS遥控数据流

本文深入解析CRSF协议数据包,通过手撕STM32代码,教你如何像调试串口一样分析ELRS遥控数据流。从硬件准备到数据包捕获状态机设计,再到高级数据分析技巧和实战应用,全面覆盖CRSF协议的解析与优化,帮助开发者构建稳定可靠的通信系统。

weixin_29194693的博客 337

POWER(十一)charge pump原理

电荷泵是一种基于电容充放电原理的DC-DC转换电路,通过开关控制实现电压转换,包括升压、降压和负压输出。其核心是利用电荷守恒原理,通过电容存储和转移电荷来改变输出电压。典型拓扑结构包括倍压电路和多阶升压电路,具有结构简单、体积小等优势。关键参数包括转换效率、输出电流能力和开关频率,适用于芯片供电、显示屏驱动等低功耗场景。LVDS部分补充说明了自举电路在驱动电路中的应用及其自同步特性。

zhlwsh的博客 2816

深度学习与计算机视觉教程(13) | 目标检测 (SSD,YOLO系列)(CV通关指南·完结)

相比于 YOLO V1,YOLO V2在精度、速度和分类数量上都有了很大的改进。YOLO V2使用DarkNet19作为特征提取网络,该网络比 YOLO V2 所使用的 VGG-16 要更快。YOLO V2使用目标分类和检测的联合训练技巧,结合Word Tree等方法,使得 YOLO V2的检测种类扩充到了上千种,分类效果更好。下图展示了 YOLO V2 相比于 YOLO V1 在提高检测精度上的改进策略。尽管一阶段检测算推理速度快,但精度上与二阶段检测算法相比还是不足。RetinaNet。

weixin_42907150的博客 1228

海康线扫相机平场矫正教程

1、白纸准备确保视野中有一张平整且无折痕的白纸,使其完全铺满相机的整个视野。2、行高设置将行高参数设定为 2048。3、灰度值控制相机端图像的灰度值应维持在 120 - 160 这个区间内。同时,最亮像素点与最暗像素点的灰度值差值不得超过 4 倍。在调整灰度值时,尽量开启增益功能。4、 图像模糊处理为减少白纸对平场矫正的影响,需将相机端获取的图像进行模糊化处理。具体操作是对镜头进行虚焦,使整体图像变得模糊。

T 2752

onestage方法_One-stage目标检测算法综述

yolo-v1:YOLO 就是使用回归这种做法的典型算法。首先将图片 Resize 到固定尺寸,然后通过一套卷积神经网络,最后接上 FC 直接输出结果,这就他们整个网络的基本结构。更具体地做法,是将输入图片划分成一个 SxS 的网格,每个网格负责检测网格里面的物体是啥,并输出 Bbox Info 和 置信度。这里的置信度指的是 该网格内含有什么物体 和 预测这个物体的准确度。更具体的是如下定义:我...

weixin_36410141的博客 861

3D 结构光相机工作原理全解 | 从编码投射到三维重建,原理 + 代码 + 工业实战一站式掌握

本文从3D结构光相机的整体架构出发,层层拆解了编码投射、相位计算、相位解包裹、三维重建的核心原理,补充了工业实战所需的公式推导、代码实现、参数调优、设备选型和案例落地,核心总结如下:相位是3D结构光成像的“灵魂”,其精度、稳定性直接决定3D重建的效果,包裹相位与绝对相位的区分的是工业实战的基础;编码投射的核心是“正弦条纹+格雷码条纹”组合,正弦条纹负责高精度相位提取,格雷码条纹辅助解包裹,适配工业场景的精度与稳定性需求;

getusushu的博客 414

【OpenClaw从入门到精通】第01篇:保姆级教程——从零开始搭建你的第一个本地AI助理(2026实测版)

本文聚焦2026年开源AI代理工具OpenClaw的本地部署与实操,从核心概念拆解入手,先厘清OpenClaw、Gateway、Skills、ClawHub的关联,再明确硬件系统要求与大模型API-Key准备要点,通过官方一键安装脚本完成本地部署,并配置阿里云百炼API实现大模型对接。以“让AI助理抓取开源中国热门项目”的虚拟实战案例,详细演示Skills调用流程,同时梳理部署中“命令找不到”“API-Key配置失败”等高频问题的解决方法。内容兼顾新手友好性与实操参考性,所有步骤均基于公开技术文档验证。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 4万+

目标检测的进阶-one stage

文章目录前言Stage它们的主要区别one-stageSSD网络结构图特点损失函数YOLOv1网络结构图特点损失函数优缺点YOLOv2网络结构特点损失函数优缺点YOLOv3网络结构Darknet-53特点two-stageAnchoranchor-free 和 anchor-based 优缺点anchor boxanchor freeInference 前言 上一章介绍了目标检测的入门,这一章就目标检测近些年的发展做一个介绍。 关于目标检测具体怎么分,谁和谁一家其实有两种分类:基于anchor和stage。

进击的扛把子 3364

【模型】OpenClaw 接入阿里云永久免费模型方案

Qwen2.5-7B-Instruct 模型为例。

海兰 4472

【深度学习】One-Stage目标检测算法

不用RP,直接在网络中提取特征来预测物体分类和位置。 任务:特征提取—>分类/定位回归。 常见的one stage目标检测算法有:OverFeat、YOLOv1、YOLOv2、YOLOv3、SSD和RetinaNet等。 一、SSD(Single Shot MultiBox Detector) 1.网络结构 SSD的优点就是它生成的 default box 是多尺度的,这是因为SSD生成default box 的 feature map 不仅仅是CNN输出的最后一层,还有利用比较浅层的featu.

MangoloD的博客 8291

UNet 改进(22):结合Transformer结构

保留了UNet的经典编码器-解码器结构在瓶颈层使用Transformer替代传统的卷积层采用跳跃连接保持空间细节信息使用双卷积块(DoubleConv)作为基础构建模块。

2401_82355416的博客 774

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

目标检测--SSD

SSD应该是和YOLO v2同一时期的论文,相比YOLO v1和RCNN系列,SSD借鉴了两者的优点,并加入了多尺度来弥补yolo在小物体检测的不足,在精度和速度上都超越了yolo v1。主要改进在于两点: (1)多尺度feature map增加鲁棒性,既能检测大物体,又能检测小物体,增加精度; (2)yolo使用全连接来预测,但是SSD采用卷积,保证速度。。 网络结构 1、base networ...

qq_41332469的博客 326

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【目标检测】【2】One-stage目标检测算法的论文阅读笔记与资料整理

把之前本地的一些论文阅读笔记和资料汇总搬上来 之前写过的相关博客: 【目标检测】【1】《SSD- Single Shot MultiBox Detector》SSD目标检测器详解 【yolov3】【2】yolov3-spp结构详解与源码解析(pytorch) 文章目录目标检测YOLO系列与SSD对比SSD《SSD: Single Shot MultiBox Detector》YOLO【YOLOv1...

yjyjjyjy1231的博客 1129

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

深度图像识别系列笔记-7.One-stage基本流程

1. 基本介绍 使用CNN卷积特征 直接回归物体的类别概率和位置坐标值 准确度低、速度相对two-stage快 2. One-Stage基本流程 #mermaid-svg-QHXgrgHpKPfTiK5a .label{font-family:'trebuchet ms', verdana, arial;font-family:var(--mermaid-font-family);fill:#333;color:#333}#mermaid-svg-QHXgrgHpKPfTiK5a .label text

u012858839的博客 692

行为分析(六):人形检测部分(一):YOLOv1-v5的学习笔记

YOLO与RCNN系列的不同 1.统一网络:YOLO没有显示求取region proposal的过程。Faster R-CNN中尽管RPN与fast rcnn共享卷积层,但是在模型训练过程中,需要反复训练RPN网络和fast rcnn网络.相对于R-CNN系列的"看两眼"(候选框提取与分类),YOLO只需要Look Once. 2. YOLO统一为一个回归问题,而R-CNN将检测结果分为两部分求解:物体类别(分类问题),物体位置即bounding box(回归问题)。 一句话概括YOLO的原理 将输入

qq_37662375的博客 6522

目标检测网络

文章目录一、目标检测网络简介二、one-stage1、yolo1.1 yolov11.2 yolov21.3 yolov31.4 yolov41.5 yolov52、SSD3、RetainNet二、two-stage1、R-CNN2、Fast R-CNN3、Faster R-CNN4、SPP-net总结 一、目标检测网络简介 大致分为两类one-stage和two-stage,主要区别是检测目标类别与bounding box回归任务是否分开进行。 two-stage代表是rcnn系列(rcnn、fast-

2d3d图像算法 halcon\opencv\c++\pcl\vtk\coluldcompare工具 程序员 学习者 5155

12 - YOLO算法三 (目标检测)

2)每个网格要预测B个bounding box,每个bounding box 除了要预测位置之外,还要附带预测一个confidence值。每个网格还要预测C个类别的分数。注意:这里的SPP和SPPnet中的SPP结构不一样,Spatial Pyramid Pooling。1) 将一幅图像分成SxS个网格(grid cell),如果。实现了不同尺度的特征融合实现了不同尺度的特征融合,中,则这个网格就负责预测这个object。5.2.1 普通CSP结构。

March_A的博客 899
上一篇: Faster RCNN系列5——RoI Pooling与全连接层
下一篇: SSD系列2——PriorBox
晓shuo
晓shuo 优质创作者: 人工智能技术领域 优质创作者: 人工智能技术领域
博客等级 码龄6年 4万+粉丝 113原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

晓shuo

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值