


不涉及transformer原理,只看transform结构的具体运行过程,涉及到推理。关于原理细节可参考这篇或者查阅其他相关优秀文章。
一、Transformer 基本结构
Transformer由encoder和decoder组成,其中:
-
encoder主要负责理解(understanding) The encoder’s role is to generate a rich representation (embedding) of the input sequence, which the decoder can use if needed
-
decoder主要负责生成(generation) The decoder outputs tokens one by one, where the current output depends on the previous tokens. This process is called auto-regressive generation
基本结构如下:
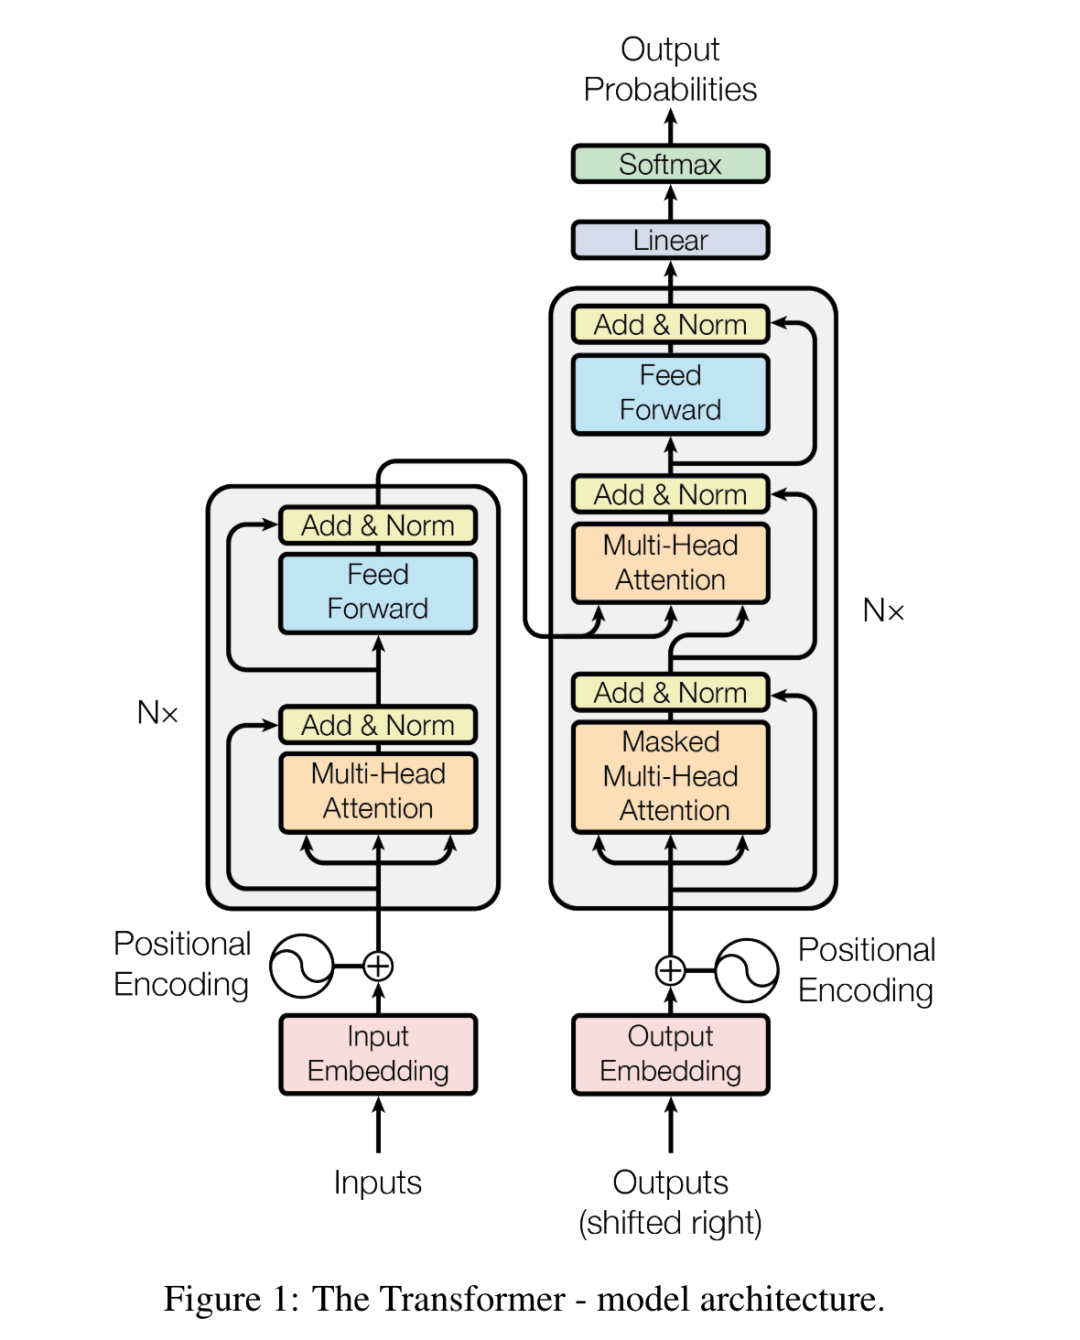
encoder结构和decoder结构基本一致(除了mask),所以主要看decoder即可:
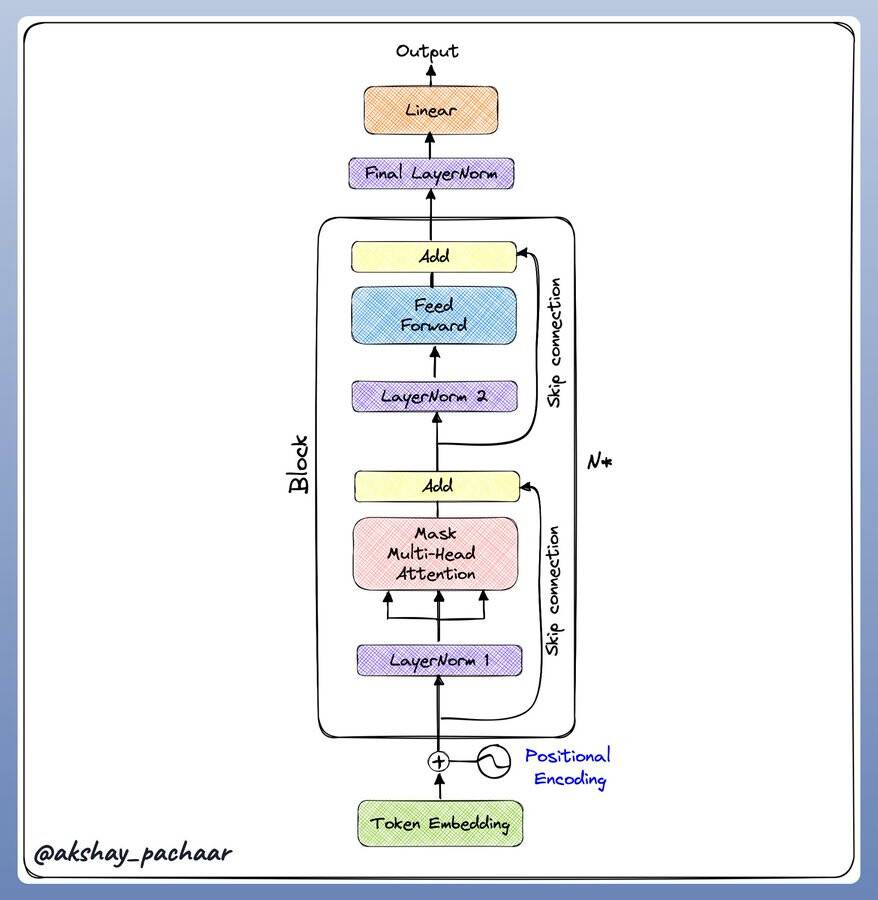
每个核心的Block包含:
- Layer Norm
- Multi headed attention
- A skip connection
- Second layer Norm
- Feed Forward network
- Another skip connection
看下llama decoder部分代码,摘自transformers/models/llama/modeling_llama.py,整个forward过程和上图过程一模一样, 只是layer_norm换成了LlamaRMSNorm:
# 省略了一些不重要的code
class LlamaDecoderLayer(nn.Module):
    def __init__(self, config: LlamaConfig, layer_idx: int):
     ...
    def forward(
        self,
        hidden_states: torch.Tensor,
        attention_mask: Optional[torch.Tensor] = None,
        position_ids: Optional[torch.LongTensor] = None,
        past_key_value: Optional[Tuple[torch.Tensor]] = None,
        output_attentions: Optional[bool] = False,
        use_cache: Optional[bool] = False,
        cache_position: Optional[torch.LongTensor] = None,
        **kwargs,
    ) -> Tuple[torch.FloatTensor, Optional[Tuple[torch.FloatTensor, torch.FloatTensor]]]:

        # hidden_states [bsz, q_len, hidden_size]
        residual = hidden_states
        hidden_states = self.input_layernorm(hidden_states)

        # Self Attention 即MHA
        hidden_states, self_attn_weights, present_key_value = self.self_attn(
            hidden_states=hidden_states,
            attention_mask=attention_mask,
            position_ids=position_ids,
            past_key_value=past_key_value,
            output_attentions=output_attentions,
            use_cache=use_cache,
            cache_position=cache_position,
            **kwargs,
        )
        hidden_states = residual + hidden_states

        # Fully Connecte
        residual = hidden_states
        hidden_states = self.post_attention_layernorm(hidden_states)
        hidden_states = self.mlp(hidden_states)
        hidden_states = residual + hidden_states

        outputs = (hidden_states,)

        return outputs
上述代码展示的是标准的decoder过程,几个关键输入:
-
hidden_states [batch_size, seq_len, embed_dim] seq_len表示输入长度
-
attention mask的size为
(batch_size, 1, query_sequence_length, key_sequence_length)注意力掩码,实际使用的时候,PyTorch 会自动广播这个掩码到注意力权重矩阵的形状 [bsz, num_heads, q_len, kv_seq_len]。 -
position_ids or position_embeddings,位置id或者已经提前计算好的位置embedding
上述最核心的结构是其调用的self.self_attn,即是Multi-headed attention。
二、Multihead Attention
Multihead Attention,多头注意力,上述decoder过程中最核心的地方,同时也是算子优化发力的地方。要理解多头先从单头开始。
单个attention
即Scaled Dot-Product Attention,公式如下:
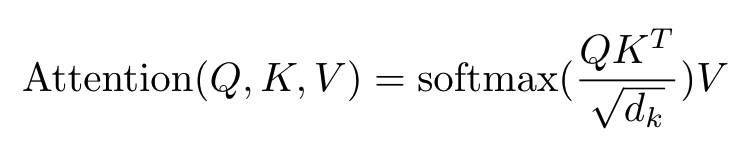
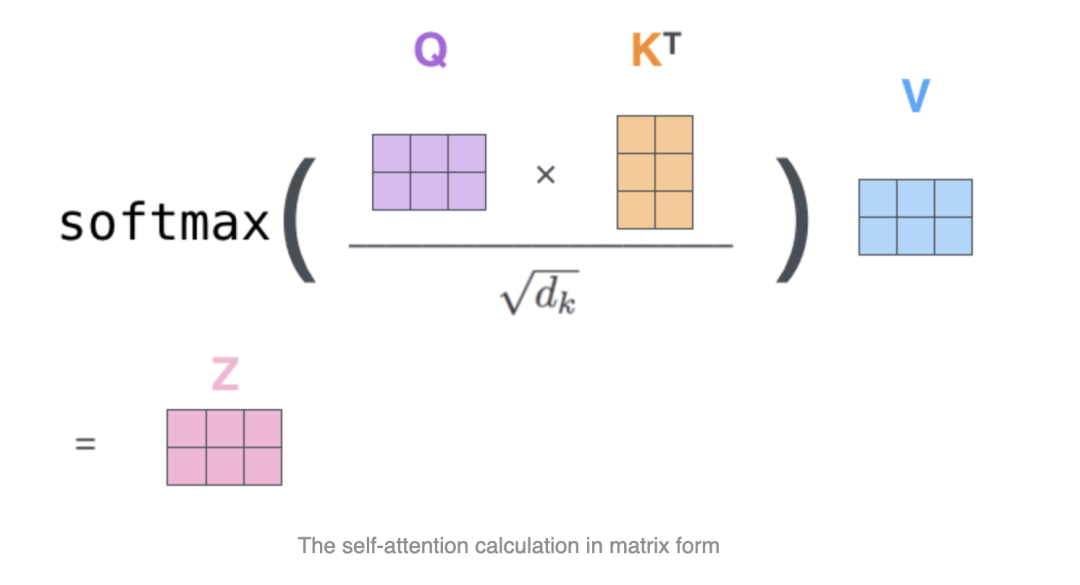
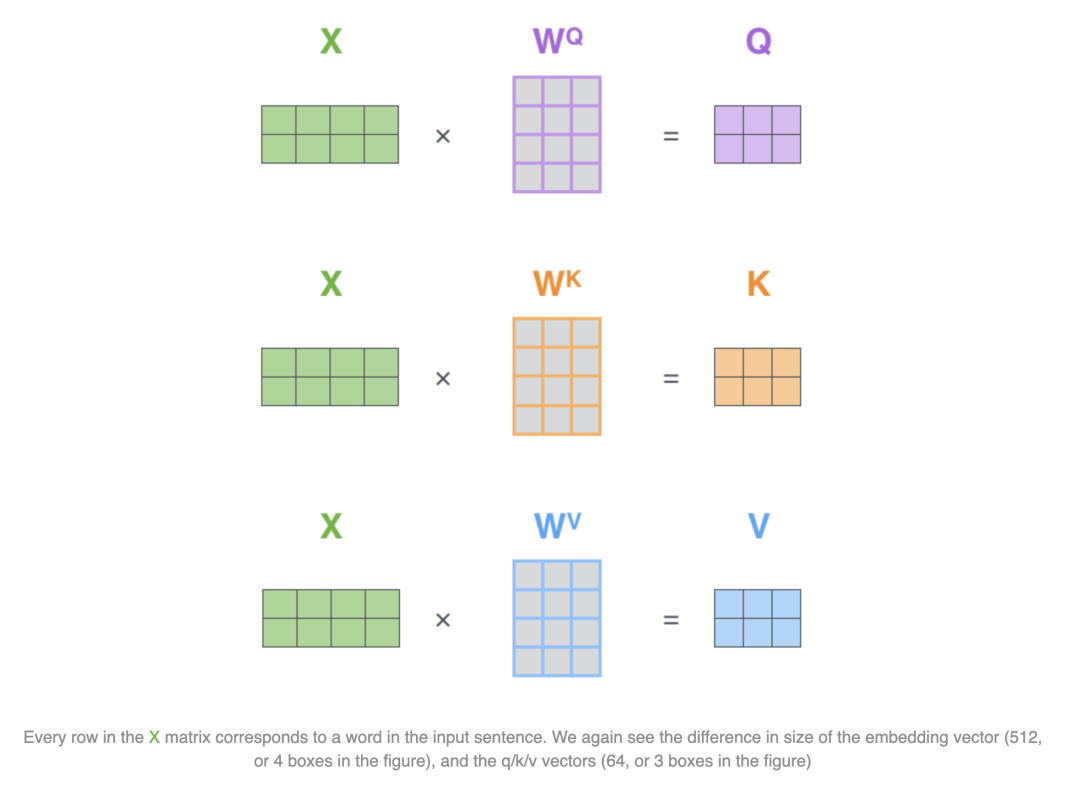
其中QKV的维度一致,比如这里都是(2,3):
那么QKV怎么得到的呢?通过输入embedding和WqWkWv相乘得到qkv,这里WqWkWv是可学习参数:
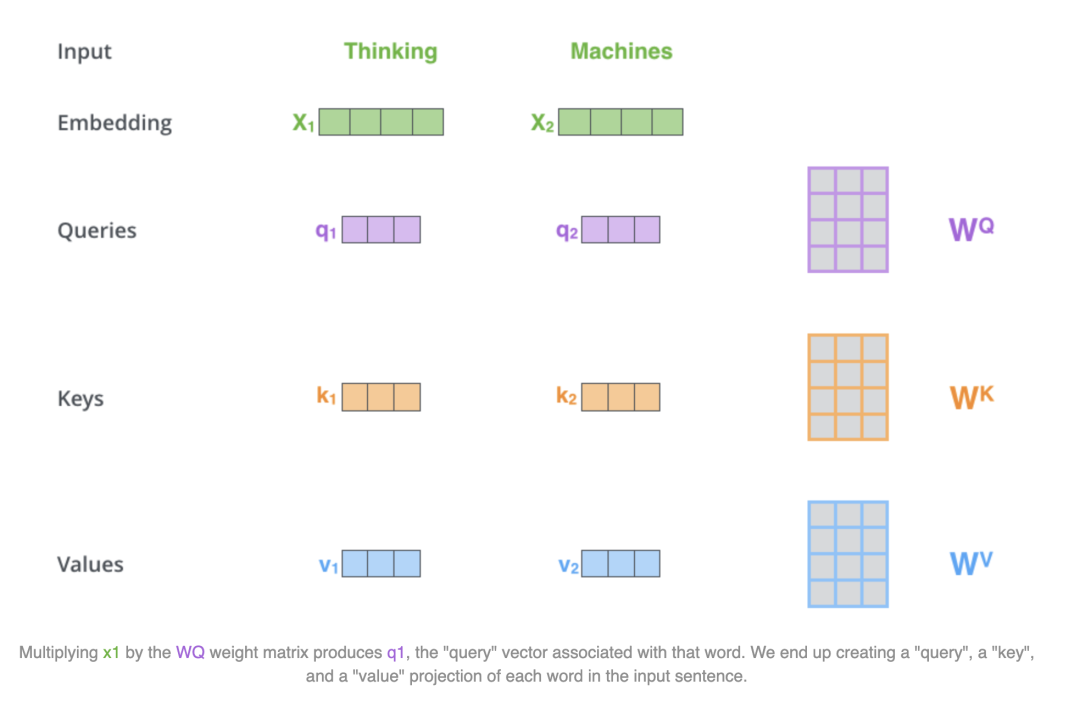
拆开合起来计算都是等价的,上述的X1和X2是拆开计算,但是组合起来为(2,4)维度,同样可以和WqWkWv进行矩阵乘
实际在decoder的计算中,会带入causal (or look-ahead) mask:
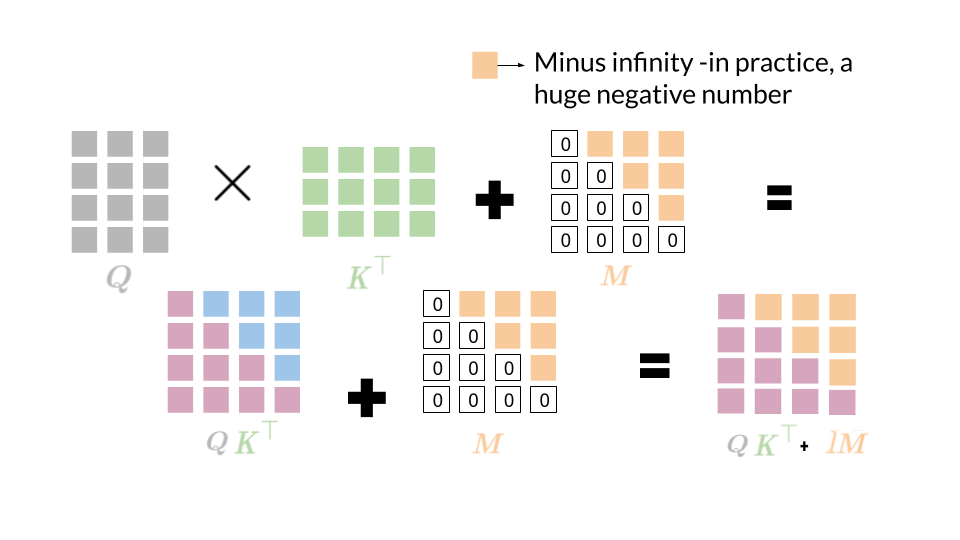
Causal mask 是为了确保模型在解码时不会关注未来的 token,这对于生成任务是必不可少的。通过这个掩码,模型只会依赖已经生成的 token,确保解码过程中是自回归的。
多个attention
实际中一般都是多个attention,和单个attention区别不大,下图右侧是多个attention的结构:
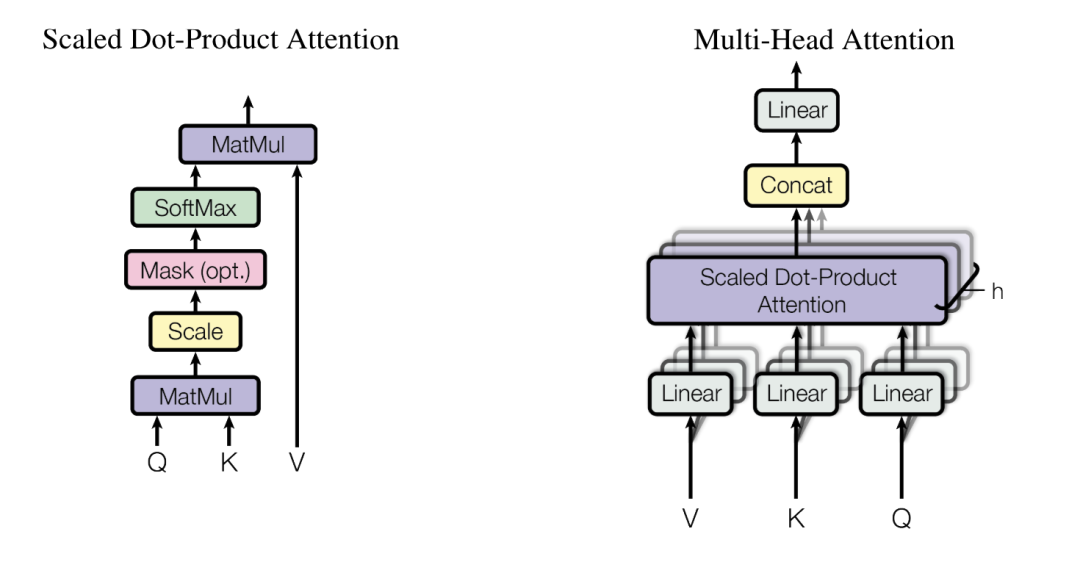
自注意力在多个头部之间并行应用,最后将结果连接在一起,我们输入(2,4)维度的X,分别和不同头的WqWkWv进行矩阵乘法得到每个头对应的QKV,然后QKV算出Z,再将所有Z合并和Wo相乘得到维度和X一致的Z:
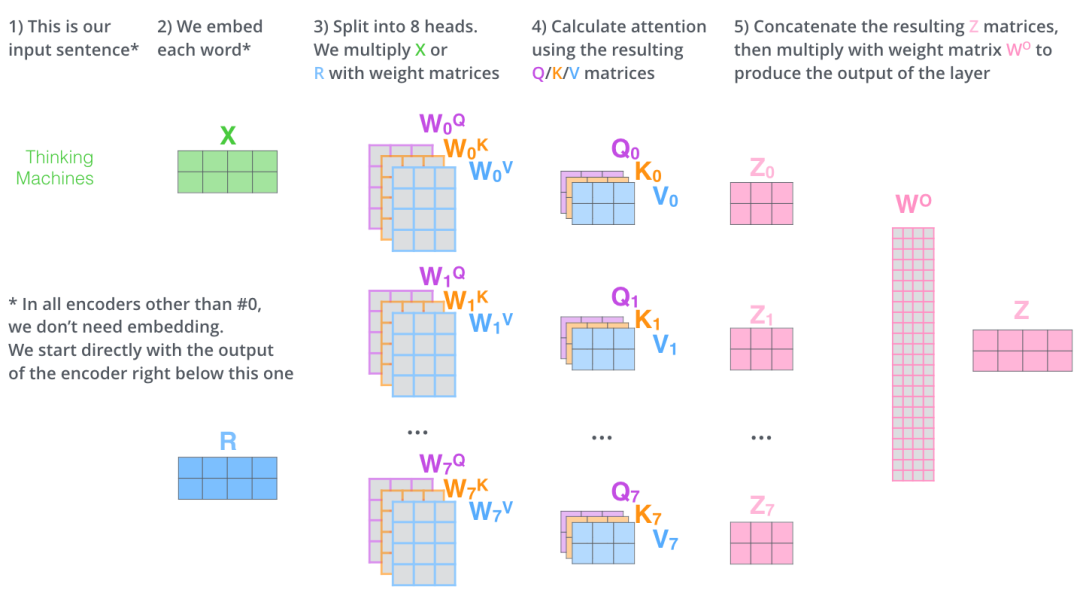
实际中需要学习的权重为每个头的WqWkWv,同时也需要一个Wo,看一下llama中的实际计算过程:
class LlamaAttention(nn.Module):
    """Multi-headed attention from 'Attention Is All You Need' paper"""

    def __init__(self, config: LlamaConfig, layer_idx: Optional[int] = None):
        super().__init__()
        self.config = config
        self.layer_idx = layer_idx
        self.attention_dropout = config.attention_dropout
        self.hidden_size = config.hidden_size
        self.num_heads = config.num_attention_heads
        self.head_dim = self.hidden_size // self.num_heads
        self.num_key_value_heads = config.num_key_value_heads
        self.num_key_value_groups = self.num_heads // self.num_key_value_heads
        self.max_position_embeddings = config.max_position_embeddings
        self.rope_theta = config.rope_theta
        self.is_causal = True

        # 这行代码是一个检查条件,确保hidden_size能够被num_heads整除。
        # 在多头注意力(Multi-Head Attention, MHA)机制中,输入的hidden_size被分割成多个头,每个头处理输入的一个子集。
        # head_dim是每个头处理的维度大小,它由hidden_size除以num_heads得到。
        if (self.head_dim * self.num_heads) != self.hidden_size:
            raise ValueError(
                f"hidden_size must be divisible by num_heads (got `hidden_size`: {self.hidden_size}"
                f" and `num_heads`: {self.num_heads})."
            )

        # 需要学习更新的四个权重 WqWkWvWo
        self.q_proj = nn.Linear(self.hidden_size, self.num_heads * self.head_dim, bias=config.attention_bias)
        self.k_proj = nn.Linear(self.hidden_size, self.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.v_proj = nn.Linear(self.hidden_size, self.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.o_proj = nn.Linear(self.num_heads * self.head_dim, self.hidden_size, bias=config.attention_bias)
        self._init_rope()

    def forward(
        self,
        hidden_states: torch.Tensor,
        attention_mask: Optional[torch.Tensor] = None,
        position_ids: Optional[torch.LongTensor] = None,
        past_key_value: Optional[Cache] = None,
        output_attentions: bool = False,
        use_cache: bool = False,
        **kwargs,
    ) -> Tuple[torch.Tensor, Optional[torch.Tensor], Optional[Tuple[torch.Tensor]]]:

        bsz, q_len, _ = hidden_states.size()

        query_states = self.q_proj(hidden_states)
        key_states = self.k_proj(hidden_states)
        value_states = self.v_proj(hidden_states)

        query_states = query_states.view(bsz, q_len, self.num_heads, self.head_dim).transpose(1, 2)
        key_states = key_states.view(bsz, q_len, self.num_key_value_heads, self.head_dim).transpose(1, 2)
        value_states = value_states.view(bsz, q_len, self.num_key_value_heads, self.head_dim).transpose(1, 2)

        kv_seq_len = key_states.shape[-2]
        if past_key_value is not None:
            if self.layer_idx is None:
                raise ValueError(
                    f"The cache structure has changed since version v4.36. If you are using {self.__class__.__name__} "
                    "for auto-regressive decoding with k/v caching, please make sure to initialize the attention class "
                    "with a layer index."
                )
            kv_seq_len += past_key_value.get_usable_length(kv_seq_len, self.layer_idx)
        cos, sin = self.rotary_emb(value_states, seq_len=kv_seq_len)
        query_states, key_states = apply_rotary_pos_emb(query_states, key_states, cos, sin, position_ids)

        if past_key_value is not None:
            cache_kwargs = {"sin": sin, "cos": cos}  # Specific to RoPE models
            key_states, value_states = past_key_value.update(key_states, value_states, self.layer_idx, cache_kwargs)

        key_states = repeat_kv(key_states, self.num_key_value_groups)
        value_states = repeat_kv(value_states, self.num_key_value_groups)

        attn_weights = torch.matmul(query_states, key_states.transpose(2, 3)) / math.sqrt(self.head_dim)

        if attention_mask is not None:
            if attention_mask.size() != (bsz, 1, q_len, kv_seq_len):
                raise ValueError(
                    f"Attention mask should be of size {(bsz, 1, q_len, kv_seq_len)}, but is {attention_mask.size()}"
                )
            attn_weights = attn_weights + attention_mask

        # upcast attention to fp32
        attn_weights = nn.functional.softmax(attn_weights, dim=-1, dtype=torch.float32).to(query_states.dtype)
        attn_weights = nn.functional.dropout(attn_weights, p=self.attention_dropout, training=self.training)
        # (bsz, self.num_heads, q_len, self.head_dim)
        attn_output = torch.matmul(attn_weights, value_states)
        # (bsz, q_len, self.num_heads, self.head_dim)
        attn_output = attn_output.transpose(1, 2).contiguous()
        attn_output = attn_output.reshape(bsz, q_len, self.hidden_size)

        attn_output = self.o_proj(attn_output)

        return attn_output, attn_weights, past_key_value
上述的计算过程可以总结为以下几个步骤,假设输入张量hidden_states的维度为[batch_size, seq_length, hidden_size]。


这个过程实现了将输入通过多个注意力"头"并行处理的能力,每个"头"关注输入的不同部分,最终的输出是所有"头"输出的拼接,再经过一个线性变换。这种机制增强了模型的表达能力,使其能够从多个子空间同时捕获信息。
因为不用GQA,q_len 就是 seq_length 就是 kv_seq_len
三、MHA计算
实际的多头计算代码如下,这里是通过torch.matmul实现的:
 attn_weights = torch.matmul(query_states, key_states.transpose(2, 3)) / math.sqrt(self.head_dim)
  if attention_mask is not None:  # no matter the length, we just slice it
      causal_mask = attention_mask[:, :, :, : key_states.shape[-2]]
      attn_weights = attn_weights + causal_mask
  position_ids: Optional[torch.LongTensor] = None,
  # upcast attention to fp32
  attn_weights = nn.functional.softmax(attn_weights, dim=-1, dtype=torch.float32).to(query_states.dtype)
  attn_weights = nn.functional.dropout(attn_weights, p=self.attention_dropout, training=self.training)
  attn_output = torch.matmul(attn_weights, value_states)
上述代码中query_states和key_states的形状分别为[bsz, num_heads, q_len, head_dim]和[bsz, num_heads, kv_seq_len, head_dim]。matmul操作会自动在最后两个维度上进行矩阵乘法,并在前两个维度上进行广播。
应用注意力掩码attn_weights = attn_weights + causal_mask,causal_mask的形状可能是[1, 1, q_len, kv_seq_len]。PyTorch会自动将其广播到attn_weights的形状[bsz, num_heads, q_len, kv_seq_len]。
应用softmax和dropout,然后最后计算attn_output = torch.matmul(attn_weights, value_states),其中attn_weights的形状为[bsz, num_heads, q_len, kv_seq_len],value_states的形状为[bsz, num_heads, kv_seq_len, head_dim]。matmul操作会在最后两个维度上进行矩阵乘法,并在前两个维度上进行广播。这里attn_output的维度为bsz, num_heads, q_len, self.head_dim。
四、torch.matmul
多维矩阵乘法,支持多维和broadcast,比较复杂:
- 如果两个输入张量都是一维张量,执行的是点积操作,返回一个标量
- 如果两个输入张量都是二维张量,执行的是矩阵乘法,返回一个新的二维矩阵,这个操作就是常见的
- 如果第一个张量是一维张量,第二个张量是二维张量,则会在第一张量的维度前面添加一个1(扩展为2维),然后进行矩阵乘法,计算完后会移除添加的维度
- 如果第一个张量是二维张量,第二个张量是一维张量,则执行的是矩阵-向量乘法,返回一个一维张量
- 当两个输入张量中有一个是多维的(N > 2),会执行批量矩阵乘法。在这种情况下,非矩阵的维度(批量维度)会被广播(broadcasted)。如果一个张量是一维,会对其进行维度扩展和移除
我们这里的多维数据 matmul() 乘法,可以认为该乘法使用使用两个参数的后两个维度来计算,其他的维度都可以认为是batch维度。
比如,输入张量的形状为 (j×1×n×n) 和 (k×n×n) 时,会输出形状为 (j×k×n×n) 的张量。
具体点,假设两个输入的维度分别是input (1000×500×99×11), other (500×11×99)那么我们可以认为torch.matmul(input, other, out=None) 乘法首先是进行后两位矩阵乘法得到(99×11)×(11×99)⇒(99×99) ,然后分析两个参数的batch size分别是 (1000×500)和 500, 可以广播成为 (1000×500), 因此最终输出的维度是(1000×500×99×99)。
计算QK点积的时候:
attn_weights = torch.matmul(query_states, key_states.transpose(2, 3)) / math.sqrt(self.head_dim)
query_states的形状为[bsz, num_heads, q_len, head_dim],key_states.transpose(2, 3)的形状为[bsz, num_heads, head_dim, kv_seq_len]。matmul操作会在最后两个维度上进行矩阵乘法,得到形状为[bsz, num_heads, q_len, kv_seq_len]的注意力权重。
计算注意力输出:
attn_output = torch.matmul(attn_weights, value_states)
这里使用torch.matmul将注意力权重与值(value)相乘。attn_weights的形状为[bsz, num_heads, q_len, kv_seq_len],value_states的形状为[bsz, num_heads, kv_seq_len, head_dim]。matmul操作会在最后两个维度上进行矩阵乘法,得到形状为[bsz, num_heads, q_len, head_dim]的注意力输出。
因为我们不用GQA,q_len 就是 kv_seq_len
最后分享
AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。
可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习_,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
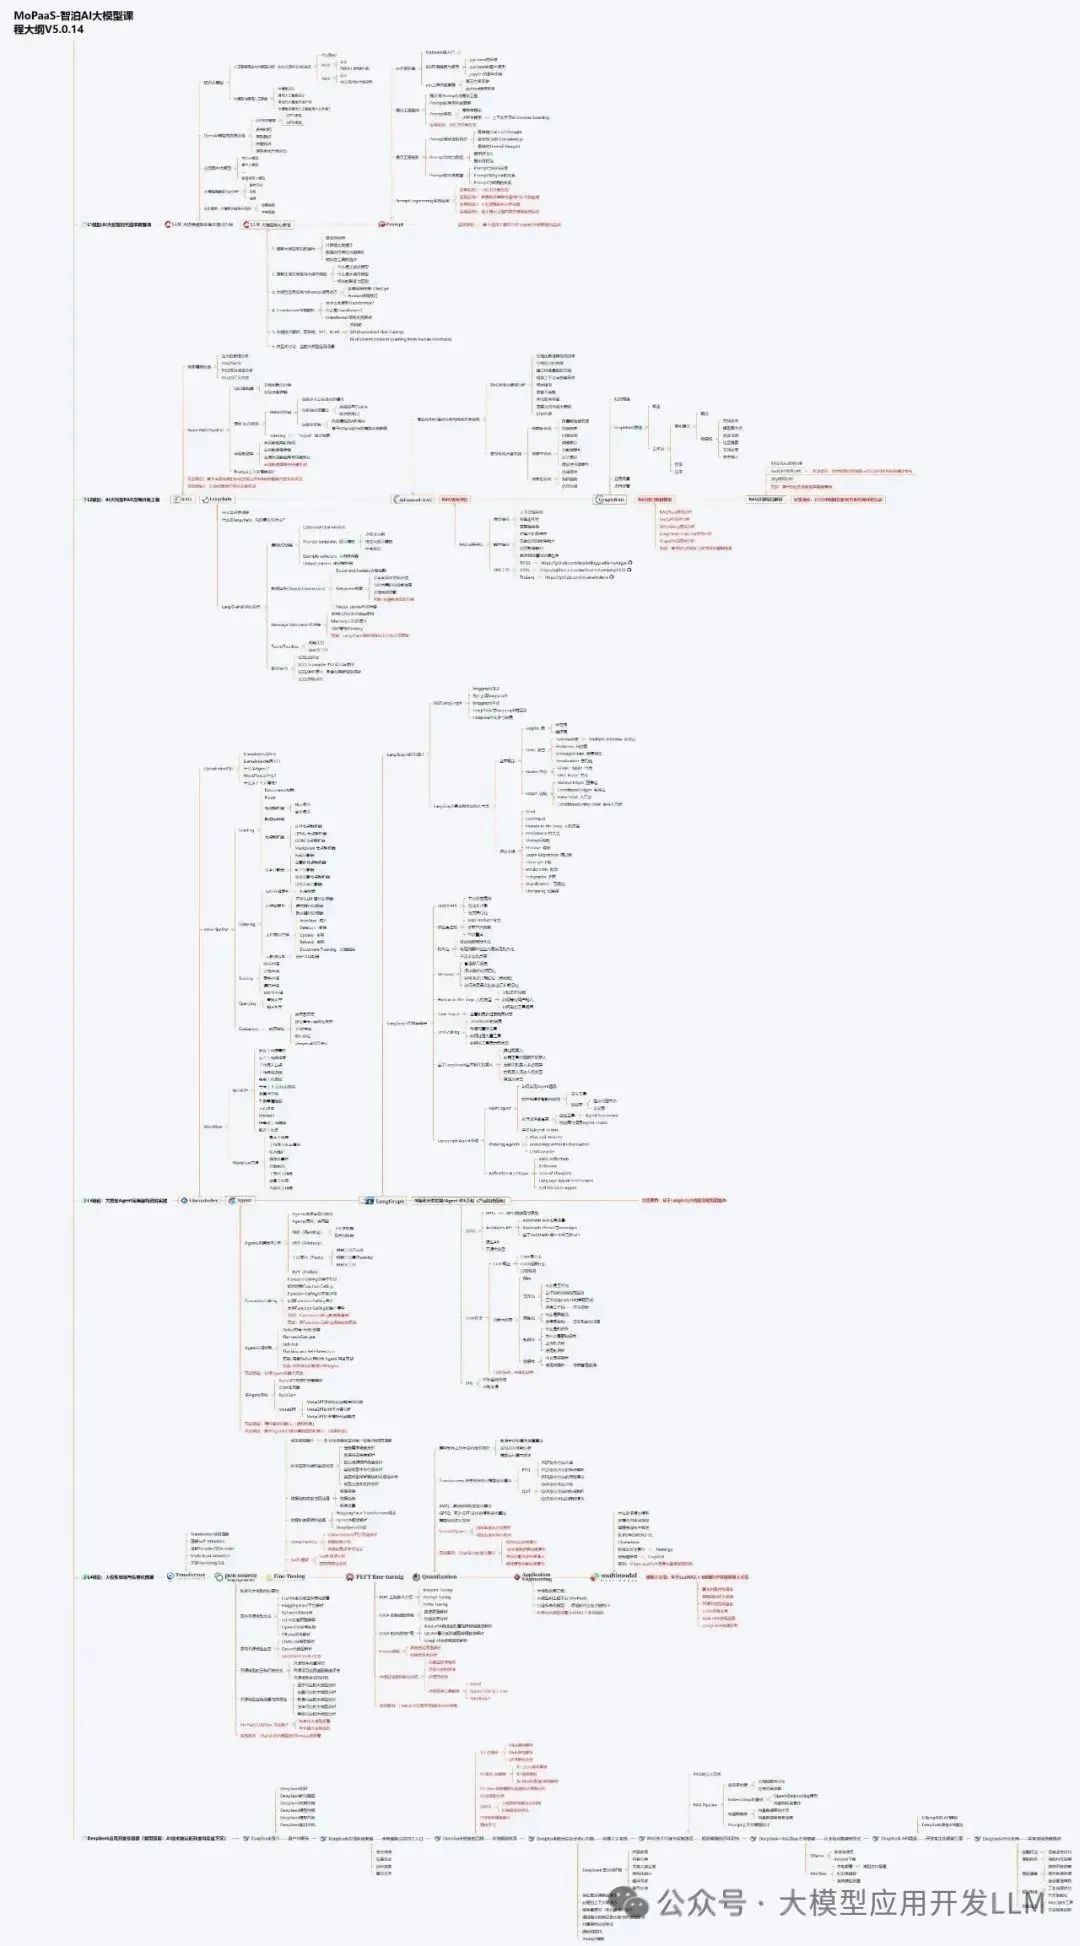
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
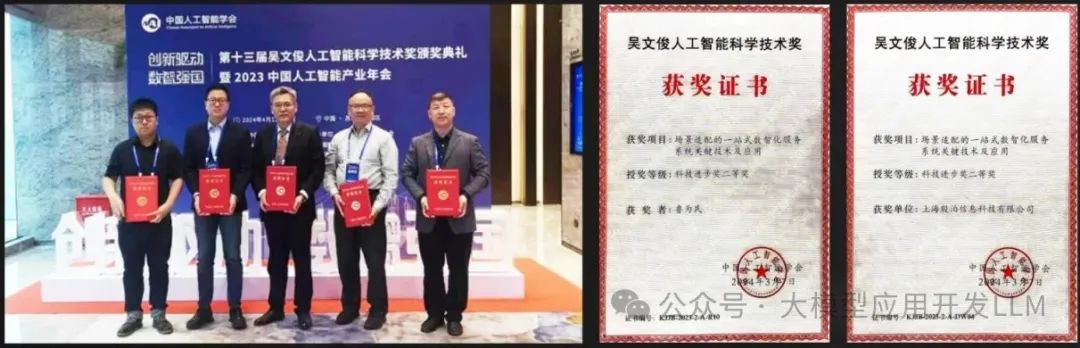
本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
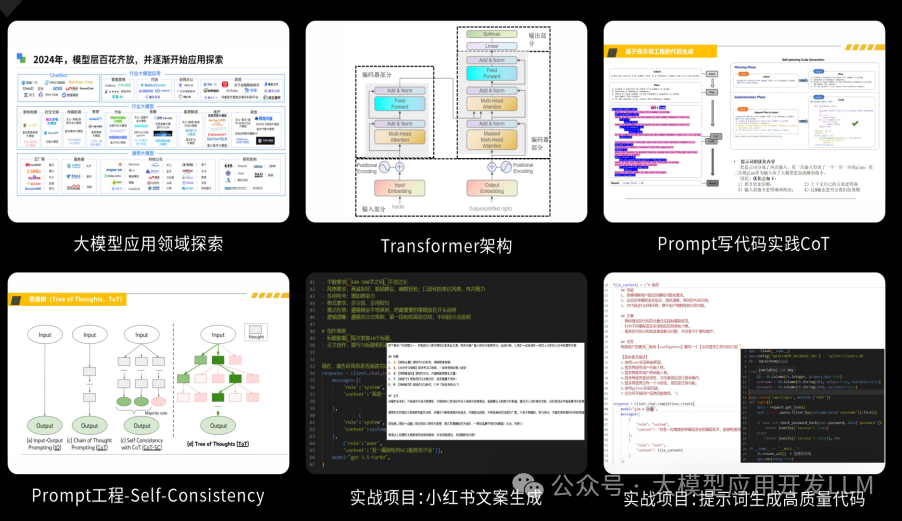
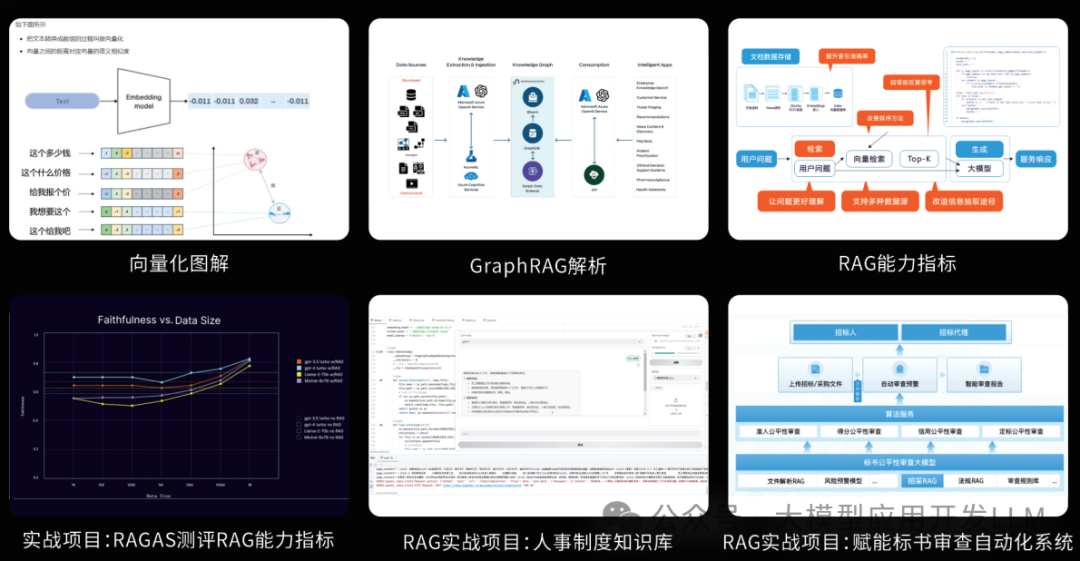
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!
 1099


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


