


一、关于RAG
1.1 简介
检索增强生成(Retrieval-Augmented Generation,RAG)是一种结合了信息检索和语言模型的技术,它通过从大规模的知识库中检索相关信息,并利用这些信息来指导语言模型生成更准确和深入的答案。这种方法在2020年由Meta AI研究人员提出,旨在解决大型语言模型(LLM)在信息滞后、模型幻觉、私有数据匮乏和内容不可追溯等问题。
即:RAG 就是可以开卷回复的 LLM
1.2 发展
RAG技术的发展历程可以分为三个主要阶段:
- Naive RAG:这是RAG技术的基础阶段,它包括了索引(Indexing)、检索(Retrieval)和生成(Generation)三个基本步骤。在这个阶段,RAG通过整合外部知识库来增强LLMs,但是存在一些限制,例如准确性低、召回低、组装prompt的问题以及灵活性问题。
- Advanced RAG:为了解决Naive RAG的不足,Advanced RAG阶段引入了预检索和后检索策略,改进了索引方法,并引入了各种方法来优化检索过程。这一阶段的RAG通过更精细的数据清洗、设计文档结构和添加元数据等方法提升文本的一致性、准确性和检索效率。
- Modular RAG:在模块化RAG阶段,RAG结构提供了更大的灵活性和适应性。它整合了各种方法来增强功能模块,例如加入搜索模块进行相似性检索,并在检索器中应用微调方法。模块化RAG允许通过多个模块进行序列化流水线或端到端训练,提供了更大的灵活性和适应性。
随着技术的发展,RAG技术也在不断进步,包括个性化、可自定义行为、可扩展性、混合模型和实时的低延迟部署等方面。这些趋势预示着RAG技术将在未来变得更加智能和高效,为各种应用程序提供更多样化的支持。RAG技术的应用已经不仅仅局限于问答系统,其影响力正在扩展到更多领域,如推荐系统、信息抽取和报告生成等。
1.3 背景
自 ChatGPT 发布以来,大型语言模型(Large Language Model,LLM,大模型)得到了飞速发展,它在处理复杂任务、增强自然语言理解和生成类人文本等方面的能力让人惊叹,几乎各行各业均可从中获益。
然而,在一些垂直领域,这些开源或闭源的通用基础大模型也暴露了一些问题,主要体现在以下 3 个方面:
- 知识的局限性: 大模型的知识源于训练数据,目前主流大模型(如:通义千问、文心一言等)的训练数据基本来源于网络公开的数据。因此,非公开的、离线的、实时的数据大模型是无法获取到(如:团队内部实时业务数据、私有的文档资料等),这些数据相关的知识也就无从具备。
- 幻觉问题: 大模型生成人类文本底层原理是基于概率(目前还无法证明大模型有意识),所以它有时候会一本正经地胡说八道,特别是在不具备某方面的知识情况下。当我们也因缺乏这方面知识而咨询大模型时,大模型的幻觉问题会各我们造成很多困扰,因为我们也无法区分其输出的正确性。
- 数据的安全性: 对于个人、创新团队、企业来说,数据安全至关重要,老牛同学相信没有谁会愿意承担数据泄露的风险,把自己内部私有数据上传到第三方平台进行模型训练。这是一个矛盾:我们既要借助通用大模型能力,又要保障数据的安全性!
为了解决以上通用大模型问题,检索增强生成(Retrieval-Augmented Generation,RAG)方案就应运而生。
1.4 工作原理
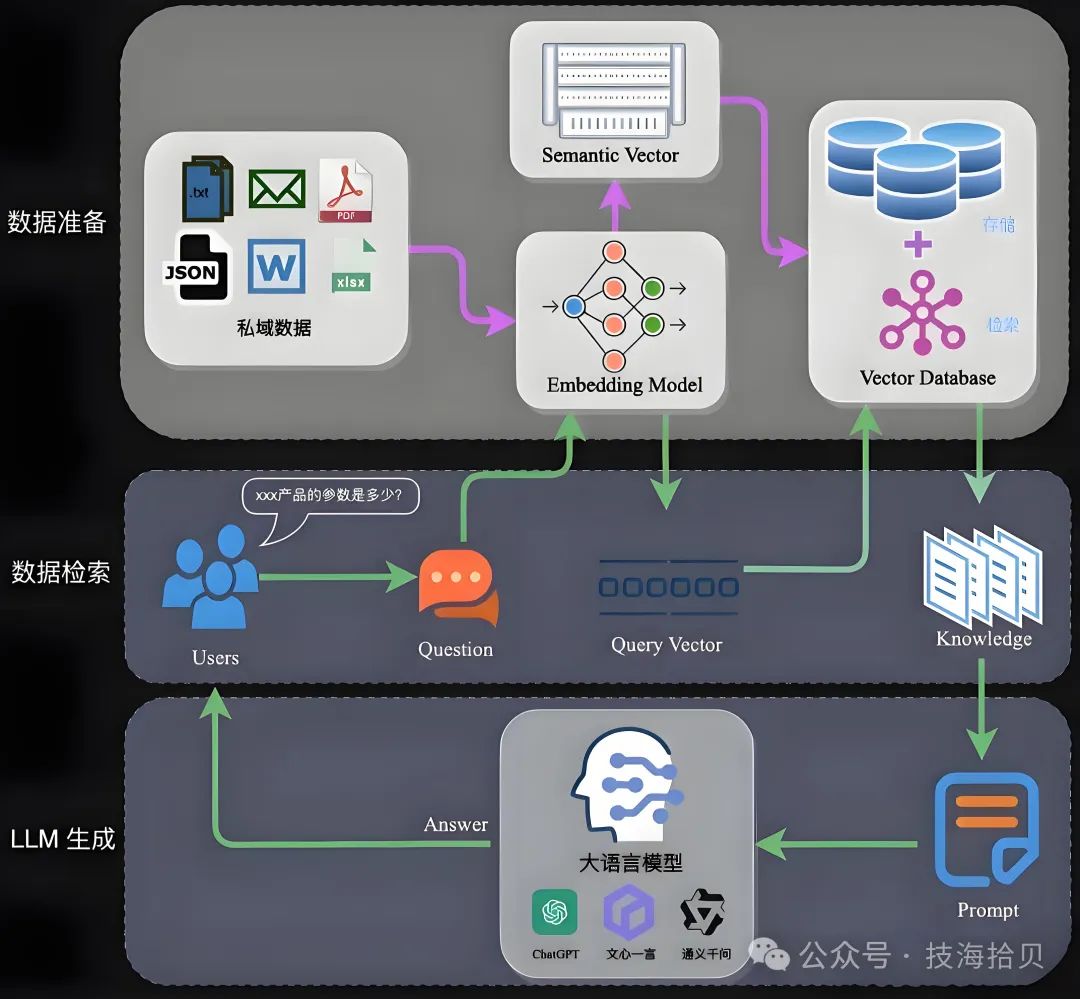
RAG 的主要流程主要包含以下 2 个阶段:
- 数据准备:首先需要准备知识文档,这可能包括多种格式的文档,如Word文档、TXT文件、PDF文件等。这些文档需要通过文档加载器或多模态模型(如OCR技术)转换为纯文本数据。然后,将这些文本分割成多个文本块,以便更高效地处理和检索信息。
- 嵌入模型:嵌入模型的核心任务是将文本转换为向量形式。这些向量能够捕捉到句子的上下文关系和核心含义,使得通过计算向量之间的差异来识别语义上相似的句子成为可能。
- 向量数据库:通过嵌入模型生成的所有向量都会被存储在向量数据库中。这种数据库优化了处理和存储大规模向量数据的效率,使得在面对海量知识向量时,能够迅速检索出与用户查询最相关的信息。
- 查询检索:用户的问题会被输入到嵌入模型中进行向量化处理,然后在向量数据库中搜索与该问题向量语义上相似的知识文本或历史对话记录并返回。
- 生成回答:将用户提问和检索到的信息结合,构建出一个提示模版,输入到大语言模型中,生成模型根据这些信息生成答案。
RAG的原理在于利用情境学习(In-Context Learning)的原理,通过检索算法找到的信息作为上下文,帮助大模型回答用户问询。这种方法特别适用于需要大量知识的任务,并且可以通过引用信息来源,增强用户对模型输出的信任。
在实际应用中,RAG可以通过多种优化策略来提高性能,包括数据清洗、分层导航小世界、查询转换、重排模型等。这些优化策略可以在AI开发框架如langchain和LLamaIndex中找到具体实现。
1.5 实现方案
目前市面上存在多个RAG(Retrieval-Augmented Generation)开源框架,它们提供了不同的功能和特性,以支持开发者构建和优化RAG系统。以下是一些流行的RAG实现框架,它们各有特点和优势:
- LangChain:这是一个功能全面的框架,提供了从数据处理到用户界面的全栈解决方案。它支持多种大模型、嵌入模型和向量数据库,非常适合需要高度定制化和复杂工作流的企业级用户。
- QAnything:由网易出品,支持任何格式文件或数据库的本地知识库问答系统,特点是加入rerank,后期更新也加入了文档理解,支持离线安装使用,适合需要数据安全保障的场景。
- RAGFlow:基于深度文档理解构建的开源RAG引擎,提供精简的RAG工作流程,支持多种文档数据类型,具有OCR功能和多种文档切分模板。
- FastGPT:提供数据处理、模型调用等能力,支持通过Flow可视化进行工作流编排,实现复杂的问答场景。
- AnythingLLM:由Mintplex Labs开发,是一个全栈应用程序,支持现成的商业大语言模型或流行的开源大语言模型,可以构建私有ChatGPT。
- Langchain-Chatchat:基于ChatGLM等大语言模型与Langchain等应用框架实现的开源、可离线部署的RAG大模型知识库项目。
这里选择AnythingLLM框架,如下介绍AnythingLLM部署及配置流程
二、Docker Desktop安装配置
这里之前文章有介绍,可参考,这里不再赘述
三、AnythingLLM 安装及配置
开始安装和部署AnythingLLM框架,包含以下 3 步:
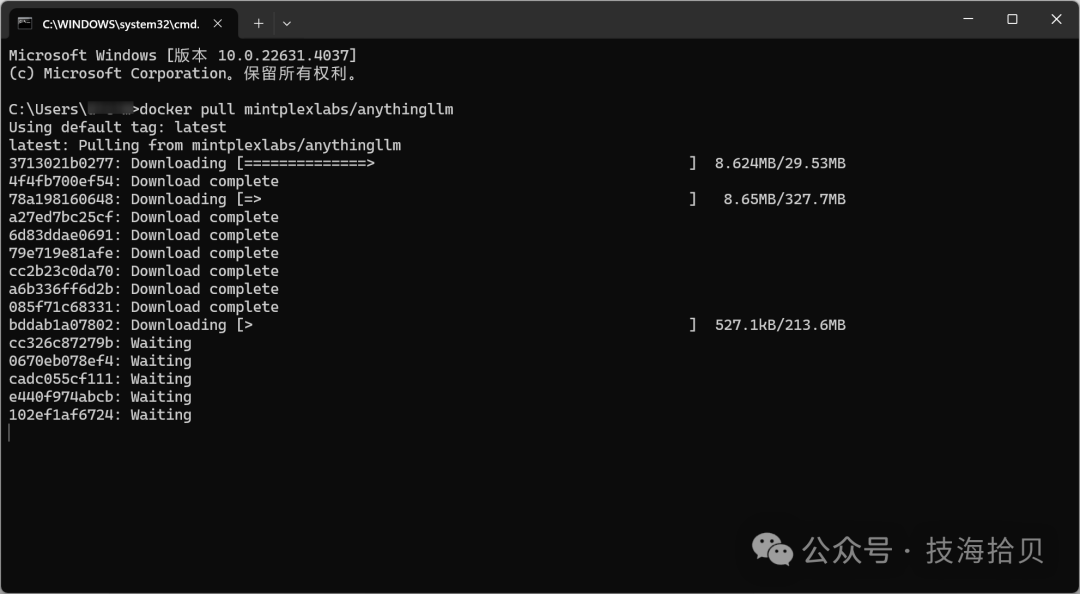
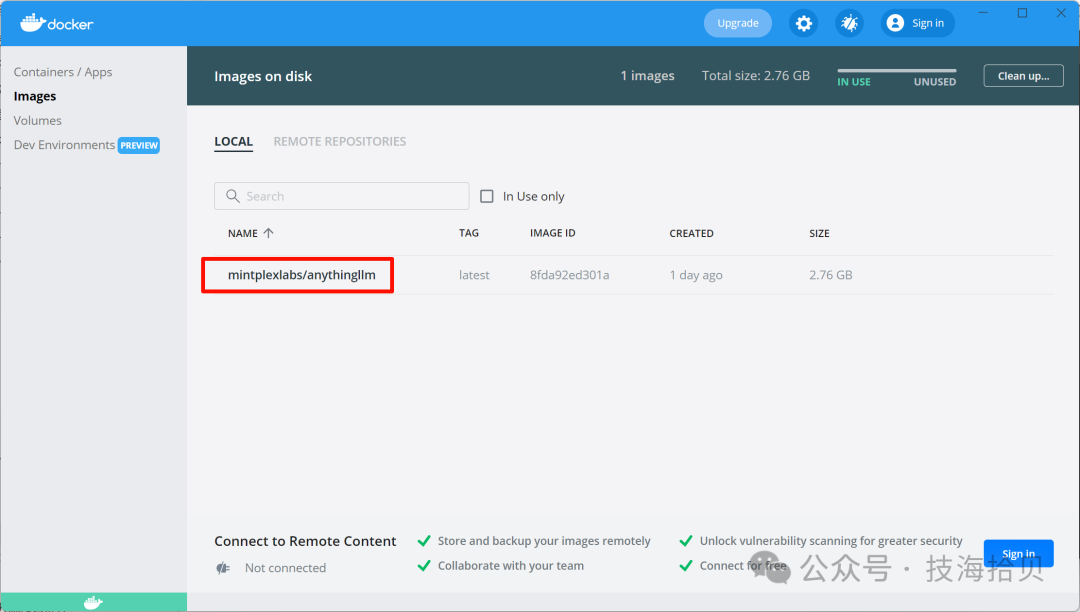
4.1 拉取镜像
docker pull mintplexlabs/anythingllm
4.2 启动镜像
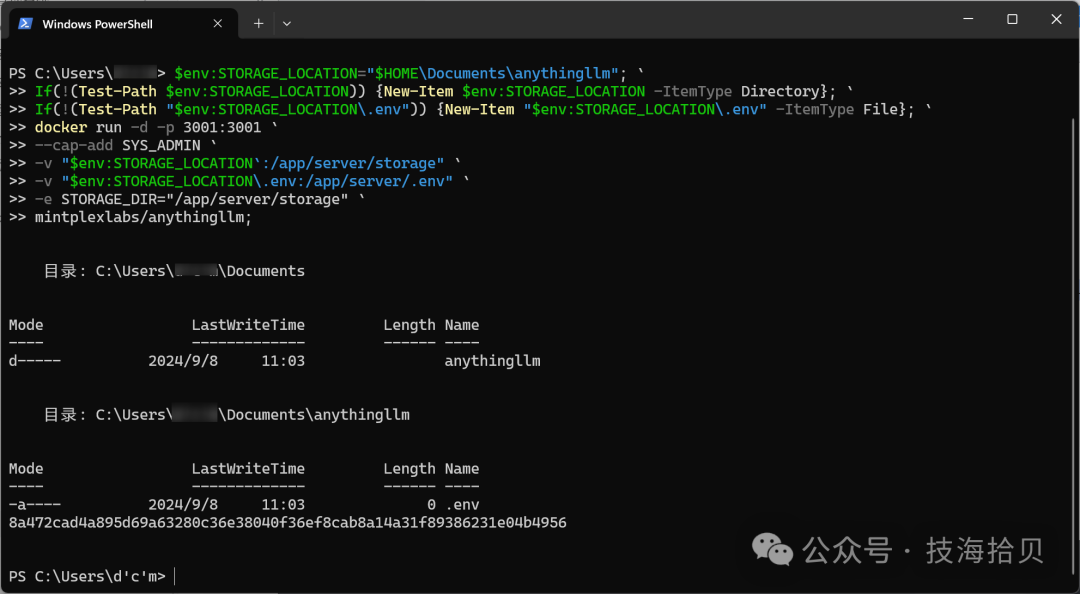
Windows环境, 通过PowerShell执行如下命令
# Run this in powershell terminal
$env:STORAGE_LOCATION="$HOME\Documents\anythingllm"; `
If(!(Test-Path $env:STORAGE_LOCATION)) {New-Item $env:STORAGE_LOCATION -ItemType Directory}; `
If(!(Test-Path "$env:STORAGE_LOCATION\.env")) {New-Item "$env:STORAGE_LOCATION\.env" -ItemType File}; `
docker run -d -p 3001:3001 `
--cap-add SYS_ADMIN `
-v "$env:STORAGE_LOCATION`:/app/server/storage" `
-v "$env:STORAGE_LOCATION\.env:/app/server/.env" `
-e STORAGE_DIR="/app/server/storage" `
mintplexlabs/anythingllm;
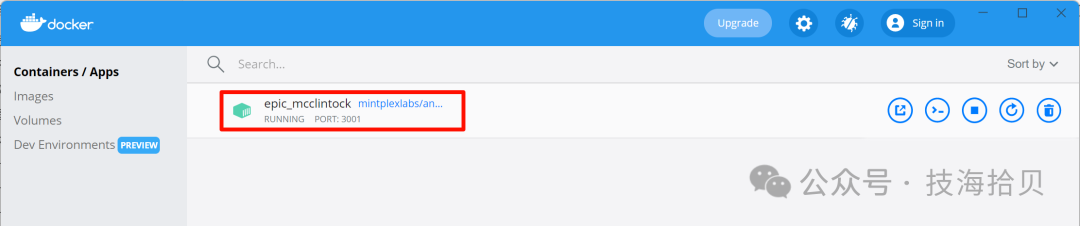
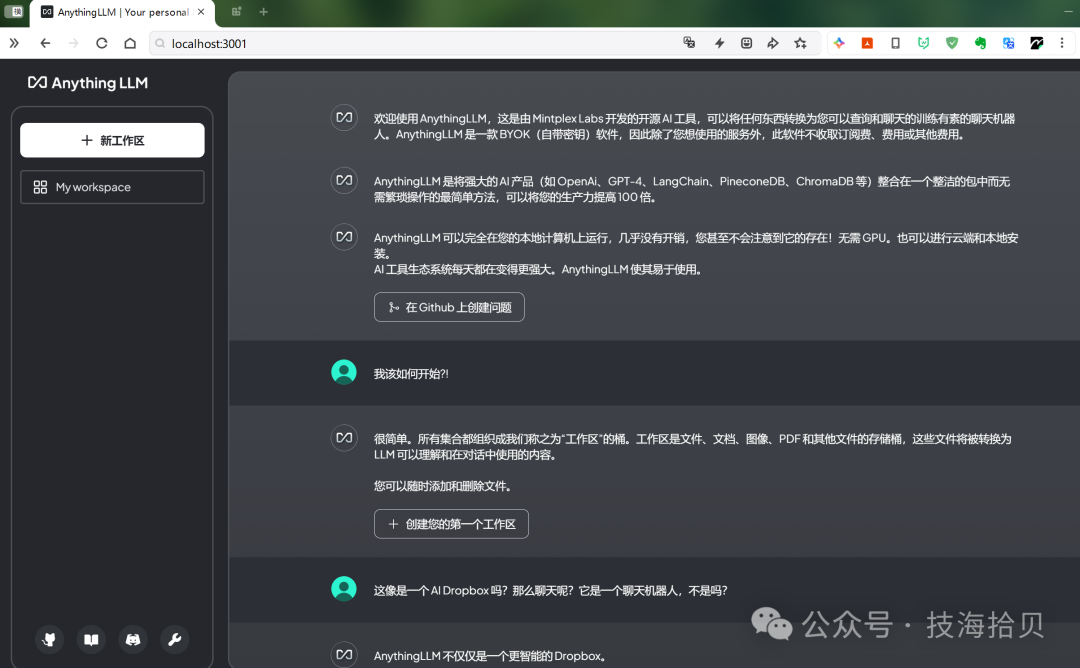
启动完成,通过浏览器打开如下网址:http://localhost:3001,进入AnythingLLM web界面
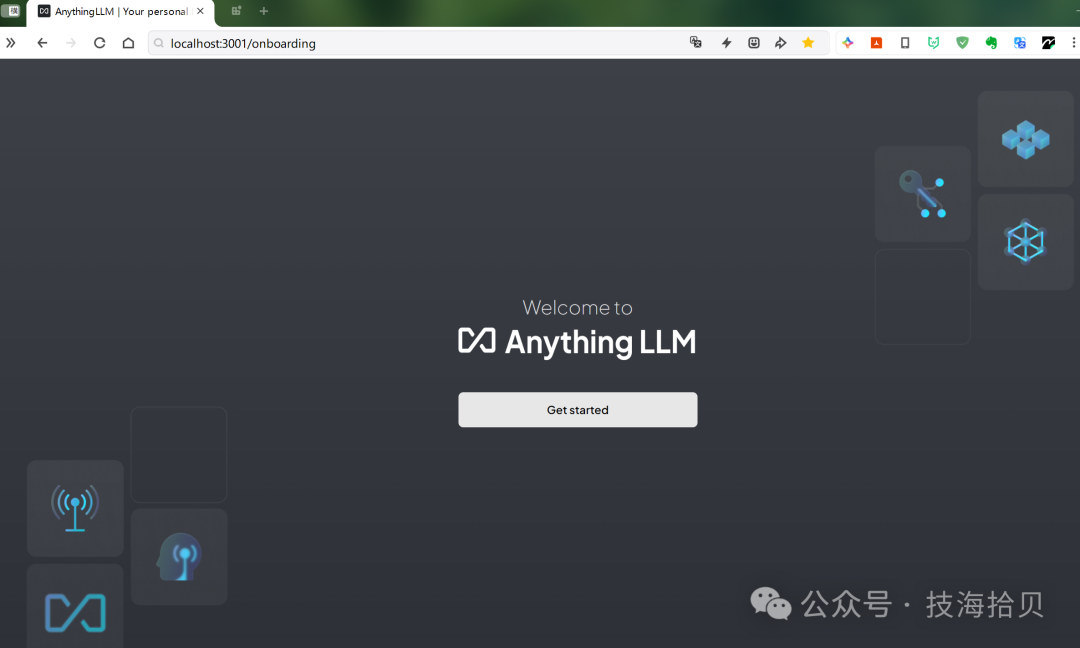
4.3 配置
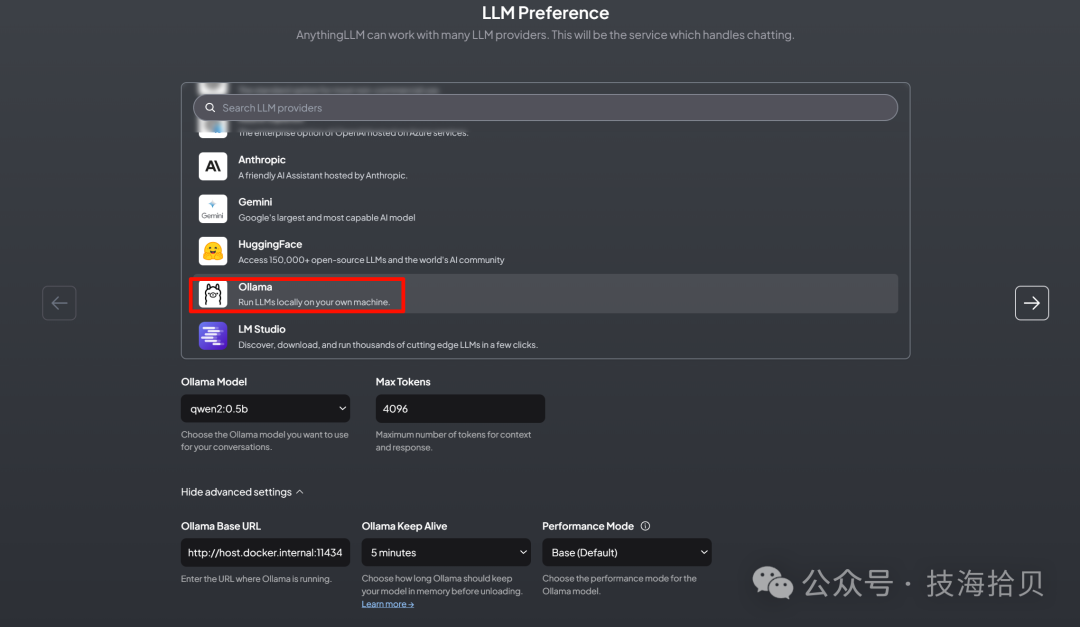
点击开始,这里选择ollama,如果本地已启动ollama,则会检测到
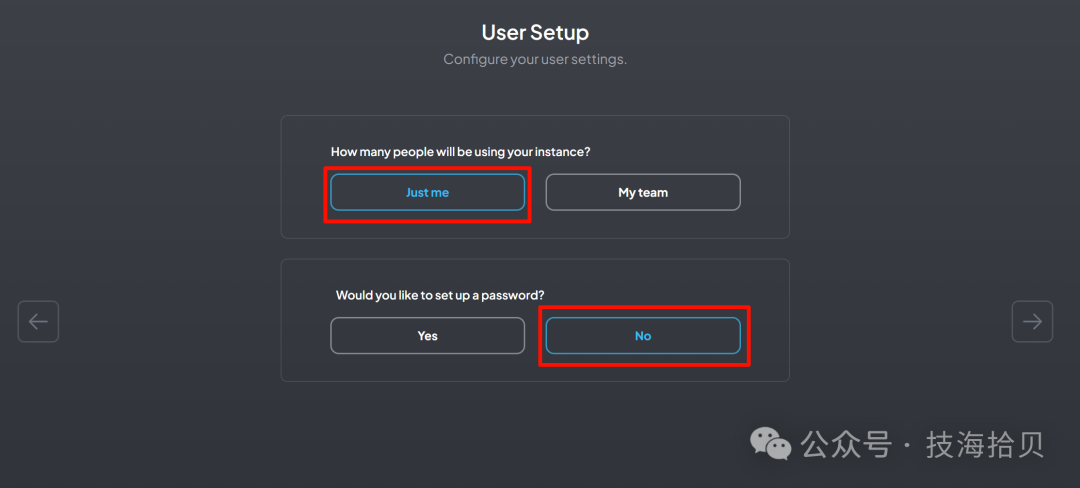
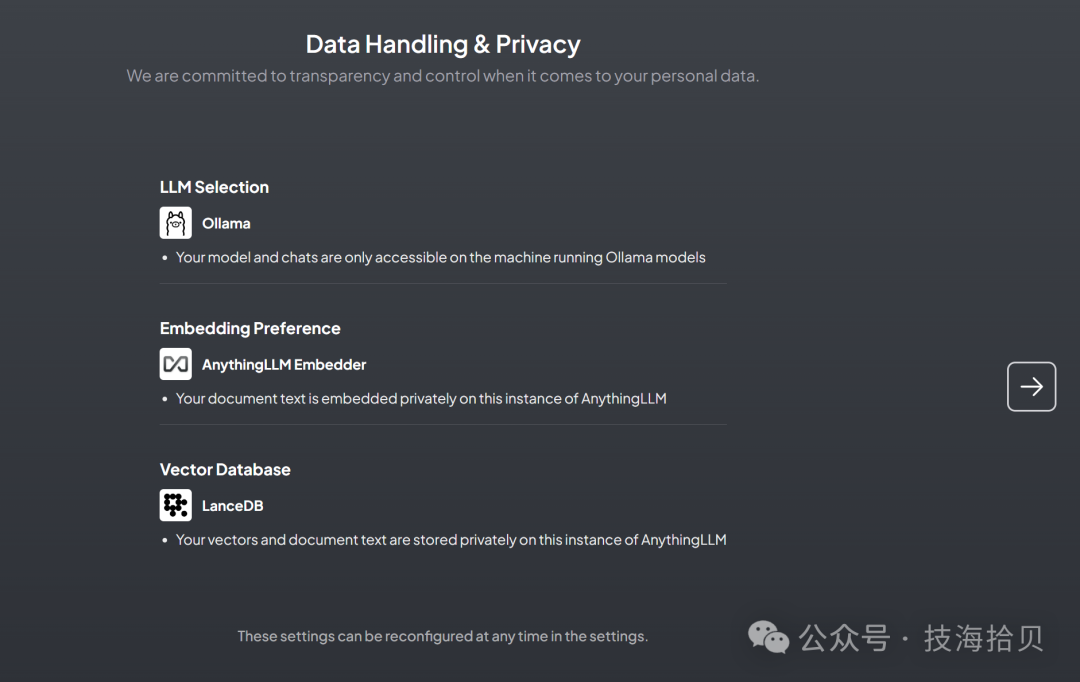
这里可以根据情况,配置当前用户使用,还是团队使用
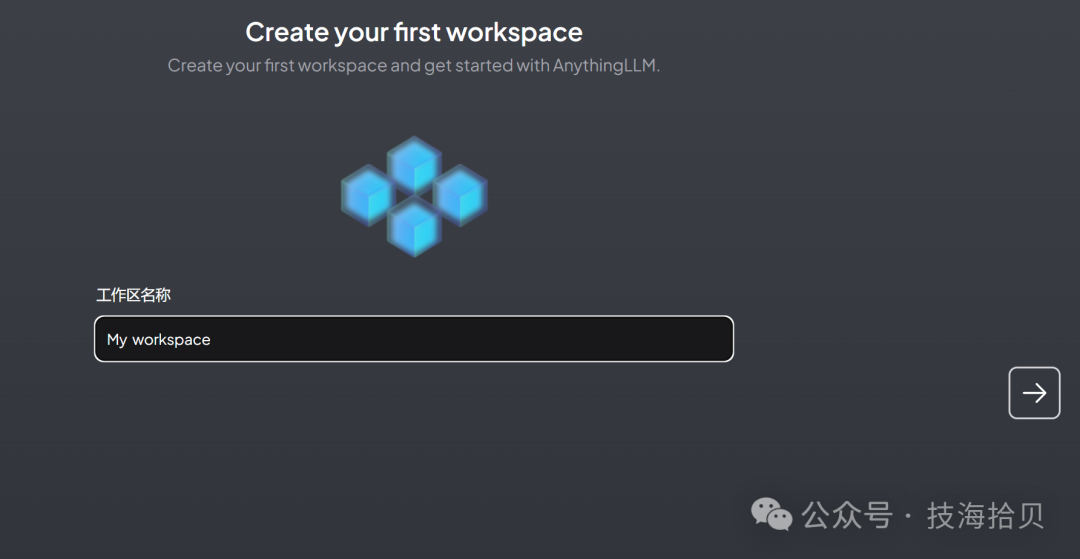
创建工作区
五、导入数据和使用
5.1 导入内部数据
创建一个word或txt文件,文本内容如下
自ChatGPT发布以来,大型语言模型(Large Language Model,LLM,大模型)得到了飞速发展,它在解决复杂任务、增强自然语言理解和生成类人文本等方面的能力让人惊叹,几乎各行各业均可从中获益。


然而,在一些垂直领域,这些开源或闭源的通用的基础大模型也暴露了一些问题,主要有以下3个方面:


1. **知识的局限性:** 大模型的知识源于训练数据,目前主流大模型(如:通义千问、文心一言等)的训练数据基本来源于网络公开的数据。因此,非公开的、离线的、实时的数据大模型是无法获取到(如:团队内部实时业务数据、私有的文档资料等),这些数据相关的知识也就无从具备。
2. **幻觉问题:** 大模型生成人类文本底层原理是基于概率(目前还无法证明大模型有意识),所以它有时候会**一本正经地胡说八道**,特别是在不具备某方面的知识情况下。当我们也因缺乏这方面知识而咨询大模型时,大模型的幻觉问题会各我们造成很多困扰,因为我们也无法区分其输出的正确性。
3. **数据的安全性:** 对于个人、创新团队、企业来说,**数据安全**至关重要,老牛同学相信没有谁会愿意承担数据泄露的风险,把自己内部私有数据上传到第三方平台进行模型训练。这是一个矛盾:我们既要借助通用大模型能力,又要保障数据的安全性!


为了解决以上3个大模型通用问题,**检索增强生成**(Retrieval-Augmented Generation,**RAG**)方案就应运而生了!
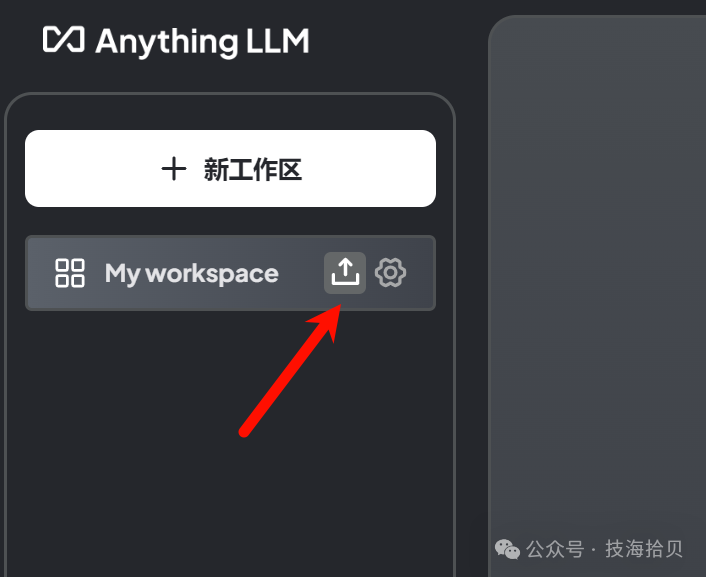
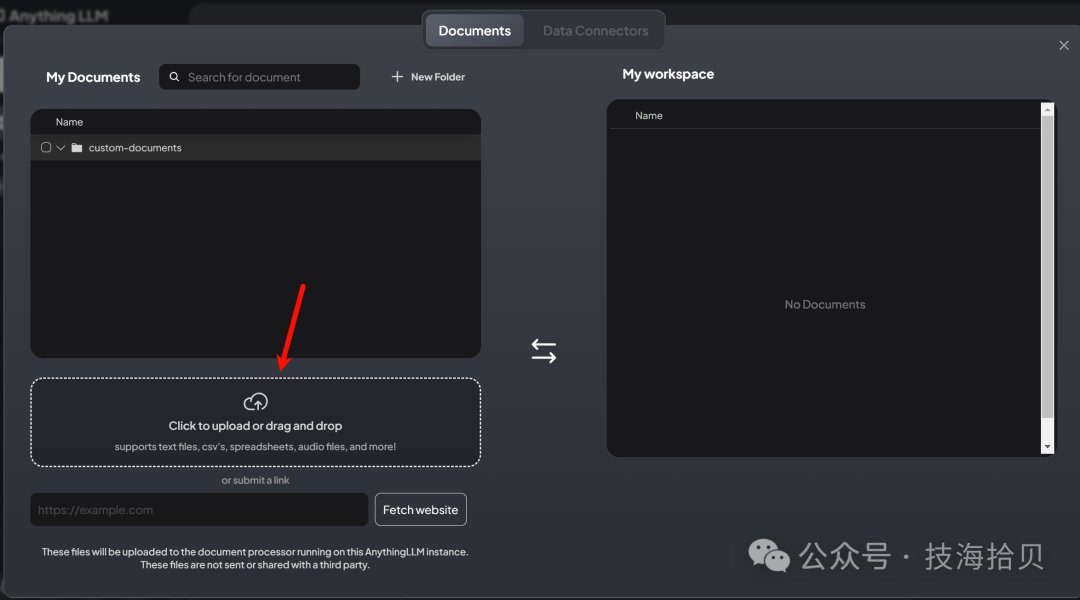
在工作区,上传上述文件
上传后移动到工作区
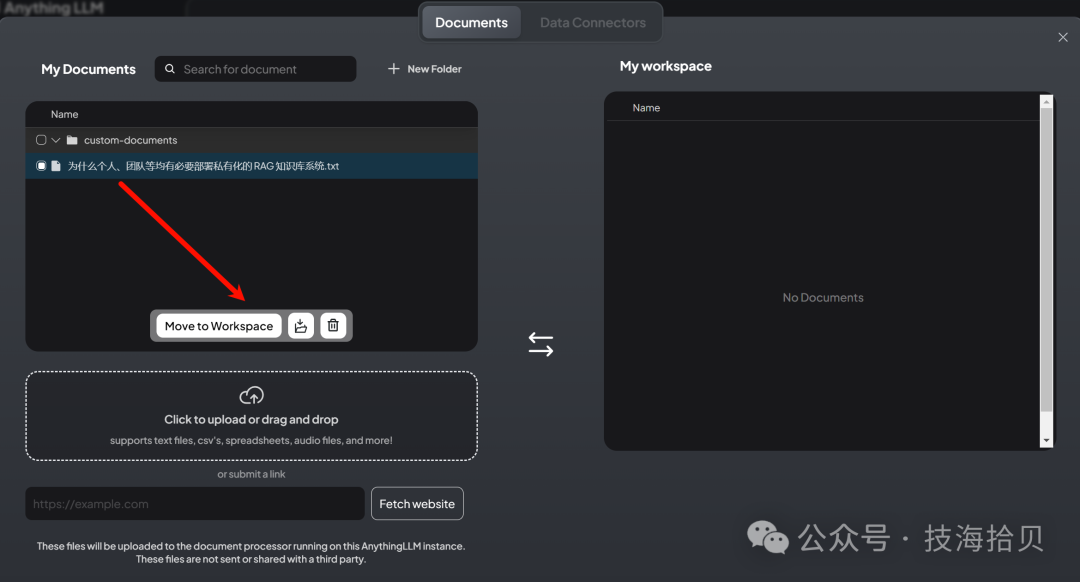
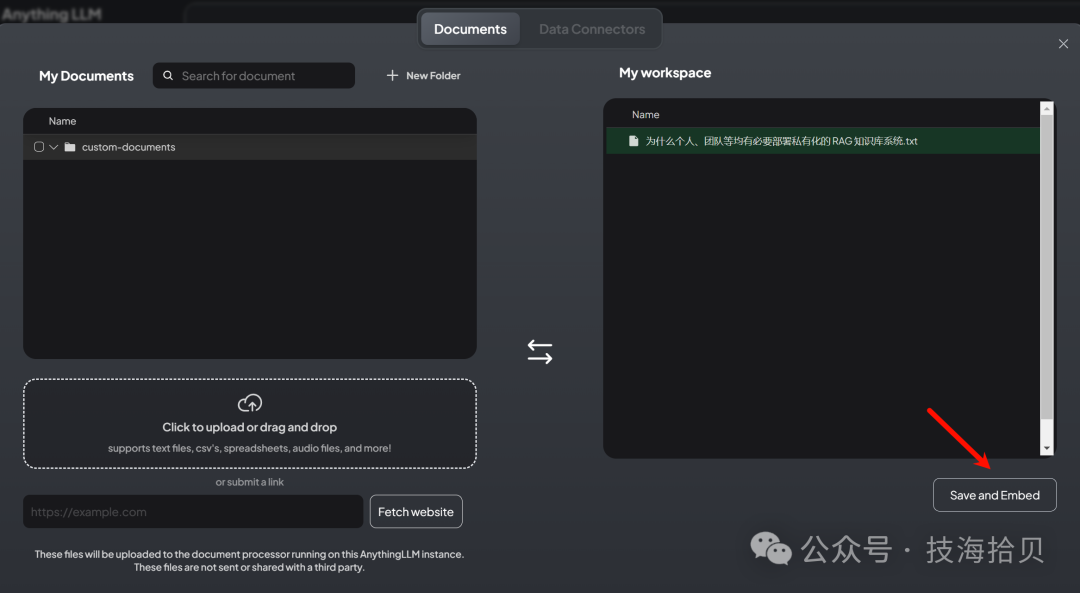
最后保存,需要一段时间
5.2 内部数据使用和验证
到对话界面,输入问题,
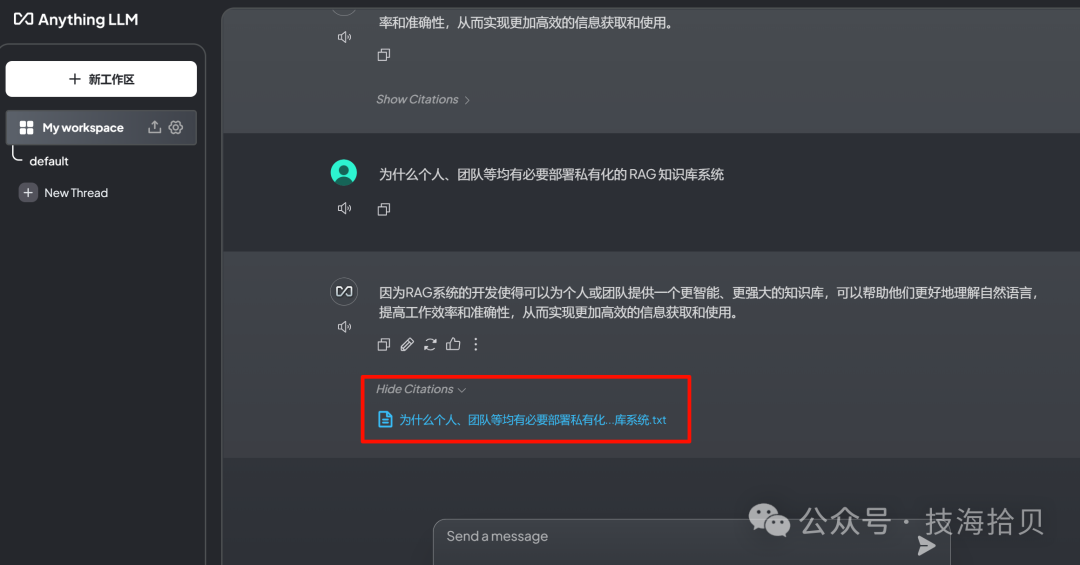
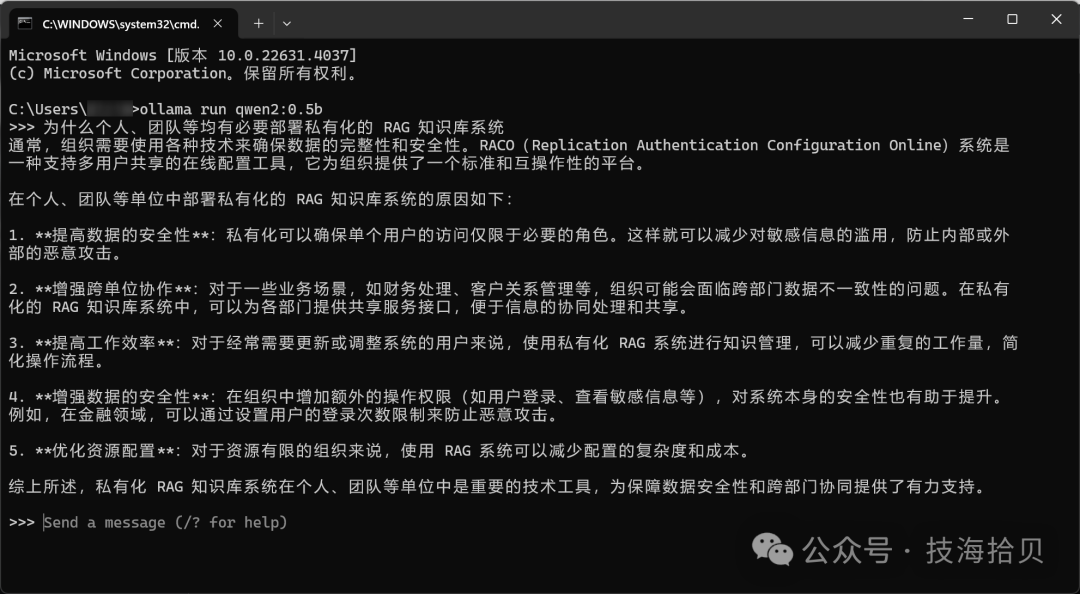
直接调用通义千文底层模型,同样的问题,查看回答,与上述对比有差异
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 7349


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


