


“ 企业知识库,建议尽早搭建!不论是否在AI时代,一个企业的核心竞争力就是知识,很多企业没有意识到,散落在各处的产品手册、用户反馈、销售分析报告等等,都是宝贵的知识资产,若把这些整合到企业知识库,是能实实在在提升运营效率,解决知识管理的大难题!每天花5-10分钟,学习一点AI知识,助您厚积薄发!”
在学习本地部署大模型(Large Language Model,简称LLM)以及拥有自有模型后,本文将继续从企业AI落地的角度,介绍如何运用RAG技术搭建企业的知识库,通过代码的方式,全流程解析开发过程与原理,其中会涉及使用的技术框架LangChain、Embedding、向量库、调用本地DeepSeek和企业自有模型等,完成知识库的问答。
01 概念:企业知识库,RAG、微调与蒸馏,LangChain
在实现企业知识库功能前,先简单介绍下知识库以及相关技术。
1、企业知识库
企业知识库是指企业用于集中存储、管理和共享内部知识与信息的数字化平台,是企业数字化转型的必备工作。其中包含了企业的组织架构、品牌及产品服务、业务操作流程、客户信息等内容,目的在于提升企业知识利用效率和各部门的协作能力。
(1)知识库核心功能。一是知识集中化管理。整合企业各类信息(如业绩报告、专利技术、客户数据等),按主题分类存储,形成可检索的共享资源。二是支撑高效协作。通过数字化平台实现自助查询,减少重复性工作,加速问题的解决。
(2)AI技术赋能,传统的知识库是以结构化的数据为主,比较依赖人工维护,基本上就存在档案室了,没有可用的余地。得益于AI的兴起,新型知识库是结合大模型与检索增强生成(RAG)技术,实现动态知识更新、上下文理解及智能问答,能够显著提升知识的利用率。
其中谈到RAG技术,顺便理解下RAG、微调与蒸馏。
2、RAG、微调与蒸馏
(1)RAG(Retrieval-Augmented Generation,检索增强生成)。结合检索(Retrieval)和生成(Generation)技术,通过实时从外部知识库检索相关信息,辅助生成更准确的回答。其实可以将知识库理解为“信息外挂”,先到知识库中获取到相关信息,大模型通过分析理解后给出答复,此时信息是比较安全的,因为其完全独立在外。
(2)微调(Fine-tuning)。在预训练大模型或者搭建的自有模型的基础上,用特定领域或任务的数据训练,使其适应特定场景的需求。此方式需要进行数据训练,若使用外部大模型时,自然会存在数据安全风险。
(3)蒸馏(Knowledge Distillation,知识蒸馏)。可以理解为与“微调”类似,只不过使用的数据是经过大模型学习后浓缩而成的数据(知识),类比于将课本知识划了重点,浓缩而成的“考试前的秘籍”,牺牲部分精度换取效率。
3、LangChain
LangChain是一个基于语言模型开发应用程序的框架。一是组件化,组件封装,将功能模块化,便于开发者直接使用。二是链,将结构化的组件组合,可以快速完成特定任务,比如QA问答等,此处不做详细介绍,后续对该框架进行详细分析,目前大致了解即可。
02 全流程实现与解析
1、实现目标
本次实现的目标是:用户检索知识库的知识,并且能看到大模型的思考过程。步骤拆解如下:
(1)文本预处理:数据(pdf、word等文档)加载与清洗。
(2)文本向量化:将数据切片,并使用预训练的词嵌入(Embedding)模型将加载的数据转换为向量。
(3)构建索引:将处理好的向量数据存储到向量检索库(如Chroma、FAISS等),同时构建知识库的向量索引。
(4)提示词prompt模板编写:让大模型按照要求进行问答。
(5)检索查询:实现一个检索函数,传递一个query参数,在索引中找到最相似的文本片段,使用LangChain的RetrievalQA完成大模型、知识向量库的链式调用。
(6)验证效果:使用根据知识的内容,进行检索效果的验证。
2、代码实现与解析
有了上述拆解过程,实现起来就方便很多了。
(1)创建Python项目
打开PyCharm,创建llm-rag-demo项目,创建data、docs目录,用于存放向量库文件以及需要加入企业知识库的文件。如下:
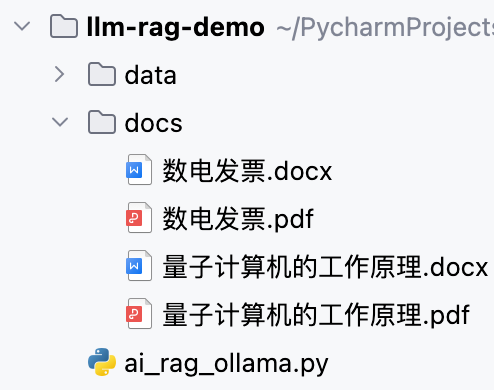
创建ai_rag_ollama.py,正式进行开发。
注意:最好设置独立的环境,避免与其他项目环境冲突。
(2)文档加载、数据切片处理、构建向量索引
# 加载文件目录
file_path = './docs/'
# 文件切割
chunk_size = 1024
chunk_overlap = 256
text_split = CharacterTextSplitter(chunk_size=chunk_size, chunk_overlap=chunk_overlap)
# 向量库
persist_directory = './data/vector_store'
# 使用本地模型,可以在各模型社区下载
embedding_model = HuggingFaceEmbeddings(model_name='./text2vec-base-chinese')
vector_db = Chroma(persist_directory=persist_directory, embedding_function=embedding_model)
# 加载文件,并进行数据切片,添加至向量库
def load_file(file_name):
print('加载文件--:', file_name)
if file_name.lower().endswith('.pdf'):
loader = PyPDFLoader(file_path + file_name)
elif file_name.lower().endswith('.csv'):
loader = CSVLoader(file_path + file_name)
elif file_name.lower().endswith('.docx'):
loader = Docx2txtLoader(file_path + file_name)
else:
raise ValueError('文件类型不支持。目前支持格式:pdf、csv、docx。')
documents = loader.load()
docs = text_split.split_documents(documents)
if docs:
vector_db.add_documents(docs)
# 遍历加载docs目录下的文件
def load_file_and_vec():
if os.path.isdir(file_path):
for root, ds, fs in os.walk(file_path):
for f in fs:
load_file(file_name=f)
(3)提示词prompt模板编写
qa_prompt = PromptTemplate.from_template(
"""
根据给出的上下文信息回答问题,如果从上下文信息中找不到答案诚实的说不知道。
上下文信息:{context}
问题:{question}
""")
提示词根据需求进行调整即可,此处用于演示相对简单。其中参数一个是上下文信息,一个是提问的问题。
(4)提示词prompt模板编写
# 检索
def do_search(msg):
llm = Ollama(model='deepseek-r1:7b')
qa = RetrievalQA.from_chain_type(
llm=llm,
retriever=vector_db.as_retriever(),
verbose=False,
chain_type_kwargs={'prompt': qa_prompt}
)
response = qa({'query': msg})
try:
ans = response['result']
except Exception as err:
print('chat err: {}'.format(err))
ans = '模型查询异常!'
return ans
解析:
-
使用了Ollama,调用的是本地模型。这个有不理解的,可以看下上一篇文章。另外后续也会介绍如何对接百度千帆、阿里百炼等平台。
-
使用了RetrievalQA,可以很方便的组合llm、vector_db、提示词,快速实现问答。
(5)main函数
if __name__ == '__main__':
# 到网上找好资料,并放在docs目录下,执行加载
# 首次加载后,后续提问时不需要再执行了
load_file_and_vec()
# 提问
query = '量子计算机的工作原理'
# query = '数电发票是什么?'
ans = do_search(query)
# 输出查询结果
print('大模型理解后回复如下:  {}'.format(ans))
(6)附:代码中的相关引用
import os
from langchain.document_loaders.pdf import PyPDFLoader
from langchain.document_loaders.csv_loader import CSVLoader
from langchain.document_loaders import Docx2txtLoader
from langchain.text_splitter import CharacterTextSplitter
from langchain.vectorstores.chroma import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from langchain.chains.retrieval_qa.base import RetrievalQA
from langchain.prompts.prompt import PromptTemplate
from langchain_community.llms import Ollama
03 跑一下,看效果
1、首次执行
首次执行后,在“./data/vector_store”下会生产相关文件。
此时可以将以下这行代码注释了。
# load_file_and_vec()
2、使用deepseek-r1:7b模型,提问“量子计算机的工作原理”
回答如下:
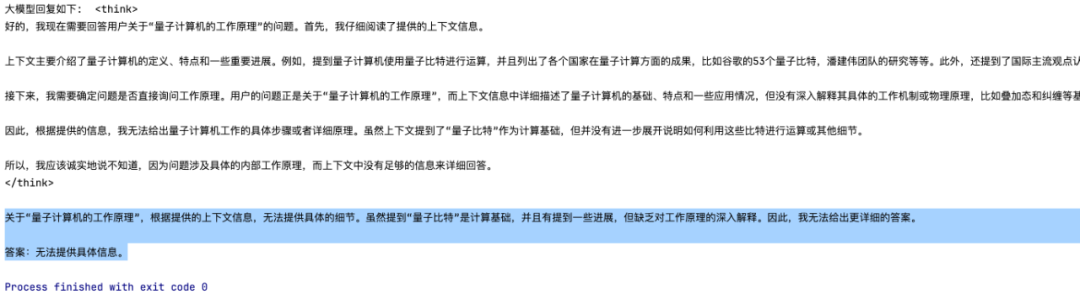
其中 标签里面是思考过程。
回复有些意外的,居然是:无法提供具体信息。
3、使用deepseek-r1:14b模型,提问“量子计算机的工作原理”
回答如下:
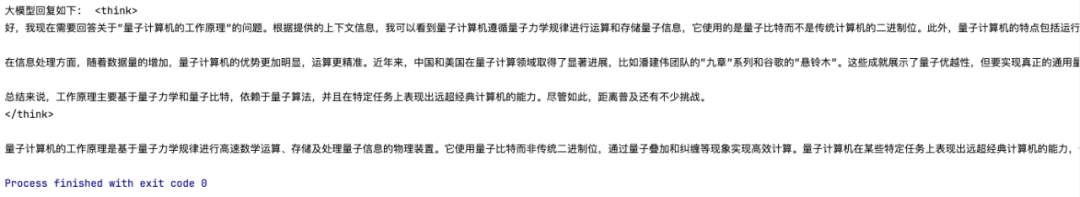
回复是正常的,可以看出来大模型的能力是能提升知识库的整体能力的。
下面可以自行调整query的值,比如提问“数电发票是什么?”,也可以切换模型做一些对比验证,另外还可以使用上一篇中自定义的模型试试哦。
至此,简易的知识库已经完成!若需要提供给用户使用,实现相应的系统界面即可。将企业文档管理起来,实时进行数据切片、向量转换与存储,根据不同类型的场景,编写不同的prompt,以及选择不同的大模型,可以达到更好的效果。
因为篇幅有限,涉及内容较多,有一些没有说到的地方,若有需要源码的,没有下载到text2vec-base-chinese模型文件的,可以私信获取。当然,有企业知识库搭建需求,欢迎私信哦。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 410


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


