


本文使用一个简单的数据集,展示大模型预训练与有监督微调过程。无论是大模型的预训练还是有监督微调,其损失值的计算过程都是与下一个要预测的词计算损失。
预训练损失值的计算,即从第一个字开始每个字都与下一个字计算损失;
有监督微调与预训练唯一不同的点,便是不对指令与用户的输入文本计算损失,实际操作就是把用户输入文本在训练过程中遮罩掉,把对应的 label 的值设置为-100。这是因为不希望大模型学会,如何生成的用户的问题。
当前文章介绍预训练,下篇文章介绍有监督微调
本文不使用 llamafactory 等,大模型微调工具,上述工具把大模型微调的过程都封装到底层了。只使用 transformers库的AutoTrain实现大模型的微调。
开源地址:
https://github.com/JieShenAI/csdn/tree/main/25/02/pre_train
原始数据集
将使用下述5条数据微调大模型,对比一下,预训练与有监督微调的区别。
[
  {
    "instruct": "请你给哪吒写一首诗:",
    "input": "哪吒降世,意气飞扬。\n逆天改命,破障冲霄。",
    "label": "红绫缠腕,风火踏浪。\n不屈不悔,笑傲苍茫。"
  },
  {
    "instruct": "请你给敖丙写一首诗:",
    "input": "碧海生龙子,云中舞雪霜。",
    "label": "恩仇难两忘,何处是家乡?"
  },
  {
    "instruct": "请你给殷夫人写一首诗:",
    "input": "十月怀胎盼子生,柔心铁骨两相承。",
    "label": "甘将慈爱护天地,不惧风雷不惧征。"
  },
  {
    "instruct": "请你给太乙真人写一首诗:",
    "input": "仙风道骨,骑兽遨游。",
    "label": "炉中炼术,指点神童。"
  },
  {
    "instruct": "请你给申公豹写一首诗:",
    "input": "阴谋藏心,步步为营。\n狂傲不羁,志向高冥。",
    "label": "欲翻天命,终难遂行。\n困局自招,悔恨难平。"
  }
]
下述是标准的有监督微调的数据格式,使用 apply_chat_template 方法,告知模型哪些是系统提示词、用户问题、模型的回答。
d = {
    "instruct": "请你给哪吒写一首诗:",
    "input": "哪吒降世,意气飞扬。\n逆天改命,破障冲霄。",
    "label": "红绫缠腕,风火踏浪。\n不屈不悔,笑傲苍茫。",
}
messages = [
    {
        "role": "system",
        "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant.",
    },
    {
        "role": "user",
        "content": d["instruct"] + d["input"],
    },
    {
        "role": "assistant",
        "content": d["label"],
    },
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    # add_generation_prompt=True
)
print(text)
输出:
<|im_start|>system
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>
<|im_start|>user
请你给哪吒写一首诗:哪吒降世,意气飞扬。
逆天改命,破障冲霄。<|im_end|>
<|im_start|>assistant
红绫缠腕,风火踏浪。
不屈不悔,笑傲苍茫。<|im_end|>
上述是数据 template的构造,每个大模型的template不一样,但很多大模型微调工具(llamafactory等)都会自动构造template,无需太担心。
本文是大模型预训练与有监督微调的手搓简化版本,数据构造不使用template,设置预训练和有监督微调的输入文本一样,都是把 instruct + input + label 拼接起来,在结尾添加一个结束符号。
instruct + input + label + tokenizer.eos_token
在结尾需要添加 tokenizer.eos_token 停止符号,这是为了让大模型学会停止文本生成。不然在大模型推理的时候,大模型就会一直往后生成文本,直到达到模型最大的生成的长度才会停止。
预训练代码实战
from typing import List, Dict, Sequence
import torch
import transformers
from transformers import TrainingArguments, Trainer
from torch.utils.data import Dataset
from dataclasses import dataclass

IGNORE_INDEX = -100
device = "cuda:0" if torch.cuda.is_available() else "cpu"
IGNORE_INDEX -100, 在 label 中被标注为-100表示不参与 loss 计算。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_dir = r"Qwen/Qwen2.5-0.5B"

model = AutoModelForCausalLM.from_pretrained(model_dir)
model = model.to("cuda:0")

tokenizer = AutoTokenizer.from_pretrained(model_dir, padding_side="right")

据上图所示,发现 Qwen 模型 文本填充与文本结束符 是同一个符号。这给后续计算文本停止符号的 loss计算 带来了麻烦。
这里的讨论可以忽略,如果想加深对 填充符号、文本停止符号、generate停止符的理解,可以阅读下述文本:
如果 文本填充与文本结束符 是同一个符号,那么在 label 中,就不能把全部的填充符号都设置为-100,因为模型的填充符号与文本生成的停止符号是同一个字符。如果全部设置为-100,都不计算 loss,会导致模型学不会生成文本结束符号。当然也可以选择对所有的文本填充符号都计算 loss,这会导致模型学会在生成填充符号之后,下一个字符继续生成填充符号。
踩坑经历:我曾经在微调模型的时候,遇到一种情况,大模型在经过微调后,文本生成结束了还在一直输出[PAD]符号。这个原因就是没有把填充符号[PAD]的 label 设置为-100,导致大模型学会了在遇到[PAD]之后,下一个词依然输出[PAD]。同时也没有把[PAD],作为停止符号,添加到generate方法的停止词中,这才导致了一直生成[PAD]的情况出现。
总而言之,Qwen的填充符与停止符是同一个符号没有问题。在模型调用generate方法生成文本时,虽然模型会一直生成填充符号,但是填充符号同时也是停止符号,模型也会停止文本生成。
由于本文不使用框架训练模型,可以更自由一点,故自定义填充符为[PAD]:
tokenizer.add_special_tokens({
    "pad_token": "[PAD]"
})
tokenizer.pad_token, tokenizer.pad_token_id
输出:
('[PAD]', 151665)
自定义数据集
class PreTrainDataset(Dataset):

    def __init__(self, data: List):
        super().__init__()
        self.data = data

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx) -> List[Dict]:
        item = self.data[idx]
        text = item["instruct"] + item["input"] + item["label"] + tokenizer.eos_token
        return text

dataset = PreTrainDataset(data)
dataset[0]
输出:
'请你给哪吒写一首诗:哪吒降世,意气飞扬。\n逆天改命,破障冲霄。红绫缠腕,风火踏浪。\n不屈不悔,笑傲苍茫。<|endoftext|>'
很多人都喜欢在自定义数据集里面完成 tokenizer,但我把这个操作留到了 DataCollator 中。
- 如果在数据集中完成tokenizer,那么就需要在
DataCollator对input_ids和attention_mask进行手动填充。 - 如果在
DataCollator完成 tokenizer,便无需再对input_ids和attention_mask手动填充。tokenizer 会默认把这个batch的数据处理完成。只需要手动处理 label。
@dataclass
class DataCollatorForPretrainDataset(object):
    tokenizer: transformers.PreTrainedTokenizer

    def __call__(self, items: Sequence[Dict]) -> Dict[str, torch.Tensor]:

        prompt = [item for item in items]

        prompt_tokenizer = tokenizer(
            prompt,
            return_tensors="pt",
            padding="longest",
            max_length=tokenizer.model_max_length,
            truncation=True,
        )

        labels = prompt_tokenizer["input_ids"].clone()

        # 不对 pad 计算 loss
        pad_idx = labels.eq(tokenizer.pad_token_id)
        labels[pad_idx] = -100

        prompt_tokenizer["labels"] = labels
        return prompt_tokenizer
-
padding="longest"把数据填充到这个 batch中数据的最大长度;
data_collator = DataCollatorForPretrainDataset(tokenizer=tokenizer)
prompt_tokenizer = data_collator([dataset[0], dataset[1]])
prompt_tokenizer
最大长度是 tokenizer中模型是最大长度
大模型预训练的 label很简单,就是input_ids,做一个复制操作就行。
在进行模型训练之前,测试一下, DataCollatorForPretrainDataset 处理数据:
tokenizer.eos_token_id, tokenizer.pad_token_id,
输出:
(151643, 151665)
data_collator = DataCollatorForPretrainDataset(tokenizer=tokenizer)prompt_tokenizer = data_collator([dataset[0], dataset[1]])prompt_tokenizer
输出:
{'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
         1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
        [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
         1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]]),
'input_ids': tensor([[112720,  89012,  99459, 122157,  61443, 108462, 100045,   5122,  99459,
         122157,  99457,  99244,   3837,  36589,  99180, 115449,   8997, 100531,
          35727,  22418,  50509,   3837,  99577,  99884,  99907, 109564,   1773,
          99425, 120827, 103073, 103610,   3837,  99208,  79599, 100875,  99964,
           8997,  16530, 102683,  16530, 103020,   3837,  48738, 102744, 102635,
         100619,   1773, 151643],
        [112720,  89012, 113735, 106980,  61443, 108462, 100045,   5122, 102461,
          55135,  21287,  99465,  44729,   3837,  99718,  15946, 100066, 100167,
         105401,   1773, 100697, 100956,  99349,  77540,  99980,   3837, 114216,
          20412, 105686,  11319, 151643, 151665, 151665, 151665, 151665, 151665,
         151665, 151665, 151665, 151665, 151665, 151665, 151665, 151665, 151665,
         151665, 151665, 151665]]),
'labels': tensor([[112720,  89012,  99459, 122157,  61443, 108462, 100045,   5122,  99459,
         122157,  99457,  99244,   3837,  36589,  99180, 115449,   8997, 100531,
          35727,  22418,  50509,   3837,  99577,  99884,  99907, 109564,   1773,
          99425, 120827, 103073, 103610,   3837,  99208,  79599, 100875,  99964,
           8997,  16530, 102683,  16530, 103020,   3837,  48738, 102744, 102635,
         100619,   1773, 151643],
        [112720,  89012, 113735, 106980,  61443, 108462, 100045,   5122, 102461,
          55135,  21287,  99465,  44729,   3837,  99718,  15946, 100066, 100167,
         105401,   1773, 100697, 100956,  99349,  77540,  99980,   3837, 114216,
          20412, 105686,  11319, 151643,   -100,   -100,   -100,   -100,   -100,
           -100,   -100,   -100,   -100,   -100,   -100,   -100,   -100,   -100,
           -100,   -100,   -100]])}
151643 是文本结束符号,151665 是文本填充符号。
attention_mask 为1的代表有意义的文本,需要参与到向量嵌入计算中。attention_mask 为 0的一般都是填充的符号。
在 decode 模型中, labels 的shape乃至内容,一般都与input_ids 一样。-100代表该位置的值不参与 loss 计算。(众所周知 decode 模型与下一个词计算loss。labels 需要左移一位并在尾部填充-100,这个操作用户无需关心,此操作由transformers包根据数据集中的labels自动转换)
模型训练
args = TrainingArguments(
    output_dir=r"C:\Users\username\Desktop\train_model_output\Qwen2.5-0.5B\CLM_output",
    num_train_epochs=10,
    per_device_train_batch_size=2,
    save_safetensors=True,
    logging_strategy="epoch",
    # fp16=True,
)
utput_dir:模型的保存地址,我的C盘是固态硬盘,加载训练完成后的模型会快一点。
trainer = Trainer(
    model=model,
    processing_class=tokenizer,
    args=args,
    train_dataset=dataset,
    eval_dataset=None,
    data_collator=DataCollatorForSupervisedDataset(tokenizer=tokenizer),
)
参数量估算
我选择 Qwen/Qwen2.5-0.5B 这个模型,因为这个模型参数少,可以更快看到结果。
上述模型微调是全参数微调,没有使用LoRA,会导致显存占用很大。
下述是显存占用的粗略估算的过程:
-
全精度,fp32:
1B = 10^9个参数 = 10^9 x 4Byte = 4GB
由于我们是全参数微调,那么最终占用的显存是: (模型参数 x1 + 梯度 x1 + Adam优化器 x2)
0.5 x 4GB x (4) = 8GB8 GB + batch的中间变量内存
-
半精度, fp16
1B = 10^9个参数 = 10^9 x 2Byte = 2GB由于我们是全参数微调,那么最终占用的显存是: (模型参数 x1 + 梯度 x1 + Adam优化器 x2)
0.5 x 2GB x (4) = 4GB4 GB + batch的中间变量内存
模型推理
使用上述训练完成的模型,在训练集的数据上进行推理。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

device = "cuda:0"if torch.cuda.is_available() else"cpu"

train_model = r"C:\Users\1\Desktop\train_model_output\Qwen2.5-0.5B\CLM_output"

model = AutoModelForCausalLM.from_pretrained(train_model)
model = model.to(device)
tokenizer = AutoTokenizer.from_pretrained(train_model, padding_side="right")

def infer(text):
    input_ids = tokenizer(text, return_tensors="pt").to(model.device)

    generated_ids = model.generate(**input_ids)
    generated_ids = [
        output_ids[len(input_ids) :]
        for input_ids, output_ids in zip(input_ids.input_ids, generated_ids)
    ]

    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    return response
text = "请你给哪吒写一首诗:"
infer(text)
输出:
'哪吒降世,意气飞扬。\n逆天改命,破障冲霄。红绫缠腕,风火踏浪。\n不屈不悔,笑傲苍茫。'
通过模型的推理结果,验证了大模型的预训练是有效果的。
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
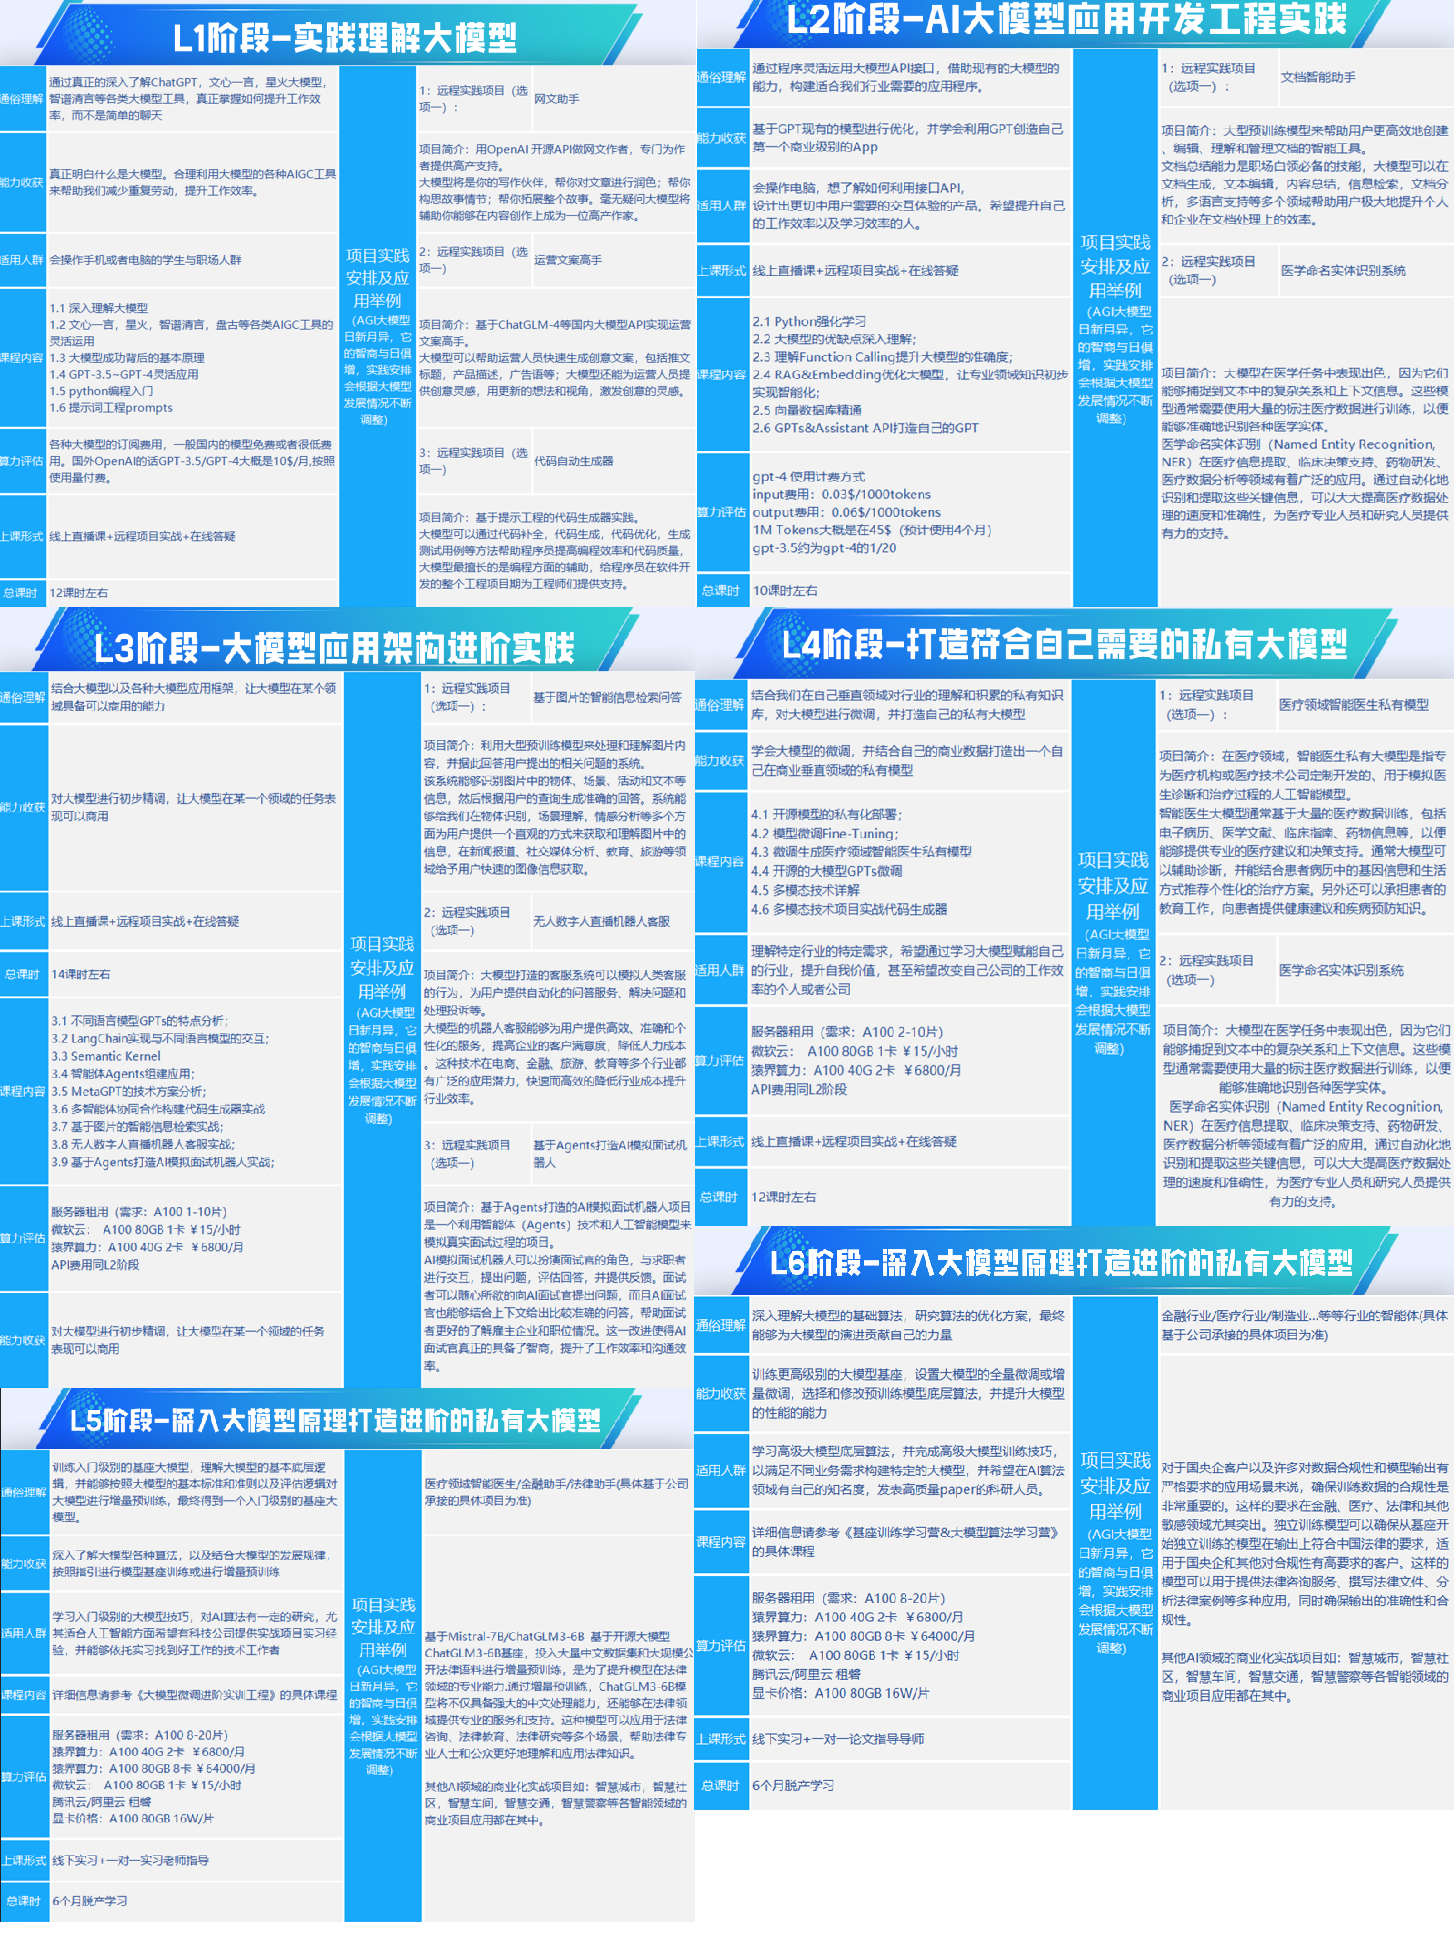
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 891


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


