微调一个自己的大模型(腾讯云cloud studio + llama factory)

微调大模型-1-云服务器使用 微调大模型第一步,如何使用云服务器 阅读详情
AI摘要

作者分享了使用腾讯云cloud studio和llama factory微调大模型的过程,包括选择服务器、框架,微调步骤等,还指出微调效果与显存、参数和数据集有关。此外,作者还分享了全套AGI大模型学习路线、640套AI大模型报告合集、AI大模型经典PDF籍和商业化落地方案等学习资料。

最近就是新项目和老项目一起支撑,老项目的人以为我还在支撑,然后新项目的人以为我不在支撑老项目了。

本来我还乐呵呵的两边一起支撑,后来领导突然问我怎么还在干老项目,让我把老项目的事情交给另一个同事去干。

感觉有点吃力不讨好之后,我直接完全不管老项目了,在我的签名上直接加上了老项目支撑=〉xx同事。

…

新项目这边之前干过一个星期,有点基础,上手也挺快。

这周当了两天测试,当了几天开发,解了一个问题单。

具体的话就是把转测的门槛用例测完了,开发了一个完整的新功能,然后定位了一个并发问题。

工作内容挺饱满,属于是又有输出了hhh

…

本来以为需要一段时间才能微调一个自己的大模型,结果上周下班后,花了几天时间,居然调好了一个

我这边选用的是腾讯云cloud studio + llama factory来调的。

首先我自己没有gpu环境,就只能搞个服务器来弄。恰巧腾讯云可以白嫖GPU服务器,所有就用它了,链接如下:

https://ide.cloud.tencent.com/dashboard/gpu-workspace

这个GPU服务器的内存是1.5G,不算大,但是既然我是白嫖怪,我就只能说腾讯大气

在这里插入图片描述

接着我找了个开源的微调框架llama factory,本来准备用ChatGLM的那个微调教程的,但是看了一下,前者好像用的人更多,也更通用,所以就选它了

我这边的话,微调并使用自己的大模型分为3部

  1. 微调开源大模型,保存参数
  2. 将模型输出成gguf格式保存
  3. 使用Ollama部署自己的大模型

第一步的话,因为我的显存只有1.5G,所以我选择微调Qwen2.5-0.5b的大模型,这个模型需要的显存大概估计如下:

参数0.5G、梯度0.5G、优化器0.3G左右,大概1.3G,所以我的服务器可以调起来。

最后调的时候我发现它实际占用只有700M左右,完全足够。

首先要自己整个huggingface的帐号,因为很多开源模型都是在这里下载的。注意,自己要在网站上生成一个token,然后在服务器登陆。

pip install --upgrade huggingface_hub
#   Linux
export HF_ENDPOINT=https://hf-mirror.com

huggingface-cli login

然后下载llama factory

git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
pip install -e ".[torch,metrics]"

微调大模型: 可以直接在已有的example上修改即可修改一下模型的名字,和自己微调数据集就好。

llamafactory-cli train examples/train_lora/llama3_lora_sft.yaml
llamafactory-cli chat examples/inference/llama3_lora_sft.yaml
llamafactory-cli export examples/merge_lora/llama3_lora_sft.yaml

我这里修改了模型名称为qwen2.5-0.5b, 然后参数类型把bf16改成了false。

在这里插入图片描述

在训练好后,模型参数就会保留下来。

在这里插入图片描述

接下来第二步就是根据模型参数,输出模型的gguf文件。

git clone https://github.com/ggerganov/llama.cpp

cd /root/autodl-tmp/llama.cpp

python convert_hf_to_gguf.py /workspace/LLaMA-Factory-main/models/llama3_lora_sft --outfile /workspace/tmp/qwen2.5-0.5b-sft.gguf --outtype q8_0

最后一步就是运行自己的模型。

在保存下来的模型文件位置新建一个配置文件test.mf

FROM ./qwen2.5-0.5b-sft.gguf

在这里插入图片描述

然后ollama创造一个model

ollama create myModel -f ./test.mf

最后运行模型 ollama run myModel,然后在enchanted里面与模型对话。

在这里插入图片描述

就成功部署好自己微调的大模型了

补充一下,最后我这个微调的大模型非常的垃圾,感觉还不如原来的0.5b hhhh。

微调大模型,感觉还是得大显存微调大参数模型,同时微调的数据集也要好。不然感觉微调了个寂寞。

职场菜鸟继续闯关ing

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

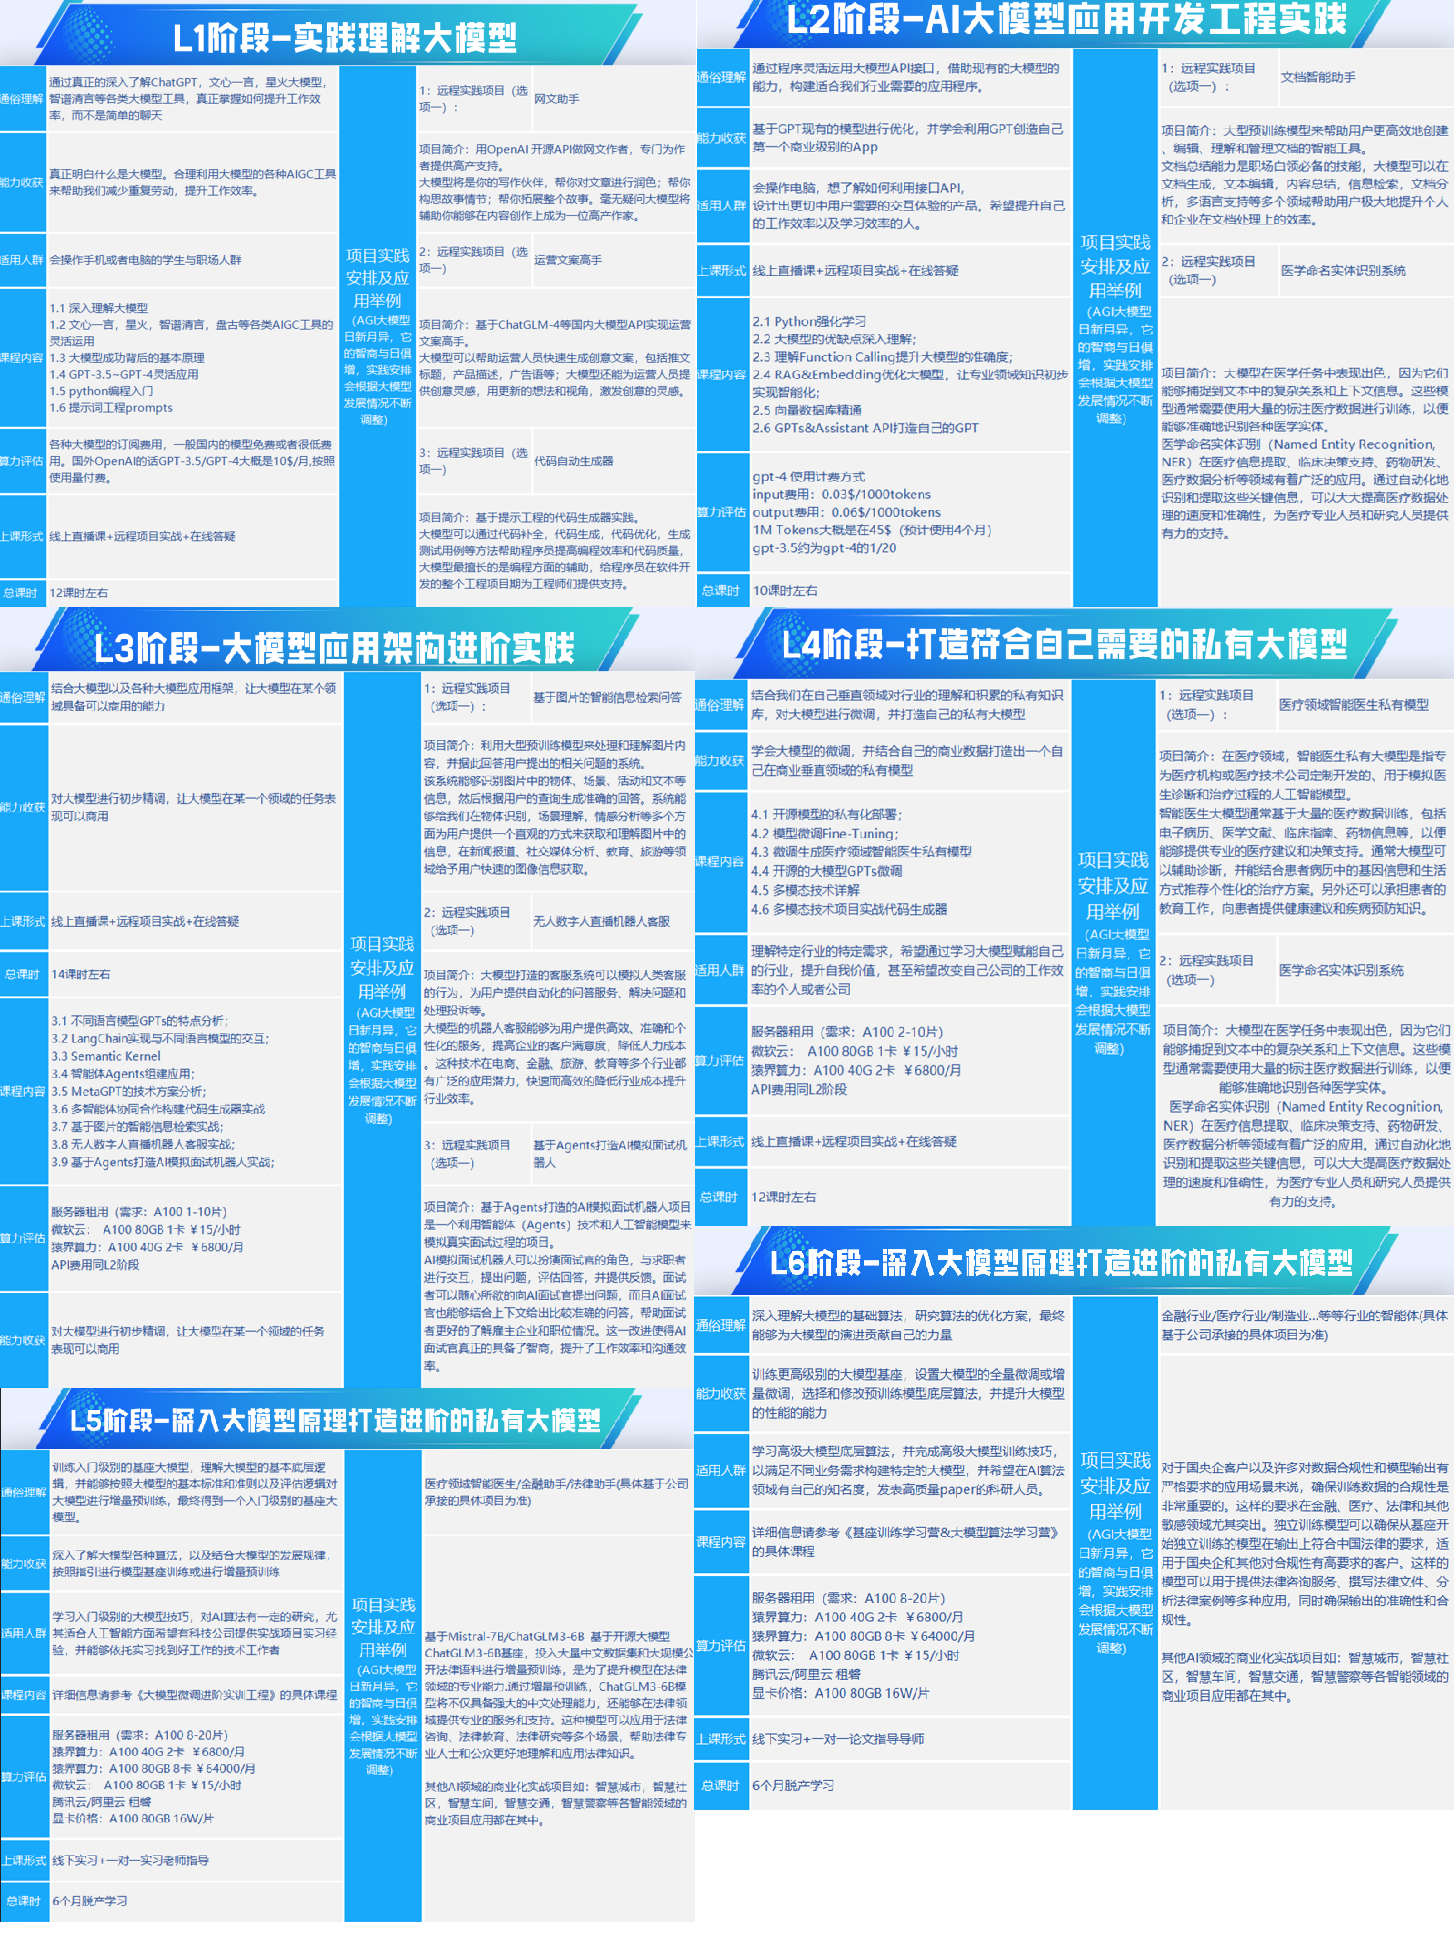
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

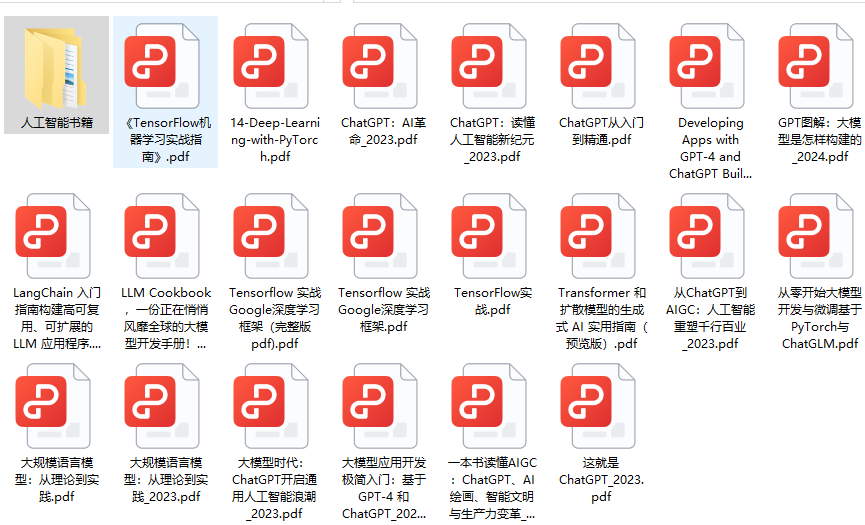
三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

代谢组数据分析(零):从质谱样本制备到MaxQuant搜库(蛋白质组和代谢组) 本文详细介绍了代谢组数据分析的过程,从LC-MS/MS技术的样本制备、分离、质谱鉴定到MaxQuant软件的使用。LC-MS/MS包括样本制备、液相色谱分离、质谱上机和鉴定等步骤。MaxQuant在蛋白质定性和定量中扮演关键角色,通过搜库和数据处理提供精准结果。此外,文章还涉及了数据采集模式、质谱图谱解析、数据库和软件选择以及结果评估等方面 阅读详情

相关推荐

化学科学催化反应产率预测之Transformer建模SMILES(Datawhale AI 夏令营)

循环神经网络:由于所有的前文信息都蕴含在一个隐向量中,随着序列长度的增加,早期的上下文信息会逐渐被遗忘。卷积神经网络:受限的上下文窗口在建模长文本时存在天然不足。需要多层卷积操作才能处理长文本。在本篇文章中,我们学习了Transformer的基本架构及其在化学反应产率预测中的应用。通过利用Transformer的Encoder部分对SMILES进行建模,我们能够更有效地捕捉序列数据的特征,从而提高模型的预测性能。

不想宅的冷同学 1096

如何通过腾讯云平台执行SFT微调大语言模型

RAG并不是万能的,也会带来额外的Token开销,如果希望将RAG里的知识内化为大语言模型的知识,或者希望对模型进行干预,比如希望llama模型回答自己是某某公司开发的而不是Meta公司开发的(哈哈,有点太绷面子了^-^),就要对既有的LLM进行微调。3. 进一步,选择LLama3 8B Instruct模型,选择按量计费,地域选择靠近客户的地域,如果没有可用GPU,可以换一个地域,选择GPU进阶型,点击立即购买,需要点时间来等待空间创建完成。我们都在Meta公司工作,开发着相似的技术。

m0_66899341的博客 1544

如何用Lmcache+vllm优化KVcache存储?CPU与SSD性能实测对比

本文通过实测对比,详细介绍了如何利用Lmcache+vLLM将大模型推理中的KV Cache卸载至CPU内存或SSD硬盘,以解决长上下文场景下的GPU显存瓶颈。测试数据显示,CPU卸载方案在首字延迟(TTFT)上显著优于SSD方案,但SSD方案在存储成本上更具优势。文章提供了完整的配置指南、性能数据分析和生产环境选型建议。

fire9的博客 991

【大模型微调】一文掌握7种大模型微调的方法

本篇文章深入分析了大型模型微调的基本理念和多样化技术,细致介绍了LoRA、适配器调整(Adapter Tuning)、前缀调整(Prefix Tuning)等多个微调方法。详细讨论了每一种策略的基本原则、主要优点以及适宜应用场景,使得读者可以依据特定的应用要求和计算资源限制,挑选最适合的微调方案。大型语言模型(LLM)的训练过程通常分为两大阶段:阶段一:预训练阶段在这个阶段,大型模型会在大规模的无标签数据集上接受训练,目标是使模型掌握语言的统计特征和基础知识。

python123456_的博客 5万+

Seafile搭建以及onlyoffice在线办公

部署seafile docker-compose.yml 如下: 参考此篇文章 version: '2.0' services: db: image: mariadb:10.1 container_name: seafile-mysql environment: - MYSQL_ROOT_PASSWORD=db_dev # mysql root的密码,同时修改 seafile的DB_ROOT_PASSWD与这个一致 - MYSQL_LOG_CONSOLE

dwdcth的专栏 4660

动手在 SAP BTP Cloud Foundry 开发和部署 SAP UI5 应用的前置条件 - 订阅 SAP Build Work Zone Standard Version

摘要:本文介绍了SAP BTP Cloud Foundry环境中HTML5应用的概念,区分了web应用、HTML5应用和SAP UI5应用的关系。重点说明了在Cloud Foundry环境部署HTML5应用的方法是通过订阅SAP Build Work Zone standard edition服务,并详细描述了订阅过程中可能遇到的"OIDC trust missing"错误。该错误是由于业务用户认证需要配置SAP Cloud Identity Services的OpenID Connec

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 314

每月免费使用10000分钟GPU:Cloud Studio在云端搭建大模型

随着大模型的普及,越来越多的开发者来学习大模型。提供了一个强大的平台,支持快速创建 GPU 加速的开发环境,尤其适合进行深度学习和 AI 相关的任务。本篇文章将为你详细介绍如何通过在云端创建一台 GPU 服务器,并通过运行机器学习模型,最终通过 Web 端进行访问。

jast 5706

【科研数据获取】根据Excel表个中的企业/公司信息批量获取经纬度坐标,并进行地图可视化

批量获取企业/公司的经纬度坐标,并进行地图可视化1 需求2 实现途径3 需求逐步实现 1 需求 在做项目的时候,老板或者项目答辩时候甲方最喜欢看到的就是可视化结果,尤其是涉及到地图可视化。很多时候会遇到企业/公司的数据,想要做地图可视化,必不可少的就是要获取它们具体地址:第一种就是像查户口一样精准一下具体的城镇街道,还有一种就是经纬度信息,前一种属于文字内容往往用于管理方面,第二种数字信息多用于数据处理与分析。 2 实现途径 获取地理信息数据,自然需要使用到地图的功能,这里直接采用百度地图的拾取坐标系统,

lys_828的博客 2337

LLM(lora + llamafactory + llama.cpp + 腾讯cloud studio + 魔塔modelscope)微调大模型完整流程(二)

注意:这里需要服务器开启 7860 端口。

哇哈哈的博客 603

6、高通8155座舱平台--摄像头系统

在项目中遇到过,很多从手机转过来的工程师,上来就按手机那套调Camera,结果发现根本跑不通——为什么?我踩过这个坑——一开始想靠软件打时间戳来对齐,结果发现两个sensor的曝光时间不一样,时间戳根本对不上。我记得第一次调AWB时,怎么调颜色都不对,后来发现是BLC的参数没配好——黑电平偏了,后面所有颜色校正都是错的。上层应用说「我要拍张照」,HAL把它翻译成「ISP你给我处理这帧数据,sensor你给我曝光一次」。8155上推荐用camx,它是高通新一代的Camera框架,性能更好,而且支持多路同步。

woailuojp的博客 59

YOLOv8【第一章:基础入门篇·第2节】一文搞定,数据集制作与标注完全指南!

🏆 本文收录于 《YOLOv8实战:从入门到深度优化》 专栏,该专栏专注于分享我在YOLOv8目标检测模型中的实战经验,涵盖从入门基础到深度优化的全方位解决方案。无论你是计算机视觉的新手,还是具有多年深度学习经验的专家,本专栏都将为你提供高效、可复现的技术方案,助你掌握YOLOv8的核心技术,提升目标检测性能,突破瓶颈,优化模型,并加速项目开发🚀!

**My Coding Family** 1510

chatglm菜鸟级启动及微调教程--使用LLaMA-Factory进行微调

记录一下打开已经配置好的chatglm的流程,以免以后忘了

qq_52234528的博客 805

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

训练专属于你的模型,使用LLaMA-Factory对LLM大模型进行微调!(附教程)

训练专属于你的模型,使用LLaMA-Factory对LLM大模型进行微调!(附教程)

2301_81888214的博客 603

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

【实战教程】如何在云GPU上快速部署 LLaMA-Factory?保姆级指南来了!

【实战教程】如何在云GPU上快速部署 LLaMA-Factory?保姆级指南来了!

Y525698136的博客 529

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

腾讯云TI平台的大模型精调解决方案

随着人工智能和大数据技术的快速发展,大模型在各行各业的应用日益广泛。然而,大规模模型的训练和部署面临着诸多挑战,包括训练资源的高效利用、模型训练的稳定性和国产化适配需求。腾讯云TI平台凭借其强大的技术底座和自主研发的模型加速框架,提供了一站式的大模型精调解决方案,帮助企业应对这些挑战,提升业务效率和竞争力。

超级英雄吉姆的博客 1452

大模型微调与RAG检索增强有何区别?从基础原理到案例分析全面详解

大模型微调(Fine-Tuning)和检索增强生成(RAG,Retrieval-Augmented Generation)是两种在模型应用中常见的技术。它们分别通过不同的方式提升模型在特定任务上的性能。大模型微调通过对已有的预训练模型进行再训练,使其更好地适应特定的应用场景;而RAG则通过引入外部的知识源,通过检索和生成相结合的方式,提高模型的回答质量和准确性。

DEVELOPERAA的博客 1190

零成本玩转国产大模型!腾讯云Cloud Studio + DeepSeek-R1:10000分钟免费算力实操全指南

通过腾讯云Cloud Studio与DeepSeek-R1的组合,开发者无需担忧硬件采购、环境配置与算力成本,即可快速验证AI创意。无论是构建智能客服、代码助手,还是垂直领域知识引擎,这套方案都提供了从实验到生产的完整路径。立即行动,用每月10000分钟的免费额度,不用时记得要关一下机。开启你的大模型之旅!

理论都是虚的,代码才是王道。 2615

白嫖腾讯云 Cloud Studio 免费算力,每月免费 1w 分钟,可部署大模型应用

腾讯云 cloud studio 提供了免费的算力可以在上面搭建属于自己的模型应用,目前注册账号每月享有 1w 分钟的免费额度

3535

微调大模型实操教程:0 基础小白也能从 0 到 1 用云算力开发一个Ai甄嬛

入门最好的方式是实操,这篇文章一共耗时 7 个小时,用大白话和实操的角度给大家分享一下, 0 基础入门微调大模型 今天阿里开源了 QwQ-32B 推理模型,320 亿参数和 DeepSeek 6710亿参数几乎相同的效果,部署成本和微调成本越来越低,所以,在做应用开发的同时,掌握微调的技能也很重要。这个文章,用大白话,面向...

qq_35485206的博客 821

中文版开源Llama 2同时有了语言、多模态大模型,完全可商用

可以说,AI 初创公司 LinkSoul.Al 的这些开源项目让海外开源大模型在国内的普及和推广速度与国际几乎保持了一致。来源丨机器之心7 月 19 日,Meta 终于发布了免费可商用版本 Llama 2,让开源大模型领域的格局发生了巨大变化。Llama 2 模型系列包含 70 亿、130 亿和 700 亿三种参数变体,相比上一代的训练数据增加了 40%,在包括推理、编码、精通性和知识测试等许多外...

idol24的博客 594

在Visual Studio Code中微调模型

上期我们介绍了在Visual Studio Code中通过VS Code AI Toolkit使用Phi-3模型,今天我们接着聊聊如何继续通过AI Toolkit在Visual Studio Code中微调模型。

Hsiao的二进制生活 1246

云计算与大模型训练的结合,非常详细收藏我这一篇就够了

我们要学会使用第三方的大模型平台,而不是什么都从0开始大模型从出现以来,其巨大的成本问题一直都是压在很多企业头上的一座山;但大模型作为一项基础设施,理论上应该和现有的基础设施相结合,比如说云计算平台。根据云计算的思想,除了实现快速部署迁移以及庞大的网络洪峰之外;其次最重要的一点就是提升资源的利用率;比如对很多公司来说,流量洪峰主要都集中在某些时间段,大部分时间的流量都比较平稳。因此,如果按照最高峰值部署服务器,那么就会造成巨大的浪费;因此,云计算的用武之地就出现了;

2401_85343303的博客 3230

基于 Llama factory 微调 Llama3.1-70B-Chinese-Chat

​ 本文通过单机多卡和多机多卡的情况下,完成基于Llama factory使用LoRA(Low-Rank Adaptation)技术对Llama3.1-70B-Chinese-Chat模型进行微调的过程。总体的推理效果不错。对于多机多卡下,训练速度慢的问题还有待改善。

qkh1234567的博客 1080

只需四步,完成基于Llama-factory的模型微调过程,大模型入门到精通,收藏这篇就足够了!

Llama-factory是一种常用的模型微调框架,之前一直知道有这样一款产品,但是没有尝试过。本文记录了本地基于Llama-factory的模型微调过程,方便后续进行复盘。

2401_82469710的博客 1161

腾讯云推出物理AI平台—格物(XPhysis),让AI从理解世界走向改变世界

2026 腾讯全球数字生态大会大数据专场在深圳举行。腾讯云大数据基础产品总经理程彬在会上推出面向 Physical AI 场景的物理 AI 平台——格物(XPhysis):腾讯云把过去一年服务数十家具身与智驾客户的工程实践,沉淀为多模态 AI 数据湖 TCLake,并进一步推出覆盖物理 AI 工程全链路的 TCLake 格物(XPhysis)平台,致力于"让 AI 从理解世界走向改变世界"。

cloudbigdata的博客 160

GPU 平台哪家服务更好?智星云、阿里云、腾讯云,从开机前比到项目结束

如果是个人或小团队,主要做短期训练、AI 内容制作和模型验证,:缺货时可以提前配置并预约,遇到问题有 7×24 小时工单,结束实例前也能明确选择是否保留磁盘。已有企业运维体系、需要提前收到维护通知的团队,可以重点比较;已有腾讯云 CVM 环境、希望沿用现有监控和故障处理流程,则可以优先看。三家的服务侧重点不同。客服回复得快、技术人员能定位故障、平台能及时提供替代资源,是三件不同的事。比较时,最好看:缺货时能否安排资源,任务变慢时能否缩小排查范围,项目结束时能否保住数据并停掉不需要的费用。

weixin_38978741的博客 209
上一篇: 如何入门大模型?大模型技术学习路线过程梳理
下一篇: docker-compose本地部署FastGPT与简单使用
少喝冰美式
博客等级 码龄3年 6852粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值