搭建FastGPT本地知识库问答系统踩过的坑

玩转大模型之三(FastGPT+OneAPI本地部署) 后续课程我会给大家介绍如何搭建本地化模型,因为上面的课程里面咱们还是使用的大厂的模型,虽然个人测试不需要收费,但是用的人多了,还是会把token额度耗尽,有条件的话,最好搭建开源的本地化模型,这样无论怎么用都不受限制了。到此为止,咱们就完成了基本的大模型和知识库结合的应用,是不是很简单,大家可以准备一台cpu虚拟机,按照我介绍的步骤,来体验一下大模型的魅力吧。到了这一步,基本就完成了底层模型的配置了,但是目前只是把知识库搭建好了,还需要创建应用,只有应用才能集成到其他系统当中使用。 阅读详情
AI摘要

本文分享利用FastGPT搭建本地知识库问答系统的经验,包括部署中遇到的docker-compose版本低、参数设置错误等问题及解决办法。还介绍大模型AI学习路径,分初阶应用、高阶应用、模型训练、商业闭环四个阶段,并提供免费学习资料。

如今部署一套基于LLM大语言模型的私有知识库问答系统已经比较普遍,而且在企业内部也有很强的应用需求。网上这方面的开源系统比较多,在经过多方调研和对比后,我选择了FastGPT来搭建本地的知识库问答系统。尽管官方也提供了安装指南,但是在实际部署过程中,就会发现有些细节之处安装指南里并没有说清楚,网上也不容易查找到,还需要自己去摸索求证。

今天给大家分享一下利用FastGPT搭建知识库问答系统过程中碰到的一些坑,希望能够帮助更多的人避开这些坑,顺利构建自己的私有知识库系统。在部署前,请先阅读官方文档(https://doc.fastgpt.in)。

对于手头没有服务器资源又不熟悉Linux操作命令的同学,如果想省心的话,可以直接利用FastGPT的云服务(https://cloud.fastgpt.in),在上面注册一个账号,然后就可以开箱使用了。平台提供了一定免费额度的token,这对于我们想调研和体验FastGPT功能的人来说,非常友好。

我采用的是Docker Compose 快速部署方式,安装步骤可以参考:https://doc.fastgpt.in/docs/development/docker/,考虑到今后要用于生产环境,因此选择了Milvus版本,服务器的配置是4C16G,CentOS7。

由于服务器上已经安装了docker和docker-compose。我碰到的第一个坑来了:docker-compose的版本过低,在启动容器的时候失败了。官方文档里写明了:**请确保docker-compose版本最好在2.17以上,否则可能无法执行自动化命令。**在确认是因为服务器上docker-compose版本低(1.5版本)引起的问题后,只能卸载旧的版本,再重新安装新的版本(安装命令可以参考官方文档)。

由于FastGPT 默认只配置了 GPT 的模型,我希望接入的是智谱清言、通义千问等国产大模型(需提前在这些国产大模型****中生成API key),因此需要通过One API进行一些额外配置。配置的参考指南地址是:

https://doc.fastgpt.in/docs/development/one-api/

依次在One API中添加了渠道(渠道里会定义接入某个厂商的哪些模型,注意不能漏了embedding向量模型)和令牌后,需要修改FastGPT中环境变量docker-compose.yml文件中的OPENAI_BASE_URL和CHAT_API_KEY。我碰到的第二个坑来了。在docker-compose.yml中,由于One API与FastGPT都是部署在同一台服务器上,因此OPENAI_BASE_URL的参数设置,我习惯性的写成了下面这种形式:

http://localhost:3001/v1(或者http://127.0.0.1:3001/v1)

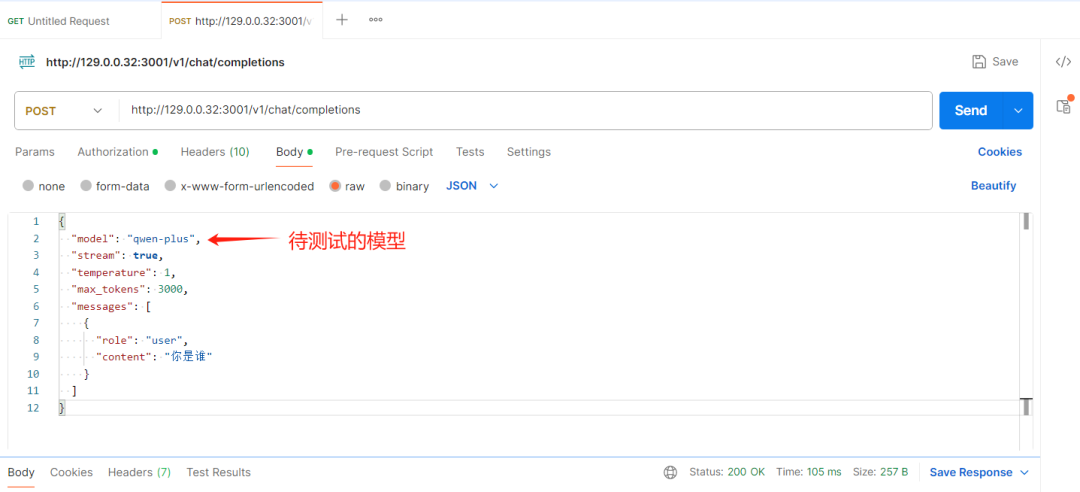
结果导致我在后面的FastGPT中上传本地文档到知识库里的时候,一直处于“索引中”的状态(这与我先前在cloud.fastgpt.in体验到的很快就完成索引的效果完全不一样)。为了排查问题,我用postman来检测接口是否正常工作。

postman中填写的URL地址形式如下:

http://服务器IP地址:3001/v1/chat/completions(注意是POST请求)

在headers部分,注意设置Content-Type是application/json,Authorization填入One API的令牌中生成的API KEY.

图片

在body部分填入JSON格式的数据,其中model是在One API中添加渠道时定义的模型名称。如下图所示。
图片

当点击Send后,看到返回的Status是200,说明One API的接口是正常的,因此我就开始怀疑OPENAI_BASE_URL是不是填错了?当我尝试将localhost换成了服务器的实际IP地址后,发现在FastGPT中上传的文档终于可以顺利的完成索引了!!!

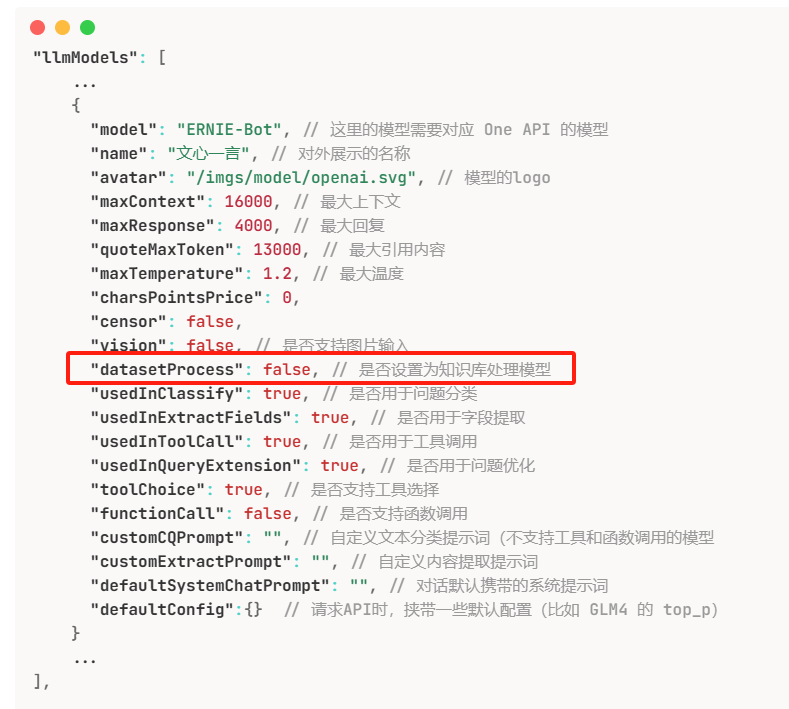
在官方文档中,接入其他模型是给文心一言的修改示例,这里又碰到了第三个坑,我在FastGPT 配置文件config.json中直接将官方示例拷贝进去,然后逐一按照我需要接入的智谱清言、通义千问的模型,逐一修改对话模型配置和向量模型配置。其中对话模型配置主要涉及以下几项:

model、name、avatar、maxContext

其中model值要与One API的渠道里显示的model名称保持一致。maxContext是模型的最大上下文长度,需要到该模型厂商的官网上查询。avatar是模型的LOGO,经过一番查找后,终于发现模型的LOGO原来在这里有定义(官方文档编写有点乱):

https://doc.fastgpt.in/docs/development/configuration/

以下是常见国产模型的LOGO图路径:

/imgs/model/baichuan.svg - 百川

/imgs/model/chatglm.svg - 智谱

/imgs/model/calude.svg - calude

/imgs/model/ernie.svg - 文心一言

/imgs/model/moonshot.svg - 月之暗面

/imgs/model/openai.svg - OpenAI GPT

/imgs/model/qwen.svg - 通义千问

/imgs/model/yi.svg - 零一万物

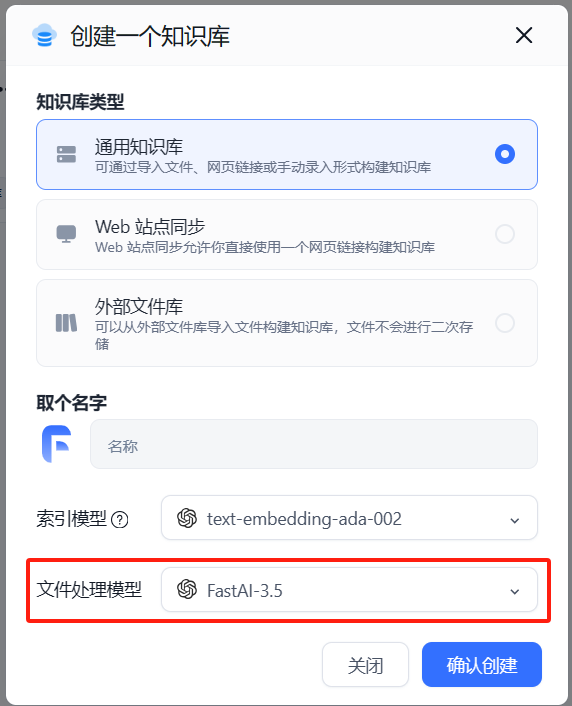
配置完config.json后,重启FastGPT,结果创建知识库时,在文件处理模型下拉框中仍然没有找到我所添加的模型名称,如下图所示:
图片

内心又开始凌乱了,无奈之下,只能继续排查我刚才添加模型的参数设置,最后终于发现官方文档中的示例有一处有错误,datasetProcess应该设置为true。此外,需要注意的是官方示例里为了便于大家了解各个参数的用途,因此做了大量的中文注释,在实际添加到config.json配置文件中时,这些中文注释都需要删掉,否则也会导致错误。
图片

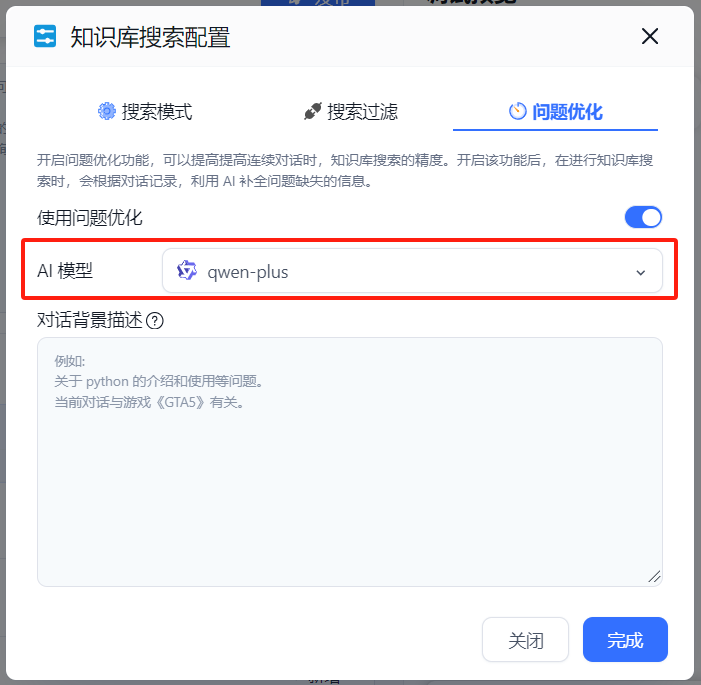
在修改了上述配置错误并且重启后,终于可以在FastGPT中顺利的创建知识库了。第四个坑又来了,在运行基于此知识库的对话应用时,系统又报错了:

undefined 当前分组 default 下对于模型 gpt-3.5-turbo 无可用渠道 (request id: 2024060603301542728313599790209)

很纳闷,我都已经改成国产大模型了,怎么还会出现gpt-3.5-turbo呢?最后,终于在知识库搜索配置的“问题优化”里找到了错误原因,在这个页面里系统默认的AI模型仍然是gpt-3.5-turbo,需要改成我们希望接入的国产大模型,如下图所示。
图片

至此,总算把整个知识库问答系统成功运行起来了。尽管细节上还有一些地方需要继续优化,但是从实际使用效果来看,还是令人比较满意的。
图片

对于希望接入Azure OpenAI接口的人来说,接入One API会更加麻烦,因为One API对Azure OpenAI的支持很不友好,对于模型名称等要求非常严苛,必须要严格一致。我尝试着配置了一下,发现还需要修改在Azure中的OpenAI配置,索性就直接放弃了。若没有特殊需求,建议还是用国产大模型,毕竟在中文领域国产大模型的表现还是非常不错的。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
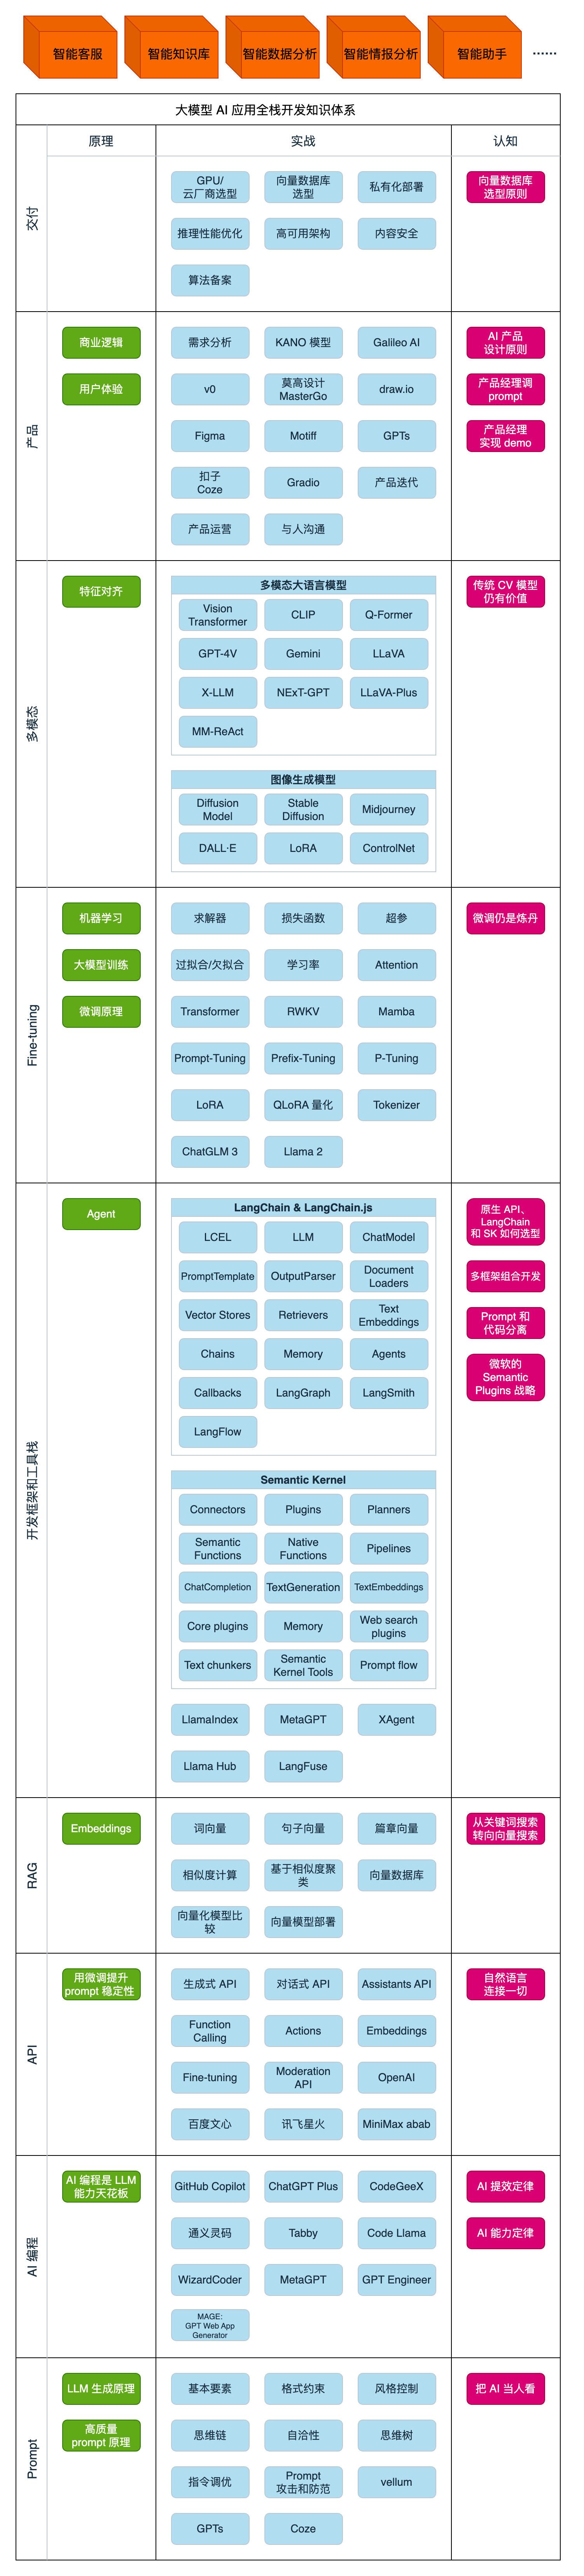
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
ollama + fastgpt 搭建免费本地知识库 基于 LLM 大语言模型的知识库问答系统。 阅读详情

相关推荐

AI时代,我用FastGPT低成本搭建了企业知识库问答系统

在当今信息过载的环境下,企业面临着知识资产流失、关键信息获取困难、新员工培训难度大以及资源重复浪费等问题。为解决这些问题,企业知识库是一个理想的解决方案。

sunsky89757的博客 4736

记录大模型应用开发过程中遇到的问题

undefined 当前分组 default 下对于模型 gpt-3.5-turbo 无可用渠道 (request id: 2024100809061365160529568802677)ollama默认会开启CPU+GPU混合运行的方式来运行模型,不需要特别配置,前提是电脑上配置了显卡驱动、CUAD、cuDNN。

爱吃雪糕的小布丁的博客 3572

自己动手,丰衣足食!用 Ollama + DeepSeek + FastGPT 搭建本地知识库,开启智能办公新体验

用 Ollama + DeepSeek + FastGPT 搭建本地知识库,轻松打造专属智能助手,还能保护隐私。按教程一步步来,小白也能搞定!

Happiness is everywhere 1482

如何部署GPT-4 Turbo和GPT-3.5-Turbo-1106模型

GPT-4 Turbo 的输入 token 性价比是 GPT-4 的 3 倍,输出 token 性价比是 GPT-4 的 2 倍,同时提供超过原来 GPT-4 模型 15 倍的上下文窗口。# 项目详细信息(1)“订阅”选择默认即可。(2)初次创建Azure OpenAI,需要在“项目详细信息”中点击“资源组”中的“创建”来创建资源组,名称可以自己设定。点击对应Azure OpenAI资源的“名称”,进入Azure OpenAI资源控制台,点击“单击此处查看终结点”或“单击此处管理密钥”查看终结点和密钥。

m0_71858447的博客 3621

Fastgpt本地或服务器私有化部署常见问题

Fastgpt本地或服务器私有部署常见问题遇到问题和排查解决办法

洛阳泰山的博客 2235

FastGPT 报错:undefined 该令牌无权使用模型:gpt-3.5-turbo (request id: xxx)

调整 FastGPT 前端工作流页面 AI对话 组件中 AI 模型的选择,默认选择的是 gpt-3.5-turbo,如果选择了 知识库搜索 组件,也需要修改其对应的模型,修改:知识库搜索组件->搜索参数设置->问题优化-> AI模型。进行对话时 FastGPT 报错如下所示。

Muti-Agent 3216

搭建FastGPT本地知识库问答系统踩过的坑:Docker Compose配置与TaoToken接入排错实录

FastGPT本地知识库问答系统部署常卡在Docker Compose配置,本文提供可复制的docker-compose.yml与config.json骨架,并详解TaoToken统一Key接入步骤。重点排查OPENAI_BASE_URL误写localhost、embedding模型缺失、问题优化模型无渠道等报错,附curl验证与索引状态检查,助你快速跑通私有问答链路。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_36311421的博客 191

dify智能体:日志管理与标注功能详解

日志管理与标注功能是优化聊天助手、Agent、文本生成应用、Chatflow 和工作流等工具交互体验的关键。日志管理允许用户查看、修改和标注日志,帮助回顾和优化交互内容。用户可以通过点击👍或👎按钮快速标注满意度,标注后的日志可用于后续优化和分析。标注功能则支持用户对交互内容进行标记和调整,以提升模型输出质量。此外,用户还可以调整界面语言和时区设置,确保在熟悉的环境中操作。这些功能共同作用,显著提升了交互体验和模型性能。

zyx_bx的博客 2710

基于FastGPT搭建知识库问答系统

FastGPT 是基于 LLM 大模型的 AI 知识库构建平台。

wbsu2004的博客 1万+

使用.NET 免费开源包ViewFaceCore做一个人脸识别并注册的功能,没有比我更全的

本文介绍了一个基于WinForm的免费人脸识别系统实现方案。系统使用AForge和ViewFaceCore库,支持从USB或电脑自带摄像头采集图像,具备人脸注册和快速识别功能。硬件方面仅需普通摄像头,软件依赖多个NuGet包(如AForge.Video、ViewFaceCore等)。界面包含视频显示、图像预览和功能按钮控件,后台采用SQLServer存储用户面部特征数据。核心代码展示了人脸检测、特征提取和多线程处理逻辑,通过ViewFaceCore实现高效识别。系统具有识别速度快、准确率高的特点,适合Win

一个靠“吃代码”长大的程序猿,专治各种“Bug 饥饿症”。 816

手把手教你搭建离线语音助手:FunASR+DeepSeek+TTS保姆级教程

本文详细介绍了如何利用FunASR、DeepSeek和TTS技术搭建离线语音助手系统。从环境配置、模型部署到唤醒词检测优化、语音识别与语义理解联调,再到语音合成与系统集成,提供全链路实战教程。特别适合智能家居控制、企业内部知识问答等需要数据隔离的场景,实现高响应、低延迟的离线语音交互体验。

weixin_30316097的博客 475

Windows系统本地部署FastGPT,通过oneapi接入deepseek模型,实现本地知识库问答系统

下载AMD64版本安装完以后需要重启一下电脑,启动Docker Desktop,无需登录(登录需要翻墙),直接进去。

weixin_62970360的博客 6242

3DE重客户端安装

3DE重客户端安装

m0_48170265的博客 9411

人人都可以创建个人知识库 | 从0到1,手把手教你基于 FastGPT 搭建本地私有化知识库!

当今环境,所有人都面临一个问题:信息过载。不知道你是否曾经遇到过以下困扰?在海量数据中搜索时,是否难以迅速找到所需的信息?在面对日益增长的专业知识,是否感到知识管理的需求愈发迫切?对于敏感数据的存储,是否时常害怕一不小心就会泄露关键信息?在日常工作中,是否因为工作效率不高而觉得时间不够用?如果这些场景让你感同身受,那么你一定在思考:是否存在一种方案,能够一举解决这些棘手的问题?

m0_70486148的博客 3970

【技能】OpenClaw Memory 与 MemOS 两种 AI 记忆方案深度解析

摘要:本文对比了两种AI记忆系统方案。OpenClaw Memory是轻量级记忆助手,内置SQLite存储,支持语义搜索,部署简单成本低,适合日常对话记忆需求。MemOS是自学习系统,通过Neo4j和Qdrant实现技能自进化,但需部署4套服务,门槛高成本大。建议普通用户选择OpenClaw Memory,技术玩家可逐步尝试MemOS。两种方案各具优势,需根据实际需求选择。

海兰 191

手把手教你学simulink(16.2)--基于Simulink的高通滤波器(High-Pass Filter)项目

基于Simulink的高通滤波器(High-Pass Filter)项目的详细实例介绍。这个项目将重点放在高通滤波器的设计、实现和仿真上,帮助你理解和应用高通滤波器在信号处理中的作用。

MHD0815的博客 926

Ollama + FastGPT搭建本地私有企业级AI知识库 (Linux)

首先我们分析下搭建本地企业级AI知识库的核心要点:1.数据安全性:本地部署可以更好地保护企业敏感数据,避免数据泄露的风险。2.定制化:根据企业特定需求进行定制,提供更精准的解决方案和服务。3.实时访问:本地知识库能够快速响应企业内部的查询需求,提高工作效率。4.合规性:更容易符合行业监管和合规要求,确保数据管理和使用符合相关法律法规。5.知识积累:集中管理和存储企业知识,促进知识共享与传承,提高整体团队的知识水平。6.成本控制:减少对外部云服务的依赖,降低长期运营成本。

l_789rty的博客 2429

Mac安装Typescript报错

根本原因是系统级目录的权限限制。推荐通过修改目录权限或使用nvm彻底解决问题。

江拥羡橙的博客 210

【大模型实战】使用Ollama和FastGPT搭建本地私有化AI问答系统!

文章详解如何使用Ollama和FastGPT搭建本地私有化AI问答系统。通过Ollama在本地运行开源大模型,结合FastGPT构建知识库问答系统,实现企业内部文档的智能问答。文章涵盖环境准备、模型部署、系统配置和知识库创建等步骤,帮助开发者快速搭建自己的私有化AI系统,提升工作效率,为职业发展增添竞争力。

2401_84495872的博客 1914

【AI智能体】Hermes Agent 从部署到项目实战操作详解

Hermes Agent 桌面版从安装到实战操作详解

congge 5129

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

FastGPT:给 GPT 插上知识库的翅膀!0基础搭建本地私有知识库,有手就行

本篇带领大家采用FastGPT,搭建一个基于本地知识库检索的问答系统。

u010522887的专栏 4193

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

基于LLM大语言模型的知识库问答系统(FastGPT)

FastGPT是一个基于LLM大语言模型的知识库问答系统。

weixin_43156294的博客 2690

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

人人都可以创建个人知识库 从0到1,手把手教你基于 FastGPT 搭建本地私有化知识库!

当今环境,所有人都面临一个问题:信息过载。不知道你是否曾经遇到过以下困扰?在海量数据中搜索时,是否难以迅速找到所需的信息?在面对日益增长的专业知识,是否感到知识管理的需求愈发迫切?对于敏感数据的存储,是否时常害怕一不小心就会泄露关键信息?在日常工作中,是否因为工作效率不高而觉得时间不够用?如果这些场景让你感同身受,那么你一定在思考:是否存在一种方案,能够一举解决这些棘手的问题?

2401_85773741的博客 1770
上一篇: 操作教程丨MaxKB+Ollama:快速构建基于大语言模型的本地知识库问答系统
下一篇: # Ollama+LobeChat:在个人电脑上打造无限制、高颜值、免费的专属大模型助手!
少喝冰美式
博客等级 码龄3年 6828粉丝 517原创
评论 6
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值