如何入门大模型?大模型技术学习路线过程梳理

大模型学习篇(一):初识大模型 初识大模型,了解什么是语言模型,以及大模型和小模型的区别。 阅读详情

“ 学习是一个从围观到宏观,从宏观到微观的一个过程 ”

学习大模型技术也有几个月的时间了,之前的学习一直是东一榔头,西一棒槌,这学一点那学一点,虽然弄的乱七八糟,但对大模型技术也算有了一个初步的认识。

因此,今天就来整体梳理一下大模型技术的框架,争取从大模型所涉及的理论,技术,应用等多个方面对大模型进行梳理。

01

—

大模型技术梳理

这次梳理大模型不仅仅是大模型本身的技术,而是一个以大模型为核心的涉及到多个方面的理论,技术和应用实践,也可以说是对自己学习大模型技术的总结吧。

话不多表,下面开始进入正题。

首先,大家应该明白一件事,大模型技术是人工智能技术的一个分支,是目前主流的一个研究方向,但并不是唯一的方向。

图片

人工智能技术是一个通过某种技术手段人为的创建一个具有类人智能的系统(软件或硬件),而大模型技术是一种仿造人类学习进化的一种方式,使用深度学习(机器学习)算法模仿人类大脑神经元,来实现智能的一种方式,其主要载体是神经网络。

神经网络之所以得到发展的原因是因为,基于神经网络架构进行预训练之后,神经网络会产生一种无法解释的涌现能力,而这个涌现能力特别像是具有了智能一样。

神经网络模型架构

既然是模仿神经网络,那么就需要一种深度学习模型来模仿人类大脑神经系统,比如CNN(卷积神经网络),RNN(循环神经网络),以及目前主流的Transformer模型,还有LSTM,ResNet,GANs等。

神经网络的主要结构为一个输入层,一个输出层,以及隐藏层(一个或多个层组成),不同网络层之间使用全连接的方式进行连接,每一个圆都代表着一个神经元,如下图所示:

图片

在神经网络中,除了输入/输出层之外,每一个神经元都有其参数,神经网络的效果就是由这些参数值决定的。

神经网络模型通过一种叫正向传播,损失计算和反向传播的方式来调整神经网络模型中每个神经元的参数。

通过把大量的训练数据输入到神经网络中,让神经网络进行“学习”(不断的调整参数),来达到类智能的能力。

不同神经网络的架构和实现有所不同,但其核心点都是基于此模型实现的,对想学习神经网络的朋友来说,先学会基础的神经网络架构,然后再针对不同的神经网络模型进行深化是最好的选择。

目前的大模型主要采用的是预训练的方式来实现智能的,简单来说就是给神经网络模型一堆资料,让它自己学,自己看,自己总结;其中给答案的叫做监督学习,没答案的叫无监督学习。

然后根据不同的任务需求,又设计出用来解决不同类型任务的神经网络,比如分类任务,图片处理任务,自然语言处理任务等。

至于大模型技术细节方面的东西,就不详细描述了,感兴趣的可以自己学习,比如编码器,损失计算和反向传播怎么实现等。

再有,设计并训练一个完整可用的神经网络模型是一个复杂的工程,比如模型的设计,训练数据的收集与处理,损失函数与反向传播算法的设计,模型过拟合,欠拟合等问题。

图片

而且随着模型规模的增大,模型的训练难度成几何式增长,比如分布式训练,并行计算等问题;以及为了提升大模型的学习效率,节约成本而设计的强化学习,迁移学习等。

最后,为了使得大模型更像人,也为了实现真正的AGI(通用人工智能),现在多模态大模型大行其道,而多模态大模型技术比传统大模型的技术复杂度又上升了不止一个台阶。

基于知识库的向量检索——RAG

大模型技术虽然很强大,但其有几个明显的缺点,第一就是知识是有限制的,因为采用的是预训练方式,因此大模型的知识最多只能到训练开始的时间节点,之后产生的新的知识大模型无法获取。

其次,由于训练大模型的成本问题,导致很多企业无法承担大模型的训练成本,因此只能使用第三方的大模型,但第三方大模型没有在特定领域的数据上进行训练或微调,因此,其表现能力一般。

这时RAG就出现了,RAG中文是检索增强,是通过外挂知识库的方式,提问大模型之前先从向量数据库中查询数据,然后一起输入到大模型,这样大模型就相当于有了一个外部资料库,遇到不懂的问题就可以通过查资料的方式解决。

以目前的技术来说,RAG是大模型技术的一个重要节点,即是大模型能力范围的扩展,也是对大模型短板的补充。

图片

微调与提示词工程

我们一般使用的大模型都是预训练模型,也就是用某些数据集训练过的模型;但这些模型一般情况下只会在特定领域表现出色,但如果用来解决自己的实际问题可能就不太好用了。

这时怎么让预训练模型在其它任务中表现更好就是一个值得思考的问题,而这就是微调与提示词工程存在的意义。

微调

微调从技术手段上来说和模型训练没有区别,只不过微调是在相似任务的预训练模型的基础之上,通过少量的数据对模型参数进行调整,使得其能够更加适应当前任务的一种方式。由于其成本低,对资金和技术要求要比完全重新设计和训练一款模型要低的多。

因此,微调存在的意义是为了节约成本和降低门槛,如果资金充足的情况下,根据任务需求设计并训练一款模型是最好的选择,微调是退而求其次的一种方式。

图片

提示词工程

如果说微调是为了让大模型去适应特定的任务,那么提示词的作用就是怎么更好的使用一个大模型。

根据研究发现,对待同样的问题使用不同的提示词有时会得到完全不一样的效果,因此根据这一现象就提出了提示学习的方法,具体的可以看之前的问题——提示学习。

用人类来举例就是,假如有人问你吃饭了吗这种简单的问题,你可以下意识的回答,而且可以回答的很好;大模型也是如此,如果你问大模型很简单的问题,它也能回答的比较好。

但如果问到一些复杂的问题就需要更加准确的描述,比如说根据当前的就业环境,从经济,市场,贸易,国际局势等多个方面来分析一下产生当前情况的原因,以及后续的应对方法。

这种复杂的问题,不论是问人还是问大模型,你说的越准确,它回答的才能更好,这就是提示词存在的意义。

智能体Agent

在前面的描述中,神经网络架构讲的是怎么构建一个大模型,知识库是怎么补充和强化大模型,微调和提示词是怎么更好的使用大模型,那么智能体就是真正的使用大模型,研究大模型的具体应用。

如果把大模型比做人类的大脑,那么智能体就是大模型的手和脚。

在此之前使用大模型,我们能够让它回答问题,写文章,生成图片和视频,但这都是大模型天生具备的能力,就类似于人类可以写写画画一样。

但如果让大模型完成更加复杂的任务,这时就需要借助外部工具,比如外出旅行需要设计旅行路线,定酒店和车票等。

这种任务就完全超出大模型或者人类本身的能力圈,如果想完成这些任务就需要借助外部工具,比如说手机APP。

智能体就是大模型+外部工具实现的一种能够独自分析和解决复杂任务的一种载体,利用大模型的独立规划能力,让它根据自己的判断去调用外部工具完成任务。

图片

使用的技术主要有function call,langchain等;如上图所示,大模型使用function call的方式调用外部工具,使用自身能力完成规划和行动,并且由于大模型没有足够的记忆能力,需要增加记忆模块来记录对复杂任务的分析过程。

目前,大模型解决复杂任务,主要通过思维链(CoT)的方式来实现对复杂问题的分解。

langchain是一种人工智能开发框架,它封装了大部分调用大模型的细节,以及其它辅助功能,比如文档的加载,多个大模型的链式调用,提示词模板的封装等,与其类似的还有LlamaIndex等。

总结

从大的方向上来说,大模型从技术到应用,主要涉及到以上几个大的模块;而每个模块又涉及到大量的技术和细节。比如打造不同任务的神经网络模型,强化学习,迁移学习,知识蒸馏,分布式训练与存储等;以及RAG使用的向量检索,向量数据库,语义理解等,还有复杂任务的思维链(CoT),模型训练使用的LoRa等微调方法。

还有多模态模型中的知识对齐,数据融合等复杂技术。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
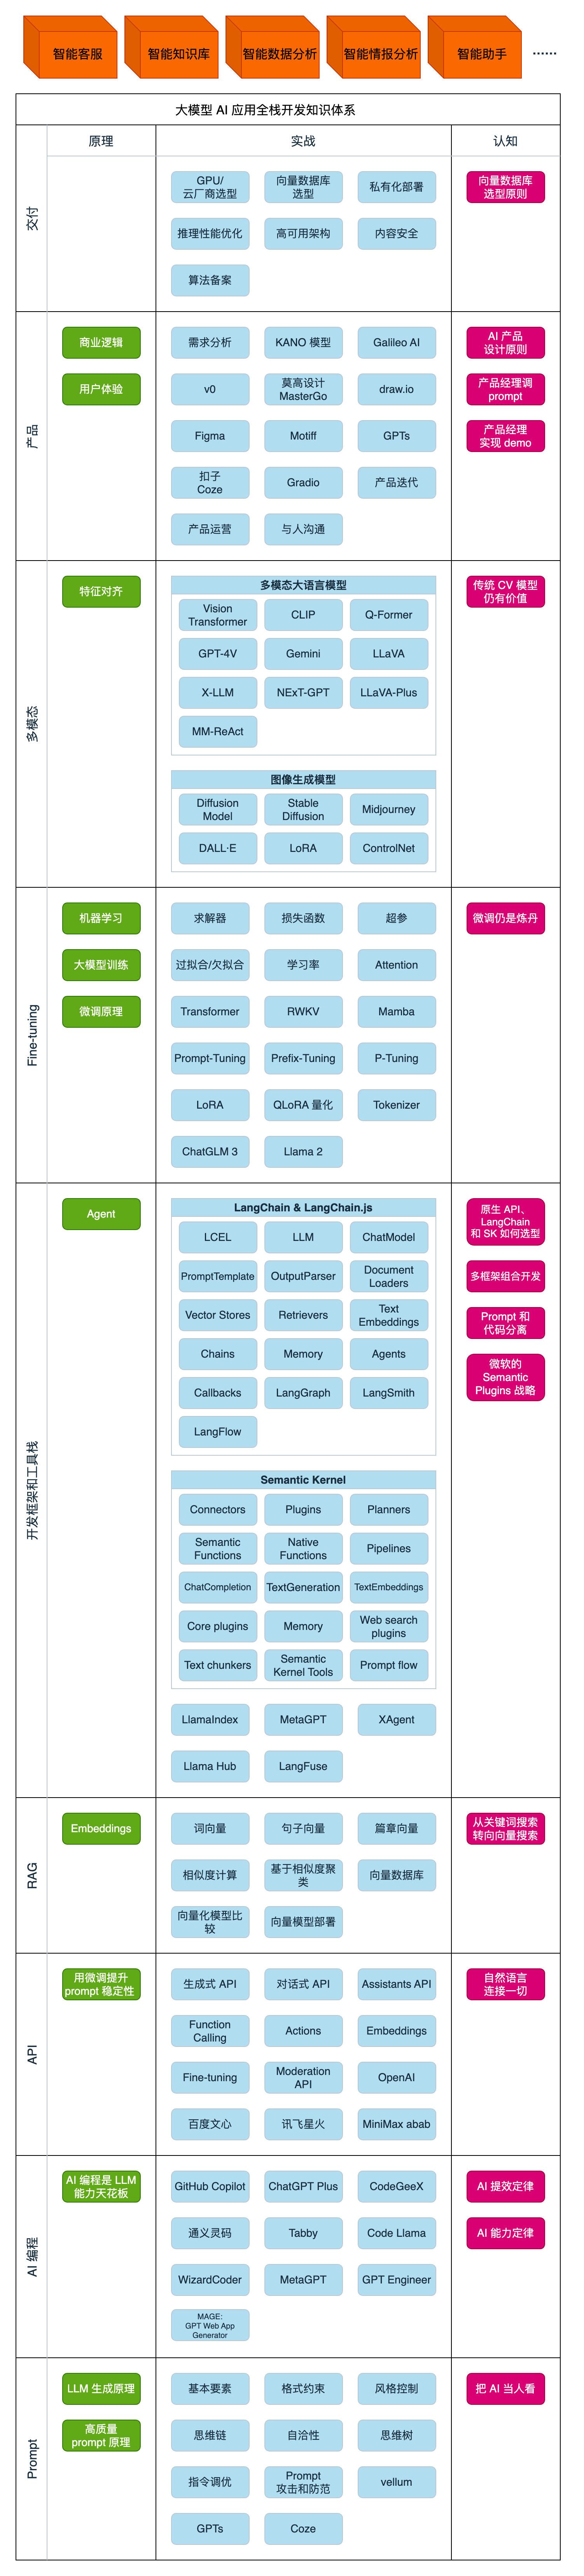
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

因此,大模型技术到应用到学习是一个系统性的复杂过程,中间涉及到无数的技术细节和理论,并且还在不断的产生新的技术和理论。

千里之行,始于足下。

大模型学习方法之——大模型技术学习路线 经验总结:定期回顾学习过程,总结技术要点和实战经验跨学科融合:探索大模型在其它领域(如金融,法律,医疗等)等应用,扩展知识广度‍如果用一句话总结就是,学习——实践——再学习——再实践。‍‍‍‍‍‍ 阅读详情

相关推荐

Anolis龙蜥内核升级实战:从查询到配置的全流程指南

本文提供了一份详尽的Anolis龙蜥操作系统内核升级实战指南。文章从升级的必要性出发,逐步讲解了升级前的系统检查与备份、从官方源获取正确内核包、分步安装与验证、配置默认启动项以及升级后的功能验证与安全回滚方案。旨在帮助运维人员安全、平稳地完成内核升级,以获取性能提升、新硬件支持及重要的安全漏洞修复。

qq_27496129的博客 573

大模型时代-大模型开发入门

深度学习基础知识:了解深度学习中的基本概念、算法和模型,包括神经网络、卷积神经网络、循环神经网络等。

JAVA领域优质创作者,基于分片网络查询方法专利发明者。 4557

Kettle实战:如何用JavaScript脚本实现数据库表批量操作(附完整代码)

本文详细介绍了如何利用Kettle的JavaScript脚本实现数据库表批量操作,包括表名采集、循环遍历和动态SQL生成等关键步骤。通过实战案例和完整代码示例,帮助ETL工程师高效处理数据密集型任务,提升数据库操作的自动化水平。

weixin_29019241的博客 233

大模型入门学习教程(非常详细)看这一篇就够了!

在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。

老皮的博客 3741

使用 Claude Skills 构建专业级 AI Agent:技术实践指南

Claude Skills(也称)是一组基于文件系统的可重用资源包,为 Claude 提供特定领域的专业知识、标准化工作流程和最佳实践。与传统一次性 Prompt 不同,Skills 是持久化、自动触发、支持代码执行的智能模块。让 AI 真正理解并执行你的工作方式。Claude Skills 正在重新定义 AI 助手的边界——从“回答问题”升级为“执行专业工作的能力”。其可组合、可移植、高效、强大的特性,使其成为自动化重复任务、标准化工作流、提升团队效率的理想工具。未来已来。

weixin_44058951的博客 2228

《从0到1:CTFer成长之路》书籍配套题目-[第二章 web进阶]文件上传

[第二章 web进阶]文件上传开始行动绕过第1个限制绕过第2个限制 介绍:记录一下笔记,方便以后迅速回忆使用。 《从0到1:CTFer成长之路》书籍配套题目,来源网站:《从0到1:CTFer成长之路》 先看一下题目源码: <?php header("Content-Type:text/html; charset=utf-8"); // 每5分钟会清除一次目录下上传的文件 require_once('pclzip.lib.php'); if(!$_FILES){ echo '

weixin_46703850的博客 3412

大模型学习路径

在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。有的时候临时抱佛脚也是可以的。

lvaolan的博客 2755

YOLOv8轻量化模型瘦身术:深度解析与实战LAMP剪枝 YOLOv8(2021)

YOLOv8模型LAMP剪枝技术解析与实战 本文深入探讨了LAMP剪枝技术在YOLOv8目标检测模型中的应用。针对深度学习模型部署面临的资源限制问题,LAMP剪枝通过最小化L2失真和层自适应稀疏度分配,实现了高效模型压缩。相比传统幅度剪枝的"一刀切"方法,LAMP创新性地将剪枝建模为优化问题,定义LAMP分数来衡量权重重要性,自动确定各层最佳剪枝率。文章从理论基础出发,详细解析了LAMP的核心数学公式和算法流程,并提供了完整的YOLOv8移植实战指南,包括代码结构、剪枝步骤和微调策略。通

FJN110的博客 2423

大模型时代下,nlp初学者需要怎么入门?

可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。大模型时代,考虑到成本和安全,在实际应用中,选择私有化部署一套自己的百亿量级的大模型的情况还是非常多的。

2401_84204207的博客 951

Dify搭建AI测试用例生成器

1、获取产品需求文档2、解读、分析、挖掘需求点,提炼为测试点3、依据测试点,生成详细的测试用例4、输出测试用例1、打开 Dify 控制台,依次点击【工作室】-【ChatFlow】-【创建空白应用】。

十二测试录 1373

YOLOv5 模型剪枝与量化实战:从训练到部署,轻量化模型性能不减(2026终极指南)

YOLOv5 轻量化三部曲稀疏训练:让模型学会“偷懒”,把不用的神经元权重压到 0。手术剪枝:切掉那些权重为 0 的神经元,物理减小模型体积。量化压缩:把剩下的神经元从“高精度浮点”变成“低精度整数”,进一步压榨速度。这套组合拳是 2026 年边缘 AI 部署的标准工业流程。虽然 YOLOv8/v10 原生支持更好的导出,但 YOLOv5 的这套手动控制流程能让你更深刻地理解模型结构,并在极端资源受限的场景下(如 MCU、超低端手机)挖掘出最后的性能潜力。最后建议如果你的项目时间紧迫,优先尝试。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 369

从理论到实践:大模型技术全框架解析与学习路线_大模型技术学习过程梳理,零基础入门到精通,收藏这一篇就够了

本文系统梳理了大模型技术框架,从神经网络基础架构到前沿应用实践。首先介绍了Transformer等主流神经网络模型的工作原理,重点分析了RAG检索增强技术如何解决大模型知识更新难题。文章详细阐述了微调技术与提示词工程在优化模型表现中的作用,并探讨了智能体(Agent)如何通过整合外部工具完成复杂任务。同时提供了包括学习路线、视频教程、行业报告等在内的完整学习资源包,帮助读者从理论到实践全面掌握大模型技术。文章强调大模型技术是一个包含神经网络设计、训练优化、知识增强、应用开发等环节的复杂系统工程,需要系统性学

WANGJUNAIJIAO的博客 961

生物量预测:基于Swin-Unet模型的生物量模型预测

本文提出了一种基于Swin-Unet架构的多源遥感地上生物量(AGB)预测方法。该方法整合了光学影像、SAR雷达影像、气候环境参数以及地形数据(坡度和坡向)等多源信息,通过24个输入通道(13+2+7+1+1)构建预测模型。研究采用Min-Max归一化预处理数据,并使用80%训练集、16%验证集和20%测试集的划分策略。模型基于Swin-Unet 2D架构,设置64个初始滤波器、4层深度、4×4堆叠数和2×2补丁大小。该方法通过整合多源遥感数据和先进深度学习架构,为AGB反演提供了新的解决方案。

此星光明博客 65

大模型技术从入门到进阶的学习路线梳理,收藏这一篇就够了

学习是一个从围观到宏观,从宏观到微观的一个过程学习大模型技术也有几个月的时间了,之前的学习一直是东一榔头,西一棒槌,这学一点那学一点,虽然弄的乱七八糟,但对大模型技术也算有了一个初步的认识。因此,今天就来整体梳理一下大模型技术的框架,争取从大模型所涉及的理论,技术,应用等多个方面对大模型进行梳理。‍‍‍‍‍‍‍‍。

lvaolan的博客 1714

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

普通人如何入门大模型—大模型技术学习过程梳理

‍‍‍‍‍‍‍从大的方向上来说,大模型从技术到应用,主要涉及到以上几个大的模块;而每个模块又涉及到大量的技术和细节。比如打造不同任务的神经网络模型,强化学习,迁移学习,知识蒸馏,分布式训练与存储等;以及RAG使用的向量检索,向量数据库,语义理解等,还有复杂任务的思维链(CoT),模型训练使用的LoRa等微调方法。还有多模态模型中的知识对齐,数据融合等复杂技术。‍‍‍因此,大模型技术到应用到学习是一个系统性的复杂过程,中间涉及到无数的技术细节和理论,并且还在不断的产生新的技术和理论。千里之行,始于足下。

2401_85378759的博客 1875

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

【大模型学习路线】2025最新大模型技术学习路线梳理!

学习是一个从围观到宏观,从宏观到微观的一个过程学习大模型技术也有几个月的时间了,之前的学习一直是东一榔头,西一棒槌,这学一点那学一点,虽然弄的乱七八糟,但对大模型技术也算有了一个初步的认识。因此,今天就来整体梳理一下大模型技术的框架,争取从大模型所涉及的理论,技术,应用等多个方面对大模型进行梳理。

AUG2468的博客 804

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

大模型技术学习过程梳理

大模型技术虽然很强大,但其有几个明显的缺点,第一就是知识是有限制的,因为采用的是预训练方式,因此大模型的知识最多只能到训练开始的时间节点,之后产生的新的知识大模型无法获取。在前面的描述中,神经网络架构讲的是怎么构建一个大模型,知识库是怎么补充和强化大模型,微调和提示词是怎么更好的使用大模型,那么智能体就是真正的使用大模型,研究大模型的具体应用。

qingkahui24689的博客 697

AI大模型技术学习过程梳理!

‍‍‍‍‍‍‍从大的方向上来说,大模型从技术到应用,主要涉及到以上几个大的模块;而每个模块又涉及到大量的技术和细节。比如打造不同任务的神经网络模型,强化学习,迁移学习,知识蒸馏,分布式训练与存储等;以及RAG使用的向量检索,向量数据库,语义理解等,还有复杂任务的思维链(CoT),模型训练使用的LoRa等微调方法。还有多模态模型中的知识对齐,数据融合等复杂技术。‍‍‍因此,大模型技术到应用到学习是一个系统性的复杂过程,中间涉及到无数的技术细节和理论,并且还在不断的产生新的技术和理论。

程序员鑫港的博客 1088
上一篇: 从零开始用Pytorch构建大型语言模型(LLM)
下一篇: 微调一个自己的大模型(腾讯云cloud studio + llama factory)
少喝冰美式
博客等级 码龄3年 6853粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值