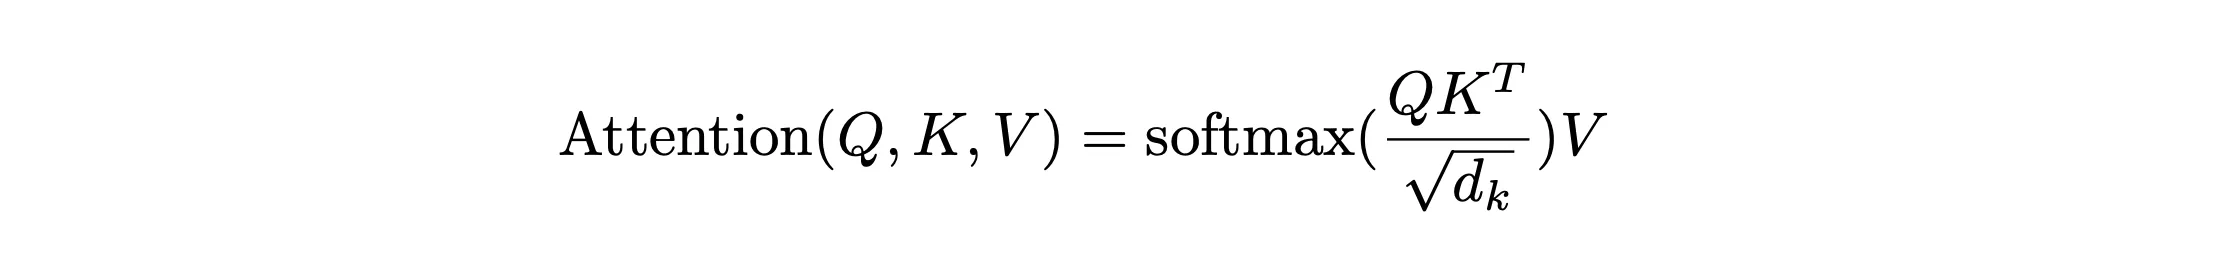二、大模型原理:图文解析Transformer原理与代码

三、大模型原理:图文解析MoE原理 2025年几乎所有领先的大型语言模型都采用了混合专家(Mixture of Experts,简称MOE)架构。从GPT-4到DeepSeek V3,从Llama 4到Grock,这种稀疏激活的架构已经成为构建高性能AI系统的标准方法。 阅读详情

Transformer是很多大模型的基石,也是现在llm面试岗位必考的。
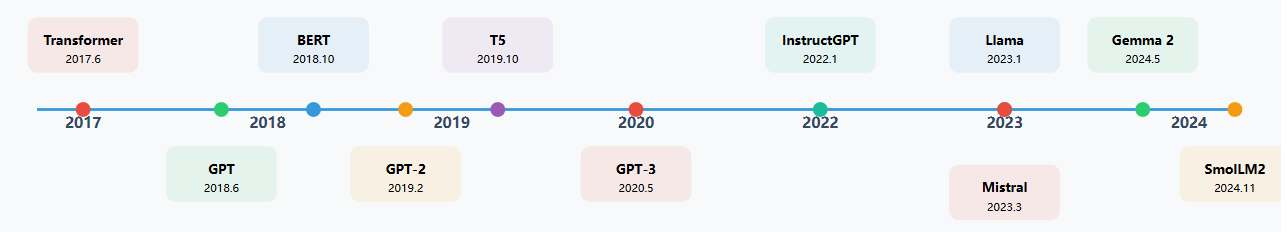
即使是ChatGPT中的"T"也代表着Transformer。以下模型都是Transformer的演变模型(当然每个大模型的Transformer都可能存在差别):
在这里插入图片描述

本文将从原理+实战带你深入理解Transformer

Transformer结构

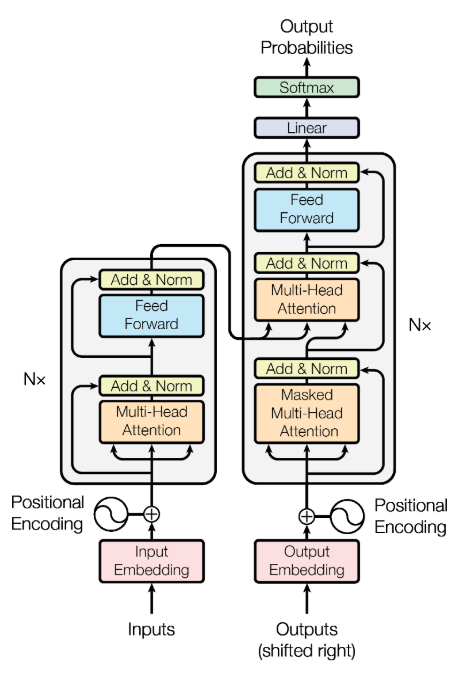
先放出整体架构,后文的1~4点都是对原件进行深入探讨的。
在这里插入图片描述
从总体上来看
可以将Transformer看为是N个编码结构和N个解码结构的模型,这里的解码/编码结构即为后文解释的 Transformer Block;
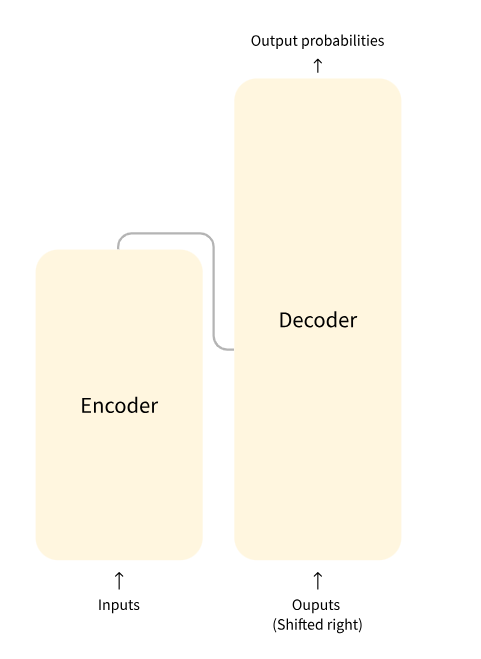
在这里插入图片描述
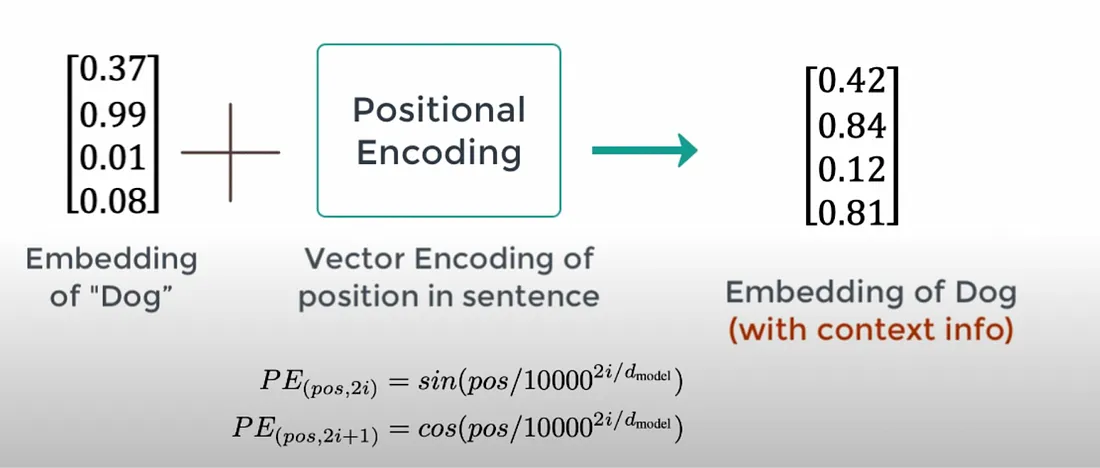
上图的inputs其实是输入的embedding向量+位置编码向量。
在这里插入图片描述

1. Token Embedding:从符号到向量的转换

上一小节我们已经讲述了一句话是如何转为数值表达的,但对于计算机而言仅仅是一个个数值是没有语义信息的。

Token本质上是符号:

  • "Apple"是一个符号
  • "Cat"是一个符号
  • "Run"是一个符号
  • "Jump"是一个符号

虽然我们知道"Run"和"Jump"都是动词,它们在语义上比"Cat"和"Apple"更相近,但从Token的角度看,它们都只是独立的符号,彼此之间没有任何关联。

实现机制:查表法

Transformer中的Token嵌入采用查表法:

  1. 维护一个包含所有可能Token及其对应向量的表格
  2. 对于每个输入Token,在表中查找其对应的向量
  3. 这些向量是模型的可学习参数,在训练过程中自动优化

2. 位置编码:为序列添加位置信息

需要位置编码原因可以回想一下RNN,对RNN而言是用的一套参数。
而Transformer的输入是一起扔给模型的,因此就缺少了先后位置关系,从而使用了位置编码。

假设没有位置编码,同一个Token总是有相同的向量表示,那么模型将会丧失了对上下文的信息保留。例如:

  • “Bank”(银行)在"I went to the bank"中
  • “Bank”(河岸)在"I sit by the river bank"中
    这两个"bank"使用相同的Token Embedding,但含义完全不同,保留了位置信息为下面的多头注意力机制保留了所含有的信息。

位置编码的实现方式

1. 人工设计的位置嵌入

最早的Transformer实现中,位置编码是人工设计的,采用以下方式:
使用正弦和余弦函数为每个位置生成独特的编码
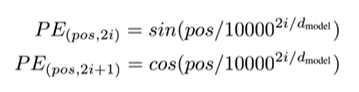
在这里插入图片描述
简单来说就是偶数位为sin,奇数位为cos。

2. 可学习的位置嵌入

位置编码也可以通过训练学习

3. 注意力机制(Attention)

通过注意力机制增加了语义的理解,解决了歧义问题(如"bank"指银行还是河岸)

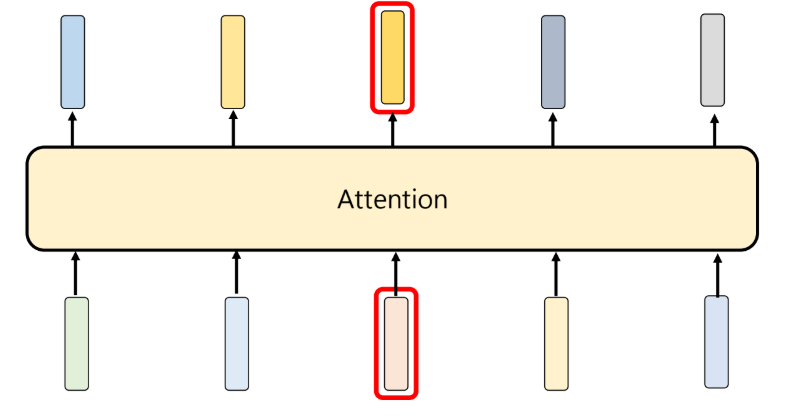
如果你能记住下面这句话,就记住了注意力的本质:
👉 输入一排词向量 → 为每个词找到重要上下文 → 得到新的词向量
在这里插入图片描述
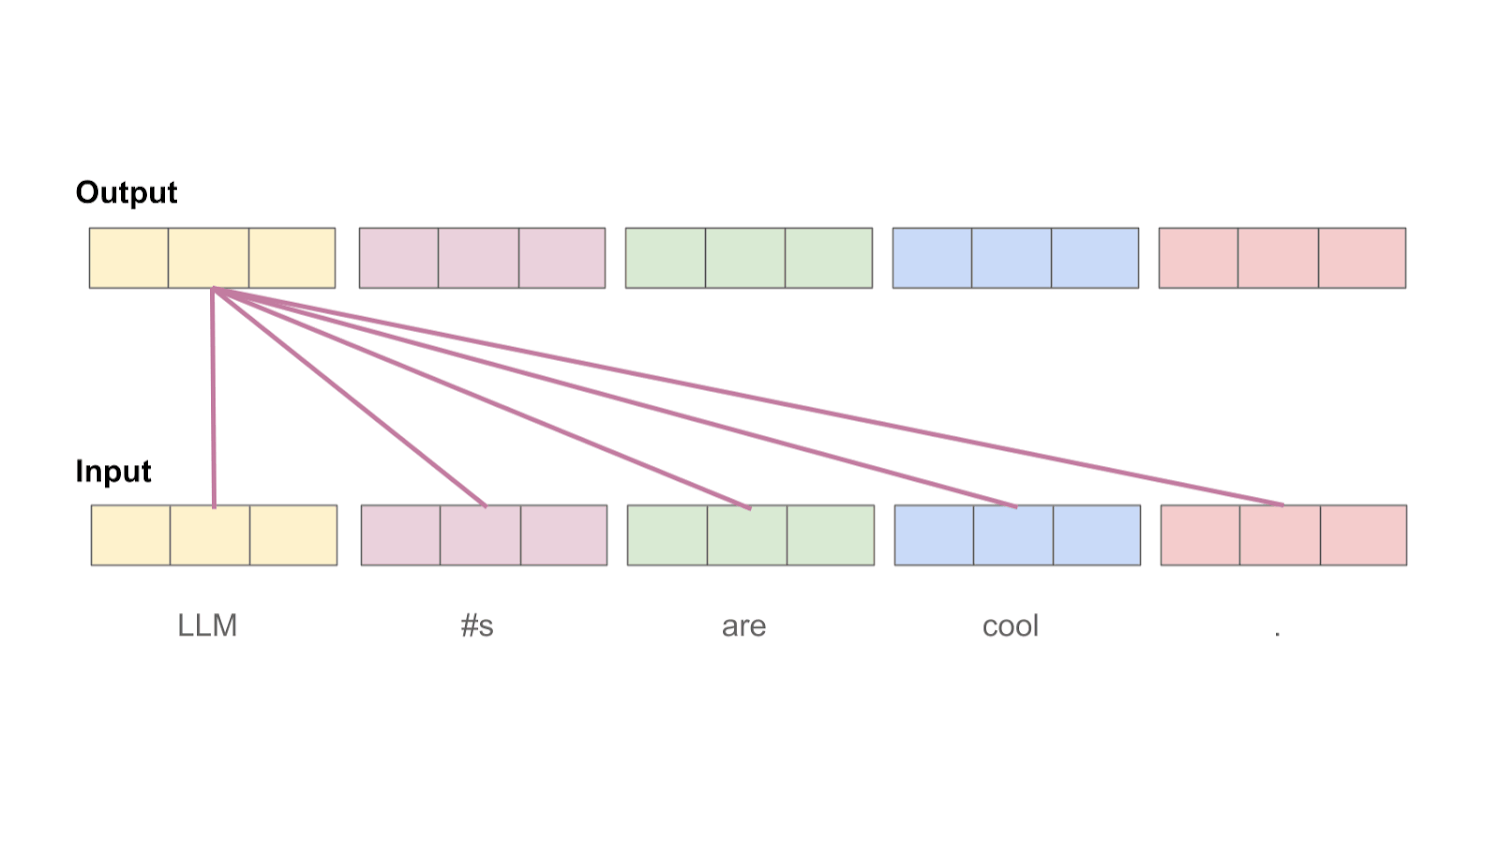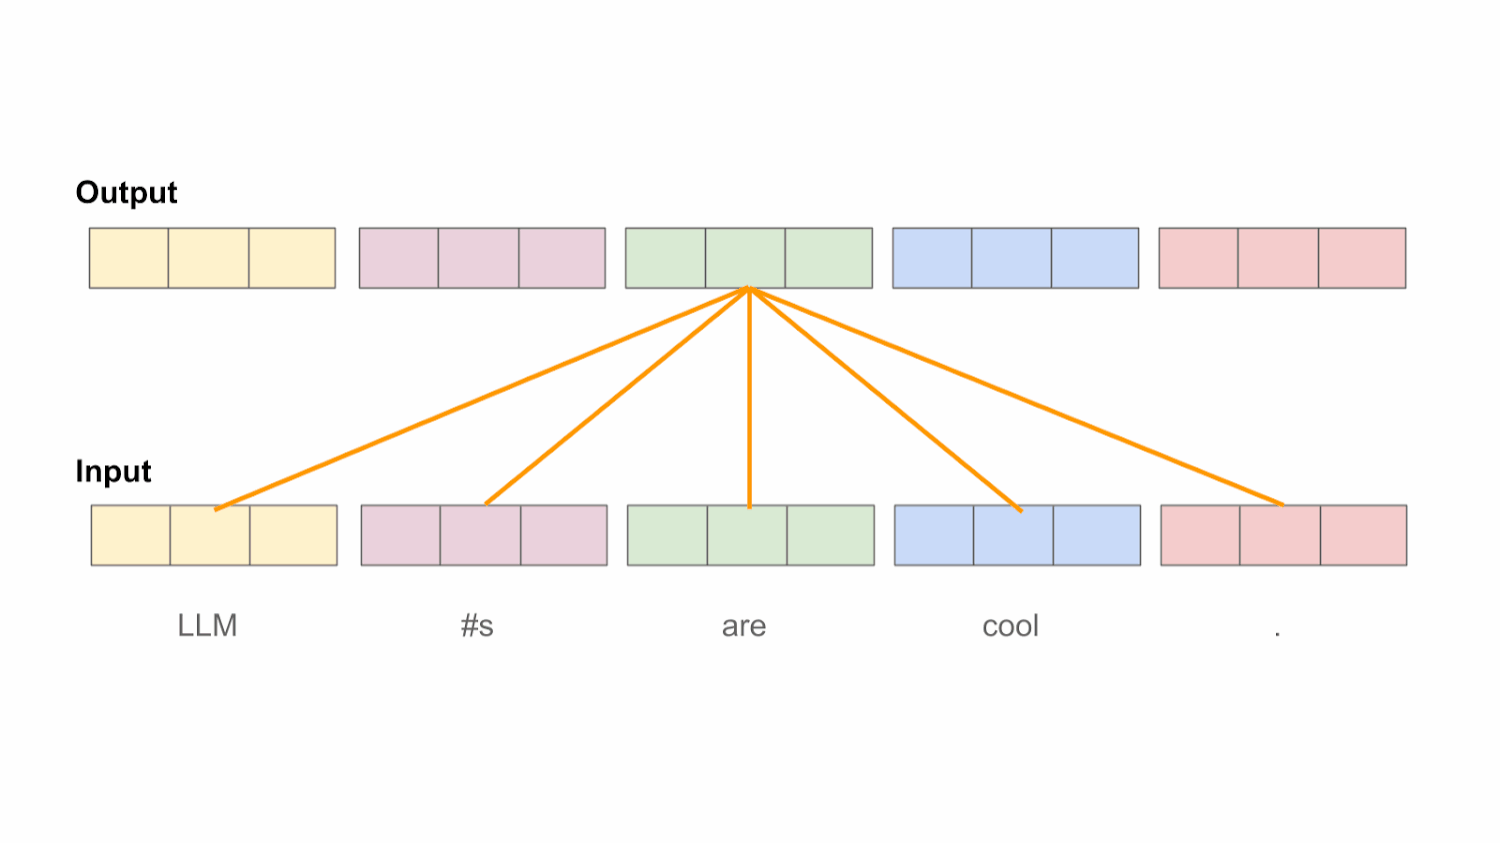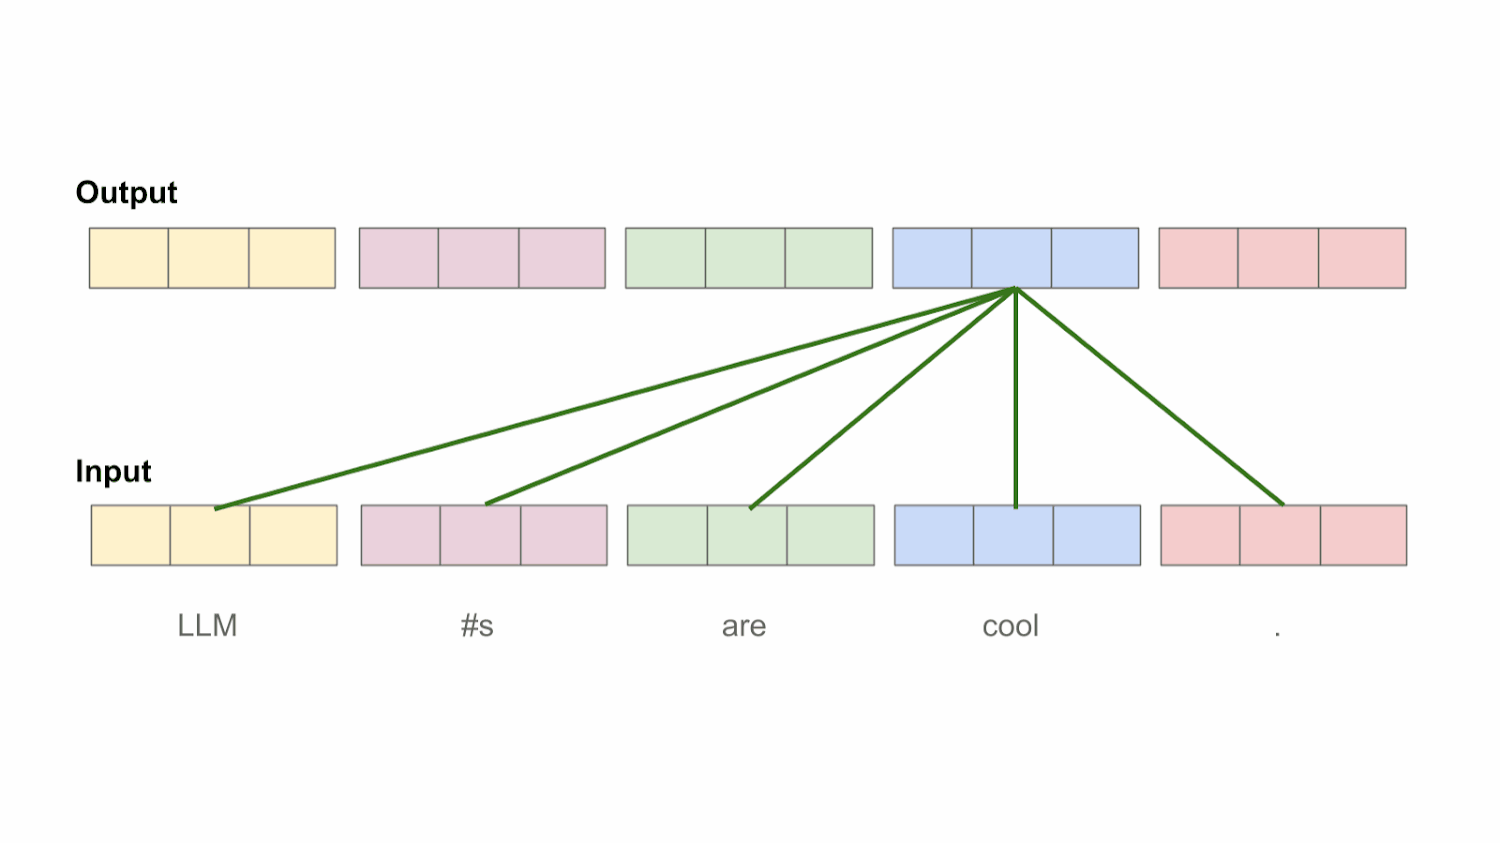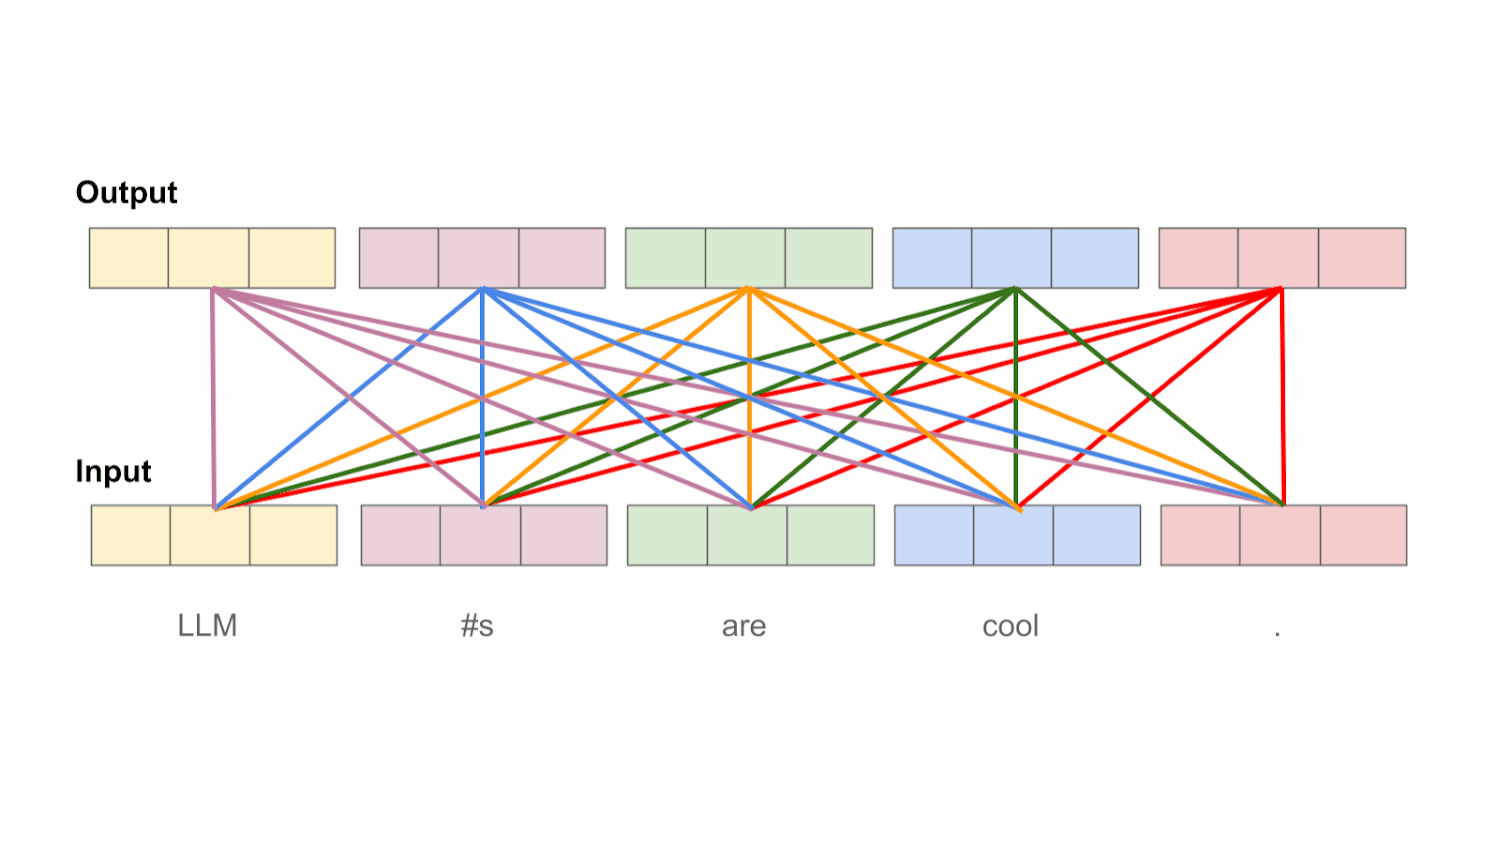
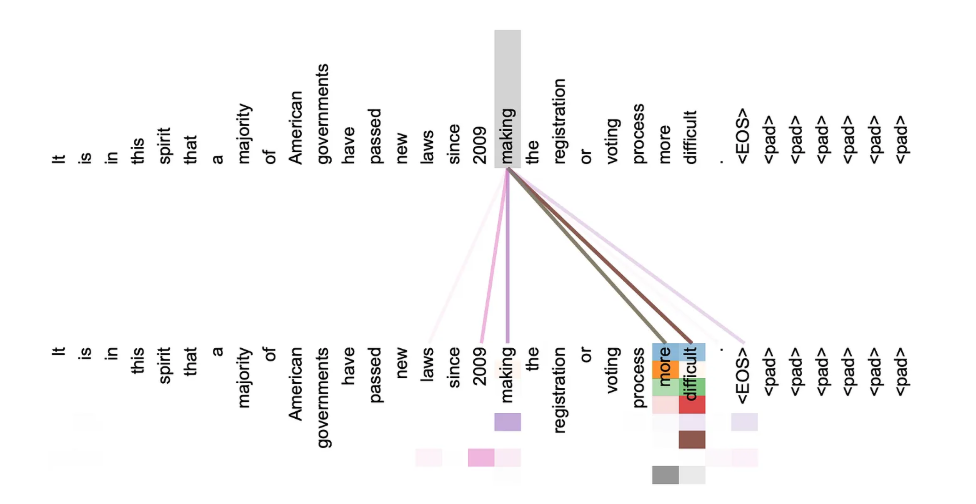
为每个词找到重要上下文,这部分即是量化了句子中任意两个词条之间的依赖关系。如下图将会去对输入句子做比较,即每个词之间又会对句子中所有词做比较
在这里插入图片描述
在这里插入图片描述

注意力机制QKV理解

注意力机制中最重要概念即对下图公式的理解
在这里插入图片描述

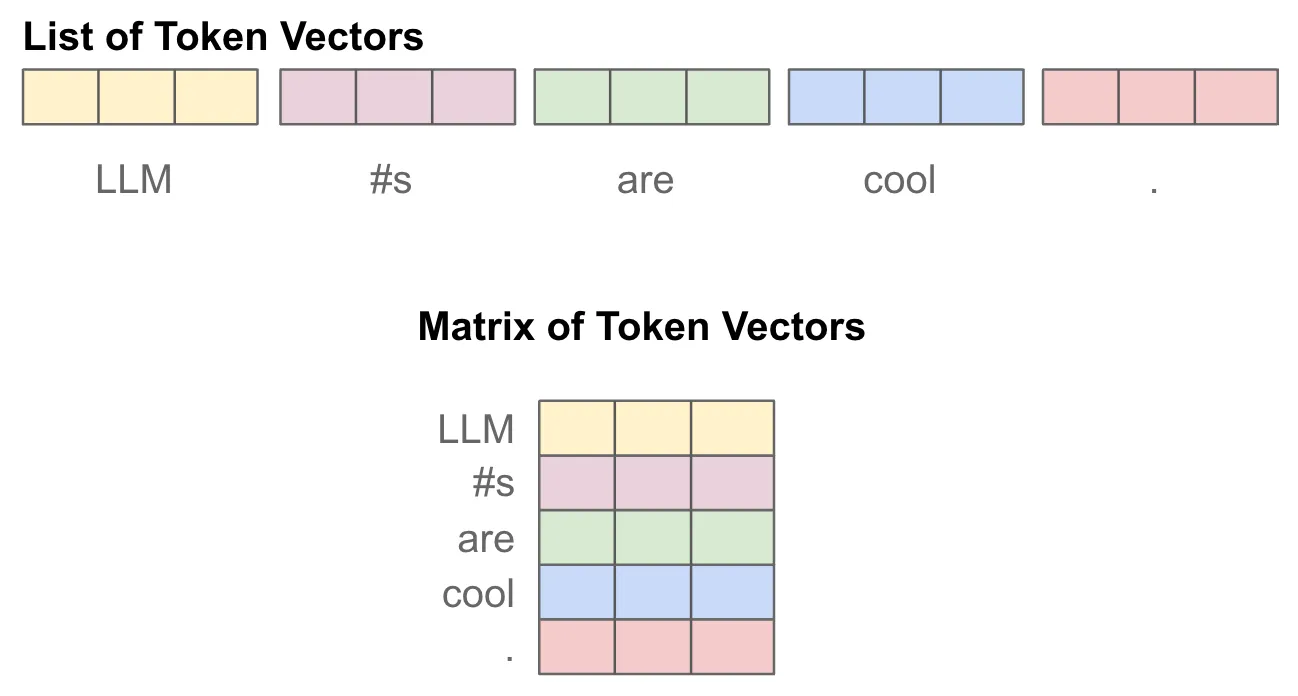
经过embedding+位置编码作为输入,我们的对模型的输入是个 [ B , T , d ] [B, T, d] [B,T,d]矩阵。其中批次大小为 B B B,每个序列长度为 T T T,每个词元向量的维度为 d d d,也就是自注意力层接收的输入张量形状就是 [ B , T , d ] [B, T, d] [B,T,d]。
为了简化说明,我们先将B设置为1,也就是单个词元序列作为输入来讲解自注意力的计算过程(见下图),但相同的原理可以很容易地扩展到多个序列组成的批次上。
在这里插入图片描述
QKV创建
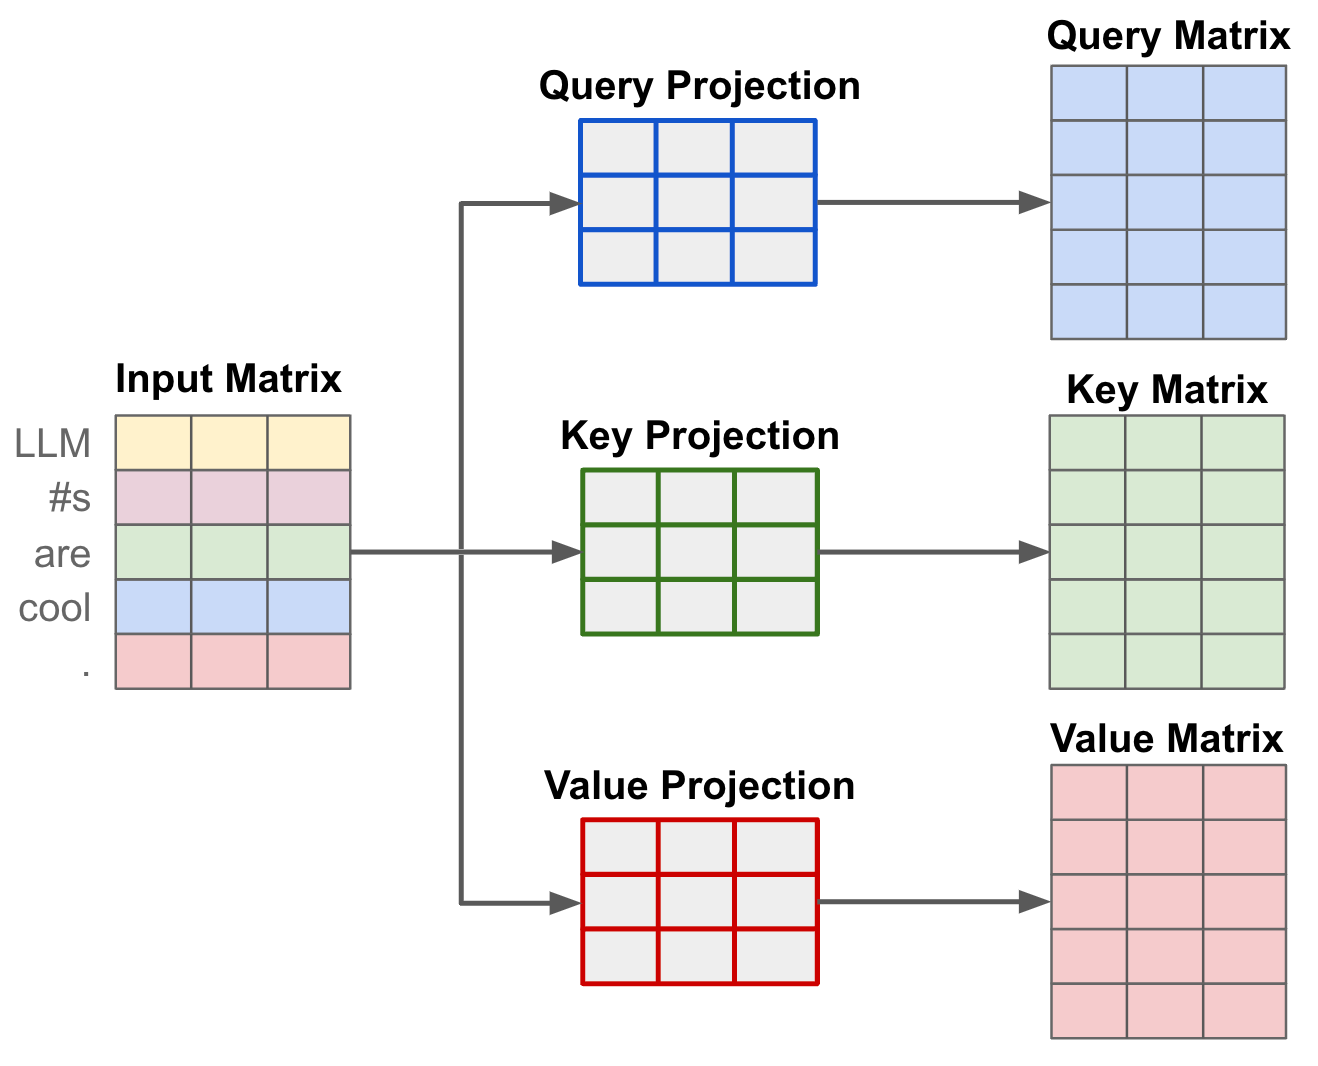
可以看到该公式引入了三个矩阵QKV,这些矩阵来自于输入序列中的token向量,经过了三次独立的(线性)投影,形成Q、K和V矩阵。
这
在这里插入图片描述
以输入 [“LLM”, “#s”, “are”, “cool”]为例,每个词通过嵌入层和线性投影后得到Query向量和Key向量。
为了简化,我们假设每个向量是3列组成的(也就是head_size,这是一个由开发者决定的超参数,控制了QKV矩阵的维度,即注意力头大小):

embeddings = [
    [0.1, 0.2, 0.3],  # "LLM"的嵌入
    [0.4, 0.5, 0.6],  # "#s"的嵌入
    [0.7, 0.8, 0.9],  # "are"的嵌入
    [1.0, 1.1, 1.2]   # "cool"的嵌入
]

投影为Query和Key矩阵
现在,我们需要用两个不同的投影矩阵将这些嵌入转换为Query和Key。
假设我们的投影矩阵是:

W_q = [
    [0.1, 0.2, 0.3],
    [0.4, 0.5, 0.6],
    [0.7, 0.8, 0.9]
]

W_k = [
    [0.9, 0.8, 0.7],
    [0.6, 0.5, 0.4],
    [0.3, 0.2, 0.1]
]

计算注意力分数
在对输入进行投影之后,会使用 Key 和 Query 向量来生成注意力分数。词之间与所有前后所有词两两组合,形成一个个词元,对每个词元进行计算注意力分数。专业点来说即是:对于序列中的每一对词元 [ i , j ] [i, j] [i,j],我们都会计算一个注意力分数 a [ i , j ] a[i, j] a[i,j]。注意力分数的取值范围是 [ 0 , 1 ] [0, 1] [0,1],它定量地表示在计算词元 i i i 的新表示时,词元 j j j 应该被考虑的程度。

i(当前词) j(参与加权的词) 计算 含义
0 (“LLM”) 0 (“LLM”) $a[0, 0] = q_0 \cdot k_0$ “LLM” 关注自己多少
1 (“#s”) $a[0, 1] = q_0 \cdot k_1$ “LLM” 关注 “#s” 多少
2 (“are”) $a[0, 2] = q_0 \cdot k_2$ “LLM” 关注 “are” 多少
3 (“cool”) $a[0, 3] = q_0 \cdot k_3$ “LLM” 关注 “cool” 多少
1 (“#s”) 0 (“LLM”) $a[1, 0] = q_1 \cdot k_0$ “#s” 关注 “LLM” 多少
1 (“#s”) $a[1, 1] = q_1 \cdot k_1$ “#s” 关注自己多少
2 (“are”) $a[1, 2] = q_1 \cdot k_2$ “#s” 关注 “are” 多少
3 (“cool”) $a[1, 3] = q_1 \cdot k_3$ “#s” 关注 “cool” 多少
2 (“are”) 0 (“LLM”) $a[2, 0] = q_2 \cdot k_0$ “are” 关注 “LLM” 多少
1 (“#s”) $a[2, 1] = q_2 \cdot k_1$ “are” 关注 “#s” 多少
2 (“are”) $a[2, 2] = q_2 \cdot k_2$ “are” 关注自己多少
3 (“cool”) $a[2, 3] = q_2 \cdot k_3$ “are” 关注 “cool” 多少
3 (“cool”) 0 (“LLM”) $a[3, 0] = q_3 \cdot k_0$ “cool” 关注 “LLM” 多少
1 (“#s”) $a[3, 1] = q_3 \cdot k_1$ “cool” 关注 “#s” 多少
2 (“are”) $a[3, 2] = q_3 \cdot k_2$ “cool” 关注 “are” 多少
3 (“cool”) $a[3, 3] = q_3 \cdot k_3$ “cool” 关注自己多少

实际计算中,我们可以通过将所有的 Query 向量和 Key 向量分别堆叠成两个矩阵

大模型核心概念与技术解析:从Transformer到应用实践 Transformer架构作为现代大模型的核心基础,通过自注意力机制实现了对长文本的全局理解,取代了传统的循环神经网络(RNN)。神经网络作为支撑系统,通过分层结构实现从低级特征到高级语义的自动学习。参数规模决定了模型的记忆能力和计算成本,当参数超过临界点时,模型会展现出零样本学习等涌现能力。这些技术广泛应用于自然语言处理、多模态融合和智能体系统等领域。自注意力机制和位置编码是Transformer的关键创新,而预训练范式和提示工程则优化了模型的训练和应用效率。量化部署技术使得大模型能够在消费级硬件上运行, 阅读详情

相关推荐

大模型语言技术演进与Transformer架构深度解析

Transformer架构作为现代自然语言处理(NLP)的核心技术,通过自注意力机制(Self-Attention)和多头注意力机制(Multi-Head Attention)实现了对长距离依赖的高效建模。其核心原理包括位置编码和缩放点积注意力,这些技术显著提升了模型在文本生成、机器翻译等任务中的性能。随着BERT、GPT等预训练模型的兴起,迁移学习成为可能,模型规模与性能呈现对数线性关系。在实际工程中,分布式训练、量化压缩和知识蒸馏等技术解决了大模型训练和部署的挑战。这些技术已广泛应用于智能编程助手、金融

weixin_30566111的博客 322

人工智能大模型原理与应用实战:知识图谱构建

1.背景介绍 知识图谱(Knowledge Graph, KG)是一种描述实体之间关系的数据结构。它是一种图形数据库,可以用来表示实体(如人、地点、组织等)以及这些实体之间的关系。知识图谱的应用范围广泛,包括信息检索、问答系统、推荐系统等。 知识图谱的构建是一个复杂的过程,涉及到大量的数据收集、预处理、提取、整合等工作。随着大数据技术的发

AI天才研究院 404

【大数据&AI人工智能】图文详解 ChatGPT、文心一言等大模型背后的 Transformer 算法原理

图文详解 ChatGPT、文心一言大模型背后的功臣 Transformer 算法原理

AI天才研究院 2万+

INS/伪距组合导航(1)

星间单差GNSS/INS伪距紧组合

u014430081的博客 874

基于ESP32-P4的低成本旋转式激光雷达系统设计

激光雷达(LiDAR)作为机器人环境感知的核心传感器,其本质是融合光学测距、机电控制与实时数据处理的嵌入式系统。理解时间飞行(ToF)原理与机械旋转耦合机制,是实现高精度点云采集的基础;而系统级误差源——如计时抖动、电机惯性、信号串扰和温漂——直接决定实际建图鲁棒性。在资源受限场景下,选用RISC-V双核MCU(如ESP32-P4)可兼顾实时控制与网络服务能力,通过硬件时间戳捕获、S型加减速轨迹规划、旋转变压器供电及双Bank OTA等工程手段,有效平衡分辨率、帧率与稳定性。本文围绕360°旋转式激光雷达的

weixin_36231030的博客 433

交换芯片数据通路四大核心微架构深度解析

数据通路是交换芯片性能的物理根基,决定着低延迟、高吞吐与突发承载能力。其本质是在硅片约束下对带宽、时序、功耗与统计复用的系统性权衡。Crossbar提供确定性低延迟但受RC延迟与功耗制约;VOQ通过虚拟队列隔离输出争抢,却引入仲裁复杂度与内存开销;Shared Buffer依托统计复用提升缓存利用率,但面临碎片化与管理策略挑战;Cell Fabric以固定长度cell重构交换粒度,在AI与金融等小包敏感场景实现尾延迟稳定。这些架构并非替代关系,而是面向不同网络不确定性(如流量不对称性、突发强度、包长分布)的

weixin_32667955的博客 189

GD32模拟IIC读写DVC1124

GD32模拟IIC读写集澈AFE芯片DVC1124

ponyma_的博客 1226

MOSFET和IGBT栅极驱动器电路的基本原理学习(2)

1.PWM直接驱动 驱动主开关晶体管栅极的最简单方法是利用 PWM 控制器的栅极驱动输出,如图 (1)如 图 8中所示,PWM 控制器和 MOSFET 之间可能有较大距离。由于栅极驱动和接地环路迹线形成的环路,这个距离形成了寄生电感,从而降低了开关速度,并导致栅极驱动波形中形成振铃。为了降低与栅极驱动连接相关的电感,需要更宽的 PCB 迹线。 (2)直接栅极驱动的另一个问题是PWM 控制器的驱动电流能力有限。极少有集成电路能提供高于 1A 的峰值栅极驱动能力。 2.旁路电容的确定 (1)位置 如果是独立的

weixin_43732932的博客 5831

Kafka 入门篇(一)

初识 Kafka 什么是 Kafka Kafka 的基本术语 Kafka 的特性(设计原则) Kafka 的使用场景 Kafka 的消息队列 点对点模式的消息队列 发布-订阅模式的消息队列 Kafka 系统架构 核心 API Kafka 为何如此之快 broker 端配置 broker.id port zookeeper.connect log.dirs num.recovery.threads.per.data.dir auto.create.topics.enable topic默认配置 num.par

1234

Transformer从菜鸟到新手(一)

从本文开始回顾一下Transformer的原理与实现细节,包括分词算法BPE的实现。最终利用从零实现的Transformer模型进行英中翻译。

日积月累,天道酬勤 2125

【科学文献计量】标准参考出版年谱(Standard RPYS)和多维参考出版年谱(Multi RPYS)

@[TOC](标准参考出版年谱(Standard RPYS)和多维参考出版年谱(Multi RPYS)) 1 标准参考出版年谱与多维参考出版年谱 1.1 标准参考出版年谱(Standard RPYS) 标准参考出版年谱(Standard Reference Publication Year Spectroscopy)是由Marx, Bornmann, Barth, and Leydesdorff(2014)和Marx and Bornmann(2014)提出的一种量化历史出版物对研究领域影响的方法。该方法通

lys_828的博客 1103

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

上一篇: (1)大模型的提示词工程实践技巧---LLM输出配置详解
下一篇: (2)大模型的提示词工程实践技巧---七大提示技巧
豆芽-无敌版
博客等级 码龄6年 888粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

豆芽-无敌版

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值