三、大模型原理:图文解析MoE原理

【人工智能】MOE架构的详细解析 MOE(Mixture of Experts,混合专家)架构是一种用于提高深度学习模型性能和效率的神经网络架构设计。以下是对MOE架构的详细解析: 阅读详情

2025年几乎所有领先的大型语言模型都采用了混合专家(Mixture of Experts,简称MOE)架构。

从GPT-4到DeepSeek V3,从Llama 4到Grock,这种稀疏激活的架构已经成为构建高性能AI系统的标准方法。

MOE(Mixture of Experts) 架构

MOE架构的主要组成部分

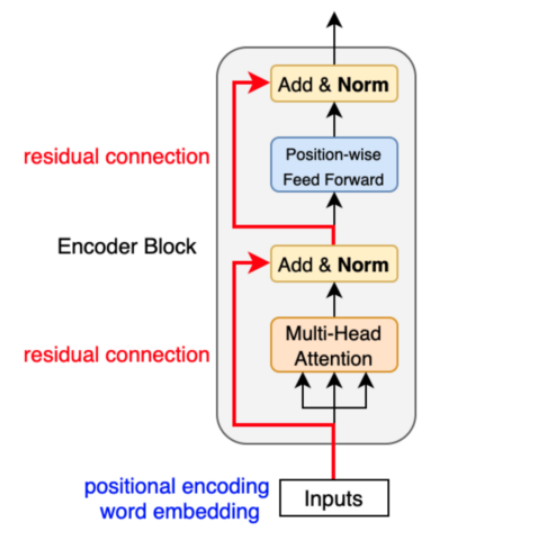
回顾下Transformer架构,我们会将token输入到Transformer中,Transformer架构是由N个编码器和N个解码器组成。编码器/解码器内部是由两部分组成:

  1. 注意力机制:残差+多头+LN
  2. 神经网络:残差+神经网络+LN
    在这里插入图片描述

而MOE架构主要修改的是Transformer模型中的神经网络部分。由左图中可知MOE包含两部分:

  1. 稀疏 MoE 层: 这我们只需将 Transformer 的神经网络多拷贝几份(后文会将这一层称为专家层),在复杂运用中也可能是多个MoE层。
  2. 路由层: 这个部分用于决定哪些token被发送到哪个神经网络中。例如,在下图中,“More”这个令牌可能被发送到第二个神经网络,而“Parameters”这个令牌被发送到第一个神经网络。有时,一个令牌甚至可以被发送到多个神经网络。该路由方式是由预训练学习的参数所得到的
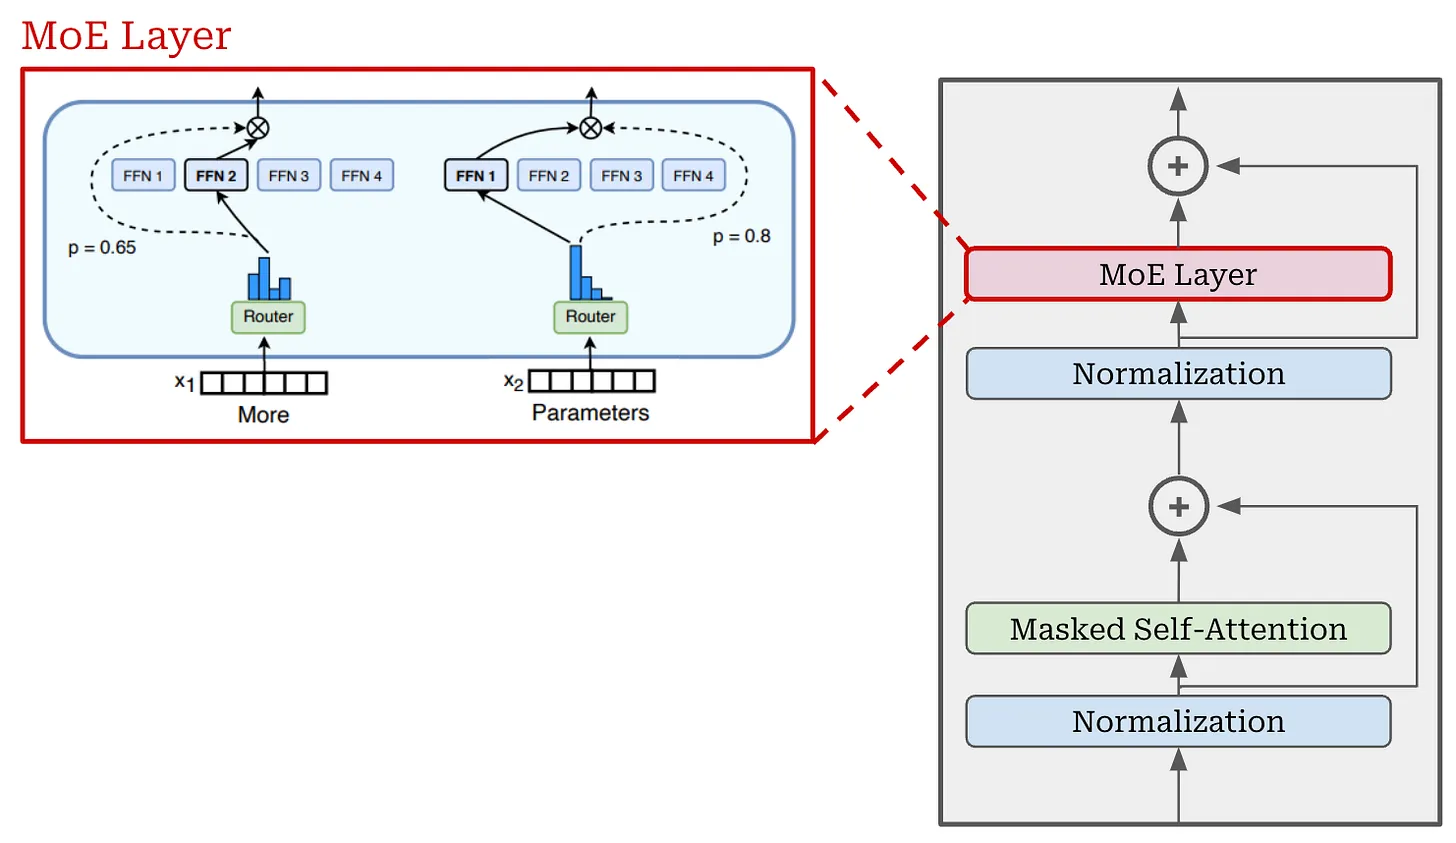
    在这里插入图片描述

1. 专家层

我们无需在 Transformer 的每个前馈层都使用MOE层。即有的使用MOE有的保持神

大模型MoE架构解析:稀疏激活如何实现万亿参数高效推理 稀疏专家混合(MoE)是现代大语言模型实现参数规模与计算效率平衡的核心范式。其原理在于通过门控网络动态路由token至Top-k专家子网络,使模型总参数量可扩展至万亿级,而单次前向传播仅激活少量专家,达成条件计算与资源解耦。这一技术显著提升模型扩展性、降低推理成本,并支撑长文本、多任务等复杂场景。工程实践中,实际激活率受语义粒度、批处理多样性及门控策略影响,在11%–16%间动态波动,远非固定‘2%’。理解MoE的数学本质、路由机制与负载均衡设计,是私有化部署、Prompt优化及成本管控的关键基础——本文即 阅读详情

相关推荐

详解大模型结构MOE(混合专家网络)

MOE全称:Mixture of expert, 是大模型的结构之一。

IT荻的博客 1777

大模型稀疏激活原理:门控网络与MoE专家路由技术解析

大模型稀疏激活是一种通过条件化路由动态调用子模型的技术,其核心在于门控网络(gating network)对输入语义的实时判别与Top-k专家选择。该机制突破了传统稠密模型的算力线性增长瓶颈,实现推理成本的非线性下降。技术价值体现在显存占用降低、首字延迟优化及硬件资源利用率提升,广泛应用于高并发客服系统、金融文档解析、多模态生成等对延迟与能效敏感的工程场景。本文深入拆解门控网络设计、负载均衡损失、分层专家架构及H100硬件协同路由协议,聚焦‘动态稀疏激活’与‘MoE专家路由’两大关键技术落地路径。

chushang0934的博客 869

国产大模型突破:长文本、MoE架构与推理成本控制实战解析

大语言模型的核心技术包括长上下文窗口、混合专家架构(MoE)和推理成本控制,这些技术共同决定了模型在真实场景中的可用性与经济性。长上下文窗口通过稀疏注意力机制降低计算复杂度,使模型能够高效处理超长文档;混合专家架构通过稀疏激活大幅减少推理算力消耗,提升响应速度;推理成本控制则依赖量化压缩与国产算力适配,直接影响大规模商业化的可行性。这些技术突破使得法律、金融、科研等长文档处理场景以及工业质检、医疗影像辅助等多模态应用成为可能。本文深入拆解国产大模型在长文本理解、多模态推理与推理成本控制方面的最新进展,结合实

weixin_33525298的博客 324

Qwen3.5混合架构解析:Gated DeltaNet+稀疏MoE如何破局大模型三难困境

大语言模型长期面临能力、速度与成本不可兼得的‘三难困境’,其本质源于传统Transformer的O(n²)注意力开销与全参数激活的硬件刚性约束。Qwen3.5通过Gated Delta Networks实现长文本逻辑分块与动态门控建模,显著降低上下文处理复杂度;结合稀疏MoE的语义感知路由机制,在3970亿总参数下仅激活170亿,达成高精度与低延迟的工程平衡。该设计不仅提升PDF解析、多语言文档理解、工具调用等真实场景的端到端性能,更推动大模型从‘参数竞赛’迈向‘系统级协同优化’。本文深入剖析其混合架构原理

weixin_33744141的博客 420

MOE(Mixture of Experts,混合专家)

MOE架构已被广泛应用于多个领域,包括自然语言处理(NLP)和计算机视觉(CV)等。在NLP领域,MOE被用于构建大型语言模型(如GPT-4),以提高模型的性能和效率。在CV领域,MOE也被用于图像分类、目标检测等任务中。在训练过程中,模型会学习如何根据输入数据的特征选择最合适的专家进行处理。在推理过程中,门控机制会根据输入数据选择一组专家进行激活,并产生输出。,实现了对输入数据的精细化处理和计算资源的智能分配。这种架构在提高模型性能和效率方面具有重要意义,并已在多个领域得到广泛应用。

ZhangJiqun&191cm&85kg 1438

DeepSeek技术解析:MoE、MLA与推理训练如何重塑大模型性价比

大语言模型的核心挑战在于平衡性能与成本。混合专家模型(MoE)通过稀疏激活机制,让模型仅调用相关专家网络,大幅降低计算量;低秩压缩(MLA)则优化KV cache显存占用,提升推理效率。这些架构创新使模型在保持高性能的同时显著降低训练与推理成本,为大规模部署提供可能。在需要复杂推理的场景中,推理训练结合过程奖励模型,让模型学会分步思考,进一步提升求解能力。DeepSeek V2、V3、R1正是这些技术的典型实践,通过MoE、MLA和推理训练的三层优化,实现了性价比的突破,为技术选型和行业分析提供了关键参考。

weixin_29038155的博客 311

DeepSeek核心原理与部署实战:MLA、MoE、FP8全解析

在Transformer大模型应用中,推理成本与显存占用是落地的主要瓶颈。以KV Cache为例,其大小随序列长度线性增长,长上下文场景下动辄消耗数十GB显存。混合专家(MoE)通过稀疏激活降低计算量,但引入了负载均衡与通信开销。DeepSeek系列模型针对这些痛点提出了系统性解决方案:MLA(多头潜在注意力)将KV Cache压缩至约1/8,DeepSeekMoE细粒度专家与无辅助损失负载均衡策略兼顾性能与稳定;FP8混合精度训练与MTP多Token预测进一步降低训练与推理成本。本文从Transforme

weixin_29095049的博客 270

DeepSeek大模型实战:从Transformer、MoE到API调用与微调部署

大语言模型基于Transformer自注意力机制构建,通过Q、K、V矩阵运算捕捉长距离依赖,而MoE混合专家架构则按token路由激活部分专家,显著降低推理计算量。DeepSeek API调用兼容OpenAI协议,本地部署可借助Ollama快速拉起量化模型,微调则常用LoRA冻结原权重、只训练低秩旁路矩阵。这些技术让大模型在私有知识问答、领域术语对齐、数据不出内网等场景中落地,兼顾成本与效果。本文围绕DeepSeek,拆解从概念到API调用、本地部署与微调实战的完整路径。

weixin_31100517的博客 249

arcgis导出自身相交数据

今天接到一个客户需求,一份面文件,里面有好多元素是两两相交甚至是三个相交的,现在要把这些重叠部分提取出来,并且把相交部分的原始要素的名称也保留在字段中,也就是说名称这个会有好多个名称字段,如果两个要素相交那就是前两个名称字段有值,后面的为空,如果是三个要素相交,那么输出的这个要素就是前三个名称字段有值,后面的为空,嗯,这里也不太确定会出现多少个名称字段,这个需要依照数据来定。 这是原始数据,...

miaowumi92的博客 6789

AutoCAD二次开发(.Net)之XData

对于CAD中的实体进行筛选等操作,常常会用到实体的XData属性,下面介绍一下实体的XData的增删改。 //XData的新增,修改跟新增一样,new一个ResultBuffer,赋值即可 Document doc=Application.DocumentManager.MdiActiveDocument; using (DocumentLock dl = doc.LockDocument()) { using (Transaction trans = doc.TransactionManager.S.

qq_21489689的博客 2593

Docker一键部署Synopsys EDA全家桶(VCS/Verdi 2018版)保姆级教程

本文提供了一份详尽的Docker容器化部署Synopsys EDA工具链(VCS/Verdi 2018版)的保姆级教程。通过环境隔离与标准化,解决传统安装的依赖冲突问题,并重点攻克了容器内GUI图形界面显示的核心难题。教程涵盖从Docker基础安装、镜像获取、容器启动配置,到使用X11转发或VNC实现Verdi完美显示的完整实践,旨在帮助芯片设计工程师快速构建稳定、可移植的一键化EDA工作环境。

weixin_29281941的博客 198

树莓派驱动步进电机

步进电机一般由电机、驱动器构成,树莓派连接驱动器控制电机。 一、接线 DIR+/- 用于控制方向,PUL+/- 用于控制转动; 正极DIR+ 和 PUL+ 接到GPIO口,两个负极接到GPIO口或地线均可,控制的时候不使用。 实验中,DIR+ 接35口,PUL+ 接38口。 树莓派4B GPIO口如图所示 远离树莓派USB的一侧 是 1、2、3号口 二、驱动 DIR控制方向,使用高电平或低电平控制; PUL控制转动,使用脉冲驱动。 三、代码 import RPi.GPI.

weixin_42337765的博客 1万+

C++语言程序设计教程第4版杨进才沈显君课后习题答案解析

为了更好地学习这门课程,我尝试在网上寻找一些学习资料和参考书籍,但效果并不是很理想。因此,我希望能有一些学长学姐或者是有经验的程序员能够分享一些学习经验和方法,让我更好地掌握这门课程。学习过程中,我发现这本书的内容非常丰富,讲解也非常详细,对于像我这样编程基础薄弱的学生来说,是一本非常实用的教材。同时,我也希望有经验的程序员能够推荐一些适合初学者的C++语言学习资料和工具,以便我能更好地学习和掌握这门课程。总之,希望能得到大家的帮助和支持,让我更好地学习和掌握C++语言程序设计。主 编: 杨进才,沈显君。

weixin_58833001的博客 1333

潇洒郎: 小白一次性成功——红米 Note 12 5G Android12 系统13.0.16/14.0.9 小米红米手机解BL锁+ROOT-刷面具—官方ROM下载-线刷降级—解锁system系统分区

小白一次性成功——红米 Note 12 5G Android12 系统13.0.16/14.0.9 小米红米手机解BL锁+ROOT-刷面具—官方ROM下载-线刷降级—解锁system系统分区

潇洒郎的博客 4585

IP-Guard安全网关实例

企业相关情况: 1.OA系统,主要为日常工作使用,该系统IP为192.168.1.2,端口为8080; 2.文件共享服务器,用于存放日常工作资料和文档,该文件共享服务器的IP为192.168.1.1,其中\\192.168.1.1\private 目录中的存放着公司重要文档,不能随意外传; 3.安全网关已采用串联的方式联入网络,IP为192.168.2.6,所有机器访问OA系统和文件共享服务...

IP-Guard专栏 707

C++ int转四字节数组

字节转换

我不是码农的博客~~~ 973

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

上一篇: 2025年LangChain(V0.3)开发与综合案例
下一篇: 大模型工具与案例:云服务器部署dify与使用
豆芽-无敌版
博客等级 码龄6年 888粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

豆芽-无敌版

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值