(1)大模型的提示词工程实践技巧---LLM输出配置详解

入门大模型后,如何优化其输出结果?丨“悟道之巅”公开课实录(2) 如果你错过了上一波深度学习引发的NLP范式转换,不要再错过这一波超大预训练模型的崛起。 近日,“悟道”核心团队推出首档公开课,公开课已全部上线,手把手帮助中国开发者理解并应用“悟道”,从而进一步挖掘“悟道”的潜力,开发自己的智能应用。 通过“悟道”公开课,开发者们将与预训练模型这一人工智能领域最重要的趋势保持同步,更有125万+“悟道之巅”比赛奖金可以拿(比赛官网)。 本次课程可以看做是面向所有人的大规模预训 阅读详情

LLM输出本质是一个预测引擎,它的输出是基于概率的下一个最可能出现的token预测,因此提示词工程即引导模型预测最符合期望的token序列的过程。

LLM输出配置详解

1. 输出长度控制

生成更多令牌需要 LLM 进行更多计算,导致更高的能耗、可能更慢的响应时间以及更高的成本。
设置输出长度(Output length)

一个重要的配置设置是响应中要生成的令牌数量。生成更多令牌需要 LLM 进行更多计算,导致更高的能耗、可能更慢的响应时间以及更高的成本。

🚫关键误区:限制令牌数量 ≠ 内容简洁

减少 LLM 的输出长度并不会使模型在其创建的输出中变得风格或文本上更简洁,它只是导致 LLM 在达到限制时强制截断。

实例对比:

设置 max_tokens=20 时:

原本完整输出:人工智能的发展对教育领域产生了深远影响,主要体现在以下几个方面:个性化学习、智能评估、辅助教学...
截断后输出:人工智能(AI)如今已渗透到各行各业,极大地改变了我们的生活和工作方式。以下是当前AI的主要...

如何正确控制输出长度?

在提示中明确指令
❌ 错误:设置 max_tokens=50
✅正确:提示中加入"用2-3句话总结"

实践建议

  • 快速问答:100-200 tokens
  • 详细解析:500-1000 tokens
  • 长文创作:1000+ tokens

2. 采样控制:温度、Top-K和Top-P

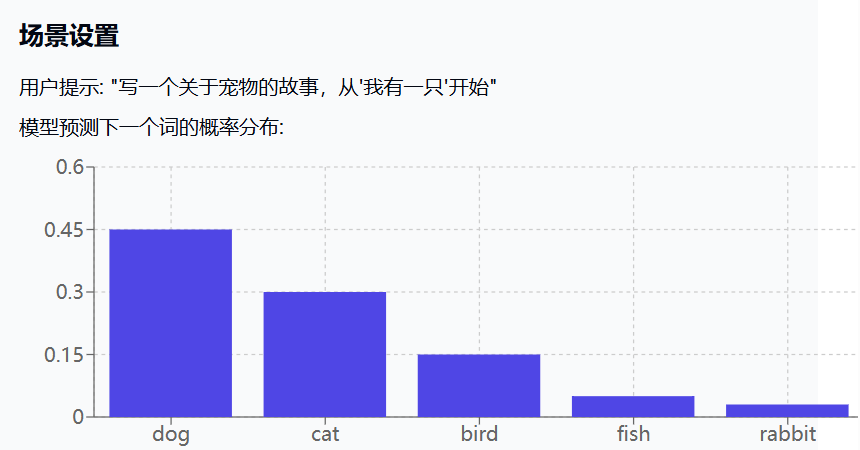
LLM并不是直接选择下一个令牌,而是输出一个概率分布——词汇表中的每个可能令牌都有其出现的概率。
这三个参数都是决定了输出的多样性和随机性。

温度(Temperature)

温度控制输出的随机性和多样性。它本质上是对概率分布进行"reshaping"的过程

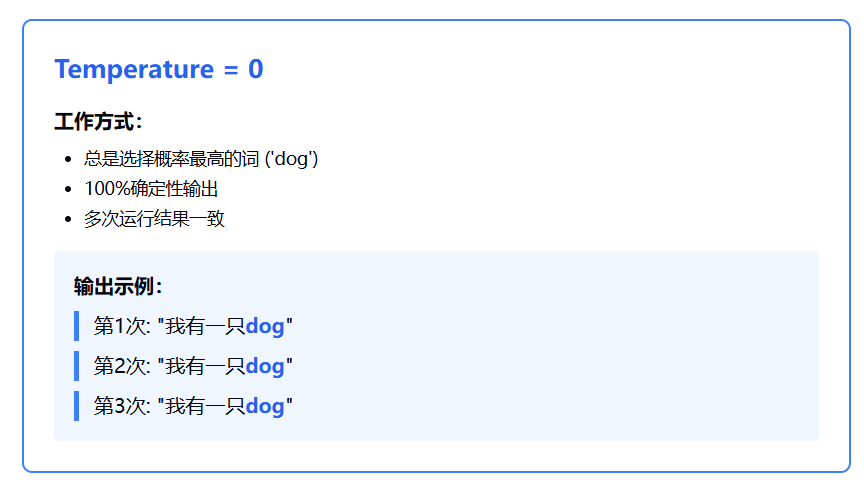
Temperature = 0 (贪婪解码)

  • 总是选择概率最高的令牌
  • 输出完全确定性(除非存在多个概率高且相同的令牌)
  • 适用场景:数学计算、代码编写、精确事实回答

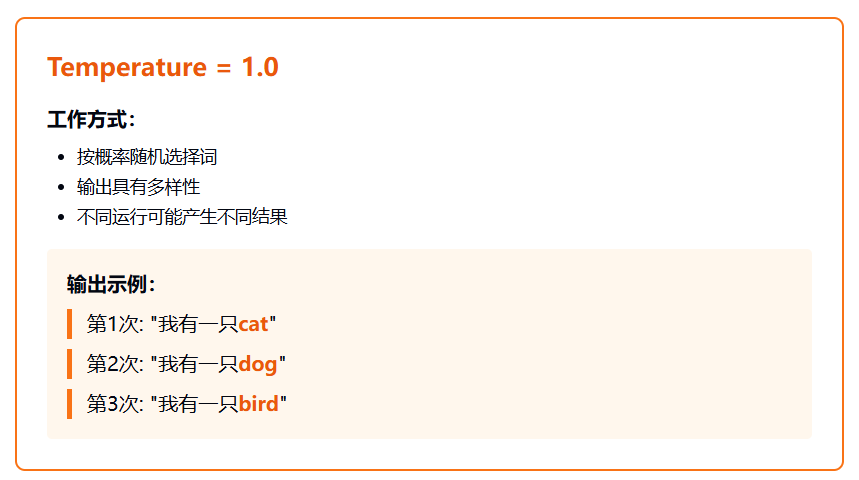
Temperature = 0.8-1.0+ (高温)

  • 高度创造性和多样性
  • 适用:创意写作、头脑风暴、创新方案
    在这里插入图片描述
    在这里插入图片描述
    在这里插入图片描述
Top-K采样

Top-K只考虑概率排名前K位的令牌,像一个"精英选拔器"。

场景:
场景:猫坐在___上面

原始概率分布:

  • 地毯:0.30(第1)
  • 沙发:0.25(第2)
  • 椅子:0.15(第3)
  • 桌子:0.10(第4)
  • 地板:0.08(第5)
  • 窗台:0.05(第6)
  • 柜子:0.03(第7)
  • 床:0.04(第8)

Top-K=3时:只考虑【地毯、沙发、椅子】
Top-K=5时:考虑【地毯、沙发、椅子、桌子、地板】

Top-K的特性:
K=1:等同于贪婪解码
K值越大:选择空间越广,输出越多样
固定选择数量:不考虑概率差异大小

Top-P (核采样)

Top-P选择累积概率达到P的令牌集合,像"智能筛选器"。

场景:
同上场景,Top-P=0.70(70%)

累积过程:

  • 地毯:0.30 → 累积30%
  • 沙发:0.25 → 累积55%
  • 椅子:0.15 → 累积70%(达到阈值)

最终候选:【地毯、沙发、椅子】

总结
参数设置影响结果其他参数状态
温度 = 0完全确定性:总是选择概率最高的tokenTop-K、Top-P变得无关紧要
温度 > 1 (如10)完全随机化:均匀采样所有可用token温度本身变得无关紧要
Top-K = 1直接选择:强制选择概率最高的token温度、Top-P失去作用
Top-K = 词汇表大小无限制采样:所有非零概率token都可用不会筛选掉任何token
Top-P ≈ 0近似确定性:几乎只考虑最高概率token温度、Top-K无效
Top-P = 1无限制概率:所有非零概率token都可用不过滤任何token

标准创造力平衡(默认推荐)
用于:文章写作、对话生成、常规任务

{
  "temperature": 0.2,
  "top_p": 0.95,
  "top_k": 30
}

高创意模式
用于:创意写作、头脑风暴、新颖输出

{
  "temperature": 0.9,
  "top_p": 0.99,
  "top_k": 40
}

事实准确模式
用于:技术文档、事实陈述、正式回答

{
  "temperature": 0.1,
  "top_p": 0.9,
  "top_k": 20
}

确定性模式
用于:数学计算、逻辑推理、有唯一正确答案的任务

{
  "temperature": 0
}

浦语提示词工程实践 大模型提示词是关键基础,应用最为广泛Prompt是一种用于指导以大语言模型为代表的生成式人工智能生成内容(文本、图像、视频等)的输入方式。它通常是一个简短的文本或问题,用于描述任务和要求。Prompt可以包含一些特定的关键词或短语,用于引导模型生成符合特定主题或风格的内容。例如,如果我们要生成一篇关于“人工智能”的文章,我们可以使用“人工智能”作为Prompt,让模型生成一篇关于人工智能的介绍、应用、发展等方面的文章。 阅读详情

相关推荐

Dify LLM 配置参数详解

这是设置部分的主标题- 设置为0.7- 设置为1- 设置为0- 设置为0- 设置为512- 设置为0- 显示"请选择"- 显示"输入序列并按Tab键"这些参数控制Dify应用中AI模型生成回答的方式,影响创造性、多样性、重复性、长度和输出格式。

AI Agent 首席体验官 5610

4种控制LLM大模型输出JSON的方法

JSON 是全球使用最广泛的数据交换格式之一,支持我们的所有需求。在构建人工智能驱动的应用程序时,工程师不可避免地需要将大型语言模型(LLM)的输出集成到他们的代码库中。通过指示 LLM 使用特定的语法或模式,然后输出应用程序所需的生成结果,我们可以使应用程序的行为更加可预测。简而言之,JSON 的互操作性使其成为数据交换的首选。

新缸中之脑 2万+

Hyper-V显卡直通实战:手把手解决Windows 11虚拟机错误码43(附完整参数配置)

本文详细解析了在Windows 11 Hyper-V虚拟机中配置显卡直通时遭遇错误码43的根源,并提供了从环境检查、核心PowerShell命令(如Set-VMGpuPartitionAdapter)配置到虚拟机内驱动替换的完整实战解决方案,帮助用户彻底解决显卡驱动无法加载的问题。

weixin_29238147的博客 899

『深度长文』4种有效提高LLM输出质量的方法!

微调的首要步骤是数据的收集和标注。成功的微调依赖于一个。

2401_85378759的博客 1348

【03】海康MVS V4.3.0 ——安装教程、查看示例、库、头文件、开发指南

海康威视MVS机器视觉软件安装与使用指南:首先从官网下载MVS 4.3.0安装包,默认设置完成安装。安装后可在Development目录查看示例代码、开发文档及头文件,支持C++/C#/Python等多语言开发。软件内置虚拟相机功能,通过工具菜单添加虚拟设备后即可模拟真实相机操作,支持中英文界面切换、参数调节(曝光/增益等)及图像采集功能。虚拟相机虽仅能显示预设图像,但完整保留了参数调节功能,适合开发者进行功能测试。

程序员,他们想的是什么?他们想的永远都是技术,他们崇尚的也永远都是技术。 3311

单路径微分相除和微分自乘相减算法(PGC-SDD-DSM)

PGC-SDD-DSM算法通过融合单路微分相除和差分自乘,解决了传统PGC解调技术对调制深度和光强干扰敏感的问题,显著提升了解调稳定性和抗失真能力。其高信噪比、低谐波失真以及对参数变化的鲁棒性,使其在光纤传感领域具有重要应用价值。PGC-SDD-DSM算法在计算复杂度方面具有显著的优势,主要体现在其高稳定性和低谐波失真上。这些优势使其在光纤光学干涉传感器中表现出色,尤其是在面对光强干扰和调制深度变化时。

百态·数智思维 | 聚焦大数据、量化与未来AI 841

AI-大语言模型LLM-Transformer架构6-输出层

本文介绍了Transformer架构中的输出层部分,主要包括Linear层和Softmax层。Linear层是一个简单的单层感知机,负责将解码器输出的语义向量映射回词表空间,与编码器的Embedding层作用相反。Softmax层则将Linear输出的词得分向量转换为概率分布,通过指数归一化处理实现数值稳定性,最终选择概率最大的词作为输出。这两层共同完成了从语义表示到具体词汇的转换过程,是Transformer生成结果的关键步骤。

tuguai7887的博客 712

要配置西门子G120XA变频器实现**端子启停**和**Modbus RTU(485)频率给定

如有问题,可通过STARTER软件在线诊断Modbus通讯状态。要配置西门子G120AX变频器实现。

微:13763355074 4849

[提示词工程] LLM输出配置

一旦选择了模型,就需要确定模型的配置。大多数LLM(大型语言模型)都提供了多种配置选项,用以控制其输出。高效的提示工程要求根据任务对这些配置进行优化设置。

weixin_49513705的博客 811

【仓颉 + 鸿蒙 + AI Agent】CangjieMagic框架(3):Agent请求和响应

CangjieMagic框架:使用华为仓颉编程语言编写,专门用于开发AI Agent,支持鸿蒙、Windows、macOS、Linux等系统。这篇文章剖析一下 CangjieMagic 框架中的 AgentRequest 和 AgentResponse。

九丘教育官方博客 1475

基于STM32设计的老人摔倒检测报警系统(OneNet+MQTT)(235)

基于STM32设计的老人摔倒检测报警系统,不仅能够实时监测老人的位置信息,方便在紧急情况下快速定位,还能通过陀螺仪模块精确检测老人的身体姿态,一旦判断为摔倒状态,系统将立即触发蜂鸣器报警,并通过4G网络向指定联系人发送短信警示,确保老人能够迅速得到援助。此外,系统还支持老人主动按下设备上的按键发送求助短信,增强了系统的灵活性和实用性。

4691

大模型提示词工程实践:提示词工程实践-引导大模型完成任务

摘要 本课程介绍了如何使用提示词引导大模型完成具体任务,重点讲解了通过提示词调用大模型的实践技巧。课程内容包括:1)安装依赖库和初始化LLM配置;2)解析模型输出的工具函数实现;3)构建调用函数并详解prompt、temperature等关键参数;4)通过客户评论情感分析案例,演示如何设计提示词生成专业邮件回复。案例中对比了不同temperature值对输出多样性的影响,展示了如何调节参数优化模型表现。学习目标是掌握大模型调用方法及提示词工程的基本原理。

WSSWWWSSW的博客 1181

银行统一监管报送系统

依据《银行业金融机构数据治理指引》,银行业金融机构应当建立适应监管数据报送工作需要的信息系统,实现流程控制的程序化,提高监管数据加工的自动化程度。银行业金融机构应当将监管数据纳入数据治理,建立工作机制和流程,确保监管数据报送工作有效组织开展,监管数据质量持续提升。银行通常要对接报送EAST5.0、1104、CRSS等近40个监管应用,涉及近1000张报表。表13-01是主要的监管报送应用、报送依据、报送规范、监管机构名称。

银行信息系统应用架构详解 4350

七天入门LLM大模型 |提示词工程-Prompt Engineering

最核心的写一条好prompt的原则就是尽可能清晰、明确地表达你的需求(类比产品经理向程序员提需求)。

python1234_的博客 2501

Open3D(C++) 点云构建三维Delaunay三角剖分

C++版本的Open3D实现从点云构建三维Delaunay,可视化效果。

点云侠的博客 2247

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

大模型提示词工程实践

core dumped 或 triton test fail。

fengyanziup的博客 1846

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

七天入门大模型 :提示词工程 Prompt Engineering,最全的总结来了!

最核心的写一条好prompt的原则就是尽可能清晰、明确地表达你的需求(类比产品经理向程序员提需求)。细分下来,具体原则包括:清晰的指令:足够清晰明确地说明你希望模型为你返回什么,最后更加细致地说明需求,避免模糊表达。提供上下文和例子:给出较为充分的上下文信息,让模型更好地理解相关背景。如果能够提供示例,模型能表现更好(类似传统LLM中的in-context learning)。善用符号和语法:使用清晰的标点符号,标题,标记有助于转达意图,并使输出更加容易被解析。

2201_75499313的博客 6992

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

【大模型炼丹指南 03】提示词工程

最核心的写一条好prompt的原则就是尽可能清晰、明确地表达你的需求(类比产品经理向程序员提需求)。足够清晰明确地说明你希望模型为你返回什么,最后更加细致地说明需求,避免模糊表达。给出较为充分的上下文信息,让模型更好地理解相关背景。如果能够提供示例,模型能表现更好(类似传统LLM中的in-context learning)。使用清晰的标点符号,标题,标记有助于转达意图,并使输出更加容易被解析。

一个程序猿的AI转型之路 2105

“LLM大模型学习精华系列(二):提示词工程与实战技巧“

最核心的写一条好 prompt 的原则就是尽可能清晰、明确地表达你的需求(类比产品经理向程序员提需求)。清晰的指令:足够清晰明确地说明你希望模型为你返回什么,最后更加细致地说明需求,避免模糊表达。提供上下文和例子:给出较为充分的上下文信息,让模型更好地理解相关背景。如果能够提供示例,模型能表现更好(类似传统 LLM 中的 in-context learning)。善用符号和语法:使用清晰的标点符号,标题,标记有助于转达意图,并使输出更加容易被解析。

2401_84495872的博客 1033

七天入门LLM大模型 | 2:提示词工程-Prompt Engineering

前一天我们讲到:prompt(提示词)是我们和LLM互动最常用的方式,我们提供给LLM的Prompt作为模型的输入,并希望LLM反馈我们期待的结果。

Langchain的博客 1916

七天入门LLM大模型 | 第二天:提示词工程-Prompt Engineering

最核心的写一条好prompt的原则就是尽可能清晰、明确地表达你的需求(类比产品经理向程序员提需求)。细分下来,具体原则包括:清晰的指令:足够清晰明确地说明你希望模型为你返回什么,最后更加细致地说明需求,避免模糊表达。提供上下文和例子:给出较为充分的上下文信息,让模型更好地理解相关背景。如果能够提供示例,模型能表现更好(类似传统LLM中的in-context learning)。善用符号和语法:使用清晰的标点符号,标题,标记有助于转达意图,并使输出更加容易被解析。

2401_85375186的博客 1468

提示词工程实战指南:5大技巧大幅提升LLM输出质量

本文结合OpenAI API实战案例,详解如何通过系统化提示词设计优化大型语言模型(LLM)输出效果。包含少样本学习、结构化指令、思维链推理等核心技巧,附完整代码示例。

m0_63137469的博客 1428

LLM 大模型学习必知必会系列(二):提示词工程-Prompt Engineering 以及实战闯关

最核心的写一条好 prompt 的原则就是尽可能清晰、明确地表达你的需求(类比产品经理向程序员提需求)。清晰的指令:足够清晰明确地说明你希望模型为你返回什么,最后更加细致地说明需求,避免模糊表达。提供上下文和例子:给出较为充分的上下文信息,让模型更好地理解相关背景。如果能够提供示例,模型能表现更好(类似传统 LLM 中的 in-context learning)。善用符号和语法:使用清晰的标点符号,标题,标记有助于转达意图,并使输出更加容易被解析。

2401_85325397的博客 1699

动手学大模型LLM应用开发之提示词工程(Prompt Engineering)

提示工程(Prompt Engineering)是一个相对较新的研究方向,用于研究如何编写和优化提示池,以便更好、更有效地使用大语言模型。我们每一次访问大模型,给模型的输入就是 Prompt,大模型给我们的返回结果我们称之为 Completion。

lcx_nanmu的博客 6129
上一篇: 一、大模型原理:第一步分词Tokenization
下一篇: 二、大模型原理:图文解析Transformer原理与代码
豆芽-无敌版
博客等级 码龄6年 888粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

豆芽-无敌版

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值