
评估每种大模型需要多少GPU显存方法与技巧

llama2模型部署方案的简单调研-GPU显存占用(2023年7月25日版) llama2显存占用,本地部署,本地推理 阅读详情
AI摘要

博客介绍了大模型显存需求计算方法,推荐使用在线“大模型显存计算器”,并以DeepSeek 7B模型为例,说明了推理、全参数微调、部分参数微调三种情况下的显存需求。还给出内存需求经验法则,同时阐述了如何根据硬件条件选择合适的模型规模。

在这里插入图片描述

若您对大模型的名称后缀比如7b/-instruct…还不太明确,推荐您先阅读LLM模型名称解读

大模型显存需求计算

这里推荐一个在线的"大模型显存计算器",可以准确计算选用的模型在不同使用场景下的显存需求。
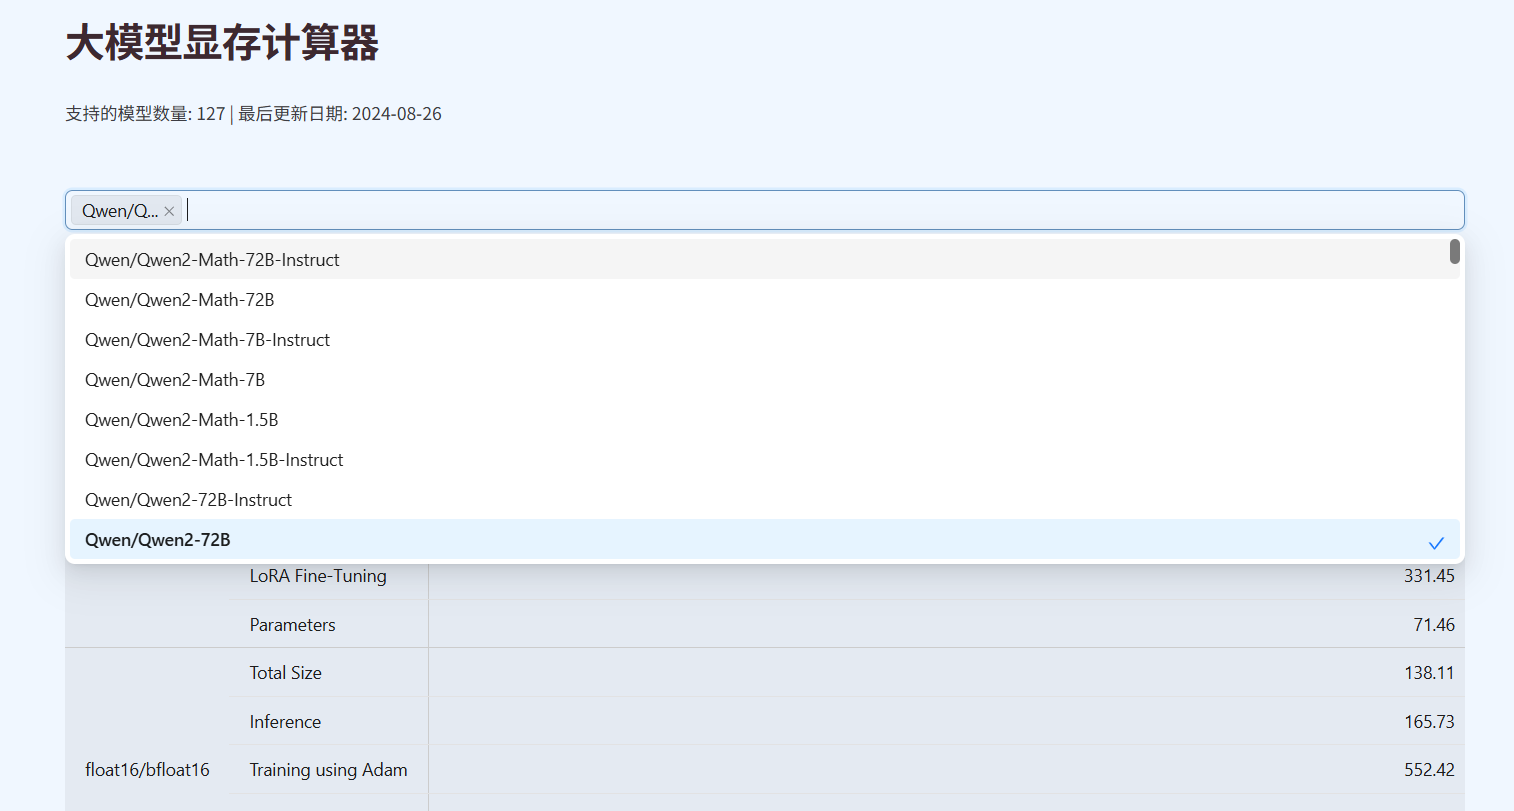
在这里插入图片描述

对于一个大模型来说,显存需求主要分为三种情况:

  1. 推理(Inference)时的显存需求:模型用于生成回答时需要的显存
  2. 全参数微调(Fine-tuning)时的显存需求:对模型所有参数进行调整时需要的显存,很少用一般不关注
  3. 部分参数微调(LORA等)时的显存需求:只更新部分参数时需要的显存

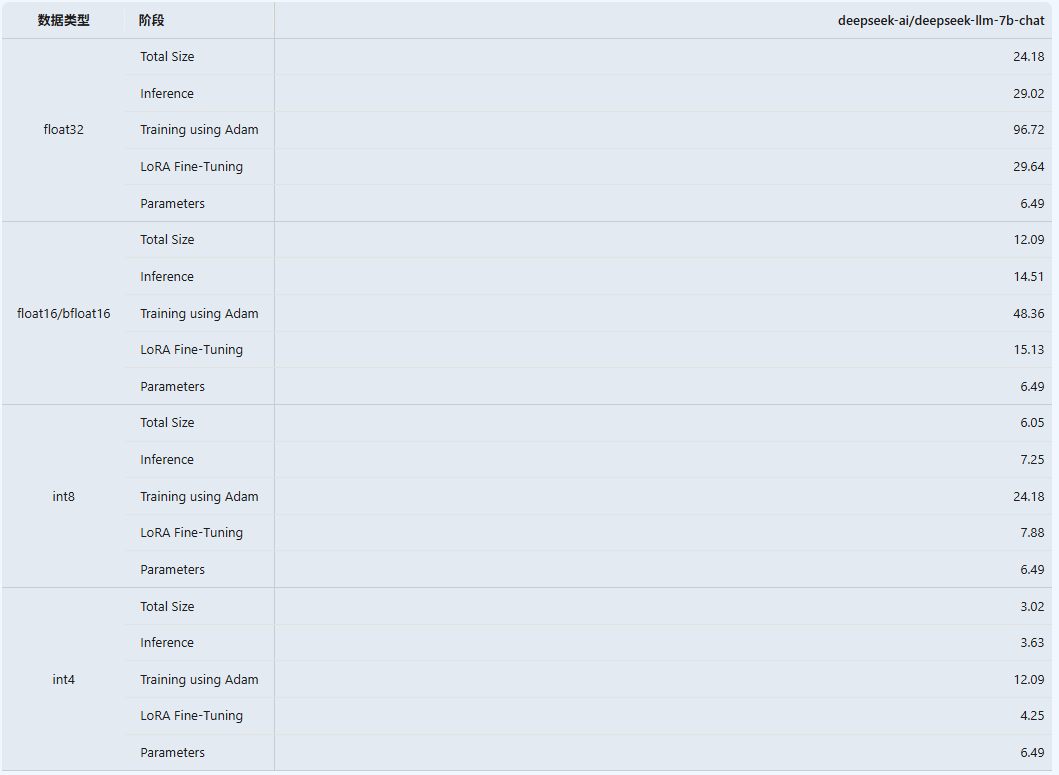
以DeepSeek 7B模型(70亿参数)为例如下图,在FP16精度(每个参数占用16位或2个字节)下:

  • 推理时需要约14.5GB显存
  • 全参数微调时需要约48GB显存
  • 部分参数微调时需要约15GB显存
    综上我们如果选用deepseek7b大约需要14~15G显存。

📋另外有个小技巧,内存需求经验法则:拥有X B参数的模型通常需要约2X GB的显存。比如这里的7B一般就是占用7*2G显存。
这些相对于原来模型小的模型不是从零开始训练的,而是通过对更大模型进行优化和降维得到的。这些模型是通过知识蒸馏、量化等技术从更大的预训练模型中"压缩"得到的。
在这里插入图片描述

大模型显存需求计算方法

对于大模型的显存需求,我们可以用一个简单的经验法则来估算:拥有X B参数的模型在FP16(半精度)格式下通常需要约2X GB的显存进行推理。例如:

  • 0.5B参数模型在FP16下需要约1GB显存
  • 7B参数模型在FP16下需要约14GB显存
  • 70B参数模型在FP16下需要约140GB显存

当然,这只是基本的参数存储需求,实际运行时还需要考虑额外的缓存、激活值和其他临时变量的存储空间。这就是为什么即使是7B模型,在推理时实际也常常需要15GB以上的显存。

利用量化技术(如4-bit量化),可以进一步降低显存需求,使更大的模型能够在普通硬件上运行。例如,一个7B模型经过4-bit量化后,理论上只需要约4GB的显存就能进行推理。

这种通过蒸馏和量化得到的小型模型,虽然与原始大模型相比有一定的性能损失,但在许多场景下仍然能够提供令人满意的结果,同时大大降低了硬件要求,使AI技术更加平民化,这也是目前大模型发展的一个重要方向。

如何选择合适的模型规模

根据你的硬件条件选择合适的模型规模是非常重要的。一般推荐选择占用机器显存的2/3内。例如:

  • 如果你使用的是RTX 4090显卡(24GB显存),可以轻松部署7B级别的模型进行推理或部分参数微调
  • 如果你拥有两张RTX 4090(总共48GB显存),甚至可以进行7B模型的全参数微调

对于更大规模的模型,如DeepSeek 67B模型,推理时需要约148GB的显存。如果是满血版的DeepSeek 671B,显存需求将是前者的十倍,高达1480GB!这就需要多张高端GPU,比如10-15张NVIDIA H200(每张96GB显存)才能满足需求。

大模型不同参数下的模型显存计算公式 在这个基础上跑一次原始参数量的推理(不需要梯度和优化器状态,但仍然需要一些显存来存储运算过程的数据),合起来就是LoRA的所需要的显存。例:原本需要微调1024×512的参数,用了LoRA之后,如果选择的 Rank=8,则只需要微调这么多参数:1024×8+512×8。以 7B-BF16 版本为例,需要显存 = 数量 * 类型大小 = 70亿 * 2字节 = 140亿字节。LoRA 只需要给原始模型做推理,训练一个更小的模型来实现和训练原始参数差不多的效果。优化器的状态:参数量的2倍。 阅读详情

相关推荐

deepseek7B大模型部署精讲:从硬件到软件(ollama+dify)

2023年用GPU云主机在优班图上搭建过xinference+dify后对AI有初步概念,2024年1月后,和另外一个同事聊天时候了解某东3060卡1800左右,就入手一张,在windows环境上对AI的底层到软件部署到开发一步步的实操,通过“格物致知”对大模型有更新的认识,本

菩提云,深入交流云技术与java开发 2940

大模型入门2: 指令微调

微调7B模型需要3×28G的显存(SGD+Momentum),至少需要2张A100的显卡才能满足。

yuetan的博客 9032

大模型显存占用评估完整指南

大模型的显存大小,与大模型本身的参数量有关,与是训练还是推理过程有关,而训练过程采用的训练参数以及推理过程采用的推理参数也会影响。模型参数量:决定了模型权重的基础存储需求运行模式:训练过程需要存储梯度和优化器状态,显存需求远高于推理训练方法:全参数微调、LoRA、QLoRA等不同方法的显存需求差异巨大量化精度:FP32、FP16、INT8、INT4等不同精度直接影响显存占用推理参数:批次大小、序列长度、KV缓存等都会显著影响推理时的显存需求。

羊城迷鹿的博客 1095

训练大模型所需要的内存计算

训练一个7B参数的大模型,显存需求大约为120-144 GB。实际需求可能因实现和硬件不同而有所变化。使用来训练模型可以显著减少显存占用,因为 BF16 每个参数仅占用2 字节(16 位),而不是 FP32 的 4 字节。使用BF16训练一个 7B 参数的大模型,显存需求大约为88-106 GB。相比 FP32 的 120-144 GB,BF16 可以节省约 25-30% 的显存。

asd8705的专栏 5979

记录思科cisco交换机升级iso步骤

Cisco Nexus 93180交换机版本升级

a635161812的博客 4378

【计算机组成原理实验】状态机实验

理解“状态机”概念,掌握“状态机”思想描述时序系统。通过下列三种基于D触发器的计数器结构,构建状态机的状态转移电路:环形计数器、扭环计数器和条件判断的扭环计数器。基于“状态机”原理,设计一个“交通灯”系统:控制红黄绿信号灯按照以下顺序循环点亮:“绿 黄 红 绿 ……”,红灯、绿灯和黄灯的亮灯持续时间可以通过拨码开关独立设置。红灯和绿灯是持续亮灯模式,黄灯则是闪烁亮灯模式。

Rover_jb的博客 1332

大模型到底需要消耗多少GPU显存?公式和工具全都有

如何计算大模型到底需要多少显存,是常常被问起的问题。现从实用角度介绍一个简单公式和一个工具方便大家工作中使用。1)估算公式(该公式来自于Sam Stoelinga简化[1])注意:该公式只是为了简化计算的估计,并未包含kvcache所需显存以及context大小的影响。下面以运行16位精度的 Llama 70B 模型所需的 GPU 内存为例套用公式:该模型有 700 亿参数。由此可见,模型所需的 GPU 内存相当大。

m0_59164304的博客 7503

Win10安装Nek5000

1 安装wsl 2 2 安装Nek5000 3 安装依赖项 4 安装openmpi 5 配置Nek5000 6 编译Nek5000 7 运行Nek5000算例 8 安装paraview并查看结果

weixin_43176703的博客 3451

部署大模型需要多少GPU显存?一文教你精准计算!

在大模型推理时,文本是逐个token生成的。为了加速这个过程,我们使用KV Cache机制来缓存中间计算结果。如果没有KV Cache,每生成一个新token,都需要重新计算之前所有token的注意力权重,这会导致大量重复计算,严重影响推理效率。通过本文的计算方法,你可以快速估算任何大模型✅ 模型参数量 × 参数精度✅ KV Cache = 层数 × Hidden维度 × 上下文长度 × 并发数✅ 其他开销约为总和的10%本文计算基于标准KV Cache推理方式实际还有许多显存优化技术。

2401_85375298的博客 915

YOLOv8改进:基于EfficientNetV2均衡缩放网络的特征提取层优化【YOLOv8】

YOLO(You Only Look Once)系列模型以其高效的实时目标检测能力而闻名。YOLOv8作为该系列的最新版本,通过引入改进的网络结构和算法优化,进一步提升了目标检测的性能。然而,YOLOv8在特征提取阶段的网络结构仍有改进的空间。EfficientNetV2是一种基于均衡缩放的卷积神经网络,它通过优化网络的宽度、深度和分辨率来实现高效的特征提取。与之前的EfficientNet版本相比,EfficientNetV2在速度和精度上都有显著提升,尤其在处理复杂目标检测任务时表现尤为突出。

博客 1582

【MATLAB代码】基于水声通信(ACOMMS)下的到达时间差(TDOA)定位的AUV自主导航例程,附完整代码

水下AUV导航系统仿真研究 本研究基于到达时间差(TDOA)技术实现了水下自主航行器(AUV)的三维导航仿真系统。系统采用四个声学信标作为定位基准,通过TDOA测量数据迭代求解AUV位置。仿真结果表明: 导航性能:系统能够有效跟踪AUV从起点(30,30,-20)到目标点(70,70,-20)的航行轨迹,定位误差保持在合理范围内。 误差分析:定位误差变化曲线显示系统具有稳定的定位精度,平均误差为0.5米左右。 技术特点:采用两步最小二乘迭代算法求解非线性TDOA方程,提高了定位精度和计算效率。 该仿真系统为

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 320

大模型推理部署实战:从 GPU 显存管理到高并发服务化的全链路设计

LLM 推理部署的核心挑战是 GPU 显存管理和高并发调度。PagedAttention 解决了 KV Cache 的显存碎片问题,Continuous Batching 提升了 GPU 利用率,Prefill/Decode 分离优化了延迟分布。但这些优化都有其适用前提和代价。落地路线建议:第一步,根据模型规模和 QPS 需求计算 GPU 资源需求,确定并行策略;第二步,部署 vLLM 推理引擎,配置 PagedAttention 和 Continuous Batching;

dicky_zhang3的博客 5624

为什么 CL_DEMO_OUTPUT 不能用于生产用途:不仅是 demo 标签那么简单

摘要:CL_DEMO_OUTPUT 虽能快速展示ABAP数据,但存在严重生产风险:1) 官方定位为示例工具,不承诺兼容性与支持;2) 非Released API,云环境直接不可用;3) 依赖SAP GUI,缺乏日志关键特性;4) 存在版本漂移、类型限制、性能隐患及安全缺口。典型事故案例包括后台Job崩溃、Gateway链路污染和云迁移失败。生产环境应改用结构化日志(如SLG1)或稳定API输出,避免将调试工具误作工程方案。(149字)

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 131

玩转大模型,你的GPU显存够用吗?一文看懂估算方法

日常做项目,对大模型的私有化部署也有刚需,花点时间深入研究了下模型使用和GPU显卡配置的关系,做个记录。

2301_81940605的博客 3047

基于PointNet++网络的点云数据分类仿真分析

局部特征学习模块用于学习点云中每个点的局部特征表示,而全局特征学习模块用于学习整个点云的全局特征表示。点云数据分类是指将点云数据分为不同的类别或标签。PointNet++是一种用于点云数据处理的深度学习网络,它能够有效地学习点云数据的特征表示并实现高精度的分类。在本文中,我们将使用MATLAB实现基于PointNet++网络的点云数据分类仿真分析,并提供相应的源代码。然后,我们使用splitEachLabel函数将数据划分为训练集和测试集,其中80%的数据用于训练,20%的数据用于测试。

HackDashX的博客 210

C++ 图像线特征提取(CannyLine算法+opencv3.4.6)

C++ 图像线特征提取(CannyLine算法+opencv3.4.6)

weixin_43896283的博客 1084

【大模型LLM】GPU计算效率评估指标与优化方法:吞吐率

GPU计算效率评估指标与优化方法:吞吐率

weixin_43988131的博客 1959

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

大模型训练的GPU资源评估

GPU需求数与算力需求和显存需求数有关,具体计算公式为:GPU需求数 = max(算力需求,显存需求)

程序员鑫港的博客 2539

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

显存评估方法论:准确预测大模型推理所需显存消耗

在大模型部署中,显存不足或资源浪费是常见痛点。通过 ms-swift 框架的‘一锤定音’脚本,可在不加载模型的情况下精准预估推理所需显存,综合考虑权重、KV Cache、激活值与运行时开销,支持多模态与并行策略,实现轻量、可集成的非侵入式评估,推动显存规划从经验走向工程化。

weixin_29041443的博客 802

LLM 面试:为大模型提供服务需要多少 GPU 显存?

在几乎所有的 LLM 面试中,有一个问题总是会被提及:“这不仅仅是一个随机的问题——它是一个关键指标,反映了你对这些强大模型在生产环境中部署和可扩展性的理解程度。当你使用 GPT、LLaMA 或任何其他 LLM 时,了解如何估算所需的 GPU 内存是至关重要的。无论你是在处理一个 70 亿参数的模型,还是更大的模型,正确地配置硬件以支持这些模型至关重要。

2301_81888214的博客 1174

大模型显存优化:简单有效的入门方法

本章是基础入门部分,帮助读者建立大模型工程化的初步认知。通过本章学习,你将全面掌握"大模型显存优化:简单有效的入门方法"这一核心主题。

未来 95% 的 AI 应用将变得隐形,广泛融入日常生活。 1万+

部署大型语言模型 (LLM) 服务需要多少 GPU 显存?

了解为 LLM 服务的 GPU 显存需求不仅仅是一个面试问题,更是现实世界的必需。下次部署模型或在面试中回答这个问题时,希望大家可以有精确的数学计算来支持您的答案。一般来说,FP16 中的 7B 参数模型需要约16.8GB 的 VRAM。利用量化、分流到CPU或多 GPU并行设置来优化显存占用。根据模型大小选择 GPU:16GB VRAM 用于小型模型,24GB 以上用于大型模型。对这些数字了解得越多,就越有信心在生产中优化和部署 LLM!

Z4400840的博客 1814

【优快云首发】大模型微调实战指南:从原理到GPU资源评估,一篇搞定!

大模型微调是在预训练模型基础上,利用特定领域数据进行的针对性训练,使其在特定任务上表现更专业。微调方法包括全参数微调和参数高效微调(如LoRA)。微调流程包括明确目标、数据准备、选择模型与方法、训练执行、评估迭代和部署应用。LoRA等参数高效微调技术大幅降低了显存需求,使个人和中小企业也能在消费级GPU上微调大模型,实现AI应用的定制化。

2301_80239908的博客 1187

手把手教你计算大模型GPU显存:Llama 70B实战案例

本文详细介绍了大模型GPU显存计算方法,以Llama 70B为例,分析模型权重显存(140GB)、KV Cache显存(800GB)和其他开销(94GB),总计约1TB支持10并发用户。文章提供优化建议,如减少并发数或上下文长度可降低显存需求,并指出显存计算是部署大模型的关键门槛,后续将介绍显存优化技术。

lvaolan168的博客 1326
上一篇: LLM模型名称解读
下一篇: 2025年LangChain(V0.3)开发与综合案例
豆芽-无敌版
博客等级 码龄6年 888粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

豆芽-无敌版

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值