Unity Burst编译

unity多线程Burst+Job System Unity自己本身UnityEngine所使用的API是不能被多线程调用的,它没有向用户开放线程接口,所以Unity是不能使用多线程的,但是C#中可以使用多线程,Unity使用C#进行脚本编辑,故而Unity也可以通过C#来调用多线程。JobSystem 是Unity Dots(多线程运行框架)的核心组件之一,也可以把它拿出来利用多线程帮我们处理一些运算,比如视锥体剔除等。1、同一时间执行多个相同的任务,专门用于操作 Transform 的 Parallel Job。IJob:执行方法示例。 阅读详情

官网文档:https://docs.unity3d.com/Packages/com.unity.burst@1.8/manual/index.html

Unity 之Burst 底层原理:https://zhuanlan.zhihu.com/p/623274986

Burst 编译器入门(五):https://developer.unity.cn/projects/5e62f15eedbc2a1feeebb83e

LLVM:https://llvm.org/

LLVM:https://aosabook.org/en/v1/llvm.html

編譯器 LLVM 淺淺玩:https://medium.com/@zetavg/%E7%B7%A8%E8%AD%AF%E5%99%A8-llvm-%E6%B7%BA%E6%B7%BA%E7%8E%A9-42a58c7a7309#20b5

一个故事看懂CPU的SIMD技术:https://www.cnblogs.com/xuanyuan/p/16048303.html

介绍

  • Burst 是一个编译器,目的是把代码跑的更高效。主要优化技术密集的任务。
    • LLVM的激进优化。
      • SIMD向量化:循环操作转为单指令多数据指令。(一个加法变四个加法一起算)
      • 循环展开:if等分支展开,比如经常true的再优化。Hint intrinsics
      • 自动内联:把小函数自动内联展开。
      • 无GC检测:因为操作都是非托管数据,所以省去一些不必要的检测。
  • 2019年官方说的: Burst必须只能在JobSystem中使用,其他地方是不能用的。
  • 从 IL/.NET 字节码转换为使用 LLVM 编译器的优化原生 CPU 代码。
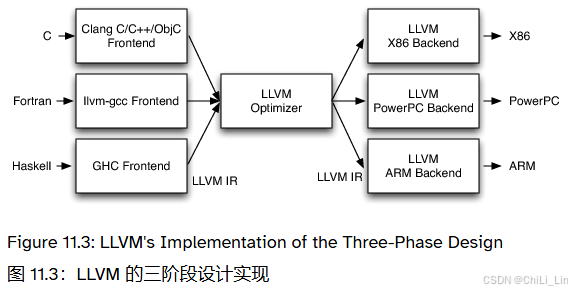
    • C#代码 -> IL -> LLVM IR -> 原生机器码
  • 适用于:
    • 物理碰撞。
    • 粒子系统刷新。
    • 图形算法处理。

LLVM

  • 模块化编译器,是一组库,可以针对特定问题优化。
    在这里插入图片描述
    在这里插入图片描述

和 IL2CPP 的关系

  • 互不影响,两套编译方式。

  • 普通代码走IL2CPP编译成C++机器码。

  • 标记[BurstCompile]的代码,有Burst单独编译优化,生成更高效的机器码。

调试

  • https://docs.unity3d.com/Packages/com.unity.burst@1.8/manual/editor-burst-inspector.html

  • Unity菜单:Jobs/Burst/Open Inspector
    在这里插入图片描述

测试

  • 对比各种遍历耗时

    • 测试了 List<T> 和 定长数组,相同操作都是定长数组更快一点。
  • 测试长度遍历一千万,测了一百万差异差不多。

测试代码

private const int TEST_COUNT = 10000000;
private float[] _managedArray = new float[TEST_COUNT];    // 托管
private NativeArray<float> _nativeArray;                  // 非托管

private void Run()
{
    _nativeArray = new NativeArray<float>(TEST_COUNT, Allocator.Persistent);
    for (int i = 0; i < TEST_COUNT; i++) 
    {
        _managedArray[i] = i;
        _nativeArray[i] = i;
    }
    
    // 测试List,同下面Array
    ...
    // 
    
    Debug.LogError("Test Array");
    using (new MyStopWatch("ManagedArray"))
    {
        for (int i = 0; i < TEST_COUNT; i++) 
            _managedArray[i] = i + 5;
    }
    using (new MyStopWatch("TestNativeArray"))
    {
        for (int i = 0; i < TEST_COUNT; i++) 
            _nativeArray[i] = i + 5;
    }
    using (new MyStopWatch("TestNativeList Job"))
    {
        var job = new NativeArrayJob { Data = _nativeArray };
        job.Run();
    }
    using (new MyStopWatch("TestNativeList Burst Job"))
    {
        var job = new NativeArrayBurstJob { Data = _nativeArray };
        job.Run(); 
    }
    using (new MyStopWatch("TestNativeArray Burst JobParallelFor"))
    {
        // List动态扩容,不支持多线程写入
        var job = new NativeArrayBurstJobParallelFor() { Data = _nativeArray };
        job.Schedule(TEST_COUNT, 64).Complete(); 
    }
    using (new MyStopWatch("TestNativeArray Burst"))
    {
        TestNativeArrayBurst(ref _nativeArray);
    }
    using (new MyStopWatch("TestNativeArray Burst Break"))
    {
        TestNativeArrayBurstBreak(ref _nativeArray);
    }

    // Natvie容器要自己释放
    _nativeList.Dispose();
}

// 普通带Burst编译
[BurstCompile]
private static void TestNativeArrayBurst([NoAlias]ref NativeArray<float> list)
{
    for (int i = 0; i < TEST_COUNT; i++) 
        list[i] = i + 5;
}

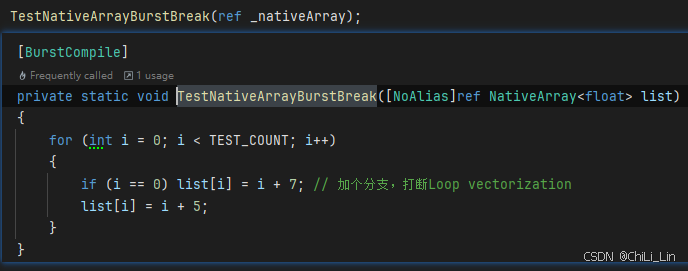
// 带Burst编译,但是加分支打断SIMD向量化
[BurstCompile]
private static void TestNativeArrayBurstBreak([NoAlias]ref NativeArray<float> list)
{
    for (int i = 0; i < TEST_COUNT; i++)
    {
        if (i == 0) list[i] = i + 7; // 加个分支,打断Loop vectorization
        list[i] = i + 5;
    }
}

// 普通Job
struct NativeArrayJob : IJob
{
    public NativeArray<float> Data;

    public void Execute()
    {
        for (int i = 0; i < TEST_COUNT; i++) 
            Data[i] = i + 5;
    }
}

// 带Burst的Job
[BurstCompile]
struct NativeArrayBurstJob : IJob
{
    public NativeArray<float> Data;

    public void Execute()
    {
        for (int i = 0; i < TEST_COUNT; i++) 
            Data[i] = i + 5;
    }
}

// 带Burst的多线程Job
[BurstCompile]
struct NativeArrayBurstJobParallelFor : IJobParallelFor
{
    public NativeArray<float> Data;
    public void Execute(int index)
    {
        Data[index] = index + 6;
    }
}

测试结果

  • PC端跑一千万次循环array[i]=i+5

    在这里插入图片描述

  • MUMU模拟器 64位,跑一亿次循环array[i]=i+5

    在这里插入图片描述

安卓跑一亿次array[i]=i+5耗时代码
普通数组80ms在这里插入图片描述
NativeArray32ms在这里插入图片描述
丢到Job中执行34ms在这里插入图片描述
Burst编译的Job31ms在这里插入图片描述
Burst编译的多线程Job。不支持NativeList<T>,因为可能出现动态扩容,导致线程不安全。28ms在这里插入图片描述
普通Burst函数34ms在这里插入图片描述
普通Burst函数,但是打断SIMD向量化78ms在这里插入图片描述
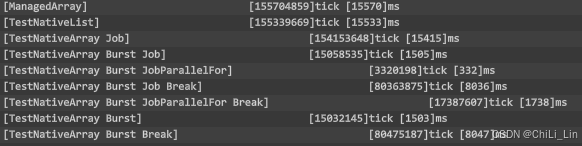
  • 跑一亿次循环array[i]=math.sin(i+5),左图:MUMU模拟器 64位,右图:RedmiNote12
    在这里插入图片描述
    在这里插入图片描述
安卓跑一亿次sin(i+5)模拟器耗时/ms真机耗时/ms
普通数组608015570
NativeArray592215533
丢到Job中执行590315415
Burst编译的Job21251505
Burst编译的多线程Job573332
普通Burst函数21161503
普通Burst函数,但是打断SIMD向量化235208047
Burst编译的Job,但是打断SIMD向量化231658036
Burst编译的多线程Job,但是打断SIMD向量化59441738
  • 模拟器下,同样循环内容下(有if和math.sin),burst编译反而跑的更慢了。可能中低端设备负优化了?

SIMD向量化

  • https://docs.unity3d.com/Packages/com.unity.burst@1.8/manual/optimization-loop-vectorization.html

  • 如果有分支或者计算结果有前后依赖,就无法向量化。简单的计算可以手动向量化用float4等。
    在这里插入图片描述


总结

  1. 复杂计算效率 Burst + JobParallelFor > Burst + Job >= Burst > Job >= 常规。

  2. 平常开发不涉及大量计算,直接用托管List<T>等常规容器就好了。托管环境Native容器虽然也快一点,但需要自己释放。

Unity DOTS Burst 运行分析 Unity DOTS Burst 解密 阅读详情

相关推荐

Unity游戏开发:通过C# JobSystem和Burst编译器优化游戏性能的终极指南

通过合理使用和Burst编译器,并结合ECS架构,Unity开发者能够在高性能要求的游戏场景中取得显著的性能提升。这些工具可以帮助你在保持代码整洁和可维护的同时,最大化地利用多核CPU的能力,减少计算瓶颈。最佳实践:并行化计算:使用JobSystem将计算任务并行化,并使用处理大量数据。优化内存布局:通过合理的内存对齐,减少缓存失效,提高数据访问效率。结合Burst编译器:为关键的Job添加特性,利用Burst编译器的优化提升性能。ECS架构应用。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1460

Unity Burst 用户指南

Burst用户指南 Burst User Guide 概观 Burst是一个编译器,它使用LLVM将IL / .NET字节码转换为高度优化的本机代码。它作为Unity包发布,并使用Unity Package Manager集成到Unity中。 快速开始 使用burst编译器编译Job Burst主要用于与Job系统高效协作。 您可以通过使用属性[BurstCompile]装饰Job结构,从而在代码...

alph258的博客 2万+

Unity Burst编译器实战指南:从原理到性能优化

在游戏开发和高性能计算领域,编译器优化是提升程序执行效率的核心技术之一。其原理是通过对代码的静态分析和转换,生成更高效的机器指令,从而减少运行时开销。这项技术的价值在于能够将高级语言编写的逻辑转化为接近底层硬件的执行效率,尤其适用于计算密集型场景,如游戏中的粒子系统、物理模拟和动画处理。Burst编译器正是Unity引擎中实现这一目标的关键工具,它基于LLVM框架,专门针对HPC#代码进行深度优化,通过自动向量化和指令集优化,显著提升Job System并行任务的执行速度。对于面临移动端性能瓶颈或需要处理大

weixin_34246826的博客 346

Unity Burst详解

Burst是Unity的编译优化技术,优化了从C#代码编译成Native代码的过程,经过编译优化后代码有更高的运行效率。在Unity中使用Burst很简单,在方法或类前加上[BurstCompile]特性即可。在构建时编译代码的步骤,Burst编译器会识别该特性对方法或类做编译优化。其适用于高性能计算的场景,逻辑复杂的场景不适用。Burst编译的实现得益于已有的SIMD和LLVM技术。

enternalstar的博客 2853

Unity性能优化:Burst Compiler与LLVM编译原理实战解析

编译器优化是现代软件开发中提升程序执行效率的核心技术,其原理在于将高级语言代码转换为底层机器指令的过程中,通过一系列优化算法减少冗余计算、改善内存访问模式。LLVM作为一套模块化的编译器基础设施,提供了强大的中间表示(IR)和优化器,能够实现自动向量化、循环展开等关键优化,从而显著提升计算密集型任务的性能。在游戏开发和高性能计算领域,这种底层优化技术具有重要价值,能够有效解决CPU计算瓶颈问题。Unity引擎中的Burst Compiler正是基于LLVM技术栈构建,专门为高性能C#子集(HPC#)提供深度

weixin_34160277的博客 545

从零到英雄:Burst编译器如何重塑你的Unity性能优化策略

本文深入探讨了Burst编译器如何显著提升Unity项目的性能优化策略。通过将C#代码转化为高度优化的原生机器码,Burst编译器特别适用于数学密集型运算、大规模数据并行处理和移动端优化,性能提升可达5-20倍。文章详细介绍了Burst的集成方法、高级优化技巧及实战案例,帮助开发者充分利用这一强大工具。

weixin_29011667的博客 402

Unity 引擎 Burst 编译技术总结

Unity的Burst编译器通过极致的性能优化,为高性能需求的游戏和应用开发提供了强大的支持。结合JobSystem和ECS,开发者可以高效地处理复杂计算和大规模并行任务。然而,Burst的高性能需要以一定的开发复杂性为代价,开发者需要合理选择使用场景,并遵循优化和数据驱动的设计原则。

小宝哥Code的专栏 2592

Unity打包遇到Burst编译器报错?手把手教你解决BuildFailedException(1.8.2版本)

本文详细解析了Unity 1.8.2版本中Burst编译器报错(BuildFailedException)的解决方案,从临时禁用Burst编译到彻底修复代码兼容性问题。提供了禁用Burst、选择性编译、代码重构和版本升级等多种方法,帮助开发者高效解决打包问题,同时保持项目性能优化。

weixin_30952535的博客 417

Unity Job System与Burst编译:MeshApiExamples多线程网格处理指南

想要提升Unity游戏性能?了解Unity Job System与Burst编译的强大组合是关键!MeshApiExamples项目展示了如何利用Unity 2020.1的新MeshData API,通过多线程网格处理实现惊人的性能提升。本指南将带您深入了解这个强大的技术组合,帮助您优化网格操作性能。 ## 🚀 为什么需要多线程网格处理? 在Unity开发中,网格处理通常是性能瓶颈。传统的单

gitblog_00627的博客 984

QT6与QT5安装全攻略:从下载到环境配置一站式指南

本文提供了一份详尽的QT6与QT5安装教程,涵盖从版本选择、在线安装器使用到环境变量配置的全过程。针对新手常见痛点,重点对比了QT6与QT5的安装差异,并给出了MinGW与MSVC编译器的选择建议,旨在帮助开发者快速搭建稳定可用的QT开发环境,避免常见错误。

weixin_29216353的博客 312

空心杯电机在美容仪器中的应用:为什么你的洗脸刷动力这么强?

本文深入解析了空心杯电机如何成为高端美容仪器的核心动力源。通过对比传统电机,揭示了其无铁芯、低惯量、零齿槽效应的技术优势,从而实现了强劲动力、极致静音与细腻震动的用户体验。文章详细阐述了空心杯电机在洁面刷、导入仪等美容仪器中的具体应用与选型考量,并指出了开发中驱动匹配、测试等关键实战要点。

j2k3l4的博客 1013

Unity Burst编译器实战:原理、调优与性能提升指南

在游戏开发和高性能计算领域,编译器优化是提升程序执行效率的核心技术之一。其原理在于将高级语言代码转换为高度优化的机器码,通过静态分析、循环向量化、函数内联等手段,大幅减少运行时开销。这项技术的核心价值在于能够充分发挥现代CPU的多核与SIMD指令集潜力,尤其适用于计算密集型的场景,如物理模拟、动画系统和实时图形处理。在Unity引擎中,Burst编译器正是这一技术的杰出代表,它通过LLVM后端将符合规范的C#代码编译为极致优化的本地机器码,绕过了传统.NET JIT的开销。开发者通过理解其工作原理与约束,并

weixin_34357436的博客 384

安卓7.0+抓包难题:雷电模拟器9.0+Charles系统证书安装全攻略

HTTPS协议通过SSL/TLS加密保障网络通信安全,其核心机制依赖于证书信任链。在Android系统中,自7.0版本起,谷歌收紧了证书信任策略,默认仅信任系统预置的CA证书,这直接导致了传统抓包方法失效。理解这一原理对于移动开发、测试及安全研究至关重要,它揭示了应用层安全策略与系统底层机制的关联。通过将用户证书安装至系统信任区,可以突破此限制,实现HTTPS流量的解密与分析。这一技术在App调试、接口测试、安全审计等场景中具有广泛的应用价值。本文以雷电模拟器9.0和Charles抓包工具为例,详细演示了如

weixin_42521843的博客 280

Unity性能优化利器:JobSystem与Burst编译器实战指南

在游戏开发中,CPU性能优化是提升帧率和游戏体验的核心挑战,尤其当面对大规模场景和复杂计算时,传统的单线程脚本往往成为瓶颈。多线程编程通过并行计算充分利用多核CPU,能显著提升数据处理效率,但其复杂性常令开发者望而却步。Unity推出的JobSystem框架,以数据安全为首要目标,通过声明式依赖管理,让开发者能安全、高效地编写并行代码,极大降低了多线程门槛。结合Burst编译器,它能将C# Job代码编译为高度优化的原生机器码,利用SIMD指令集和零GC开销,实现数量级的性能飞跃。这套技术组合尤其适用于数据

weixin_30727835的博客 392

C#工业通信完整项目实战:从协议解析到数据库存储,打造工业级全链路数据闭环(完整可复用源码)

工业自动化的核心诉求是「数据闭环」:从工业设备采集真实生产数据 → 解析校验获得有效数据 → 持久化存储到数据库形成生产台账 → 数据分析/报表展示/异常预警,形成采集→解析→处理→存储→应用的全链路数据流转,这也是工业上位机开发的终极落地形态,区别于单纯的「数据采集」demo。本次实战是一套工业级完整投产级项目,基于C# WinForm + .NET Framework 4.8(工业标配)✅双通信链路完美适配:同时封装TCP网口 + 串口(RS232/485)

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1038

杰理AC695N系列芯片红外遥控按键使用教程

本文介绍了杰理AC695N芯片红外按键功能的配置和使用方法。主要内容包括:硬件连接说明(红外接收头接线至GPIO口)、软件配置(使能红外功能并设置接收引脚)、按键映射表修改(原始键值到逻辑按键的转换)以及按键扫描参数调整(消抖、长按时间等)。重点展示了三级映射机制,指导如何根据实际遥控器键值修改映射关系,实现不同模式下(蓝牙/音乐/FM)的自定义按键功能。最后提供了调试方法,可通过串口打印查看遥控器原始键值。

qq_42014563的博客 1463

Unity性能优化利器:Burst编译器原理、实战与调优指南

在游戏开发与实时计算领域,性能优化始终是核心挑战。从底层原理看,代码执行效率受限于运行时开销、内存访问模式与CPU指令集利用率。传统托管代码在垃圾回收、虚拟方法调用等方面存在固有开销,而SIMD(单指令多数据流)向量化技术能大幅提升数据并行计算吞吐量。Burst编译器通过将C#代码编译为高度优化的本地机器码,结合无垃圾分配与自动向量化,为计算密集型任务带来数量级性能提升。这一技术尤其适用于游戏开发中的粒子系统、实体组件系统(ECS)数据处理等场景,通过与Unity Job System协同,实现多核并行与极

weixin_34401479的博客 415

在 SAP SD 模块里,销售订单号既可以由系统“自动”产生,也可以由用户“手工”输入,核心取决于“号码段(Number Range)”与“订单类型(Sales Document Type)”这两处配

SAP销售订单编号配置指南:系统提供内部自动编号和外部手工编号两种方式,通过VN01定义号码段(内部/外部),VOV8分配给订单类型并设置"ExtNo.Rq"选项即可切换。高阶应用支持灵活编号(如加前缀)或通过增强出口完全自定义编号规则。配置时需注意号码段创建、分配及传输问题,常见故障包括号码范围不存在或配置错误。核心是"号码段+订单类型"的组合控制编号生成方式,满足从简单到复杂的业务需求。

金牌架构师 531

Unity jobsystem 和 burst编译器代码演示及效率测试

Unity jobmanager 和 burst编译器代码演示及效率测试 最近看了相关内容做了个测试 直接上代码 using System.Collections; using System.Collections.Generic; using UnityEngine; using Unity.Burst; using Unity.Jobs; using Unity.Collections; using System.Diagnostics; public class NewBehaviourScript

TGB666的博客 1723

【K8S系列】Kubernetes 中 Pod 无法通过 Service 名称访问服务的 DNS 解析失败问题【已解决】

在 Kubernetes 中,Service 提供了一种稳定的方式,通过名称访问一组 Pod。当其他 Pod 无法通过 Service 名称访问服务,并且出现 DNS 解析失败时,通常会导致应用无法正常工作。本文将详细分析此问题的常见原因及其解决方案。

颜淡慕潇 1万+

YOLOv11 环境配置全流程 | 从零开始搭建训练与推理环境

YOLOv11环境配置与训练全流程指南 本文详细介绍了YOLOv11目标检测模型的环境配置、训练与推理全流程。内容包括: 环境要求:列出GPU、CUDA、Python等组件的版本要求,提供快速检查脚本 Windows配置: CUDA 12.6和cuDNN 8.9.7安装步骤 使用Conda创建隔离环境 PyTorch GPU版本安装方法 IDE环境配置 Linux配置:提供Ubuntu 22.04下的CUDA、cuDNN安装命令和Conda环境搭建 Docker方案:提供一键式容器化部署命令 训练实战: 数

shrgegrb的博客 2019

Burst编译器:Unity 生态下的高性能数值计算利器

Burst编译器是Unity专为高性能数值计算开发的AOT编译器,通过将C#代码直接编译为原生机器码,显著提升物理模拟、粒子系统等计算密集型任务的性能。其核心优势在于:1) 与C# JobSystem深度协同实现多线程并行;2) 零GC开销的强类型安全约束;3) 自动SIMD向量化等硬件优化。开发者只需添加[BurstCompile]特性标记纯数值计算代码,即可获得接近C++的性能,同时保持C#开发便利性。Burst特别适用于ECS架构的大规模模拟场景,但对代码有严格限制(禁用Unity API调用和托管内

分享知识,拥抱变化 472

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Unity多线程编程新纪元:基于Burst编译器的Job System极致优化

掌握Unity多线程性能优化秘诀,深入解析DOTS 的作业系统如何提升游戏运行效率。结合Burst编译器实现Job System极致并发,适用于高负载物理计算与大规模实体处理,显著降低CPU开销。性能飞跃,值得收藏

CompiGap的博客 1258

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

matlab2019 编译器_Burst 编译器,让Arm 架构中的Unity 项目性能最大化

Burst 编译器的最新技术可以帮助Unity 开发者们利用起Arm Neon 指令集,在安卓设备上,Arm 架构下的Unity 项目可借助Burst 编译器提高性能。Unity 与Arm 在此前确立了合作伙伴关系,致力于提升安卓生态中数十亿由Arm 驱动的移动设备的游戏开发体验。对于游戏开发者来说,性能就是一切。Arm 年复一年地改进CPU 与GPU 技术,为打造丰富体验而不断提高设备...

weixin_39828193的博客 474

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Unity Job System 实战:Burst 编译与并行加速的边界

Job System 配合 Burst 把均匀可并行的实体更新从主线程串行搬到多核并行,是千级实体同屏的可行加速路径。其代价是 Burst 不支持托管类型导致算法须约束在兼容子集,以及共享写依赖引发的并行退化与并行调试困难。工程落地应遵循组件单写者原则、延迟 Complete 与渲染重叠执行、严格配对 NativeArray 的 Dispose 防泄漏,并借助确定性回放定位并行竞态。调度批大小须按实体规模调优,避免调度开销吞噬收益。

2301_77785315的博客 5098

Unity.Mathematics性能优化实战:从SIMD向量化到Burst编译全解析

在游戏开发与高性能计算领域,SIMD(单指令多数据流)技术是实现并行计算的核心原理,它允许CPU单条指令处理多个数据点,大幅提升数学运算吞吐量。基于这一原理,向量化编程模型将传统标量运算转化为批量数据处理,释放硬件并行潜力。Unity.Mathematics作为官方高性能数学库,正是这一技术的工程实践典范,它通过float4、quaternion等向量化类型与Burst编译器深度协同,生成高效SIMD指令码。其技术价值在于为移动端、VR及大型游戏提供底层数学运算性能保障,解决密集计算场景下的帧率瓶颈。应用场

weixin_34034670的博客 403
上一篇: 2D 游戏艺术、动画和光照
下一篇: 腾讯游戏开发精粹Ⅲ LQA部分
ChiLi_Lin
博客等级 码龄12年 760粉丝 184原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值