深入理解 DeepSeek 与企业实践(三):671B 超低成本部署方法与效果评测

DeepSeek-R1模型1.5b、7b、8b、14b、32b、70b和671b有啥区别? deepseek-r1的1.5b、7b、8b、14b、32b、70b和671b有啥区别?码笔记mabiji.com分享:1.5B、7B、8B、14B、32B、70B是蒸馏后的小模型,671B是基础大模型,它们的区别主要体现在参数规模、模型容量、性能表现、准确性、训练成本、推理成本和不同使用场景 阅读详情
AI摘要

本文聚焦于以最低成本部署 DeepSeek-R1 671B 大模型,介绍了不同量化版本解析、部署实践及评测。包括 1.58-bit 极限压缩方案、3090 集群多机扩展方案、H20×8 + AWQ 高性能方案等,还给出实战案例、成本效益分析,最后展望了全精度未量化模型部署策略。

前言

在《深入理解 DeepSeek 与企业实践(一):蒸馏、部署与评测》、《深入理解DeepSeek与企业实践(二):32B多卡推理的原理、硬件散热与性能实测》的系列文章中,我们分别介绍了 DeepSeek R1 不同模型的关系、核心指标,并在 ZStack AIOS 智塔上完成了几种蒸馏模型的部署和评测。根据我们的评测,蒸馏后的版本在数学、代码等能力方面往往较原模型有提升,但如果涉及较复杂的任务(例如完整编写上百行的代码)其效果可能不尽如人意。此时我们需要考虑使用 DeepSeek-R1 671B 模型,也就是网上常说的“满血版”。

但是 671B 参数量太大,如果设备不支持 FP8 的话,仅是模型权重就有 1.3TB,成本非常高昂,因此本文将聚焦于如何以最低成本部署DeepSeek-R1 671B 这一近万亿参数级大模型、量化版本的实际表现如何、量化版本相比未量化版本损失有多少、不同硬件配置的综合性价比和适合场景。

本文目录

一、DeepSeek-R1 671B 量化版本解析

二、极限压缩方案:DeepSeek-R1 671B 1.58-bit 部署实践

三、多机扩展方案:3090 集群部署 671B-1.58b 评测

四、高性能方案:H20×8 + AWQ 量化部署

五、实战案例:Flappy Bird 代码生成

六、成本效益分析和结论

七、展望:全精度未量化模型的部署策略

一、DeepSeek-R1 671B 

量化版本解析

当前,针对 DeepSeek R1 671B 的量化方案有很多,这里不再详细介绍 IQ_1_S、AWQ 等量化方法是什么具体含义,直接选取几种典型方案和显存需求对比如下:

图片

(注:显存需求包含了最小的 KV 缓存与系统开销,且为最低需求,实际需要根据上下文窗口大小、KV 缓存精度等准确估算。GGUF 格式与 safetensor 格式由于推理引擎和并行方法不同,因此显存占用不能直接比较)

二、极限压缩方案:

DeepSeek-R1 671B 1.58-bit 部署实践

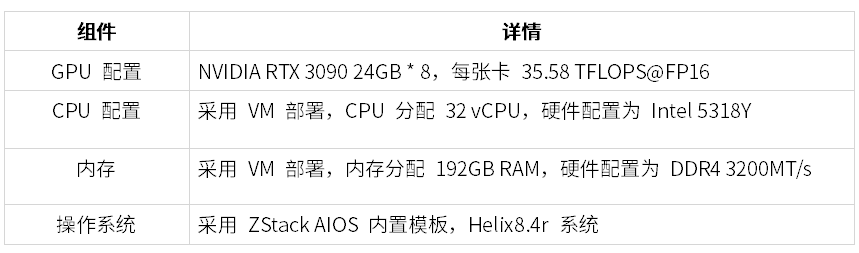
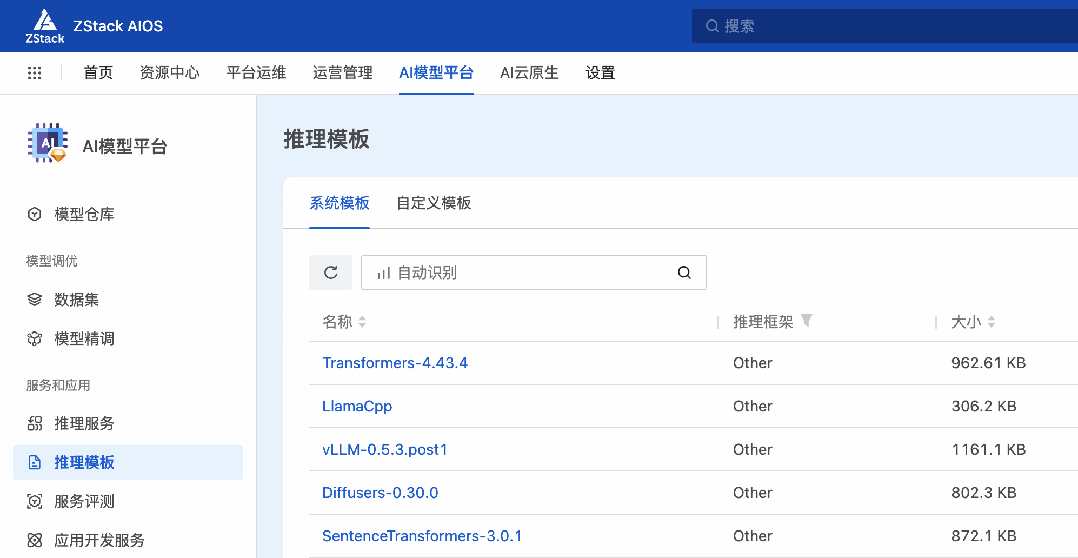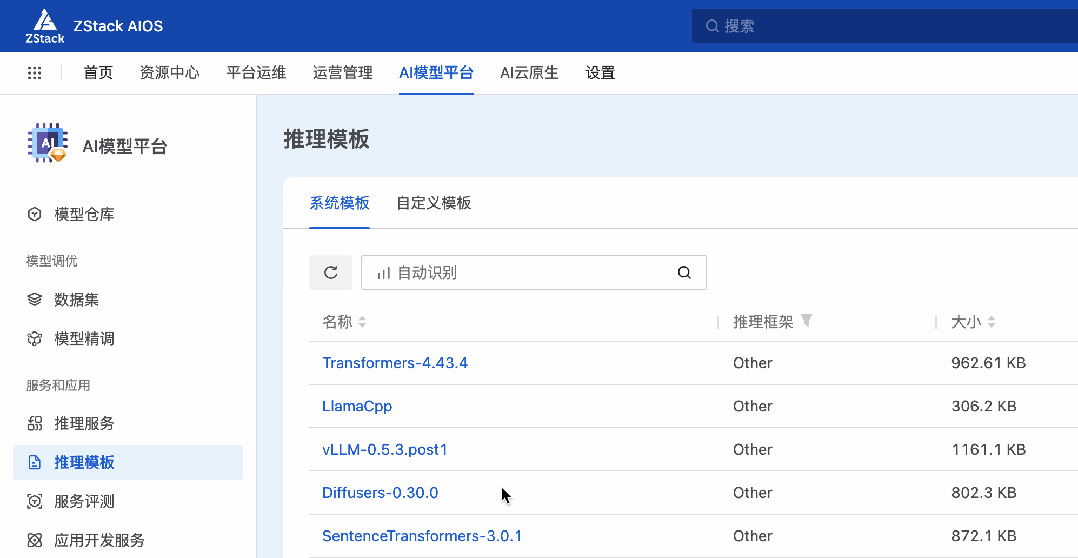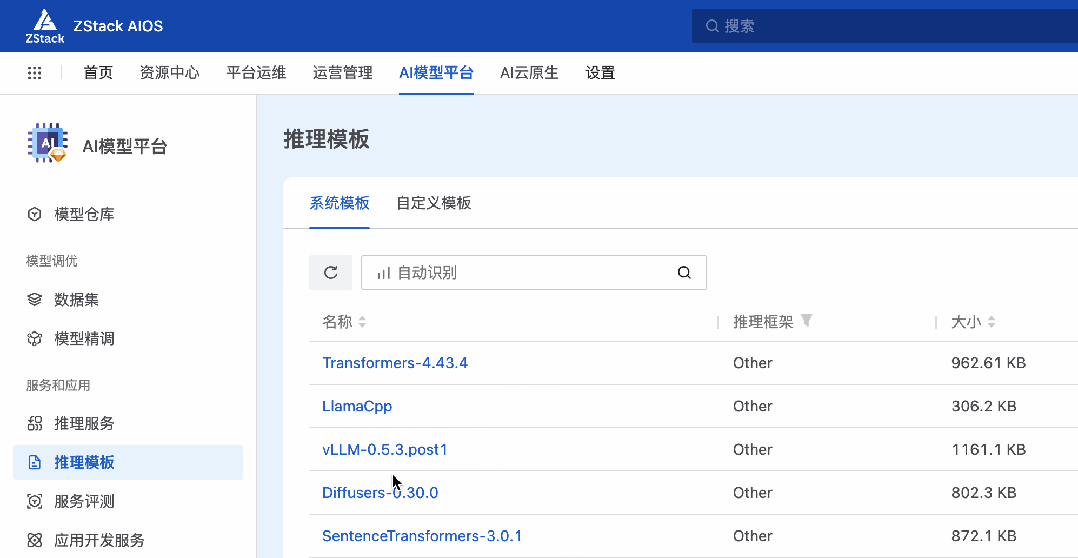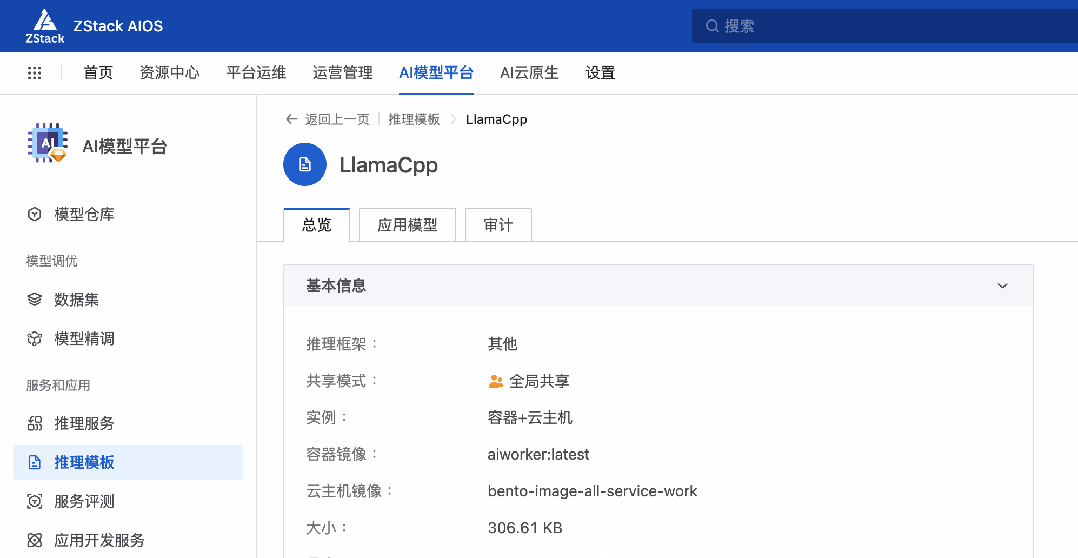
根据前面的表格,我们不难发现一台 3090 8 卡服务器正好就可以满足 671B-1.58b 的最低要求!而且可以将全部权重放到 GPU 里,推理速度是比较有保障的,不过要注意的是因为格式为 GGUF 格式,因此需要使用 llama.cpp 推理框架,在 ZStack AIOS 智塔里,支持多种推理框架,方便用户根据实际需求使用。
图片

环境配置

图片

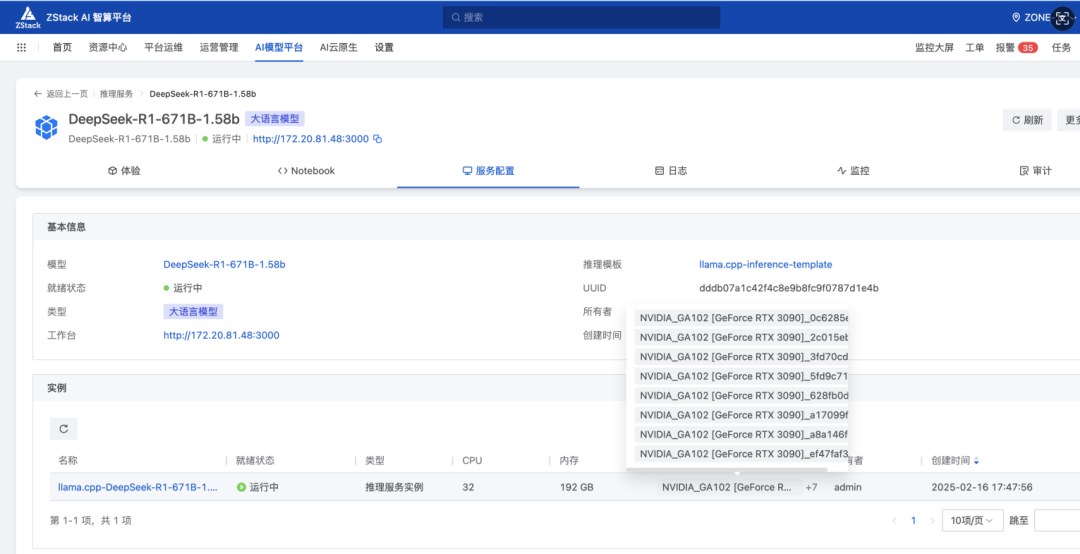
部署过程

  1. 环境准备:安装 ZStack AIOS,确保系统满足运行要求

  2. 一键部署:

    1. 使用 ZStack AIOS 选择模型并关联合适的推理模板(llama.cpp)和镜像

    2. 指定运行该模型的GPU规格和计算规格后即可部署

  3. 测试运行:在体验对话框中可以尝试对话体验或者通过 API 接入到其他应用

图片

性能评测

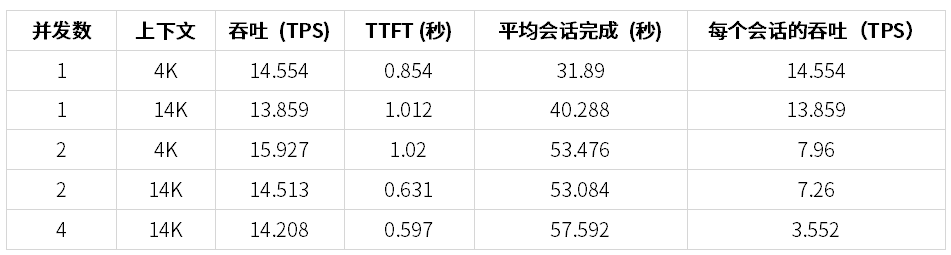
图片

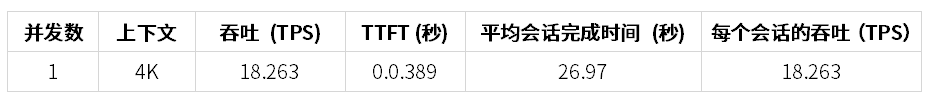
我们很顺利地将 671B-1.58b 运行起来了!但是很遗憾的是我们只有 4K 上下文,这是因为 llama.cpp 采用了将模型分层加载到 GPU 中,因此每一层需要有完整的上下文大小以确保模型运行。此外,受限于 llama.cpp 的推理原理,增加并发基本不会增加整个服务的总吞吐还会减少单个会话的上下文大小,所以我们没有继续增加并发。

然而 4K 上下文对于 DeepSeek-R1 来说是远远不够的,非常容易在回答时被截断,无法完成我们常用的 MMLU、C-EVAL 等评测,为了增加上下文大小,我们需要用多机部署 DeepSeek-R1-671B-1.58b 来测试。

三、多机扩展方案:

3090 集群部署 671B-1.58b 评测

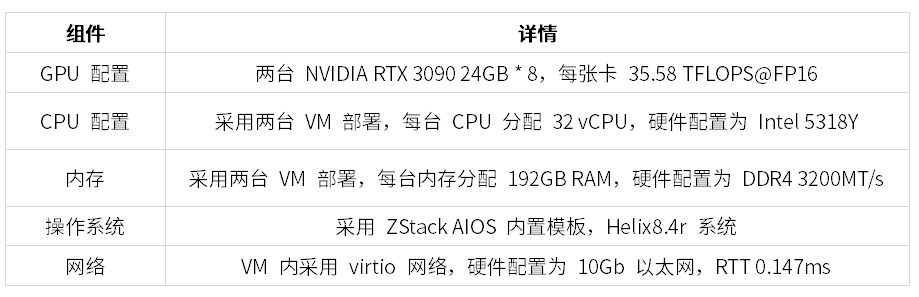
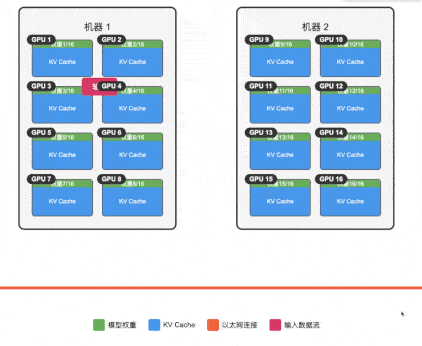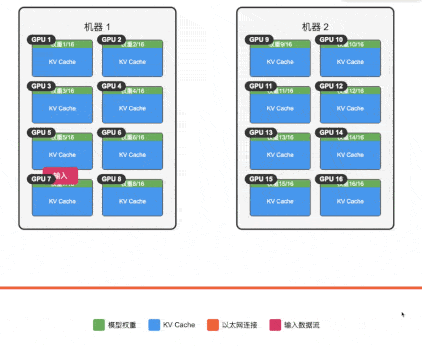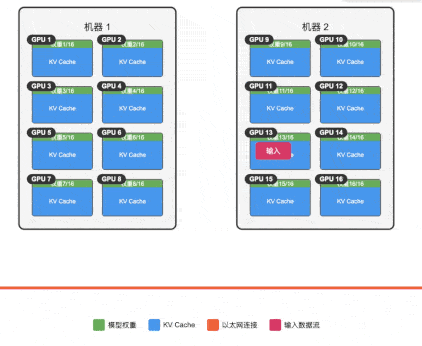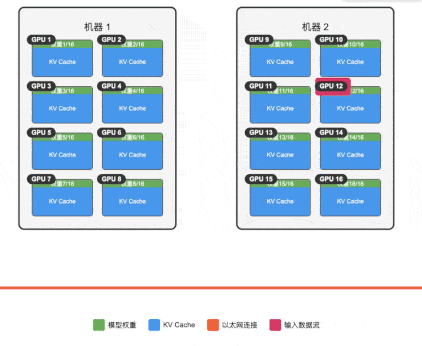
由于单机 3090 上的上下文太小,我们尝试通过集群来扩展 671B-1.58b 模型服务的上下文,通过将模型权重分散到 16 张卡上,理论上我们可以获得接近 14GB 的空间用于运行 KV Cache,也就是接近 14K 的上下文空间(注意 llama.cpp 的多机并行推理并不是生产推荐用法,这里仅作测试用)。
图片

环境配置

图片

性能表现

图片

瓶颈分析

  • 可以看到在长上下文时,模型吞吐略有增加

  •  由于 llama.cpp 的架构和 3090 显卡的带宽所限,更高的并发无法有效提升 GPU 利用率

模型能力评测

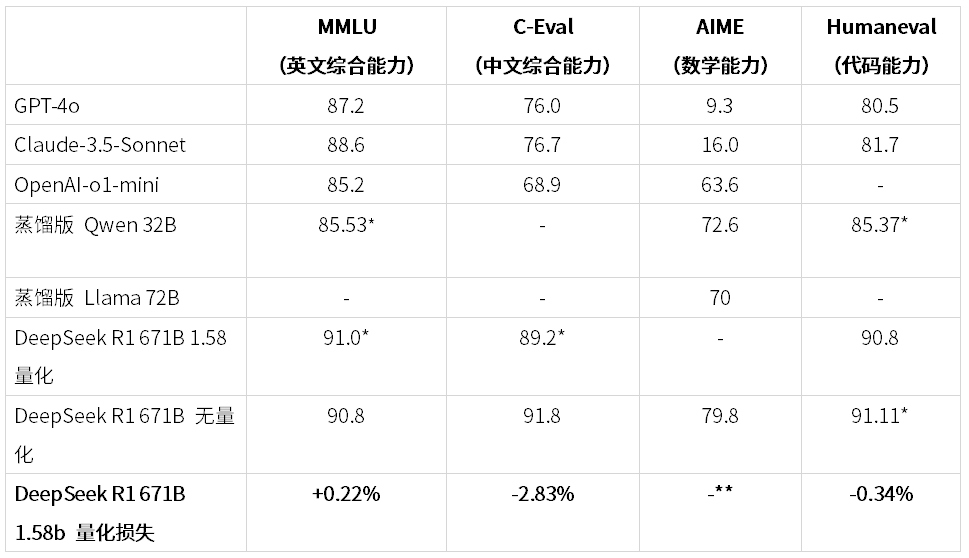
通过 ZStack AIOS 的服务评测功能,我们对 DeepSeek-R1-671B-1.58b 进行了 MMLU、C-Eval、HumanEval 等评测,从不同维度比较 671B 量化之后的能力表现,以及和蒸馏版的对比。
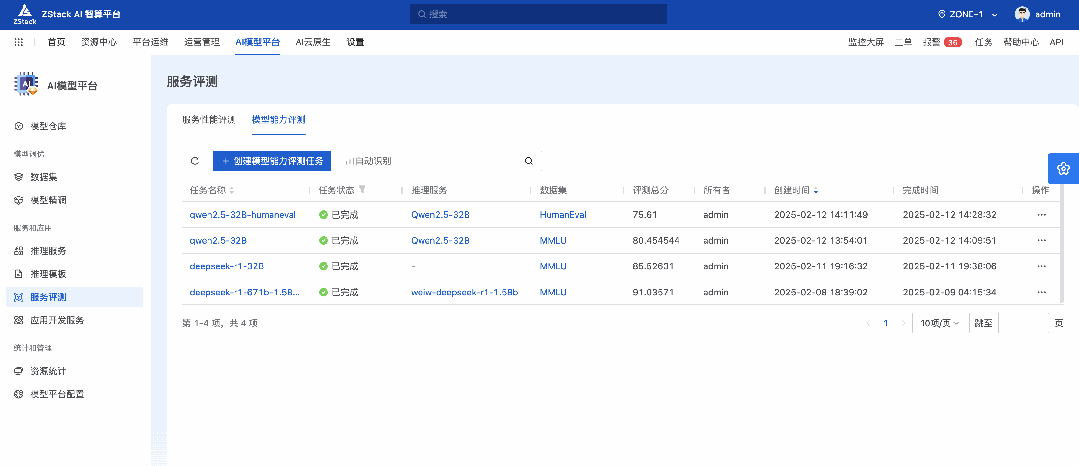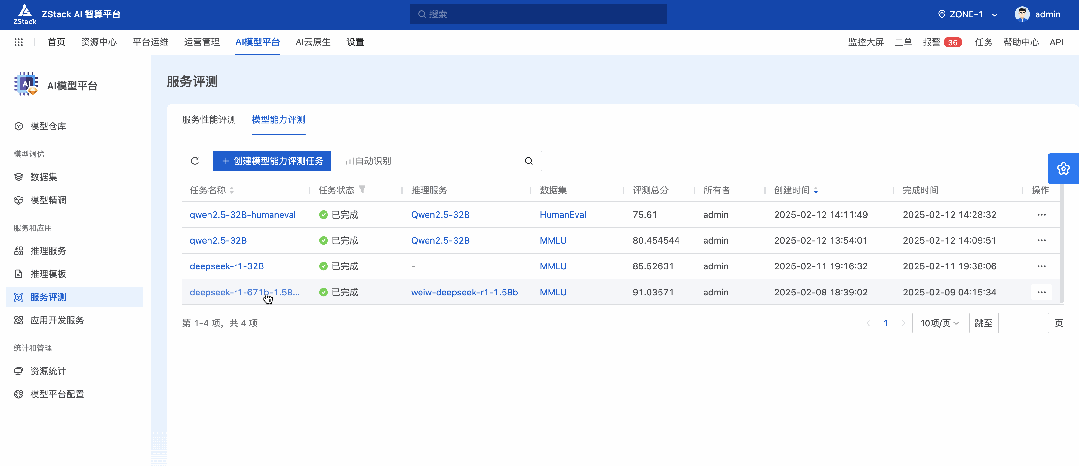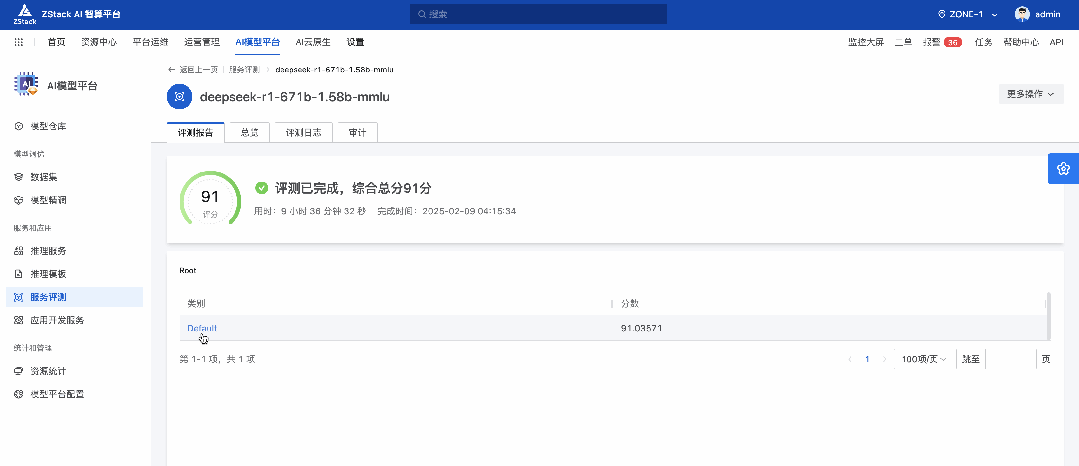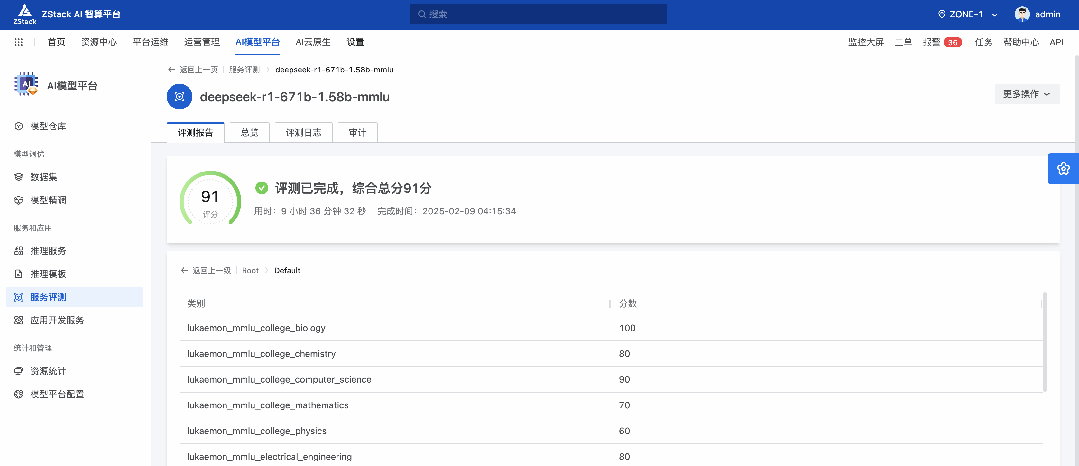
图片

由于运行时间过于漫长,所以对部分评测进行了采样,汇总如下:

图片

*标注表明数据为 ZStack 实验环境测试,非官方论文数据

**由于上下文只有 14K,无法正常完成 AIME24 的测试

根据上面数据,我们可以看到经过 1.58 量化后,能力有一定影响,但是影响并没有想象中的大,且在英文综合、中文综合、代码能力上对比 GPT-4o、Claude-3.5 仍有显著优势。

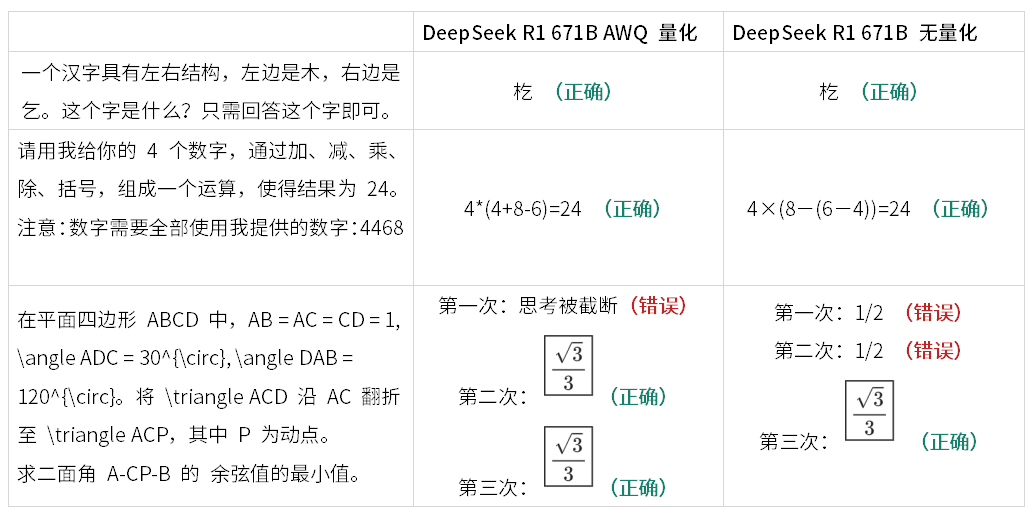
网上有一些“识别模型是否为满血版的技巧”,我们摘取几个也进行了测试,发现这些题目确实有一定辨识度:
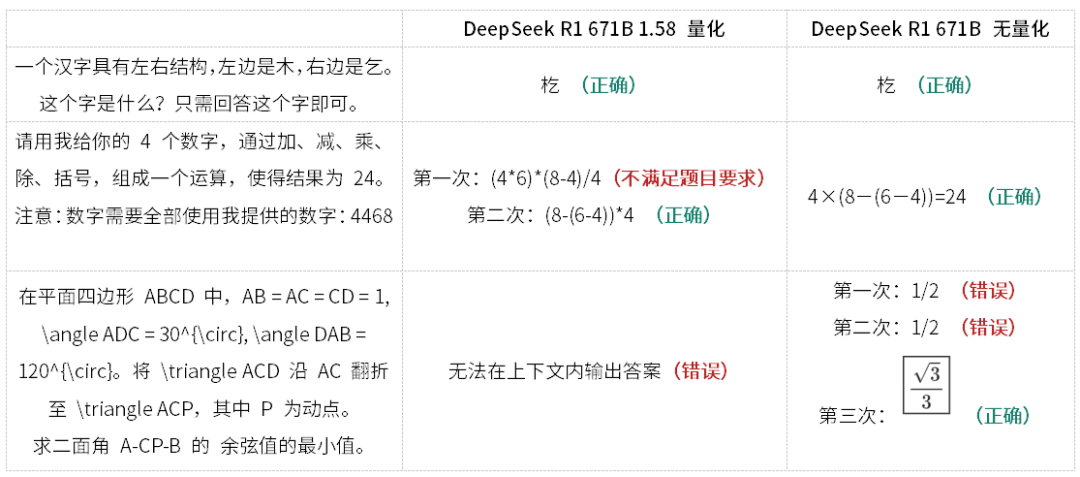
图片

四、高性能方案:

H20×8 + AWQ 量化部署

受限于 llama.cpp 的架构设计以及 1.58 量化的数据结构,进一步提升性能是比较困难的,但对于企业来说,单台或两台 3090 固然成本低,但是其上下文窗口能力、并发能力都会受到比较大的掣肘。

因此,我们再继续考虑另一种量化手段——AWQ,理论上 AWQ 量化后只需要 8 张 64GB 以上显存的显卡即可运行,但由于条件原因,我们采用 H20 96GB 来测试 AWQ 量化后模型的表现。

环境配置
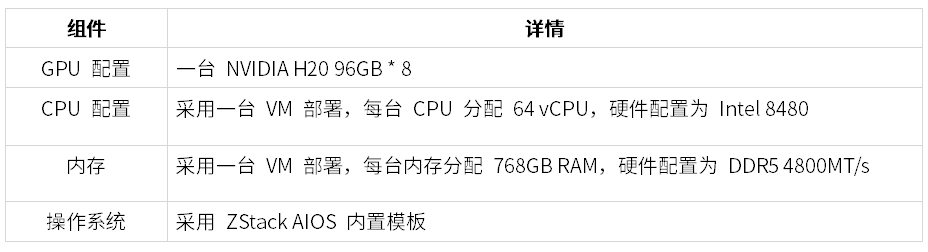
图片

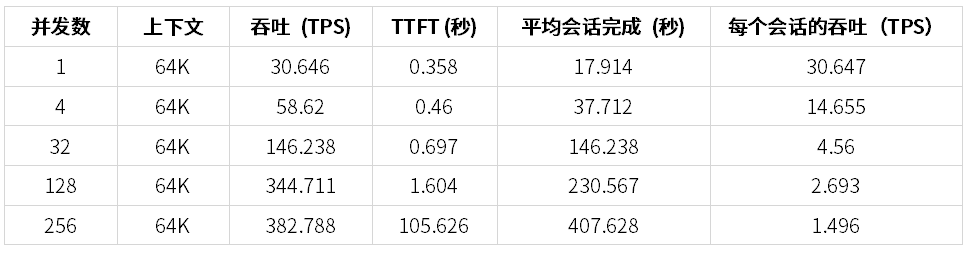
性能表现

图片

下图为在 ZStack AIOS 智塔上通过 DeepSeek-R1-AWQ 对话的性能表现 
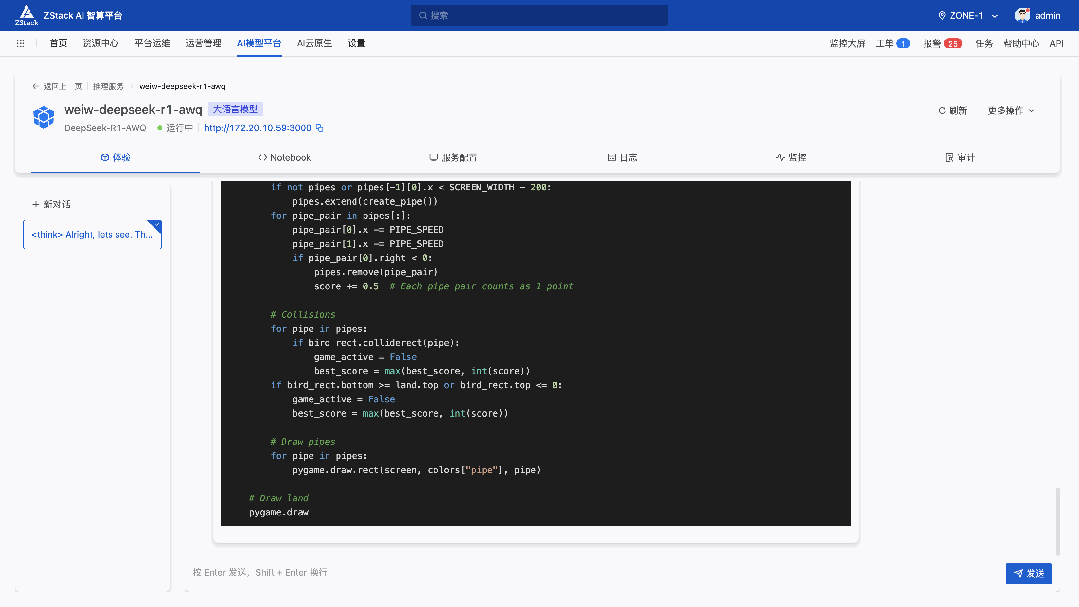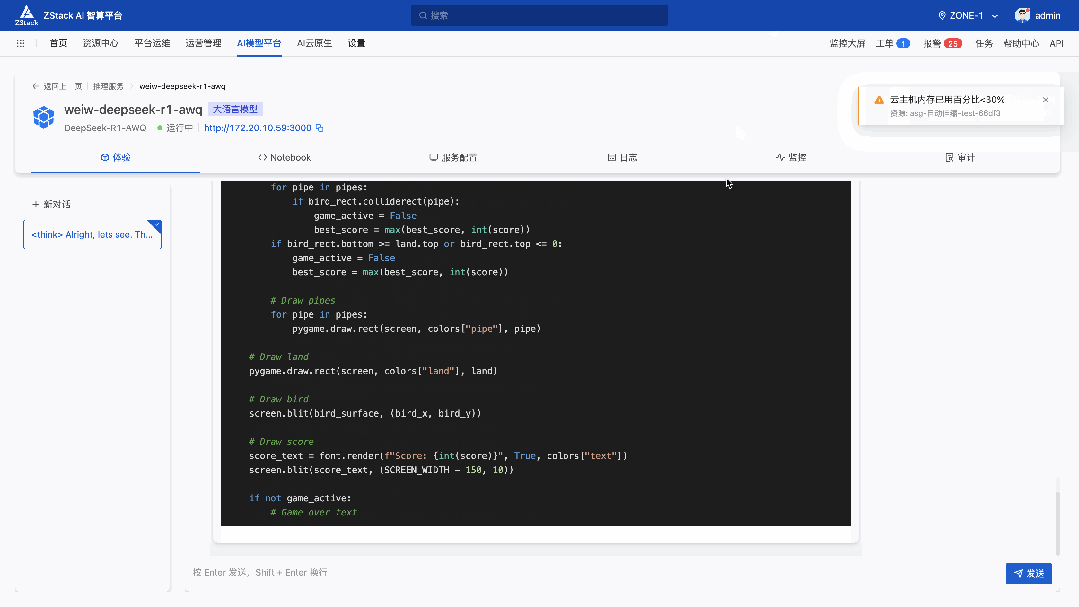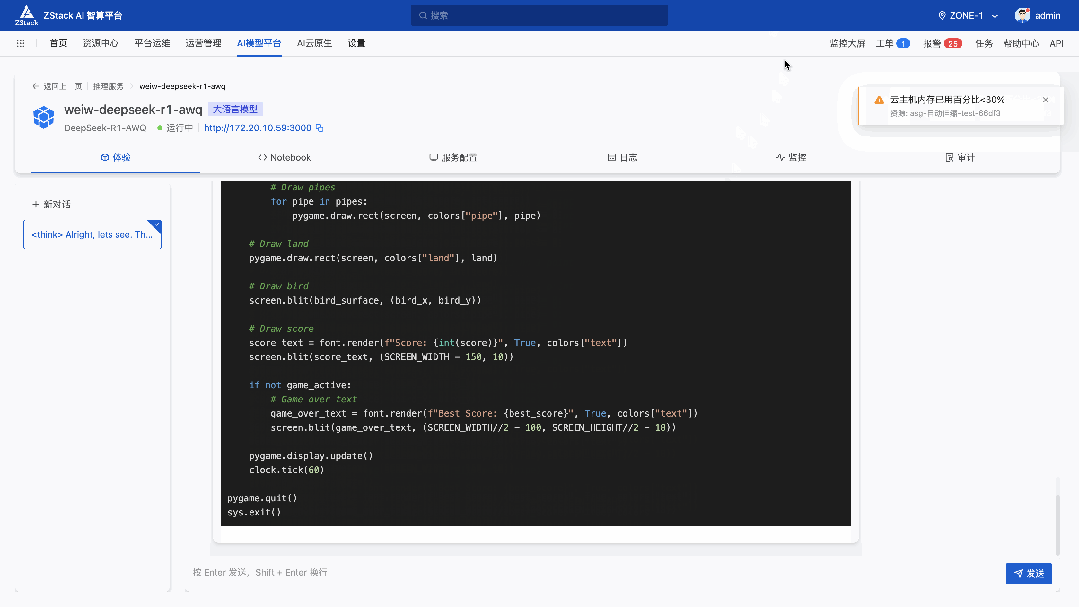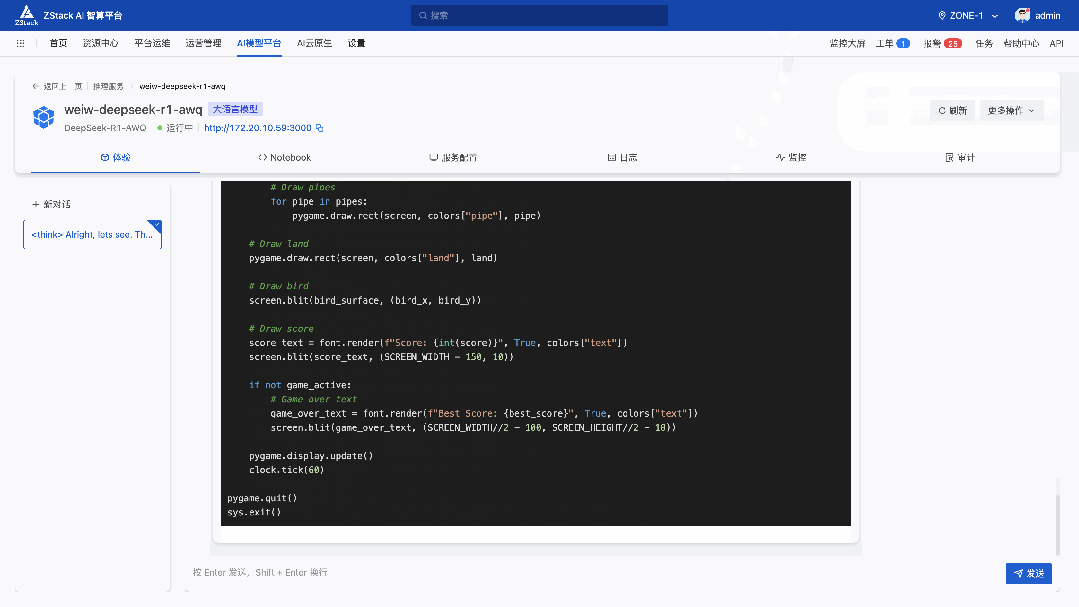
图片

性能分析

1. AWQ 量化后无法使用 MLA 加速、FP8 加速等方法,导致在多并发场景下性能可能还不能充分发挥;

2. 随着并发数增长,吞吐可以持续增加到接近 400 Token/s,但是此时每个会话的吞吐已经极低,只适合于离线场景;

3. 由于测试方法较为严格,测试过程中 KV Cache 命中率较低,如果我们采用接近的 Prompt 以提升 KV Cache 命中反,最多可以提升到 910 TPS 左右。

能力评测对比:
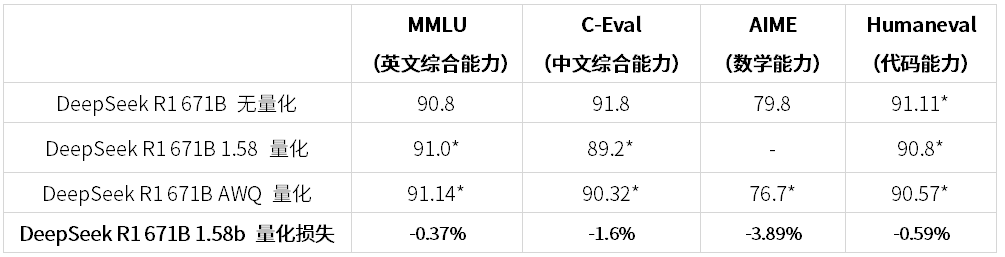
图片

与 1.58 类似,我们也运行了网上流行的“满血版测试”:

图片

五、实战案例:Flappy Bird 代码生成

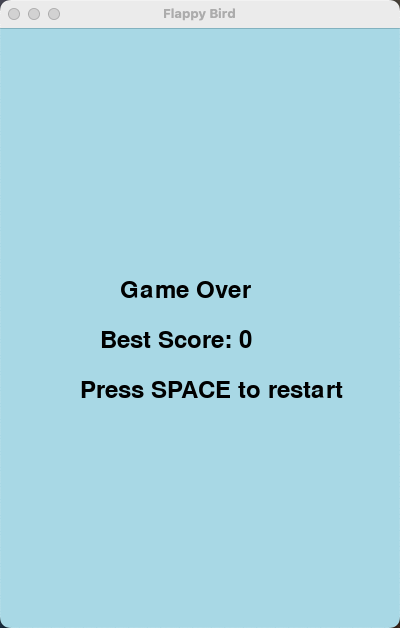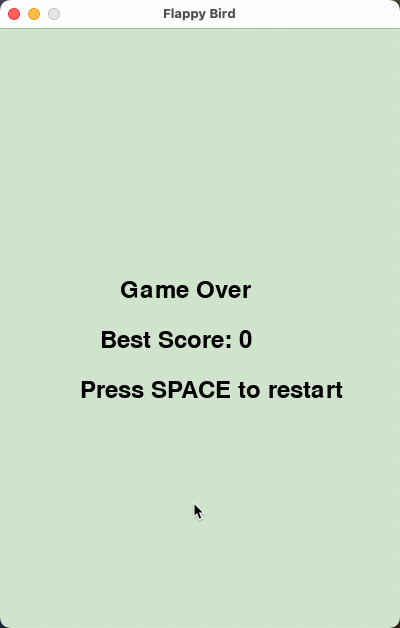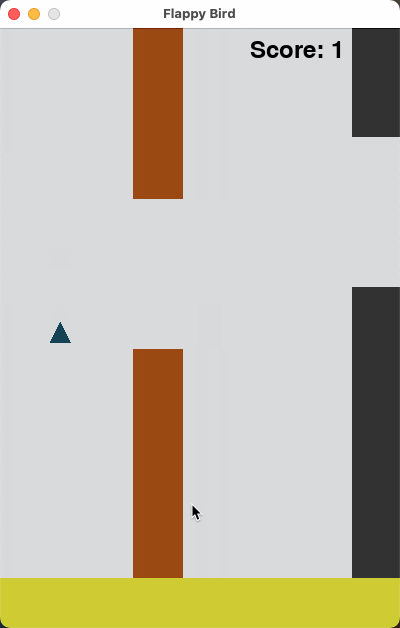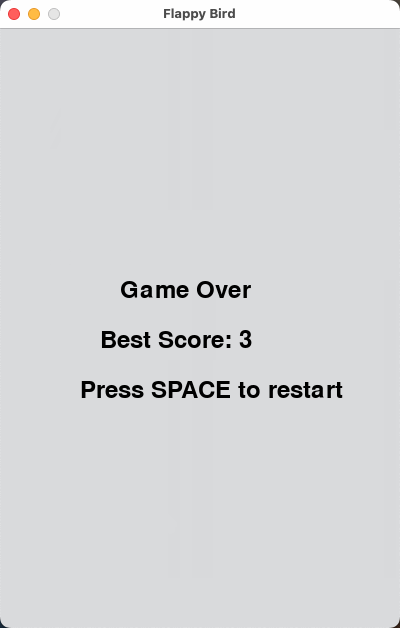
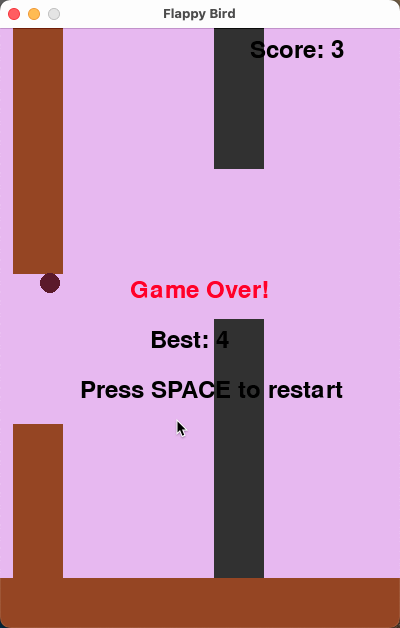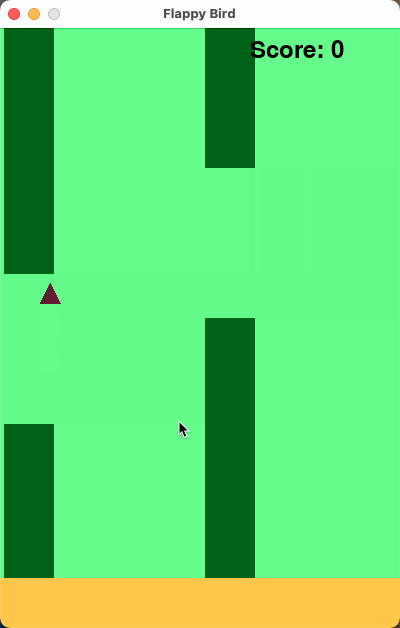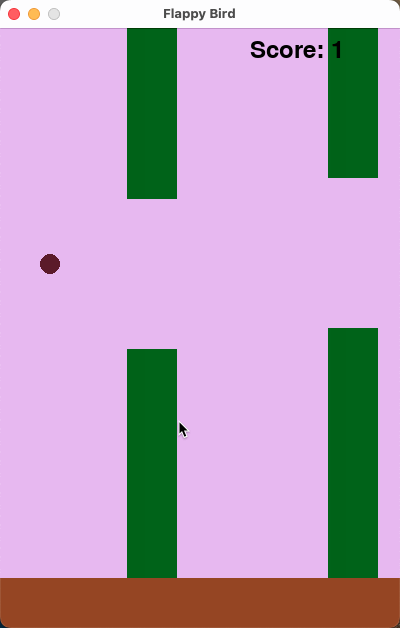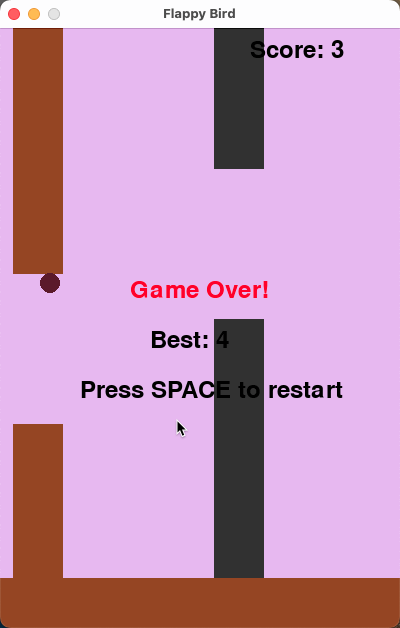
前面我们看到了 DeepSeek-R1-671B 量化对于代码生成的能力影响不大,但是 HumaneEval 90 分对于读者来说可能并不直观,我们参考了 Unsloth 的测试方法——我们要求模型创建 3 次 Flappy Bird 游戏(pass@3),我们按10个标准(例如使用随机颜色,随机形状, 是否可以成功运行等) 评分,最后取三次测试取平均分。测试中使用的 Temperature 为 0.6。

下面是使用的 Prompt:

1 Create a Flappy Bird game in Python. You must include these things:
2 You must use pygame.
3 The background color should be randomly chosen and is a light shade. Start with a light blue color.
4 Pressing SPACE multiple times will accelerate the bird.
5 The bird's shape should be randomly chosen as a square, circle or triangle. The color should be randomly chosen as a dark color.
6 Place on the bottom some land colored as dark brown or yellow chosen randomly.
7 Make a score shown on the top right side. Increment if you pass pipes and don't hit them.
8 Make randomly spaced pipes with enough space. Color them randomly as dark green or light brown or a dark gray shade.
9 When you lose, show the best score. Make the text inside the screen. Pressing q or Esc 9 will quit the game. Restarting is pressing SPACE again.
10 The final game should be inside a markdown section in Python. Check your code for errors and fix them before the final markdown section.

下面的运行效果是我们运行 3 次选取效果最好的情况,得分为平均分:

可以看到在较长的代码生成中,AWQ 量化后略有下降,但是整体表现与 DeepSeek-R1 区别并不大。

_

运行效果

得分

DeepSeek-R1-671B-1.58b 量化

图片

78.5%

DeepSeek-R1-671B-AWQ 量化

图片

91.0%

DeepSeek-R1-671B 无量化

图片

92.5%

可以看到在较长的代码生成中,AWQ 量化后略有下降,但是整体表现与 DeepSeek-R1 区别并不大。

六、成本效益分析和结论

考虑到 GPU 机型价格受硬件配置、市场供给情况影响较大,这里基于较为流行的在线算力平台 

基于 AutoDL 实例价格估算:
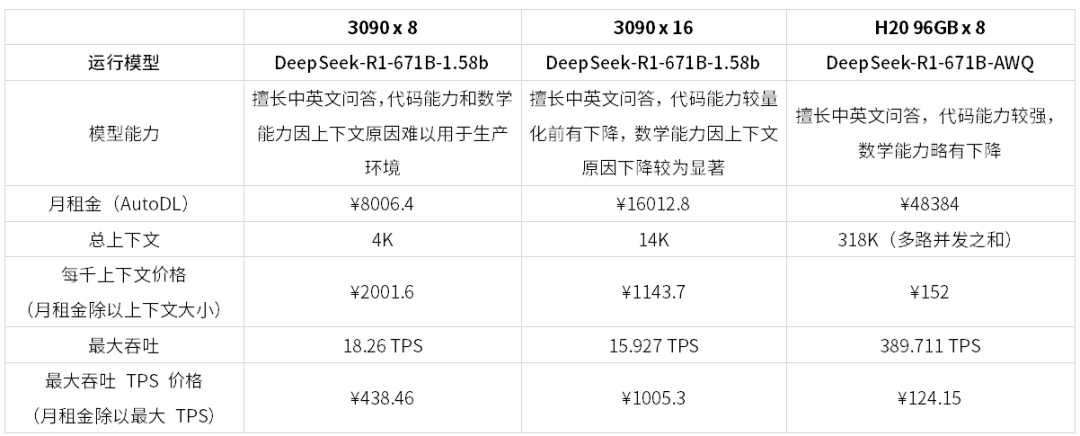
图片

需要注意的是,月租金和购买成本并不一定成正比,例如在这里 H20 8 卡服务器月租金是 3090 八卡服务器的 6 倍,但是其购买成本不一定是 6 倍;

结论:

  • 3090 单机适合于简单体验,不涉及数学、代码(均需要较长的上下文)等任务的测试;

  • 3090 多机比较适合于个人或超小规模场景下生成代码,14K 上下文在代码生成时一般足够够用,但不适合复杂的数学推理场景;

  • 虽然 3090 单机成本低,但是在批量运行场景下优势不明显,所以如果追求较大的上下文窗口、较高的并行能力的话,更高的配置其综合性价比反而会更高;

  • 受限于模型的参数量所带来的超大计算量,单用户很难获得超过 30~50 TPS 的推理速度。

不过,由于 DeepSeek 模型发布时间还较短,因此推理引擎还会有一些优化空间,未来可能还会发生变化。

七、展望:更大参数模型的部署策略

通过本文的探讨,我们深入了解了 DeepSeek-R1-671B 模型如何通过 1.58 量化来降低体验成本和通过 AWQ 量化来降低超长上下文的成本,测试了对应的模型运行性能和能力,可以看到复杂数学推理能力是最容易在量化中损失的,此外在部署中,需要密切关注上下文的大小,这将对模型的表现影响很大。

在后续的文章中,我们将继续探讨:

  • 全精度部署策略: 在高性能计算环境下,如何正确部署模型,充分发挥大型模型的能力和硬件资源。

通过对比不同规模和精度的模型,我们希望为企业级应用提供更加全面和细致的部署方案,帮助更多行业快速落地大语言模型技术,实现商业价值。

注:本文中的部分数据为示例,实际情况可能有所不同,建议在具体实施过程中进行详细测试和验证。

ollama大模型参数的1.5b 7b都是什么意思以及所需要的机器配置 1.5b”、“7b”、“8b”、“14b”、“32b”、“70b” 和 “671b” 表示模型的参数数量。参数数量是衡量机器学习模型复杂性和能力的一个重要指标。一般来说,参数越多,模型的表达能力和学习能力通常也越强,但这也意味着需要更多的计算资源和训练数据。在您提到的模型中,列出的不同参数数量的模型可能用于不同的应用场景,开发者可以根据需求选择合适的模型。 阅读详情

相关推荐

一文解锁DeepSeek大模型参数【671B、70B、32B、14B、8B、7B】

大模型的参数是深度学习模型中的核心组成部分,它们决定了模型对输入数据的表示学习能力以及最终的预测或决策能力,即影响大模型“智商”的决定性因素!DeepSeek大模型参数【671B、70B、32B、14B、8B、7B】是什么以及啥作用,本文就来了解一下这些参数背后的原理!

u013891230的博客 7715

目前我见到的全网硬件成本最低运行DeepSeek R1 671b满血版完整指南(翻译)

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

m0_63171455的博客 1万+

DSP28335学习笔记——McBSP配置为SPI

由于28335硬件外设上只有一个SPI接口,所以当SPI接口不够用时,可以将McBSP配置为SPI接口。 参考28335的数据手册,当DSP为主机时,配置McBSP为SPI所用到的接线如下图所示。 另外总结一些调试过程中的经验。 1.传输数据位数的确定 由RCR1寄存器中的RWDLEN1和XCR1寄存器中的XWDLEN1决定。分别对应着接受和发送的位数,在配置成SPI模式的时候,这

捕虫少年 1万+

deepseek 671B 版本推理究竟需要什么样的GPU H100, H20, A6000,TRX 4090

或者 8卡 80G显存的H800. 可以考虑2.51-bit量化版本 预测速度预估20~30TPS (待验证)或者 8卡 40G显存的A6000. 可以考虑2.51-bit量化版本 预测速度预估3~10TPS (待验证)基于8卡 24G 显存的4090 全可以考虑1.58-bit版本,预测速度预估3~10TPS (待验证)基于4/ 8卡96G 显存H20 , 预测速度22tps 8张卡每张卡显存占用30。跟进DeepSeek-R1:动手部署671B模型推理(2.51-bit量化)

weixin_43480227的博客 1万+

笔记本摄像头模拟监控推送RTSP流

FFmpeg软件:选择Windows builds by BtbN一个完整的跨平台解决方案,用于录制、转换和流式传输音频和视频。选择Windows版本EasyDarwin开源流媒体服务器 支持Windows、Linux、macOS平台;支持RTSP推流分发(推模式转发);支持RTSP拉流分发(拉模式转发);VLC Media Player软件:选择Windows64bit支持众多与及文件格式,并支持DVD影音光盘,VCD影音光盘及各类协议。

IT_LittleBaby的博客 3875

实战:如何用MIPI CSI-2高效传输RAW10图像数据(附带宽优化技巧)

本文深入探讨了MIPI CSI-2协议在RAW10图像数据传输中的高效应用,详细解析了4像素5字节打包机制及其带宽优化技巧。通过动态Lane分配、位深度自适应压缩和虚拟通道交错传输等实战方法,显著提升传输效率,适用于IoT摄像头开发等低功耗场景。

css33的专栏 733

深入理解DeepSeek与企业实践(四):671B满血版部署和性能优化思路

本次详细介绍在ZStack AIOS 平台智塔多机多卡部署 671B 满血版模型的实践过程,分析其性能表现,为企业 AI 技术落地提供有力支撑和指导。

ZStack_io的博客 2281

Calibre LVS效率翻倍秘籍:用Hierarchical Flow处理亿级晶体管设计的5个关键阶段

本文详细解析了如何利用Hierarchical Flow技术提升Calibre LVS在亿级晶体管SoC设计中的验证效率。通过五个关键阶段的分层验证流程,包括顶层抽象验证、模块级独立验证等,可显著降低内存占用40-60%,缩短迭代周期50-70%,特别适用于SMIC等先进工艺节点。文章还分享了算力资源优化、并行化处理等实战技巧,帮助工程师应对大规模芯片验证挑战。

sam99的博客 770

深入理解 DeepSeek 与企业实践(一):蒸馏、部署与评测

本文从 DeepSeek 模型的演进出发,探讨了蒸馏和量化在模型部署中的重要作用。

ZStack_io的博客 1309

分析攻击流量样本

利用wireshark分析.pcap攻击样本的攻击流程,利用漏洞等。

一段旅途 6845

基于FPGA的多级CIC滤波器实现四倍插值

基于FPGA的多级CIC滤波器实现四倍插值 原文链接:基于FPGA的多级CIC滤波器实现四倍插值 在《基于FPGA的多级CIC滤波器实现四倍抽取一》和《基于FPGA的多级CIC滤波器实现四倍抽取二》中我们先来了解滑动平均滤波器、微分器、积分器以及梳状滤波器原理以及它们的幅频响应。此篇我们将用verilog实现基于FPGA的多级CIC滤波器实现四倍插值。 1 CIC滤波器的基本概述 CIC(积分梳状...

baidu_34971492的博客 3142

深入理解 DeepSeek 与企业实践(五):知识库、Manus、代码生成三大场景的原理、评测与部署

哪种模型适合特定场景?该使用推理模型还是通用模型?不同模型的投入成本与性能表现如何平衡?

ZStack_io的博客 1659

混响效果的编程实现:Schroeder混响模型与Moorer型混响

Schroeder混响模型是由Manfred R. Schroeder在1962年提出的,它基于一系列串联的反射器(Allpass Comb Filters)和并联的反射器(Feedback Comb Filters)构成。Schroeder混响模型是由Manfred R. Schroeder在1962年提出的,它基于一系列串联的反射器(Allpass Comb Filters)和并联的反射器(Feedback Comb Filters)构成。通过调整各个反射器和全通滤波器的参数,可以实现不同的混响效果。

2301_79326857的博客 1083

手搓Manus+DeepSeek,企业私有化 AI 场景实战全攻略

哪种模型适合特定场景?该使用推理模型还是通用模型?不同模型的投入成本与性能表现如何平衡?

ZStack_io的博客 1672

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

DeepSeek-R1本地化部署 java调用 图文教程(Ollama+Docker+OpenWebUI)

DeepSeek-R1 是幻方量化旗下大模型公司 DeepSeek 研发的系列推理模型,以下是关于它的简介:2024 年 11 月 20 日:DeepSeek-R1-Lite 预览版正式上线网页端,仅支持网页使用,暂不支持 API 调用。 2025 年 1 月 20 日:DeepSeek 正式发布 DeepSeek-R1 模型,并同步开源模型权重。 2025 年 1 月 24 日:在 Arena 上,DeepSeek-R1 基准测试升至全类别大模型第三,在风格控制类模型分类中与 OpenAI o1 并列第一

深耕 Java 后端与企业级软件架构设计,专注微服务、分布式系统、大模型 AI 应用架构落地。 2677

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

DeepSeek私有化专家 | 云轴科技ZStack入选IDC中国生成式AI市场概览

IDC 指出 DeepSeek 将在基础设施层重点影响是软硬件协同创新。云轴科技ZStack开启并深化软硬协同创新,为企业用户私有化部署和应用 DeepSeek 降低门槛。

ZStack_io的博客 819

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2320

MoE、推理模型、多模态:三个维度彻底拆解大模型分类

大模型技术快速演进,围绕模型架构、能力范式和输入模态的定义却常常被混为一谈。MoE(混合专家)解决的是算力分配问题,通过稀疏激活和路由机制,在总参数庞大的情况下保持单次推理效率;推理模型强调显式的长思维链与自我校验,适合数学证明、代码调试等复杂任务;多模态则决定模型能理解图片、音频还是纯文本。三者分属不同坐标系,却常被厂商宣传和榜单标签模糊边界,导致选型失误、部署OOM甚至成本失控。理解这些基础概念,能帮助研发者在工程实践中更精准地评估模型:从架构看清显存需求,从推理深度匹配任务难度,从模态范围确认输入支持

weixin_34391445的博客 275

人工智能求职指南(职业规划)、预训练、稠密模型、Moe

人工智能求职指南(职业规划)

enthan809882的博客 561

【AI应用开发工程师】第四章:模型层技术

书接上回:【小白成长之路】第三章:大语言模型原理理解了 LLM 的工作原理后,下一个问题自然来了:这些模型是怎么训练出来的?预训练需要多少数据?微调为什么有效?LoRA 是怎么做到只更新 1% 参数就能达到全量微调效果的?本章从"原理"走向"工程",拆解模型层的关键技术。主题: 模型层技术完成本章学习后,你将能够:本章涉及两大类技术,它们的关系如下:适配技术训练流水线减少训练显存减少推理显存4.1 预训练4.2 监督微调4.5 对齐4.2 全量微调4.3 参数高效微调4.4 模型量化模型层技术4.1 预训练

sjy8207380的专栏 320

Deepseek教程外加671B 满血版

Linux (推荐 Ubuntu 20.04+),Windows需WSL2。GPU:至少2张 A100 80G(需NVLink)或更高配置。:参数量减少的轻量版,资源需求低,适合普通GPU或CPU部署。GPU:单卡 RTX 3090/4090(24G显存)或更低。:完整参数模型,需高性能硬件,适合追求极致效果的用户。存储:1TB+ SSD(模型文件约600GB)。法律合规:遵守数据隐私法规,避免处理敏感信息。存储:100GB+ SSD(依版本而定)。内存:64GB+ RAM。内存:32GB RAM。

qq_37935324的博客 1万+

完整的671B DeepSeek R1本地部署,详尽教程来了!

过年这几天,DeepSeek 算是彻底破圈了,火遍大江南北,火到人尽皆知。虽然网络版和 APP 版已经足够好用,但把模型部署到本地,才能真正实现独家定制,让 DeepSeek R1 的深度思考「以你为主,为你所用」。 然而,完整的 671B MoE 模型也可以通过针对性的量化技术压缩体积,从而大幅降低本地部署门槛,乃至在消费级硬件(如单台 Mac Studio)上运行。

嘴巴吃糖了 8953

通俗诠释 DeepSeek-V3 模型的 “671B” ,“37B”与 “128K”,用生活比喻帮你理解模型的秘密!

在DeepSeek-V3模型的参数描述中,你可能会看到类似“671B 37B 128K”这样的标记。这些字母和数字的组合看起来像密码,但其实它们揭示了模型的“大脑容量”和“工作方式”。下次看到模型参数时,记住这不是性能竞赛的分数,而是匹配需求的工具说明书。就像不会用挖掘机削苹果,合理配置才能发挥AI的真正价值。显然,通讯录人数多不代表聚会能办好,关键看联系谁(激活参数)以及记住多少细节(上下文)。这就是参数配置的实际意义。论文撰写、代码调试、长文档总结。移动端使用建议调低激活参数。优先选择总参数大的模型。

涛涛讲AI 7859

AWQ和GPTQ量化的区别

DeepSeek模型量化版能节约大量现存,所以要不要用呢?一文给你答案。

Thomas_Cai的记忆殿堂 3604

完整的671B R1塞进本地,详尽教程来了!

Datawhale干货作者:李锡涵,编译:机器之心本文作者:李锡涵(Xihan Li)作者简介:伦敦大学学院(UCL)计算机系博士研究生,谷歌开发者专家,主要研究方向为学习优化,在 NeurIPS、ICLR、AAMAS、CIKM 等会议发表过学术论文,Circuit Transformer 作者,图书《简明的 TensorFlow 2》(https://tf.wiki)作者过年这几天,Deep...

Datawhale 1862
上一篇: 云轴科技ZStack+神州鲲泰,全面支持企业私有化部署DeepSeek模型
下一篇: 知识篇 | DeepSeek企业部署模式主要有6种
ZStack开发者社区
博客等级 码龄2年 682粉丝 257原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值