


在我们前几篇文章中,我们深入探讨了 DeepSeek-R1 系列模型(蒸馏版7B、32B,以及671B 量化版和非量化版)的部署和推理原理。
然而,面对如此多样的模型选择,企业在实际应用中常常困惑:哪种模型适合特定场景?该使用推理模型还是通用模型?不同模型的投入成本与性能表现如何平衡?本文将针对这些问题,先对目前最常见也火爆的知识库、代码辅助和智能体(Manus)场景进行分析,最后结合当前硬件成本和实际企业应用场景,提供系统的分析和建议。
本文目录
一、场景 1:知识库
二、场景 2:代码辅助
三、场景 3:智能体(Manus)
四、企业 AI Infra 建设方案建议
五、总结与展望
场景 1:知识库
企业知识库应用是大模型落地最常见的场景,对于简单的、对幻觉容忍度较高的场景,例如旅游景点问答或内部辅助等场景,业界已经形成了非常标准的 RAG 三件套——embedding + LLM + rerank(文档切片、向量化、检索内容重排、大模型总结答案),在上述简单场景中已经可以运用到实践中。
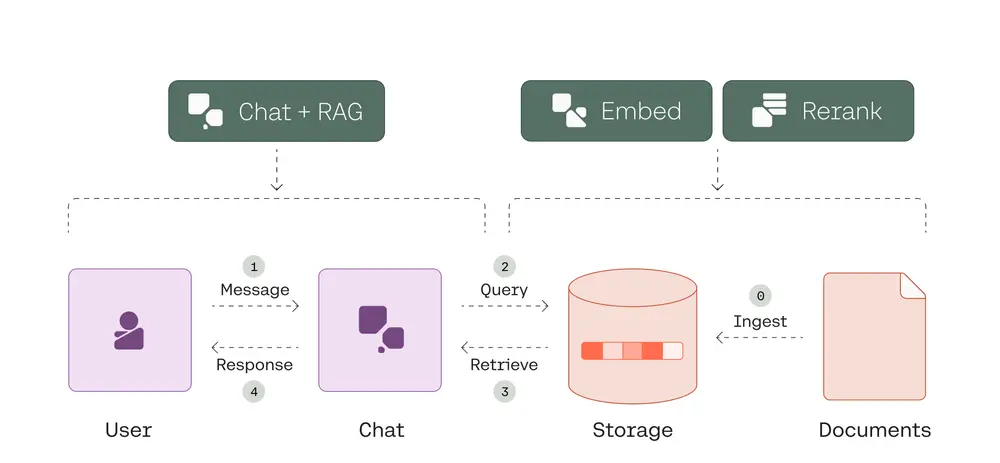
但在要求更高的企业场景中,知识库常常是“Demo 三天、优化半年”,这是因为在企业实际应用中,知识库的核心技术 RAG 往往会面临诸多挑战。根据业内实践,知识库部署主要存在以下难点:
-
多跳问题处理
多跳问题常见于企业报告数据整理环节、大量同义近义用语乃至指代等场景,如"从多份报表中找出企业近三年的复合增长率并与竞对比较"。这类问题需要模型具备理解意图、拆分实体和进行多步推理的能力。 -
上下文内容丢失问题
企业文档中的关键信息如时间、区域标记往往分散在文档不同位置,传统 chunking 方法容易造成信息丢失。例如,财报中年份信息可能只在文件名和大标题出现,导致分割后的文本片段失去时间背景。
-
结构化数据处理
企业需要同时处理结构化数据(如数据库、Excel 表格)和非结构化数据。大模型原生处理的是非结构化数据,但企业场景中结构化数据同样重要。 -
计算与逻辑推理问题
在一些场景里,需要对输入信息进行综合计算和推理,例如已知某些配件的价格,需要计算总体的成本等。
-
多模态内容解析
企业文档中包含大量图表、思维导图等复杂视觉内容,需要布局识别和理解能力,而非简单的 OCR。
对此,业界也提出了诸如问题分类(Routing)、问题优化(Rewriting)、知识图谱(GraphRAG)、复杂文档提取等方法,但这些方法往往涉及不同模型的配合,那么如何选择模型、如何让模型快速配合、确保每个步骤的落地就变成了关键问题。
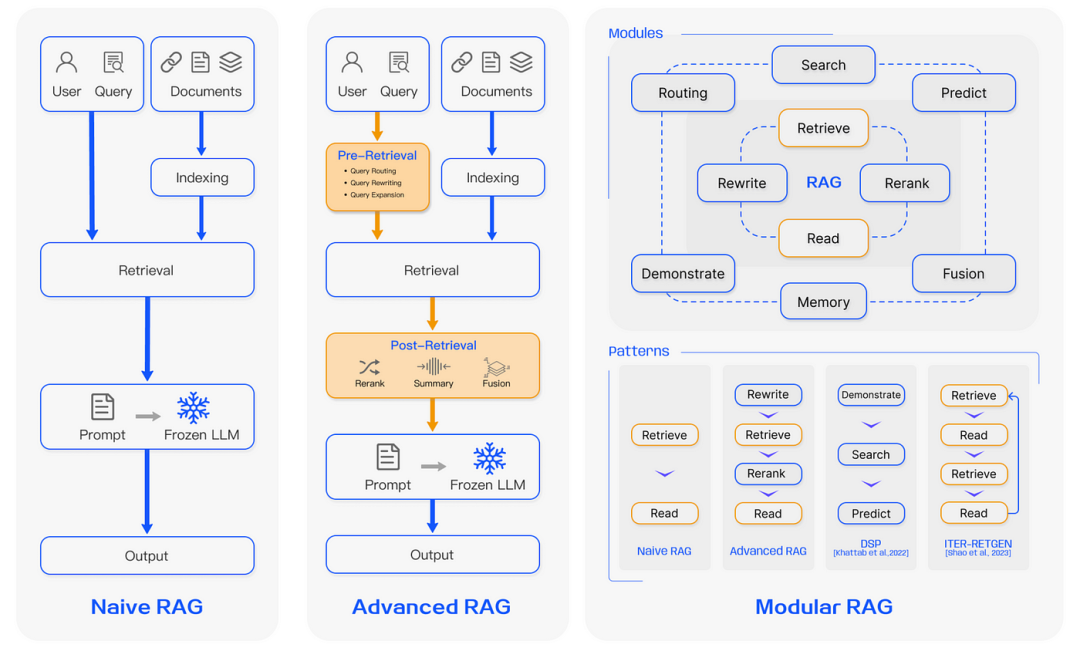
(图片来自网络)
接下来,我们将这些业界方案分为“知识构建”、“知识检索”和“答案生成”三个阶段来看。
阶段 1:知识构建

不难发现,知识构建阶段会涉及到多种大小各异的模型,例如 embedding、OCR 之类小模型可能最低仅需要几 GB 显存,而企业级的知识图谱提取、大语言模型则通常需要上百 GB,因此,在 AI Infra 层面一定要考虑到对显存的灵活切分,以适应各种模型的测试、推理需求。
如图,通过 ZStack AIOS 智塔所支持的显存切分,可以将 24GB 卡切分出 4GB,足以满足高性能向量模型的需要,并能够提供 360 以上 QPS。


阶段 2:知识检索

结构化输出 是指大语言模型(LLM)生成的具有预定义格式的输出,如JSON、XML、表格或其他特定结构的数据,而不是自由形式的文本。这种输出方式使模型的回答具有一致的格式和明确的数据结构,便于后续程序处理和解析。
如下图所示,ZStack AIOS 智塔支持结构化输出(这里通过 Swagger UI 演示),这样开发者不需要处理小模型不遵循指令的情况,这样用小模型处理问题分类或问题优化会方便很多。

阶段 3:答案生成

答案生成阶段对大参数模型的依赖更重,需要更加庞大的 GPU 算力集群,也意味着更高昂的硬件成本,企业需要重视集群架构、网络传输及存储系统的规划和性能提升方案,力求将硬件性能发挥到极致。
如下面视频所示,ZStack AIOS 智塔支持 Nvidia、Huawei、Hygon 等 GPU/NPU 的大模型推理,充分发挥多芯片集群的性能,并且在横向扩展方面具备出色的灵活性,为企业优化算力资源、降低成本提供了有力支持。
ZStack AIOS智塔支持多芯片大模型推理
小结
知识库是企业应用中常见且需求旺盛的部分。然而,RAG 知识库 “Demo 易,上线难” 的问题,始终困扰着大模型应用开发者。这不仅依赖大模型能力提升、工程应用创新微调,更离不开底层平台的支撑优化,多方协作才能构建线上 AI 服务。
如今,知识库不再由单一的大语言模型包揽所有问题,而是在多种工具、模型配合实现,特别是大小模型配合、向量多模态语言模型、OCR 类传统模型和生成式模型配合,
在实践中不断运用各类工具,充分结合业务数据的多样性和特定场景达到比较好的效果,这都需要底层平台的强大支撑。
若想了解 ZStack 在 RAG 场景的经验,可参考此前文章《DeepSeek 企业应用落地:智能客服如何助力科技企业》
场景 2:代码辅助
得益于大量的开源高质量代码,目前 AI 在代码生成上是非常擅长的,我们将 AI 代码辅助分成几种场景,以方便我们在效果、成本之间进行权衡。
1. 开发者以对话形式向 AI 提问
2. 开发者完成代码后由 AI 进行代码评审
3. 开发者通过 IDE 集成 AI 来完成代码补全
4. 开发者提出思路或目标由 AI 完成代码或任务
1、对话场景
目前适合代码辅助的 AI 主要分为通用模型、推理模型和专用模型,其中推理模型意味着模型在生成最终答案之前会输出“思考过程”,专用模型意味着模型为代码场景专门调优。

从上述表格可知,HumanEval 测试生成的代码较短,多数模型已经可以取得较高分数,所以在小规模函数生成以及特定代码的 UT 生成方面,大部分模型基本可以胜任。但想要更好效果,一方面需要较长上下文(开发者常对代码片段反复修改),另一方面则需要得分更高的模型。据我们经验,LiveCodeBench 分数达到 DeepSeek V3,对辅助编写代码就会有很大帮助。
如下图所示,ZStack 产品研发中心每日 Token 消耗量在 300 万至 500 万左右(周末用量会减少),主要使用 Qwen2.5 - 72B、DeepSeek 等模型 。

2、代码评审场景
代码评审任务的实现门槛较低,但其上限颇高。最基础的代码评审,仅需将代码的 diff 补丁发送至模型即可,开发者依据常见代码风格或其他要求设计 prompt,待 AI 回复后,再将回复发送至 Gitlab、Gerrit 等内部评审系统。
然而,这种方式效果欠佳,主要存在以下问题:
-
AI 难以洞悉整个代码库的代码风格;
-
AI 无法掌握代码片段的依赖关系与上下文;
-
AI 无法结合传统 lint 工具进行细致检查。
因此,当下 AI 代码评审常采用一系列手段来增加模型输入,以提升评审效果:
-
在虚拟机(适用于测试代码涉及复杂现有环境操作的情况)或容器(适用于仅进行静态 lint 检查等场景)中运行测试及代码扫描;
-
支持用户对话,并将相关内容结合 Jira 等问题跟踪平台存入向量数据库,便于搜索;
-
借助依赖分析工具为代码搜索更丰富的上下文。

以上架构目前在 ZStack 产品研发中心也得到运用,平均每天 200 多个 contributions(包含代码总结、评论),Review 30 多个 PR,给出 50 多条可行的建议。

下面是 AI 评审的一个具体例子,可以看到 AI 指出了原本在调用的 ZStack 内部库函数 subprocess.call 不够安全,建议改用内部的 check_call 库函数,并给出了示例。

接下来这个例子中,AI 评审的效果更为显著,AI 指出了代码中使用的 SystemTag 可能有误用,这里无论 DataVolume、SystemTag 都是 ZStack 内部的代码概念。这一成果表明,AI 已深度理解 ZStack 的专有概念与架构思路,不仅能够精准发现问题,还能提供切实可行的指导建议 。

3、代码补全场景
前面我们看到大部分模型在 HumanEval 上得分都是比较高的,这意味着简单“代码补全”场景使用以上模型基本都可以正常使用,使用小模型可能更有速度和性价比上的优势。但如果我们希望 AI 更加智能,当前的 AI IDE 或插件往往采用了 Plan+Act 的架构,可能需要推理模型和通用模型配合使用,例如 DeepSeek R1 + DeepSeek V3 或者 DeepSeek R1 Distilled Lllama 70B + Qwen2.5 72B。
4、AI 直接完成任务
以上场景都是以人为主,AI 辅助的形式,哪怕是代码补全不断 Tab 或者 Plan+Act 也往往需要人去验证、测试代码。我们最终期望的形式是人只要提要求,AI 就可以自动完成了,这个对系统的要求与代码评审类似,但是沙盒的重要性会更高,此外需要更多的存储来存放运行过程的记录,下面以 OpenHands 为例进行分析,涉及对象存储、向量模型、大语言模型、容器沙盒:

当前,AI直接执行任务大多仍处于实验阶段,效果高度依赖大模型自身性能。在2024年的测试里,Claude 3.5 Sonnet 是表现最为出色的模型,DeepSeek v2.5 的得分仅为 Claude 3.5 Sonnet 的50% 。虽然尚未对DeepSeek V3展开测试,但鉴于 DeepSeek V3 在 SWE Verified 测试中的表现相较于 V2.5 提升了86%,大致可推断其性能能够达到 Claude 3.5 Sonnet 的水平。
不过,仍存在以下情况:
- OpenHands目前无法基于推理模型制定计划,后续仍有优化空间;
- DeepSeek系列模型暂不支持Vision功能,在支持任务的多样性方面相比 Sonnet存在一定差距。

5、小结
企业应搭建基于本地化基础设施的AI辅助编码体系,结合自身代码库与工作流特性,灵活融合AI技术,进而提升开发效率与代码质量。具体体现在以下几方面:
-
多样化应用场景:目前 AI 在代码辅助领域应用广泛,涵盖对话问答、代码评审、IDE 补全以及自动化任务执行等场景。在不同场景中,企业可按需选用通用模型、推理模型或专用模型,实现精准适配。
-
合理权衡模型选择与性能:在短小函数生成和基本代码补全方面,多数模型已能获得较高分数。但面对复杂代码片段以及需反复修改的上下文场景,就需要得分更高且支持长上下文的模型,如 DeepSeek V3、Qwen2.5 系列等进行规划。企业应依据实际需求,综合考量成本效益,合理调整模型部署。
-
代码评审和上线检验:尽管最简单的评审方式只需传递 diff 补丁,但为了更准确识别代码问题与安全风险,需要结合传统的 lint 工具、虚拟机/容器测试环境,以及依赖分析工具。通过将 AI 评审建议与内部版本控制、 issue 跟踪系统结合,能够更好地满足企业级质量控制要求。
-
本地化部署的重要性:通过自建本地化基础设施,企业可以利用内部代码库和专有工作流来对 AI 模型进行调优,确保模型能更好地理解项目代码风格、依赖关系和特定业务逻辑,从而在安全性、准确性与效果上取得更高保障。与此同时,本地化部署也便于整合企业现有工具体系(如 Gitlab、Gerrit 等),推动 AI 辅助编码方案的落地。
总体而言,企业在构建 AI 辅助编码方案时,不仅要关注 AI 模型的原始生成能力,更要整合内部资源,构建一个包含代码生成、评审、补全及全自动任务执行的闭环体系,实现高效、可靠的编码辅助与质量管控。
场景 3:智能体(Manus)
自上周 Manus 发布以来,智能体直接执行通用任务进入了大众视野,社区中也涌现出 Open Manus、Owl 等各类开源复现成果。这实际上是随着平台支撑能力的发展,上层应用综合运用多种工具所呈现出的成效。
其实在上个月 OpenAI Deep Research 凭借模型+自主搜索+自主阅读已经让很多人感到 AI 的便利,随着 Manus 发布,让更多人看到了 AI 直接完成报告、计划、游戏、网页、声音的可能性。
智能体的概念并不稀奇,但 Manus 相比最早的 Agent 在多个方面实现了革新:
-
充分运用 Browser Use,即通过 AI 使用浏览器阅读网页
-
充分运用 Computer Use,即通过 AI 操作电脑,编写文件、运行代码等
-
通过沙盒运行代码,模仿熟悉计算机和编程的人类来完成任务
接下来,我们将逐一对这几项技术进行介绍。
1、Browser Use
浏览器自动化是个非常“古老”的课题。在 UI 测试中,对浏览器进行各类自动化操作的需求极为迫切。因此,从 Selenium 到 playwright,无论是采用 headless 设计,还是结合截图的设计方式,UI 自动化领域几乎探索了所有可能的途径。自 Vision 模型发布后,尤其是 GPT - 4o、Claude 3.5 展现出对网页极为出色的理解能力以来,人们开始尝试运用模型以端到端的方式去理解和操作浏览器,并且取得了良好的效果。
例如,我们使用开源模型 Qwen2.5 - VL - 72b,成功实现了从 ZStack 官网进入了“帮助与支持”菜单,进而跳转至最新版本特性页面的操作过程。不过该过程存在较高的延迟,Manus 团队或许已针对此情况进行了一定程度的优化。

通过测试集测试也可以看到目前 Qwen2.5-VL-72B 已经在多个测试上超过 Claude 3.5,甚至 7B 模型目前的性能也不错且可以大幅提升运行速度。

2、Computer Use
除了操作浏览器之外,有些情况可能需要 AI 编写代码、调用程序甚至运行一些测试等,测试需要运用到 Computer Use,例如在下面的演示中我们让 AI 自动打开了浏览器,浏览了一些网页最后生成了 Markdown 格式的文件(视频已经过加速)。

Computer Use 对模型的能力要求和 Browser Use 基本是类似的,区别在于目前 Computer Use 往往需要大量编写代码,通过文件来一步步完成工作,对代码的要求比较高,因此推荐使用代码能力强、支持 Tool Use 的模型。
3、沙盒技术
通过上面的分析可以看到,Browser Use 、特别是 Computer Use 在实际运行过程中是存在一定安全风险的,因此需要考虑通过沙盒来确保安全性,因此我们在看 Manus 工作的时候可以看到右侧始终有一个 Manus 的电脑,从最终效果来猜测应该是一个虚拟机或轻量虚拟机而非容器。在我们测试 OpenManus 和 Owl 等 Agent 平台时,均采用了在 ZStack AIOS 平台智塔上启动 Ubuntu 的云主机来测试。

4、小结
Deep Research 基于深度网页搜索构建报告,为我们的调研与学习带来了极大便利。Manus 在此基础上更进一步,尽管不少网文认为其技术壁垒不高,主要依靠工程实现,但我们认为 Manus 这类应用的发展,为企业运用 AI 开辟了广阔的想象空间:
-
模型能力提升驱动优化:随着模型不断进步,其对 Computer Use 的理解将愈发迅速且深入,制定计划的能力也会相应增强。当下,Manus 存在多 Agent 配合时错误可能逐步放大的隐患,但随着模型能力提升,这一问题有望得到缓解。
-
解决企业老旧应用自动化难题:企业内部存在大量无法 API 化的老旧应用,或缺乏 API 支持的业务。借助Browser Use、Computer Use 实现自动化不失为一种可行方案。相较于 RPA,编写 Prompt 更为灵活、便捷。
-
推动生成式 AI 融入企业业务:目前生成式AI主要以文字形式输出,然而文字难以直接对接业务。唯有通过工具调用、函数调用、网页调用等方式,才能加速生成式AI融入企业业务流程。
企业 AI Infra 建设方案建议
通过上面的介绍可以看到企业完整落地各类 AI 应用需要:
-
不同的模型,例如小尺寸的 embedding、rerank、语音,中等尺寸的图形理解、文生视频,大尺寸的推理模型和通用模型等;
-
不同的算力形式,例如沙盒需要启动云主机,模型启动可能通过容器;
-
充分测试工具,快速检验模型服务可支撑的线上并发、比较模型之间的能力差距等;
-
良好的运维辅助,监控和分析模型负载状态、GPU 的工作状态,提供掉卡报警等。

因此如果要构建一个整体化的 AI 平台,可以通过几种方式,我们把各自优缺点和适合场景整理到了下面的表格中:

得益于 ZStack AIOS 智塔的灵活架构,我们给客户提供了多样性的解决方案,不同的客户可以根据自身的机房条件、业务需求和未来规划进行选择,而且得益于同一品牌的软件,现有集群可以通过升级版本纳管 GPU,一体机既可以加入现有平台也可以独立使用,如果处于业务安全诉求不能升级也可以通过云管来统一管理、统一监控、统一运维,给予用户充分的自由度。
总结与展望
在刚过去的2024 年,AI 落地的关键场景聚焦于文生图、知识库与代码辅助领域。在设计、影视、广告及游戏行业,文生图技术已广泛落地应用。随着知识提取技术的精进以及大量开源知识库软件的兴起,知识库也为更多人所熟知。而代码辅助更是成为多数开发者工作中不可或缺的部分。
然而,生成式 AI 融入业务的路径与上一代决策式 AI 有所不同。决策式 AI 往往直接切入业务,如提升风控准确率、优化商品推荐等。新一代 AI 则率先从赋能个体的生产效率起步,首先提升了设计师、软件工程师以及客服技术支持人员的工作效率。基于此,企业有必要搭建起支撑底层创新的平台。这一平台应确保无论有无代码基础的业务人员,都能在无需担忧 “Token” 费用及 “信息安全” 问题前提下,借助流畅且高性能的模型 API,充分释放自身创造力,快速尝试各类新兴的 AI 应用 。

因此 ZStack AIOS 智塔实现了上述的三层架构:
-
智算底座:确保运维人员能够安全、便捷的运维智算集群,通过多芯片兼容保障供应链安全;
-
模型层:允许用户及时使用到新发布的模型、简化模型的运维,如果企业自身具有 AI 的团队,AI 团队也可以将自身优化过的模型或测试的模型直接发布到云上,供业务部门测试和对比;
-
运营层与应用层:不仅提供了服务评测对比不同模型的效果和性能,还内置了一些常用的 AI 应用方便企业快速部署搭建常见应用,加速创新,如果有门户运营的需求,也可以实现多租户管理、计费账单等功能。
基于上述三层架构,充分融合云平台本身具备的云主机、VPC 网络、多租户等功能,ZStack AIOS 智塔为多个企业打造了智算创新的底座,为企业发挥 AI、落地 AI 奠定了坚实的基础。
 304


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


