


目录
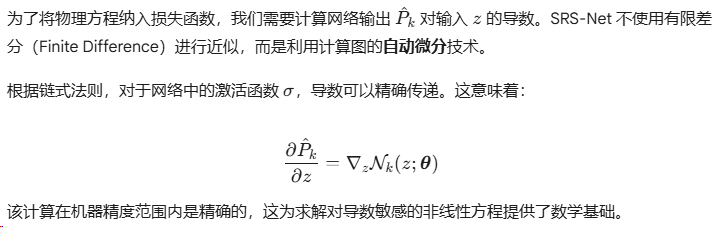
3.2 自动微分 (Automatic Differentiation, AD)
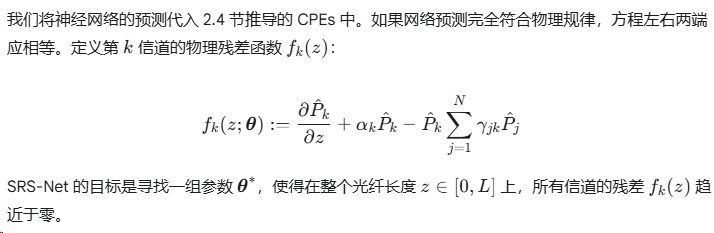
3.3 物理残差流形 (Physics Residual Manifold)
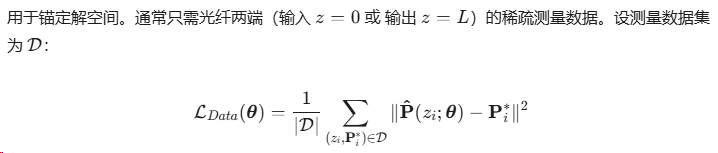
4.1 数据损失 ($\mathcal{L}_{Data}$)
4.2 物理信息损失 ($\mathcal{L}_{Physics}$)
2) 关键实现(PyTorch)—— 主文件 srs_pinn.py
4) 损失函数(loss)与训练(forward / inverse / combined)
1. 引言
在现代高容量波分复用(WDM)光通信系统与高功率光纤激光器中,受激拉曼散射(Stimulated Raman Scattering, SRS)是限制系统性能的核心非线性效应。传统的数值求解方法(如龙格-库塔法、分步傅里叶法)虽然成熟,但在处理高维参数空间、反向参数辨识及实时优化问题时,面临计算复杂度高且难以微分的瓶颈。
SRS-Net 是一种创新性的科学机器学习(SciML)框架,它将光纤非线性光学的物理控制方程(偏微分方程组)直接嵌入深度神经网络的损失流形中。本章将从第一性原理出发,详细推导控制SRS功率演化的耦合方程组,并从数学角度证明SRS-Net如何利用自动微分机制实现对该物理系统的精确逼近与求解。
2. 物理模型推导:SRS耦合功率方程
为了构建SRS-Net的物理约束核心,我们首先必须推导描述多信道光波在光纤中相互作用的数学模型。
2.1 系统假设与变量定义
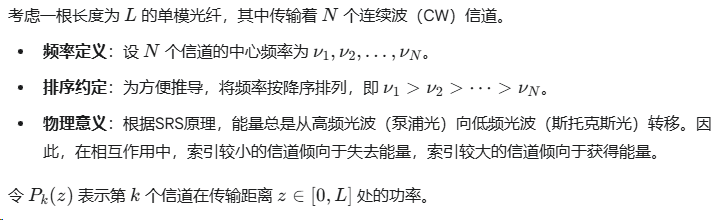
2.2 相互作用机制分析
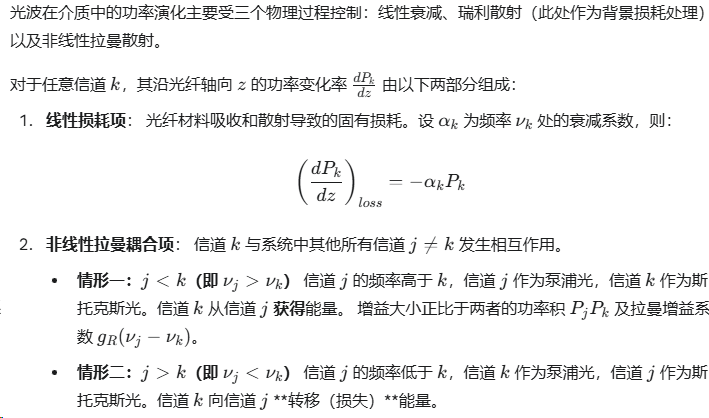
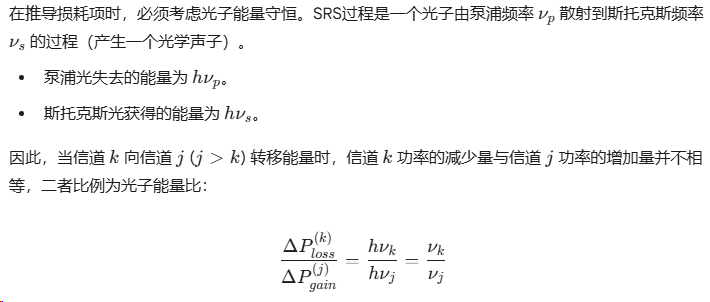
2.3 能量守恒修正与光子通量
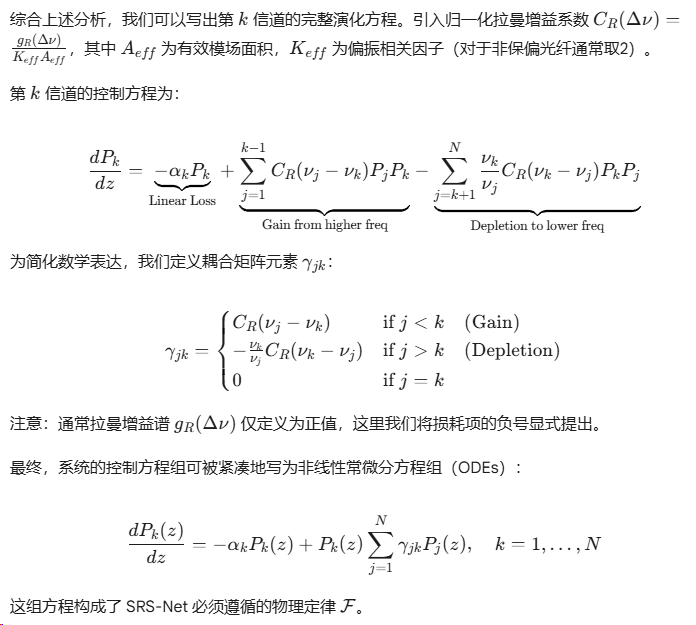
2.4 完整的耦合常微分方程组 (CPEs)
3. SRS-Net 算法架构与原理
SRS-Net 的核心思想是利用深度神经网络作为上述物理方程解的通用逼近器,并通过物理残差约束网络的训练。
3.1 神经网络映射构建
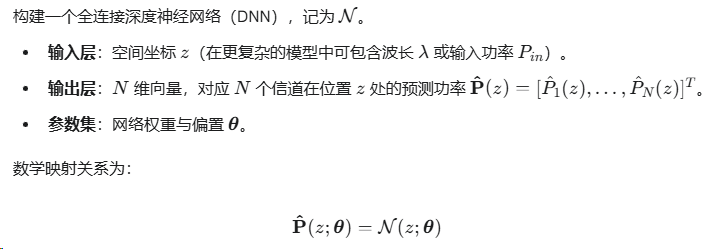
3.2 自动微分 (Automatic Differentiation, AD)
3.3 物理残差流形 (Physics Residual Manifold)
4. 优化目标与损失函数设计

4.1 数据损失 ($\mathcal{L}_{Data}$)
4.2 物理信息损失 ($\mathcal{L}_{Physics}$)
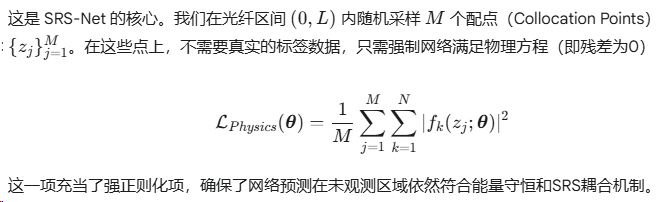
4.3 总变分损失
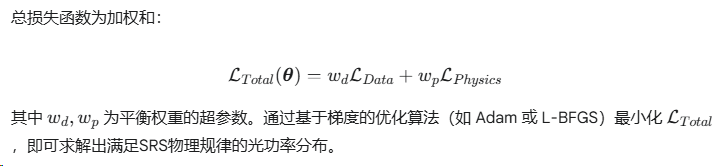
5. 算法的通用性:正向预测与反向演化
SRS-Net 框架的一个显著数学特性是其参数反演能力。
5.1 正向问题 (Forward Problem)

5.2 反向问题 (Inverse Problem)
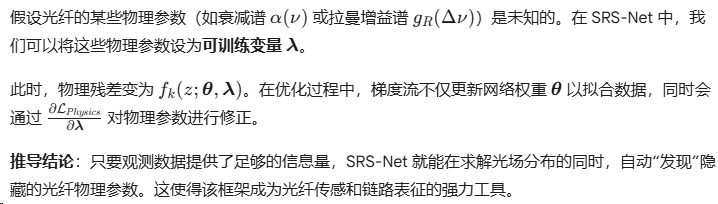
6. 总结
SRS-Net 并非简单的黑盒模型,而是一个物理可解释的计算框架。它通过严格推导的耦合功率方程(CPEs)定义了假设空间,利用自动微分消除了数值离散误差,并通过多任务损失函数实现了从稀疏数据到全域物理场的高精度重构。这一算法原理为非线性光纤光学中的复杂系统建模、参数辨识及逆向设计提供了统一且严密的数学解法。
7.PyTorch 实现骨架(含注释与关键细节)
说明:下面的实现为可直接运行的模板,需要根据你的具体通道数(N)、频段、边界条件、数据读取等做小的参数替换。代码尽量详尽注释以便用于论文复现实验与工程改进。论文中方程与论述已被用作物理约束的来源。Nature
1) 主要思路概览(中文、简短)
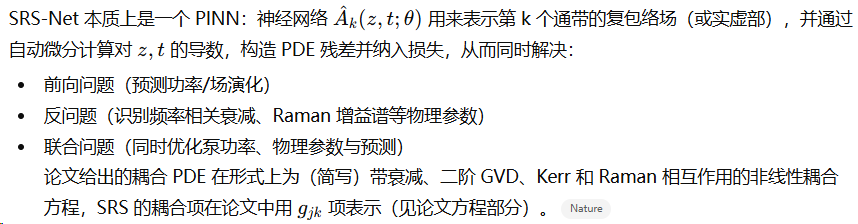
SRS-Net 本质上是一个 PINN:神经网络 A^k(z,t;θ) \hat{A}_k(z,t;\theta)A^k(z,t;θ) 用来表示第 k 个通带的复包络场(或实虚部),并通过自动微分计算对 z,tz,tz,t 的导数,构造 PDE 残差并纳入损失,从而同时解决:
-
前向问题(预测功率/场演化)
-
反问题(识别频率相关衰减、Raman 增益谱等物理参数)
-
联合问题(同时优化泵功率、物理参数与预测)
论文给出的耦合 PDE 在形式上为(简写)带衰减、二阶 GVD、Kerr 和 Raman 相互作用的非线性耦合方程,SRS 的耦合项在论文中用 gjkg_{jk}gjk 项表示(见论文方程部分)。Nature
2) 关键实现(PyTorch)—— 主文件 srs_pinn.py
# srs_pinn.py
# 运行环境:Python 3.9+, PyTorch 2.x
# 安装依赖:pip install torch numpy tqdm

import torch
import torch.nn as nn
import torch.optim as optim
from torch.autograd import grad
import numpy as np
from tqdm import tqdm

# ---------------------------
# 1) 工具函数
# ---------------------------
def to_tensor(x, dtype=torch.float32, device='cpu'):
    return torch.tensor(x, dtype=dtype, device=device)

def complex_from_two(real, imag):
    return torch.complex(real, imag)

def split_complex(u):
    return u.real, u.imag

# 小技巧:用于初始化频域/时间归一化
class Normalizer:
    def __init__(self, arr):
        self.mean = np.mean(arr)
        self.std = np.std(arr) + 1e-12
    def normalize(self, arr):
        return (arr - self.mean) / self.std
    def denormalize(self, arr):
        return arr * self.std + self.mean

# ---------------------------
# 2) 网络:复数 MLP(输出实部+虚部)
#    支持 Fourier features 输入(对时间 t 做高频特征扩充)
# ---------------------------
class FourierFeatures(nn.Module):
    def __init__(self, in_dim, n_fours=64, scale=10.0):
        super().__init__()
        self.B = nn.Parameter(torch.randn(in_dim, n_fours) * scale, requires_grad=False)  # fixed random proj
    def forward(self, x):  # x: [..., in_dim]
        proj = 2 * np.pi * x @ self.B  # [..., n_fours]
        return torch.cat([torch.sin(proj), torch.cos(proj)], dim=-1)

class ComplexMLP(nn.Module):
    def __init__(self, in_dim, width=256, depth=6, fourier_t=None, out_channels=1):
        super().__init__()
        self.fourier = fourier_t
        last_in = in_dim
        if self.fourier is not None:
            self.ff_dim = self.fourier.B.shape[1] * 2
            last_in += self.ff_dim

        layers = []
        for i in range(depth):
            layers.append(nn.Linear(last_in if i==0 else width, width))
            layers.append(nn.GELU())
        # 输出实部和虚部
        self.net = nn.Sequential(*layers)
        self.head_real = nn.Linear(width, out_channels)
        self.head_imag = nn.Linear(width, out_channels)

    def forward(self, x):  # x shape [batch, in_dim]
        if self.fourier is not None:
            t = x[:, -1:].clone()  # 假设 time 在最后一维
            ff = self.fourier(t)
            x = torch.cat([x, ff], dim=-1)
        h = self.net(x)
        real = self.head_real(h)
        imag = self.head_imag(h)
        return real, imag
3) 物理解算子(残差)实现
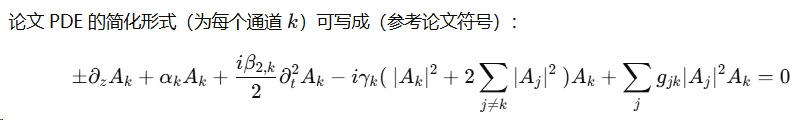
(实际论文里还有多项耦合与频依赖项 —— 在代码里我们把这些项模块化以便替换/扩展)。Nature

# ---------------------------
# PDE residual 函数
# ---------------------------
def compute_pde_residual(net, zk_tensor, tk_tensor, params, mode='time'):
    """
    net: ComplexMLP 网络,输入 [z,t],输出 real, imag
    zk_tensor, tk_tensor: torch tensors with requires_grad=True
    params: dict 包含 alpha_k, beta2_k, gamma_k, g_jk 等(torch tensors)
    returns: residual_real, residual_imag (both shape [batch, channels])
    """
    # 拼输入
    x = torch.cat([zk_tensor, tk_tensor], dim=-1)  # assume shape [B, 2]
    real, imag = net(x)  # shape [B, channels]
    Ak = torch.complex(real, imag)  # complex field

    # 1) z 导数
    # 注意:需要 ensure zk_tensor requires_grad=True
    grads_z = grad(real.sum() + imag.sum(), zk_tensor, create_graph=True)[0]  # shape [B, 1]
    dreal_dz = grads_z[:, 0:1]  # if multiple dims, adapt
    # imag part
    grads_z_im = grad(imag.sum(), zk_tensor, create_graph=True)[0]
    dimag_dz = grads_z_im[:, 0:1]

    dAk_dz = torch.complex(dreal_dz, dimag_dz)

    # 2) t 二阶导
    grads_t = grad(real.sum() + imag.sum(), tk_tensor, create_graph=True)[0]
    dreal_dt = grads_t[:, 0:1]
    dimag_dt = grad(imag.sum(), tk_tensor, create_graph=True)[0][:,0:1]
    # 第二阶(对 t 再微分)
    d2real_dt2 = grad(dreal_dt.sum(), tk_tensor, create_graph=True)[0][:,0:1]
    d2imag_dt2 = grad(dimag_dt.sum(), tk_tensor, create_graph=True)[0][:,0:1]
    d2Ak_dt2 = torch.complex(d2real_dt2, d2imag_dt2)

    # 参数(广播到 batch)
    alpha = params['alpha']  # shape [channels]
    beta2 = params['beta2']
    gamma = params['gamma']
    g_jk = params['g']  # shape [channels, channels] or function

    # 注意广播匹配;Ak shape [B, C]
    # Self / cross terms
    abs2 = (Ak.abs()**2)  # [B, C]

    # Kerr term: - i * gamma_k ( |Ak|^2 + 2 * sum_{j != k} |Aj|^2 ) * Ak
    cross = 2.0 * (abs2.sum(dim=1, keepdim=True) - abs2)  # [B, C]
    kerr_factor = -1j * gamma * (abs2 + cross)  # [B] or [C] broadcast
    kerr_term = kerr_factor * Ak

    # Raman term: sum_j g_jk |Aj|^2 Ak
    # implement matrix multiplication per-sample
    # abs2 [B, C], g_jk [C, C] -> result [B, C]
    raman_factors = (abs2.unsqueeze(1) @ g_jk).squeeze(1)  # check dims
    raman_term = raman_factors * Ak  # complex

    # GVD term: i * beta2 / 2 * d2Ak_dt2
    gvd_term = 1j * beta2/2.0 * d2Ak_dt2

    # Attenuation: alpha * Ak
    atten_term = alpha * Ak

    # sign for direction: if backward propagation then -d/dz ? paper uses ±
    # assume forward: +dAk_dz ...
    residual = dAk_dz + atten_term + gvd_term + kerr_term + raman_term

    return residual.real, residual.imag
注:上面
grad的用法对批量可能需要更细的实现(例如对每个样本单独调用 grad 或使用torch.autograd.functional.jacobian),这里给出逻辑骨架。实际工程中应使用矢量化/批次策略以提升速度(见性能建议)。
4) 损失函数(loss)与训练(forward / inverse / combined)
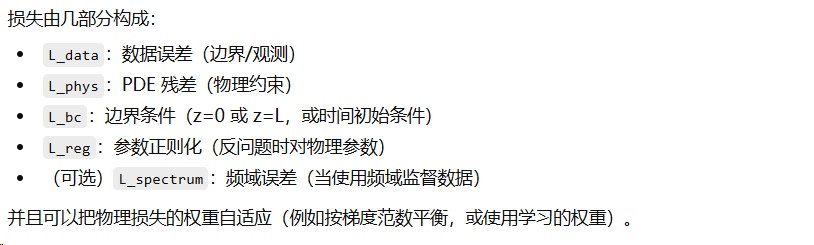
下面给出训练循环样板(包含学参训练):
# ---------------------------
# Training loop skeleton
# ---------------------------
def train(model, params, data_loader, epochs=10000, device='cuda'):
    model.to(device)
    # 将待学习的物理参数作为 torch.nn.Parameter 放入优化器(若做 inverse)
    learnables = [p for p in model.parameters()]
    # 假设 params_to_learn 为 dict of torch.nn.Parameter
    if 'learnables' in params:
        for k, p in params['learnables'].items():
            learnables.append(p)

    optimizer = optim.Adam(learnables, lr=1e-3)
    scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=2000, gamma=0.5)

    for epoch in range(epochs):
        model.train()
        total_loss = 0.0
        pbar = tqdm(data_loader)
        for batch in pbar:
            # batch should provide z_pts, t_pts, data_obs (optional)
            z_batch = batch['z'].to(device).requires_grad_(True)
            t_batch = batch['t'].to(device).requires_grad_(True)
            # Observed complex field/power if available
            obs_real = batch.get('real', None)
            obs_imag = batch.get('imag', None)

            optimizer.zero_grad()
            res_real, res_imag = compute_pde_residual(model, z_batch, t_batch, params)

            # physics loss (MSE) on residuals
            L_phys = (res_real**2 + res_imag**2).mean()

            # data loss if observations exist
            L_data = torch.tensor(0.0, device=device)
            if obs_real is not None:
                # forward pass to get predictions at observed points
                x_obs = torch.cat([z_batch, t_batch], dim=-1)
                pred_r, pred_i = model(x_obs)
                L_data = ((pred_r - obs_real.to(device))**2 + (pred_i - obs_imag.to(device))**2).mean()

            # optional bc loss, param reg
            L = params.get('w_phys', 1.0) * L_phys + params.get('w_data', 1.0) * L_data

            L.backward()
            # Optional: gradient clipping
            torch.nn.utils.clip_grad_norm_(learnables, max_norm=1.0)
            optimizer.step()
            total_loss += L.item()
            pbar.set_description(f"loss {total_loss:.4e}")

        scheduler.step()
    return model, params
5) 频域 / 多通道扩展说明(实现提示)
论文指出 SRS-Net 结合时域 PINN 与频域分析来处理多信道 / 宽带系统(C+L 带 ~10 THz)。实现要点:
-
把时间维度做 FFT:对于宽带多信道,直接在频域上描述耦合会更自然(Raman 增益谱、频依赖衰减等)。使用
torch.fft.fft与torch.fft.ifft在网络-物理约束之间来回转换。 -
网络输出可为频域复谱:网络输入仍可为 z(传播坐标)与 channel index(one-hot 或连续频率值),输出为复频谱 A~k(z,ω) \tilde{A}_k(z,\omega)A~k(z,ω)。对网络输出做 ifft 得到时域,再计算非线性项(Kerr、|A|^2)——注意非线性最好在时域计算(因为 |A|^2 是时域操作),然后再 FFT 回频域以与线性项/频域增益匹配。
-
频域-时域来回(关键开销点):实现时应尽量批量化并在 GPU 上完成全部 FFT 操作,避免 CPU-GPU 往返。
-
Raman 增益 g_{jk}:可预先构建频依赖增益矩阵(channels × channels),并把它作为常数或可学的参数(用于 inverse)。
示例伪代码片段(频域 forward):
# 输入: z_grid shape [B,1], freq_grid shape [Nf]  (or channel dim)
# 网络直接输出 complex spectrum S(z, f)
real, imag = model(torch.cat([z_repeat, freq_coord], dim=-1))
S = torch.complex(real, imag)  # [B, Nf]

# 时域转换
a_t = torch.fft.ifft(S, dim=-1)  # [B, Nt]
# 非线性计算在时域: |a_t|^2 * a_t etc.
nl_time = compute_nonlinear_time(a_t)  # [B, Nt]
# 回频域
nl_freq = torch.fft.fft(nl_time, dim=-1)
# 构造残差:线性 frequency-dependent operator + nl_freq + losses...
6) 初始/边界条件与观测点选取策略
-
对 PINN:在 z=0 处强制输入边界(已知输入功率谱/场),在 z=L 处如有观测则作为
L_data。 -
对 bidirectional 情形:分别定义正向/反向网络或者在网络中加入 direction token(+1 或 -1),并在 PDE 残差中引入 ±∂/∂z 符号(正向和反向同时优化)。
-
点采样:把训练点分为:
-
PDE 内点(随机采样 z×t 或 z×freq)
-
边界点(z=0,z=L)
-
观测点(实验/仿真测得)
这样可以让L_phys、L_bc、L_data协同优化。
-
7) 反问题(Inverse)实现要点
-
把需要识别的物理量(如
alpha(ω),g(ω))作为torch.nn.Parameter,并加入优化器;在compute_pde_residual中使用这些参数(记得对其设定合理初值与约束范围)。 -
为稳定性,可对参数加 log 或 sigmoid 变换来保证正值或在合理区间。
-
加入
L_reg(例如 L2 或 Tikhonov)以避免过拟合 / 非唯一解。
示例:
# 将 alpha(ω) 设为可学参数
alpha_param = nn.Parameter(torch.ones(num_channels) * 0.2)  # 初值
params['learnables'] = {'alpha': alpha_param}
# 在残差里使用 torch.abs(alpha_param) 或 softplus 保证正值
alpha = torch.nn.functional.softplus(params['learnables']['alpha'])
8) 性能优化 & 实战建议(工程级细节)
-
归一化:对 z,t,频率与功率做归一化(零均值单位方差)能大幅提升训练稳定性。
-
批次与向量化:尽量把残差计算矢量化(避免 for-loop),对大模型使用较大 batch。
-
自动微分注意:对高阶导数(如 ∂²/∂t²)使用
torch.autograd.grad时要注意内存消耗,必要时使用 checkpointing 或分块计算。 -
权重平衡:物理损失与数据损失量级差异大时,使用自适应权重(例如根据各损失梯度范数动态缩放)。
-
混合精度:对于大规模频域 FFT、网络,可尝试
torch.cuda.amp混合精度来减少显存并加速。 -
初始化:Fourier feature + small init 能帮助表征高频时间结构(波形)。
-
调试技巧:先只训练
L_data(监督)确认网络能拟合,再加入L_phys逐步调权重。 -
验证速度:论文指出 SRS-Net 在实验设置下相较经典数值方法能达到数十到上百倍的速度提升——在工程实现中,关键瓶颈通常在频域 FFT 与高阶 autodiff,上述优化能显著缩短训练/推理时间。Nature
9) 小型完整示例:合成数据 + 训练(可直接试跑)
下面是一个最小可跑示例(时域单通道问题)把上面模块拼起来,省略了一些工程代码(数据加载、保存、详尽日志),但足够演示完整流程:
# example_run.py
import numpy as np
import torch
from torch.utils.data import DataLoader, TensorDataset

# 导入上面定义的 ComplexMLP, FourierFeatures, train, compute_pde_residual 等

device = 'cuda' if torch.cuda.is_available() else 'cpu'

# 合成:简单单通道传输 (长度 L, 时间窗口 T)
L = 1.0
Tmax = 1.0
n_samples = 2000

# 采样 z in [0, L], t in [-Tmax/2, Tmax/2]
z_samples = np.random.rand(n_samples, 1) * L
t_samples = (np.random.rand(n_samples, 1) - 0.5) * Tmax

# 构造合成 ground-truth: 简单高斯脉冲推进(仅示例)
def ground_truth_field(z, t):
    # 简单相位/衰减示例
    amp = np.exp(-z*0.1) * np.exp(- (t**2)/(0.02))
    phase = -2.0 * z + 5.0 * t
    return amp * np.cos(phase), amp * np.sin(phase)

real_gt, imag_gt = ground_truth_field(z_samples, t_samples)

# DataLoader
dataset = TensorDataset(torch.tensor(z_samples, dtype=torch.float32),
                        torch.tensor(t_samples, dtype=torch.float32),
                        torch.tensor(real_gt, dtype=torch.float32),
                        torch.tensor(imag_gt, dtype=torch.float32))
loader = DataLoader(dataset, batch_size=256, shuffle=True)

# 网络
fourier = FourierFeatures(in_dim=1, n_fours=64, scale=10.0)
model = ComplexMLP(in_dim=2, width=128, depth=5, fourier_t=fourier, out_channels=1)

# params(示例常数)
params = {
    'alpha': torch.tensor([0.1], device=device),
    'beta2': torch.tensor([0.0], device=device),
    'gamma': torch.tensor([0.0], device=device),
    'g': torch.zeros((1,1), device=device),  # single channel no cross-term
    'w_phys': 1.0,
    'w_data': 1.0,
}

# 简化 train wrapper(使用上面 train 函数)
model, params = train(model, params, loader, epochs=5000, device=device)
 1849


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


