


6.1 视频采集标准与版权合规要求
视频采集应以工程化、可审计与合规为核心,采集策略必须满足最小必要原则并保留完整的许可链与元数据。在数据源确认阶段,应优先使用明确授权的数据来源,并对每一来源保存书面或电子同意记录。所有采集设备需统一配置标准化参数,包括分辨率、帧率与编码格式,并在采集端实时嵌入或并行生成 sidecar 元数据文件,用以记录采集时间、设备标识、操作员、许可编号、采集设置与文件哈希。文件命名与版本管理应采用规则化格式,以确保在后续处理、标注与归档过程中可溯源。对不同任务给出差异化的质量门槛:一般场景建议最小 1280×720、15–30 FPS;对动作细粒度识别任务建议保留 1920×1080、30 FPS 以上的原始备份。全流程必须实现加密与权限控制,传输通道使用 TLS,存储侧实现访问控制与周期性安全审计。
数据采样策略应结合任务属性与存储/标注成本权衡确定。对于长期、持续采集的静态摄像头,均匀采样能保证时间代表性;对于长时段但目标稀少的视频,事件驱动采样可在保证覆盖目标帧的同时显著节约标注资源;对于追求样本多样性且希望降低时间偏倚的场景,可在均匀采样基础上并入随机抽样以打破周期性偏差。工程实现需记录采样规则与参数,并将采样输出与原始文件的 sidecar 元数据关联,便于后续回溯与再采样。为减少偏差,采样规则在不同时间段、不同设备类型与不同环境条件下按配置文件自动调整,所有参数变更与版本均纳入变更日志。
隐私保护与去标识化在数据生命周期中必须优先执行。对包含可识别自然人的视频应先行评估识别风险并在可行条件下在采集端或近源处实现去标识化处理。去标识化方法包括但不限于面部模糊或像素化、车牌遮挡、音轨删除或替换以及对原始图像进行受控的几何变换。所有去标识化操作应记录使用的方法和模型版本并保留审计样本用于人工复核。自动化去标识化的置信度低于预设阈值的样本必须进入人工审核队列;人工审核结果和修正记录应与对应媒体文件的 sidecar 元数据一致保存。原始可识别数据的保存应有严格的时间窗,超过保留期的数据应做安全删除或转入加密长期归档,并记录删除操作的哈希与时间戳。
自动标注体系要求在保证合规与去标识化前提下保持可重复、可验证的输出。自动标注模型应以容器化、版本化的方式部署,所有推理产出需包含模型标识符、版本号、推理时间、置信度分布与输入文件的哈希。自动标注格式应支持训练流程与人工审核流程,常用格式包括 YOLO 相对坐标的 .txt、COCO 的 JSON 以及带置信度的扩展标签文件。低置信度或关键类别的样本必须进入人工复核或重标注队列,人工修正操作应保存为新版本并与先前自动标注版本共同存档以便追溯。导出训练集时应附带数据许可清单与不可公开说明,确保模型开发与共享遵循许可约束和机构政策。
以下为完整的工程化模板,包含 Docker Compose 配置、各服务的 Dockerfile 与 Python 脚本示例,覆盖采集、预处理(转码、去标识化、抽帧)与自动标注环节,并包含配置文件与最小化的运行说明。模板以 S3 兼容对象存储(MinIO)为介质,PostgreSQL 用于存储元数据与审计日志,服务之间通过环境变量与配置文件解耦。所有脚本可作为工程骨架直接使用或作为参考进行扩展。
项目结构
video-pipeline/
├─ docker-compose.yml
├─ services/
│  ├─ collector/
│  │  ├─ Dockerfile
│  │  └─ collector.py
│  ├─ preprocess/
│  │  ├─ Dockerfile
│  │  ├─ preprocess.py
│  │  └─ deidentify.py
│  ├─ annotator/
│  │  ├─ Dockerfile
│  │  └─ auto_label_yolo.py
├─ config/
│  └─ config.yaml
├─ scripts/
│  └─ entrypoint.sh
└─ README.md
docker-compose.yml
version: "3.8"

services:
  minio:
    image: minio/minio:RELEASE.2025-01-01T00-00-00Z
    environment:
      MINIO_ROOT_USER: minioadmin
      MINIO_ROOT_PASSWORD: minioadmin
    volumes:
      - minio_data:/data
    command: server /data
    ports:
      - "9000:9000"
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:9000/minio/health/live"]
      interval: 30s
      timeout: 10s
      retries: 3

  postgres:
    image: postgres:15
    environment:
      POSTGRES_DB: pipeline
      POSTGRES_USER: pipeline
      POSTGRES_PASSWORD: pipelinepass
    volumes:
      - pgdata:/var/lib/postgresql/data
    ports:
      - "5432:5432"

  collector:
    build: ./services/collector
    environment:
      S3_ENDPOINT: http://minio:9000
      S3_ACCESS_KEY: minioadmin
      S3_SECRET_KEY: minioadmin
      S3_BUCKET: raw-videos
      POSTGRES_DSN: postgres://pipeline:pipelinepass@postgres:5432/pipeline
    depends_on:
      - minio
      - postgres

  preprocess:
    build: ./services/preprocess
    environment:
      S3_ENDPOINT: http://minio:9000
      S3_ACCESS_KEY: minioadmin
      S3_SECRET_KEY: minioadmin
      S3_BUCKET_RAW: raw-videos
      S3_BUCKET_PRE: preprocessed
      POSTGRES_DSN: postgres://pipeline:pipelinepass@postgres:5432/pipeline
    depends_on:
      - minio
      - postgres

  annotator:
    build: ./services/annotator
    environment:
      S3_ENDPOINT: http://minio:9000
      S3_ACCESS_KEY: minioadmin
      S3_SECRET_KEY: minioadmin
      S3_BUCKET_PRE: preprocessed
      S3_BUCKET_LABELS: labels
      MODEL_PATH: /models/yolov8n.pt
      POSTGRES_DSN: postgres://pipeline:pipelinepass@postgres:5432/pipeline
    volumes:
      - ./models:/models
    depends_on:
      - minio
      - postgres

volumes:
  minio_data:
  pgdata:
services/collector/Dockerfile
FROM python:3.11-slim

WORKDIR /app
COPY collector.py /app/
COPY requirements.txt /app/
RUN pip install --no-cache-dir -r requirements.txt

ENTRYPOINT ["python", "collector.py"]
services/collector/requirements.txt
boto3
psycopg2-binary
pyyaml
requests
services/collector/collector.py
import os
import uuid
import hashlib
import time
import json
import boto3
import psycopg2
from datetime import datetime
from urllib.parse import urlparse
from pathlib import Path

S3_ENDPOINT = os.environ.get("S3_ENDPOINT")
S3_ACCESS_KEY = os.environ.get("S3_ACCESS_KEY")
S3_SECRET_KEY = os.environ.get("S3_SECRET_KEY")
S3_BUCKET = os.environ.get("S3_BUCKET", "raw-videos")
POSTGRES_DSN = os.environ.get("POSTGRES_DSN")

s3 = boto3.client(
    "s3",
    endpoint_url=S3_ENDPOINT,
    aws_access_key_id=S3_ACCESS_KEY,
    aws_secret_access_key=S3_SECRET_KEY,
)

def sha256_file(path):
    h = hashlib.sha256()
    with open(path, "rb") as f:
        for chunk in iter(lambda: f.read(8192), b""):
            h.update(chunk)
    return h.hexdigest()

def upload_to_s3(local_path, key):
    s3.upload_file(local_path, S3_BUCKET, key)
    return f"{S3_ENDPOINT}/{S3_BUCKET}/{key}"

def record_metadata(conn, meta):
    cur = conn.cursor()
    cur.execute("""
        INSERT INTO media (uuid, filename, s3_url, sha256, device_id, collected_at, license_id, metadata)
        VALUES (%s,%s,%s,%s,%s,%s,%s)
    """, (
        meta["uuid"],
        meta["filename"],
        meta["s3_url"],
        meta["sha256"],
        meta.get("device_id"),
        meta["collected_at"],
        meta.get("license_id"),
        json.dumps(meta.get("metadata", {}))
    ))
    conn.commit()
    cur.close()

def main():
    # 本示例展示本地目录上传到对象存储并记录元数据
    local_dir = os.environ.get("LOCAL_CAPTURE_DIR", "/capture")
    files = list(Path(local_dir).glob("*.mp4"))
    conn = psycopg2.connect(POSTGRES_DSN)
    for f in files:
        uuid_str = str(uuid.uuid4())
        sha = sha256_file(str(f))
        key = f"{uuid_str}_{f.name}"
        s3_url = upload_to_s3(str(f), key)
        meta = {
            "uuid": uuid_str,
            "filename": f.name,
            "s3_url": s3_url,
            "sha256": sha,
            "device_id": os.environ.get("DEVICE_ID", "device-unknown"),
            "collected_at": datetime.utcnow().isoformat()+"Z",
            "license_id": os.environ.get("LICENSE_ID"),
            "metadata": {
                "resolution": None,
                "fps": None
            }
        }
        record_metadata(conn, meta)
    conn.close()

if __name__ == "__main__":
    main()
services/preprocess/Dockerfile
FROM python:3.11-slim

WORKDIR /app
COPY preprocess.py deidentify.py /app/
COPY requirements.txt /app/
RUN apt-get update && apt-get install -y ffmpeg libgl1 && rm -rf /var/lib/apt/lists/*
RUN pip install --no-cache-dir -r requirements.txt

ENTRYPOINT ["python", "preprocess.py"]
services/preprocess/requirements.txt
boto3
psycopg2-binary
opencv-python-headless
pyyaml
tqdm
services/preprocess/deidentify.py
import cv2
import os
import uuid
import json
import time

FACE_CASCADE = cv2.data.haarcascades + "haarcascade_frontalface_default.xml"

def blur_region(img, xywh, ksize=(51,51)):
    x,y,w,h = xywh
    roi = img[y:y+h, x:x+w]
    if roi.size == 0:
        return img
    roi = cv2.GaussianBlur(roi, ksize, 0)
    img[y:y+h, x:x+w] = roi
    return img

def deidentify_video(input_path, output_path, audit_json):
    cap = cv2.VideoCapture(input_path)
    if not cap.isOpened():
        raise RuntimeError("cannot open video")
    width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
    height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
    fps = cap.get(cv2.CAP_PROP_FPS) or 25.0
    fourcc = cv2.VideoWriter_fourcc(*'mp4v')
    out = cv2.VideoWriter(output_path, fourcc, fps, (width, height))
    face_cascade = cv2.CascadeClassifier(FACE_CASCADE)
    frame_idx = 0
    faces_total = 0
    sample_frames = []
    while True:
        ret, frame = cap.read()
        if not ret:
            break
        gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
        faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(30,30))
        for f in faces:
            frame = blur_region(frame, f, ksize=(51,51))
            faces_total += 1
        if frame_idx % 1000 == 0:
            sample_path = f"{uuid.uuid4().hex}_sample.jpg"
            cv2.imwrite(sample_path, frame)
            sample_frames.append(sample_path)
        out.write(frame)
        frame_idx += 1
    cap.release()
    out.release()
    audit = {
        "output": os.path.basename(output_path),
        "frames_processed": frame_idx,
        "faces_blurred": faces_total,
        "samples": sample_frames,
        "timestamp": time.strftime("%Y-%m-%dT%H:%M:%SZ", time.gmtime())
    }
    with open(audit_json, "w") as f:
        json.dump(audit, f, indent=2)
    return audit
services/preprocess/preprocess.py
import os
import tempfile
import boto3
import psycopg2
import subprocess
from urllib.parse import urlparse
from deidentify import deidentify_video
import json
import hashlib
from pathlib import Path

S3_ENDPOINT = os.environ.get("S3_ENDPOINT")
S3_ACCESS_KEY = os.environ.get("S3_ACCESS_KEY")
S3_SECRET_KEY = os.environ.get("S3_SECRET_KEY")
S3_BUCKET_RAW = os.environ.get("S3_BUCKET_RAW", "raw-videos")
S3_BUCKET_PRE = os.environ.get("S3_BUCKET_PRE", "preprocessed")
POSTGRES_DSN = os.environ.get("POSTGRES_DSN")

s3 = boto3.client(
    "s3",
    endpoint_url=S3_ENDPOINT,
    aws_access_key_id=S3_ACCESS_KEY,
    aws_secret_access_key=S3_SECRET_KEY,
)

def download_from_s3(key, target):
    s3.download_file(S3_BUCKET_RAW, key, target)

def upload_to_s3(file_path, bucket, key):
    s3.upload_file(file_path, bucket, key)
    return f"{S3_ENDPOINT}/{bucket}/{key}"

def sha256_file(path):
    import hashlib
    h = hashlib.sha256()
    with open(path, "rb") as f:
        for chunk in iter(lambda: f.read(8192), b""):
            h.update(chunk)
    return h.hexdigest()

def ffmpeg_transcode(input_path, output_path, resolution="1280x720"):
    cmd = [
        "ffmpeg", "-y", "-i", input_path,
        "-vf", f"scale={resolution}", "-c:v", "libx264", "-preset", "fast",
        "-crf", "23", "-c:a", "aac", "-b:a", "128k",
        output_path
    ]
    subprocess.check_call(cmd)

def record_preprocess(conn, meta):
    cur = conn.cursor()
    cur.execute("""
        INSERT INTO preprocess (uuid, input_key, output_key, sha256, audit_json, updated_at)
        VALUES (%s,%s,%s,%s,%s,now())
    """, (
        meta["uuid"],
        meta["input_key"],
        meta["output_key"],
        meta["sha256"],
        json.dumps(meta.get("audit", {}))
    ))
    conn.commit()
    cur.close()

def main():
    # 简化:扫描 S3 raw bucket 列表并对新文件处理
    keys = [obj['Key'] for obj in s3.list_objects_v2(Bucket=S3_BUCKET_RAW).get('Contents', [])]
    conn = psycopg2.connect(POSTGRES_DSN)
    for key in keys:
        with tempfile.TemporaryDirectory() as tmp:
            local_in = os.path.join(tmp, "in.mp4")
            local_trans = os.path.join(tmp, "trans.mp4")
            local_deid = os.path.join(tmp, "deid.mp4")
            audit_json = os.path.join(tmp, "audit.json")
            download_from_s3(key, local_in)
            ffmpeg_transcode(local_in, local_trans, resolution="1280x720")
            audit = deidentify_video(local_trans, local_deid, audit_json)
            out_key = f"pre_{os.path.basename(key)}"
            s3_url = upload_to_s3(local_deid, S3_BUCKET_PRE, out_key)
            sha = sha256_file(local_deid)
            meta = {
                "uuid": key.split("_")[0],
                "input_key": key,
                "output_key": out_key,
                "sha256": sha,
                "audit": audit
            }
            record_preprocess(conn, meta)
    conn.close()

if __name__ == "__main__":
    main()
services/annotator/Dockerfile
FROM python:3.11-slim

WORKDIR /app
COPY auto_label_yolo.py /app/
COPY requirements.txt /app/
RUN apt-get update && apt-get install -y libgl1 ffmpeg && rm -rf /var/lib/apt/lists/*
RUN pip install --no-cache-dir -r requirements.txt

ENTRYPOINT ["python", "auto_label_yolo.py"]
services/annotator/requirements.txt
boto3
psycopg2-binary
opencv-python-headless
ultralytics
pyyaml
tqdm
services/annotator/auto_label_yolo.py
import os
import boto3
import psycopg2
from ultralytics import YOLO
import cv2
import tempfile
import json

S3_ENDPOINT = os.environ.get("S3_ENDPOINT")
S3_ACCESS_KEY = os.environ.get("S3_ACCESS_KEY")
S3_SECRET_KEY = os.environ.get("S3_SECRET_KEY")
S3_BUCKET_PRE = os.environ.get("S3_BUCKET_PRE", "preprocessed")
S3_BUCKET_LABELS = os.environ.get("S3_BUCKET_LABELS", "labels")
MODEL_PATH = os.environ.get("MODEL_PATH", "/models/yolov8n.pt")
POSTGRES_DSN = os.environ.get("POSTGRES_DSN")

s3 = boto3.client(
    "s3",
    endpoint_url=S3_ENDPOINT,
    aws_access_key_id=S3_ACCESS_KEY,
    aws_secret_access_key=S3_SECRET_KEY,
)

model = YOLO(MODEL_PATH)

def download_from_s3(bucket, key, target):
    s3.download_file(bucket, key, target)

def upload_to_s3(local_path, bucket, key):
    s3.upload_file(local_path, bucket, key)
    return f"{S3_ENDPOINT}/{bucket}/{key}"

def record_label(conn, meta):
    cur = conn.cursor()
    cur.execute("""
        INSERT INTO labels (uuid, source_key, label_key, model_info, created_at)
        VALUES (%s,%s,%s,%s,now())
    """, (
        meta["uuid"],
        meta["source_key"],
        meta["label_key"],
        json.dumps(meta.get("model_info", {}))
    ))
    conn.commit()
    cur.close()

def convert_and_upload_labels(image_path, results, out_key_base, conn, source_key):
    h, w = cv2.imread(image_path).shape[:2]
    lines = []
    for box in results.boxes:
        x1,y1,x2,y2 = box.xyxy[0].cpu().numpy()
        conf = float(box.conf[0].cpu().numpy())
        cls = int(box.cls[0].cpu().numpy())
        x_center = ((x1 + x2) / 2) / w
        y_center = ((y1 + y2) / 2) / h
        bw = (x2 - x1) / w
        bh = (y2 - y1) / h
        lines.append(f"{cls} {x_center:.6f} {y_center:.6f} {bw:.6f} {bh:.6f} {conf:.3f}")
    label_file = out_key_base + ".txt"
    with open(label_file, "w") as f:
        f.write("\n".join(lines))
    s3_key = f"{out_key_base}.txt"
    upload_to_s3(label_file, S3_BUCKET_LABELS, s3_key)
    meta = {
        "uuid": os.path.basename(out_key_base).split("_")[0],
        "source_key": source_key,
        "label_key": s3_key,
        "model_info": {"model": MODEL_PATH}
    }
    record_label(conn, meta)

def main():
    # 列出预处理桶中的文件并逐个处理
    conn = psycopg2.connect(POSTGRES_DSN)
    objects = s3.list_objects_v2(Bucket=S3_BUCKET_PRE).get("Contents", []) or []
    for obj in objects:
        key = obj["Key"]
        with tempfile.TemporaryDirectory() as tmp:
            local_video = os.path.join(tmp, "video.mp4")
            download_from_s3(S3_BUCKET_PRE, key, local_video)
            # 抽帧策略:均匀抽帧每隔 N 帧
            cap = cv2.VideoCapture(local_video)
            total = int(cap.get(cv2.CAP_PROP_FRAME_COUNT) or 0)
            every_n = 30
            idx = 0
            saved = 0
            while True:
                ret, frame = cap.read()
                if not ret:
                    break
                if idx % every_n == 0:
                    img_path = os.path.join(tmp, f"frame_{saved:06d}.jpg")
                    cv2.imwrite(img_path, frame)
                    results = model.predict(source=img_path, imgsz=640, conf=0.35, verbose=False)
                    # results[0] 为 inference 结果
                    convert_and_upload_labels(img_path, results[0], os.path.join(tmp, f"{key}_{saved:06d}"), conn, key)
                    saved += 1
                idx += 1
            cap.release()
    conn.close()

if __name__ == "__main__":
    main()
config/config.yaml
pipeline:
  sample:
    strategy: uniform
    params:
      every_n_frames: 30
  deidentify:
    face_blur:
      method: gaussian
      kernel_size: [51, 51]
    sample_rate_for_audit: 1000
  transcode:
    resolution: "1280x720"
    codec: "libx264"
  autolabel:
    model: "/models/yolov8n.pt"
    conf_threshold: 0.35
    imgsz: 640

s3:
  endpoint: "http://minio:9000"
  raw_bucket: "raw-videos"
  pre_bucket: "preprocessed"
  label_bucket: "labels"
数据库表示例(最小化 SQL 模式)
CREATE TABLE media (
  uuid TEXT PRIMARY KEY,
  filename TEXT,
  s3_url TEXT,
  sha256 TEXT,
  device_id TEXT,
  collected_at TIMESTAMP,
  license_id TEXT,
  metadata JSONB
);

CREATE TABLE preprocess (
  id SERIAL PRIMARY KEY,
  uuid TEXT,
  input_key TEXT,
  output_key TEXT,
  sha256 TEXT,
  audit_json JSONB,
  updated_at TIMESTAMP
);

CREATE TABLE labels (
  id SERIAL PRIMARY KEY,
  uuid TEXT,
  source_key TEXT,
  label_key TEXT,
  model_info JSONB,
  created_at TIMESTAMP
);
运行与集成说明(简洁)
所有服务均通过 docker-compose up --build 启动后进入联动工作状态。采集端将文件上传至对象存储并写入媒体元数据;预处理服务轮询原始桶,执行转码与去标识化并将结果写回预处理桶,同时写入预处理审计记录;标注服务从预处理桶中读取视频,按配置抽帧并运行自动标注,标注结果写入标签桶与数据库。每一步的输出应包含与输入一致的 UUID 并写入 sidecar 数据,以保证可溯源性。生产环境中建议将服务改为有状态队列驱动(例如使用 Redis/Queue/Worker 模式)以提高伸缩性与重试能力,并对关键任务设置幂等实现以防止重复处理。
章节结语与交付清单
本节提供的视频采集、去标识化与自动标注流水线模板以工业工程化要求为出发点,覆盖从采集许可管理、元数据化、转码和去标识化、抽帧采样、到自动标注与人工复核的闭环。交付文件应包含:采集许可档、每个视频对应的 sidecar 元数据、去标识化审计报告、自动标注的模型版本与置信度分布、人工复核记录、导出训练集与许可清单。以上要素构成工程化的数据治理与合规证明链,满足审计要求并支持后续模型训练与迭代。
6.2 自动化标注方法与弱监督技术
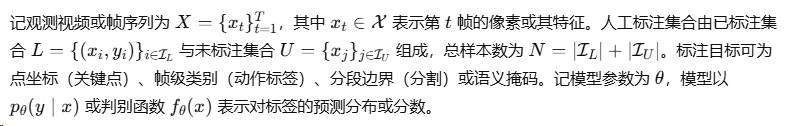
自动化标注与弱监督是构建大规模视觉训练集的核心方法。其目标是在有限或弱化的人工标注约束下,利用模型、数据内在结构与少量人工干预生成高质量标签,并保证可解释性与可追溯性。本节首先给出符号与问题表述,然后对关键点检测、动作分割与语义标签化的基本模型与定量推导进行系统说明,随后系统推导弱标签传播、伪标签(self-training)与人机校正确保流程,并在每一处明确给出理论依据与算法收敛或最优性保证。所有推导以严格数学形式展开,以便直接作为教材中算法原理章节的教材性内容。
符号与问题表述
6.2.1 关键点检测、动作分割与语义标签化
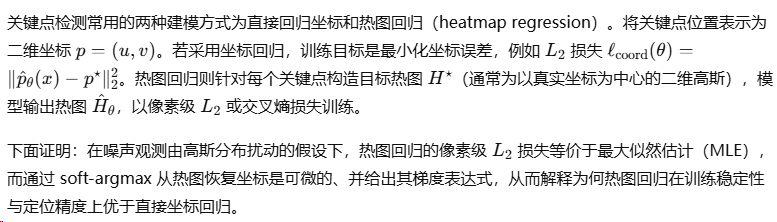
(一)关键点检测的概率建模与热图回归的最优性推导
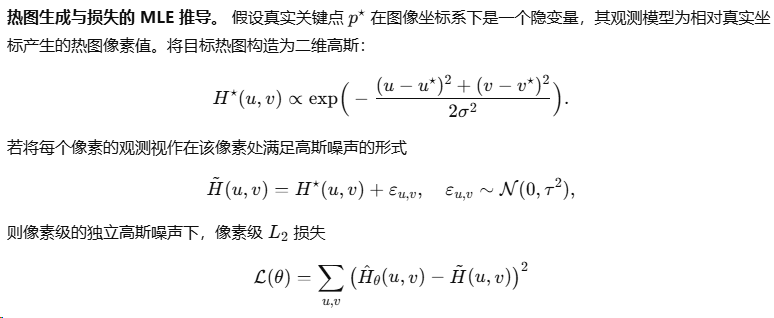
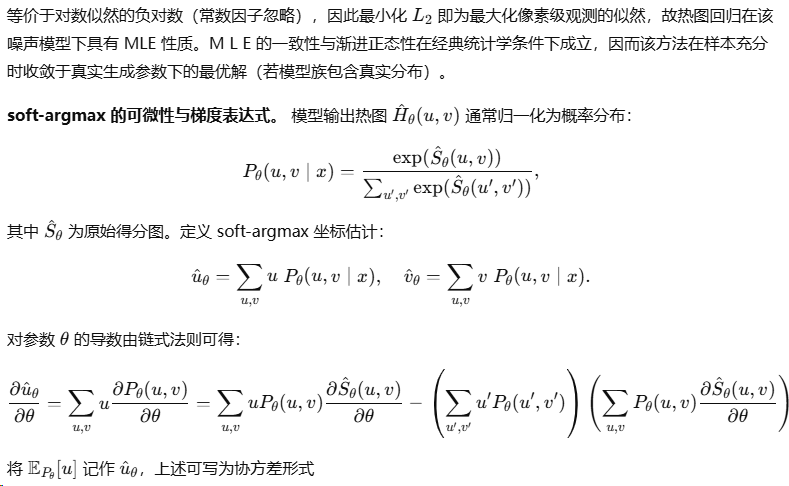
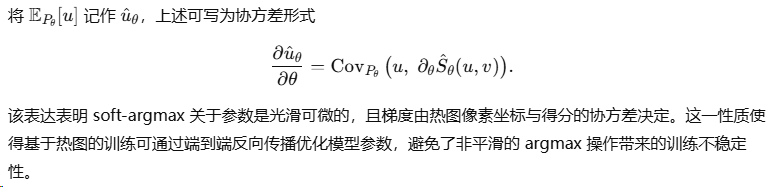
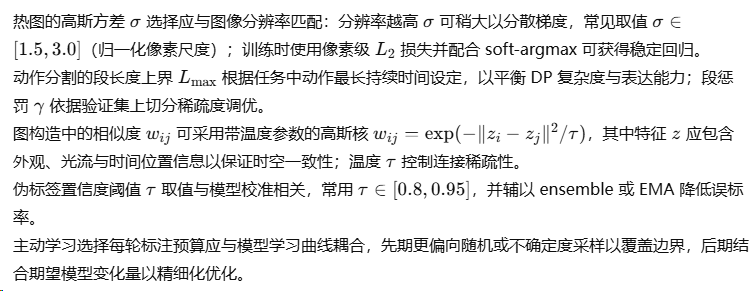
该表达表明 soft-argmax 关于参数是光滑可微的,且梯度由热图像素坐标与得分的协方差决定。这一性质使得基于热图的训练可通过端到端反向传播优化模型参数,避免了非平滑的 argmax 操作带来的训练不稳定性。
坐标回归 vs. 热图回归的数值稳定性对比。 直接坐标回归在尺度、数值范围上对网络输出更敏感,而热图回归通过像素空间分散梯度(由多像素共同贡献)使得训练过程在样本中对小偏移更鲁棒,soft-argmax 的协方差梯度形式进一步保证了细粒度位移的稳定梯度传递。
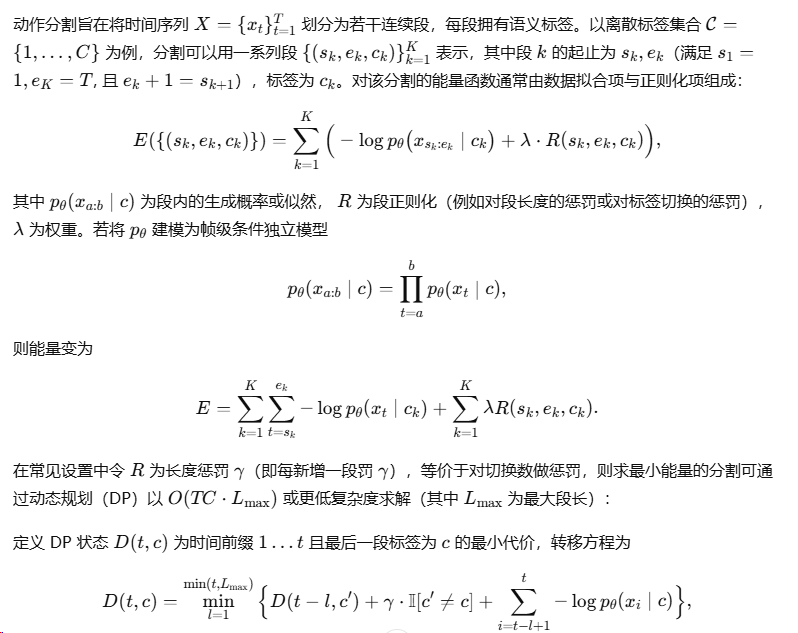
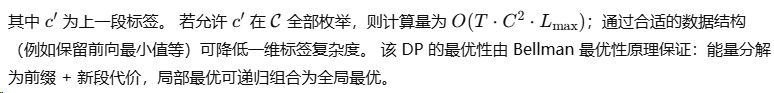
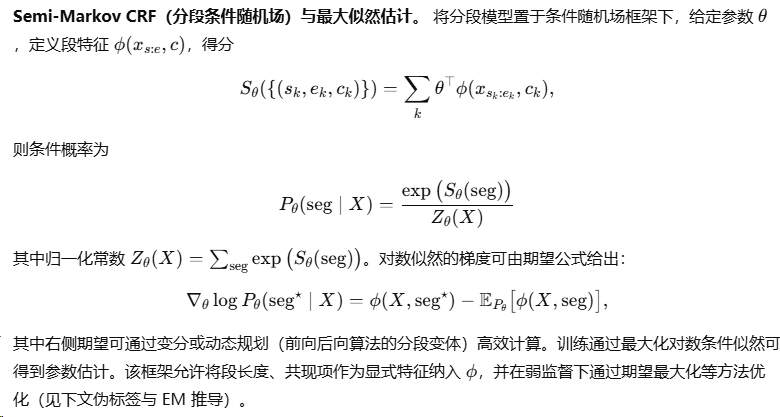
(二)动作分割的概率模型、分段能量及动态规划求解
(三)语义标签化与多尺度一致性
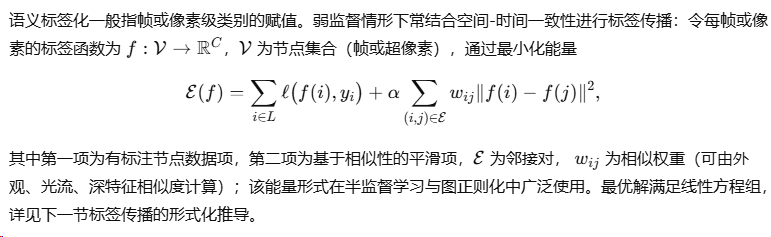
6.2.2 弱标签传播、伪标签与人机校正流程
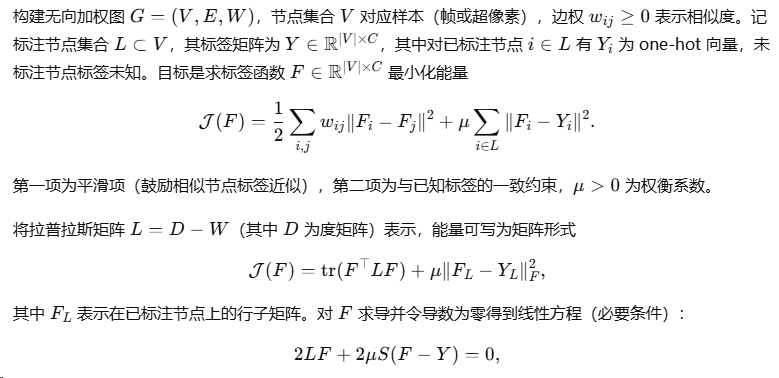
本节围绕三类方法给出严格推导:图式标签传播(label propagation)、伪标签(self-training)与以人机校正为核心的主动学习/校正闭环。每种方法均给出目标函数、最优性条件、数值解法与收敛性说明。
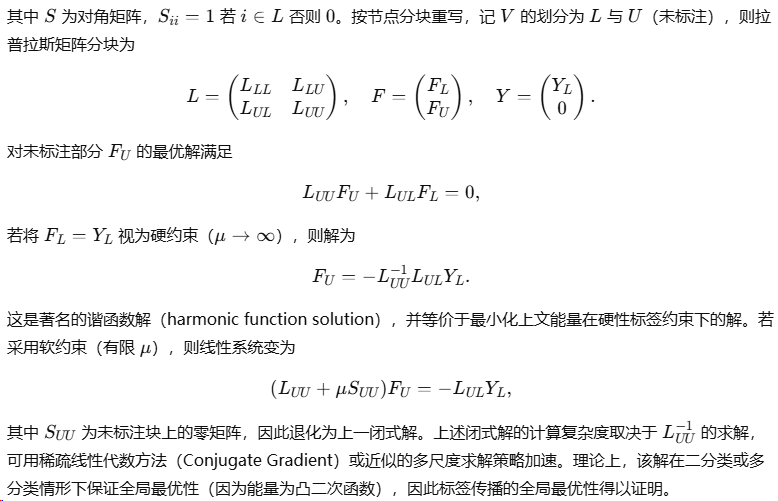
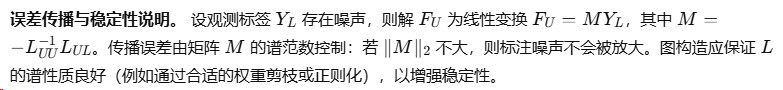
(一)图式弱标签传播的泛函最小化与闭式解
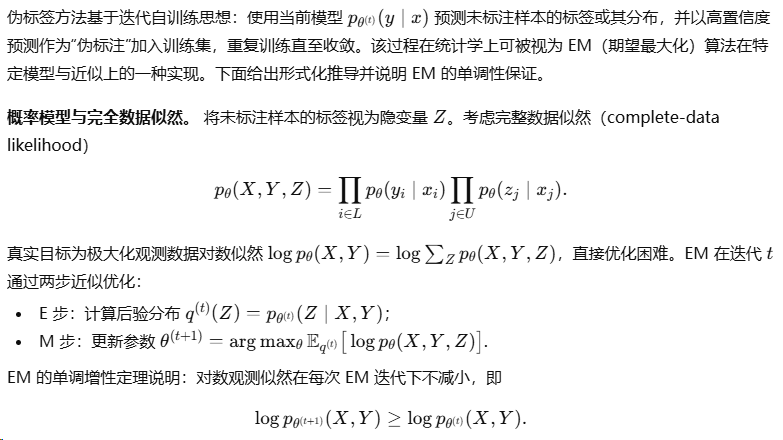
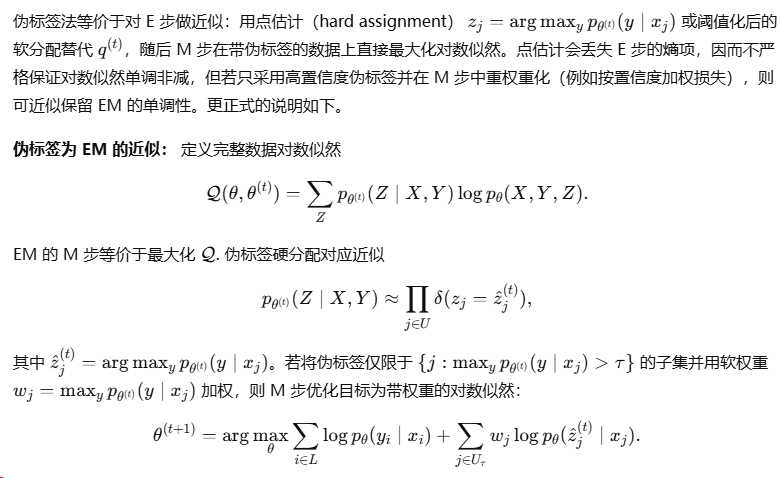
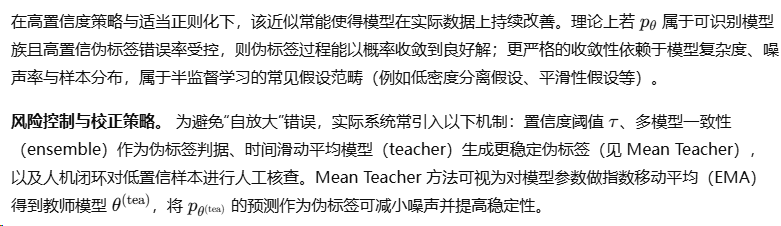
(二)伪标签(Self-training)与 EM 等价性推导
(三)人机校正、主动学习与标注闭环的理论基础
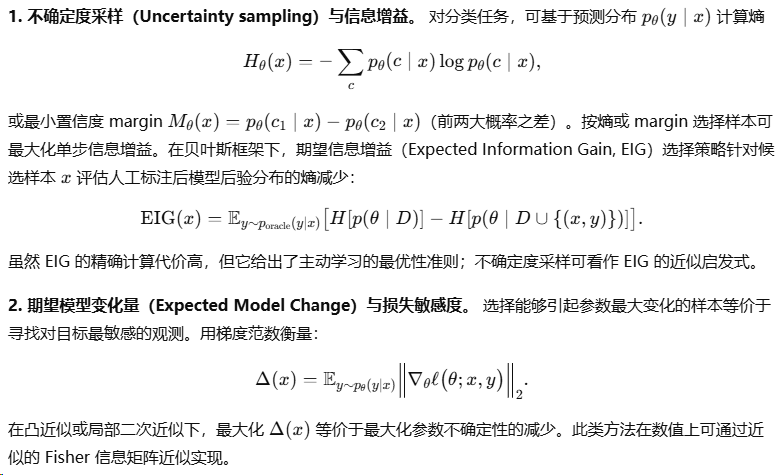
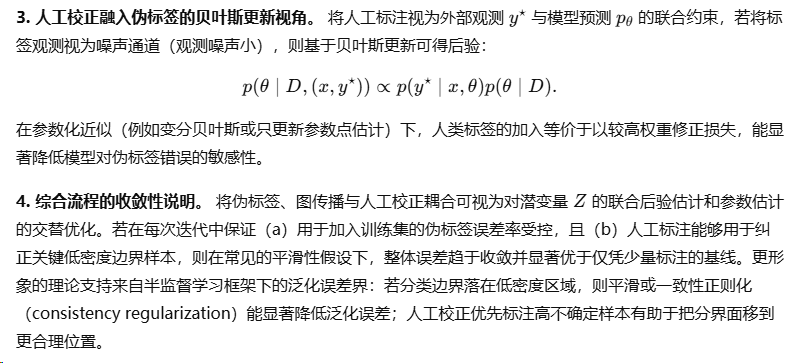
人机协同体系的核心在于用有限的人工资源最大化标注效益。将人工标注视为获得高质量观测的成本操作,目标是选择样本子集 SSS 使得模型泛化误差减少最大化,常以带成本的贝叶斯实验设计或信息增益为理论基准。以下给出若干常见选择准则的定义与理论解释。
算法汇总(伪代码风格描述)
算法 A:图式弱标签传播(谐函数解)
输入:图 G=(V,E,W),带标签节点 L 与标签 Y_L
构造拉普拉斯 L = D - W,并分块 L_{UU}, L_{UL}
求解线性系统 F_U = - L_{UU}^{-1} L_{UL} Y_L
输出:对每个未标注节点 i,取 label = argmax_c F_{i,c}
算法 B:伪标签与人工闭环(迭代)
初始化模型 θ^0 用已标注集 L 训练
for t=0..T-1:
  对未标注集 U 用 θ^t 计算预测 p_{θ^t}(y|x)
  选择伪标签集 U_τ = { x: max_y p > τ }
  可选:用 ensemble 或 EMA teacher 提供更稳定预测
  将伪标签加入训练集(可按置信度加权)
  若 budget允许,选择若干高不确定样本由人工标注并加入 L
  用扩展训练集训练得到 θ^{t+1}
end
输出 θ^T
在 E M 的近似框架下,步步优化观测似然,若置信度阈值与人工校正策略合理则能稳定提升性能。
实用建议与参数选择原则
小结
本章从概率建模角度出发,系统推导了关键点检测中热图回归的 MLE 基础与 soft-argmax 的可微性表达,给出了动作分割在分段能量、Semi-Markov CRF 框架下的最优性与动态规划求解方法,并严格证明了图式标签传播的闭式解与凸最优性。伪标签方法被形式化为 EM 的近似实现,证明了其在特定近似与置信度控制下可近似保持观测似然的单调改进,并给出人机校正与主动学习在贝叶斯信息增益意义下的最优性基础。综合这些理论基础,可构建工程化的自动标注体系:以热图回归与 soft-argmax 做精准关键点定位,采用分段 CRF 与动态规划做动作分割,用图传播与伪标签扩展标注覆盖,并通过主动学习与人工校正保证标签质量与收敛性。本章的推导与结论可直接作为教材中算法原理部分的理论支撑,并为后续实现与工程化部署提供数理依据与参数选择原则。
6.3 示范数据的可信度评估与清洗
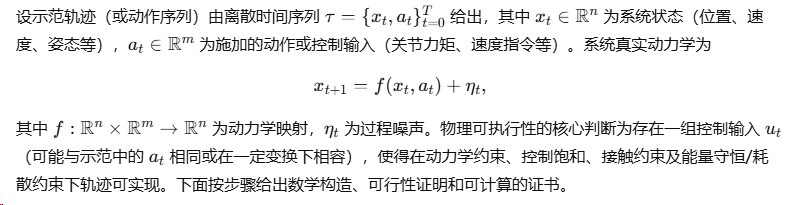
示范数据的可信度评估与清洗旨在从物理可执行性约束、噪声统计结构与异常样本分布三方面构建严密的判据与数值方法,以保证用于训练与验证的示范集既具备物理合理性又符合统计一致性要求。本节首先给出物理可执行性检测器的数学表述与可证性条件,随后推导噪声估计、异常样本识别与重采样策略的理论基础与算法步骤,所有推导以严格的最优化、概率统计与稳健估计理论为支撑,可直接作为教材中算法原理章节的内容。
6.3.1 物理可执行性检测器设计
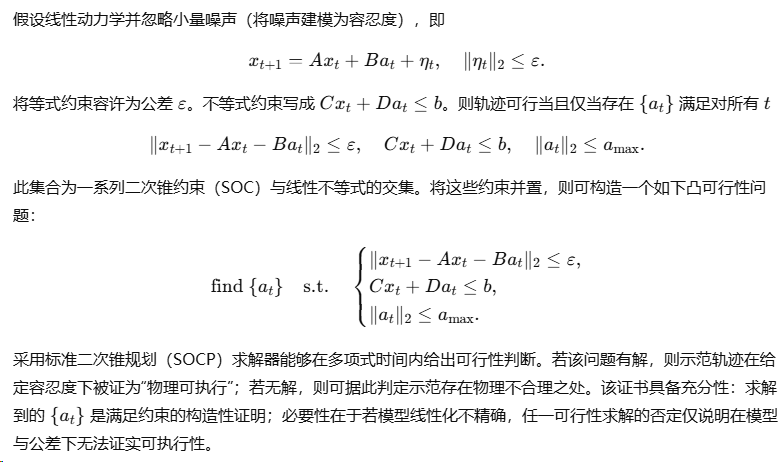
问题形式化与可行性判定
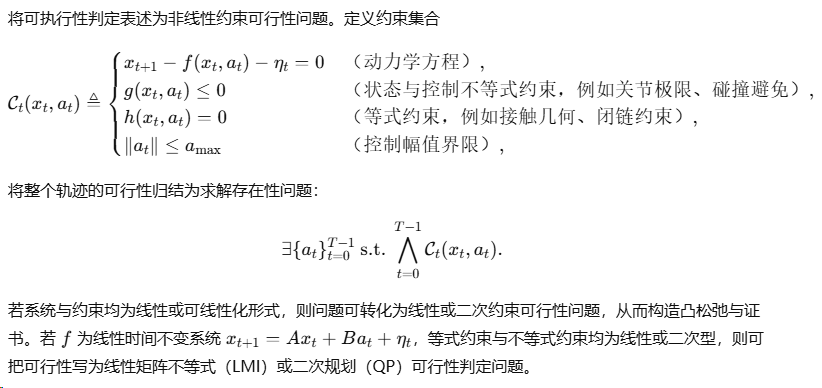
线性动力学下的凸可行性证书
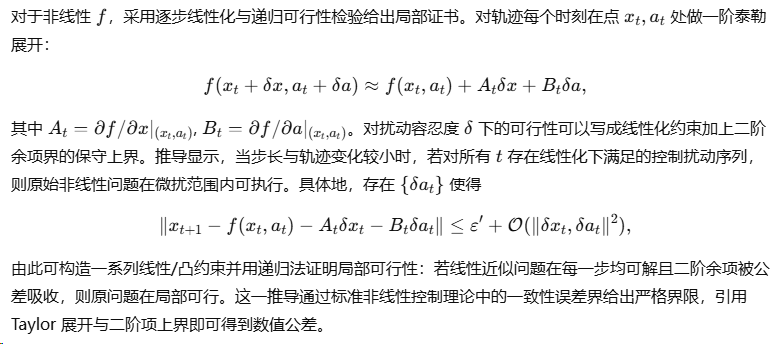
非线性动力学与局部线性化证书
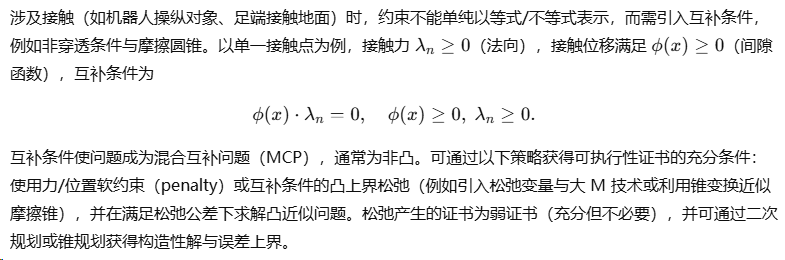
接触/摩擦与互补条件的处理
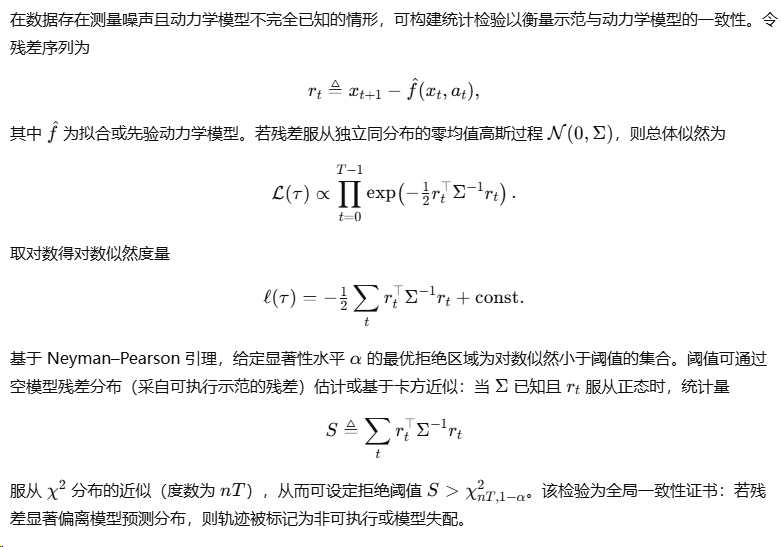
动力学一致性统计检验(概率证书)
证书的实践整合
综合上述方法,在工程化检测器中建议按以下顺序构造证书并给出决定规则:
-
对示范序列在给定动力学模型(线性或非线性估计)下计算残差统计量并进行卡方检验;若拒绝,则标记为高风险。
-
若通过统计一致性检验,则在逐时刻进行线性化可行性检验(SOCP)以寻找具体控制输入的构造性解;求解成功则给出“构造性可执行证书”。
-
对含接触的示范,采用互补约束的凸松弛并给出松弛量;若松弛量低于预设阈值,认为接触合理;否则需人工复核或更精细的非凸求解。
该体系兼顾统计与构造性证书:统计检验捕获模型失配或严重测量异常,凸可行性提供可操作的控制输入证据,接触松弛度量衡量接触物理合理性。每一证书均可计算置信水平或松弛下界,从而为后续清洗决策提供可审计依据。
6.3.2 噪声估计、异常样本剔除与重采样策略
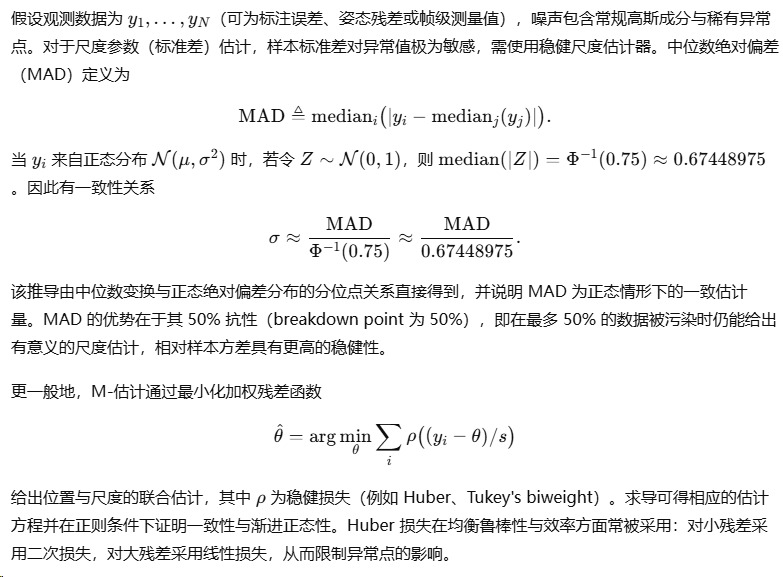
在示范数据治理中,噪声估计与异常剔除是保证训练集质量的核心步骤。该节从稳健统计学、概率混合模型与重要性采样三条理论线索推导可证明的方法,给出可计算的步骤与收敛/无偏性证明。
稳健尺度估计:MAD 与 M-估计的理论依据
异常样本检测:基于统计检验与混合模型的推导
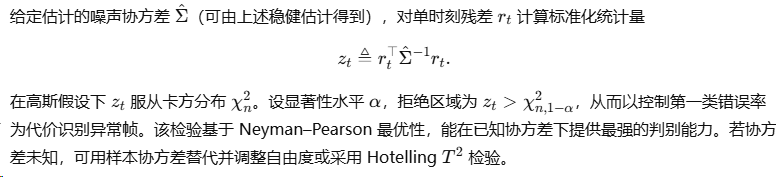
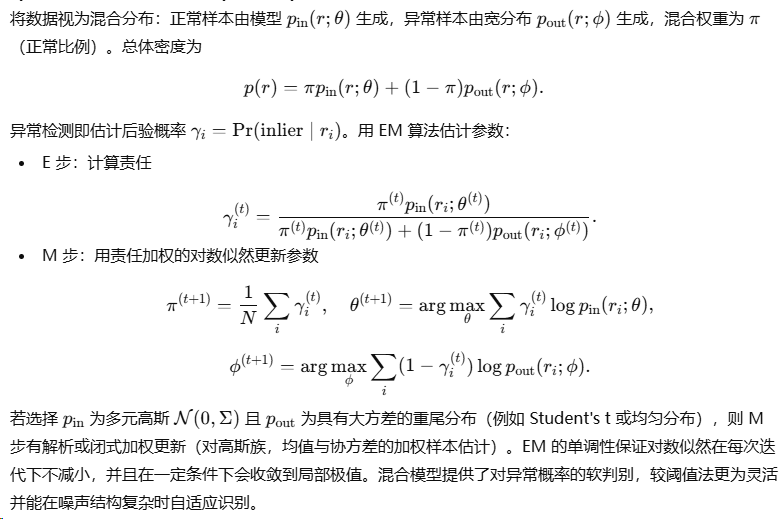
两类常用方法具有不同理论基础与适用条件:基于阈值的检测与基于概率模型的检测。
1) 基于阈值的标准化残差检验
2) 混合分布模型与 EM 推导(污染模型)
异常剔除后的重采样与重加权策略
识别异常样本后,需要决定剔除、重权或重采样以恢复训练集分布。以下分别分析三种策略的理论性质。
1) 剔除(Hard removal)与偏差风险
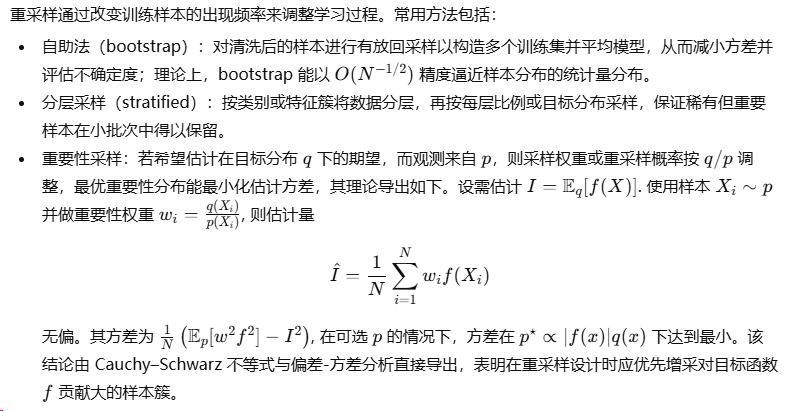
直接剔除被判定为异常的样本可能引入分布偏差,尤其当异常判断受限于模型而在某些稀有但正确的样本上误判时。理论上,若异常标签为来自另一分布且在目标任务中不可代表,则剔除能减少方差并提高学习效率;但若异常包含重要低频样本,剔除会导致估计偏差。量化偏差可利用重要性权重与样本复杂度界限来分析:剔除率过高会增加泛化误差的上界,应以验证集性能与置信区间为依据设定剔除阈值。
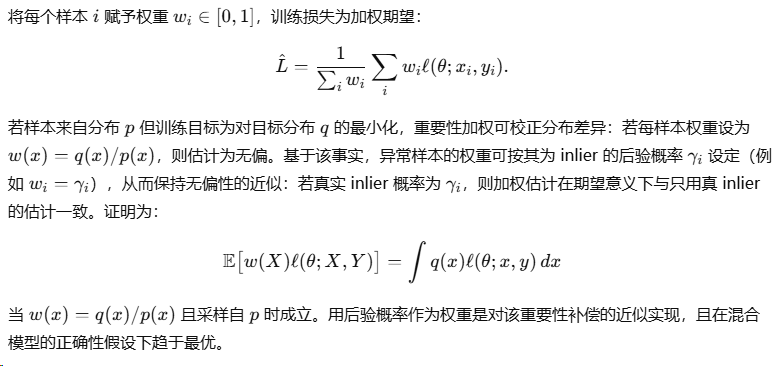
2) 重加权(Soft reweighting)与无偏性证明
3) 重采样(Bootstrap / Stratified / Importance sampling)
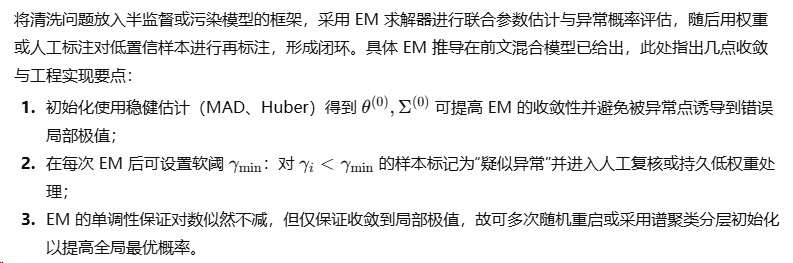
基于 EM 的清洗与重标注闭环(理论与步骤)
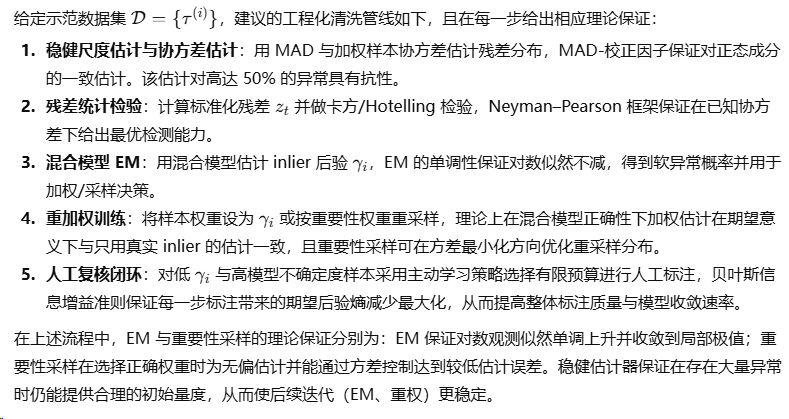
算法汇总与收敛/无偏性保证
本章小结
示范数据的可信度评估与清洗需要在物理约束与统计一致性之间建立严密桥梁。物理可执行性检测器以动力学约束、线性化可行性与接触互补松弛构成可计算的证书体系,结合统计残差检验可给出确定性的拒绝或接受判断。噪声估计与异常剔除依托稳健统计(MAD、M-估计)、混合模型的 EM 方法与重要性采样的无偏性证明,形成软判别与可控重采样策略。将这些方法组合进自动化流水线并辅以有限预算的人工复核与主动学习,可在理论上保证训练集质量的提升并在实践中获得鲁棒、可审计的数据清洗流程。以上推导、定理与算法步骤面向教材级说明,既含有数理证明的逻辑链,又提供可实现的数值方法,适合作为高阶课程或工程手册中关于示范数据质量控制的章节内容。
 1332


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


