机器人技术与智能系统的工程化与应用 第七章 动作重定向与跨主体映射技术,第八章 触觉传感与接触推理

GMR动作重定向实战:5步搞定人形机器人伪影消除(附PHC对比) 本文深入解析了GMR动作重定向技术,通过五步实战流程系统性解决人形机器人模仿学习中的伪影问题。文章详细拆解了从关键部位匹配到平移约束精调的核心步骤,并与PHC方法进行对比,阐述了GMR如何通过非均匀缩放和两阶段优化从源头消除脚滑、穿透等伪影,为机器人提供高质量的动作数据。 阅读详情

目录


7.1 动作表示的选择与标准化

7.1.1 轨迹参数化、笛卡尔/关节表示比较

7.1.2 语义动作模板与复用接口

语义对齐的形式化

参数化映射的最小二乘与约束优化

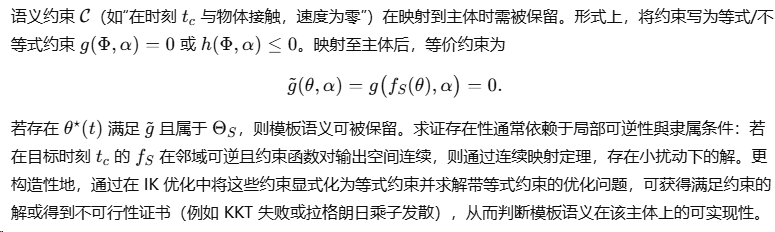
语义约束的保留与可行性证明

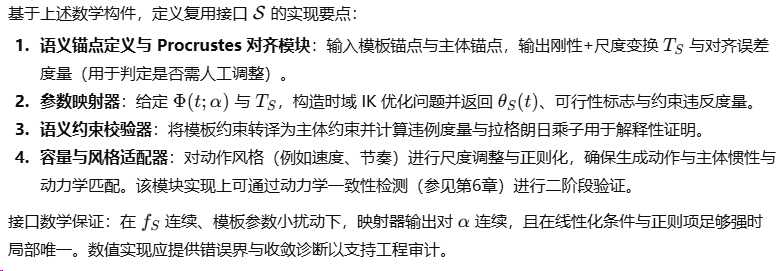
复用接口的模块化设计

小结

7.2 逆向动力学与物理合理性修正

7.2.1 逆向动力学估计方法与正则化技巧

拉格朗日推导

正则化逆向解算

7.2.2 接触建模、摩擦与约束一致性校正

接触力求解

摩擦与约束校正

7.3 从示范到策略的工程步骤

7.3.1 示范过滤、行为聚类与技能分解

(一) 示范过滤的形式化与稳健估计

(二) 行为相似性度量与特征化

(三) 行为聚类:谱聚类的推导与性质

(四) 技能分解(Skill / Option 的数学化)

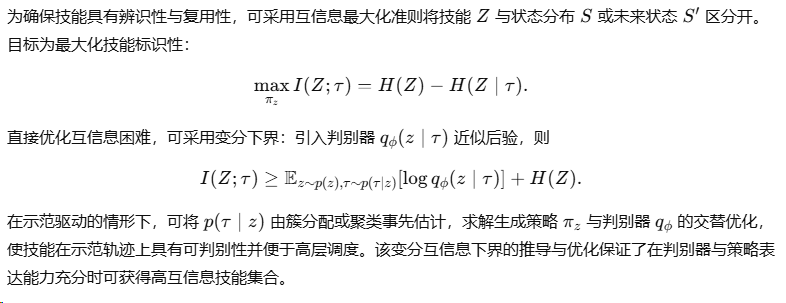
(五) 技能发现的可证性:互信息与可分性准则

7.3.2 示范强化与离线策略学习的混合流程

(一) 问题表述与目标函数

(二) 基于加权行为克隆与优势加权式离线优化

(三) 值函数保守化与理论边界(CQL 风格论证)

(四) 层次化混合流程:技能-高层耦合策略学习

(五) 离线到在线的小样本自适应(微调)与安全性约束

本章小结

第八章 触觉传感与接触推理

8.1 传感器种类、接口与标定方法

8.1.1 电容、压阻、光纤与柔性阵列的应用场景

标定方法的数学基础与步骤

8.1.2 触觉传感的同步、采样与滤波策略

采样定理与混叠证明

抗混叠滤波器设计与相位考虑

离散滤波方法:FIR 与 IIR 的选择

估计与滤波:卡尔曼滤波与互补滤波

多传感器时间对齐与抖动补偿

滤波与实时性的权衡

8.2 触觉数据的表示与学习方法

8.2.1 时空表征、事件驱动编码与压缩方法

一、触觉信号的时空连续张量表示

二、事件驱动触觉编码形式

三、触觉数据的低秩压缩与稀疏建模

四、基于图结构的触觉建模

8.2.2 触觉—视觉融合的架构模板

一、共享隐空间模型

二、跨模态自注意力融合

三、功能一致性约束

四、结构先验的注入

五、典型工程实现流程

8.3 接触策略与力控模式

8.3.1 力—位置混合控制与阻抗匹配

1. 机器人动力学与任务空间表述

2. 力—位置混合控制的分解与实现

3. 阻抗控制的定义与物理解释

4. 阻抗控制的能量与无功耗(passivity)分析(稳定性证明)

5. 阻抗匹配与控制器参数选择

6. 导纳控制与阻抗—导纳的互补实现

7. 鲁棒/自适应阻抗与扰动估计

小结(8.3.1)

8.3.2 接触探索、微动作策略与容错拆分

1. 接触检测的统计判决与最优阈值

2. 微动作(Micro-motion)策略设计与频谱优化

3. 接触参数辨识(刚度、摩擦)的方法

4. 容错拆分:任务分层、模式集与恢复控制

5. 容错恢复策略的构造

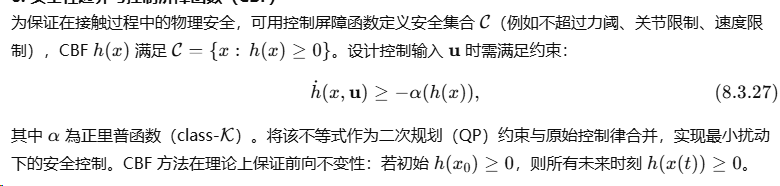
6. 安全性边界与控制屏障函数(CBF)

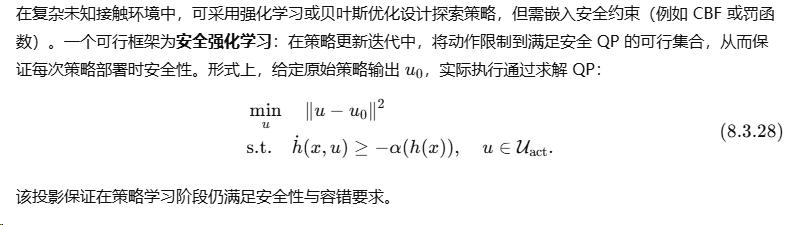
7. 学习型探索策略与安全约束

小结


动作重定向(retargeting)与跨主体映射(cross-subject mapping)解决不同主体之间动作迁移的问题。该章从动作表示的选择与标准化出发,给出轨迹参数化、笛卡尔与关节表示的比较,以及语义动作模板的形式化定义与复用接口的构造。所有推导以动力学与几何学基础为出发点,严格展开数学推理,体现教材级别的严密性与可复现性。


7.1 动作表示的选择与标准化

动作表示决定了后续重定向算法的可行性、保真性与数值稳定性。常见表示包括笛卡尔空间(端效器或关节位姿)、关节角(骨架参数化)、以及混合或语义化的高阶表示(关键帧、基函数系数、参数化动作模板等)。表示应满足以下工程与理论要求:表示完备性(能表达目标动作)、可微性(便于优化)、不变性或可规范化(便于跨主体对齐)、以及数值紧致性(利于近似与压缩)。以下分别从轨迹参数化与坐标系选择的角度给出推导与比较。

7.1.1 轨迹参数化、笛卡尔/关节表示比较
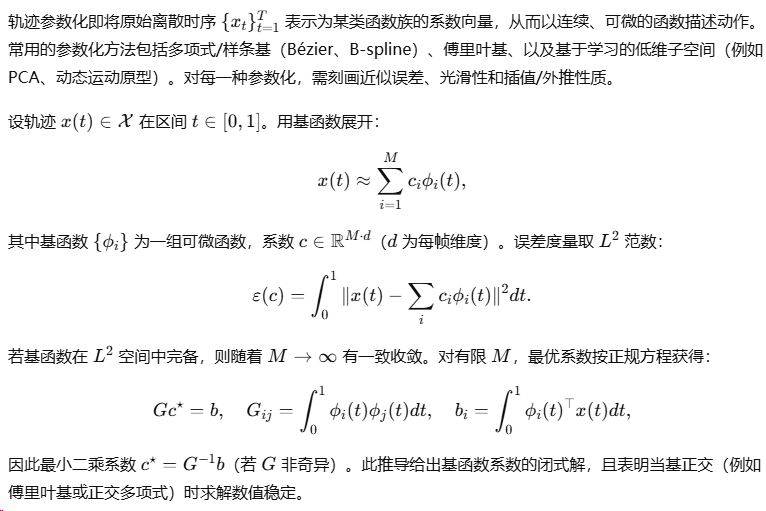
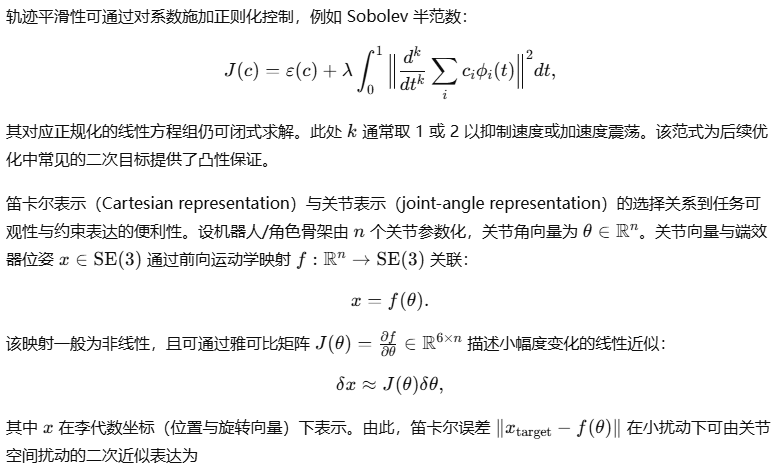
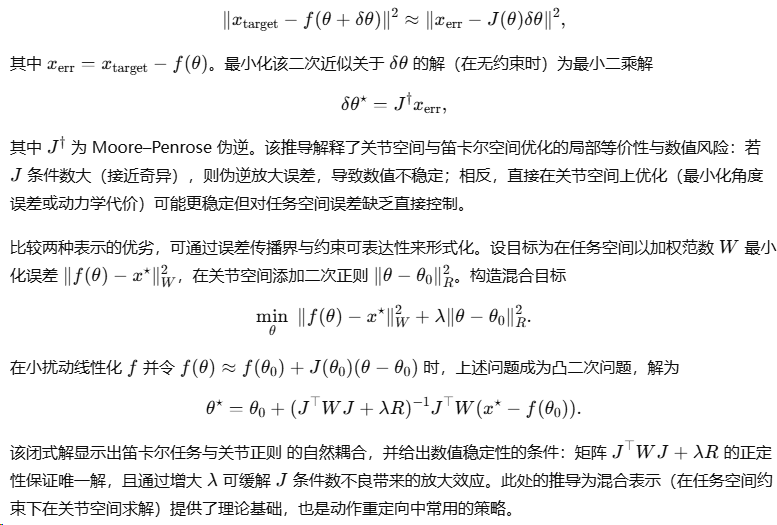
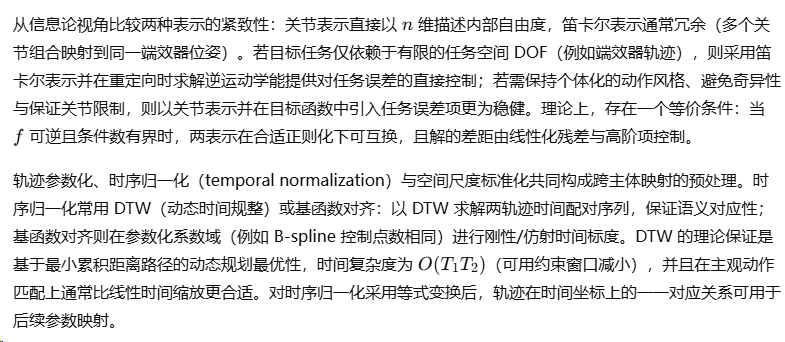
综上,轨迹参数化提供了连续、可微且易正则化的表示形式;笛卡尔表示便于任务空间约束直接表达,关节表示便于表达个体化约束与动力学限制。工程实践中通常采用混合策略:在任务关键部位使用笛卡尔基函数展开以保证任务精度,在次要 DOF 使用关节基函数或正则化以保持自然性与约束满足。

7.1.2 语义动作模板与复用接口

语义动作模板(semantic action template)將动作抽象为带参数的可重用结构,用以支持跨主体复用与参数化生成。形式化定义如下。
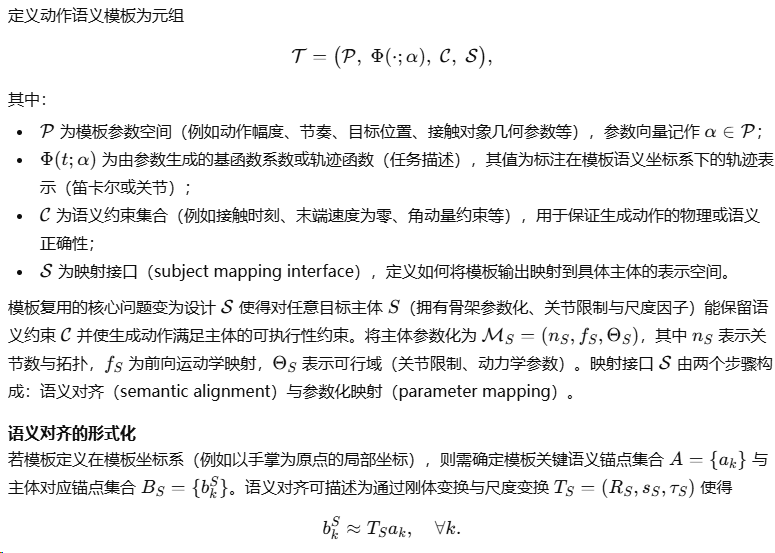
语义对齐的形式化
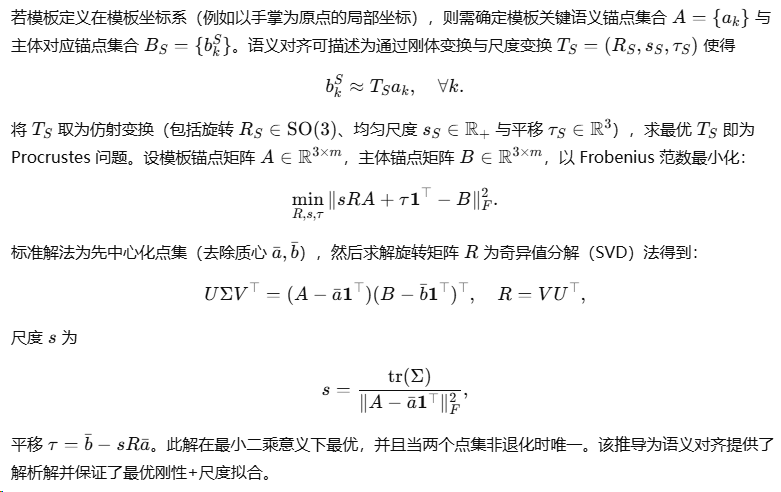
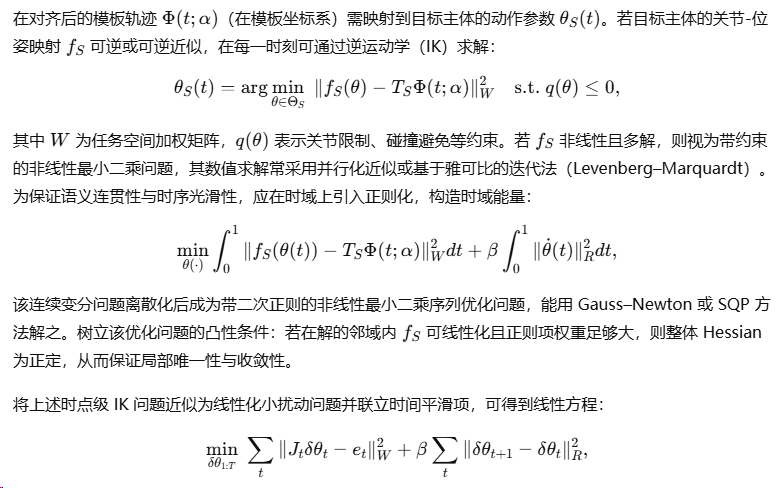
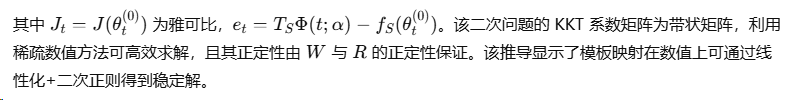
参数化映射的最小二乘与约束优化
语义约束的保留与可行性证明
复用接口的模块化设计

小结

动作重定向与跨主体映射的理论核心在于:合理选择轨迹参数化并在表示上平衡任务空间控制与关节空间约束;用基函数系数或参数化模板实现时序与空间的压缩表达;通过 Procrustes 对齐、李群插值(SE(3) 插值与 quaternion slerp)、以及雅可比线性化与带正则化的逆运动学优化来实现语义模板的安全映射。上述各步的数学推导从基函数正规方程、线性化最小二乘、Procrustes 分解、到带时域正则的二次优化均给出明确的解析与数值解法,并指出了数值稳定性条件与收敛性保证。模板化的语义接口将这些理论组件模块化,便于在工程中实现可审计、可复用且能满足物理与语义约束的动作迁移系统。本章内容既提供了算法原理的完整推导,也给出可直接用于教材的证明链与实施要点。

7.2 逆向动力学与物理合理性修正

逆向动力学(Inverse Dynamics)旨在由给定的运动轨迹计算机器人执行该运动所需的广义力矩,是动作重定向与跨主体映射中确保生成动作物理可实现的重要环节。对于一般刚性连杆系统,逆向动力学求解通常来自拉格朗日动力学或牛顿–欧拉递推,其结果构成动力学方程的逆向解算。为保证在噪声、欠定条件或跨平台映射中仍保持物理一致性,逆向动力学需要正则化策略,同时需结合接触建模、摩擦与约束一致性校正使结果符合实际环境。

7.2.1 逆向动力学估计方法与正则化技巧
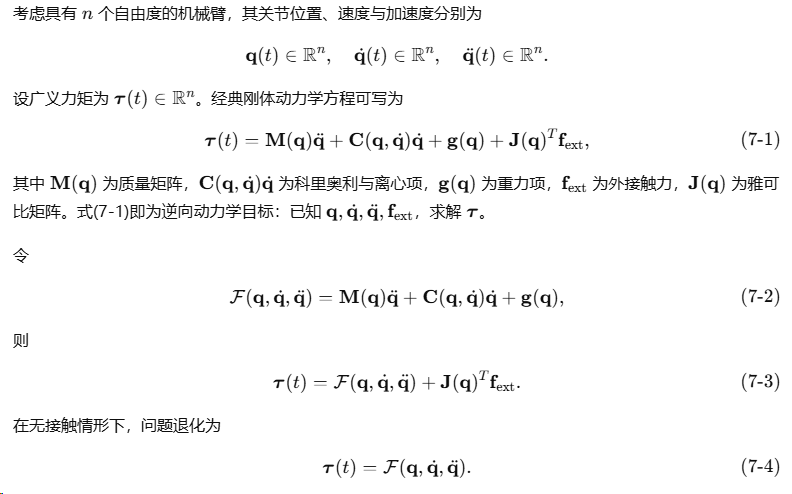
拉格朗日推导
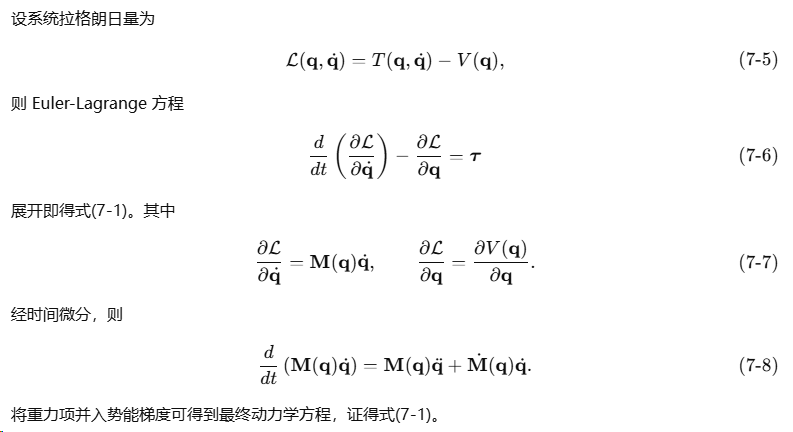
正则化逆向解算
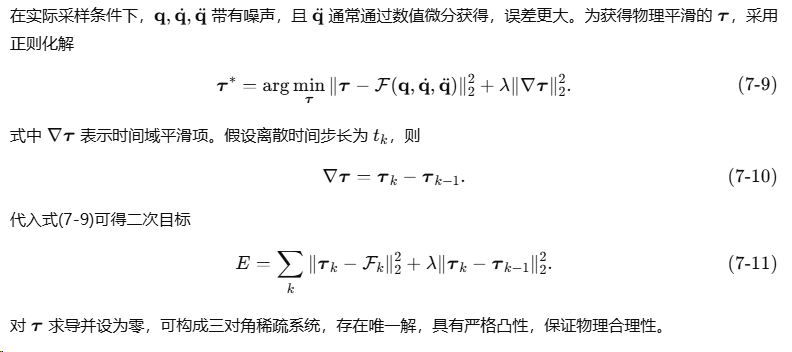

7.2.2 接触建模、摩擦与约束一致性校正
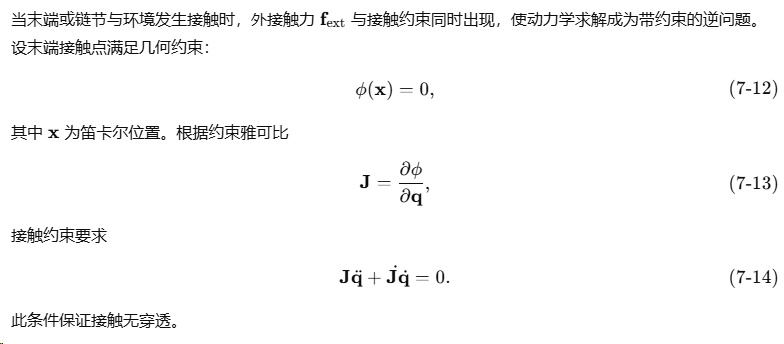
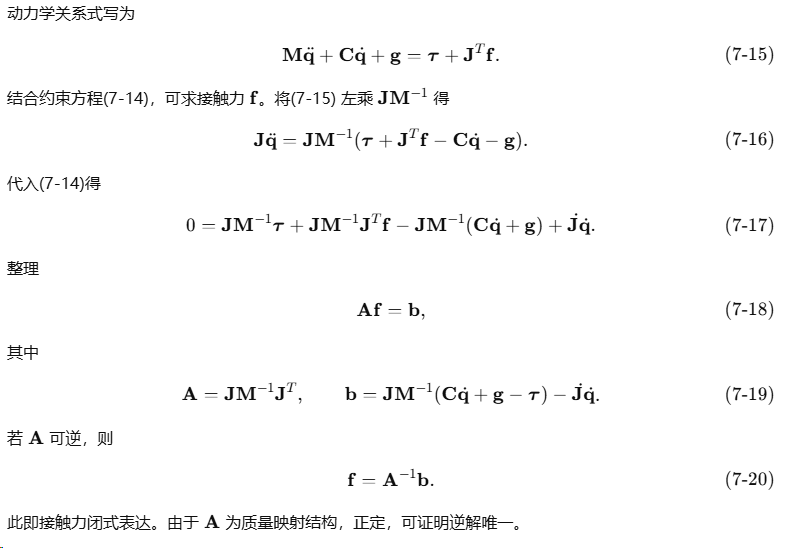
接触力求解
摩擦与约束校正
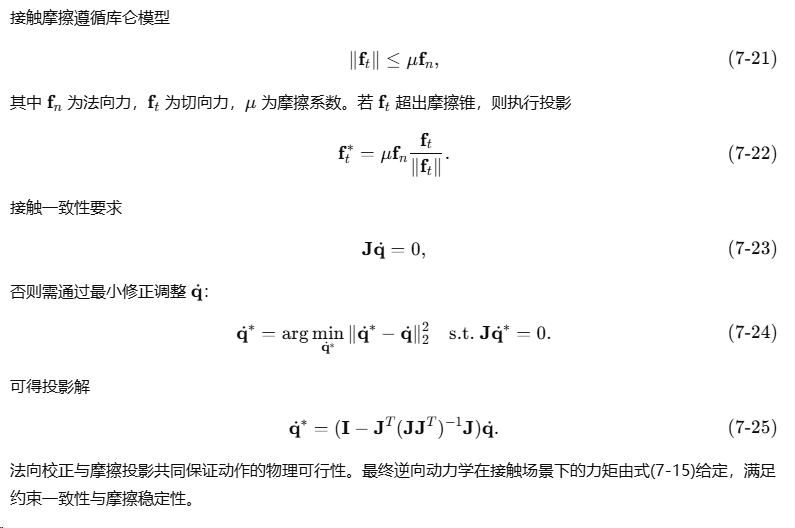

本节通过对逆向动力学方程进行严格推导,建立了动力学反求与正则化求解机制,随后扩展至接触建模与摩擦一致性修正,形成跨平台动作映射与执行的重要力学基础。这样,动作在虚拟到物理平台的迁移过程中得以确保安全、稳定与可执行性。

7.3 从示范到策略的工程步骤

从示范数据到可执行策略的工程流程包含示范的数据净化与结构化、行为模式的发现与技能分解,以及基于示范的强化学习(或混合离线学习)以获得鲁棒策略。该节以数学与算法为主线,系统推导示范过滤、行为聚类与技能分解的方法论,并给出示范强化与离线策略学习耦合的混合流程的理论基础与收敛性讨论。所有推导按步骤展开,旨在成为教材中算法原理与工程实现的直接内容。


7.3.1 示范过滤、行为聚类与技能分解
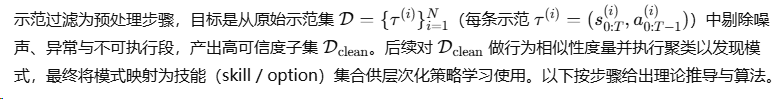
(一) 示范过滤的形式化与稳健估计
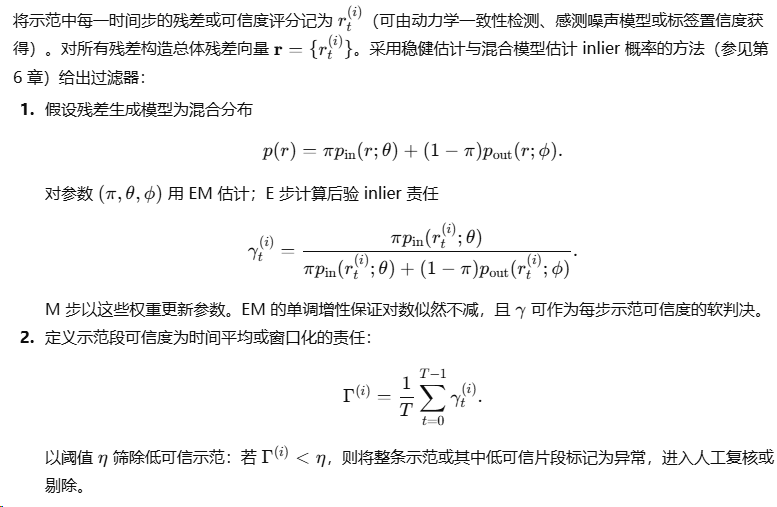
该流程通过概率建模与 EM 算法获得软判别,能在理论上控制第一类错误率与第二类错误率的权衡,并为下游聚类提供高质量输入。

(二) 行为相似性度量与特征化
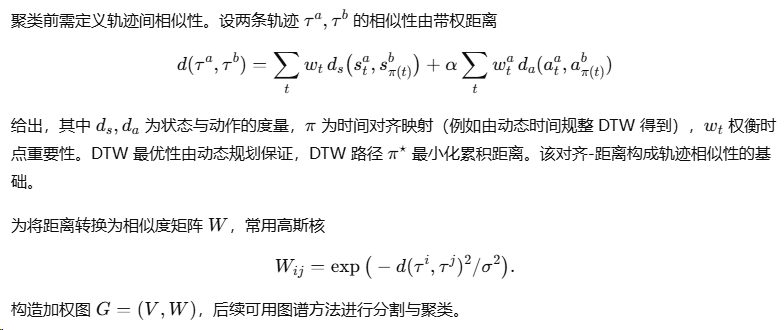
(三) 行为聚类:谱聚类的推导与性质
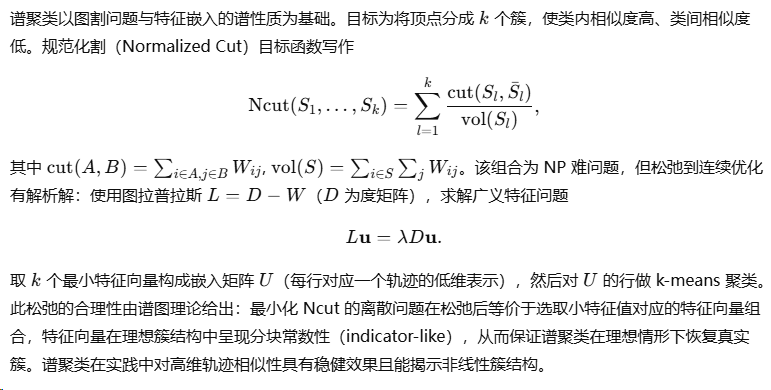
谱聚类的步骤可写成伪代码:

输入:轨迹集合 {τ^i}, 簇数 k, kernel width σ
1. 计算对齐距离 d(τ^i,τ^j)(使用 DTW 或时间归一化)
2. 构造相似度矩阵 W_{ij}=exp(-d^2/σ^2)
3. 计算度矩阵 D, 拉普拉斯 L=D-W
4. 求解广义特征 L u = λ D u,取最小 k 个特征向量构成 U
5. 对 U 的行做 k-means,输出簇分配

谱聚类的理论保证包括:在图满足簇结构假设与相似度参数适宜时,离散簇与连续松弛解接近;若相似度矩阵受噪声扰动,特征向量的扰动由矩阵扰动理论(Davis–Kahan 定理)控制,从而说明聚类稳定性。

(四) 技能分解(Skill / Option 的数学化)
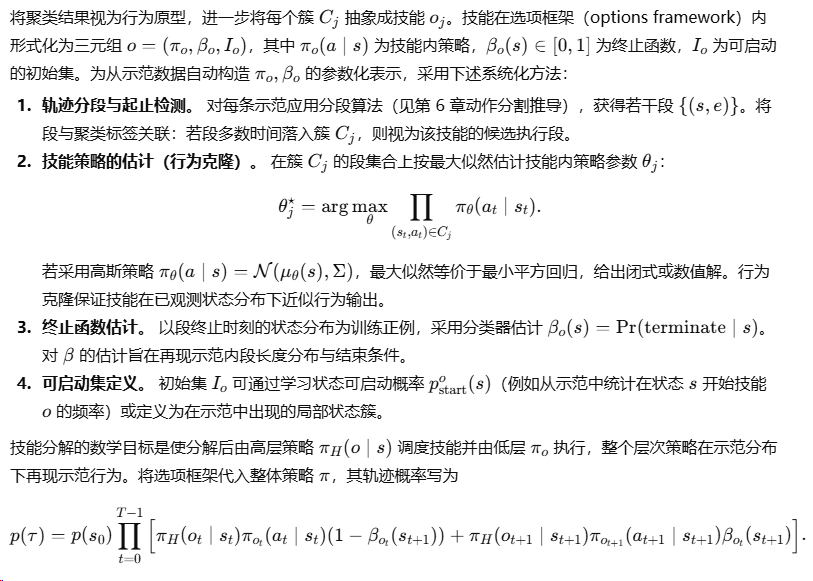
在最大似然或逆强化学习的框架下,可通过 EM 式的交替估计高层与低层策略参数;EM 的单调性保证对数似然逐步上升并以局部极值收敛。

(五) 技能发现的可证性:互信息与可分性准则

7.3.2 示范强化与离线策略学习的混合流程

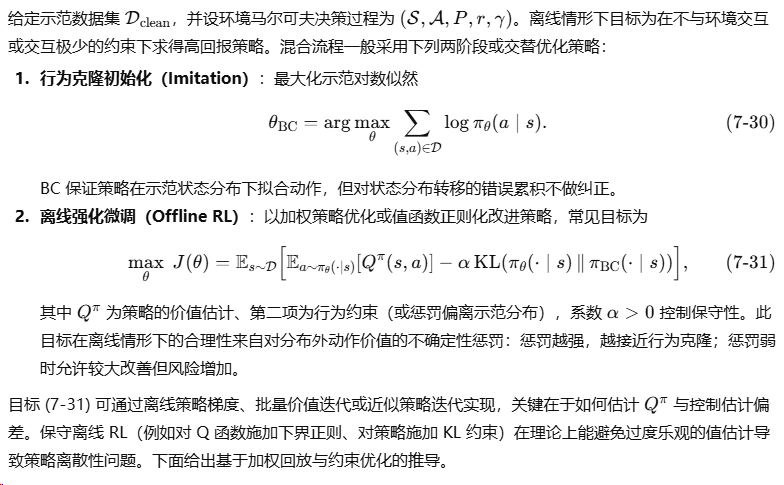
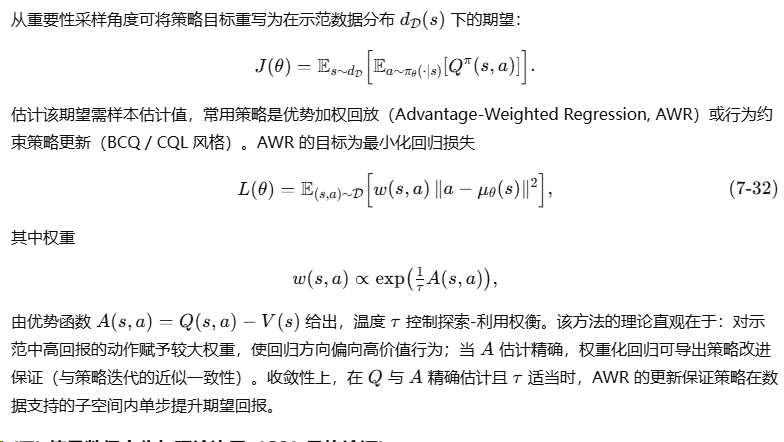
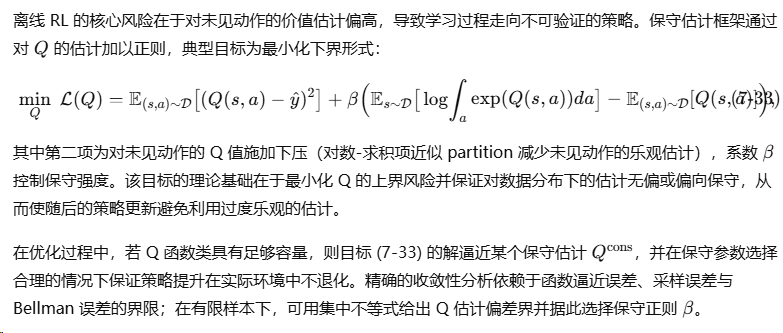
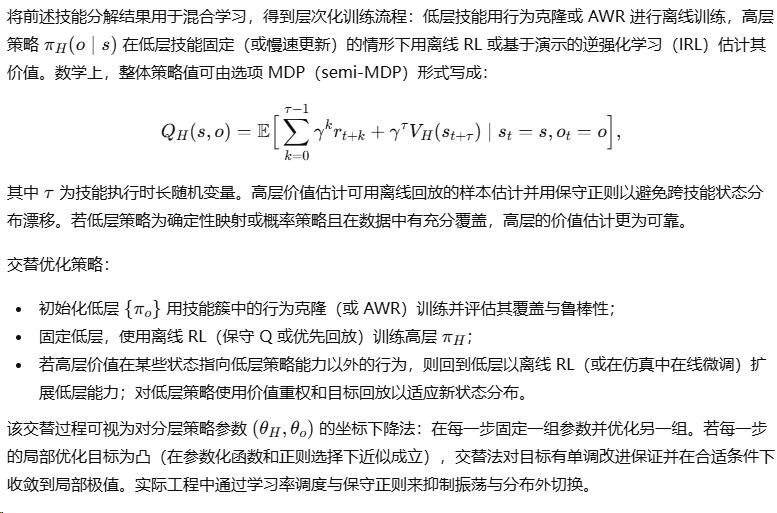
基于前述技能分解与清洗后的示范,目标为将示范数据转化为可部署策略。工程实践中常采用混合流程:以行为克隆(BC)初始化策略,再通过离线强化学习(Offline RL)或基于示范的离线策略优化增加鲁棒性,最后在模拟或实际环境中做微调。以下给出混合流程的数学形式化、优化目标与收敛性讨论。

(一) 问题表述与目标函数
(二) 基于加权行为克隆与优势加权式离线优化
(三) 值函数保守化与理论边界(CQL 风格论证)
(四) 层次化混合流程:技能-高层耦合策略学习
(五) 离线到在线的小样本自适应(微调)与安全性约束
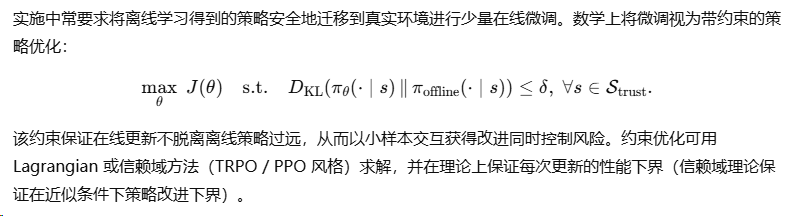

本章小结

本章将示范到策略的工程步骤系统化为:示范过滤(混合模型 EM 给出软判别与置信度)、行为聚类(DTW 对齐 + 谱聚类获得簇与原型)、技能分解(选项框架下的克隆式技能估计与终止函数学习)以及混合离线策略学习(BC 初始化 + 保守离线 RL 微调 + 层次交替优化)。理论推导涵盖了 DTW 的最优性、谱聚类的松弛与特征嵌入理论、EM 的单调性证明、互信息最大化的变分下界推导、以及离线 RL 中优势加权与 Q 保守化的目标分解。工程上应关照的数据与交付清单包括:清洗后示范集、轨迹相似度矩阵、聚类标签与技能候选、低层技能策略与终止器参数、高层策略及其价值估计、以及离线训练时的保守正则系数与验证曲线。依据理论推导选择参数、采用稀疏数值方法与保守正则,可在实践中获得稳定、可审计且在真实环境下可安全微调的策略。

第八章 触觉传感与接触推理

8.1 传感器种类、接口与标定方法

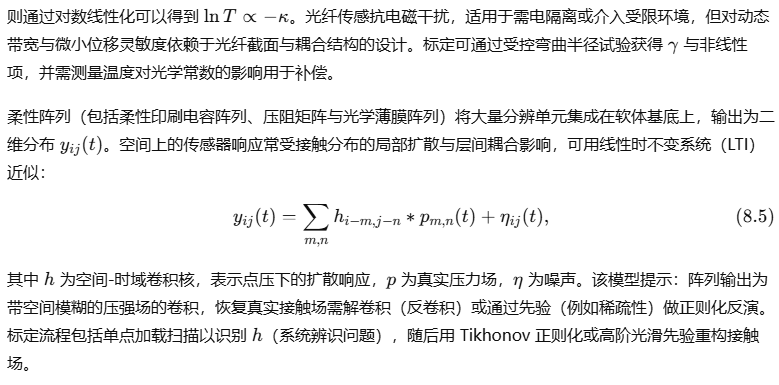
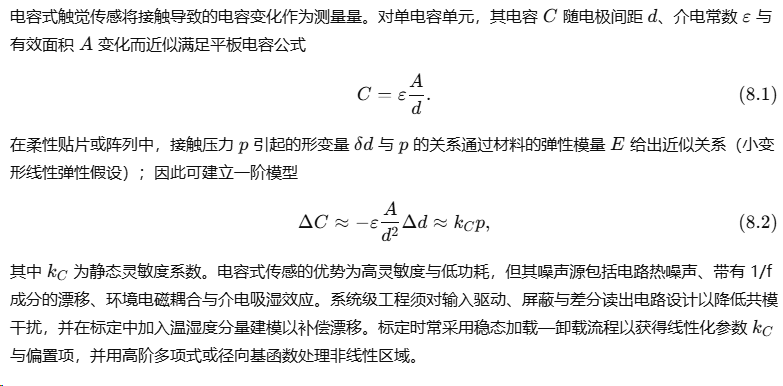
触觉传感作为机器人感知物理接触的核心,其工程化设计必须同时满足物理量测精度、时域响应与系统可耦合性三方面约束。传感器的类型决定了测量机理与噪声结构,接口与采样策略决定了时间一致性与带宽上界,标定方法决定了测量值到物理量(力、压力、接触点、剪切)的映射精度。以下对常用触觉传感器的物理模型、噪声与失真来源、适用场景及其系统级标定法作严格推导与说明;随后在第 8.1.2 节对触觉数据的同步、采样与滤波策略给出数学推导与工程实现准则。

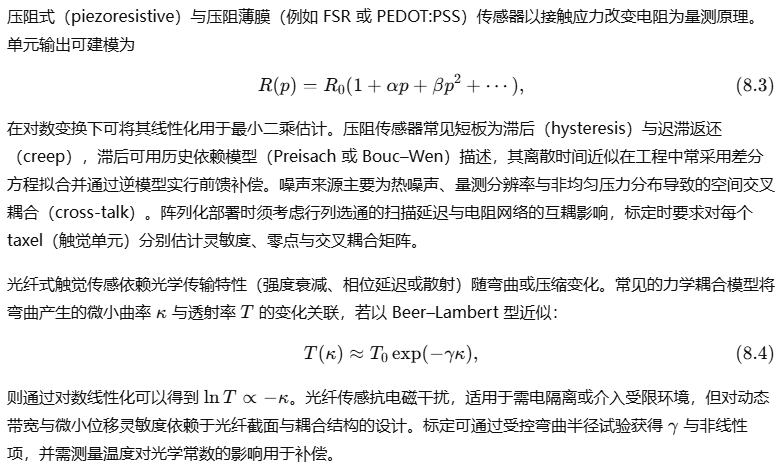
8.1.1 电容、压阻、光纤与柔性阵列的应用场景
标定方法的数学基础与步骤
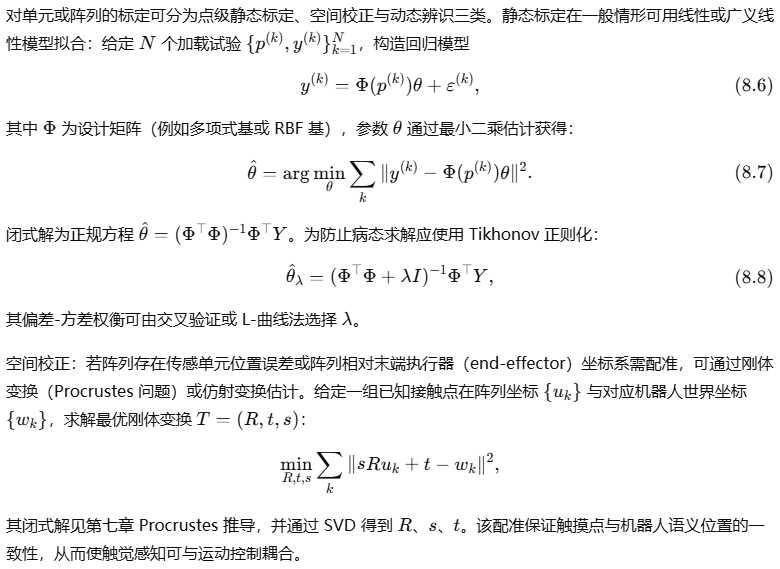
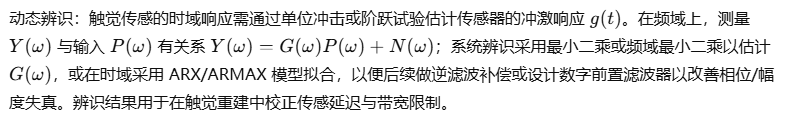
标定流程的工程步骤为:确定试验台架与加载装置;按设计矩阵收集足够丰富的刺激(保证持久激励,persistence of excitation,以确保参数可辨识);选择模型类并估计参数;评估残差统计(白噪声假设检验、残差自相关);若残差显示系统动态或非线性,改用动态模型;最后交叉验证并生成校正表格或参数以供运行时在线补偿使用。

8.1.2 触觉传感的同步、采样与滤波策略

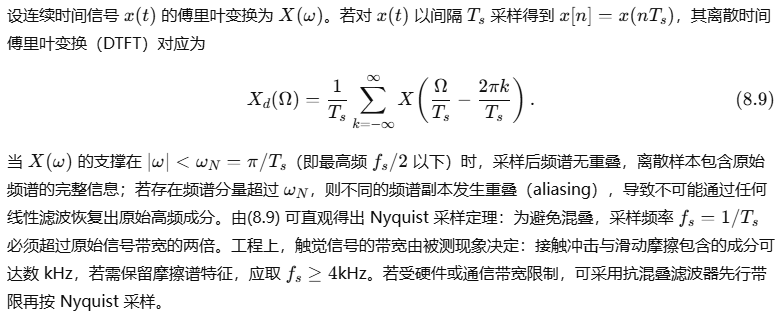
触觉数据的有效利用依赖于采样理论、抗混叠设计与时序对齐方法。触觉信号通常包含低频静态压力分量与高频接触冲击、滑动摩擦成分,设计采样与滤波策略需在保真与降噪之间权衡。以下从采样定理出发证明采样频率选择原则,给出抗混叠滤波器设计与数字滤波器的时延/相位考量,并导出多传感器时间对齐与数据融合的数学方法。

采样定理与混叠证明
抗混叠滤波器设计与相位考虑
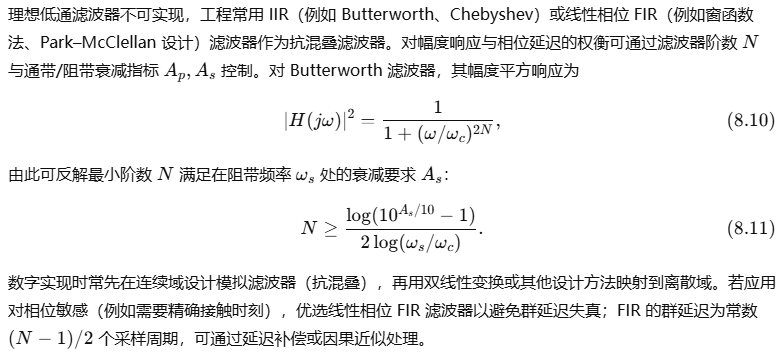
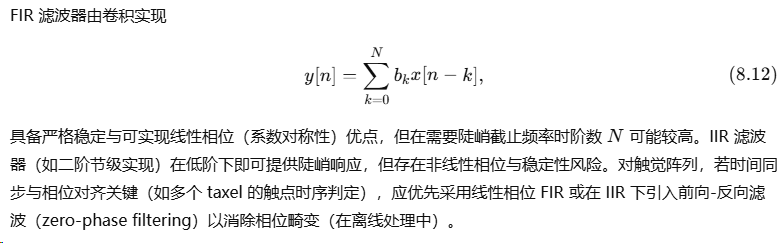
离散滤波方法:FIR 与 IIR 的选择
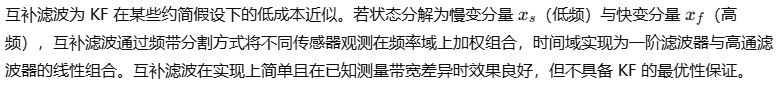
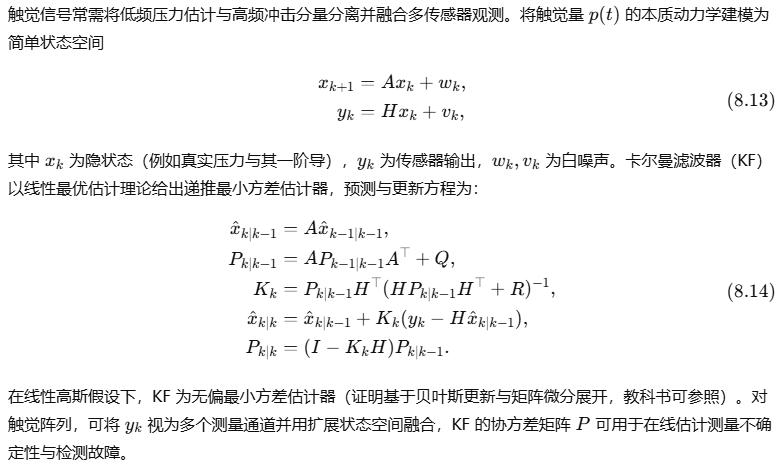
估计与滤波:卡尔曼滤波与互补滤波
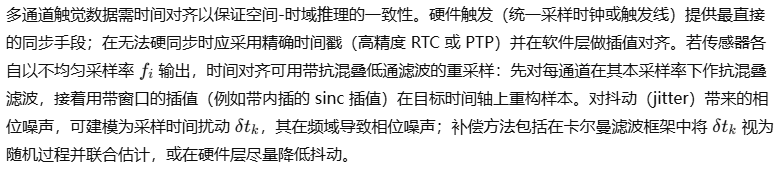
多传感器时间对齐与抖动补偿
滤波与实时性的权衡

设计滤波器时必须权衡延迟(群延迟)、计算复杂度与实时性。实时控制回路中允许的延迟受控制系统稳定性约束,通常需要总感知延迟低于若干毫秒。实践中采用双路径策略:在线使用低阶、低延迟滤波器保障控制稳定性;离线或后台处理使用高阶滤波器与反卷积重建更高保真触觉图像。对阵列图像的去模糊(反卷积)问题应采用正则化方法以免噪声放大。


本节以物理机理为出发点建立了传感器建模框架,并给出标定与辨识的数学方法:静态最小二乘及 Tikhonov 正则、空间配准的 Procrustes 解、传感器时域响应的系统辨识以及滞后建模的历史依赖模型。对触觉数据的采样与滤波作了从采样定理到抗混叠滤波器阶数估计、线性相位考虑、卡尔曼与互补滤波证明与多传感器时间对齐方法的系统推导。这些理论与方法为工程实施提供可验证的设计准则:根据任务带宽确定采样率、先用模拟或数字抗混叠滤波器带限、用稳健回归与正则化完成标定、并在运行时用卡尔曼滤波器或互补滤波器融合多模态触觉观测以获得稳健的接触推断与控制输入。


8.2 触觉数据的表示与学习方法

触觉信号是物体交互过程中最直接的力学量测形式,能够对局部接触状态、材料属性与微观几何结构进行有效表征。其主要特点包括:
(1) 显著的时序相关性;
(2) 局部空间结构性;
(3) 强噪声与弱结构信息特点;
(4) 强烈依赖交互过程;
(5) 与视觉在信息表达上互补。
因此,针对触觉数据,需要建立统一的时空编码框架、降维与压缩机制、事件驱动建模方法及其与视觉融合的学习体系。


8.2.1 时空表征、事件驱动编码与压缩方法

一、触觉信号的时空连续张量表示
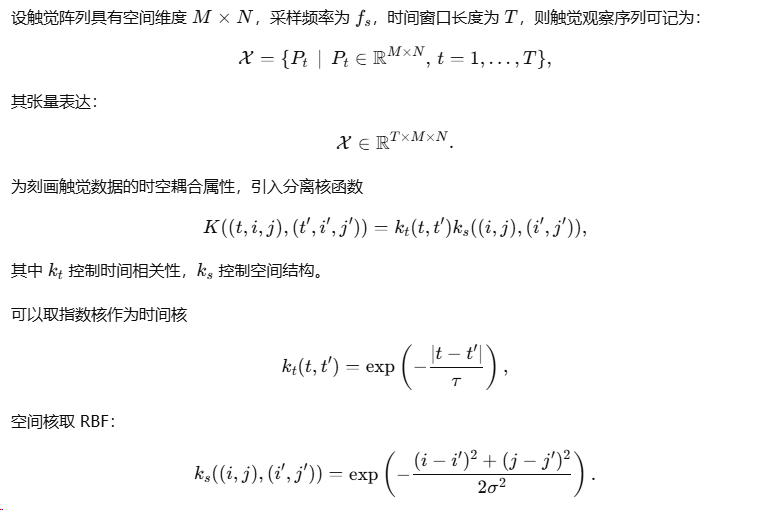
命题 8.2.1
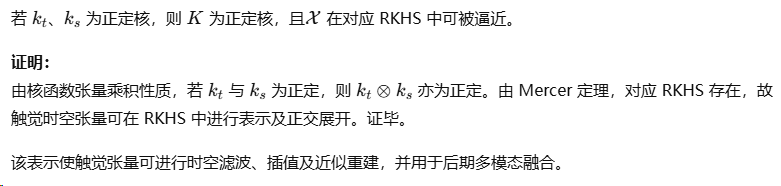

二、事件驱动触觉编码形式
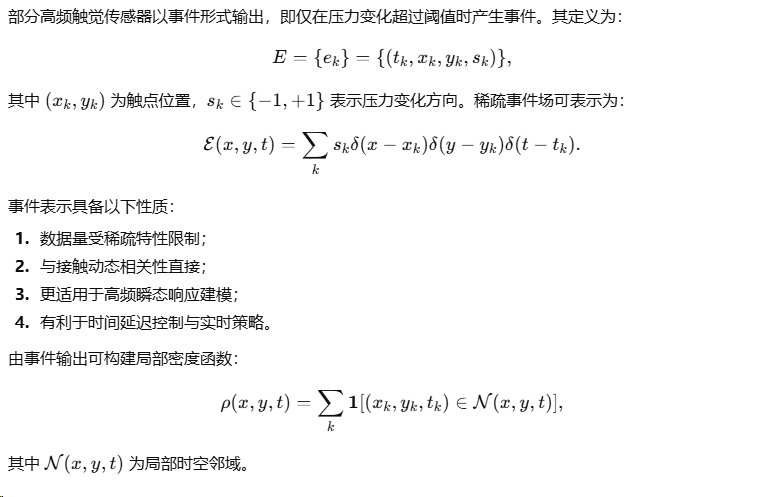

三、触觉数据的低秩压缩与稀疏建模
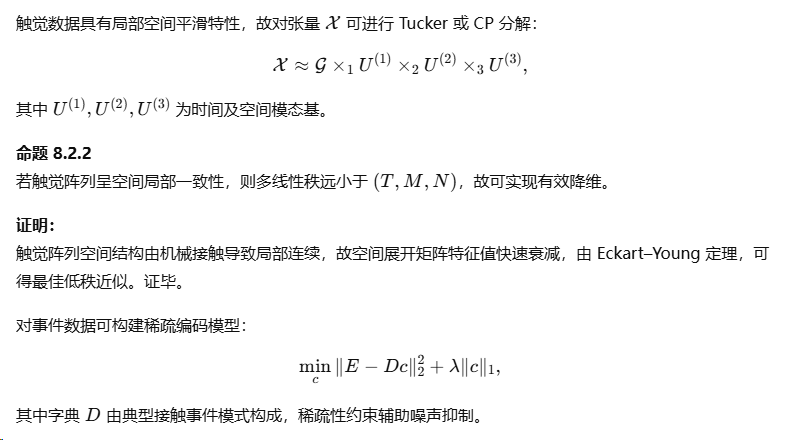

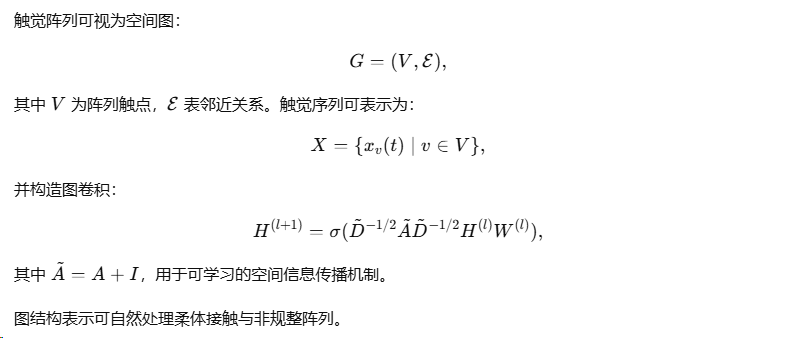
四、基于图结构的触觉建模

8.2.2 触觉—视觉融合的架构模板

触觉信息对视觉的典型补充在于:
(1) 检测遮挡区域接触信息;
(2) 获取几何不可见信息如材质与摩擦系数;
(3) 区分视觉相似但力学不同对象;
(4) 提高动作规划的稳定性。

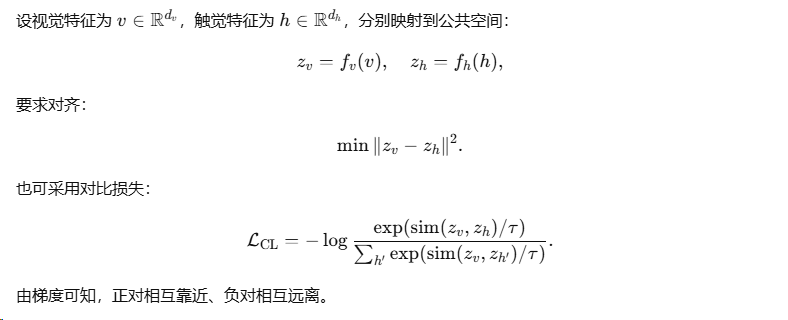
因此,触觉—视觉融合的核心是构建统一隐空间,使力学与几何信息协同。


一、共享隐空间模型

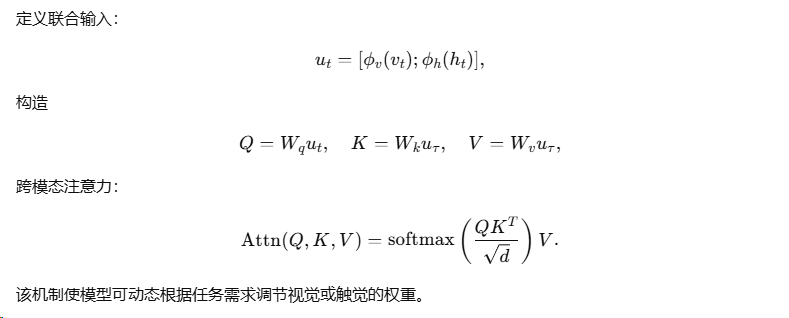
二、跨模态自注意力融合

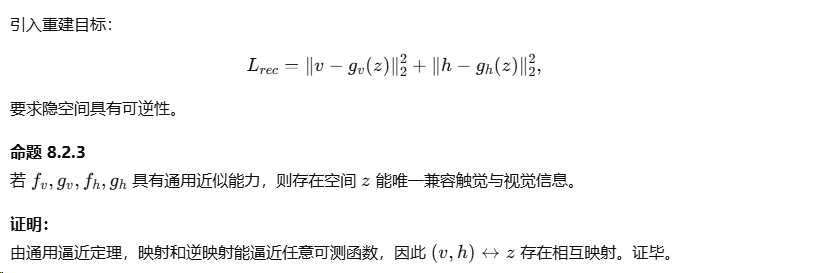
三、功能一致性约束

四、结构先验的注入
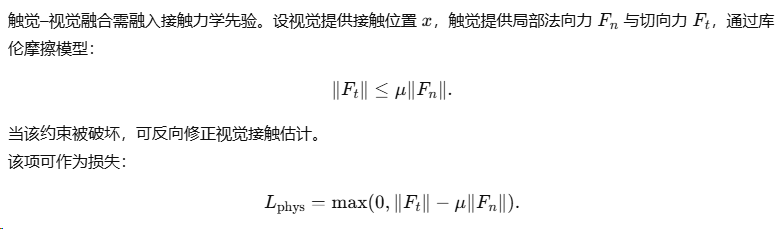

五、典型工程实现流程
  1. 视觉编码器提取几何与纹理信息;

  2. 触觉编码器提取局部力学结构;

  3. 跨模态对齐模块建立共享特征;

  4. 触觉约束校正视觉不确定与遮挡区域;

  5. 视觉信息补充触觉的空间结构;

  6. 联合目标驱动策略学习与物体理解。

8.3 接触策略与力控模式

接触任务的控制目标既包括轨迹/位姿跟踪,又包含力/力矩的精确调节。力—位置混合控制(hybrid force/position control)与阻抗/导纳控制(impedance/admittance control)构成接触策略的核心工具。针对接触的不确定性与可能的扰动,需要在控制律设计、稳定性证明、接触检测与微动作探索以及容错与恢复策略上给出严密的理论与工程实现方法。本节首先系统推导力—位置混合控制与阻抗匹配的理论基础与稳定性条件,随后推导接触探索、微动作设计与容错拆分的数学准则与算法框架。


8.3.1 力—位置混合控制与阻抗匹配

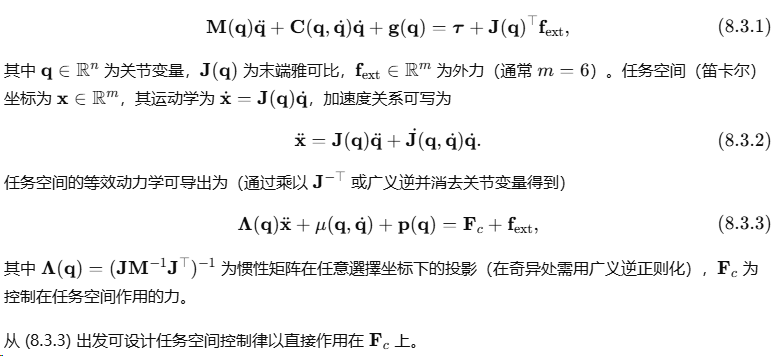
1. 机器人动力学与任务空间表述

考虑一般刚体机械臂,其关节空间动力学为
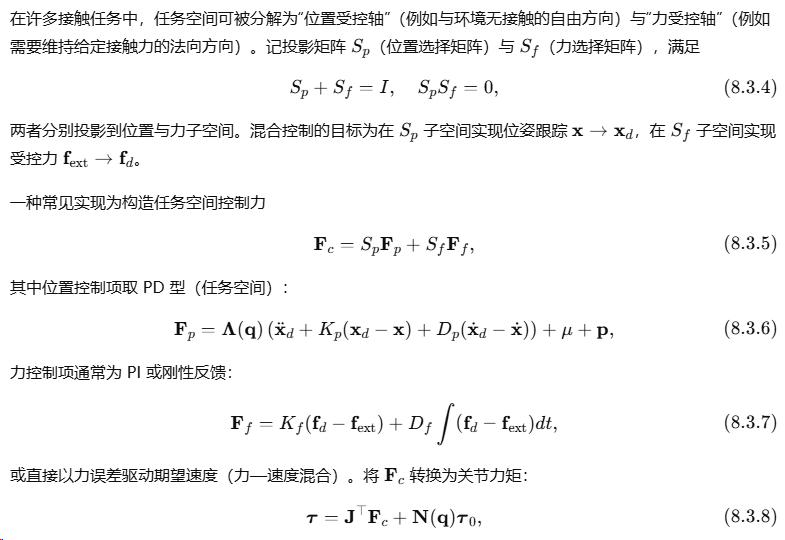
2. 力—位置混合控制的分解与实现
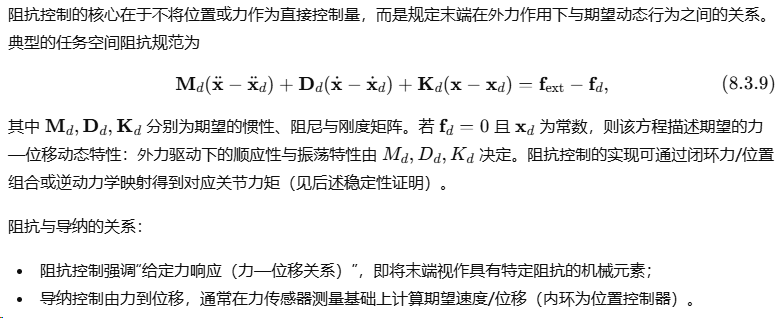
3. 阻抗控制的定义与物理解释
4. 阻抗控制的能量与无功耗(passivity)分析(稳定性证明)

为证明阻抗控制的稳定性与安全性,采用能量函数(储能函数)方法。

定义误差:
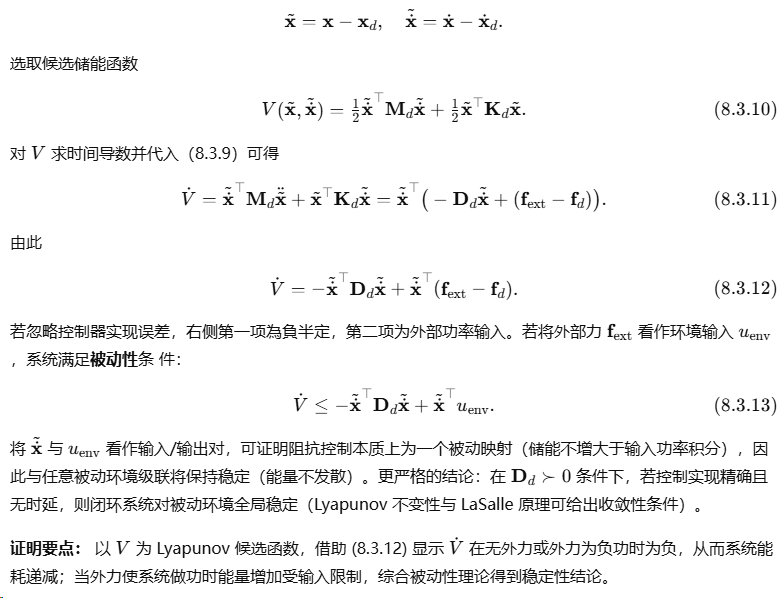
5. 阻抗匹配与控制器参数选择

阻抗匹配的目标是在接触过程中使机器人与环境共同的合成动力学满足预期性能并避免震荡或发散。若环境被建模为弹簧—阻尼元件
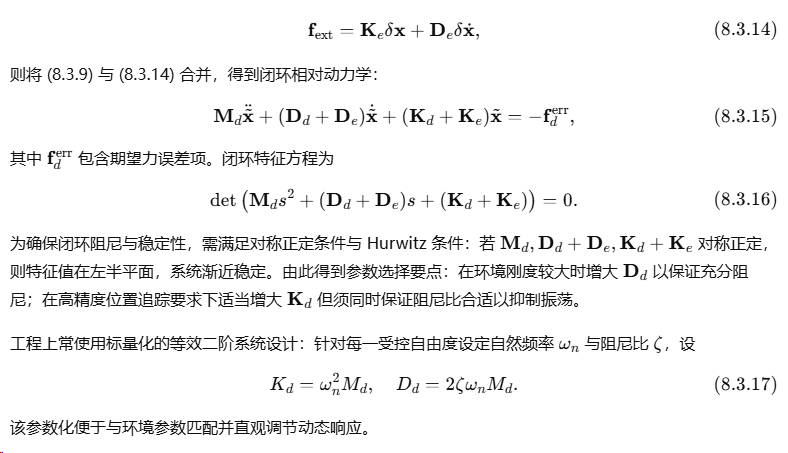
该参数化便于与环境参数匹配并直观调节动态响应。

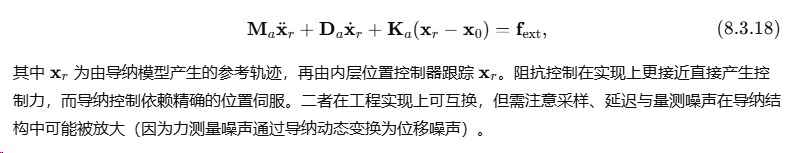
6. 导纳控制与阻抗—导纳的互补实现

导纳控制(admittance control)通过测量力来计算期望的位移或速度命令,其连续形式为
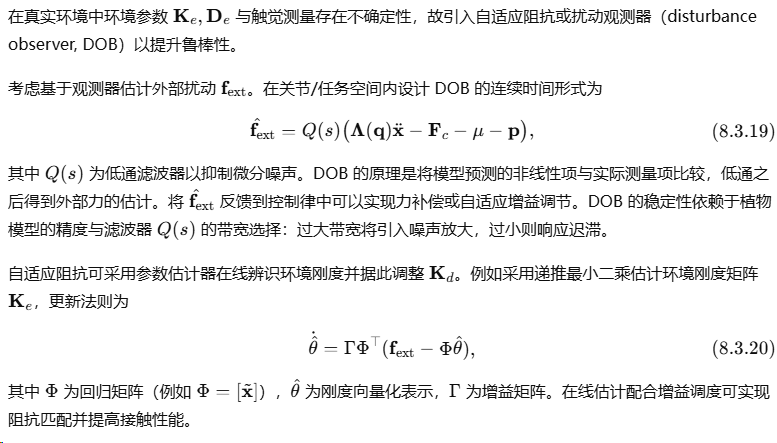
7. 鲁棒/自适应阻抗与扰动估计

小结(8.3.1)

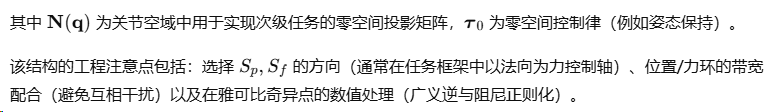
力—位置混合控制、阻抗与导纳控制提供了在接触任务中在位置与力之间进行权衡的系统性方法。通过任务空间动力学投影、能量与被动性分析、环境—控制器参数的匹配(阻抗匹配)与扰动观测器/自适应方法,可以在理论上证明闭环的稳定性与鲁棒性。工程实践要点包括子空间选择、增益的自然频率—阻尼比参数化、雅可比奇异性处理以及力测量滤波与 DOB 设计的带宽权衡。


8.3.2 接触探索、微动作策略与容错拆分

接触任务往往需要在未知环境中搜索接触、辨识环境参数并在受扰动时实现安全恢复。为此提出系统的接触探索与容错策略:包括微动作(micro-motion)设计用于高概率发现接触、检测与统计判决用于可靠判断接触发生、以及任务分层与容错拆分用于恢复与安全停止。以下按理论推导与算法步骤展开。

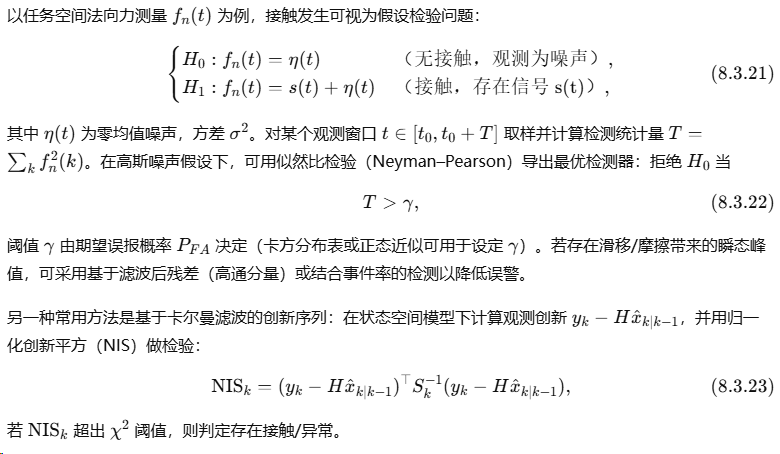
1. 接触检测的统计判决与最优阈值
2. 微动作(Micro-motion)策略设计与频谱优化
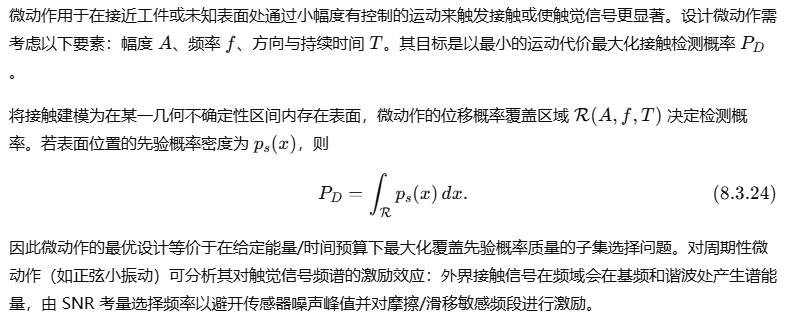
工程常用策略包括:

  • 线性扫描(小幅位移直线移动并持续施力);

  • 圆弧/正弦微振动以产生周期接触并便于频域滤波提取信号;

  • 增量推进(微步增加压入深度以避免大冲击)。

3. 接触参数辨识(刚度、摩擦)的方法
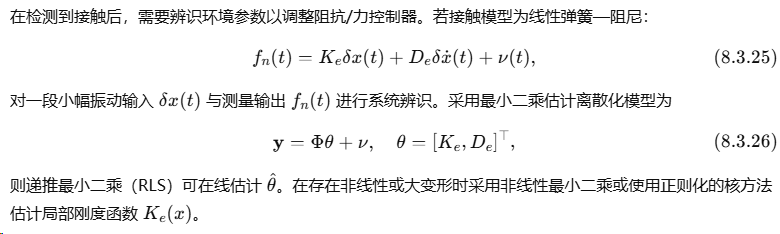
估计结果用于自适应阻抗增益调度或力饱和设定。

4. 容错拆分:任务分层、模式集与恢复控制

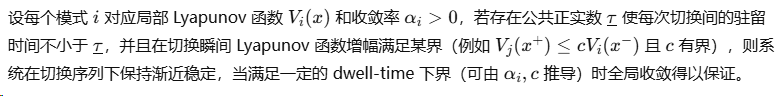
在接触故障或异常(过大冲击、滑脱、力超限)发生时,需要将策略拆分为若干模式并定义相应的切换/恢复律。构造三层控制结构为常用模式:

  1. 正常执行模式(Nominal):执行任务轨迹或技能,使用阻抗/混合控制;监测接触与力异常指标。

  2. 探索/微动作模式(Explore):用于搜索接触或在接触不确定时以微动作辨识环境。

  3. 恢复/安全模式(Recovery):在检测到异常(力超限、失稳或接触不可行)时,停止推进,撤退并执行安全停靠或重新规划。

切换律设计可采用形式化的阈值与宾语(guards)并结合多 Lyapunov 函数与**最小驻留时间(dwell-time)**理论以保证切换稳定性。
5. 容错恢复策略的构造

恢复策略应包含以下步骤:检测→安全撤退→状态重置/重定位→重新规划/查询策略库。伪代码如下:

procedure recovery_procedure():
  if force > f_safe:
    execute retreat_motion()  # 以降功率、受控速度退离接触
    set mode := Recovery
    perform local perception_update()
    if recovery_possible():
      compute new approach trajectory
      switch to Explore or Nominal
    else:
      execute safe_shutdown()

退避轨迹设计应保证在退避过程中不会再次发生冲击,通常采用低刚度、高阻尼的阻抗参数化,并限制最大速度与加速度。

6. 安全性边界与控制屏障函数(CBF)
7. 学习型探索策略与安全约束

小结

接触探索与微动作策略的设计应在能量、安全与信息获取之间进行折衷:微动作需在最小风险下尽可能提升接触信息量;接触检测需采用统计判决或卡尔曼创新检验以获得可靠性;容错拆分以模式化的切换与驻留时间保证稳定性,恢复策略应以受控撤离、参数估计与安全重试为核心;学习型方法需嵌入实时安全投影保证可验证的部署安全。理论工具包括假设检验、频谱分析、递推辨识、切换系统的多 Lyapunov 理论以及控制屏障函数—这些工具结合阻抗/导纳框架共同构成健壮的接触策略库。


本章对接触控制的核心问题从动力学表述、混合控制结构、阻抗匹配的能量稳定性证明、到接触检测、微动作设计、参数辨识与容错恢复给出严密的理论推导与工程实现框架。这些推导与算法直接服务于基于触觉感知的机器人接触行为设计,既可用于教材理论章节,也可为工程实现提供明确的数学与算法依据。

工程实践:从SMPL到机器人——动作重定向配置详解 本文详细介绍了在PHC开源框架下,如何将SMPL人体模型与AMASS动作数据重定向至机器人,实现动作模仿的工程实践。核心在于通过配置YAML文件,完成机器人关节与SMPL关节的精准匹配、虚拟关节扩展及初始姿态调整,并提供了完整的调试与可视化验证流程,帮助开发者高效生成可用的机器人动作数据。 阅读详情

相关推荐

OCTF2016--piapiapia

知识点: php反序列化长度变化尾部字符串逃逸 目录扫描发现www.zip,下载得到源码 源码有index.php,输入账号密码后会进入profile.php,还有register.php、updata.php、class.php和config.php flag值在config.php中,想办法访问到其内容 通过seay代码审计找到一点线索 看到profile.php中存在任意文件读取漏洞,前面还有反序列化 现在我们有个大体思路了,update.php中有一个$prof..

Oavinci的博客 476

动画重定向技术分析及其在Unity中的应用

动画重定向技术是一种时间换空间的思路,在运行时将一套动画根据预计算好的骨骼差异信息,得到目标模型骨架上可以适用的动画数据,就可以生成目标角色的受击动画效果。这种方式既可以减少美术的工作量,又可以增加游戏对策划需求和修改的灵活度。 前言 笔者新的手游项目使用Unity引擎,动画部分要使用重定向技术来实现动画复用。笔者之前在大公司工作的时候对这块了解比较深入,读过Havok引擎在这部分的实现源码,并基于自己的理解,在公司自研的手游引擎中实现了一个简化的版本。本文将从原理层面分析Animation Retar

蛰伏--当你不够强大时,就不要放弃努力 3066

FPGA工程师必看:JESD204B同步机制实战指南(含SYSREF信号调试技巧)

本文为FPGA工程师提供了一份JESD204B同步机制的实战指南,重点聚焦于SYSREF信号的调试技巧。文章从同步的核心逻辑出发,深入剖析了时钟、SYSREF与对齐序列这“三驾马车”的协作,并详细阐述了硬件PCB布局、FPGA IP核配置、状态机监控以及使用示波器进行波形分析等关键实战步骤,旨在帮助工程师解决多通道高速系统中的同步难题,确保链路的稳定与确定性延迟。

weixin_29239661的博客 334

运动重定向:C-3PO

在不同尺寸和运动学构型的同质多形体之间进行运动重定位需要全面的(逆)运动学知识。此外,提供一个与运动无关的通解是困难的。在本研究中,我们开发了一种基于深度强化学习的人-机器人运动重定向**循环三阶段(cyclic three-phase)**优化方法。该方法通过循环路径和滤波路径在潜在空间中使用精细数据进行运动重定向学习。此外,基于人在环的三阶段方法从定量和定性两方面为改进运动重定向策略提供了一个框架。利用所提出的C-3PO方法,我们成功地学习了NAOPepperBaxter和。

Airs-Gao的博客 2005

window系统 dlib库安装

1. 安装visual studio 1.1. 安装vs2017或以上版本 1.2. 我们需要安装使用C++的桌面开发,且必须选上用于Cmake的Visual C++工具 1.3. 安装完成后,将D:\Program Files (x86)\Microsoft Visual Studio\2019\Community\Common7\IDE\CommonExtensions\Microsoft\CMake\CMake\bin 添加到环境变量PATH中 2 下载cmake文件,并添加环境变量 2.1 在c

@bangbang的博客 818

当拿到金葡菌的全基因组测序数据后该怎样进行分析呢

很多做科研实验/做课题报告的科研老师们在拿到全基因组测序数据之后要进行一系列的分析,但同时也担心数据庞大分析缓慢导致进度,也有因为不会编程不知道该如何进行拼接分析的...其实需要质控拼接、MLST分析及菌种鉴定等完全可以自己在平台上进行分析,下面以金葡菌为例进行了质控拼接及菌种鉴定等分析。 网络图片(侵删) 金黄色葡萄球菌(Staphylococcus aureus,S. aureus)也称“金葡菌”,隶属于葡萄球菌 属,是革兰氏阳性菌的代表,为一种常见的食源性致病微生物。 那么在取得了金葡菌全基

GenesClouds的博客 1970

搞了半天blender整动画这么爽,骨骼重定向一回,动作就可以到处套用,和音频对轨也好使

在blender的大纲视图里,对应模型下方可以找到动画(就叫动画,英文Animation),接着在动画下方可以看到一个跟动画摄影表一样图标的对象。那个就是具体的动作。我们假定用的是Tpose的模型(因为我这个bvh文件是Tpose用的,所以为了动作映射不出问题,优先整的这种模型),需要给它套上运动数据。当我对其中一个模型进行骨骼重定向/映射(都是一个意思)之后,该模型的动作属性可以任意赋给别的那四个模型。我们搞到了运动数据(可能是bvh文件,也可能是fbx文件)之后,想要让某个静态的模型动起来。

dalaomanzou的博客 4924

华为OD技术面八股文_C++_02

汇总华为OD面试C++方面计数八股文真题,提供详细解答。

qq_45776114的博客 770

IL_策略训练_Animate + mujoco

【代码】BI_动作重定向_Animate + mujoco。

eillot_qian的博客 409

AppStore逆向分析(登录、查询、下单)

某网站全协议流程逆向与分析(自动登录、激活、查询、下单)

吴秋霖的博客 3032

利用XGBoost实现短期电力负荷预测

本数据集为某地区2009年-2015年的用电负荷,时间片为每分钟这里我们定义了XGB模型作为实例,来进行模型训练,之后我们会对其使用网格搜索找到最优的参数。

优快云 精品推荐 4497

CVPR 2020丨无监督动作迁移TransMoMo

导读在CVPR 2020上,来自CMU、北京大学、清华大学、商汤研究院的研究者提出了一种无监督的人体动作迁移方法,为动作序列数据建模提供了新思路。该论文提出了一种新颖的动作重定向网络(M...

idol24的博客 3528

【图像超分】论文精读:Interpreting Super-Resolution Networks with Local Attribution Maps(LAM)

论文题目:Interpreting Super-Resolution Networks with Local Attribution Maps —— 用局部归因图解释超分辨率网络CVPR 2021!必读文章!必须会的可视化手段!很多文章中都会对比LAM!图像超分辨率 (SR) 技术发展迅速,受益于深度网络的发明及其连续突破。然而,众所周知,深度学习和深度神经网络很难解释。SR网络继承了这种神秘的性质,很少有作品试图理解它们。在本文中,我们对 SR 网络进行了归因分析。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 548

工程实战:机器人动作数据重定向

本文介绍了如何利用PHC工具实现人体动作数据到机器人动作数据的重定向。主要内容包括:1)使用SMPL人体模型和AMASS动作数据集作为输入;2)通过形状拟合(fit_smpl_shape.py)和动作拟合(fit_smpl_motion.py)两个步骤,将人类动作转换为机器人可用的关节角度数据;3)详细说明了如何通过修改YAML配置文件来适配自定义机器人模型,包括关节匹配和虚拟扩展部位的设置。该方法已被H2O、HOVER等多个项目采用,实现了人体动作到机器人的高效转换。

CyanNoah的博客 2052

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

**探索视频动作重定向新领域——TS-Net**

探索视频动作重定向新领域——TS-Net WACV23_TSNetThe pytorch implementation of our WACV23 paper "Cross-identity Video Motion Retargeting with Joint Transformation and Synthesis".项目地址:https://gitcode.com/gh_mirrors/w...

gitblog_00040的博客 471

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

HDU 4005 The war(双连通好题)

HDU 4005 The war 题目链接 题意:给一个连通的无向图。每条边有一个炸掉的代价。如今要建一条边(你不不知道的),然后你要求一个你须要的最少代价,保证无论他建在哪,你都能炸掉使得图不连通 思路:炸肯定要炸桥,所以先双连通缩点,得到一棵树,树边是要炸的,那么找一个最小值的边。从该边的两点出发。走的路径中,把两条包括最小值的路径。的两点连边。形成一个环。这个环...

weixin_33739646的博客 171

Blender骨骼动画重定向:解决跨模型动作迁移的技术方案

在Blender动画制作中,骨骼动画重定向是最常遇到的技术挑战之一。不同来源的3D模型往往使用不同的骨骼结构和命名规范,导致动作资源无法直接复用。本文将介绍基于约束映射的实用解决方案,帮助创作者高效实现动作重定向。 ## 问题分析:骨骼动画兼容性障碍 当尝试将Unity或Unreal Engine的标准动画应用到自定义角色时,经常会遇到以下问题: 1. **骨骼轴向差异**:不同软件导出的骨

gitblog_00625的博客 1251

动画重定向技术分析和Unity中的应用

动画重定向,即Animation Retargeting,是一种动画复用的技术,直观上,你可以把它的作用想象成周星驰电影《西游-降魔篇》里的“听话符”——“我做什么,你就跟我做什么”。简单来说,重定向技术就是一种在将动画数据从一个骨架拷贝到另外一个骨架的过程,只是这个所谓的“拷贝”过程,没有Ctrl+C、Ctrl+V这么简单,其实现的方式,也会影响到动画应用到另外一个骨架之后的效果。...

rexgp的博客 1650

asp.net mvc中动作方法的重定向

简单介绍一下mvc控制器下怎样重定向的其它页面 1、方式1:Response.Redirect重定向 //Response.Redirect方式跳转 Response.Redirect("~/Login/Weclome"); 2、方式2:Redirect重定向 //Redirect方式跳转 return Redirect("~/Login/Main"); 3、方式3:RedirectT...

weixin_33795833的博客 395

ue4人物动作_UE4动画重定向

动画重定向相同骨骼的动画重定向动画信息描述:https://docs.unrealengine.com/en-us/Engine/Animation/AnimationRetargeting动画重定向设置:https://docs.unrealengine.com/en-US/Engine/Animation/AnimHowTo/Retargeting打开骨骼模型,在window里面勾选Skele...

weixin_39829166的博客 1596

UE4 人物骨骼-动画重定向

UE4中,使用动画重定向,对导入的人形骨骼进行修改,并套用引擎中已存在的动画。 一.可用的动画模型 UE4 默认有一套基本的人形骨骼(同Unity),一般UE4商城动画都使用Humanoid Rig。 如果商城介绍中,存在“Rigged to Epic skeleton Yes”,则可以使用Epic所提供的动画资源。 二.具体操作 1.打开面板 windows - Retarget Manager面板 - 选择使用的Rig操纵。 2.对比使用动画骨骼修改 打开原动画骨骼,与导入的新模

Deveuper的博客 1万+

重定向实现的三种方法

实现方法:一、通过.htaccess文件配置二、Apache的主配置文件<Directory>段(Windows中的httpt.conf或Linux中的apache2.conf文件中配置)三、使用php或者其他脚本语言实现(只能实现外部重定向)一、通过.htaccess实现        cmd中创建.htaccess(因为目录不能创建):进入到网站根目录,输入 echo 1>....

Grey_coder的博客 1万+

ue4 怎么修改骨骼动画_【UE4】动画重定向

虚幻4动画重定向重定向虚幻争霸中两个角色,使用同一套动画。1.首先我们从虚幻商城下载两个角色到项目内。(我这里选择了Wraith、Revenant)由于需要使用另外的动画,我这里选择将两个骨架的重定向姿势都设置成另外一个骨架的姿势。2.打开骨架编辑器,点击重定向管理器:3.点击设置绑定,选择人型绑定:4.点击查看姿势:5.打开Wraith的骨骼调整按照上述操作查看姿势,然后调整两个骨架网格体的姿势...

weixin_39633455的博客 4394

【算法拾光】队列|在每个树⾏中找最⼤值 + 最后⼀块⽯头的重量

本文总结两道经典算法题:一是通过层序遍历(BFS)逐层找最大值,利用队列分层处理,每层维护最大值;二是用大根堆(优先队列)模拟石头碰撞过程,每次取最大两块石头,差值重新入堆,直至剩余一块或无石。前者适用于树的层次遍历,后者适合动态获取最值场景。核心思想:队列用于分层遍历,堆用于高效取极值。

wuqingyigexiaoba的博客 202
上一篇: 机器人技术与智能系统的工程化与应用 第六章 视频示范采集与自动标注体系
下一篇: 机器人技术与智能系统的工程化与应用 第九章 双手与复杂对象操控,第十章 高吞吐仿真与并行训练架构
VectorShift
博客等级 码龄1年 1844粉丝 1109原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

VectorShift

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值