机器人技术与智能系统的工程化与应用 第四章 生成式轨迹模型概论,第五章 扩散与概率运动规划

损失函数与优化器:从「梯度是怎么被造出来的」到「梯度是怎么被用掉的」 本文揭示损失函数与优化器本质一体:优化器仅依赖损失产生的梯度,而损失决定梯度的方向、尺度与噪声特性。错误的损失选择(如分类用MSE)会导致梯度失衡,使优化器失效;不同损失(如Huber、Focal)通过调控梯度分布影响优化过程。实测表明,归约方式、标签结构与损失配对直接决定梯度行为,进而影响收敛性与泛化。核心观点:选对损失,才是让优化器“看得懂”的前提。 阅读详情

系列文章目录

第1章 摘要与阅读指引

第2章    架构范式与模块化设计

第3章    视觉—语言—动作(VLA)模型专题


文章目录

目录

4. 生成式轨迹模型概论

4.1 概念框架与模型家族

4.1.1 隐式密度模型:条件生成对抗网络 (cGAN)

4.1.2 潜在变量模型:条件变分自编码器 (CVAE)

4.1.3 精确密度模型:条件流模型 (Conditional Flow Models)

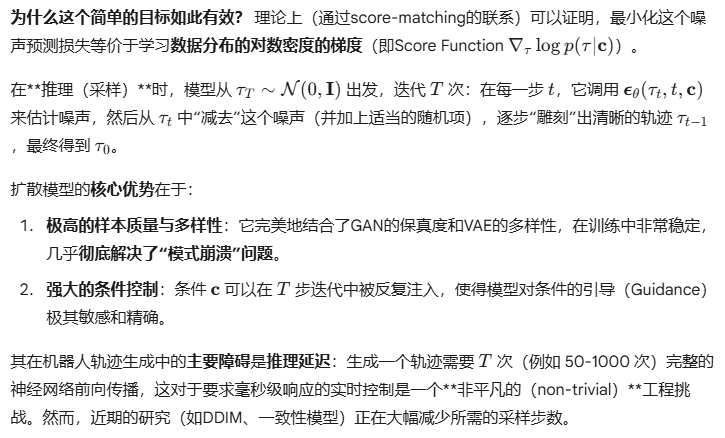
4.1.4 迭代精炼模型:扩散模型 (Diffusion Models)

4.2 条件采样与约束注入技术

4.2.1 状态约束、碰撞约束的嵌入方法

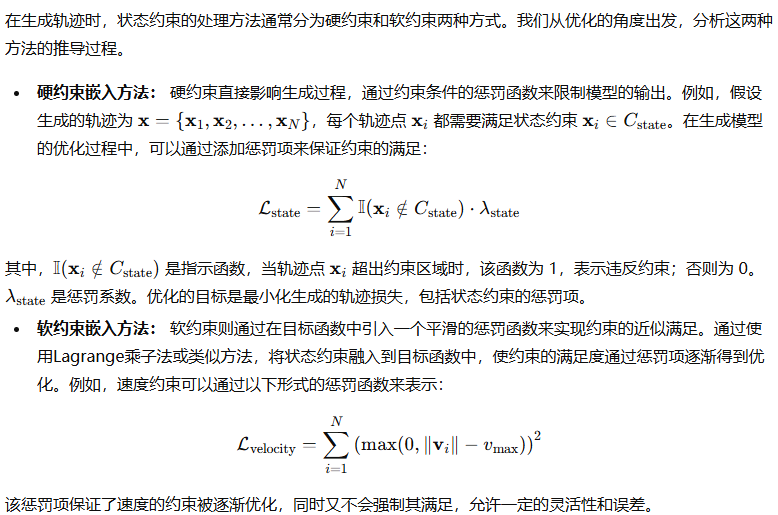
1. 状态约束的嵌入方法

2. 碰撞约束的嵌入方法

4.2.2 实时约束适配与修正策略

1. 约束动态更新

2. 局部修正与反馈控制

4.2.3 采样效率与实时性优化手段

1. 重要性采样与策略优化

2. 并行化与GPU加速

3. 增量式优化与局部调整

4.3 生成模型与控制器的融合模式

4.3.1 生成模块作为建议器的工程模式

1. 生成轨迹的候选空间

2. 建议与执行的反馈回路

4.3.2 轨迹置信度评估与安全筛选器

1. 置信度评估的理论框架

2. 安全筛选器的设计

4.3.3 异常恢复与在线微调机制

1. 异常恢复的理论框架

2. 在线微调机制

5 扩散与概率运动规划

5.1 模型结构细节与损失设计

5.1.1 条件损失、重建损失与正则化项

条件损失(Conditional Loss)

重建损失(Reconstruction Loss)

正则化项(Regularization Term)

5.1.2 多目标与对抗性数据的训练策略

多目标优化(Multi-Objective Optimization)

对抗性训练(Adversarial Training)

5.2 训练数据管线与数据增强技巧

5.2.1 示范数据的合成方法与质量控制

5.2.2 稀有场景的采样增强与权重重校正

稀有场景采样增强

5.3 评测指标与破坏性测试模板

5.3.1 多样性度量、鲁棒性曲线与失败分类

轨迹多样性度量

鲁棒性曲线

失败分类

5.3.2 可重复性实验卡与对比基线设计

可重复性实验卡

实验卡是科学实验标准化的实现工具,确保每次实验可复现。内容包括:

对比基线设计


4. 生成式轨迹模型概论

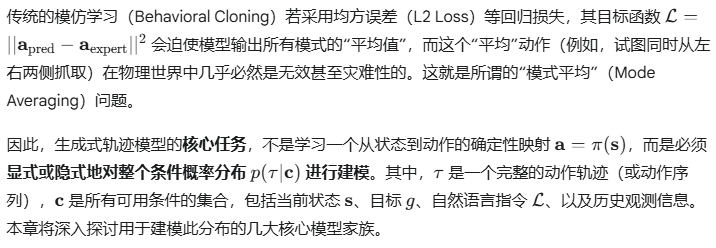
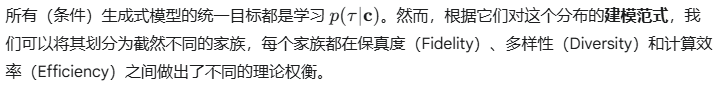
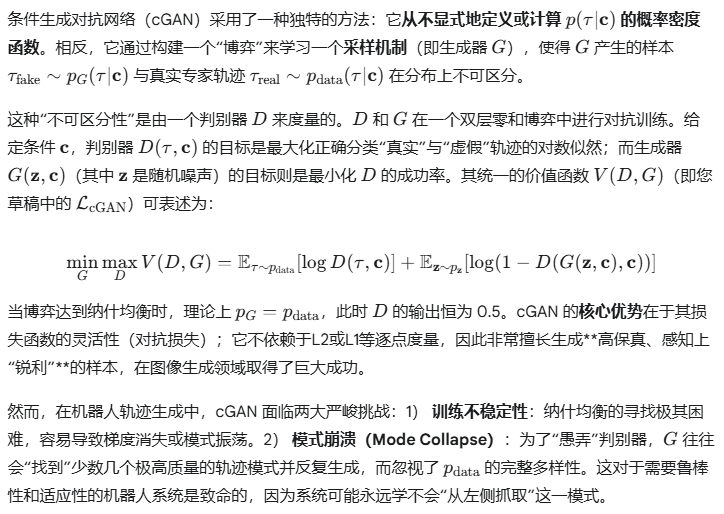
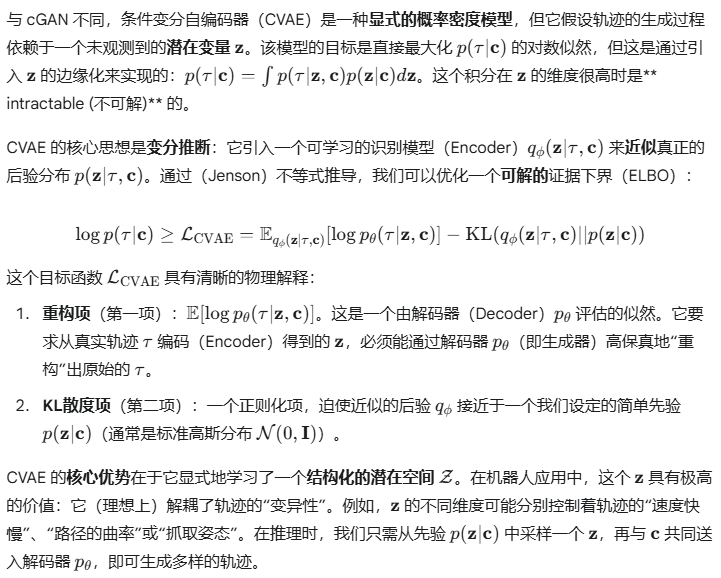
生成式轨迹模型,旨在从给定的、可能不完整或高维的输入信息中,学习并采样出符合任务要求和动力学约束的动作序列分布。在机器人学中,这一问题具有根本性的挑战:对于一个给定的任务(例如,从桌上“拿起杯子”),其解空间本质上是**多模态(Multi-modal)**的。机器人可以从左侧抓、从右侧抓、抓手柄或抓杯身,这些都是同样有效的“专家”轨迹。
4.1 概念框架与模型家族
4.1.1 隐式密度模型:条件生成对抗网络 (cGAN)
4.1.2 潜在变量模型:条件变分自编码器 (CVAE)
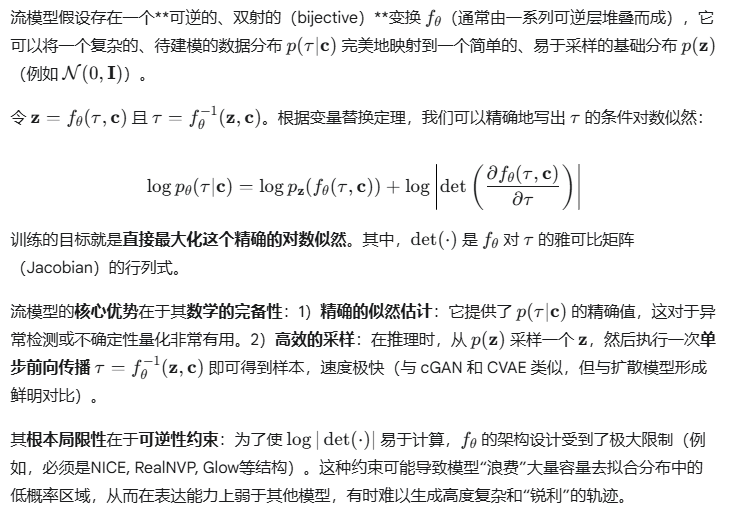
4.1.3 精确密度模型:条件流模型 (Conditional Flow Models)
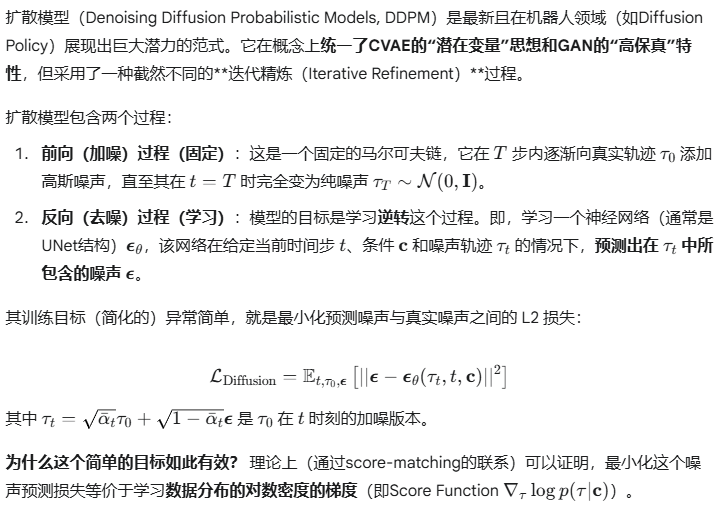
4.1.4 迭代精炼模型:扩散模型 (Diffusion Models)
4.2 条件采样与约束注入技术

在机器人轨迹生成及规划中,条件采样与约束注入技术扮演着至关重要的角色。条件采样允许模型在给定的条件下生成符合要求的轨迹,而约束注入则确保这些轨迹符合实际操作中的物理和安全约束。通过这些技术,可以确保生成的轨迹不仅满足任务要求,还能够有效规避碰撞和物理限制。以下将详细推导并分析几种常用的条件采样与约束注入方法,包括状态约束、碰撞约束的嵌入方法、实时约束适配与修正策略、以及采样效率与实时性优化手段。

4.2.1 状态约束、碰撞约束的嵌入方法

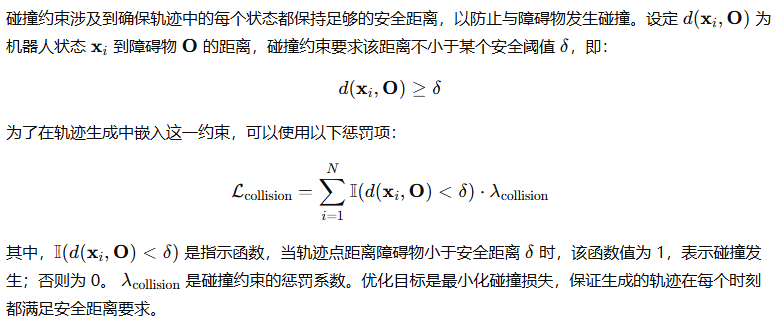
在生成轨迹的过程中,状态约束和碰撞约束是最基础且最重要的约束类型。状态约束通常限制机器人在给定任务中必须遵守的物理参数(如位置、速度、加速度等),而碰撞约束则确保机器人在运动过程中避免与环境中的障碍物发生碰撞。我们通过严格的数学推导,探讨如何将这些约束有效地嵌入轨迹生成模型。

1. 状态约束的嵌入方法

状态约束涉及到对机器人的各类状态变量进行约束,比如位置约束、速度约束、加速度约束等。这些约束通常以不等式的形式出现,如:
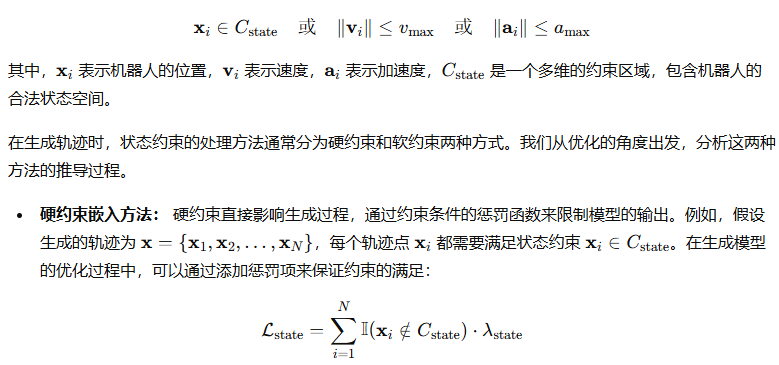
    2. 碰撞约束的嵌入方法
    4.2.2 实时约束适配与修正策略

    在实际应用中,环境是动态变化的,障碍物可能移动,任务要求可能随时变化。因此,在轨迹生成过程中,需要实时适配新的约束条件,并对现有轨迹进行修正。为了保证机器人在复杂环境中的实时性和鲁棒性,实时约束适配与修正策略显得尤为重要。

    1. 约束动态更新

    在轨迹生成的过程中,新的约束条件可能随时加入。比如,障碍物的移动可能导致新的碰撞约束,而外部任务需求的变化可能引入新的状态约束。因此,需要设计能够动态更新约束的机制。可以通过以下方法进行约束的动态更新:

    • 增量式约束优化:每当约束条件发生变化时,可以对目标函数进行增量式更新,而不是从头开始计算新的轨迹。例如,在每次更新约束时,仅优化受影响的部分轨迹,避免了整个轨迹的重新生成,从而提高了计算效率。

    • 在线规划与重规划:当新的约束加入或环境发生变化时,可以触发重规划机制。常见的重规划方法包括基于采样的快速扩展随机树(RRT)和RRT*算法,在新的约束条件下重新规划轨迹。

    2. 局部修正与反馈控制

    当机器人在执行过程中遇到实时的偏差或扰动时,需要通过局部修正和反馈控制来修正轨迹。通过实时的感知数据,机器人能够估计自己的当前状态,并在此基础上修正轨迹。具体地,可以使用以下技术进行局部修正:

    • 状态估计与校正:使用卡尔曼滤波或粒子滤波等技术对机器人状态进行实时估计。在每个时间步,基于当前估计的状态,对生成的轨迹进行局部修正,确保机器人始终保持在可行轨迹上。

    • 增量式控制与规划:通过增量式的轨迹修正策略,例如基于PID控制器的路径跟踪,实时调整机器人的轨迹,确保其满足实时的约束条件。

    4.2.3 采样效率与实时性优化手段

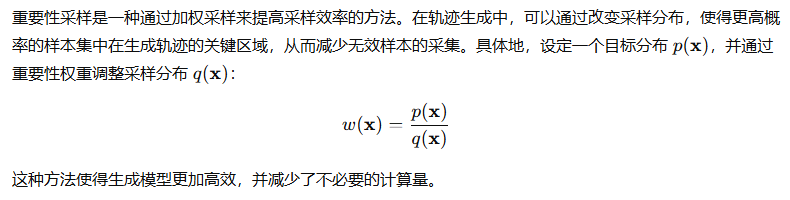
    在轨迹生成中,尤其是在大规模问题和动态环境下,采样效率和实时性是非常关键的。为了提高采样效率,并满足实时性要求,需要设计高效的采样策略和优化手段。

    1. 重要性采样与策略优化
    2. 并行化与GPU加速

    为了在复杂环境中实现高效的轨迹生成,可以采用并行化和GPU加速方法。通过将采样任务分配到多个处理器或计算节点上,可以显著提高采样效率。在实际应用中,可以利用GPU加速矩阵运算、梯度计算等任务,从而提高计算速度。

    3. 增量式优化与局部调整

    增量式优化方法可以提高生成轨迹的实时性。在每次更新时,只对当前轨迹的部分进行调整,而不是重新计算整个轨迹。增量式优化方法的实现可以通过局部调整策略来快速适应环境变化,确保轨迹生成的实时性和准确性。

    4.3 生成模型与控制器的融合模式

    在实际机器人轨迹生成中,单一的生成模型往往无法直接满足复杂动态环境下的实时性与准确性要求。为了提高轨迹生成的稳定性与效率,生成模型与控制器的协同工作成为一个关键的解决方案。生成模型主要负责提供候选轨迹,而控制器则负责基于环境反馈调整轨迹,确保机器人能够高效、安全地执行任务。本文将详细探讨生成模型与控制器融合的不同模式,重点关注生成模型作为建议器的工程模式、轨迹置信度评估与安全筛选器、以及异常恢复与在线微调机制。

    4.3.1 生成模块作为建议器的工程模式

    在很多机器人应用中,生成模型被设计为轨迹生成过程中的建议器(Advisor)。此时,生成模型的任务是生成多个候选轨迹,而控制器则负责基于环境感知与约束条件来选择、执行并调整最终轨迹。生成模型和控制器之间的协同工作通常按照以下步骤进行。

    1. 生成轨迹的候选空间

    生成模型的目标是为控制器提供一个多样化的候选轨迹集。通过从环境与任务特征中提取信息,生成模型能够生成符合要求的轨迹。生成的轨迹集通常通过条件采样或优化方法得到。这些轨迹在多样性上进行设计,以满足不同任务需求和环境条件。生成模型如扩散模型、变分模型或流模型等都可以用于此类任务。

    在机器人应用中,生成模块不要求生成的轨迹完全满足可执行性,而是侧重于提供一组候选解。在动态环境下,机器人可以根据实际情况从这些候选轨迹中选择最优路径。因此,生成模块的首要任务是保证轨迹的多样性和候选集的充足性,而不是严格要求每条轨迹都能直接执行。

    2. 建议与执行的反馈回路

    生成模型提供候选轨迹后,控制器会根据实时状态和环境感知对每条轨迹的执行可行性进行评估。控制器的主要职责是根据传感器数据对生成轨迹进行调整,确保轨迹能够在不断变化的环境中高效、安全地执行任务。

    在实际应用中,控制器会对生成的轨迹进行以下几种处理:

    • 平滑与修正:若生成的轨迹存在急转弯、速度突变等不符合物理限制的情况,控制器将采用平滑技术或在线优化算法进行修正。例如,基于控制理论的平滑方法可以调整轨迹的速度变化,使其符合系统的动力学约束。

    • 动态约束处理:控制器会根据实时的环境感知,更新状态约束(如位置、速度限制)和碰撞约束,确保轨迹的安全性。如果生成的轨迹会导致碰撞或不符合安全标准,控制器会立即修正或选择其他可行轨迹。

    • 实时适应:当环境变化导致生成的轨迹不可行时,控制器将根据新获得的感知数据选择新的轨迹或重新生成轨迹,确保机器人能够顺利完成任务。

    这一过程的核心是生成模块专注于轨迹候选的生成,而控制器则在执行层面进行实时反馈和调整。两者的协同作用使得系统既能提供多样化的轨迹方案,又能在执行时保证适应性和安全性。

    4.3.2 轨迹置信度评估与安全筛选器

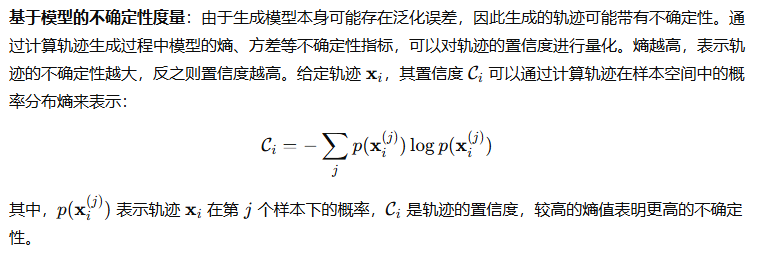
    生成模型通常会输出多个候选轨迹,这些轨迹可能在执行时面临不同的风险与挑战。因此,对生成的轨迹进行置信度评估和安全筛选是确保轨迹可执行性与安全性的关键步骤。置信度评估与安全筛选器的任务是对轨迹进行评分和筛选,确保所选轨迹不仅符合执行条件,也能够满足安全性要求。

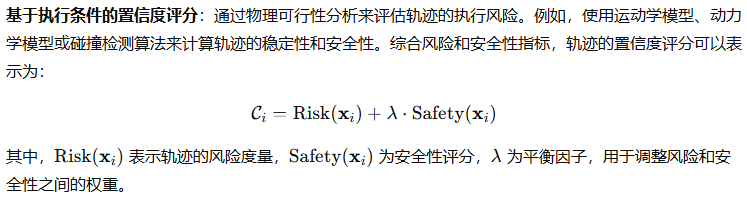
    1. 置信度评估的理论框架

    轨迹的置信度评估旨在量化每条轨迹的执行风险,并对其进行评分。常见的评估方法包括基于模型的不确定性度量和基于执行条件的置信度评分。
    2. 安全筛选器的设计

    在生成多个候选轨迹后,安全筛选器的任务是根据置信度评估筛选出最安全的轨迹。在实际应用中,安全筛选器通常会执行以下步骤:

    • 碰撞检测:对每条轨迹进行碰撞检测,剔除与环境中的障碍物发生碰撞的轨迹。

    • 稳定性检查:通过动力学模型评估轨迹的稳定性,剔除可能导致机器人失稳的轨迹。

    • 可执行性评估:根据任务要求(如时间限制、能耗等)评估轨迹的可执行性,剔除不符合要求的轨迹。

    安全筛选器的核心目标是快速且高效地评估所有候选轨迹的安全性,确保所选轨迹既能满足任务需求,又能保证安全性和稳定性。

    4.3.3 异常恢复与在线微调机制

    在动态环境中,机器人在执行任务时难免会遭遇各种异常情况,如传感器故障、环境变化或不可预见的障碍物。为了确保机器人在这些情况下能够继续有效执行任务,异常恢复和在线微调机制显得尤为重要。异常恢复机制旨在实时修正轨迹,保证机器人能在出现异常时快速恢复任务执行。

    1. 异常恢复的理论框架

    异常恢复机制的目标是通过实时监控与检测,快速识别异常情况并调整轨迹。常见的异常包括传感器故障、机器人与障碍物发生碰撞或环境变化引发的误差等。为了应对这些异常,恢复机制通常采用以下策略:

    • 实时监控与检测:通过传感器数据和环境变化实时监控机器人的状态,并检测潜在的异常。一旦发现异常,立即采取措施进行恢复。

    • 局部修正:采用局部优化算法对当前轨迹进行修正。例如,基于模型预测控制(MPC)的方法可以在异常发生时,通过计算新的控制输入来修正轨迹。

    2. 在线微调机制

    在线微调机制的目的是在执行过程中根据实时反馈数据对生成轨迹进行微调。具体步骤包括:

    • 实时感知数据更新:通过传感器实时更新环境数据,判断是否存在新的障碍物或环境变化。

    • 轨迹再规划:在感知数据更新后,使用局部轨迹优化方法对当前轨迹进行微调。例如,可以使用实时优化算法对轨迹进行局部修正,确保机器人始终沿着优化后的轨迹执行。

    • 执行反馈:通过反馈控制机制,调整机器人的运动,确保其始终沿着优化后的轨迹执行。

    在线微调机制确保了机器人能够适应动态变化的环境,并在面临突发情况时迅速恢复任务执行。

    5 扩散与概率运动规划实战配方

    在现代机器人控制与路径规划任务中,扩散模型与概率运动规划方法已经展现出了强大的能力,尤其是在复杂且动态的环境中。通过合理的模型结构设计、损失函数的构建以及训练策略的选择,可以显著提升机器人在实际环境中执行任务的性能与鲁棒性。本章将深入讨论如何结合扩散模型与概率运动规划方法,尤其是如何设计合适的损失函数、正则化项、训练策略以及多目标优化与对抗性训练方法,以提升模型的效果和可靠性。

    5.1 模型结构细节与损失设计

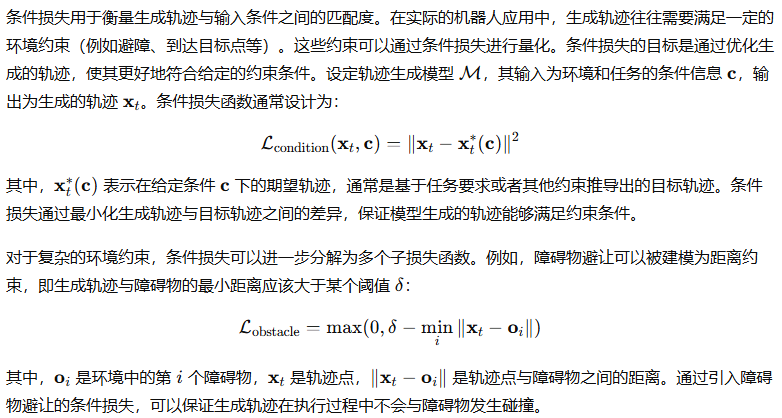
    在扩散模型与概率运动规划中,模型结构的设计与损失函数的优化直接影响轨迹生成的质量和执行效果。生成轨迹的优化过程通常需要在多种约束条件下进行,同时确保轨迹具有平滑性、物理可行性与安全性。设计合理的损失函数能够帮助模型在训练过程中有效地学习如何生成高质量的轨迹。

    5.1.1 条件损失、重建损失与正则化项

    条件损失(Conditional Loss)
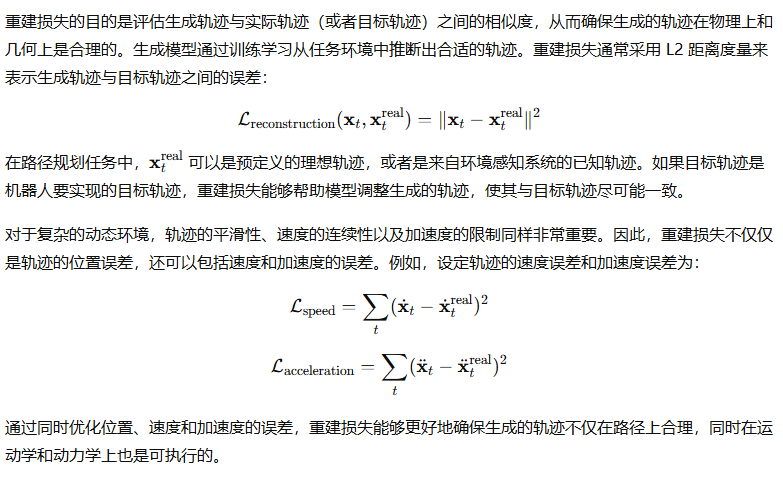
    重建损失(Reconstruction Loss)
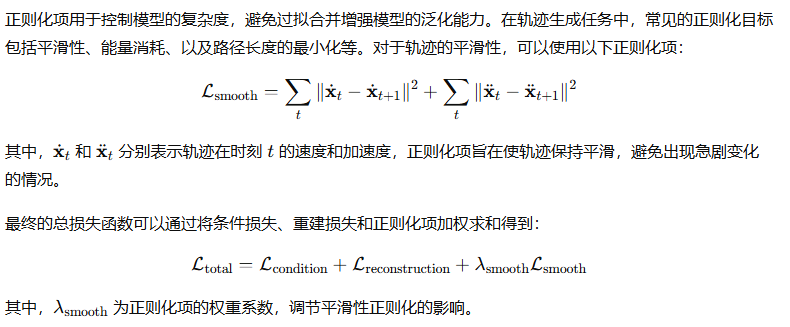
    正则化项(Regularization Term)
    5.1.2 多目标与对抗性数据的训练策略

    多目标优化(Multi-Objective Optimization)

    在实际的轨迹规划任务中,机器人往往需要在多个目标之间进行权衡,例如最短路径、最低能量消耗和最快时间等。多目标优化的目标是同时考虑多个目标函数,使得生成的轨迹能够在多个方面达到最优。为此,损失函数通常被设计为多个目标函数的加权和。例如,对于路径长度、能量消耗和时间最短的优化问题,总损失函数可以写作:
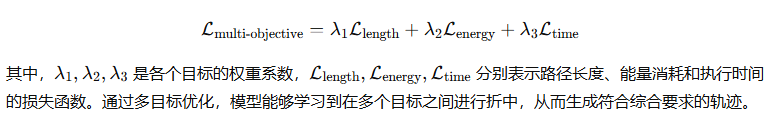
    对抗性训练(Adversarial Training)

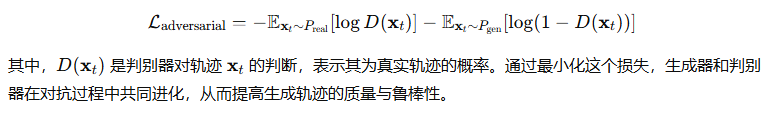
    对抗性训练是一种通过引入扰动数据来提升模型鲁棒性的方法。在轨迹生成任务中,模型可能会受到各种扰动的影响,例如传感器误差、环境变化或未建模的动态因素。对抗性训练的基本思想是训练一个生成器(如扩散模型)和一个判别器,通过博弈式优化使得生成器生成的轨迹更加鲁棒。

    在轨迹生成的对抗性训练中,生成器的目标是生成逼真的轨迹,而判别器的目标是区分真实轨迹与生成轨迹。通过对抗性训练,生成器能够在面对各种扰动时生成更鲁棒的轨迹。对抗性损失可以定义为生成器与判别器之间的博弈损失:
    5.2 训练数据管线与数据增强技巧

    在扩散模型与概率运动规划的训练中,数据管线的构建和数据增强方法的设计对于模型的性能和泛化能力至关重要。训练数据不仅需要覆盖任务空间中的典型轨迹,还需充分考虑边缘场景和稀有情况,以保证模型在动态复杂环境中具有鲁棒性。本节将深入推导训练数据构建与增强方法的原理,分析示范数据的合成、质量控制机制,以及稀有场景的采样增强与权重重校正的理论基础和实现方法。

    5.2.1 示范数据的合成方法与质量控制

    示范数据是训练生成模型的核心,它为模型提供了目标轨迹的参考。示范数据的构建通常依赖于以下两种来源:一是通过机器人控制器生成的高质量轨迹,二是通过仿真环境或专家演示获得的轨迹。为了保证训练数据的有效性,需要对示范数据进行严格的质量控制和合理的合成。

    示范数据的合成方法
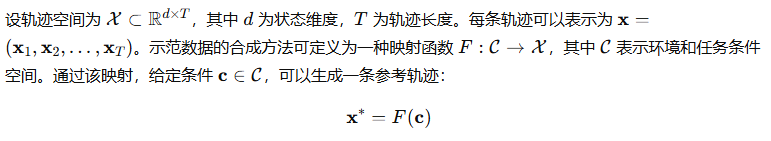
    在实际构建过程中,常用方法包括:

    1. 控制器生成:使用已知控制器(如 MPC、RRT* 或优化控制器)在不同任务和环境条件下生成轨迹。此方法保证轨迹满足动力学约束、碰撞约束以及任务约束。

    2. 仿真采样:通过物理仿真环境生成轨迹,可以在多种初始条件和扰动下采集轨迹数据,确保数据分布覆盖真实环境的多样性。

    3. 专家演示:通过人工操作或远程控制机器人生成示范轨迹,能够在复杂环境下捕捉非线性决策策略。

    质量控制机制

    示范数据的质量直接影响模型训练效果。质量控制的核心目标是保证轨迹的可执行性、稳定性以及对任务的适应性。具体措施包括:
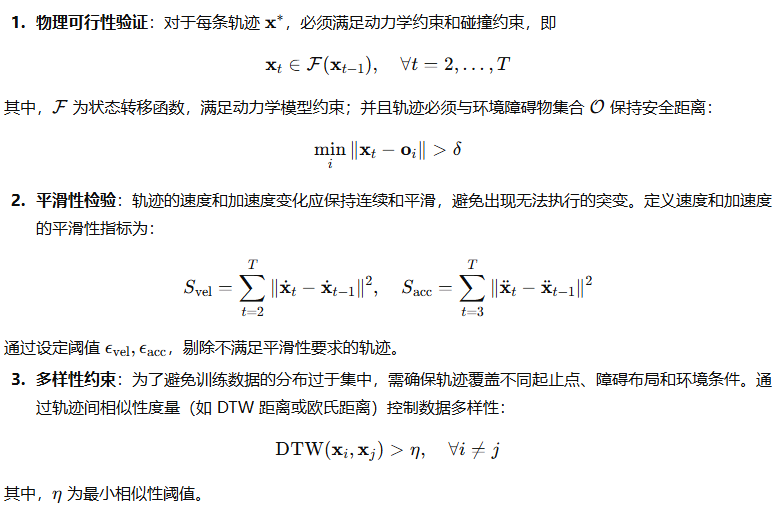
    通过以上质量控制机制,示范数据不仅满足物理约束和任务要求,还保证了数据的多样性,为生成模型的训练提供了稳定可靠的基础。

    5.2.2 稀有场景的采样增强与权重重校正

    在实际环境中,一些极端或稀有场景的出现频率低,但其对机器人安全和任务完成具有关键影响。因此,需要设计数据增强方法以提高模型在稀有场景下的鲁棒性,并通过权重重校正确保训练过程的有效性。

    稀有场景采样增强
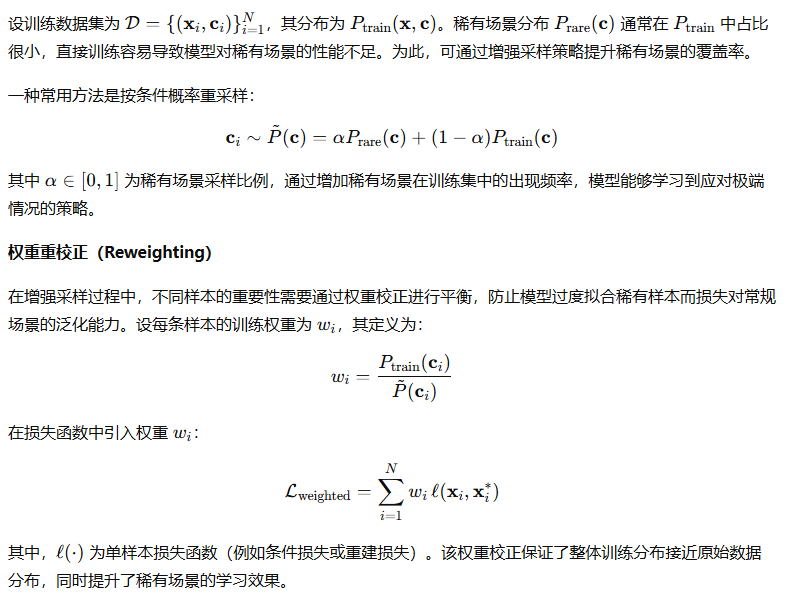
    通过稀有场景采样增强和权重重校正,可以系统性地改善模型在极端或边缘条件下的表现,同时保持对常规场景的高效泛化能力。这一策略在机器人运动规划中,尤其在动态复杂环境和高风险任务下具有重要作用。

    5.3 评测指标与破坏性测试模板

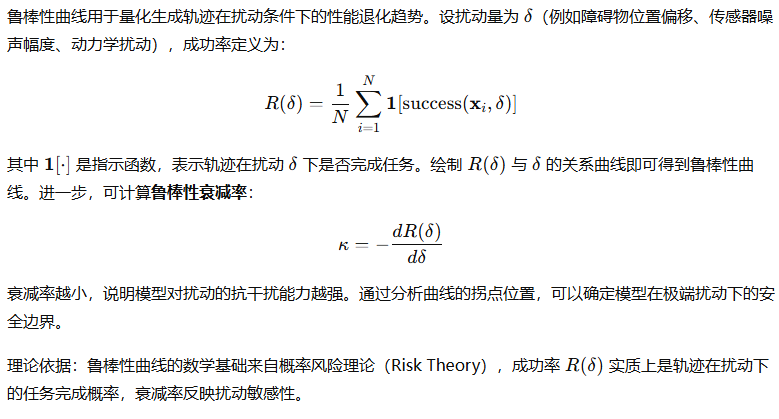
    在扩散模型与概率运动规划中,仅仅依靠训练损失的下降和直观轨迹效果并不能全面衡量模型的能力。必须建立科学的评测指标和破坏性测试模板,对模型在复杂、动态及极端环境下的性能进行严格量化。评测体系应包括多样性度量、鲁棒性曲线、失败分类、可重复性实验卡与对比基线设计,以确保评估结果既精确又可复现。


    5.3.1 多样性度量、鲁棒性曲线与失败分类

    轨迹多样性度量

    轨迹多样性不仅衡量模型生成多个候选轨迹的变化范围,也反映了模型在面对不确定环境时的选择余地。设生成轨迹集合为:
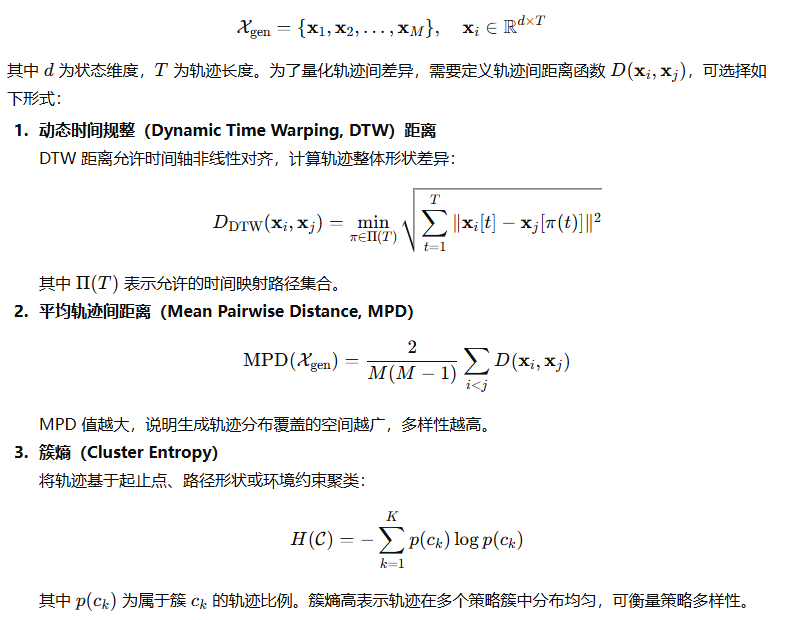
    理论依据:多样性度量的目标是避免模式坍缩(mode collapse),确保生成模型不会在训练集中仅学习有限的轨迹模式。这对动态环境适应和极端场景应对至关重要。


    鲁棒性曲线

    失败分类

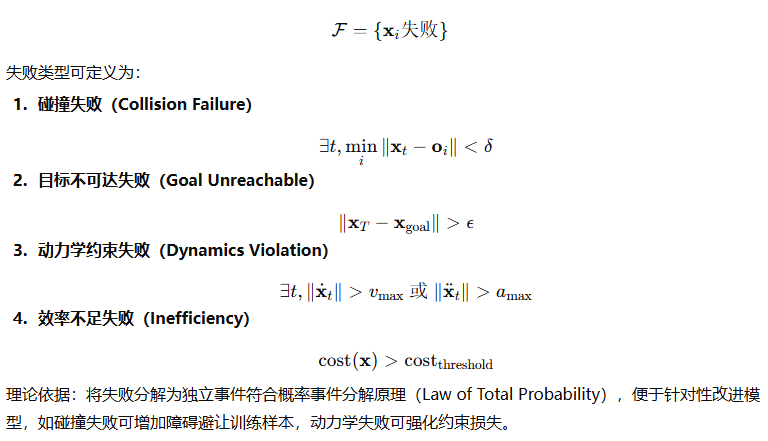
    在破坏性测试中,仅统计成功/失败是不够的,需要进一步对失败类型进行分类。设失败事件集合为:

    5.3.2 可重复性实验卡与对比基线设计

    可重复性实验卡
    实验卡是科学实验标准化的实现工具,确保每次实验可复现。内容包括:
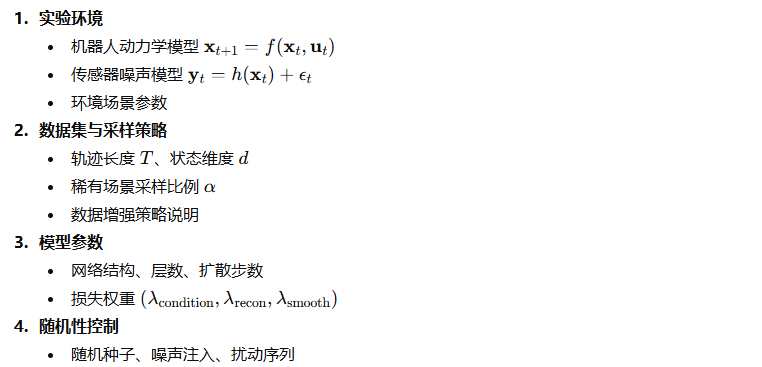
    理论依据:实验可重复性依赖于确定性控制理论(Deterministic Control),通过固定初始条件和扰动序列,确保实验结果可复现。


    对比基线设计

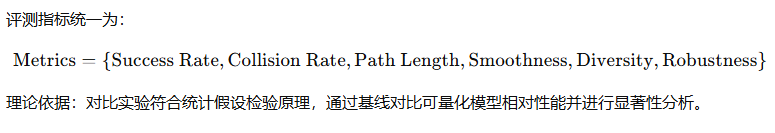
    评估扩散轨迹生成模型需设计合理的对比基线,包括:

    1. 经典规划算法

      • RRT、PRM、MPC

      • 用于基线性能对比,如规划速度、成功率、路径长度

    2. 生成模型基线

      • CVAE、GAN轨迹生成方法

      • 对比生成多样性和轨迹质量

    3. 随机策略基线

      • 随机采样生成轨迹

      • 对比模型相对于随机探索的优势

    Meta-World环境实战解析:pick-place-v2中的状态观测与动作控制 本文深入解析了Meta-World中pick-place-v2环境的强化学习实战要点。文章详细拆解了39维状态观测向量的构成与意义,包括机械臂末端、物体位置及目标坐标,并揭示了默认部分可观测设置的潜在影响。同时,阐述了4维动作空间的控制逻辑与奖励函数的分阶段设计,为训练高效稳定的抓放策略提供了核心指导与实用调优技巧。 阅读详情

    相关推荐

    kaggle——信用卡欺诈检测项目实战

    笔记第一步:了解题目,确定任务第二步:场景分析第三步:数据预处理看是否有缺失值查看样本类别分布数据不均衡解决办法数据值标准化/归一化第四步:特征工程1)查看特征分布情况,把不同类别下特征分布相差不大的特征删除掉2)特征缩放第五步:模型训练处理不平衡样本交叉验证求取最好的模型参数第六步:模型评估使用下采样数据训练与测试使用下采样数据训练与测试(不同的阈值对结果的影响)使用下采样数据训练,原始数据进行测试原始数据进行K折交叉验证使用原始数据进行训练和测试查看ROC曲线逻辑回归阈值选择过采样总结 第一步:了解题目

    weixin_45942265的博客 1万+

    条件变分自编码器CVAE

    转自:https://zhuanlan.zhihu.com/p/25518643 上一期探讨了变分自编码器模型(VAEs),本期继续生成模型的专题,我们来看一下条件概率版本的变分自编码器(CVAEs)。(对应的,另一类生成模型GANs也有条件概率版本,称为CGANs。) VAE回顾 VAE的目标是最大化对数似然函数 其中, 由于KL散度非负,对数似然函数的变分下界即为...

    lrt366的博客 8051

    深入理解光流法外推雷达回波

    背景介绍 鉴于本人实在太过疲惫和劳累,一些简单的便于理解的废话就不在记录,耗费两天时间研究了一下光流法,本帖用于记录学习过程中源码的难点细节。 使用光流预测的核心有两个利用多张连续回波图像(变分)或者相邻两张回波图(交叉相关,LK等)计算出光流场(速度矢量场),之后利用半拉格朗日方法进行外推。 半拉格朗日方法 三时间步半拉格朗日方法,其核心公式如下 但这个有点难理解,但看一维的图就很好理解 它的核心就是迭代求Am(位移矢量),如果理解困难的话,其实质上就是通过未来迭代(猜)出当前时刻的Am找到过去的假设

    weixin_44695861的博客 6036

    探索CVAE-GAN-zoos:PyTorch初学者的生成模型乐园

    探索CVAE-GAN-zoos:PyTorch初学者的生成模型乐园 去发现同类优质开源项目:https://gitcode.com/ 在深度学习的世界中,生成对抗网络(GANs)和变分自编码器(VAEs)是两个强大的工具,它们可以创造出逼真的图像、音频和其他数据。现在,有一个名为的开源项目,将这两个模型集合在一起,为Python和PyTorch新手提供了一个实践平台。本文将详细介绍该项目的核心概念...

    gitblog_00042的博客 489

    CRISPR筛选全流程指南:从文库构建到数据分析实战

    功能基因组学研究需要高效解析基因型与表型的关联,高通量筛选技术是其中的关键工具。基于CRISPR系统的筛选方法通过大规模sgRNA文库扰动基因功能,结合慢病毒递送和测序分析,能够系统鉴定影响细胞增殖、耐药、病毒感染的候选基因。与RNAi或化学小分子筛选相比,CRISPR筛选具有覆盖全基因组、脱靶率低、信号清晰等优势,已广泛应用于药物靶点发现、合成致死和免疫治疗机制研究。本文围绕实验设计与操作中的核心要点展开,涵盖文库扩增、病毒滴度控制、MOI把握、筛选模式选择以及基于MAGeCK的sgRNA丰度分析,并针对

    weixin_31188927的博客 290

    科研党福音:如何用Zotero+Paper Agent打造你的AI论文速递系统(附详细配置教程)

    本文为科研工作者提供了一套利用Zotero和开源工具Paper Agent构建自动化AI论文速递系统的详细教程。该系统能基于用户在Zotero中的文献库智能学习研究兴趣,每日自动从arXiv等平台筛选、下载并深度解读最相关的前沿论文,生成个性化日报,实现从被动接收到主动精准获取的知识工作流重塑。

    kite3的博客 519

    卡内基梅隆大学开源:图神经网络和多样性采样的联合3D跟踪和预测

    作者 介绍 3D多对象跟踪(MOT)和轨迹预测是目前3D感知系统中的两个关键组件,需要对多主体交互进行精确建模。我们假设将两个任务统一在一个框架下以了解代理交互的共享特征表示是有益的。为了评估此假设,作者提出了3D MOT和轨迹预测的统一解决方案,其中还合并了两个其他新颖的计算单元。首先,我们通过引入图形神经网络(GNN)来提出一种功能交互技术,以捕获多个代理相互交互的方式。G...

    图像算法Imalg的博客 1455

    温升试验详解

    温升试验是电子设备可靠性验证的重要手段,用于评估器件在正常工作或极限条件下的热稳定性。试验通过测量器件表面或关键点温度与环境温度的差值(ΔT),判断是否存在过热风险。主要依据行业标准,采用热电偶、热像仪等设备测量稳态温度。热阻分析可建立温升与功耗的关系,指导器件选型、PCB热设计和散热结构优化。典型应用包括电源模块和LED电路测试。温升试验通过系统性热分析,能有效提升产品在高负载、高温环境下的可靠性和安全性,对现代小型化、高密度电子设备尤为重要。

    硬核科技 1333

    CVAE-GAN:通过不对称学习生成细粒度图像

    摘要 Abstract 我们提出了可变的生成对抗网络,一个大体上包含一个采用生成式对抗网络的可变自动编码器

    大烤翅的博客 2135

    雷达参数的设置

    采样率又可以叫做采样速率或者,顾名思义就是每秒采集的次数。该值越高,单位时间内对信号的采集越多,采样率的单位可以用Hz或者sps表示(sps是采样率,是每秒采样点的数量,sp表示采样点数),一般1sps=1Hz。采样时间是采样点数和采样周期的乘积得到的结果。假设实际采样率为4560ksps,采样点数为256,那么采样周期为1/4560(ms),那么ADC的采样时间就为256*(1/4560)(ms)=0.056ms=56微秒。

    qq_50974341的博客 1914

    第三篇:NVIDIA cuOpt Python API 详解:LP、QP、MILP 建模与求解,附核心术语名词解释

    NVIDIA cuOpt是一款GPU加速的优化求解库,支持LP、QP、MILP和路径优化问题。本文详细介绍了其Python API使用方法,包括核心类Problem的变量定义、约束添加、目标设置和求解配置,并提供了术语解释。cuOpt通过GPU并行计算大幅提升大规模优化问题的求解效率,支持多种求解算法和参数配置,适用于需要高性能计算的优化场景。安装方式包含pip和Docker两种,验证安装后即可快速开始建模求解。

    算法工程师 237

    探究CVAE(条件自编码) Condition GAN (条件GAN) 和 VAE-GAN模型之间的区别之程序入口函数

    三个程序的入口地址: main函数() 程序运行的命令是: CUDA_VISIBLE_DEVICES=0 python main --gan_type F_GAN import os from CGAN import CGAN from CVAE import CVAE from F_GAN import F_GAN from utils import check_folde...

    YYLin 1115

    DISM进行系统修复,进度条卡在63.2%的解决方法

    一时用不了软件,安装修复的时候也出现问题 DISM一直卡在63.2%,等了好久时间,直接强制退出寻找最终的解决方案

    码农研究僧的博客 1万+

    低温ECR-MOCVD生长(002)GaN:椭偏仪测厚与电学性能

    本研究用ECR-MOCVD在Si(111)和蓝宝石衬底上低温生长GaN薄膜,蓝宝石1.0SCCM、2h样品呈完全(002)择优取向,椭偏仪测厚32.81nm,迁移率10.42cm²/(V·s)。文章梳理了生长温度、TMGa流量与生长时间对结晶取向、膜厚、粗糙度、光学带隙和电学性能的影响。

    Flexfilm_的博客 403

    Devexpress16.2.6破解工具

    Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

    NTscan扫描工具

    ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

    【第84期】过拟合欠拟合与复杂度对照的实验与排查

    系列:《从小白到 AI 大模型开发工程师的进阶之路》 技术点:AI-0306 过拟合与欠拟合 主人公:小蓝伞 前置:AI-0302 本期产出:学习曲线小蓝伞用越来越高次的多项式拟合一条带噪曲线,训练误差继续下降,但这不能说明他更接近真实关系。本期固定训练样本与噪声,只改变多项式次数,比较对训练点和无噪参考曲线的误差,并区分验证曲线与学习曲线。教学情境用来组织问题,下面的执行数据来自构造实验。

    qq_36085846的博客 204

    贝叶斯统计 [韦来生编]

    贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

    小批量训练的JAX机器学习

    本文介绍基于BFGS的小批量训练算法,针对全批量方法在高样本量下计算复杂度高的问题,结合JAX的自动微分与高效计算,实现快速收敛。通过optimtool库中的改进的bfgs优化器与小批量策略,支持分类与回归任务,具备早停机制与灵活监控选项,显著提升大规模机器学习训练效率。

    林景的博客 144

    新品快讯 | ROHM支持GaN高频开关的TP-PFC控制器IC

    另一方面,传统的TP-PFC控制技术广泛使用MCU,但对于小型电源设备而言,除了功耗、电路规模和成本方面的挑战外,如何实现针对GaN HEMT高频开关的控制也成为亟需解决的难题。全球知名半导体制造商ROHM(总部位于日本京都市)宣布,开发出有助于实现小型高效率AC-DC电源的Totem Pole PFC*1(图腾柱PFC,以下简称“TP-PFC”)控制器IC“BM85060FV”,其特点是可在支持GaN HEMT*2高频开关的MHz频段工作。GaN(氮化镓)是一种用于新一代功率元器件的化合物半导体材料。

    ONEYAC唯样的博客 235

    从认识人工智能到理解机器学习:我的 AI 入门第一课

    正式开始学习人工智能之前,我对 AI 的认识其实比较模糊:知道 ChatGPT、知道大模型,也知道现在很多岗位都在谈 AI,但如果有人问我“人工智能到底是什么”“机器是怎么学会识别一只猫的”,我未必能从头到尾讲清楚。上午的课程更偏向行业全景:人工智能的发展、研究方向、NLP、岗位分工、学习路线和 AI Coding 工具。下午的课程更偏向技术基础:机器学习的原理、有监督学习、深度学习、模型训练和评估方法。

    chh563的博客 580

    机器学习基础|监督学习、标签、回归

    网约车预估等待时长依赖监督学习中的回归任务。平台利用历史订单数据,以司机实际到达耗时为标签,通过上车点、时间、运力、路况等特征训练模型。模型不断优化预测值与真实耗时的误差,最终对新订单输出连续的预估等待时间,实现精准预测。

    weixin_43971465的博客 281

    Hugging Face:成为机器学习界的“Github”

    以下文章来源于OneFlow,作者OneFlow社区五年前,AI领域的知名研究者Andrej Karpathy发文称,传统人工编程属于“软件1.0”,“软件2

    2601_96798011的博客 156

    机器学习——混淆矩阵(待更新)

    二元: true表示真实==预测,positive表示预测值=1.

    m0_61175448的博客 179

    Spark06_MLlib机器学习

    本文是《PySpark 从入门到实战》系列收官篇,带你用 Spark MLlib 走通机器学习全流程:从三要素与 7 步标准流程讲起,剖析 KNN、朴素贝叶斯、决策树三大算法原理,再以 KNN 手写、垃圾短信分类、决策树分类、逻辑回归鸢尾花(准确率 96.67%)、K-Means 聚类(轮廓系数 0.7345)五个案例落地,最后详解 TF-IDF 文本特征与余弦相似度。全文代码可直接运行,适合有 RDD 与 Spark SQL 基础的开发者快速上手。

    2301_80420058的博客 484

    LoRA的低秩数学与QLoRA实现

    本文系统解析了LoRA及其进阶版QLoRA在十亿参数模型微调中的高效机制。通过低秩假设,将权重更新量ΔW近似为低秩矩阵积,显著压缩可训练参数与显存占用;QLoRA进一步将基座模型量化至4比特(NF4),结合双重量化与分页优化器,实现65B模型单卡微调。文章详解了B初始化为零、缩放系数α/r设计、挂载位置选择等关键实操细节,并给出可运行代码。实践表明:4比特基座+高精度LoRA在多数任务上媲美全参微调,且训练效率极高。超参方面,r不宜过大,学习率需上调,数据质量重于数量。最后强调:LoRA适用于风格适配与领域

    2601_96733043的博客 344

    AI小白入门|无监督学习到底是什么?

    很多新手看完无监督学习的定义只会死记硬背。本文避开复杂公式,从真实业务场景切入,对比监督学习,讲清楚无监督学习的核心价值、适用场景、底层逻辑和容易踩坑的认知误区,帮你理解它在机器学习链路里的定位。

    weixin_43971465的博客 206

    SVM支持向量机通俗解析:找到机器学习的“最优分界线”

    一、爆款钩子:同样是画分界线,为何SVM能成为机器学习的“王者选手”?做机器学习的人,几乎都绕不开一个问题:如何给混乱的数据“分家”?有人用逻辑回归,有人用KNN,但有一个算法

    2601_96798737的博客 172

    机器学习03,端到端02

    个人笔记

    qq_59247073的博客 296

    GaN 动态导通电阻测试专题:电流崩塌从哪来,测量窗口怎么选

    但器件装到实际电路上跑一段时间,或者用双脉冲台架模拟开关工况再测导通压降,数值往往明显高于手册静态值,而且关断应力越强(母线电压越高、应力保持越久),抬升越明显;:使用钳位电压探头,把示波器通道的工作区间限制在低电压区(常见做法是钳位在 1.5V 附近的导通压降区),应力高压段由钳位电路吸收,导通段以高分辨率采样。台架搭建相对简单,是器件表征最常用的方案。双脉冲台的难点不在发脉冲,而在采样:漏源电压要从几百伏的应力电平瞬间跌落到毫伏至伏级的导通压降,示波器单一量程难以兼顾"扛住高压"和"分辨毫伏"。

    Namisooft的博客 278
    上一篇: 机器人技术与智能系统的工程化与应用 第三章 视觉—语言—动作(VLA)模型专题
    下一篇: 机器人技术与智能系统的工程化与应用 第六章 视频示范采集与自动标注体系
    VectorShift
    博客等级 码龄1年 1844粉丝 1109原创
    评论
    成就一亿技术人!
    拼手气红包6.0元
    还能输入1000个字符
     
     条评论被折叠 查看
    添加红包

    请填写红包祝福语或标题

    个

    红包个数最小为10个

    元

    红包金额最低5元

    当前余额3.43元 前往充值 >
    需支付:10.00元
    成就一亿技术人!
    领取后你会自动成为博主和红包主的粉丝 规则
    hope_wisdom
    发出的红包

    打赏作者

    VectorShift

    你的鼓励将是我创作的最大动力

    ¥1 ¥2 ¥4 ¥6 ¥10 ¥20
    扫码支付:¥1
    获取中
    扫码支付

    您的余额不足,请更换扫码支付或充值

    打赏作者

    实付元
    使用余额支付
    点击重新获取
    扫码支付
    钱包余额 0

    抵扣说明:

    1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
    2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

    余额充值