机器人技术与智能系统的工程化与应用 第三章 视觉—语言—动作(VLA)模型专题

视觉语言动作模型(VLA)核心技术解析与应用实践 视觉语言动作模型(VLA)作为具身智能的核心技术,通过Transformer架构实现视觉、语言与动作的跨模态对齐。该技术解决了时空一致性、语义鸿沟和动作量化等关键问题,在机器人控制、智能交互等领域展现出巨大潜力。实验表明,完全统一Transformer架构在推理效率上具有优势,减少70%特征转换开销。工程实践中,数据增强和混合精度训练等技巧可显著提升模型性能。当前VLA模型已能实现92.4%的桌面整理成功率,但在处理模糊指令方面仍需改进,引入人类反馈强化学习(RLHF)是重要优化方向。 阅读详情

系列文章目录

第1章 摘要与阅读指引

第2章    架构范式与模块化设计

文章目录

目录

​编辑

系列文章目录

文章目录

3 视觉—语言—动作(VLA)模型专题

3.1 跨模态表示的构建方法(总体框架与目标)

3.1.1 视觉与语言对齐技术

3.1.2 时序与动作条件化的表达方式

3.1.3 语义层次化表示与任务接口约定

3.2 指令到动作的流水线设计

3.2.1 自然语言解析与指令抽象化

1) 解析过程的结构化设计

1.1 语言模型与句法分析

1.2 语义理解与意图提取

2) 任务表示与指令抽象化

3.2.2 任务规划与低层控制的分工契约

1) 任务规划

1.1 基于图的任务规划

1.2 规划算法的推导与实现

2) 低层控制分工

2.1 低层控制与高层指令的映射

2.2 低层控制模块的设计

3.2.3 交互式纠错与意图澄清机制

1) 交互式纠错机制

1.1 任务失败检测与纠错推导

2) 意图澄清机制

2.1 意图澄清的实现推导

3.3 可扩展性与共享策略库

3.3.1 模块化技能库的设计要点

1) 模块化设计原则

1.1 功能独立性与高内聚性

1.2 接口标准化与低耦合性

1.3 可组合性与灵活性

1.4 状态管理与上下文感知

2) 模块化设计的数学描述

3.3.2 版本控制、兼容性与回滚策略

1) 版本控制策略

2) 兼容性管理

2.1 兼容性测试与验证

2.2 回滚策略

3.3.3 共享基线与互操作性规范

1) 共享基线的定义与实现

1.1 基线设计要点

1.2 基线实例

2) 互操作性规范

2.1 通信协议标准

2.2 模块兼容性协议


3 视觉—语言—动作(VLA)模型专题

视觉—语言—动作(VLA)模型的目标是将视觉感知、语言指令与动作生成在统一的概率/表征框架下耦合,使机器人能够从异质模态输入推理出连贯、可执行且语义一致的动作序列。为实现这一目标,需要构造(1)能够实现模态间语义对齐的共享表征;(2)能捕捉时序依赖并以条件方式生成动作的时序模型;(3)基于语义层次为任务分解与接口提供形式化约定的层次化表示。本章在形式化概率框架下系统说明跨模态表示的构建方法,并在关键处给出逐步推导,以便作为教材中可直接引用的原理章节。


3.1 跨模态表示的构建方法(总体框架与目标)
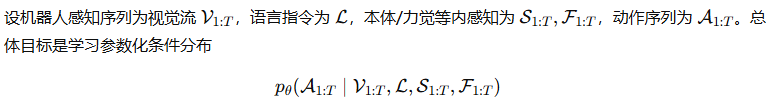
或等价地学习一组可交互的潜在表征 zzz(或分层潜变量)使得动作生成与模态对齐成为高效的下游推断问题。跨模态表示设计应满足三条要求:信息保真(与动作相关的信息尽量保留)、语义可对齐(不同模态在同一语义空间中可比)、条件可分离(高层语义与低阶执行可分离以便层次化控制)。下文依次讨论对齐、时序条件化与语义层次化的具体方法与数学推导。


3.1.1 视觉与语言对齐技术
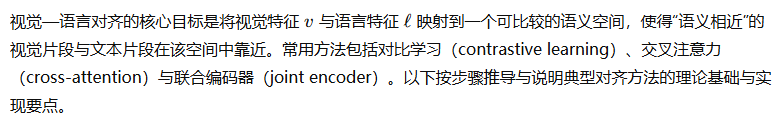
(一)对比学习(InfoNCE / 对齐损失)的推导与实现。
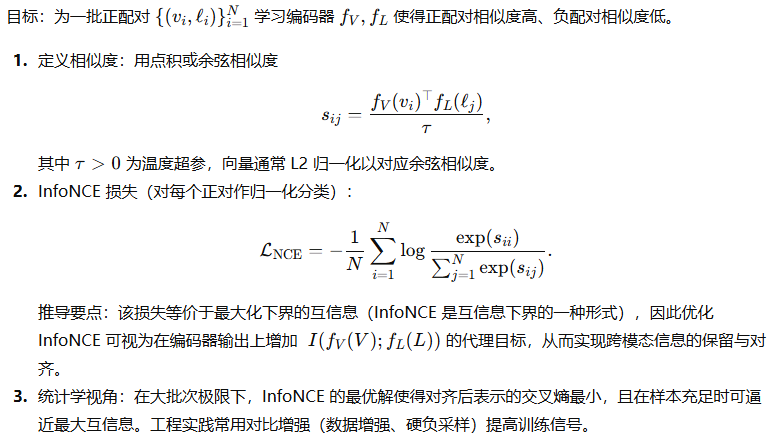
(二)交叉注意力/联合 Transformer 的对齐机制。
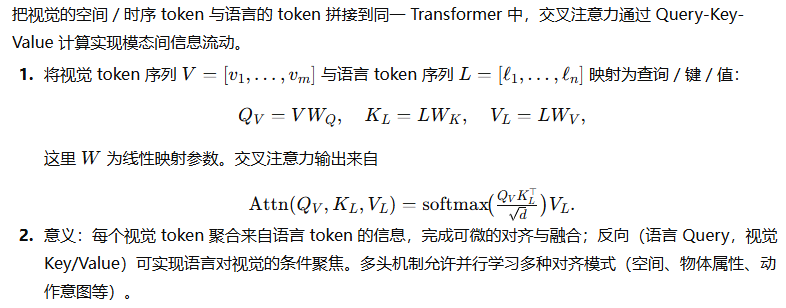
(三)联合表示与对齐正则。
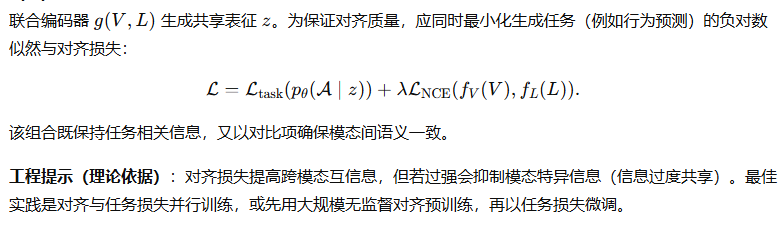

3.1.2 时序与动作条件化的表达方式

动作是时序的—决策依赖历史观测与动作。时序条件化的核心是以合适的概率分解和潜变量模型来表达历史依赖与不确定性,常见路径有自回归建模、条件潜变量序列模型(sequential VAE / state-space models)与条件扩散过程。下面逐步推导关键形式化表达与训练目标。

(一)自回归条件分解(逐步因子化)。
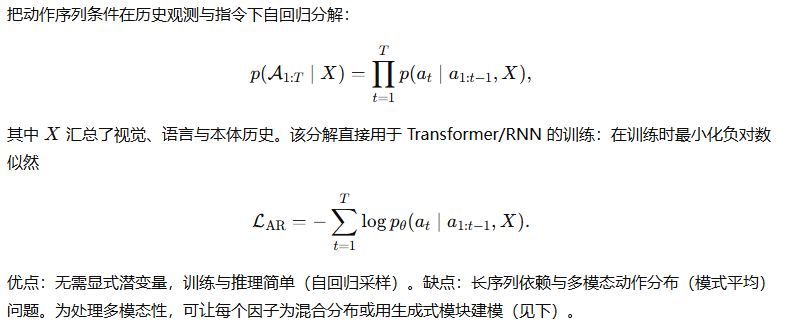
(二)条件潜变量序列模型(时序 VAE / State-Space Model)及 ELBO 推导。
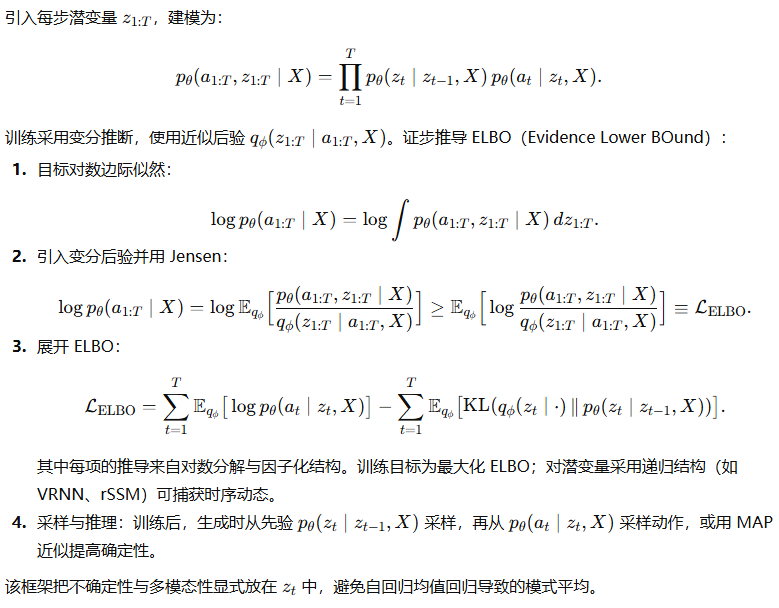
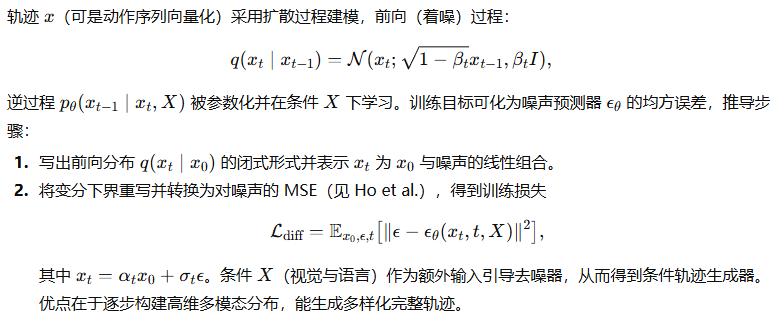
(三)条件扩散模型用于轨迹生成(简化推导)。
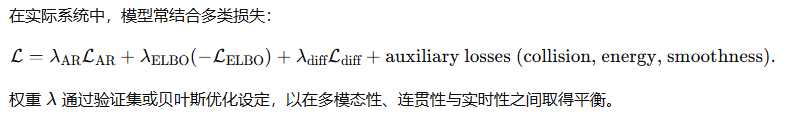
(四)联合训练目标的组合形式。

3.1.3 语义层次化表示与任务接口约定

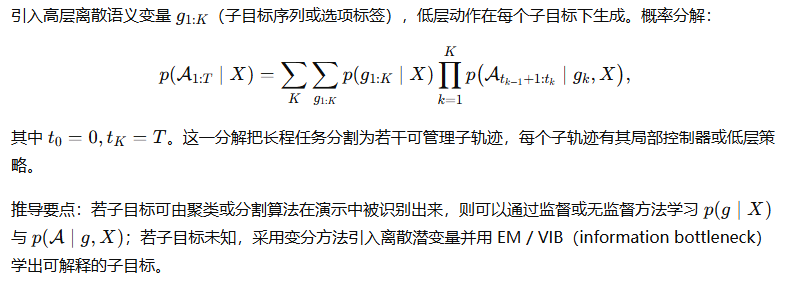
任务通常天然层次化:高层表述目标/意图(semantic goal),中层负责子任务(subgoals / options),低层执行连续控制(motor commands)。构造语义层次化表示既有利于数据效率(高层抽象泛化更好),也便于将学习策略与传统规划/符号方法结合。下文按步骤给出层次化概率模型、接口规范与符号化/接地(grounding)方法。

(一)层次化概率分解与选项框架。
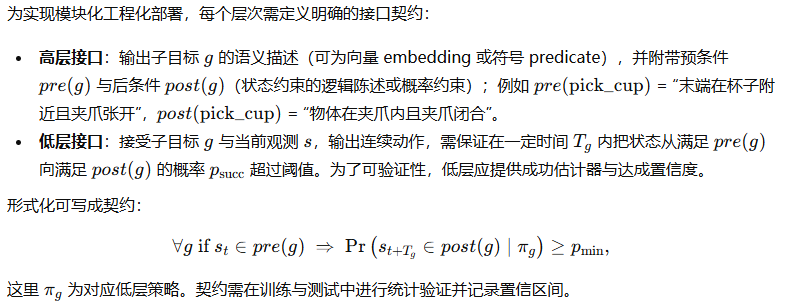
(二)语义接口(contracts)与预条件/后条件。
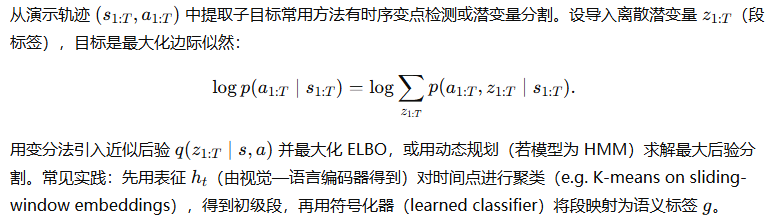
(三)子目标提取:无监督分割与语义聚类的实用推导。
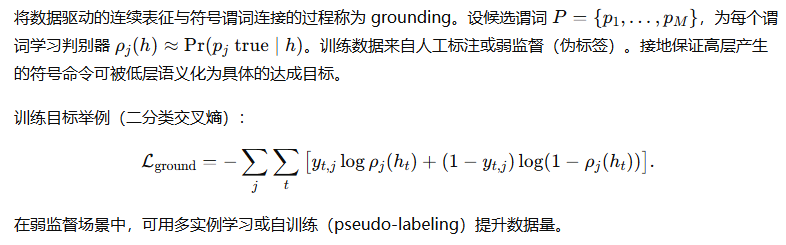
(四)语义与符号化接地(grounding)。
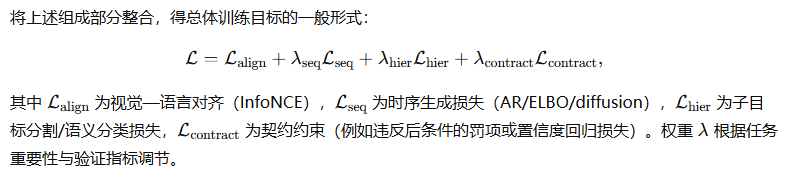
(五)层次化学习的联合目标(整合式损失)。
3.2 指令到动作的流水线设计

在机器人系统中,指令到动作的流水线设计是实现高效和精确任务执行的关键。为了将自然语言指令转化为可执行的动作序列,系统必须具备多个模块的配合,这些模块包括自然语言解析、任务规划、低层控制分工以及交互式纠错与意图澄清机制。本节将详细描述这三个模块的设计原理和实现方法,确保从输入的自然语言指令到输出的具体动作之间能够保持一致性与高效性。


3.2.1 自然语言解析与指令抽象化

自然语言解析是将语言输入转化为机器可理解的形式,是指令到动作流水线的起点。解析的核心任务是将人类语言中的模糊、复杂信息映射为明确的逻辑结构和符号表示。指令抽象化则是通过识别任务中的关键组成部分,转换为任务执行所需的高层目标或操作步骤。

1) 解析过程的结构化设计

1.1 语言模型与句法分析
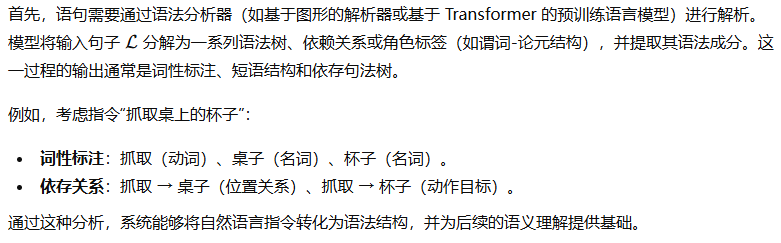
1.2 语义理解与意图提取

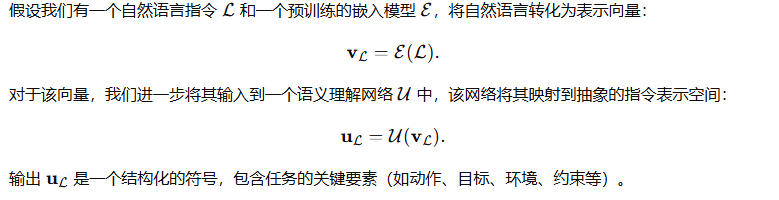
语法分析为后续的语义理解奠定基础。语义理解的目标是从句法结构中提取出指令的实际意图。例如,指令“抓取桌上的杯子”可以拆解为以下几个任务元素:

  • 动作:抓取

  • 目标:杯子

  • 位置:桌子

为了进一步抽象化,系统需要通过词汇的嵌入表示(如词向量、BERT 等)来捕捉不同词语之间的关系,并通过图神经网络(GNN)等模型推理出任务的高级目标和操作。

数学推导:
2) 任务表示与指令抽象化

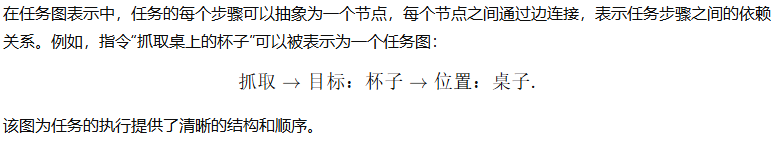
指令的抽象化通过识别和抽取指令中涉及的核心任务元素(如动作、目标、约束等),并将其转化为一个高层次的表示(例如符号化、任务图或约束条件)。这一过程中,系统需要利用语义图(或语义角色标注)将动作与目标之间的关系明确化。

任务图表示:

3.2.2 任务规划与低层控制的分工契约

任务规划和低层控制的分工契约是指在高层任务规划与低层控制之间建立有效的协作机制。任务规划模块负责从高层次的目标生成子任务,并将这些子任务传递给低层控制模块执行。低层控制则负责处理具体的动作生成和执行。

1) 任务规划

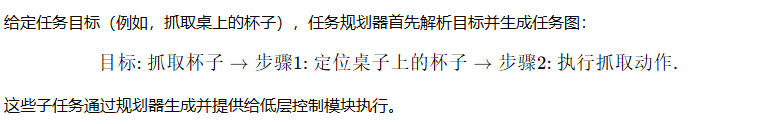
任务规划的目标是将高层目标(如“抓取桌上的杯子”)分解为具体的可执行子任务。任务规划器需要依据任务约束、环境状态和已有知识,制定出执行步骤,并确保步骤间的合理性。

1.1 基于图的任务规划

图规划方法广泛应用于任务规划中。在这种方法中,任务可以表示为图的形式,其中节点表示任务步骤,边表示任务步骤之间的依赖关系。常见的任务规划方法包括基于PDDL(Planning Domain Definition Language)的规划器和基于图搜索的策略。
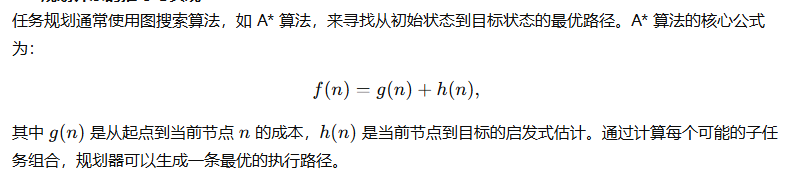
1.2 规划算法的推导与实现
2) 低层控制分工

低层控制是任务执行过程中至关重要的部分,它负责将任务规划器生成的子任务转化为具体的控制指令。低层控制模块涉及对机器人的各类感知输入(如视觉、力觉、本体感觉等)进行实时处理,并根据任务需求生成相应的动作。

2.1 低层控制与高层指令的映射

低层控制与任务规划之间的分工契约体现在任务子任务的分配和执行上。例如,在执行抓取任务时,低层控制需要根据视觉输入(例如,抓取对象的位置)来调整机械臂的轨迹,并在执行过程中确保目标的稳定性和抓取精度。

2.2 低层控制模块的设计

低层控制模块通常包括轨迹生成、力控制、碰撞检测等子模块。轨迹生成模块基于规划任务给出的目标位置信息(如桌上的杯子位置),生成合适的运动轨迹。力控制模块则根据实际抓取中的反馈(如触觉信息),调整抓取力度,以确保杯子不被打翻。


3.2.3 交互式纠错与意图澄清机制

在任务执行过程中,可能会出现意图不明确、环境信息不完备或外部干扰等问题,导致机器人无法准确地执行预定任务。为了保证任务的顺利执行,机器人系统需要具备交互式纠错和意图澄清机制,以便及时调整执行策略,并在必要时向用户请求额外的信息或修正。

1) 交互式纠错机制

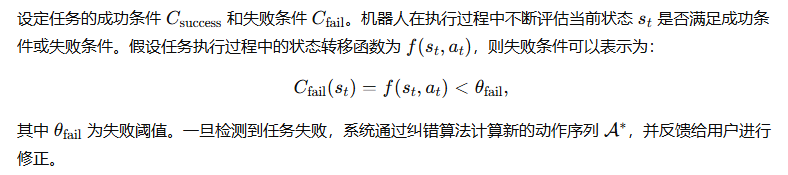
交互式纠错机制的目标是当机器人在执行过程中遇到问题时,能够及时识别并进行修正。常见的纠错方式包括:

  • 任务失败检测:机器人在执行过程中通过传感器(如视觉、力觉等)实时监控任务状态,并通过误差检测算法判断任务是否成功完成。例如,当抓取任务失败时,机器人可以根据目标物体的位置偏差或抓取力反馈检测到任务失败。

  • 错误反馈机制:当检测到任务失败或异常时,机器人能够通过语音或显示器向用户反馈错误,并提出可能的原因和解决方案。

1.1 任务失败检测与纠错推导
2) 意图澄清机制

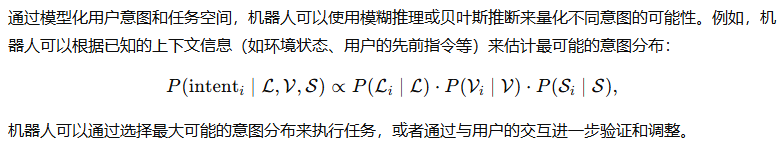
在多轮交互中,用户的意图可能不明确或存在歧义,机器人需要主动澄清用户的意图,以避免误解。意图澄清通常包括:

  • 任务细节询问:当机器人不确定如何执行任务时,它可以通过询问用户来澄清任务细节。例如,用户指示“拿起杯子”,机器人可以询问:“你希望我从桌子的哪个位置拿起杯子?”

  • 多模态反馈:机器人可以结合视觉反馈、语音确认和图形界面等多种方式与用户交互,以帮助澄清任务意图。

2.1 意图澄清的实现推导
3.3 可扩展性与共享策略库

在现代机器人技术中,提升系统的可扩展性和复用性是至关重要的。随着任务复杂性的不断增加,机器人系统需要支持更加灵活和高效的技能调用方式,并能够适应不同任务需求的变化。为了实现这一目标,模块化的技能库设计和共享策略库的规范化至关重要。通过采用合理的版本控制、兼容性管理和互操作性标准,机器人系统能够在不同任务间实现高效的迁移学习和模块复用。本节将详细探讨模块化技能库的设计要点、版本控制与兼容性管理策略以及共享基线和互操作性规范。


3.3.1 模块化技能库的设计要点

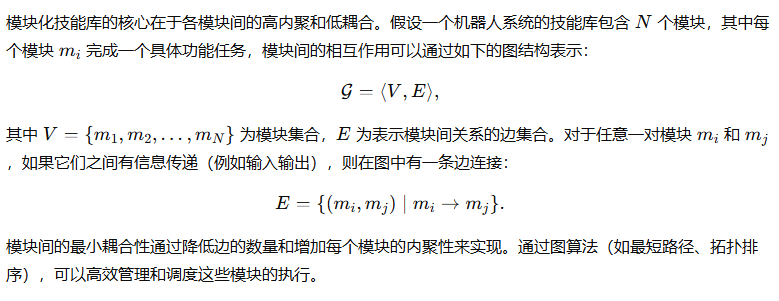
模块化技能库(Modular Skill Library)是为了增强机器人系统的灵活性和可扩展性而设计的核心组成部分。它通过将复杂的任务分解为多个可独立执行的小模块,使得各个模块可以在不同任务之间共享和复用,从而大大提升了系统的效率与可维护性。

1) 模块化设计原则

模块化技能库的设计应遵循以下基本原则:

1.1 功能独立性与高内聚性

每个模块应仅完成一个具体的功能或任务,并具有高度的内聚性。模块的功能应尽可能单一,避免功能耦合。这样可以确保模块的复用性,使得模块能够在不同的任务中高效应用。例如,一个视觉处理模块可以专注于图像预处理,而一个抓取技能模块则可以专注于基于视觉输入进行抓取动作的生成。

1.2 接口标准化与低耦合性

模块之间应通过标准化接口进行交互,以降低模块之间的耦合性。接口应清晰地定义输入和输出的格式、数据类型以及数据流向。通过标准化接口,系统可以方便地进行模块替换和扩展。例如,一个抓取模块可能通过接受目标位置和抓取策略的参数作为输入,并输出控制信号给低层控制器;而视觉模块则提供图像输入和位置信息的输出。

1.3 可组合性与灵活性

模块的设计应具有良好的组合性,允许通过简单的组合多个基础模块来实现复杂的任务。设计时要支持模块的动态加载和卸载,以便根据不同的任务需求灵活调整。比如,在执行一个清洁任务时,机器人可以灵活调用不同的视觉、抓取和路径规划模块。

1.4 状态管理与上下文感知

为了使模块能够在不同的任务场景下发挥作用,必须设计一个有效的状态管理机制,使得模块能够感知并响应环境状态和任务状态的变化。例如,抓取模块不仅需要知道目标物体的位置,还需要理解环境中其他物体的位置以及它们之间的相对关系。

2) 模块化设计的数学描述

3.3.2 版本控制、兼容性与回滚策略

在大规模和长期运行的机器人系统中,版本控制和兼容性管理是确保模块更新、升级和维护能够顺利进行的关键。随着技能库不断扩展和技术的不断演进,管理不同版本的模块以及确保新版本的模块能够与旧版本兼容是非常重要的。

1) 版本控制策略

版本控制策略的核心在于记录模块的历史版本,并确保不同版本之间的差异能够被跟踪和管理。为了确保系统的稳定性和高效性,机器人系统应采用语义化版本控制(Semantic Versioning)策略,具体包括以下内容:

  • 主版本号:当模块发生了不可兼容的变更(例如接口变化或算法更新)时,主版本号加一。

  • 次版本号:当模块增加了新功能或优化,但保持向后兼容时,次版本号加一。

  • 修订号:当模块修复了已知 bug 或进行了小范围的性能优化时,修订号加一。

例如,一个视觉模块的版本可能由 1.2.31.2.31.2.3 升级为 2.0.02.0.02.0.0,其中主版本号的变化表示该版本包含了不兼容的改动,而次版本号的变化表示对已有功能的扩展或增强。

2) 兼容性管理

为了在多个版本之间保持兼容性,系统需要采用接口兼容性测试和数据兼容性验证。兼容性管理的核心任务是确保新版本的模块能够正确地与旧版本的模块协同工作。例如,当引入一个新版本的视觉模块时,系统应验证该模块是否能够正确与现有的控制模块进行数据交换,而不破坏原有功能。

2.1 兼容性测试与验证

兼容性测试可以通过以下方式进行:

  • 单元测试:对每个模块进行独立的功能测试,确保新版本模块能通过单元测试并满足设计要求。

  • 集成测试:在系统集成时测试模块之间的兼容性,特别是在不同版本的模块之间。

2.2 回滚策略

回滚策略的核心是在遇到模块不兼容或出现故障时,能够快速恢复到稳定版本。系统应记录每个模块的版本号和更新历史,并提供一个回滚机制,允许系统将模块切换回先前的稳定版本。回滚策略包括:

  • 自动回滚:当检测到模块故障时,系统可以自动切换到先前的版本。

  • 手动回滚:通过操作控制台或命令行,系统管理员可以手动将模块降级至之前的版本。

回滚策略可通过版本控制系统和历史记录管理来实现。例如,通过 Git 等版本控制工具来管理模块的不同版本,确保模块的历史版本可以随时恢复。


3.3.3 共享基线与互操作性规范

在多机器人系统中,不同机器人之间的协调和协作要求具有良好的互操作性。而在大规模部署时,不同开发团队或不同系统之间的模块共享和兼容性要求进一步提升。因此,制定共享基线和互操作性规范是实现系统间高效协作的基础。

1) 共享基线的定义与实现

共享基线(Shared Baseline)指的是一组共同认可的技术标准和接口协议,它们定义了不同模块和子系统之间的数据交换格式、通信协议和功能接口。共享基线的制定可以确保不同模块和子系统在不同开发环境和任务需求下能够顺利协作。

1.1 基线设计要点

共享基线的设计应确保以下几点:

  • 标准化接口:定义标准化的接口协议,如 ROS 2(Robot Operating System)中的消息传递机制,以便不同模块和机器人之间能够无缝通信。

  • 数据格式统一:定义统一的数据格式和通信协议(如 JSON、Protocol Buffers、XML 等),确保数据能够在不同模块间正确解析。

  • 模块协作规范:规定模块之间如何进行信息交换和控制信号传递,确保模块间的协作不会冲突。

1.2 基线实例

一个典型的共享基线设计可以采用基于 ROS 的框架,其中每个机器人模块都可以通过统一的 ROS 接口与其他模块进行信息交换。例如,视觉模块提供图像数据,控制模块接收图像数据并生成相应的动作指令。所有模块都遵循统一的消息传递协议,从而确保系统的互操作性。

2) 互操作性规范

互操作性规范是指不同机器人系统、不同硬件平台或不同开发团队之间如何实现无缝集成和协作。为了确保互操作性,系统应遵循以下规范:

2.1 通信协议标准

不同机器人系统之间必须采用兼容的通信协议进行信息交换。常见的通信协议包括:

  • ROS 2:为机器人系统提供高效的数据交换机制。

  • MQTT:适用于低带宽和高延迟环境下的消息传递。

  • DDS(Data Distribution Service):一种数据通信中间件,广泛应用于分布式系统中。

2.2 模块兼容性协议

为了确保不同开发团队或不同硬件平台的机器人系统能够兼容,必须制定统一的模块接口协议。这些协议定义了如何通过标准输入输出接口(如传感器数据流、控制指令等)进行协作。

从CLIP到VLA:一文读懂视觉语言动作模型的演进与未来趋势 本文系统梳理了视觉语言动作模型从CLIP到VLA的演进历程,深入剖析了端到端统一、模块化融合及分层规划三大核心架构范式的原理与代表模型。文章探讨了驱动VLA发展的数据与仿真双引擎,并指出了当前在跨模态对齐、物理常识理解及工程化落地方面面临的挑战。最后,展望了世界模型、互联网视频学习等关键突破方向,揭示了VLA作为实现通用具身智能核心技术的未来趋势。 阅读详情

相关推荐

VLA三大工程化范式:视觉-语言-动作耦合的落地路径

VLA(Vision-Language-Action)是具身智能的核心技术栈,本质是构建视觉感知、语言理解与物理动作之间的可靠闭环。其原理并非简单拼接多模态模型,而是围绕信息耦合方式重构模态接口——包括视觉Token化嵌入、分层语义桥接与动作驱动聚焦三种结构化范式。技术价值在于突破端到端方案的延迟瓶颈与语义失真,实现工业级鲁棒性:支持-10℃冷库、强光反光、粉尘等真实场景连续30天稳定运行。典型应用场景涵盖仓储AGV定位、工业机械臂抓取、家用服务机器人指令执行等需毫秒级响应与空间精准理解的任务。本文深入解析

weixin_34203832的博客 348

XR-1:首个真正可工作的机器人VLA模型,打通视觉-语言-动作统一表示

在机器人学和具身智能领域,如何让机器像人一样理解世界并执行任务,一直是核心挑战。传统方法采用模块化设计,将视觉感知、语言理解和动作规划分开处理,导致系统复杂、泛化能力弱且数据需求大。其根本原理在于缺乏一个统一的语义空间来对齐多模态信息。VLA(Vision-Language-Action)模型的技术价值在于,它旨在构建一个端到端的“通才”大脑,能够将视觉观察、语言指令和连续动作映射到同一表示空间,从而实现更自然、更高效的机器人控制。这种统一表示是迈向通用机器人的关键,其应用场景广泛,包括家庭服务、工业装配和

weixin_30352191的博客 321

VLA模型:具身智能的务实技术栈与工程化落地

视觉-语言-动作(VLA)模型是实现具身智能的核心技术,其本质在于打通感知、认知与执行的闭环,使AI系统能基于多模态输入在物理世界中完成真实任务。它不同于纯语言大模型或孤立视觉模型,强调跨模态对齐、物理约束建模与硬件协同。技术价值体现在鲁棒性、实时性与安全可控性上,广泛应用于工业质检、仓储物流、家庭服务等需人机共融的场景。本文聚焦‘务实VLA’——以模块化分层、知识引导+数据驱动、硬件在环验证为三大支柱,构建可部署、可维护、可演进的基础模型体系。

420

一文理清大模型、VLA 岗位差异与技术方向,附高薪岗位推荐

一文理清大模型、VLA 岗位差异与技术方向,附高薪岗位推荐

xxue345678的博客 1580

DeepVision-VLA:解决VLA模型视觉衰减的工程化方案

视觉-语言-动作(VLA)模型是具身智能的核心架构,其本质是将多模态感知转化为物理执行决策。然而在深层Transformer中,视觉token贡献持续衰减,导致动作规划脱离真实场景——这一‘视觉失明’现象已成为工业质检、手术机器人等高鲁棒性场景落地的关键瓶颈。DeepVision-VLA通过VL-MoT框架实现视觉专家特征与LLM深层注意力的动态耦合,并以AGVP策略用动作意图引导视觉聚焦,从原理上保障像素级空间细节向决策层的保真传递。该方案不依赖海量标注或算力堆叠,已在RLBench仿真与Franka真实

weixin_29056701的博客 313

VLA模型工程化实践:从原理到部署,解决机器人手眼协调难题

视觉语言模型(VLM)通过融合视觉与语言信息,实现了对复杂场景的深度理解。其核心原理在于将图像特征与文本语义在统一的高维空间中对齐,从而具备强大的跨模态推理能力。这一技术为机器人赋予了“看懂”并“听懂”指令的潜力,其工程价值在于能够将高层任务指令直接转化为可执行的动作序列。在机器人控制、智能体交互等应用场景中,视觉语言动作模型(VLA)作为VLM的具身化延伸,正成为解决机器人“手眼协调”这一经典难题的关键技术路径。本文聚焦于VLA模型的开源生态、部署门槛与真实场景验证,为开发者提供一份从仿真测试到真机集成的

weixin_30617797的博客 709

从大模型到VLA:一文读懂自动驾驶核心技术差异与高薪岗位

本文详解了大模型在自动驾驶领域的应用,重点解析了VLA(视觉-语言-动作)技术与端到端系统的区别,介绍了业界两种VLA方案:两阶段(大模型+Diffusion)和单阶段(完全基于大模型)。文章提供了大模型研发工程师、端到端/VLA工程师等高薪岗位信息,强调这些岗位围绕大模型、diffusion和数据生成等技术展开,是值得投入的研发方向。

2401_84204207的博客 993

VLA Foundry:面向具身智能体的端到端视觉-语言-动作训练框架

具身智能体(Embodied Agent)是实现机器人自主交互的核心范式,其技术本质在于统一建模视觉感知、语言理解与物理动作三者间的联合表征与协同优化。VLA(Vision-Language-Action)架构为此提供了结构化基础,而流匹配(Flow Matching)作为新兴生成式建模范式,正逐步替代传统回归或分类动作建模,显著提升轨迹连续性与物理合理性。Qwen3-VL等多模态大模型的成熟,进一步为VLA系统提供了高保真跨模态对齐能力。本文聚焦于VLA Foundry这一工程化框架,解析其如何通过单数据

weixin_30907935的博客 304

Pi0 VLA模型商业应用探索:工业质检机器人多模态指令执行系统

本文介绍了如何在星图GPU平台上自动化部署Pi0机器人控制中心镜像,构建工业质检机器人多模态指令执行系统。该系统基于Pi0视觉-语言-动作模型,能够理解自然语言指令,实现如“检查零件表面划痕并分拣”等复杂任务,显著提升工业自动化的灵活性与易用性。

weixin_28922227的博客 957

具身智能实战指南:从VLA模型到机器人控制的技术栈与实现

具身智能(Embodied AI)是人工智能领域的重要分支,它强调智能体通过物理身体与环境进行交互,实现感知、决策与行动的闭环。其核心原理在于构建一个能够整合多模态信息(如视觉与语言)并进行实时决策的“智能大脑”。在技术实现上,视觉-语言-动作(VLA)模型扮演关键角色,它通过编码环境观察与指令,直接输出控制动作,从而赋予机器人执行复杂任务的能力。这类技术正推动机器人、自动驾驶等领域的革新,尤其在需要适应开放环境与未知任务的场景中价值显著。本文聚焦于具身智能的工程实践,详细解析了其技术栈构成,并提供了从仿真

weixin_29043895的博客 316

具身智能大脑实战:从VLA模型到机器人控制的完整开发指南

具身智能作为人工智能与机器人学交叉的前沿领域,其核心在于构建能够理解物理世界、进行任务规划并控制实体行动的智能系统。其基本原理是通过视觉-语言-动作模型建立感知、认知与执行的统一映射,使智能体能在非结构化环境中泛化执行复杂指令。这一技术的核心价值在于将大模型的语义理解能力与机器人的物理交互能力相结合,从而在家庭服务、柔性制造等场景实现自主任务完成。本文以Ego2Robot项目为切入点,深入探讨了如何利用仿真环境与开源工具链,从零搭建一个基于VLA模型的具身智能系统原型,并提供了完整的代码示例与工程实践指南,

weixin_33158887的博客 307

VLA模型:具身智能的视觉-语言-动作融合技术解析与实战

在机器人学和人工智能领域,感知与决策的融合一直是核心技术挑战。传统方法通常采用模块化架构,将视觉感知、任务规划和动作控制分离,但这种方式存在信息损失和误差累积问题。随着深度学习的发展,端到端学习为机器人控制提供了新思路,但面临着安全性和可解释性挑战。VLA(视觉-语言-动作)模型通过结合预训练的视觉-语言基础模型和动作生成模块,实现了从多模态输入到动作输出的直接映射,在机器人操作、自动驾驶等具身智能场景展现出巨大潜力。这种技术架构充分利用了大规模预训练模型的泛化能力,同时通过相对较小的动作头实现高效微调,为

weixin_33794672的博客 381

流模型驱动的VLA在线强化学习:面向真实机器人的动作生成与微调

视觉-语言-动作(VLA)模型是具身智能的核心范式,但其在真实物理系统中常因动作离散化、反馈延迟和环境非平稳性而泛化失效。流模型(Flow Model)凭借可逆映射、隐空间连续性与端到端可微性,为VLA提供了满足机器人控制需求的动作先验建模能力;结合在线强化学习(Online RL),可实现毫秒级闭环响应与持续策略进化。该技术路径突破了传统离线微调与扩散/自回归解码器的工程瓶颈,在机械臂操作、人形机器人步态调控及AGV导航等场景中显著提升动作平滑度、任务成功率与部署实时性。πRL即为此类流+在线+VLA融合

weixin_34168880的博客 319

大模型在自动驾驶中的应用:从VLA到端到端技术全解析

大模型在自动驾驶领域的应用日益广泛,其中VLA(视觉-语言-动作)技术成为关键发展方向。文章解析了VLA与端到端的关系,并对比了两阶段(大模型+Diffusion)和单阶段(纯大模型)两种实现方案。同时提供了高薪岗位信息,包括大模型研发工程师、端到端/VLA工程师等职位,详细列出了岗位职责和技术要求。这些岗位普遍需要掌握Transformer、多模态大模型、轨迹预测等技术,并优先考虑有顶会论文或竞赛获奖经历的候选人。文章为开发者提供了职业发展参考,并附带大模型学习资源获取方式。

m0_74942241的博客 962

XGBoost调参新姿势:Bayesian优化实战指南(附完整代码)

本文详细介绍了如何使用Bayesian优化方法高效调优XGBoost模型参数。通过解析Bayesian优化核心原理和XGBoost关键参数,提供完整的实战代码示例,帮助读者掌握这一智能调参技术,显著提升模型性能。文章特别适合机器学习工程师和数据科学家阅读。

weixin_42536058的博客 367

CentOS7安装openGauss5.0.2LTS版本

该文档要根据自己的实际情况调整ip地址。要根据自己的实际网卡调整。

superhanyubo的专栏 2581

Pi0 VLA开源模型企业实操:产线质检机器人自然语言调试方案

本文介绍了如何在星图GPU平台上一键自动化部署Pi0机器人控制中心镜像,快速构建产线质检机器人的自然语言调试系统。该方案利用VLA模型,使工程师能通过直观的Web界面,用自然语言指令实时调整机器人动作,例如微调检测角度或灵敏度,从而大幅提升调试效率与灵活性。

weixin_42608299的博客 714

Python量化投资入门教程:从零构建你的第一个交易策略

量化投资教程以数学模型和计算机程序实现超额收益,选用Python工具链完成数据获取、策略构建及回测。通过移动平均线交叉策略示例,展示数据预处理、信号生成、收益计算及可视化全流程,结合收益率、最大回撤和夏普比率评估策略,并建议参数优化与策略融合提升稳健性。

ylmx5201314的博客 2461

VLA 落地先签动作合同:从视觉语言输入到可执行控制指令

文章摘要 本文探讨视觉语言动作模型(VLA)在实际机器人系统中的落地问题,指出模型能输出动作张量并不意味着可直接控制机器人。关键挑战在于建立完整的动作接口合同,包括输入时序对齐、动作语义定义、执行安全协议等。文章系统分析了五类动作表示方法(关节动作、末端Delta Pose、离散Token、连续Action Chunk、技能调用)的特点与适配要求,提出动作表示、生成头和控制频率的三层架构,并给出跨本体适配原则和项目启动检查清单。核心观点是:VLA部署的核心不在于算法选择,而在于建立严格的动作合同体系,确保模

谢谢你的喜欢 我们一起无限进步 381

MOOS-ivp实战:从零搭建水下机器人通信系统(Ubuntu 22.04版)

本文详细介绍了在Ubuntu 22.04系统上从零开始搭建MOOS-ivp水下机器人通信系统的完整实战流程。内容涵盖环境准备、核心安装、MOOSDB通信模型解析、自定义应用节点开发、以及调试监控工具链的使用,旨在帮助开发者快速掌握这一分布式机器人系统框架,构建稳定可靠的水下机器人通信与控制系统。

snow3的博客 636

点云从入门到精通技术详解100篇-基于点云语义分割的电力线提取及聚类研究

在现代社会,电力一直扮演着最重要的角色之一。它不仅与人民的生活息息相关,更是一个国家发展的命脉。近年来,随着我国各特高压输电线路建成(比如2022年1月份白鹤滩江苏特高压输电线路的放线)以及电网规模的不断扩大,我国年发电量稳步上升,人民的生活水平越来越高。我国土地辽阔,输电线路分布广泛,再加上地形环境复杂多样,电力线可能遭受风吹雨晒甚至是冰雪寒灾的影响。因此,为了保障电力线的可靠供电,防止停电意外发生,电力部门要定期对输电线路进行检查。目前我国主要。

getusushu的博客 1010

具身智能之OpenVLA详解:开源 VLA 的基线时刻——如何把机器人动作接进语言模型

OpenVLA是一个7B参数的开源视觉语言动作模型(VLA),旨在推动机器人策略基础模型的发展。该模型基于Prismatic-7B VLM,采用DINOv2+SigLIP融合视觉编码器,并连接Llama 2 7B语言模型,将连续机器人动作离散化为token进行预测。训练数据来自Open X-Embodiment,经过筛选后使用970k条真实机器人轨迹,在64张A100上训练14天完成。实验表明,OpenVLA在29个真实机器人任务上比闭源的55B RT-2-X模型成功率高出16.5%,且通过微调在多物体多指

m_aigc2022的博客 438

Autosar 下电过程-基于ETAS工具

本文介绍基于ETAS工具对应的BIP包的下电过程,仅供参考。在最后调用SBC下电时,需要理清楚SBC的休眠流程,否则可能会出现休眠又唤醒情况。后面有空会介绍9471的休眠流程。

赞的博客 815

VLA模型:具身智能的技术新共识与实践指南

在人工智能与机器人领域,多模态融合已成为实现高级智能的核心路径。其基本原理在于通过统一架构处理并关联视觉、语言等不同模态信息,从而让机器能更自然地理解世界与人类指令。这一技术价值显著,它为实现更通用、更灵活的智能系统提供了可行框架,尤其在机器人操作、人机交互等应用场景中潜力巨大。当前,基于Transformer架构的视觉-语言-动作模型正成为该路径下的工程实践焦点,它通过端到端学习直接建立从感知到行动的映射,有效规避了构建完美世界模型的挑战。这一技术收敛,标志着行业从路线之争转向了更具可操作性的解决方案探索

weixin_34054931的博客 327

17、高通8155座舱平台--QNX开发基础

我个人习惯,拿到一个新板子,第一件事就是打开IDE,建一个空的QNX项目,然后跑一遍Hello World。比如,当触摸屏被按下时,驱动发一个脉冲给UI进程,告诉它“嘿,有人摸屏幕了”。我在8155上调试时,就遇到过因为脉冲优先级太低,导致触摸响应延迟的问题。IDE自带的编译器是qcc,它其实是gcc的封装。QNX的IPC机制,可以说是它最牛的地方。嗯,这套流程走下来,你对QNX开发的基本功就差不多了。QNX默认的消息缓冲区大小是64KB,如果你要传大块数据,比如音频流,那就得用共享内存了。

woailuojp的博客 55

ximalaya 新xm-sign逆向思路

本文主要介绍目标网站新xm-sign值的逆向思路。仅代表个人理解,如有其他建议可在评论区沟通。声明仅仅记录一下自己的学习方法,不作为其他参考、更不作为商业用途。如有侵犯请联系本人删除。

weixin_66580433的博客 2017
上一篇: 机器人技术与智能系统的工程化与应用 第一章、第二章
下一篇: 机器人技术与智能系统的工程化与应用 第四章 生成式轨迹模型概论,第五章 扩散与概率运动规划
VectorShift
博客等级 码龄1年 1843粉丝 1109原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

VectorShift

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值