【深度学习原理】深入理解梯度爆炸(Gradient Explosion)及解决方案

【深度学习 | 梯度那些事】 梯度爆炸或消失导致的模型收敛困难?挑战与解决方案一览, 确定不来看看? 今天来跟大家聊一聊深度学习中的一个重要问题——梯度爆炸和梯度消失。这可是学习深度学习的同学们经常会遇到的难题哦!😱😱 首先,我们先来了解一下梯度爆炸的问题。当我们使用梯度下降算法进行训练时,有时候会出现梯度值变得非常大的情况,这就是梯度爆炸。梯度爆炸可能会导致模型无法收敛或收敛速度过慢。😫😫 那么,梯度爆炸是如何发生的呢?有几个原因可能导致这个问题的出现。首先,我们要注意激活函数的选择。如果我们在神经网络中使用了具有饱和性质的激活函数,比如Sigmoid函数,而且权重初始化不当,那么就可能会出现 阅读详情

​ 在深度学习中, 梯度爆炸(Gradient Explosion) 是训练深层神经网络时经常遇到的问题之一。本文将结合数学原理和实践示例,为你全面解析梯度爆炸的原因、现象以及应对策略。
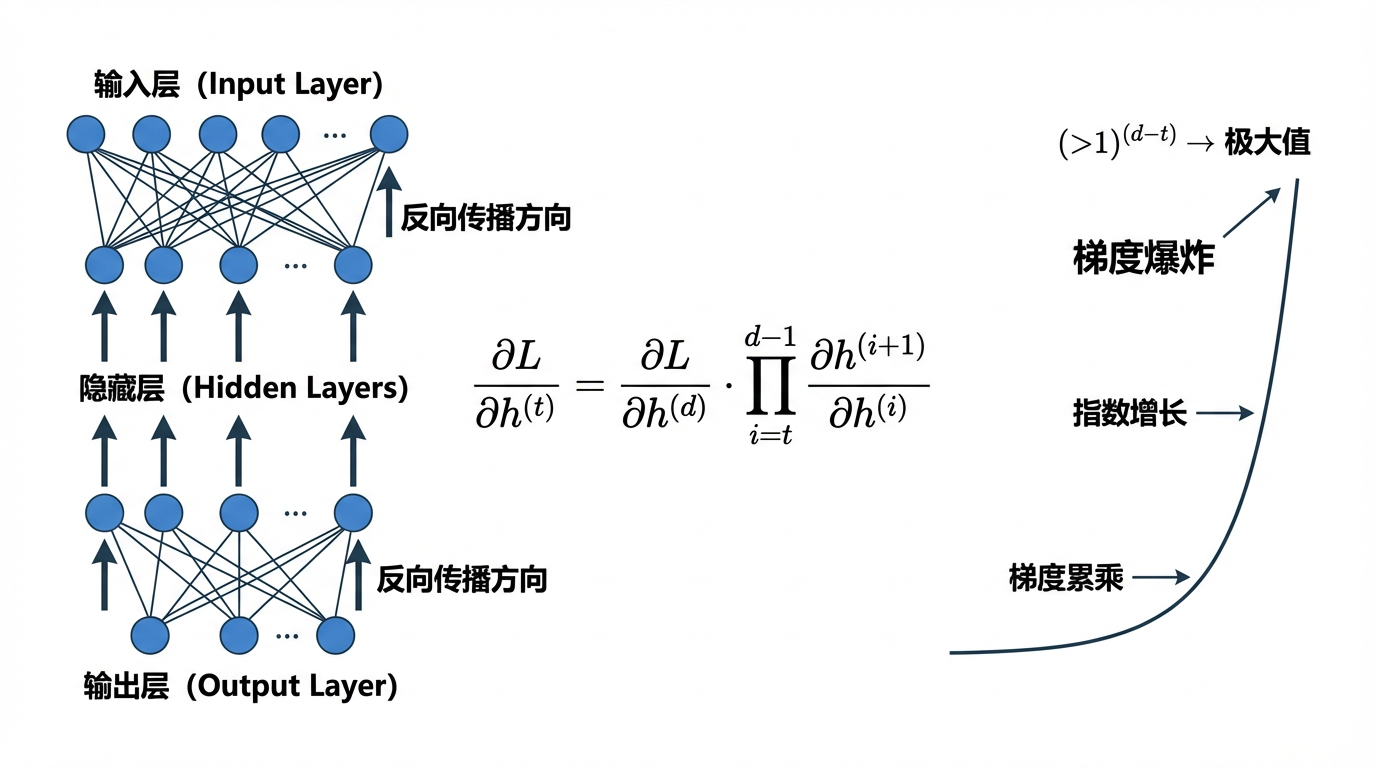
在这里插入图片描述

一、梯度爆炸的概念

本节从数学形式出发,解释梯度爆炸是什么、从哪里来、为什么会发生。

​ 在深度学习训练中,梯度爆炸(Gradient Explosion) 指的是反向传播过程中,梯度值快速增大,超过数值类型所能表示的范围,导致模型训练不稳定或直接发散。梯度爆炸是与 梯度消失(Gradient Vanishing) 相对的现象,两者都是深层神经网络训练中常见的数值问题。

1. 梯度爆炸是如何出现的

​ 假设我们有一个深度神经网络,反向传播时梯度涉及多层的链式乘积:
∂L∂h(t)=∂L∂h(d)∏i=td−1∂h(i+1)∂h(i) \frac{\partial L}{\partial \mathbf{h}^{(t)}} = \frac{\partial L}{\partial \mathbf{h}^{(d)}} \prod_{i=t}^{d-1} \frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}} ∂h(t)∂L​=∂h(d)∂L​i=t∏d−1​∂h(i)∂h(i+1)​
​ 其中,h(t)\mathbf{h}^{(t)}h(t)是第ttt层的隐藏状态(或特征表示),LLL是网络的损失函数,∂L∂h(t)\frac{\partial L}{\partial \mathbf{h}^{(t)}}∂h(t)∂L​是损失对第ttt层输出的梯度,∏i=td−1∂h(i+1)∂h(i)\prod_{i=t}^{d-1} \frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}}∏i=td−1​∂h(i)∂h(i+1)​是从第 ttt层到第ddd层的梯度链式乘积,即链式法则的应用。

​ 简单来说,损失对当前层的梯度 = 后面所有层的梯度“累乘”回来。

  • 当网络层数d−td-td−t很大时,如果每层梯度或权重大于 1,这个乘积就会呈指数增长。
  • 这意味着在深层网络中,即使单层梯度不大,累积效果也可能导致最终梯度数值极大。
(1) 链式乘积的来源
  • 在深度网络中,每一层输出依赖于前一层:
    h(i+1)=f(W(i)h(i)+b(i)) \mathbf{h}^{(i+1)} = f(\mathbf{W}^{(i)} \mathbf{h}^{(i)} + \mathbf{b}^{(i)}) h(i+1)=f(W(i)h(i)+b(i))

  • 反向传播时,损失对 h(i)\mathbf{h}^{(i)}h(i)的梯度通过链式法则传递:
    ∂L∂h(i)=∂L∂h(i+1)∂h(i+1)∂h(i) \frac{\partial L}{\partial \mathbf{h}^{(i)}} = \frac{\partial L}{\partial \mathbf{h}^{(i+1)}} \frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}} ∂h(i)∂L​=∂h(i+1)∂L​∂h(i)∂h(i+1)​

  • 递归展开到第ttt层,就得到公式中的乘积形式。

(2) 为什么会导致梯度爆炸

​ 假设每层梯度或权重矩阵的范数∂h(i+1)∂h(i)∥>1\frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}}\| > 1∂h(i)∂h(i+1)​∥>1,那么:
∏i=td−1∂h(i+1)∂h(i)∼(大于1)d−t \prod_{i=t}^{d-1} \frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}} \sim (\text{大于1})^{d-t} i=t∏d−1​∂h(i)∂h(i+1)​∼(大于1)d−t

  • 当网络层数d−td-td−t很大时,这个乘积会指数增长,最终导致∂L∂h(t)\frac{\partial L}{\partial \mathbf{h}^{(t)}}∂h(t)∂L​ 极大,从而出现梯度爆炸。

  • 反之,如果每层梯度小于 1,就可能出现梯度消失。

2. 对应激活函数的影响(以 ReLU 为例)

上一节从整体链式法则的角度解释了梯度爆炸的来源,下面我们进一步从单层局部梯度的角度,分析激活函数是如何参与梯度放大过程的。

​ 在分析梯度爆炸问题时,激活函数的导数形式会直接影响反向传播过程中梯度的放大或抑制方式。这里以 ReLU 激活函数为例进行说明。

(1) ReLU激活函数的定义

​ ReLU(Rectified Linear Unit)的定义如下:
σ(x)=max⁡(0,x) \sigma(x) = \max(0,x) σ(x)=max(0,x)
​ 其导数为:
σ′(x)={1 if x>00 otherwise  \sigma'(x) = \begin{cases} 1 & \text{ if } x>0 \\ 0 & \text{ otherwise } \end{cases} σ′(x)={10​ if x>0 otherwise ​

​ 这意味着:

  • 当神经元被激活(x>0x>0x>0)时,梯度可以无衰减地通过;
  • 当神经元未激活(x≤0x \le 0x≤0)时,梯度被完全阻断。
(2) 反向传播中的梯度累乘形式

​ 考虑一个深度前馈网络,在反向传播过程中,从第ttt层到第ddd层的梯度传播可以写成:
∂h(d)∂h(t)=∏i=td−1∂h(i+1)∂h(i) \frac{\partial \mathbf{h}^{(d)}}{\partial \mathbf{h}^{(t)}} = \prod_{i=t}^{d-1} \frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}} ∂h(t)∂h(d)​=i=t∏d−1​∂h(i)∂h(i+1)​
​ 该公式来源于链式法则,表示梯度在反向传播时需要逐层“传回”,并在每一层都会与该层的局部梯度相乘。网络层数越深,这种累乘效应就越显著。

  • 对于使用 ReLU 激活函数的网络,第iii层的前向传播形式为:
    h(i+1)=σ(W(i)h(i)+b(i)) \mathbf{h}^{(i+1)}=\sigma(\mathbf{W}^{(i)}\mathbf{h}^{(i)}+\mathbf{b}^{(i)}) h(i+1)=σ(W(i)h(i)+b(i))

  • 忽略偏置项(不影响梯度传播结构),可以利用链式法则将局部梯度展开为:
    ∂h(i+1)∂h(i)=diag(σ′(W(i)h(i)))W(i) \frac{\partial \mathbf{h}^{(i+1)}}{\partial \mathbf{h}^{(i)}} = \text{diag}(\sigma'(\mathbf{W}^{(i)}\mathbf{h}^{(i)}))\mathbf{W}^{(i)} ∂h(i)∂h(i+1)​=diag(σ′(W(i)h(i)))W(i)
    其中:

    • diag⁡(σ′(⋅))\operatorname{diag}(\sigma'(\cdot))diag(σ′(⋅))是一个对角矩阵,用于表示 ReLU 在每个神经元上的导数
    • 对角线上元素为 1 表示该神经元处于激活状态,梯度可以通过
    • 对角线上元素为 0 表示该神经元未激活,梯度在此被直接阻断
    • W(i)\mathbf{W}^{(i)}W(i)则决定了梯度在该层的线性映射和尺度变化。
  • 因此,从第ttt层到第ddd层的整体梯度传播形式可以写为:
    ∏i=td−1diag(σ′(W(i)h(i)))W(i) \prod_{i=t}^{d-1}\text{diag}(\sigma'(\mathbf{W}^{(i)}\mathbf{h}^{(i)}))\mathbf{W}^{(i)} i=t∏d−1​diag(σ′(W(i)h(i)))W(i)

(3) ReLU对梯度放大的影响

​ 由于 ReLU 的导数σ′(x)\sigma'(x)σ′(x) 只取 0 或 1,这带来两个重要影响:

  • 梯度路径筛选(masking)

    • 为 0 的位置直接切断梯度;
    • 为 1 的位置,梯度完全由权重矩阵W(i)\mathbf{W}^{(i)}W(i)决定。
  • 梯度规模主要由权重决定

    在激活为正的路径上,梯度的大小近似来源于:
    ∏i=td−1W(i) \prod_{i=t}^{d-1} \mathbf{W}^{(i)} i=t∏d−1​W(i)
    当网络较深(即d−td-td−t很大),且权重矩阵的谱范数或典型值大于 1 时,梯度会呈指数级增长。

    例如,当网络深度d−t=100d - t = 100d−t=100,权重尺度W≈1.5\mathbf{W} \approx 1.5W≈1.5时,则有:
    1.5100≈4×10¹⁷ 1.5^{100} \approx 4 \times 10^{17} 1.5100≈4×10¹⁷
    这已经远远超出了数值计算中可控的范围,从而导致梯度爆炸。

3. 矩阵乘积爆炸的直观示例

​ 为了更直观地理解这一现象,可以通过连续矩阵相乘来模拟梯度的累乘过程:

import torch

M = torch.normal(0, 1, size=(4,4))
print('一个矩阵 \n', M)

for i in range(100):
    M = torch.mm(M, torch.normal(0, 1, size=(4, 4)))

print('乘以100个矩阵后\n', M)

​ 示例输出如下:

一个矩阵
tensor([[-2.1385e-01,  4.6225e-01, -5.0861e-01, -8.8057e-01],
        [ 1.4022e+00,  1.0260e+00, -1.2511e+00,  2.2817e-01],
        [-1.0128e+00, -2.6599e-01,  3.2404e-02, -2.2224e+00],
        [-4.3064e-01,  1.3997e-03,  4.1939e-01, -2.0210e-01]])

乘以100个矩阵后
tensor([[-4.3617e+23, -5.9455e+23, -3.7624e+23,  4.6231e+23],
        [-1.7493e+24, -2.3845e+24, -1.5089e+24,  1.8541e+24],
        [ 4.2498e+23,  5.7931e+23,  3.6660e+23, -4.5046e+23],
        [ 5.1668e+23,  7.0431e+23,  4.4570e+23, -5.4765e+23]])

​ 可以看到,即使每个矩阵元素本身来自标准高斯分布,在多次相乘后,结果仍然会迅速膨胀到 102310^{23}1023量级以上,这与深层网络中梯度爆炸的行为高度一致。

4. 为什么梯度爆炸会影响训练

​ 梯度爆炸会导致数据溢出、模型参数更新失控、训练过程不稳定等。

(1) 数值溢出(Numerical Overflow)

​ 当梯度在反向传播过程中不断累乘并迅速增大时,其数值可能会超出浮点数的可表示范围。

  • 例如:

    • float32 的有效数值范围约为
      1.18×10−38∼3.4×1038 1.18 \times 10^{-38} \sim 3.4 \times 10^{38} 1.18×10−38∼3.4×1038

    • float16 的数值范围更小,在深层网络或混合精度训练中尤为脆弱。

  • 一旦梯度或中间激活值超出该范围:数值会被截断为 inf或在后续计算中产生 NaN

    这会直接破坏反向传播过程,使得参数更新失效,训练无法继续。

(2) 模型参数更新失控(Uncontrolled Parameter Updates)

​ 梯度下降的参数更新公式为:
Wt+1←Wt−α∇WL(Wt) \mathbf{W}_{t+1} \gets \mathbf{W}_{t} - \alpha \nabla_\mathbf{W} L(\mathbf{W}_t) Wt+1​←Wt​−α∇W​L(Wt​)
​ 其中,α\alphaα是一个标量缩放因子,用于控制沿该方向前进的距离;∇WL(Wt)\nabla_\mathbf{W} L(\mathbf{W}_t)∇W​L(Wt​)决定更新方向和更新幅度。

  • 在参数空间中,一次更新的实际“步长”可以表示为:
    ∥ΔW∥=α∥∇WL(Wt)∥ \|\Delta \mathbf{W}\| = \alpha \|\nabla_{\mathbf{W}} L(\mathbf{W}_t)\| ∥ΔW∥=α∥∇W​L(Wt​)∥

  • 当梯度发生爆炸时,即使学习率α\alphaα保持不变,梯度范数∥∇WL∥\|\nabla_\mathbf{W} L\|∥∇W​L∥也会急剧增大,从而导致:

    • 单次参数更新幅度异常增大
    • 参数在一次迭代中跳跃到远离当前区域的位置
    • 模型直接偏离原本可能收敛的轨道

    此时,参数更新不再是“沿着损失下降方向的小幅前进”,而更像是一次失控的跳跃,极易导致训练发散。

(3) 训练过程不稳定
  • 在参数更新失控和数值异常的共同作用下,训练过程会表现出明显的不稳定性:

    • 损失函数在相邻迭代之间剧烈波动,难以呈现稳定下降趋势;
    • 参数频繁被推离合理区域,使得模型难以逐步逼近最优解;
    • 网络无法稳定地学习有效特征,最终表现为模型性能明显下降。
  • 在更极端的情况下,梯度爆炸会使损失函数持续上升,训练过程完全发散,模型无法收敛。

​ 梯度爆炸会先导致数值计算失真,继而引发参数更新失控,最终破坏整个训练过程的稳定性。这种影响会随着网络深度的增加而被进一步放大。

二、梯度爆炸出现的典型场景

本节结合模型结构与训练设置,说明在什么情况下梯度爆炸最容易发生。

​ 梯度爆炸并非偶然现象,而是深度模型结构、训练方式与参数设置共同作用的结果。以下是实践中最常见的三类高发场景。

1. 深层前馈网络(Deep Feedforward Networks)

​ 在深层前馈网络中,梯度在反向传播过程中需要逐层传递,其数学形式可以写为多层雅可比矩阵的乘积。

  • 当网络层数ddd很大时,这种连乘结构会带来一个关键问题:

    • 若每一层的梯度范数略大于 1
    • 多层相乘后,整体梯度会呈 指数级放大
  • 特别是在以下情况下,梯度爆炸更容易发生:

    • 权重矩阵的谱范数(最大奇异值)大于 1
    • 使用未约束的全连接层
    • 激活函数在某些区间导数较大(如 ReLU 在正区间)

​ 因此,在深层网络中,即使单层看似“正常”的梯度,也可能在整体反向传播过程中被不断放大,最终导致梯度爆炸。

2. 循环神经网络(RNN)与长序列任务

​ 梯度爆炸在 RNN 中尤为典型,其根本原因在于时间维度上的梯度累乘。

​ 在 RNN 中,隐藏状态的更新形式为:

h(t)=f(Wh(t−1)+Ux(t)) \mathbf{h}^{(t)} = f(\mathbf{W}\mathbf{h}^{(t-1)} + \mathbf{U}\mathbf{x}^{(t)}) h(t)=f(Wh(t−1)+Ux(t))

​ 在反向传播时,某一时间步的梯度需要经过多个时间步反传。

  • 这意味着:
    • 序列越长,梯度连乘项越多
    • 若循环权重矩阵W\mathbf{W}W 的范数大于 1
    • 梯度会在时间维度上迅速放大
  • 因此,在以下任务中梯度爆炸尤为常见:
    • 长文本建模
    • 时间序列预测
    • 语音、金融等长时间依赖任务

​ 这也是 LSTM、GRU 等门控结构被提出的重要动机之一,它们通过门控机制对梯度流进行约束,缓解梯度爆炸与消失问题。

3. 不合理的权重初始化或高学习率

​ 除了模型结构本身,训练超参数设置不当同样会显著放大梯度。

(1) 权重初始化不合理
  • 若权重初始值过大,会导致前向传播中激活值迅速增大

  • 激活值变大 → 反向传播中梯度也随之放大

  • 多层叠加后,梯度可能迅速失控

    例如,当权重矩阵的元素方差过大时,其对应的梯度范数往往也偏大,从而加剧梯度爆炸风险。

(2) 学习率过高

​ 当学习率α\alphaα过大时,即使梯度本身尚可接受,也会导致:

  • 参数在一次更新中“跨步过大”
  • 模型跳过最优区域
  • 损失函数剧烈震荡甚至直接发散

三、梯度爆炸与梯度消失的对比

本节从机制和训练现象角度,对比梯度爆炸与梯度消失的异同。

特性梯度爆炸梯度消失
梯度变化指数增长指数减小
网络层数影响层数越多问题越严重层数越多问题越严重
典型后果参数更新过大,训练发散参数几乎不更新,训练停滞
解决策略梯度裁剪、权重初始化优化、学习率调节激活函数选择(ReLU)、权重初始化优化、归一化

四、总结

  • 梯度爆炸:反向传播中梯度值过大,导致训练不稳定或发散。
  • 主要原因:深层网络/长序列 RNN、激活函数特性、权重初始化不当、学习率过高。
  • 训练影响:数值溢出、参数更新失控、损失剧烈波动。
  • 应对策略:梯度裁剪、优化权重初始化、调节学习率、自适应优化器、改进网络结构(如 LSTM/GRU)

​ 总之,梯度爆炸是深度网络训练中的常见问题,通过梯度裁剪等方法可以有效控制梯度幅度,保证训练稳定性。在实际应用中,结合学习率调整、权重初始化等策略,还能进一步提高深层网络的训练鲁棒性。

深度网络梯度爆炸的原因、产生的影响和解决方法(常用激活函数) 1.概念 深度模型有关数值稳定性的典型问题是:衰减(vanishing)和爆炸(explosion)。 2.导致梯度爆炸的原因 当神经网络的层数较多时,模型的数值稳定性容易变差。举个简单的例子: 为了便于讨论,不考虑偏差参数, 且设所有隐藏层的激活函数为恒等映射(identity mapping)φ(x) = x。给定输入X,多层感知 机的第l层的输出H(l) = XW(1)W(2) ...W(l)。此时,如果层数l较大,H(l)的计算可能会出现衰 减或爆炸。举个例子,假设输入和所有层的权重参数都是 阅读详情

相关推荐

什么是梯度爆炸?

梯度爆炸(Gradient Explosion)是指在神经网络训练过程中,梯度值变得非常大,超出了网络的处理范围,从而导致权重更新变得不稳定甚至不收敛的现象。当梯度爆炸发生时,网络的权重更新可能会变得异常大,导致网络的参数值迅速膨胀,最终可能导致数值溢出、计算错误和训练失败。梯度爆炸通常在深度神经网络中出现,特别是当网络的层数较多,网络结构复杂时,或者使用了不合适的激活函数、初始化方法或优化算法时更容易发生。这是一种常见的方法,通过设置梯度的阈值来限制梯度的大小,确保梯度不会超过一定的范围。

优快云 精品推荐 3017

梯度消失与梯度爆炸产生、原理和解决方案

本文章总结了梯度消失与梯度爆炸产生、原理和解决方案。

caip12999203000的博客 1万+

IoTDB时序数据库在Windows下的保姆级安装教程(含环境变量配置避坑指南)

本文提供Apache IoTDB时序数据库在Windows系统下的详细安装与配置指南。教程涵盖从Java环境检查、软件下载解压,到环境变量配置的深度避坑,并详解了服务的启动、停止、连接测试及基础数据操作,帮助物联网开发者在Windows平台快速搭建稳定的时序数据库环境。

weixin_29275257的博客 263

梯度爆炸与梯度消失是什么?有什么影响?如何解决?

文章目录一、梯度爆炸1.什么是梯度爆炸?2.有何影响?二、梯度消失1.定义2.有何影响?三、共同点1.产生原因2.解决办法a. 方案1-预训练加微调b. 方案2-梯度剪切、正则化c. 方案3-relu、leakrelu、elu等激活函数解决方案4-batchnorm/批规范化解决方案5-残差结构解决方案6-LSTM 梯度消失与梯度爆炸其实差不多,两种情况下梯度消失经常出现,一是在深层网络中,二是采...

江南蜡笔小新 4万+

傻白入门芯片设计,SystemVerilog Assertion(SVA)学习(二十一)

对SVA(SystemVerilogt Assertion)有了更深刻的认识,对经典的AveMC形式验证工具进行了介绍

qq_46675545的博客 8473

Fiddler Everywhere保姆级教程:10分钟搞定手机HTTPS抓包(附证书配置避坑指南)

本文提供Fiddler Everywhere移动端HTTPS抓包的保姆级教程,涵盖环境配置、代理设置、证书安装及常见问题排查。重点解析如何正确安装并信任Fiddler根证书以解密HTTPS流量,帮助开发者快速搭建抓包环境,高效分析应用网络行为,提升调试效率。

git9versioner的博客 705

Python机器学习:从零基础到项目实战

当您翻开此书,您正踏入一场数据与智慧的修行。机器学习,并非冰冷的符码,而是机器模拟人类洞察世界的法门。本书将带您,以Python为舟,泛游于算法之海。我们不只传授“术”,更探求其后的“道”——从数据的生灭流转中观照规律,于模型的迭代演进里体悟得失。愿您合上书卷时,收获的不仅是驾驭数据的技能,更有一双洞悉复杂、化繁为简的“智慧之眼”。现在,让我们一同启程。

YunWisdom 969

C#报表,使用微软rdlc模板,生成Excel, PDF, Word, Image文件,使用自定义对象做数据集不连接数据库

我项目是用vs2017 建的,.NET farmwork 4.7.2 这种报表可以用于任何模式的应用,web,桌面,因为这只是生成一个文件或者文件流 步骤比较详细啰嗦,其中有讲到rdlc怎么新建设计,如果已经会设计rdlc了的可以直接跳到底部看代码的执行结果, 底部还有源码下载链接,百度盘 首先控制台安装报表包 新建rdlc 报表 建立rdlc里要用的数据模型 模型建完,或者修改都要重新...

qq_35955916的博客 5203

什么是梯度爆炸/梯度消失?

深度神经网络训练的时候,采用的是反向传播方式,该方式使用链式求导,计算每层梯度的时候会涉及一些连乘操作,因此如果网络过深。 那么如果连乘的因子大部分小于1,最后乘积的结果可能趋于0,也就是梯度消失,后面的网络层的参数不发生变化. 那么如果连乘的因子大部分大于1,最后乘积可能趋于无穷,这就是梯度爆炸 如何防止梯度消失? sigmoid容易发生,更换激活函数为 ReLU即可。 权重初始化用高斯初始化 如何防止梯度爆炸? 1 设置梯度剪切阈值,如果超过了该阈值,直接将梯度置为该值。 2 使用ReLU

浩瀚之水的专栏 2万+

Xilinx ERNIC RoCEv2 FPGA实现与QP队列深度解析

本文深入解析Xilinx ERNIC RoCEv2在FPGA上的实现,重点剖析QP队列对的管理机制与深度优化策略。通过Verilog代码示例和工程实战,详细介绍了如何实现高吞吐量、低延迟的RDMA硬件卸载方案,为金融交易和数据中心应用提供性能优化指导。

solidity8miner的博客 878

KEGG数据库与KAAS工具:基因功能注释的实用指南

本文提供了使用KEGG数据库与KAAS工具进行基因功能注释的完整实用指南。详细阐述了如何从准备基因或蛋白序列开始,通过KAAS服务器获取KEGG Orthology(KO)编号,并解读注释结果。文章进一步介绍了如何利用KOBAS工具进行通路富集分析,将定性观察转化为定量洞察,并分享了提高注释准确率、处理大数据集及使用API等避坑技巧与高阶方法,为基因组学、转录组学研究者奠定坚实的数据分析基础。

weixin_29292535的博客 391

神经网络问题之二:梯度爆炸(Gradient Explosion)

梯度爆炸问题对神经网络训练的影响是显著的。当梯度爆炸发生时,网络的权重更新可能会变得异常大,导致网络的参数值迅速膨胀。梯度爆炸问题通常发生在深度神经网络中,是深度神经网络的结构和训练过程中的一些固有特性,特别是当网络的层数较多、网络结构复杂时,或者使用了不合适的激活函数、初始化方法或优化算法时,随着网络层数的增加,梯度爆炸(Gradient Explosion)是神经网络训练过程中常见的一个问题,它指的是在反向传播过程中,梯度值变得非常大,超出了网络的处理范围,从而导致权重更新变得不稳定甚至不收敛的现象。

搏博的专栏 4753

【OS】AUTOSAR OS系统调用产生Trap的过程详解

AUTOSAR OS系统调用产生Trap的过程详解

qq_36056498的博客 2439

【机器学习300问】77、什么是梯度消失和梯度爆炸?

梯度消失(Vanishing gradients)是什么?梯度爆炸(Exploding gradients)是什么?

qq_39780701的博客 6759

2026年03月CCF-GESP编程能力等级认证Scratch图形化编程一级真题解析

本文收录于《,订阅后可阅读专栏内所有文章。

人生就是一个不断学习的过程 240

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

梯度消失和梯度爆炸及解决方法

梯度消失和梯度爆炸的原因和解决办法

hollyprince的博客 1万+

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

什么是梯度爆炸与梯度消失

梯度爆炸(Gradient Explosion)和梯度消失(Gradient Vanishing)是深度学习训练过程中的两种常见问题。 梯度爆炸是指当训练深度神经网络时,梯度的值会快速增大,造成参数的更新变得过大,导致模型不稳定,难以训练。 梯度消失是指当训练深度神经网络时,梯度的值会快速减小,导致参数的更新变得很小,甚至无法更新,使得模型难以学习有用的特征。 这两种问题都会降低模型的性能,因此对...

weixin_35755434的博客 2948

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

机器学习:神经网络中的梯度消失和梯度爆炸

一、什么是梯度消失和梯度爆炸 1. 梯度消失(gradient vanishing problem) 我们知道神经网络在进行反向传播(BP)的时候会对参数W进行更新,梯度消失就是靠后面网络层(如layer3)能够正常的得到一个合理的偏导数,但是靠近输入层的网络层,计算的到的偏导数近乎零,W几乎无法得到更新。 2. 梯度爆炸(gradient exploding problem) 梯度爆炸的意思是,靠近输入层的网络层,计算的到的偏导数极其大,更新后W变成一个很大的数(爆炸)。 ...

JacksonKim的博客 1万+

梯度爆炸和梯度消失的原因及解决办法

1.合理的初始化权重值。初始化权重,使每个神经元尽可能不要取极大或极小值,以躲 开梯度消失的区域。3.使用其他结构的RNNs,比如长短时记忆网络(LTSM),这是比较流行的做法。2.梯度截断:当梯度的模大于一定阈值时,就将它截断成为一个较小的数。梯度呈指数级增长,变的非常大,然后导致网络权重的大幅更新,使网络变得不稳定。1.权重衰减:通过给参数增加L1或L2范数的正则化项来限制参数的取值范围。梯度趋近于零,网络权重无法更新或更新的很微小,网络训练再久也不会有效果。

m0_64665859的博客 3084

详解梯度消失、梯度爆炸问题

1、梯度消失(vanishing gradient problem)、梯度爆炸(exploding gradient problem)原因 神经网络最终的目的是希望损失函数loss取得极小值。所以最终的问题就变成了一个寻找函数最小值的问题,在数学上,很自然的就会想到使用梯度下降(求导)来解决。 梯度消失、梯度爆炸其根本原因在于反向传播训练法则(BP算法):是指在使用梯度下降法对误差进行反向传播时,由于求偏导累乘而出现趋于0(梯度消失)或者趋于无穷大(梯度爆炸)的问题 。 所以梯度消失和爆炸出现的原因经

王叔叔 4513

深度学习基础知识---梯度弥散 梯度爆炸

防止过拟合:在网络的训练中,BN的使用使得一个minibatch中所有样本都被关联在了一起,因此网络不会从某一个训练样本中生成确定的结果,即同样一个样本的输出不再仅仅取决于样本的本身,也取决于跟这个样本同属一个batch的其他样本,而每次网络都是随机取batch,这样就会使得整个网络不会朝这一个方向使劲学习。1)没有它之前,需要小心的调整学习率和权重初始化,但是有了BN可以放心的使用大学习率,但是使用了BN,就不用小心的调参了,较大的学习率极大的提高了学习速度。但如果数据的分布一直在变,学习就很难了。

thequitesunshine007的博客 3655

NNDL 实验七 循环神经网络(2)梯度爆炸实验

范数(norm)是线性代数中的一个基本概念。在泛函分析中,它定义在赋范线性空间中,并满足一定的条件,即①非负性;②齐次性;③三角不等式,它常常被用来度量某个向量空间(或矩阵)中的每个向量的长度或大小。划重点:非负性、齐次性、三角不等式。外文名:n o r m normnorm作用:常常被用来度量某个向量空间(或矩阵)中的每个向量的长度或大小。记号:f ( x ) = ∥ x ∥我们常用表示具体范数,其中下标s y m b symbsymb是区分范数的助记符号,如、、、范数。

fangerfang? 777

深度学习避坑指南:一文搞懂梯度消失与梯度爆炸

梯度消失与梯度爆炸的本质是梯度在反向传播中的极端累积,解决问题的核心思路是减少梯度的衰减/膨胀,增强梯度的传递能力。深度学习避坑指南:一文搞懂梯度消失与梯度爆炸在神经网络训练中,模型通过反向传播计算来更新参数。当梯度出现异常时,参数更新就会失控,进而导致模型训练失败。二者的本质是梯度在反向传播过程中的极端变化,但表现却截然相反。t=P7R7深度学习避坑指南:一文搞懂梯度消失与梯度爆炸在神经网络训练中,模型通过反向传播计算来更新参数。当梯度出现异常时,参数更新就会失控,进而导致模型训练失败。

febwww的博客 3107

深入浅出讲解梯度消失和梯度爆炸问题(原因、解决方法)

1.梯度消失和梯度爆炸产生的原因: 传统的神经网络通常是基于BP算法优化权重参数的,即通过损失函数计算的误差通过梯度反向传播的方式对神经网络中的权重进行更新,其中用到的是连乘形式的链式法则。 梯度消失:产生的原因基本上是网络太深或是采用了不恰当的损失函数,如sigmoid函数、tanh函数等。由于sigmoid函数的导数最大值是0.25,因而通过链式法则,导致靠近输入层的权重更新缓慢甚至停...

程序星空实验室 4065

【深度学习实战】梯度爆炸怎么解决?

本文全面探讨了深度神经网络训练中的梯度爆炸问题,分析了其成因、症状及多种解决方案。梯度爆炸通常由模型深度、权重初始化不当、学习率过高等因素引发,表现为损失函数变为NaN、权重溢出等。文章提供了八类解决方案,包括梯度裁剪、权重初始化优化、降低学习率、使用稳定激活函数、添加归一化层、使用残差网络、切换优化器及改良损失函数,并附有PyTorch实践代码。此外,文章还介绍了检测梯度爆炸的调试技巧,如打印梯度范数和使用TensorBoard可视化梯度。最后,文章总结了实战建议,强调调整学习率、加入梯度裁剪和监控梯度变

未名编程 2423

梯度消失、梯度爆炸及其表现和解决方法

一、梯度消失 梯度消失出现的原因: 在深层网络中,如果激活函数的导数小于1,根据链式求导法则,靠近输入层的参数的梯度因为乘了很多的小于1的数而越来越小,最终就会趋近于0,例如sigmoid函数,其导数f′(x)=f(x)(1−f(x))的值域为(0,1/4),极易发生这种情况。 所以梯度消失出现的原因经常是因为网络层次过深,以及激活函数选择不当,比如sigmoid函数。 梯度消失的表现: 模型无法...

vivian_ll的博客 2万+
上一篇: 【LLM评价指标】从概率到直觉:理解语言模型的困惑度
下一篇: 【深度学习原理】数值稳定性(一):为什么深度神经网络如此脆弱
未收敛
博客等级 码龄11年 3317粉丝 163原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

未收敛

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值