【LLM评价指标】从概率到直觉:理解语言模型的困惑度

【LM】(八)语言模型评价指标——困惑度Perplexity原理及代码 0.语言模型 语言模型(Language Model,LM),基于统计的语言模型,给出一句话的前k个词,预测第k+1个词,即求第k+1个词出现的概率p(xk+1|x1,x2,...,xk)。在深度网络中,比如bert,可以词前后的内容,预测当前词,类似做完形填空。 1.什么是困惑度 在信息论中,perplexity(困惑度)用来度量一个概率分布或概率模型预测样本的好坏程度。它也可以用来比较两个概率分布或概率模型。(应该是比较两者在预测样本上的优劣)低困惑度的概率分布模型或概率模型能更好地预测样本。 阅读详情

“如果你想知道一个语言模型到底有多聪明,它在写下一个词时心里有多少个备选答案,就得看看困惑度了。”

​ 无论是 n-gram 语言模型(unigram、bigram、trigram)还是理论上可以记忆无限上下文的 递归神经网络语言模型(RNN LM),一个核心问题始终存在:如何评价语言模型的好坏?

​ 语言模型广泛应用于文本生成、语言预测等任务。最直接的评估方法是将其用于下游 NLP 任务中观察性能,但这种方法复杂且耗时。我们需要一个直接、量化的指标,来衡量语言模型本身的质量。
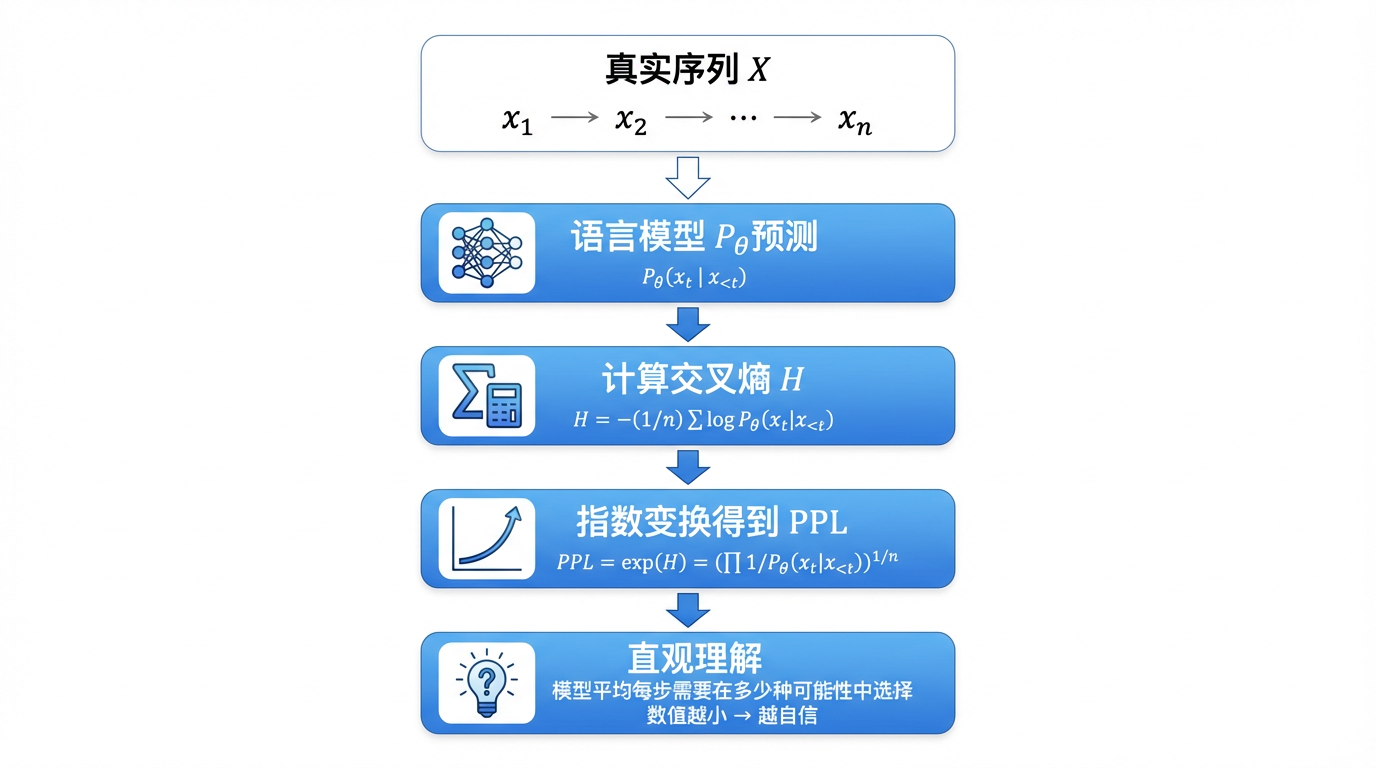
在这里插入图片描述

一、语言模型预测能力的直观理解

示例来自沐神教程:8.4.4 困惑度

​ 一个高质量的语言模型应当能够以较高的条件概率预测序列中下一个词元。以提示 “It is raining …” 为例,不同语言模型可能给出风格和质量差异极大的续写。

1. “It is raining outside”(外面下雨了);

2. “It is raining banana tree”(香蕉树下雨了);

3. “It is raining piouw;kcj pwepoiut”(piouw;kcj pwepoiut下雨了)。

​ 从语义连贯性和语言统计规律的角度看,这些续写反映了模型在不同层次上对真实语言分布的拟合程度。

  • 就质量而言,例1显然是最合乎情理、在逻辑上最连贯的。 虽然这个模型可能没有很准确地反映出后续词的语义, 比如,“It is raining in San Francisco”(旧金山下雨了) 和``“It is raining in winter”(冬天下雨了)` 可能才是更完美的合理扩展, 但该模型已经能够捕捉到跟在后面的是哪类单词。

  • 例2则要糟糕得多,因为其产生了一个无意义的续写。 尽管如此,至少该模型已经学会了如何拼写单词, 以及单词之间的某种程度的相关性。

  • 例3表明了训练不足的模型是无法正确地拟合数据的。

    上述直观例子揭示了语言模型预测能力的差异,但仍然缺乏一个可比较、可量化的指标。

二、从序列似然到平均不确定性

​ 为了定量刻画模型对真实语言分布的拟合程度,我们可以考虑模型在给定真实序列上的似然概率。

​ 对于句子 X = [ x 1 , x 2 , ⋯   , x n ] \mathbf{X}=[x_1, x_2, \cdots, x_n] X=[x1​,x2​,⋯,xn​],其联合概率为:
P ( X ) = P ( x 1 , x 2 , ⋯   , x n ) = P ( x 1 ) P ( x 2 ∣ x 1 ) ⋯ P ( x n ∣ x 1 , ⋯   , x n − 1 ) P(\mathbf{X}) = P(x_1, x_2, \cdots, x_n) = P(x_1)P(x_2|x_1)\cdots P(x_n|x_1,\cdots, x_{n-1}) P(X)=P(x1​,x2​,⋯,xn​)=P(x1​)P(x2​∣x1​)⋯P(xn​∣x1​,⋯,xn−1​)

  • 直接比较完整序列的联合概率存在问题:
    • 序列越长,其联合概率天然越小:较短的序列比较长的序列更有可能出现
    • 不同样本长度不同,使得数值本身缺乏可比性。
  • 因此,我们需要一种能够消除序列长度影响、刻画模型平均预测能力的度量方式。

三、交叉熵与平均不确定性

​ 信息论为这一问题提供了自然的解决方案。语言模型可以被理解为一个条件概率编码器:模型对真实词元的预测概率越高,就意味着在编码该序列时,所需的平均码长越短。

​ 形式上,语言模型定义了一个条件概率分布:
P θ ( x t ∣ x < t ) P_{\theta}(x_t|x_{<t}) Pθ​(xt​∣x<t​)
​ 其中, P θ ( x t ∣ x < t ) P_{\theta}(x_t|x_{<t}) Pθ​(xt​∣x<t​)表示模型在时间步 t t t下,在给定历史上下文 x < t = ( x 1 , … , x t − 1 ) x_{<t} = (x_1, \dots, x_{t-1}) x<t​=(x1​,…,xt−1​) 的条件下,对词元 x t x_t xt​ 的预测概率(或对数似然值)。

​ 从概率编码的角度看,一个更好的语言模型,应当能够在平均意义下更准确地预测真实出现的词元,从而降低文本的不确定性。

​ 在实践中,这种平均不确定性通常通过 token 级交叉熵 来衡量。给定长度为 n n n 的序列 X = [ x 1 , x 2 , … , x n ] \mathbf{X} = [x_1, x_2, \dots, x_n] X=[x1​,x2​,…,xn​],其交叉熵定义为:
H = 1 n ∑ t = 1 n − log ⁡ P ( x t ∣ x t − 1 , ⋯   , x 1 ) \begin{aligned} H &= \frac{1}{n}\sum_{t=1}^n-\log P(x_t|x_{t-1},\cdots,x_1) \\ \end{aligned} H​=n1​t=1∑n​−logP(xt​∣xt−1​,⋯,x1​)​
​ 其中, x t x_t xt​表示在时间步 t t t观察到的真实词元, H H H刻画了模型在真实数据分布下的平均不确定性,由于取了平均值,它天然消除了序列长度带来的影响。

  • 交叉熵越低 → 模型预测越准确 → 平均编码长度越短。

​ 至此,我们已经得到了一个能够衡量语言模型平均预测不确定性的指标。在工程实践中,人们通常对这一量再做一次指数变换,从而得到更直观的评价指标:困惑度(Perplexity)。

四、困惑度

perplexity

​ 由于历史和工程实践的原因,自然语言处理领域通常不直接使用交叉熵本身,而是采用其指数形式,即困惑度—个在数值尺度和直觉上都更易理解的指标。

1. 交叉熵的指数形式

​ 设有一个长度为 n n n的分词序列 X = [ x 1 , x 2 , … , x n ] \mathbf{X}= [x_1, x_2, \dots, x_n] X=[x1​,x2​,…,xn​],基于交叉熵 H H H的困惑度可以表示为:
PPL ( X ) = exp ⁡ ( H ) = exp ⁡ ( − 1 n ∑ t = 1 n log ⁡ P ( x t ∣ x 1 , … , x t − 1 ) ) = [ exp ⁡ ( ∑ t = 1 n log ⁡ P ( x t ∣ x < t ) ) ] − 1 n = ( ∏ t = 1 n P ( x t ∣ x < t ) ) − 1 n = ∏ t = 1 n 1 P ( x t ∣ x < t ) n . \begin{aligned} \text{PPL}(\mathbf{X}) &= \exp(H) \\ &= \exp\Bigg(-\frac{1}{n} \sum_{t=1}^n \log P(x_t \mid x_1, \dots, x_{t-1}) \Bigg) \\ &= \Bigg[\exp\Big( \sum_{t=1}^n \log P(x_t \mid x_{<t})\Big)\Bigg]^{-\frac{1}{n}} \\ &= \Bigg(\prod_{t=1}^n P(x_t \mid x_{<t}) \Bigg)^{-\frac{1}{n}} \\ &= \sqrt[n]{\prod_{t=1}^n \frac{1}{P(x_t \mid x_{<t})}}. \end{aligned} PPL(X)​=exp(H)=exp(−n1​t=1∑n​logP(xt​∣x1​,…,xt−1​))=[exp(t=1∑n​logP(xt​∣x<t​))]−n1​=(t=1∏n​P(xt​∣x<t​))−n1​=nt=1∏n​P(xt​∣x<t​)1​ ​.​
​ 可以看到,根号内是整个句子概率的倒数,因此:句子在模型下的概率越大,困惑度越小,模型对该句子就越“不困惑”。

​ 此外,开 n n n次方根( n n n为句子长度)意味着对 token 概率取几何平均,从而消除了序列长度对评价结果的影响,使得不同长度句子之间具有可比性。

​ 从这个角度看,困惑度可以理解为:模型在平均每一个时间步上,对下一个词元的不确定性大小。

​

2. 困惑度:序列负对数似然的指数平均值

​ 困惑度也常被直接定义为序列联合概率的负幂平均值。

​ 对同一序列 X \mathbf{X} X:
PPL ( X ) = [ P ( x 1 , x 2 , ⋯   , x n ) ] − 1 n = [ P ( x 1 ) P ( x 2 ∣ x 1 ) ⋯ P ( x n ∣ x 1 , ⋯   , x n − 1 ) ] − 1 n = 1 ∏ t = 1 n P ( x t ∣ x < t ) n \begin{aligned} \text{PPL}(\mathbf{X}) &= [P(x_1, x_2, \cdots, x_n)]^{-\frac{1}{n}}\\ &= [P(x_1)P(x_2|x_1)\cdots P(x_n|x_1,\cdots, x_{n-1})]^{-\frac{1}{n}} \\ &= \sqrt[n]{\frac{1}{\prod_{t=1}^n P(x_t|x_{<t})}} \end{aligned} PPL(X)​=[P(x1​,x2​,⋯,xn​)]−n1​=[P(x1​)P(x2​∣x1​)⋯P(xn​∣x1​,⋯,xn−1​)]−n1​=n∏t=1n​P(xt​∣x<t​)1​ ​​

  • 这种写法直接强调了困惑度与整个序列概率之间的关系:
    • 若模型对整句赋予较高的联合概率 → 困惑度较小
    • 若模型对序列整体“难以置信” → 困惑度较大

3. 两种视角的统一理解

  • 交叉熵视角:
    困惑度是“平均每个 token 的不确定性”的指数形式

  • 联合概率视角:
    困惑度是“序列整体概率的归一化逆量”

    二者在数学上完全等价,只是强调角度不同。

​ 因此,困惑度并不是一个新的概念,而是对平均不确定性的另一种表达方式,可以被理解为:模型在预测下一个词元时,平均需要在多少种可能性中做选择。

五、困惑度的直观理解

参考知乎文章示例:LLM评估指标困惑度的理解

​ 假设我们的测试文档只有一句话:

“爱你就像爱生命。”

​ 词表(token)只有 7 个:

tokens_map = {
    '爱': 0,
    '你': 1,
    '就': 2,
    '像': 3,
    '生': 4,
    '命': 5,
    '。': 6,
}

1. 模型输出概率矩阵

​ 使用 GPT 类模型生成句子时,通常会得到形状为 [句子长度, 词表长度] 的概率矩阵。对于我们当前的示例,句子长度 = 8(“爱 你 就 像 爱 生 命。” 一共 8 个词元),词表长度 = 7(词表 tokens_map 有 7 个 token)。

​ 所以矩阵就是 8 行 7 列,每一行对应一个词元的预测情况,每一列对应词表中的某个词。

​ 假设有两个模型 A 和 B,其预测概率如下:

# modelA
probs_modelA = [
    [0.16, 0.16, 0.16, 0.16, 0.16, 0.16, 0.04], 
    [0.05, 0.30, 0.05, 0.40, 0.05, 0.10, 0.05], 
    [0.30, 0.05, 0.30, 0.20, 0.05, 0.05, 0.05], 
    [0.20, 0.10, 0.05, 0.50, 0.05, 0.05, 0.05], 
    [0.30, 0.30, 0.05, 0.05, 0.10, 0.15, 0.05], 
    [0.05, 0.05, 0.05, 0.15, 0.35, 0.30, 0.05], 
    [0.05, 0.05, 0.05, 0.15, 0.05, 0.60, 0.05],
    [0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.70]
]

# modelB
probs_modelB = [
    [0.16, 0.16, 0.16, 0.16, 0.16, 0.16, 0.04], 
    [0.05, 0.50, 0.05, 0.20, 0.05, 0.10, 0.05], 
    [0.30, 0.05, 0.40, 0.10, 0.05, 0.05, 0.05], 
    [0.10, 0.10, 0.05, 0.60, 0.05, 0.05, 0.05], 
    [0.40, 0.30, 0.05, 0.05, 0.10, 0.05, 0.05], 
    [0.05, 0.05, 0.05, 0.15, 0.40, 0.25, 0.05], 
    [0.05, 0.05, 0.05, 0.15, 0.05, 0.60, 0.05],
    [0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.70]
]

​ 其中,第 t t t行表示模型在当前时间步(生成第 t t t个词元时),对词表中的每个词的预测概率。此外,注意第 2 个词元的概率分布是条件概率,依赖于前面生成的词。

2. 取句子中实际词元的概率

​ 计算句子概率序列(取每个时间步真实词元的预测概率)。

​ 下表列出了每个词元在模型预测下的概率,便于直观对比模型 A 和 B 的预测能力:

词元A概率B概率
爱0.160.16
你0.300.50
就0.300.40
像0.500.60
爱0.300.40
生0.350.40
命0.600.60
。0.700.70

第 1 个词元是 爱(token 0),对应 probs_modelA 的第 0 行第 0 列 → 0.16

第 2 个词元是 你(token 1),对应第 1 行第 1 列 → 0.30

第 3 个词元是 就(token 2),对应第 2 行第 2 列 → 0.30

​ 可以直观地看到,模型 B 对大部分词元的预测概率更高。

3. 计算句子联合概率

​ 模型生成整个句子的概率为各词元概率连乘:
P ( X ) = ∏ t = 1 n P ( x t ∣ x < t ) P(\mathbf{X}) = \prod_{t=1}^nP(x_t|x_{<t}) P(X)=t=1∏n​P(xt​∣x<t​)
​ 为了避免数字过小,可以取 log ⁡ \log log 或 log ⁡ 2 \log_2 log2​计算。

  • 模型A: P ( X ) A = log ⁡ 2 ( 0.16 × 0.30 × 0.30 × 0.50 × 0.30 × 0.35 × 0.60 × 0.70 ) = − 11.62 P(\mathbf{X})_{A} = \log_2(0.16 \times 0.30\times 0.30\times 0.50 \times 0.30 \times 0.35 \times 0.60 \times 0.70)=-11.62 P(X)A​=log2​(0.16×0.30×0.30×0.50×0.30×0.35×0.60×0.70)=−11.62

  • 模型B: P ( X ) B = log ⁡ 2 ( 0.16 × 0.50 × 0.40 × 0.60 × 0.40 × 0.40 × 0.60 × 0.70 ) = − 9.59 P(\mathbf{X})_B = \log_2(0.16 \times 0.50 \times 0.40 \times 0.60 \times 0.40 \times 0.40 \times 0.60 \times 0.70)=-9.59 P(X)B​=log2​(0.16×0.50×0.40×0.60×0.40×0.40×0.60×0.70)=−9.59

    可以看到$P(\mathbf{X})_A < P(\mathbf{X})_B $ ,这说明模型B生成这句话的概率更高。

​ 这个结果我们可以理解为模型B可能是一个作家,相对更容易写出这样的句子,模型A是一个刚入门的作者,很难写出这样的句子。所以在这个测试集下B比A好。

4. 计算困惑度

​ 根据困惑度公式:
PPL ( X ) = 1 ∏ t = 1 n P ( x t ∣ x < t ) n \begin{aligned} \text{PPL}(\mathbf{X}) &= \sqrt[n]{\frac{1}{\prod_{t=1}^n P(x_t|x_{<t})}} \end{aligned} PPL(X)​=n∏t=1n​P(xt​∣x<t​)1​ ​​

  • 模型 A: PPL ( X ) A ≈ 3.28 \text{PPL}(\mathbf{X})_A \approx 3.28 PPL(X)A​≈3.28

  • 模型 B: PPL ( X ) B ≈ 2.56 \text{PPL}(\mathbf{X})_B \approx 2.56 PPL(X)B​≈2.56

    数值越小 → 模型越自信、越不困惑 → 模型 B 优于模型 A

六、结语

​ 困惑度(Perplexity, PPL)衡量了语言模型在预测序列时的“心智状态”:数值越小,表示模型在每一步预测下一个词元时更自信、备选方案更少,也就是越不困惑。

​ 可以想象你在玩一个写句子的小游戏:每写一个词,你心里都有一堆备选单词。困惑度就是告诉你平均每一步有多少个备选词。

NLP知识点 - perplexity 困惑度 语言模型(language model)是用来预测句子中的next word的概率分布(probability distribution),并计算一个句子的概率。一个好的语言模型,应该给well-written 的句子更高的生成概率,阅读这些句子不应该让人感到困惑。比较这句话的概率与当前语言模型生成的其他句子的概率,来判定生成句子的好坏呢?答案是否定的,因为句子的最终概率是单词概率连乘得到的,所以随着句子长度的增加,概率会越来越小。因为是概率的倒数,所以困惑度越低,句子概率越高,语言模型就越好。 阅读详情

相关推荐

语言模型?

以下将从语言模型的定义、分类、构造与评价方法,以及实际应用场景等方面,为你详细讲解语言模型的相关知识:

mayaohao的博客 893

LLM(大语言模型)常用评测指标-困惑度(Perplexity)

困惑度(Perplexity)是自然语言处理(NLP)中常用的一种评估语言模型的指标。它衡量的是模型对测试数据的预测能力,即模型对测试集中单词序列出现概率的预测准确度。困惑度越低,表示模型对数据的预测越准确。

qq_36485259的博客 9264

LLM评估陷阱:为什么BLEU/ROUGE正在扼杀模型理解力

大语言模型评估的核心矛盾,本质是‘文本相似度’与‘任务有效性’的错位。BLEU、ROUGE等传统指标源于2002年机器翻译场景,依赖n-gram重叠或子序列匹配,天然奖励词汇复刻而非概念转译;当模型需完成科普解释、医疗共情或法律通俗化等意图驱动型任务时,高分反成理解失能的信号。其技术价值在于工程可复现性,但代价是系统性忽视事实准确性、逻辑连贯性与用户认知适配性。真实应用场景中,教育需验证学生后测提升,客服依赖首解率,医疗关注误诊率下降——这些业务结果才是评估的终极锚点。本文聚焦LLM评估范式迁移,揭示指标幻

adr5970的博客 409

LLM评估指标:困惑度(Perplexity, PPL)

困惑度衡量的是一个概率模型。

qq_54708219的博客 1928

AI科学发现瓶颈:大语言模型为何难以实现溯因推理与理论创新

在人工智能与机器学习领域,大语言模型(LLM)凭借强大的知识记忆、关联和演绎推理能力,已成为处理复杂任务的重要工具。其核心原理基于海量数据的模式识别与概率预测,能够高效完成代码生成、文本归纳等任务,展现出显著的技术价值。然而,当应用场景转向需要创造性科学发现时,如提出全新理论假设,当前模型面临关键瓶颈——溯因推理能力的缺失。这涉及从观察现象逆向推断最佳解释的思维跃迁,是科学创新的核心。本文聚焦于这一瓶颈,探讨大语言模型在实现“溯因跃迁”上的局限与前沿突破路径,为构建具备知识创造潜力的下一代AI系统提供洞见。

weixin_32181267的博客 341

别再手动切换了!用SP3485+三极管搞定RS485自动收发电路(附完整原理图)

本文详细介绍了如何利用SP3485芯片和三极管设计RS485自动收发电路,解决传统手动切换带来的IO资源占用和软件复杂度问题。通过原理分析、电路设计拆解和实战注意事项,帮助工程师打造稳定可靠的自动收发通信模块,显著提升系统性能和可靠性。

weixin_26833939的博客 509

LLM评估有哪些指标? ROUGE 分数、BLEU、困惑度、MRR、BERTScore

此外,它不是一个单一的分数,而是计算召回率、准确率和 F1,这被称为 ROUGE-Recall、ROUGE-Precision 和 ROUGE-F1。(Bilingual Evaluation Understudy,双语评估替补),它评估输出与 Ground Truth 的相似程度(因此与 Perplexity 不同,需要 Ground Truth),主要用于机器翻译问题。***基本 LCS 的问题:***基本 LCS 测量在两个文本中以相同顺序出现的最长单词序列的长度,但不区分连续匹配和分散匹配。

stephen147的博客 4041

EMC案例:解决千兆网口RTL8211F EMI问题

摘要:本文分析了Amlogic S812平台OEM项目中RTL8211F-CG千兆网卡EMI辐射超标问题。发现百兆测试时25MHz时钟有3dB余量,但千兆125MHz时钟导致超标。问题根源包括:未关闭PHY芯片悬空CLKOUT引脚、TX/RXCLK端RC位置错误、包地不完整及参考地缺失。解决方案涉及软件关闭无用时钟、优化RC布局、加强包地与打孔、调整共模电感位置,并在HDMI 3.3V加磁珠。关键结论指出千兆网125MHz时钟需严格包地打孔,且RC取值需平衡EMI与通信性能。

电子绿洲的博客 1276

一文详解困惑度(PPL)

简单来说,困惑度是用于衡量概率模型(特别是语言模型)好坏的一个指标。它的核心思想是:对于一个训练好的语言模型,它在面对一段真实的、人类书写的文本时,会感到有多“意外”或多“困惑”。

weixin_41413777的博客 825

OpenWRT端口转发与NAT环回冲突的排查与解决

本文详细解析了OpenWRT路由器中端口转发与NAT环回功能冲突导致的内网访问故障。通过生活化类比阐明两者工作原理,提供从基础诊断到内核参数调整、LuCI选项配置及手动编写iptables规则的多套解决方案,并给出进阶排查思路,帮助用户彻底解决内网无法通过公网地址访问服务的常见问题。

weixin_29243279的博客 505

RH850从0搭建Autosar开发环境【23】- Davinci Configurator之DCM实操实现DID的读取写入

RH850从0搭建Autosar开发环境【23】- Davinci Configurator之DCM实操实现DID的读取写入,结合Developer实现

weixin_42412049的博客 1807

收藏必备!大模型能力评估体系详解:指标、方法与实践

本文系统介绍了大语言模型的评估指标与方法。评估指标涵盖分类任务(准确率、精确率等)、语言模型(交叉熵、困惑度)和文本生成(BLEU、ROUGE)三大类。评估方法包括人工评估(贴近人类判断但成本高)、大语言模型自评(高效但依赖评估模型质量)和对比评估(适用于模型性能比较)。文章详细分析了各类方法的优缺点、适用场景及实施细节,为全面评估大模型能力提供了实用指南。

2401_85375186的博客 1178

4.6 知识库使用指南:如何让AI Agent拥有专业知识

本文介绍了如何为AI Agent构建和使用知识库。知识库的作用是为Agent提供专业知识,包含文档、数据和规则,可用于专业问答和知识检索。使用方法包括创建知识库(上传文档)、向量化处理、知识检索以及在Agent中的应用。核心要点是理解知识库的价值和使用流程。文章还提出了构建方法、检索优化和应用实践等思考题,建议准备高质量数据、优化检索效果并持续更新知识库。下节将介绍用LangGraph构建复杂AI应用。

yonggeit的博客 3007

语言模型(Language Model)介绍

摘要: 语言模型是NLP的核心技术,通过计算文本概率评估其合理性。主要分为四类:统计语言模型(如N-gram,基于频率统计)、神经语言模型(如RNN,利用词向量捕捉语义)、预训练语言模型(如BERT,通过微调适配任务)和大语言模型(如GPT-4,具备强大生成能力)。N-gram模型基于马尔科夫假设,但面临数据稀疏问题,需通过平滑技术解决。神经网络模型能处理长距离依赖,泛化能力更强。评价指标以困惑度(PPL)为主,值越低模型越好。典型应用包括语音识别、输入法等,通过优化文本序列选择提升结果准确性。

feffsdsfdsfd的博客 1801

传统方式部署 Hadoop 高可用集群

传统方式部署 Hadoop 高可用集群

寂夜了无痕的博客 265

AutoCAD中圆弧折线化方法与实现

在AutoCAD中,圆弧折线化是将圆弧曲线转换为由一系列线段组成的折线曲线的过程。本文将介绍如何使用LISP编写代码来实现圆弧折线化,并提供相应的源代码。上述示例代码将生成一个以坐标原点为圆心、起点为(5.0, 0.0, 0.0)、终点为(0.0, 5.0, 0.0)、半径为5.0、角度为90度的圆弧的折线表示。通过使用上述的LISP代码,你可以在AutoCAD中实现将圆弧转换为折线的功能。你可以根据需要修改代码中的参数来适应不同的圆弧转换需求。函数,并传入圆弧的起点、终点、圆心、半径和角度参数。

VcuOcaml的博客 1417

从直觉到数据:构建LLM产品系统化评估框架的实践指南

在人工智能和机器学习领域,模型评估是确保技术有效性与可靠性的基石。其核心原理在于通过量化指标替代主观判断,将模糊的性能感知转化为可比较、可复现的客观数据。这一过程的技术价值在于驱动产品持续优化、降低风险,并实现从实验原型到稳定服务的工程化落地。在大型语言模型(LLM)等生成式AI的应用场景中,评估尤为复杂,需兼顾生成质量、逻辑一致性、安全性及成本效率等多重维度。本文聚焦于如何超越直觉检查,通过建立涵盖能力、质量、性能、稳定性及长期监控的多维度评估框架,并借助自动化工具与人工校准相结合的混合策略,构建一个能够

weixin_34296641的博客 313

SAP 经营范围(Operating Concern) 和业务范围 (Business Area) 在核算架构或是管理架构中的区别和联系分别是什么 请给具体的示例

摘要:SAP系统中,业务范围(Business Area)和经营范围(Operating Concern)在核算架构中具有不同功能。业务范围是FI/CO共用维度,用于跨公司码的业务线核算(如电子产品、机械设备),支持内部管理和简单对外报表。经营范围则是CO-PA专属维度,聚焦获利能力分析,可细化到产品+客户+区域组合(如分析手机在华东区域的获利情况)。两者存在层级关联:经营范围包含业务范围作为基础维度,业务范围数据会传递至经营范围进行深度分析。实际应用中需先配置业务范围,再设置经营范围并关联相关维度,共同支

金牌架构师 94

提升LLM效率的第三路径:连续自回归语言模型(CALM)!

本文介绍了一种名为CALM的连续自回归语言模型新范式,通过将传统模型逐字生成转变为一次预测包含K个词的连续向量,实现了生成步数的指数级减少。文章提出高保真自动编码器实现词块与向量的无损转换,并创新性地解决了连续向量预测中的"无可能性"问题,包括能量损失训练方法、BrierLM评估指标和无可能性温度采样算法。实验证明,CALM在显著降低计算成本的同时,能够达到与传统Transformer相当甚至更好的性能,开辟了提升LLM效率的全新路径。

Trb201013的博客 783

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

AI伪人鉴定指南:从文本困惑度到行为轨迹的全链路排查

人工智能生成内容(AIGC)正在深刻改变信息生产的方式,大语言模型产出的文本、评论乃至对话已难辨真假。面对这一挑战,“伪人识别”成为内容安全与风控领域的新焦点。其在技术原理上并不依赖玄学,而是建立在可统计的文本特征之上:困惑度(Perplexity)衡量文本的意外程度,突发性(Burstiness)反映句子节奏的波动,模型水印则提供了可溯源的机器信号。这些指标构成了一套从静态文本到动态行为的检测维度。工程实践中,单一指标往往容易被对抗样本绕过,因此需要将统计特征、分类器概率、行为轨迹等多信号融合,配合人工复

weixin_29090677的博客 324

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

AI辅助同行评审:从检测到人机协同的工程实践

学术出版领域正面临投稿量激增与审稿人资源稀缺的双重压力,大语言模型的普及更让同行评审面临新的挑战。AI生成内容与人工写作的边界日益模糊,单纯依赖检测工具已无法解决问题。构建一套可解释、可审计的辅助评审系统成为学术信息化的关键方向。本文从文本特征分析、困惑度检测、语义向量匹配等基础技术切入,探讨如何利用大语言模型生成评审要点,并结合审稿人语义匹配实现智能分发。文章强调人机协同的决策机制,展示了从数据预处理到风险检测、匹配推荐、意见汇总的完整工程链路,为科研人员、期刊编辑和系统开发者提供了可落地的技术参考,帮助

weixin_30550081的博客 1176

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

基于LLM与Shapley值的多智能体知识扩散仿真建模实践

多智能体系统是模拟复杂社会与组织行为的重要计算框架,其核心在于构建具有自主决策能力的智能体模型。传统基于规则的智能体往往决策逻辑僵化,难以模拟人类在模糊信息和复杂语境下的真实交互。大语言模型凭借其强大的上下文理解与生成能力,为智能体赋予了拟人化的“大脑”,使得仿真过程更加贴近现实。结合形式化规范对交互协议与行为边界进行约束,可以确保仿真的可控性与可解释性。这种技术融合的价值在于,能够为研究知识传播、团队协作等动态过程提供高保真的计算实验平台。通过引入合作博弈论中的Shapley值,可以量化评估每个智能体对群

weixin_30785593的博客 718

NLG评估指标全解析:从BLEU到BERTScore的演进与应用实战

自然语言生成(NLG)评估是衡量机器生成文本质量的关键环节,其核心原理在于量化生成文本与人类期望文本之间的相似度。传统方法如BLEU和ROUGE基于词重叠统计,计算高效但难以跨越“词汇鸿沟”。随着预训练语言模型的发展,基于语义的评估指标如BERTScore应运而生,它利用上下文向量计算语义相似度,能有效识别同义表达,极大提升了评估与人类判断的相关性。在工程实践中,评估指标的技术价值在于为模型迭代提供客观、可量化的依据,直接影响损失函数优化、架构选择和数据增强等决策。针对不同应用场景,需构建多维评估体系:机器

ciya3282的博客 314

高校“宁愿没有AI”?教育评价体系如何应对大模型冲击

大语言模型的文本生成能力正在深刻影响高等教育评价体系,传统依赖提交物判断学生能力的模式面临失效。本文从AI文本生成的统计特征入手,解析困惑度与突发性等检测算法原理,指出AI检测工具在学术场景中的概率性局限。面对这一技术变革,高校需要从“对抗AI”转向“重构评价”,通过过程性评价、答辩验证、AI使用审计等工程化手段,建立更可信的学术诚信机制。文章结合教育信息化实践,探讨了适用于高校教师、开发者及学生的技术方案,为应对大模型时代的教学评价挑战提供了可落地的参考路径。

weixin_34050005的博客 309

大语言模型的意识幻觉:从人机对话实验解码AI自我指涉机制

意识并非AI的内在属性,而是一种在特定交互情境中被诱发的语言现象。当前大语言模型不具备主观体验或具身感知能力,其表现出的‘类意识’响应,本质是统计建模、指令微调与人类对话期待共同作用的结果。技术原理上,这类响应依赖于注意力机制对语义场的几何邻近检索、RLHF奖励函数对拟人化表达的隐性优化,以及上下文窗口对用户认知姿态的敏感捕捉。其核心价值在于揭示模型行为边界,支撑可信AI设计——如客服系统的可信度仪表盘、教育AI的认知诚实度开关、法律文书的责任隔离协议。本文聚焦‘自我指涉’与‘认知边界’两大热词,通过可复现

weixin_34161032的博客 680
上一篇: 【深度学习】Hidden vs Latent:神经网络与概率模型中两个“隐”的本质区别
下一篇: 【深度学习原理】深入理解梯度爆炸(Gradient Explosion)及解决方案
未收敛
博客等级 码龄11年 3303粉丝 163原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

未收敛

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值