


大模型如何获得Agent能力
这是一个非常核心的问题。让我从训练方法论的角度拆解,大模型如何获得Agent能力。
一、能力分层:不同能力来自不同训练阶段
┌─────────────────────────────────────────────────────────────┐
 │                    Agent 能力金字塔                          │
 ├─────────────────────────────────────────────────────────────┤
 │                                                             │
 │         ┌─────────────────┐                                 │
 │         │   自主决策能力   │  ← RL / RLHF / 结果导向训练      │
 │         │  (何时做什么)    │                                 │
 │         └────────┬────────┘                                 │
 │                  │                                          │
 │         ┌────────▼────────┐                                 │
 │         │   工具使用能力   │  ← SFT on Tool Use Data         │
 │         │  (如何调用工具)  │                                 │
 │         └────────┬────────┘                                 │
 │                  │                                          │
 │         ┌────────▼────────┐                                 │
 │         │   推理规划能力   │  ← CoT SFT + 推理强化            │
 │         │  (分析和规划)    │                                 │
 │         └────────┬────────┘                                 │
 │                  │                                          │
 │         ┌────────▼────────┐                                 │
 │         │   基础语言理解   │  ← 大规模预训练                  │
 │         │  (理解指令/文档) │                                 │
 │         └─────────────────┘                                 │
 │                                                             │
 └─────────────────────────────────────────────────────────────┘
二、各阶段训练方法详解
阶段1:预训练 → 基础理解与知识
目标:让模型理解语言、积累知识、初步具备推理能力
方法:
-
海量文本的 Next Token Prediction
-
包含代码、文档、教程、论坛讨论等多样数据
对Agent能力的贡献:
预训练数据中包含:
 ├── 技术文档 → 理解工具/API的能力
 ├── 代码仓库 → 理解代码结构的能力
 ├── 问答论坛 → 问题诊断和解决的模式
 ├── 教程文章 → 步骤化执行的模式
 └── 错误日志 → 错误识别和修复的模式
关键洞察:模型在预训练阶段已经"见过"大量的 问题 → 调试 → 解决 的模式,这是后续能力的基础。
阶段2:SFT(监督微调)→ 工具使用与格式遵循
目标:让模型学会正确的工具调用格式和交互模式
训练数据构造:
// 工具使用的训练样本
 {
   "messages": [
     {"role": "system", "content": "你可以使用以下工具:[bash, read_file, write_file]"},
     {"role": "user", "content": "帮我看看当前目录有什么文件"},
     {"role": "assistant", "content": "我来查看当前目录。
 <tool_call>
 {\"name\": \"bash\", \"args\": {\"command\": \"ls -la\"}}
 </tool_call>"},
     {"role": "tool", "content": "total 24
 drwxr-xr--x  5 user  staff   160 Jan 10 10:00 .
 drwxr-r--r--  1 user  staff   256 Jan 10 09:00 README.md
 drwxr-r--r--  1 user  staff  1024 Jan 10 09:30 main.py"},
     {"role": "assistant", "content": "当前目录包含:
 - README.md:项目说明文件
 - main.py:Python主程序文件"}
   ]
 }
关键技巧:
| 技巧 | 做法 | 目的 |
|---|---|---|
| 格式一致性 | 所有样本用统一的工具调用格式 | 模型输出稳定可解析 |
| 思考链保留 | 调用工具前先说明意图 | 提高决策可解释性 |
| 结果整合 | 工具返回后要总结/分析 | 形成完整的交互闭环 |
| 多轮对话 | 包含多步骤任务的完整轨迹 | 学习任务分解和状态跟踪 |
阶段3(续):推理能力强化
方法1:CoT(Chain-of-Thought)微调
训练样本结构:

 User: 这个函数有bug,运行时报错 IndexError

 Assistant(训练目标):
 <thinking>
 让我分析这个问题:
 1. IndexError 通常是数组越界
 2. 需要检查所有数组访问的地方
 3. 特别关注循环边界条件和空数组情况
 4. 我应该先看一下具体的代码
 </thinking>

 我来帮你分析这个bug。首先让我查看相关代码。
 <tool_call>{"name": "read_file", ...}</tool_call>
为什么有效:显式的思考过程让模型学会"先想后做",而不是直接跳到答案。
方法2:规划能力专项训练
构造"任务分解"的训练数据:
User: 帮我把这个单体应用拆分成微服务

 Assistant(训练目标):
 这是一个复杂任务,让我制定一个计划:

 ## 执行计划

 ### 第一阶段:理解现状
 - [ ] 分析现有代码结构
 - [ ] 识别核心业务模块
 - [ ] 梳理模块间依赖关系

 ### 第二阶段:设计拆分方案
 - [ ] 确定服务边界
 - [ ] 设计服务间通信方式
 - [ ] 规划数据拆分策略

 ### 第三阶段:逐步实施
 - [ ] 从依赖最少的模块开始
 - [ ] 每拆一个服务就验证功能
 - [ ] 保持向后兼容

 让我从第一阶段开始...
阶段4:失败处理与自我纠错 → 核心难点
这是最关键也最难训练的能力。几种主要方法:
这是Agent可靠性的关键——不是不犯错,而是能从错误中恢复。
方法1:失败轨迹SFT(Failure Trajectory Learning)
核心思想:训练数据必须包含完整的"尝试→失败→分析→修正→成功"轨迹
{
   "trajectory": [
     {"role": "user", "content": "修复登录功能的bug"},
     {"role": "assistant", "content": "让我先运行测试看看具体错误...", "tool_call": "bash: npm test"},
     {"role": "tool", "content": "FAIL: LoginTest - TypeError: Cannot read property 'token' of undefined"},
     {"role": "assistant", "content": "看到token未定义。我检查一下认证逻辑...", "tool_call": "read_file: auth.js"},
     {"role": "tool", "content": "function login(user) { return api.post('/login', user) }"},
     {"role": "assistant", "content": "问题找到了:login没有返回token。让我修复...", "tool_call": "write_file: auth.js"},
     {"role": "tool", "content": "File written successfully"},
     {"role": "assistant", "content": "修复完成,重新运行测试验证...", "tool_call": "bash: npm test"},
     {"role": "tool", "content": "FAIL: LoginTest - Expected token to be string, got object"},
     {"role": "assistant", "content": "还有问题,返回的是对象而非字符串。需要提取token字段...", "tool_call": "write_file: auth.js"},
     {"role": "tool", "content": "File written successfully"},
     {"role": "assistant", "content": "再次验证...", "tool_call": "bash: npm test"},
     {"role": "tool", "content": "PASS: All tests passed"},
     {"role": "assistant", "content": "问题已修复。根本原因是login函数返回了完整响应对象而非token字符串。"}
   ]
 }
关键要点: - 第一次修复失败,模型继续分析而非放弃 - 每次失败后有明确的错误分析 - 修正策略基于错误信息调整,而非随机重试
方法2:结果导向强化学习(Outcome-Based RL)
核心思想:用最终结果作为奖励信号,让模型学会"什么策略能最终成功"
奖励设计:

 任务完成度:
 ├── 完全成功(测试全过)    → +1.0
 ├── 部分成功(部分测试过)  → +0.5
 ├── 失败但有进展           → +0.1
 └── 完全失败/放弃          → -0.5

 过程奖励(可选):
 ├── 合理的错误分析         → +0.1
 ├── 有效的修正策略         → +0.1
 └── 无意义的重试           → -0.1
训练流程:
1. 给模型一个任务
 2. 模型自主尝试(可能多次失败重试)
 3. 根据最终结果给予奖励
 4. 用PPO/DPO等算法更新模型

 关键:奖励的是"最终成功",而非"每一步正确"
      这让模型学会为了最终目标而容忍中间失败
方法3:对比学习(Contrastive Learning on Trajectories)
核心思想:让模型区分"好的失败处理"和"差的失败处理"
正例(好的处理):
 遇到错误 → 分析错误信息 → 定位根因 → 针对性修复 → 验证

 负例(差的处理):
 遇到错误 → 随机修改代码 → 再次失败 → 继续随机改 → 放弃
 遇到错误 → 不看错误信息 → 凭猜测修改 → 问题扩大
 遇到错误 → 立即向用户求助 → 没有自主尝试
DPO训练:
同一个任务,收集多条处理轨迹
 人工标注或自动判断哪条更好
 用DPO让模型偏好更好的处理方式
方法4:环境交互强化(Interactive Environment Training)
核心思想:在真实或模拟环境中训练,而非静态数据
训练设置:

 ┌─────────────────────────────────────────────────┐
 │                  训练循环                        │
 │                                                 │
 │  ┌─────────┐     ┌─────────┐     ┌─────────┐   │
 │  │  模型    │────→│  环境   │────→│  反馈   │   │
 │  │ (Agent) │     │(沙箱/模拟)│     │ (奖励)  │   │
 │  └────▲────┘     └─────────┘     └────┬────┘   │
 │       │                               │        │
 │       └───────────────────────────────┘        │
 │                                                 │
 └─────────────────────────────────────────────────┘

 环境类型:
 ├── 代码沙箱:真实的编译器/运行时反馈
 ├── 模拟API:返回真实格式的成功/错误响应
 ├── 虚拟文件系统:可读写的文件环境
 └── 合成任务:自动生成的bug/任务用于训练
优势: - 反馈是真实的,不是人造的 - 可以大规模生成训练场景 - 模型学到的是"真正有效的策略"
三、感知环境的训练方法
方法1:多样化感知数据
训练数据覆盖各种环境状态:

 ├── 不同项目结构(monorepo/多包/单文件)
 ├── 不同语言/框架
 ├── 不同状态(干净/有未提交修改/冲突)
 ├── 不同规模(10文件 vs 10000文件)
 └── 不同信息密度(详细注释 vs 无注释)
方法2:探索策略训练
训练模型学会"高效探索":

 正例:
 - 先看README了解项目概况
 - 根据任务类型定位相关目录
 - 用搜索快速找到关键代码

 负例:
 - 逐个文件阅读(低效)
 - 不看结构直接搜索(可能遗漏)
 - 获取过多信息(超出上下文窗口)
方法3:信息提取训练
给模型"信息压缩"的能力:

 输入:大量原始环境信息
 输出:与当前任务相关的关键摘要

 训练样本:
 - 看了10个文件 → 提取与bug相关的3个关键点
 - 搜索返回50个结果 → 识别最相关的3个位置
四、训练技巧总结
| 能力 | 训练方法 | 数据要点 |
|---|---|---|
| 工具调用 | SFT | 格式统一、覆盖所有工具、包含思考过程 |
| 任务规划 | CoT SFT | 显式分解步骤、包含长任务轨迹 |
| 失败处理 | 失败轨迹SFT + RL | 必须包含失败→恢复过程、多次重试样本 |
| 环境感知 | 多样化环境SFT | 覆盖各种项目类型和状态 |
| 自主决策 | RL / RLHF | 结果导向奖励、过程奖励辅助 |
五、实践建议
如果你要为自己的领域训练/微调Agent能力:
1. 数据构造优先级
最重要 → 最不重要:

 1. 失败恢复轨迹(最稀缺最有价值)
 2. 多步骤完整任务轨迹
 3. 工具调用格式数据
 4. 单轮问答数据
2. 合成数据策略
# 自动生成训练数据的思路

 def generate_training_data():
     # 1. 创建一个有bug的代码环境
     env = create_buggy_codebase()

     # 2. 用强模型(如Claude/GPT-4)解决问题
     trajectory = strong_model.solve(env)

     # 3. 记录完整轨迹作为训练数据
     # 包括所有的尝试、失败、修正
     return trajectory

 # 关键:保留失败的中间步骤,不要只要最终成功路径
3. 评估指标
不只看最终成功率,还要看:

 ├── 首次尝试成功率(反映规划能力)
 ├── 平均重试次数(反映纠错效率)
 ├── 错误后恢复率(反映韧性)
 ├── 任务放弃率(反映坚持度)
 └── 步骤效率(反映探索策略)
如何抢占先机,拥抱 Agent?
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
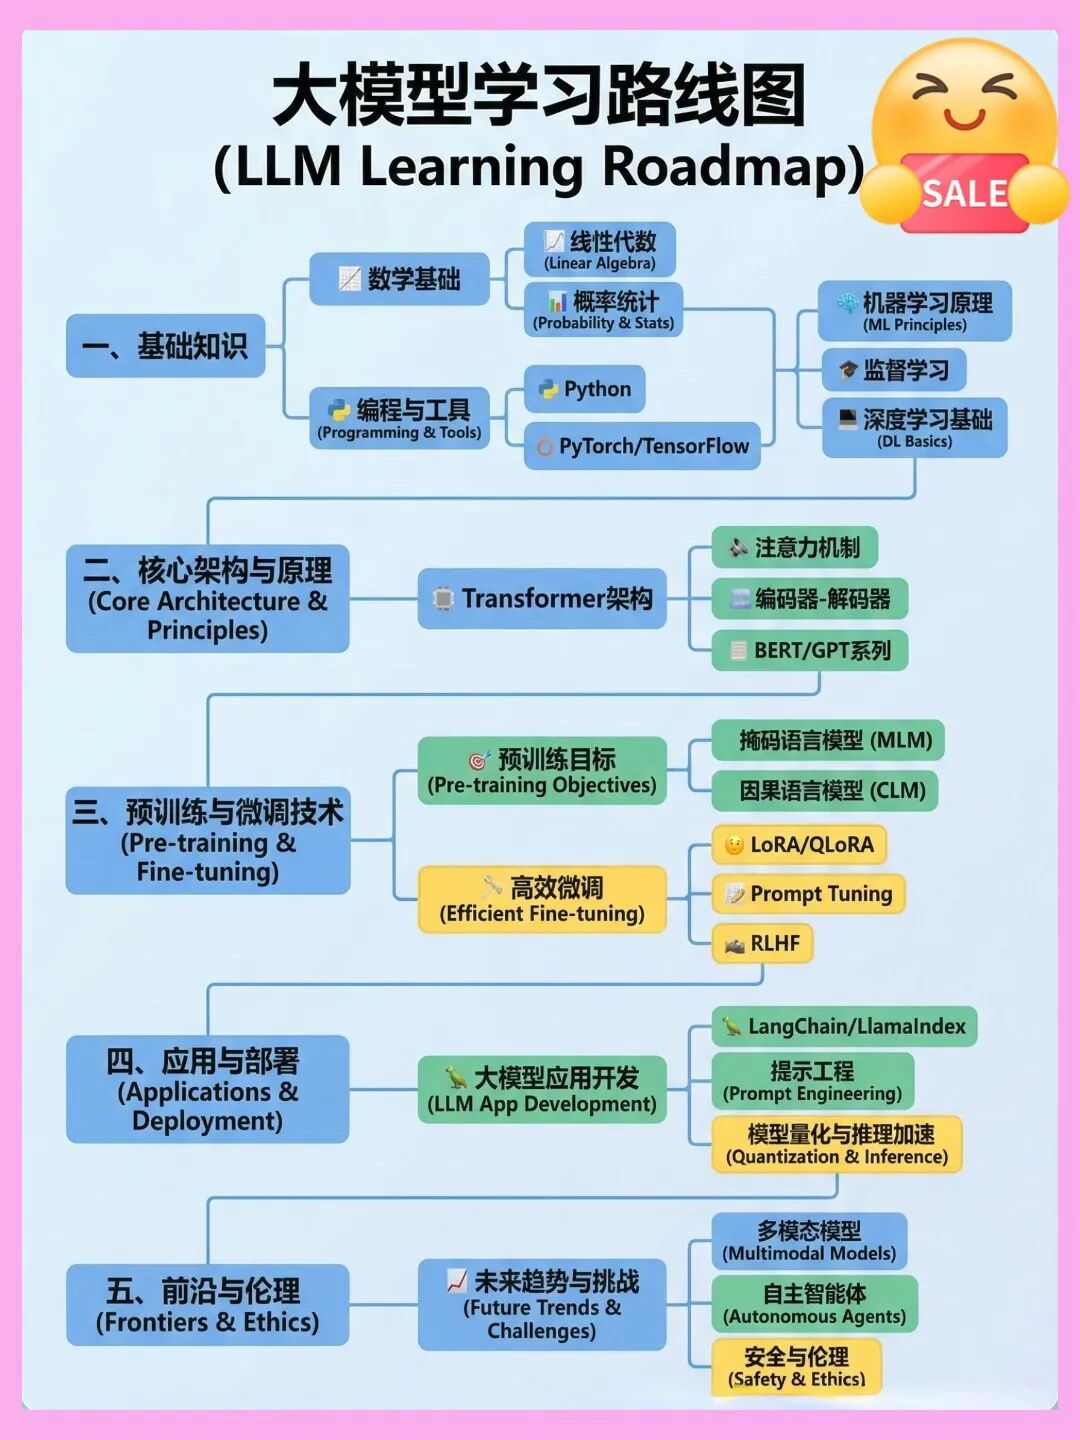
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取