


本来想了解一下RAG,没想到连Agent和MCP也一起搞清楚了,现在放在一起,用大白话说说。
话说大模型本身只会说话————大模型全称是语言大模型(直译是大语言模型,Large Language Model, 简写LLM),其本质是用海量的文本资料训练,让它用统计学的方法得出,对于用户的输入,最靠谱的回答是什么。是的,大模型本身只会说话,你问它一个问题,它给出回答,仅此而已。
要让大模型真正有用,需要在两个方面增强它。
第一个方面,是大模型的知识结构“广而不精”。它的知识结构可谓是“上知天文、下知地理”,什么都懂。然而到具体应用到专业领域时候,某个窄领域的专业知识,可能它的知识储备还是不够,或者某些知识是组织的内部知识库里的,并不对外开放,所以大模型的训练资料库不可能覆盖到。这个问题有两种解决方法,第一个办法是微调,非常有实力的单位,拿专业的领域知识重新训练大模型。这种方法要求太高,不在本次讨论范围之内。第二种方法叫RAG(Retrieval Augmented Generation, 检索增强生成,这个名词听起来有点不知所谓,后者逐步介绍)。RAG的想法非常朴素,就是既然大模型“广而不精”,我在问它问题时候,同时把包含相关知识的文字资料直接喂给它,让它自己综合文字资料的内容再回答我的问题,这样回答的质量就很高了,这就是所谓的增强生成(Augmented Generation),大模型理解文字资料、重新组织语言的能力还是很高的。后一种方法很好,然而需要解决的问题,是如何在提问的同时提供相关的文字资料。如果是让用户自己去找相关的资料并提交,大模型只是做一个综合,那么这大模型的应用的效率就大打折扣了。解决的方案是预先构建一个专业的知识库,把专业的知识内容都存在知识库里面。用户使用时候根据用户的问题,自动匹配最相关的知识内容,和问题一起提交给大模型。
如何根据用户的问题,自动匹配最相关的知识内容呢?总不能把整个知识库都提交过去,那内容太庞大了,超出了大模型的处理能力。答案是文本的向量化,在存储知识内容的时候,除了存储知识内容的文本文字,还存储了知识内容的向量化结果。而在回答用户问题时候,也将用户问题的文本内容也同样做向量化处理,然后搜索数据库,用知识的向量匹配问题的向量,向量距离最近的几条记录,即为和用户问题最相关的知识内容,这就是检索 (Retrieval)。(至于什么是文本文字的向量化,为什么向量距离最近的即为最相关的内容,感兴趣的可以去搜索学习)。
这里边的知识点,有嵌入(Embedding)模型,很多大模型都有Embedding版本,专门用来处理文本的向量化。有向量数据库,传统关系型数据库有向量化扩展(如pg_vector),也有专门的向量数据库(Milvus / Chroma)。
语言大模型的第二个局限性,是它是一个绝对的君子,只会动口,不会动手。你问它一个问题,他给你一个答案,而且这答案,是它训练时的资料里就有的,除此以外都不知道。要让一个应用程序真的有用,我们需要让大模型“做”点事情。比如最早的大模型辅助编程,就是使用网页版本的大模型对话框,用户输入描述,让大模型在对话框里输出源代码,然后用户再手工拷贝到原始文件里做修改,这样的效率太低了,要是大模型能直接修改原始文件就好了。用户问大模型今天天气怎么样的时候,大模型应该会自己去主动连接网络上提供天气信息的接口查询天气,然后返回天气结果。
Agent(智能体)设计用来解决这个问题。大致的情景如下:我们建立一个Agent,后端连接大模型,前端连接用户,并且内置有有关的Tool(工具)。Agent将用户的问题传达给大模型时候,顺便告诉大模型,我这里都有哪些工具可用。大模型分析用户的问题并回答,答案里直接包含了对工具调用,然后根据工具的执行结果,决定下一步继续让大模型处理还是直接返回结果给用户。
再举辅助编程的例子,我们让大模型实现某个功能的时候,会由Agent告诉大模型,我这里有工具可以读取原文件和修改文件。于是大模型经过分析要实现的功能,然后输出指令,去读取某个文件。我们的读取工具会读取文件内容传递给大模型。大模型综合文件内容,决定修改哪个位置以及如何修改,再由修改文件工具做实际的修改。
而对于查询天气的例子,我们的Agent会告诉大模型,我们有个查询天气工具,然后大模型初次产生的回答,就包含了对查询天气工具的调用,然后把查询结果再送给大模型润色后输出。
不过这里智能体的工具,是特定于某个智能体的,不能做到通用。如果某个第三方开发了一个非常有用的工具,他肯定想让对所有的智能体都可用。MCP就是这个通用的协议,用MCP协议开发的工具,可以被所有支持MCP协议的智能体使用。
相关的工具/框架,首先是LangChain,LangChain对常见的大模型/向量数据库/嵌入模型等都做了封装,同样一个代码,稍加修改就可用于平替到替代品,LangChain需要自己写代码控制。然后是LangFlow,LangFlow是将LangChain封装起来,以可视化/拖放方式开发应用(所谓的低代码或无代码开发,有点当年用Delphi的感觉),很容易上手。不过就我试验的结果,LangFlow的成熟度不够高,发生过属性明明设置了自己丢失等等大大小小的问题。其他还有注重于RAG的UltraRAG/FlashRAG等,另外LlamaIndex感觉定位和LangChain类似。
也有几个专注于大模型前端界面的值得提一下:Open-WebChat / LibreChat / AnythingLLM,基本内容都是要安装以后设置自己的大模型/嵌入模型/向量数据库后端,然后就可以上传文件以及聊天。
如何抢占先机,拥抱 Agent?
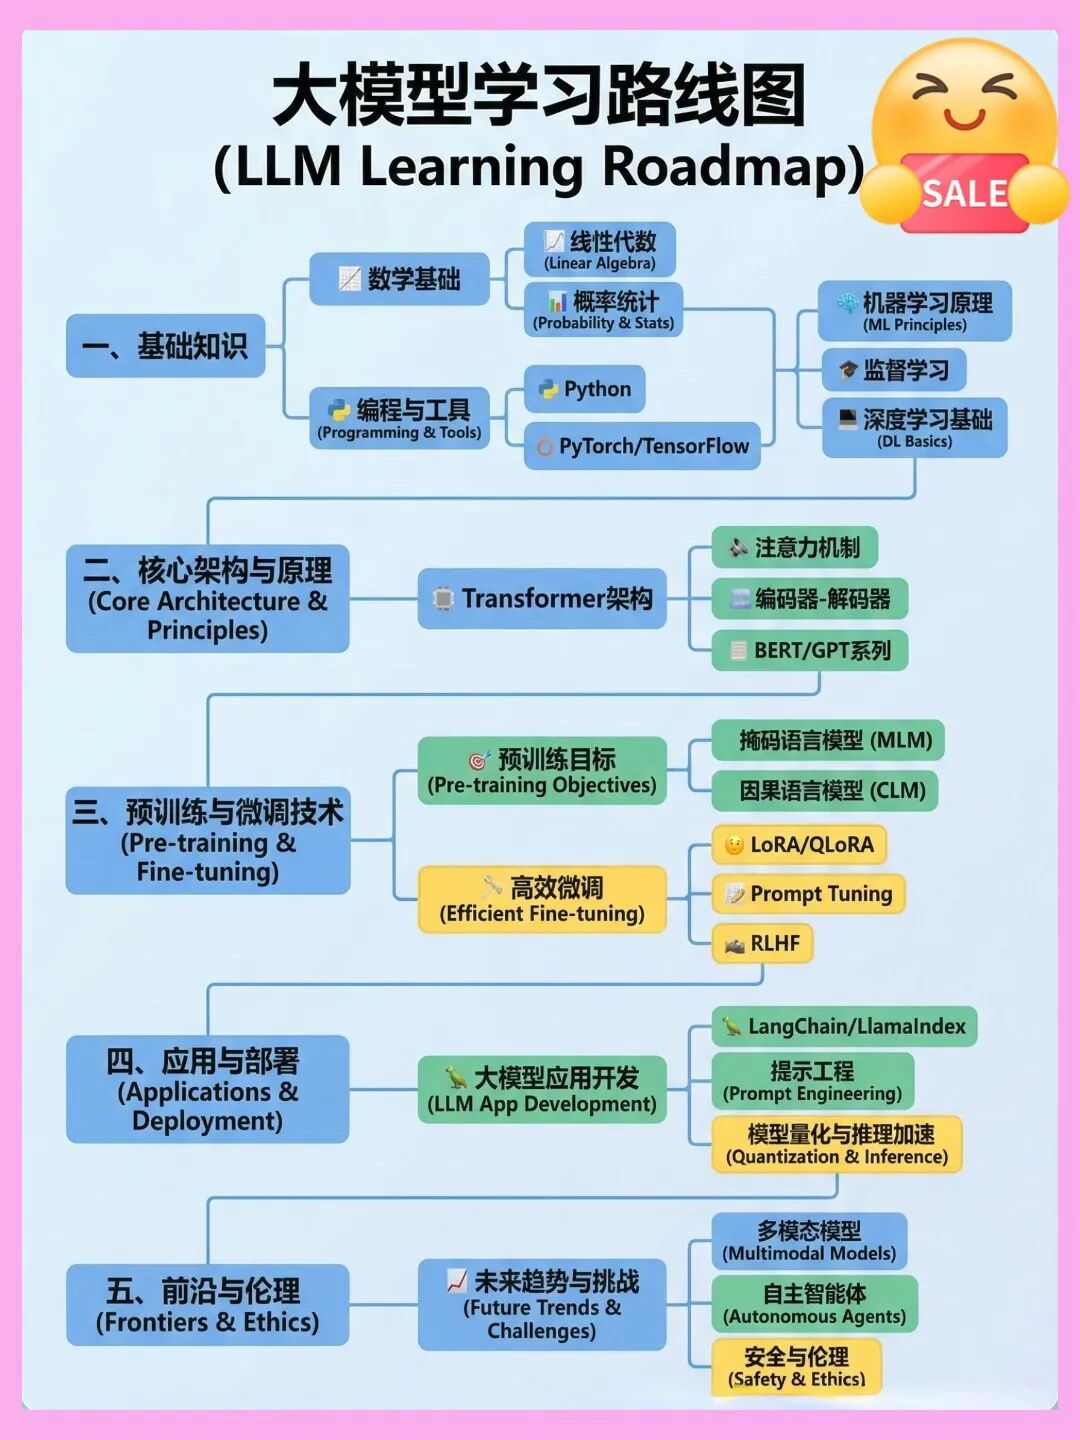
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取