


LLM与Agent
现在是AI的时代,大模型如火如荼,旁边同事张口大模型,闭口Agent,耳朵快磨出老茧了,趁着这股劲儿,也是学习学习大模型的知识吧。
1
什么是大模型
大模型(Large Language Model,LLM)本质上是一个数学模型,核心就是通过海量的数据,基于深度学习训练出来的一个"具有思考能力的"知识大脑。可以理解和生成人类语言,具备一定的推理和创作能力。
优点
理解人类语言+具备思考能力=解放人类的一些简单性的、可替代的工作。
缺点
理解人类意图却无法主动发起事件的触发,换句话说大模型(后续以LLM简称)只能在海量数据训练的基础上进行检索思考总结,并无法执行一些动作。
现在国内外很多大厂基本大模型就是标配,目前市面上比较流行的大模型以及厂家如下,只是列出一部分:

2
什么是Agent
因为LLM不具备执行的能力,所以在LLM的加持下,配合着上下文记忆、工具以及方法(本地/远端)调用,任务规划等等动作,形成一台完整的可闭环的执行链,并且在这个闭环中可以有Agent自行决策也可以加入人类的决策。
agent执行过程:

一个简单的Agent的创建过程,实例代码用python+langchain.
from langchain.agents import create_agentfrom langchain_openai import ChatOpenAIimport dotenv#加载配置文件dotenv.load_dotenv()llm = ChatOpenAI(api_key=os.getenv("DASHSCOPE_API_KEY"),model='qwen3-max',base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",temperature=0.9)agent = create_agent(model=llm)agent.invoke({"messages": [{"role": "user", "content": "你是谁"}]})
因为LLM是基于一定的数据训练的,所以数据具有一定的时效性,并且对于人类的多变的需求也无法单独靠LLM就可以搞定,所以Agent的可扩展的能力是尤为关键。
记忆能力
LLM是没有记忆能力的,但是在多轮对话的场景下需要记忆能力,以便于更好的分析和给出更加准确的答案。
记忆分为短期记忆(short-term Memory,STM,历史对话等)和长期记忆(long-term Memory,LTM,历史的任务经验等)。
上网能力
LLM的知识是有范围边界的,并且LLM本身没有上网的能力,所以Agent可以结合上网的工具来检索LLM本地知识以外的数据。
本地方法调用/MCP
MCP即Model Context Protocol(模型上下文协议)的缩写,一种AI大模型与外部系统交互的接口协议。比如LLM想查询今天某地的天气预报或者导航信息,LLM自己是无法实现的,可以调用远程的一些服务接口(墨迹天气或者高德地图的接口)来达到目的。这样一来AI大模型也就可以与原先的系统进行很好的融合和接入了。并不会因为引入大模型而摒弃原先的系统。
RAG
RAG 是 Retrieval-Augmented Generation(检索增强生成) 的缩写。如果想搭建某个细小的专业领域的知识库,不希望这部分数据被外界感知,只供内部系统使用,那么则可以搭建一个企业内部RAG知识库,实现数据的隐私性。兵且RAG无需对大模型进行微调,如果数据更新,则只需要对RAG库进行更新即可,在成本方面也是非常友好的。
3
一个多Agent的案例
在任务比较复杂的场景下,单Agent可能无法实现完整的效果,这时候就需要多个Agent来协同完成复杂的任务。一般一个Agent完成单一的工作。
多Agent的场景比单Agent的场景多了决策分类即子任务执行哪个Agent,兵且最后把结果进行汇总反馈的步骤。如果是串行的场景,则上一个Agent的输出是下一个Agent的输入。
举个栗子:
需求描述:实现一个AI客户端,客户端的功能有:1、可以帮我实现规划出行计划;2、基本本地的数据,实现对对联的功能;3、可以利用大模型给我讲一个笑话。(案例参考网络上一个例子)。
实现设计:
利用Agent来实现此功能。可以划分为3部分:1、利用现有的MCP出行计划服务来实现规划的功能;2、利用Embeddibng向量化存储和加载,来实现相似度的检索和模型调用;3、直接利用大模型来实现讲笑话的功能。

涉及到的技术点:
1、LLM
2、Agent
3、Langraph以及图的概念
4、RAG、Embedding
5、MCP
代码太多,只放一些核心实现部分吧。
# 图的状态class State(TypedDict):messages: Annotated[list[str], add]type: str# 超级助手,决策节点def super_visor_node(state: State):prompt = """你是一个非常专业的客服助手,现在需要对用户的问题进行分类并将任务分给其他的Agent执行。如果用户的问题是和旅游路线规划相关的,那就返回 travel。如果用户的问题是和讲笑话相关的,那就返回 joke。如果用户的问题是希望对一个对联,那就返回 couple。如果是其他问题,那就返回other。除了上述几个选项之外,不要返回其他额外的内容。"""prompts = [{"role": "system", "content": prompt},{"role": "user", "content": state["messages"][0]}]# 如果属性中有type,说明是返回的,直接结束即可if "type" in state:writer({"super_visor_step": f"以获得结果结果:{state['type']}"})return {"type": END}else:response = llm.invoke(prompts)type_res = response.contentwriter({"super_visor_step": f"问题分类的结果:{type_res}"})if type_res in legal_nodes:return {"type": type_res}else:raise ValueError("type is not in ('travel', 'joke', 'couple', 'other','super_visor')")def travel_node(state: State):prompt = """你是一个非常专业的旅行助手,根据用户的需求规划出比较完美的出行计划,请用中文回答。字数不超过200字。"""prompts = [{"role": "system", "content": prompt},{"role": "user", "content": state["messages"][0]}]# os.environ["TAVILY_API_KEY"] = os.getenv("TAVILY_API_KEY")# https://docs.tavily.com/documentation/integrations/langchain# tavily第三方免费的MCP服务search = TavilySearch(tavily_api_key='api_key',max_results=5)search_tool = Tool(func=search.run,name="search",description="互联网搜索引擎")agent = create_react_agent(model=llm,tools=[search_tool])res = agent.invoke({"messages": prompts})return {"messages": [AIMessage(content=res["messages"][-1].content)], "type": "travel"}def joke_node(state: State):joke_prompt = """你是一个非常专业的笑话大师,现在根据用户的信息将一个字数在200字以内的笑话。"""joke_prompts = [{"role": "system", "content": joke_prompt},{"role": "user", "content": state["messages"][0]}]joke_res = llm.invoke(joke_prompts)return {"messages": [joke_res], "type": "joke"}def couple_node(state: State):query = state["messages"][0]prompt_template = ChatPromptTemplate.from_messages([("system","""你是一个专业的对联大师,现在需要你根据用户给出的上联,对出下联。回答时可以参考下述的参考对联。参考对联:{sample}请用中文回答"""),("user","{text}"),])samples = couplet_rag(query)couplet_prompt = prompt_template.invoke({"sample":samples,"text":query})couplet_res = llm.invoke(couplet_prompt)return {"messages": [couplet_res], "type": "couple"}def other_node(state: State):return {"messages": [HumanMessage(content="暂时我还无法回答您的问题呢,要不换个问题再试试吧~")], "type": "other"}# 构建图builder = StateGraph(State)# 添加节点,即各个子模块任务builder.add_node("super_visor_node", super_visor_node) #builder.add_node("travel_node", travel_node) # 旅游助手builder.add_node("joke_node", joke_node) # 写玩笑助手builder.add_node("couple_node", couple_node) # 对对联助手builder.add_node("other_node", other_node) # 其他# 条件边选择def routing_fun(state: State):route_type = state["type"]if route_type == "super_visor":return "super_visor_node"elif route_type == "travel":return "travel_node"elif route_type == "joke":return "joke_node"elif route_type == "couple":return "couple_node"elif route_type == END:return ENDelse:return "other_node"# 添加边builder.add_edge(START, "super_visor_node")builder.add_conditional_edges("super_visor_node",routing_fun,["travel_node", "joke_node", "couple_node", "other_node", END])# 各个模块处理完交给super_visor_node处理builder.add_edge("travel_node", "super_visor_node")builder.add_edge("joke_node", "super_visor_node")builder.add_edge("couple_node", "super_visor_node")builder.add_edge("other_node", "super_visor_node")# 构建graphcp = InMemorySaver()graph = builder.compile(checkpointer=cp)# RAG数据加载#... 此处省去一万字,展示关键部分embedding_model = DashScopeEmbeddings(model='text-embedding-v4')vector_store = InMemoryVectorStore(embedding_model)#...省去 读取本地文件数据,即参考文件vector_store.add_texts(batch_texts)#...# 相似度检索res_doc = vector_store.similarity_search_with_score(query, k=10)
将上述代码画成图即如下所示:
png_bytes = graph.get_graph().draw_mermaid_png(background_color="white")# 保存到文件with open('graph_output.png', 'wb') as f:f.write(png_bytes)print("图片已保存为 graph_output.png")

对于像这种需要多个任务或者多个环节的任务,可以利用Langraph的图的概念来实现完成,串成一整个任务,然后根据一些特定的条件来做执行策略。
如何抢占先机,拥抱 Agent?
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
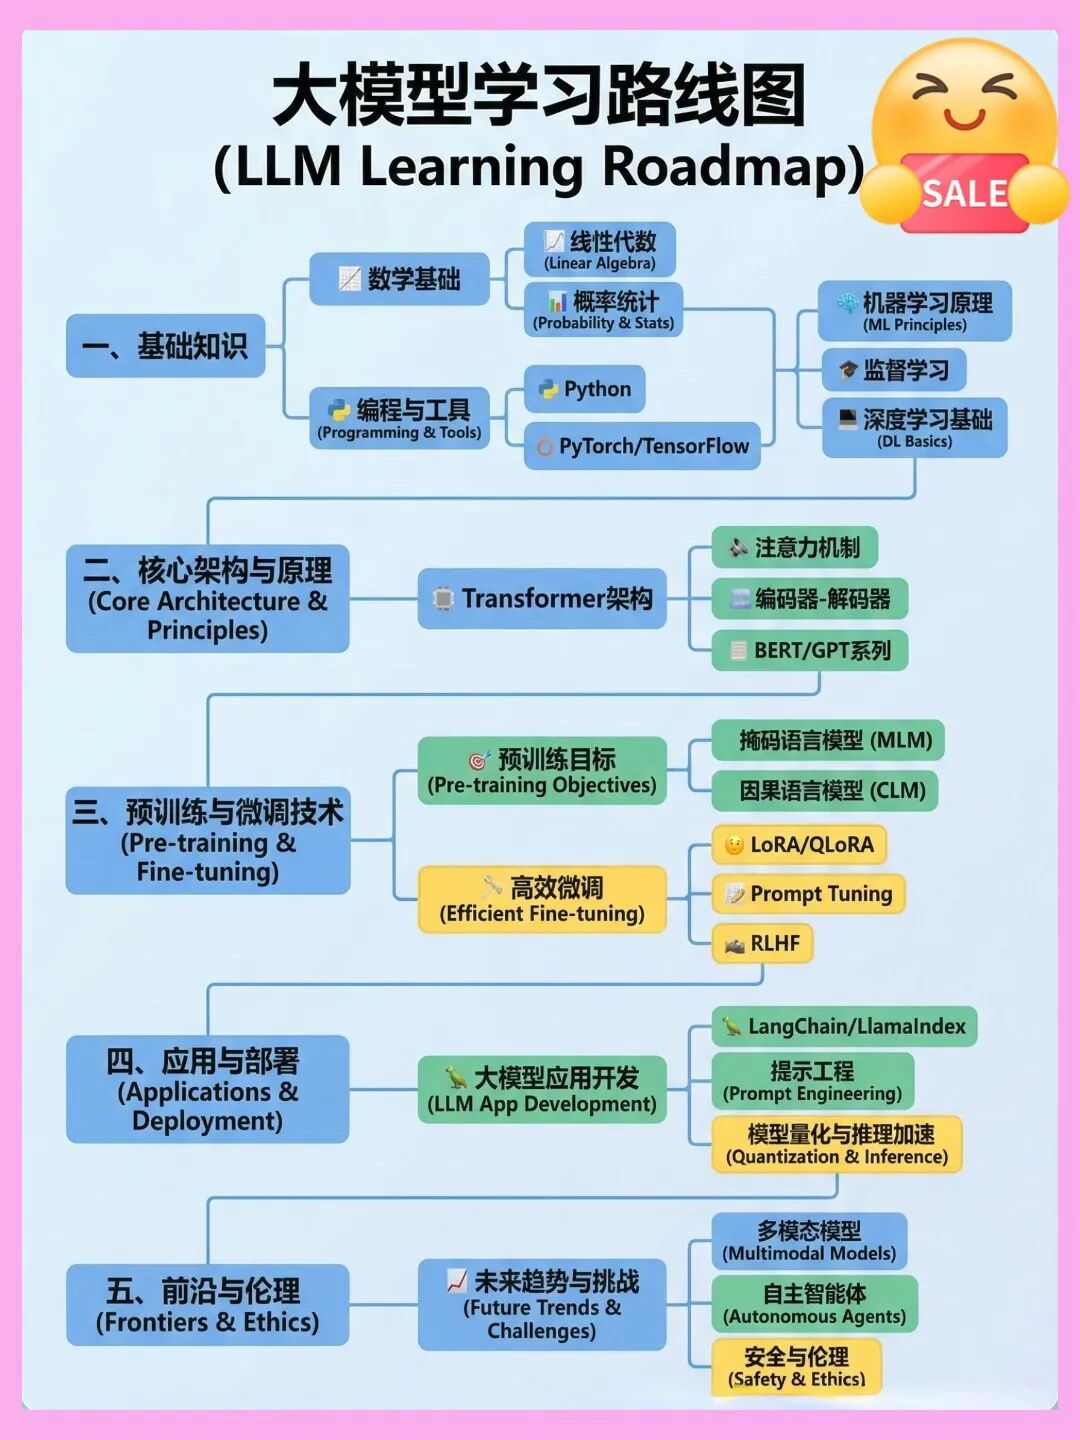
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取