RAG优化大法:20+招式助你玩转大模型应用!从零基础到精通,收藏这篇就够了!

检索增强生成(RAG) 优化策略篇 本文详细介绍了检索增强生成(RAG)技术的各个优化策略,包括文档块切分、文本嵌入模型、提示工程、大模型迭代、架构优化、索引优化、索引数据优化等多个方面。通过这些优化策略,RAG 技术在处理复杂查询和生成信息丰富回应方面展示了巨大的潜力。未来,RAG 技术将在垂直优化、横向扩展以及生态系统构建等方面继续发展,为多领域应用提供更低的训练成本和更优的性能表现。 阅读详情

RAG优化大法:20+招式助你玩转大模型应用!

大语言模型(LLMs)已经火到出圈,简直成了我们工作和生活中的“万金油”!它们聪明又全能,和信息的互动方式都被它们给颠覆了。

不过,可别以为LLMs就无敌了。它们有时候也会“抽风”,给你整出些“幻觉”,要么就是抱着过时的信息不撒手,遇到专业问题就“掉链子”,逻辑推理能力也时常让人捉急。

在现实世界中,数据得像“窜天猴”一样更新,生成的内容还得像“玻璃罩”一样透明可追溯,不然成本控制和数据隐私就都成了“老大难”。所以,光靠这些“黑盒”模型可不行,咱得有更精细的“武器”来应对这些挑战。这不,检索增强生成技术(Retrieval-Augmented Generation,RAG)就闪亮登场了,成了LLM时代的“弄潮儿”!

基础RAG架构

瞅瞅上图,基础RAG架构的流程简单得就像“1+1=2”,最大的特点就是数据单向流通。搭个这样的系统快得很,但离真正“上战场”还差得远呢。想要让这套系统召回文档更准、更“皮实”,有两条路子:一是多找几条“腿”走路(增加召回管道),二是加上“反馈机制”。增加召回管道就像“子查询”、“rag-fusion”、“混合检索”,多路召回,把召回率拉满;增加反馈机制就像“rerank”、“后退提示”、“self-rag”,优化原始结果,把准确率提上去。

这么一搞,RAG架构的数据和信息就不再是“单行道”了,而是“四通八达”、“并驾齐驱”。

进阶RAG结构

为了让大家看得更清楚,咱就按照数据流动的方向,从文本预处理、文本分块、嵌入、检索和生成这几个环节,挨个儿说说这些优化方法。

文本数据“整容术”

不管RAG系统多复杂,数据驱动的特性决定了,数据质量得高!检索之前,原始数据得这么优化:

  1. 实体解析:给实体和术语“正名”,消除歧义,统一说法。比如,把“LLM”、“大语言模型”、“大模型”都叫“大模型”,多省事!
  2. 文档划分:不同主题的文档,得像“分院帽”一样,分得清清楚楚。要是人眼都分不清哪个文档能回答问题,检索系统也“没辙”。
  3. 数据增强:用同义词、换个说法,甚至用“外语”翻译,让知识库更“丰满”。
  4. 处理特殊数据:比如那些“时效性”强的数据,对于更新快的主题,得有个机制让过时的文档“下岗”或者“翻新”。
  5. 增加元数据:给内容加个“摘要”、盖个“时间戳”、想想用户可能问啥问题,这些都能让知识库更“有料”。

文本分块“切西瓜”

通常,被检索的知识库里的数据量,比LLM能接受的输入长度大得多,所以“切西瓜”(Chunking)得讲究技巧,既不能超出LLM的“胃口”,还得保证块和块之间有区别,块内部又得“拧成一股绳”。当然,这是最理想的状态,现实中,可能有些文档像“散文”,段落之间没啥明显区别,段落内部又特别“散”,整篇文档还特别长。咱也不可能提前就把文本按内容切得“天衣无缝”,毕竟下游还有LLM这样的“聪明”模型呢,咱提供的块不过是“提示”。但咱还是得尽量提供有用的信息,别给LLM添乱。所以,可以试试这些高级的“切西瓜”方法:

  1. 句子分割:用NLTK或者spaCy库的句子分割功能,主流开发框架如langchain都集成了,直接“拿来主义”。
  2. 递归分割:像“套娃”一样,重复应用分块规则,把文本“大卸八块”。比如,在langchain中,先用段落换行符(\n\n)分割。然后看看这些块的大小,如果不超过“警戒线”,就留着。超过了,就用单换行符(\n)再切。以此类推,不断根据块大小更新更小的分块规则(比如空格,句号)。这种方法能灵活调整块的大小。比如,文本中信息“扎堆”的地方,可能需要切得更细;信息少的地方,就可以切得“粗犷”些。
  3. 语义分割:算算向量化后的文本的相似度,从语义层面“下刀”。
  4. 特殊结构分割:针对Markdown、LaTex、JSON这些“特殊”结构的内容,有专门的分割器,确保“原汁原味”。

“切西瓜”还有个重要的事儿,就是块的大小。除了嵌入模型,文档类型、用户查询的长度和复杂性,都影响着块的大小。处理长篇文章或书籍,大块头有助于保留更多上下文和主题连贯性;社交媒体帖子,小块头可能更适合捕捉每个帖子的“灵魂”。如果用户的查询通常简短又具体,小块头可能更合适;反过来,查询复杂,可能就需要大块头。实际操作中,咱可能还得不断“试错”,在一些测试中,128大小的块往往是“最佳选择”,没头绪的时候,可以从这个大小开始“摸索”。

嵌入“变身术”

接下来就是数据处理的“压轴戏”了,相当于数据的“类型转换”,就是用嵌入(Embedding)模型把文本数据变成向量(Vectorization),方便在检索阶段用向量检索(Vector Retrieval)。嵌入阶段有几个“加分项”:

  1. 尽量用动态嵌入:动态嵌入比静态嵌入更能处理“一词多义”。比如:“我买了一张光盘”,这里的“光盘”是圆盘;“光盘行动”里,“光盘”是把饭吃光,语义完全不一样。静态嵌入,向量是固定的。但引入自注意力机制的模型,比如BERT,能提供动态的词义理解,同一个词在不同语境下,向量也不同。
  2. 微调嵌入:大多数嵌入模型都是在通用语料上“修炼”的,有些项目为了让模型对垂直领域的词汇更“感冒”,会对嵌入模型“微调”,让模型对垂直领域词汇和通用词汇“一视同仁”,不“跑偏”。
  3. 混合嵌入:对用户问题和知识库文本用不同的嵌入模型。

查询优化“导航仪”

实际环境中,可能因为用户的表达“五花八门”或者“含糊不清”,导致检索时召回率和准确率“不给力”,这时候就得给查询“导航”一下,规范和丰富查询包含的信息,方便系统检索到相关的文档。查询优化有这么几招:

  1. 查询重写:让LLM或者用专门的“问题重写器”(通常是微调过的小Transformer)给用户的问题“改头换面”。
  2. 后退提示:让LLM提出一个关于高层次概念或原则的抽象通用问题(叫“后退”问题)。后退问题的抽象程度,得根据具体任务调整。最后,后退问题和原始问题一起检索。比如,问“Estella Leopold在1954年8月至11月期间上了哪所学校?”,这问题不好直接回答,因为时间限制太细。这时候,问个后退问题“Estella Leopold的教育经历怎么样的?”,就能帮系统检索。
  3. Follow Up Questions:用LLM针对历史对话和当前问题,生成一个独立问题。这招主要针对这些情况:a. 后续问题建立在前一次对话的基础上,或引用了前一次谈话。比如,用户先问“我在意大利能做什么”,然后问“那里有什么类型的食物”——如果只嵌入“那里有哪种类型的食物”,LLM就不知道“那里”在哪。b. 嵌入整个对话(或最后k条消息)。如果后续问题和之前的对话完全无关,可能会返回无关结果,分散LLM的注意力。
  4. HyDE:用LLM生成一个“假设”答案,把它和问题一起检索。HyDE的核心思想是,接收用户提问后,先让LLM在没有外部知识的情况下,生成一个假设性的回复。然后,把这个假设性回复和原始查询一起用于向量检索。假设回复可能“不靠谱”,但蕴含着LLM认为相关的信息和文档模式,有助于在知识库中找类似的文档。
  5. 多问题查询:基于原始问题,让LLM从不同角度“发问”,生成多个新问题或者子问题,用每个新问题检索,后续用RRF或者rerank合并不同问题的检索结果。比如,问“谁最近赢得了总冠军,红袜队还是爱国者队?”,可以生成两个子问题:a. 红袜者队上次赢得总冠军是啥时候?b. 爱国者队上次赢得总冠军是啥时候?

检索“寻宝图”

检索(Retrieval)的终极目标,就是找到最相关的文档,或者保证最相关的文档在找到的文档列表里。为了实现这个目标,有这么几招:

  1. 上下文压缩:文档块太大,可能包含太多“废话”,传递这样的文档块,可能导致LLM调用更贵,响应更差。上下文压缩,就是让LLM根据上下文,把单个文档内容“瘦身”,或者对返回结果“过滤”,只留下相关信息。
  2. 句子窗口搜索:反过来,文档块太小,会导致上下文“缺失”。有个解决方案叫窗口搜索,核心思想是,提问匹配好文档块后,把这块周围的块也当成上下文,一起交给LLM,让LLM对文档上下文理解更透彻。
  3. 父文档搜索:父文档搜索也是个类似的方案,先把文档分成尺寸更大的主文档,再把主文档分割成更短的子文档。用户问题和子文档匹配,然后把子文档所属的主文档发给LLM。
  4. 自动合并:自动合并是在父文档搜索上更复杂的方案。同样,先把文档“大卸八块”,比如按三层树状结构切割,顶层节点的块大小1024,中间层512,底层叶子节点128。检索时,只拿叶子节点和问题匹配,如果某个父节点下的大部分叶子节点都和问题匹配,就把这个父节点作为结果返回。
  5. 混合检索:RAG系统,本质上是开放域、基于自然语言的问答系统。为了获得开放式用户查询的高事实召回率,概括和聚焦应用场景,选择合适的检索模式或组合很重要。大多数文本搜索场景,主要目标是确保最相关的结果出现在候选列表里。混合检索,通过混合多个检索方法,实现不同检索技术的“强强联合”,最大化事实召回率。比如,可以用向量检索+关键词检索的组合,构建RAG系统的检索模块。
  6. 路由机制:建立了多个针对不同数据类型和查询需求的索引后,比如,有个索引专门处理摘要类问题,另一个专门应对直接寻求具体答案的问题,还有一个专门针对需要考虑时间因素的问题。这时候,就需要用路由机制,选择最合适的索引检索数据,提升检索质量和响应速度。
  7. 使用Agent:这招就是用Agent决定用啥检索方法,从不同的检索方法中选一个或多个召回。组合方式也灵活,可以是“垂直”关系,也可以是“平行”关系。比如,问“最新上映的科幻电影推荐”,Agent可能先把它“导”到专门处理当前热点话题的索引,然后利用专注于娱乐和影视内容的索引,生成相关推荐。

检索后处理“精修师”

检索后处理,概念很宽泛,就是对检索结果“精加工”,方便后续LLM更好地生成,典型的就是重排序(Rerank)。向量检索,其实就是算语义层面的相似性,但语义最相似,不一定最相关。重排模型,通过对初始检索结果进行更深入的相关性评估和排序,确保最终展示给用户的结果更符合查询意图。实现重排序,除了可以提示LLM重排,更多的是用专门的重排序模型(比如闭源的Cohere,开源的BAAI和IBM发布的模型)。这些模型会考虑更多特征,比如查询意图、词汇的多重语义、用户的历史行为和上下文信息,保证最相关的文档排在最前面。

生成“演说家”

生成(Generation)阶段的优化,更多的是考虑用户体验,有几点可以参考:

  1. 多轮对话:就是带聊天历史的RAG,AI搜索的“明星产品”perplexity就支持多轮对话,用户可以通过连续对话,深入了解解决某个问题。
  2. 增加追问机制:在prompt里加上“如果无法从背景知识回答用户的问题,则根据背景知识内容,对用户进行追问,问题限制在3个以内”。这招没啥技术含量,主要靠大模型的能力。不过能大大改善用户体验,用户在多轮引导中,逐步明确自己的问题,从而得到合适的答案。
  3. prompt优化:RAG系统中的prompt,应明确指出回答只基于搜索结果,不要加任何其他信息。比如,可以设置prompt:“你是一名智能客服。你的目标是提供准确的信息,并尽可能帮助提问者解决问题。你应保持友善,但不要过于啰嗦。请根据提供的上下文信息,在不考虑已有知识的情况下,回答相关查询。”当然,也可以根据场景需要,适当让模型的回答融入一些主观性或其对知识的理解。此外,用Few-shot的方法指导LLM如何利用检索到的知识,也是提升LLM生成内容质量的“妙招”。
  4. 用户反馈循环:基于现实世界用户的反馈,不断更新数据库,标记它们的真实性。

总结

上面这些方法,就是针对基础RAG在各个环节的“优化大法”。实际开发中,不是所有方法都有效,不同问题有不同的“解药”,针对应用场景选择合适的优化方法组合,才能最大限度发挥RAG的“威力”。

黑客/网络安全学习包

资料目录

  1. 成长路线图&学习规划

  2. 配套视频教程

  3. SRC&黑客文籍

  4. 护网行动资料

  5. 黑客必读书单

  6. 面试题合集

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

优快云大礼包:《黑客&网络安全入门&进阶学习资源包》免费分享

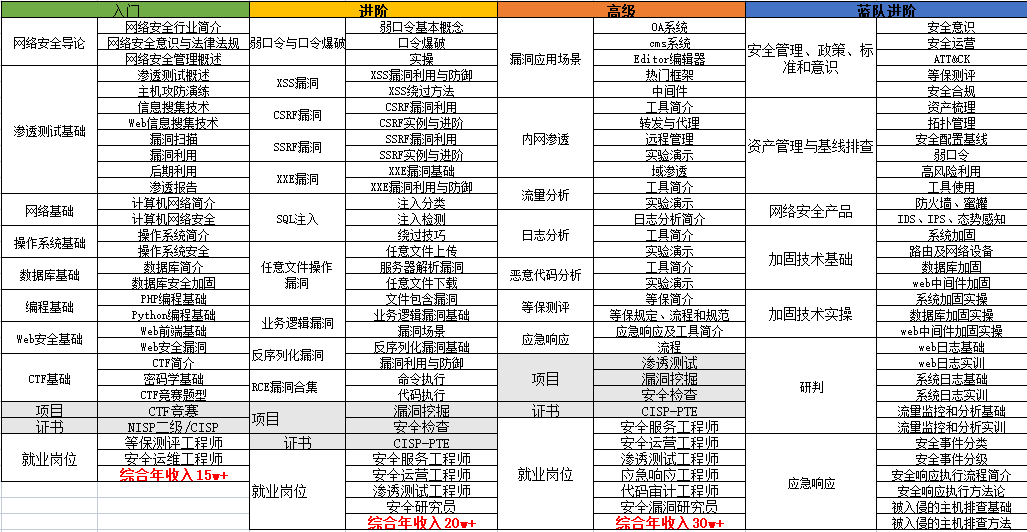
1.成长路线图&学习规划

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过网络安全的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

优快云大礼包:《黑客&网络安全入门&进阶学习资源包》免费分享

2.视频教程

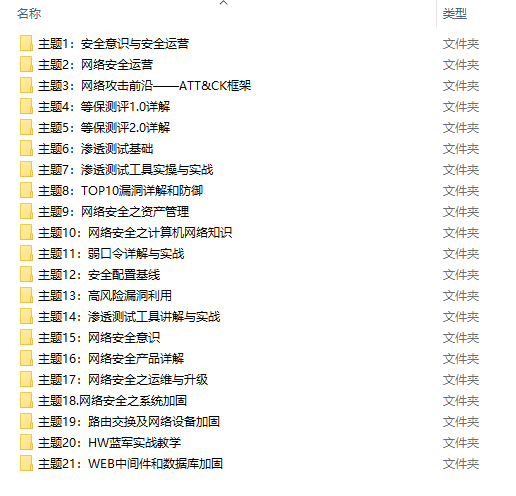
很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,其中一共有21个章节,每个章节都是当前板块的精华浓缩。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

优快云大礼包:《黑客&网络安全入门&进阶学习资源包》免费分享

3.SRC&黑客文籍

大家最喜欢也是最关心的SRC技术文籍&黑客技术也有收录

SRC技术文籍:
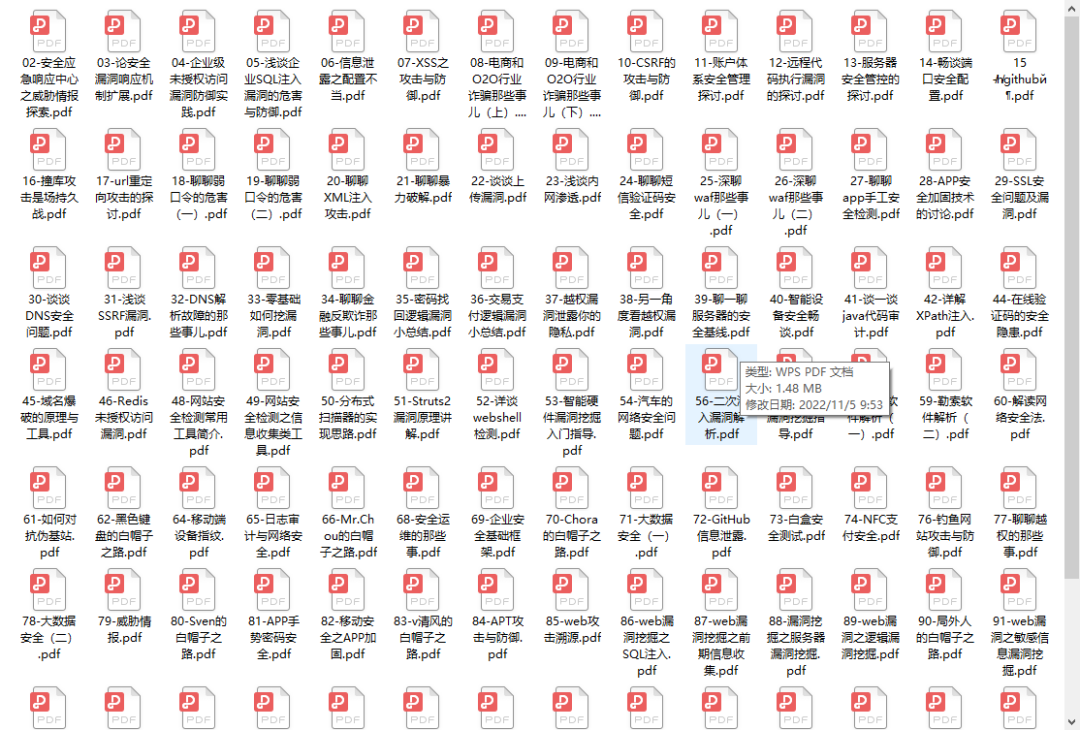
黑客资料由于是敏感资源,这里不能直接展示哦!

4.护网行动资料

其中关于HW护网行动,也准备了对应的资料,这些内容可相当于比赛的金手指!

5.黑客必读书单

**

**

6.面试题合集

当你自学到这里,你就要开始思考找工作的事情了,而工作绕不开的就是真题和面试题。
更多内容为防止和谐,可以扫描获取~

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

优快云大礼包:《黑客&网络安全入门&进阶学习资源包》免费分享

向量数据库华山论剑:AI开发者的选型指南 本文深度横评7大主流向量数据库技术特性与适用场景:FAISS是学术研究的"瑞士军刀",Pinecone提供开箱即用的云服务,Weaviate以模块化设计见长,Milvus适合K8s生产环境,ChromaDB专注快速原型开发,Qdrant支持高级过滤功能,Neo4j则实现图数据与向量的融合。各方案在索引算法(HNSW/IVF/PQ)、混合搜索、部署方式等方面呈现显著差异。作者建议根据数据规模、延迟要求、运维能力等维度选择,小型项目可从ChromaDB起步,复杂场景推荐混合架构。最后抛出开放性问题,邀请读者分享 阅读详情

相关推荐

gnuradio+b210实现FM收音机

gnuradio+b210实现FM收音机环境介绍FM接收1 Flow Graph2 变量参数FM发射1 Flow Graph 环境介绍 Name Version gnuradio 3.7.14.0 uhd 3.15.0.0 ubuntu 18.04 usrp b210 参考 https://www.ijedr.org/papers/IJEDR1702038.pdf Audio File Transmission using GNURADIO and USRP FM接

u011745228的博客 5123

一文彻底搞懂检索增强生成(RAG) 优化策略

本文详细介绍了检索增强生成(RAG)技术的各个优化策略,包括文档块切分、文本嵌入模型、提示工程、大模型迭代、架构优化、索引优化、索引数据优化等多个方面。通过这些优化策略,RAG 技术在处理复杂查询和生成信息丰富回应方面展示了巨大的潜力。未来,RAG 技术将在垂直优化、横向扩展以及生态系统构建等方面继续发展,为多领域应用提供更低的训练成本和更优的性能表现。读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用如果你是零基础小白,想快速入门大模型是可以考虑的。

2401_85379281的博客 5021

LWIP协议栈在STM32H7上的内存优化实战:如何用32KB RAM实现稳定千兆以太网通信

本文深入探讨了在STM32H7微控制器上,如何通过内存优化策略,在仅32KB的D2 SRAM中稳定运行LWIP协议栈以实现千兆以太网通信。文章详细分析了STM32H7的内存架构、LWIP的内存消耗瓶颈,并提供了从描述符表与PBUF池精确分配、链接脚本修改到MPU区域划分的一整套实战优化方案,旨在解决大数据量传输卡死等常见配置问题。

gg901的博客 603

一文详谈20多种RAG优化方法

以上这些方法就是针对基础RAG在各个环节的优化方法,在实际开发过程中并不是所有方法都是有效的,不同问题有不同的解决方案,针对应用场景选择合适的优化方法组合才能最大限度发挥RAG的作用。

m0_59164304的博客 3796

数据科学助力大数据领域的航空安全分析

随着航空业的快速发展,航班数量不断增加,航空安全问题日益受到关注。大数据时代的到来,使得航空领域积累了大量的数据,包括飞行数据、维护数据、气象数据等。本文章的目的在于探讨如何运用数据科学的方法和技术,对这些大数据进行分析,以提高航空安全水平。范围涵盖了从数据收集、预处理到数据分析、模型构建和应用的整个流程。本文将按照以下结构进行组织:首先介绍数据科学和航空安全分析的核心概念以及它们之间的联系;接着阐述核心算法原理和具体操作步骤,并使用Python源代码进行详细说明;

软件工程实践的博客 1291

YOLO11改进|卷积篇|引入多样化分支块DBB

YOLO11中添加多样化分支块DBB

A1983Z的博客 1443

【AI大模型】一文详谈RAG优化方案与实践,收藏这一篇就够了!!

RAG通过检索现有的大量知识,结合强大的生成模型,为复杂的问答、文本摘要和生成任务带来了全新的解决方案。本文详细的介绍了RAG遇到的挑战、通用范式、工程实践、优化实现策略等。

datian1234的博客 872

Python爬虫实战:高效爬取中国版权登记数据

本文将详细介绍如何使用Python最新技术栈构建一个高效、稳定的中国版权登记数据爬虫系统。我们将使用Playwright+Asyncio实现无头浏览器自动化,结合Redis分布式任务队列和MongoDB数据存储,打造一个能够应对反爬机制的企业级数据采集方案。文章包含完整代码实现、性能优化技巧以及法律合规建议,帮助开发者快速掌握大规模数据采集的核心技术。本文详细介绍了2024年使用Python最新技术栈构建中国版权登记数据爬虫的完整方案。基于Playwright的无头浏览器自动化。

2201_76125261的博客 1897

关于RAG优化的几个小技巧

在对知识库中文档内容进行切片时,是可以以该切片为假设条件,利用LLM预先设置几个候选的相关性问题的,也就是说,这几个候选的相关性问题是和切片的内容强相关的。另一方面,在实际的业务场景中,准确率可能是现阶段最重要的问题,业务人员对于应用的要求可能是90分,而LLM目前的能力只能达到60分,如果不能通过其它的方式提升效果,那么应用可能无法在实际场景中使用了。一种处理的方案是,通过分割和存储小块数据来实现,在检索过程中,它首先获取小块,然后查找这些块的父ID,并返回那些较大的文档。

python1234567_的博客 1660

PCL 基于强度的双边滤波【2026最新版】

基于强度信息的双边滤波代码实现、滤波前后点云未出现变化的原因以及获取带有强度pcd点云的方法。本文由优快云点云侠原创,博客长期更新,本文最近一次更新时间为:2026年5月24日。

点云侠的博客 29万+

在 TASKPROCESSING 上为 ABAP OData 服务添加多个系统别名:从原理到落地的完整实践

本文面向SAP Gateway与ABAP开发者,详细讲解如何在TASKPROCESSING OData服务上添加系统别名。首先介绍了系统别名的概念与设计初衷,阐述了添加别名的业务场景需求,包括多系统接入、用户分流和灰度发布等。随后提供了标准配置步骤,从SPRO路径到具体操作说明,并分享了三个实际案例说明如何实现跨区域统一待办、按用户角色分流和灰度发布。最后给出了验证方法和常见问题解决方案,帮助开发者掌握这项基础但关键的配置技能,实现服务路由的可控管理。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 135

RAG优化大法:20+招式助你玩转大模型应用!(非常详细)从零基础到精通,收藏这篇就够了!

大语言模型(LLMs)已经火到出圈,简直成了我们工作和生活中的“万金油”!它们聪明又全能,和信息的互动方式都被它们给颠覆了。不过,可别以为LLMs就无敌了。它们有时候也会“抽风”,给你整出些“幻觉”,要么就是抱着过时的信息不撒手,遇到专业问题就“掉链子”,逻辑推理能力也时常让人捉急。在现实世界中,数据得像“窜天猴”一样更新,生成的内容还得像“玻璃罩”一样透明可追溯,不然成本控制和数据隐私就都成了“老大难”。所以,光靠这些“黑盒”模型可不行,咱得有更精细的“武器”来应对这些挑战。

Libra1313的博客 964

无刷电机FOC硬件电路设计

本文先对MIT无刷电机FOC硬件电路分析做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章软件程序在我另外一个博客【嵌入式–伺服电机】MIT无刷电机FOC驱动程序分析。

qq_35635374的博客 574

RAG优化大法:20+招式助你玩转大模型应用!(非常详细)从零基础到精通,收藏这篇就够了!

上面这些方法,就是针对基础RAG在各个环节的“优化大法”。实际开发中,不是所有方法都有效,不同问题有不同的“解药”,针对应用场景选择合适的优化方法组合,才能最大限度发挥RAG的“威力”。黑客/网络安全学习包资料目录成长路线图&学习规划配套视频教程SRC&黑客文籍护网行动资料黑客必读书单面试题合集因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取优快云大礼包:《黑客&网络安全入门&进阶学习资源包》免费分享1.成长路线图&学习规划要学习一门新的技术,作为新手一定要先学习成长路线图。

leah126的博客 879

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

RAG优化的17种方法

本文系统分析了RAG(检索增强生成)系统中的文档切块技术及其优化策略。首先阐述了传统切块方法存在的三大问题:粒度控制难、上下文缺失和全局视角不足。随后详细介绍了17种优化方案,包括语义分块、上下文增强检索、查询改写、知识图谱等,每种方法都基于不同的技术假设并具有独特优势。文章还对这些方案进行了评分比较,从实现简易度、改进效果等维度评估其适用性。这些优化策略为提升RAG系统的检索精度和信息相关性提供了多元化的技术路径,需要根据具体场景平衡效果与实现成本进行选择。

weixin_55781982的博客 2439

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

RAG的12种调优策略

随着越来越多的开发人员在创建RAG流程的原型方面积累经验,讨论如何使RAG流程达到投入生产所需的性能变得更为重要。本文主要阐述了以下调优点:

python1234_的博客 3468

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

大模型新书丨基于大模型的RGA应用开发与优化-构建企业级LLM应用(附PDF)

当前大模型被普遍看好的两个专业应用方向是 RAG(Retrieval-Augmented Agenerated,检索增强生成)与 Agent(AI 智能体)。本篇首先尝试用通俗易懂的语言帮助大家认识 RAG 这一重要应用形式。

Y525698136的博客 1855

大模型RAG优化方案与实践(非常详细)从入门到精通,看这一篇就够了

RAG通过检索现有的大量知识,结合强大的生成模型,为复杂的问答、文本摘要和生成任务带来了全新的解决方案。本文详细的介绍了RAG遇到的挑战、通用范式、工程实践、优化实现策略等。一、RAG的背景介绍随着ChatGPT的兴起,大语言模型再次走进人们的视野,其在NLP领域表现出的语言识别、理解以及推理能力令人惊叹。越来越多的行业开始探索大语言模型的应用,比如政务、医疗、交通、导购等行业。通义系列、GPT系列、LLama系列等模型,在语言交互场景下表现十分抢眼。

玩赚AI大模型的博客 4926

一文详谈RAG优化方案与实践

导读RAG通过检索现有的大量知识,结合强大的生成模型,为复杂的问答、文本摘要和生成任务带来了全新的解决方案。本文详细的介绍了RAG遇到的挑战、通用范式、工程实践、优化实现策略等。一、RAG的背景介绍随着ChatGPT的兴起,大语言模型再次走进人们的视野,其在NLP领域表现出的语言识别、理解以及推理能力令人惊叹。越来越多的行业开始探索大语言模型的应用,比如政务、医疗、交通、导购等行业。通义系列、GP...

weixin_45583158的博客 1885

【AI大模型教程】深度解析RAG优化策略的五大核心范式与路径,收藏这一篇就够了!!!

在AI领域,随着大模型的广泛应用,如何高效地利用外部知识成为提升模型性能的关键。检索增强生成(Retrieval-Augmented Generation, 简称RAG)作为一种结合信息检索与文本生成的技术框架,正在迅速成为解决这一问题的重要工具。 RAG应用普及促进RAG技术不断演进,衍生出多个变体和优化方案,如GraphRAG、MultiHop-RAG(多跳RAG)、HyDE和RAGFusion等就是目前市场中主流的几个RAG家族成员,这些RAG技术优化路线各有侧重,适用于不同的应用场景。本文将系统梳

嘴巴吃糖了 1030

RAG介绍及RAG的优化

信息检索和生成语言建模。这种方法旨在为语言模型提供访问外部数据源,来提高其在生成响应时的准确性和相关性,从而增强语言模型的能力。1)检索:用收到的query去库里查到最相关的文档或者上下文2)生成:把以上得到的内容输入给LLM,LLM通过理解和结合,整理回答出问题的答案。参考 https://mp.weixin.qq.com/s/mn0MilYoyV0Df_7SXnuY2g高级检索增强生成(Advanced RAG):对传统RAG增加复杂的检索前 和检索后过程。检索后:增加ReRank。

qq_29837229的博客 1143
上一篇: 震惊!信息安全、网络安全、数据安全竟然不是一回事?从零基础到精通,收藏这篇就够了!
下一篇: 网络安全 从零基础到精通,收藏这篇就够了!
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值