RAG的12种调优策略

检索增强生成(RAG) 优化策略篇 本文详细介绍了检索增强生成(RAG)技术的各个优化策略,包括文档块切分、文本嵌入模型、提示工程、大模型迭代、架构优化、索引优化、索引数据优化等多个方面。通过这些优化策略,RAG 技术在处理复杂查询和生成信息丰富回应方面展示了巨大的潜力。未来,RAG 技术将在垂直优化、横向扩展以及生态系统构建等方面继续发展,为多领域应用提供更低的训练成本和更优的性能表现。 阅读详情
AI摘要

本文介绍检索增强生成(RAG)流程的优化策略,涵盖数据索引和推理阶段,旨在提升RAG系统的性能。从数据清洗、分块技术到嵌入模型选择,再到查询转换和重排序模型,提供全面的技术指导。

数据科学是一门实验性科学。它始于“无免费午餐定理”,即不存在适用于每个问题的通用算法。

因此,数据科学家们使用实验跟踪系统来帮助调整他们机器学习项目的超参数,以实现最佳性能。

01、整体优化方案说明

检索增强生成(Retrieval-Augmented Generation,以下简称RAG)是一种比较有效的大模型使用场景中的补充模型能力的机制,在实践中可以通过调整其各种参数提高RAG流程的性能。类似于深度学习中的实验,数据增强技术不是超参数,而是可以调整和实验的旋钮。

本文从数据索引阶段和推理阶段分别阐述RAG流程的“超参数”和调优建议。

数据索引阶段可优化点:

  1. 数据清洗

  2. 分块

  3. 嵌入模型

  4. 元数据

  5. 多索引

  6. 索引算法

推理阶段可优化点:

  1. 查询转换

  2. 检索参数

  3. 高级检索策略

  4. 重新排序模型

  5. 语言模型微调

  6. 提示工程

请注意,本文的用例是基于文本类的RAG应用。对于多模态的RAG应用,可能需要考虑其他不同的因素。

02

索引阶段-优化方案

数据索引阶段是构建RAG的准备步骤,类似于机器学习中的数据清洗和预处理。数据索引阶段通常包括以下步骤:

  1. 数据收集

  2. 分块:将大量数据分割成较小的块,以便更有效地处理和管理数据。

  3. 向量化: 使用嵌入模型将每个数据块转换为向量表示这有助于在后续的检索和生成阶段中处理和分析文本。

  4. 存储:将生成的向量和相应的数据块存储在向量数据库中。

图片

2.1、数据清洗

数据质量在RAG中起着至关重要的作用,因此在进行以下任何步骤之前,需确保数据集符合以下标准:

  • 整洁:请应用一些在自然语言处理中常用的数据清洗方法。例如确保所有特殊字符被正确编码。
  • 正确:确保信息的一致性与准确性,避免可能混淆语言模型的冲突信息。

若原始数据集不符合这样的标准,首先要做的就是将数据集清洗为符合这两条标准的数据格式,然后再进行下面的步骤。

2.2、分块

在RAG中,对文档进行切块是处理外部知识源的一项重要步骤,会直接影响性能。分块是一种生成有逻辑关联的信息片段的技巧,通常做法是通过将长文档分割成小节(也可以将小片段组合成段落)。

分块技术是影响分块效果的一个因素。如在LangChain中,不同的文本拆分器根据不同的逻辑拆分文档,比如按字符、标记等。这要根据你的数据类型来决定。

分块长度(chunk_size)也要具体情况具体分析:若使用场景是问答,可能需要更短的、更具体的切块;但如果是摘要,可能需要更长的切块。此外,如果一个切块太短,可能不包含足够的上下文。另一方面,如果切块太长,可能包含太多不相关的信息。

另外,还需要考虑在切块之间引入一些额外上下文的“滚动窗口”(重叠),来提高信息连贯性。

2.3、嵌入模型

嵌入模型是检索的核心,嵌入的质量直接影响检索结果。通常来说,生成的嵌入的维度越高,嵌入的精度就越高。

虽可以直接使用通用嵌入模型,但在某些情况下,对嵌入模型进行微调以适应特定用例可能是有意义的,因为这样可以避免后期出现领域外问题。根据LlamaIndex的实验证明,微调嵌入模型通常可以导致检索评估指标提高5-10%,

但不是所有嵌入模型都可以进行微调。

2.4、元数据

将向量嵌入存储在向量数据库中时,一些向量数据库可以将它们与元数据(或未向量化的数据)一起存储。使用元数据注释向量嵌入可以对搜索结果进行后处理,例如元数据过滤,或者添加日期、章节或子章节引用等元数据。

2.5、多索引

若元数据不足以在逻辑上区分不同类型的上下文,可以尝试使用多索引。如可以为不同类型的文档使用不同的索引。需要注意的是,若对元数据和独立集合(separate collections)感兴趣,可能也会想要了解原生多租户。

2.6、索引算法

为了在大规模情况下实现快速相似性搜索,向量数据库和向量索引库使用的是近似最近邻搜索(Approximate Nearest Neighbor,ANN)而不是k最近邻搜索(k-nearest neighbor,kNN)。顾名思义,ANN算法近似最近邻,因此可能比kNN算法精度略低。

其中,有许多不同的ANN算法,例如Facebook Faiss(聚类)、Spotify Annoy(树)、Google ScaNN(向量压缩)和HNSWLIB(接近图)。这些ANN算法一般都有可以调整的参数,比如HNSW中的ef、efConstruction和maxConnections

此外,可以对索引算法启用向量压缩,使用向量压缩会损失一些精度。但是,你也可以(根据场景)对压缩算法的选择和调整进行优化。

在实践过程中,算法的参数通常已经由数据库研究团队在基准实验中进行调整了,RAG系统的开发人员通常不会改动。

03、推理阶段-优化方案

RAG的主要组成部分是检索和生成。本节主要讨论提升检索效果的策略(查询转换、检索参数、高级检索策略和重新排序模型)。因为相对于生成,检索对结果的影响更大。但检索也会简单涉及到一些生成的策略(LLM和提示工程)。

图片

3.1、查询转换

RAG中,用于获取额外上下文的搜索查询也被嵌入到向量空间中,因此查询的表达方式会对搜索结果产生影响。若搜索查询没有得到满意的结果,可尝试一些查询转换技术,如:

  1. 重新表达: 使用语言模型(LLM)重新表达查询,然后再次尝试。

  2. 假设性文档嵌入(HyDE): 使用语言模型生成对搜索查询的假设响应,然后将两者一起用于检索。

  3. 子查询: 将较长的查询分解为多个较短的查询。

3.2、检索参数

检索是RAG的重要组成部分,在检索中首先要考虑的是,语义搜索是否足够满足用例,或者是否希望使用混合搜索。

在采用混合搜索的情况下,需要尝试调整混合搜索中稀疏和密集检索方法的加权聚合。因此,调整参数alpha将变得至关重要。

此外,检索结果的数量也很重要。检索到的「上下文数量」将影响「所使用的上下文窗口的长度」。同时,若使用重排序模型,则需要考虑将多少上下文输入到模型中。

虽然语义检索相似性度量方式可以设置,但应根据所使用的嵌入模型来修改,而不是进行不必要的实验。如text-embedding-ada-002支持余弦相似度,而multi-qa-MiniLM-l6-cos-v1支持余弦相似度、点积和欧几里得距离。

3.3、高级检索策略

高级检索的基本思想为用于检索的块不一定要与用于生成的块相同。理想情况下,会把检索嵌入为较小的块,去检索较大的上下文。

  • 句子窗口检索(Sentence-window retrieval):不仅检索相关句子,还要检索句子之前和之后的窗口。
  • 自动合并检索(Auto-merging retrieval):文档以类似树状结构组织。查询时,可以将单独但相关的较小块合并成更大的上下文。

3.4、重排序模型

语义搜索是基于上下文与搜索查询的语义相似性来检索的,但**“最相似”并不一定意味着“最相关”**。重排序模型,例如Cohere的重排序模型,可以通过计算每个检索到的上下文与查询相关性的分数来消除不相关的搜索结果。

如果使用重排序模型,可能需要重新调整输入到重排序器的搜索结果数量,以及您希望将多少经过重新排序的结果输入到LLM中。和嵌入模型一样,您可能需要根据您的用例来微调重排序模型。

3.5、语言模型微调

LLM是生成响应的核心组件。类似于嵌入模型,根据您的需求(如开放式与专有模型、推理成本、上下文长度等),有各种各样的LLM可供选择。与嵌入模型或重排序模型一样,您可能希望尝试对LLM进行微调来适应特定用例。

3.6、提示工程prompt极大地影响LLM的生成结果。

请仅基于提供的搜索结果回答问题,切勿参考其他信息!

这一点非常重要!您的回答必须建立在提供的搜索结果之上。请解释您的答案为何基于搜索结果。

此外,在提示中使用少量示例可以提高完成结果的质量。

上下文长度是一个应该尝试实验的参数,虽然通过增加相关上下文可以改善RAG的性能,但如果将相关上下文放置在过多上下文的中间,可能遇到“中间迷失”效应,即LLM可能无法识别中间位置的相关上下文。

04、优化方案总结

随着越来越多的开发人员在创建RAG流程的原型方面积累经验,讨论如何使RAG流程达到投入生产所需的性能变得更为重要。本文主要阐述了以下调优点:

数据索引阶段中的策略:

  • 数据清洗:确保数据清洁且正确。
  • 切块:选择切块技术、切块大小(chunk_size)和切块重叠(overlap)。
  • 嵌入模型:选择嵌入模型,包括维度,以及是否进行微调。
  • 元数据:是否使用元数据以及元数据的选择。
  • 多索引:决定是否为不同的数据集使用多个索引。
  • 索引算法:ANN和向量压缩算法的选择和调整是可以进行调整的,但通常不由RAG应用开发者进行调整。

在推理阶段(检索和生成)的策略:

  • 查询转换:尝试重新表达、HyDE或子查询。
  • 检索参数:选择搜索技术(如果启用混合搜索,则为alpha)和检索到的搜索结果数量。
  • 高级检索策略:是否使用高级检索策略,如句子窗口或自动合并检索。
  • 重排序模型:是否使用重排序模型,重排序模型的选择,输入到重排序模型的搜索结果数量,以及是否对重排序模型进行微调。
  • LLMs:LLM的选择以及是否对其进行微调。
  • 提示工程:尝试不同的措辞和少量示例。

RAG为大模型的落地和使用提供了更多可能,但如何使用RAG又是一项关键技术,因此RAG的调优显得尤其重要。本文整理了12种调优策略,在实际场景中,还存在其他的策略,以上内容仅供参考和探讨。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

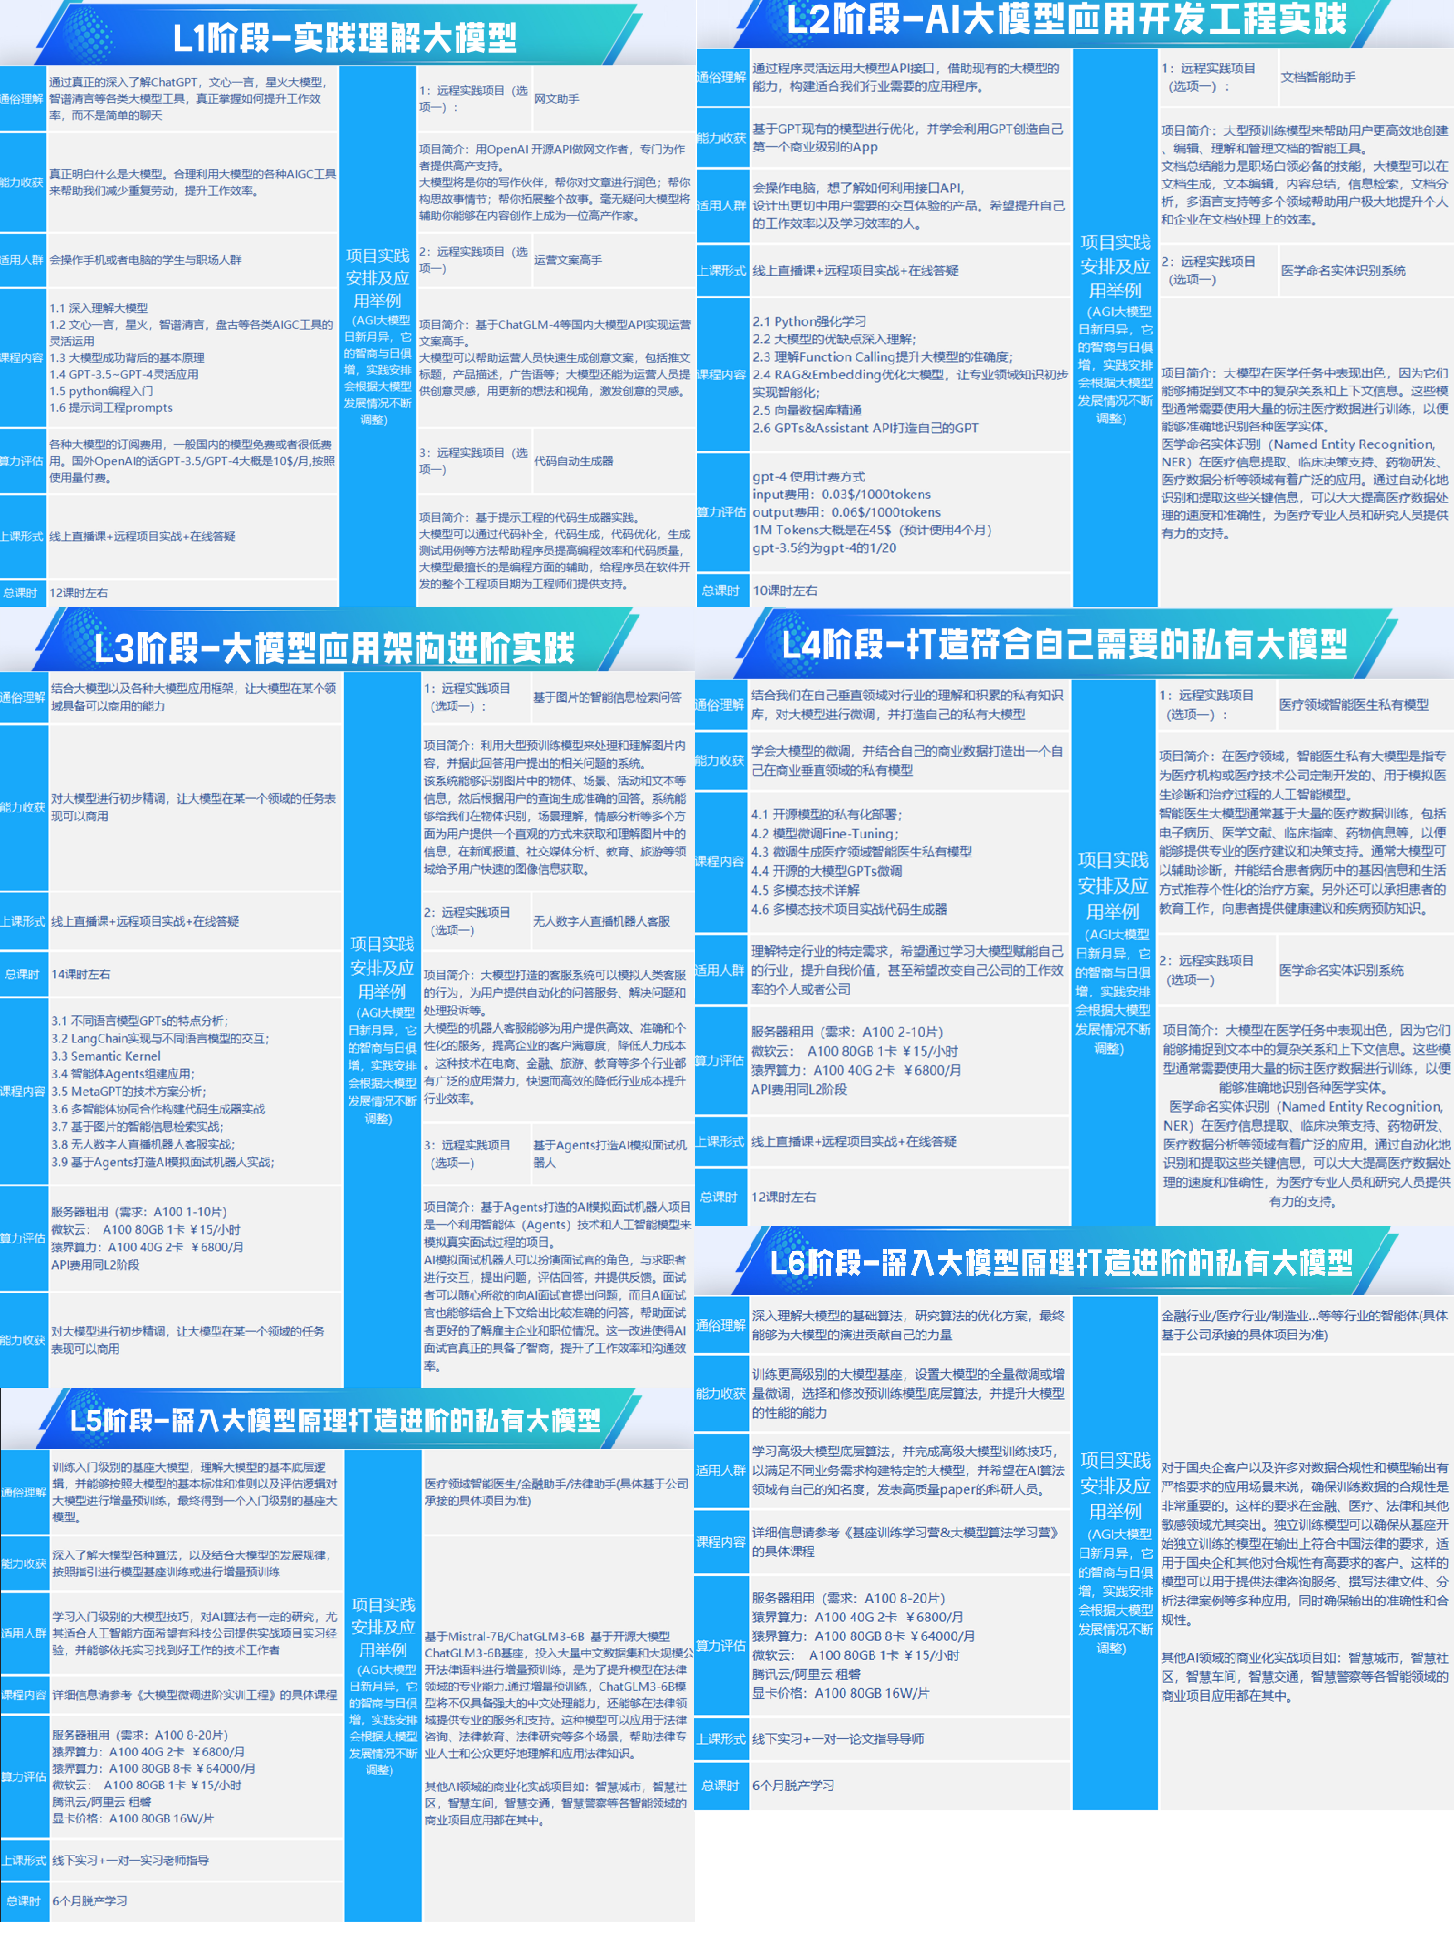
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【NLP】RAG 应用中的调优策略 ​检索增强生成应用程序的调优策略没有一种放之四海而皆准的算法能够最好地解决所有问题。本文通过数据科学家的视角审视检索增强生成(RAG)管道。它讨论了您可以尝试提高 RAG 管道性能的潜在“超参数”。与深度学习中的实验类似,例如,数据增强技术不是超参数,而是可以调整和实验的旋钮,本文还将介绍您可以应用的不同策略,这些策略本身不是超参数。本文涵盖以下按相关阶段排序的“超参数”。在RAG 管道的请注意,本文涵盖了 RAG 的文本用例。对于多模式 RAG 应用,可能需要考虑不同的因素。 阅读详情

相关推荐

『大模型笔记』RAG应用的12种调优策略指南

本文从数据科学家的角度审视了一种 检索增强生成(Retrieval-Augmented Generation,以下简称RAG),讨论了一些潜在的“超参数”——您可以通过调整它提高RAG流程的性能。类似于深度学习中的实验,数据增强技术不是超参数,而是您可以调整和实验的旋钮,本文还将涵盖您可以应用的不同策略,这些策略并非严格意义上的超参数。

AI新视界 787

RAG的12种调优策略_rag调优

随着越来越多的开发人员在创建RAG流程的原型方面积累经验,讨论如何使RAG流程达到投入生产所需的性能变得更为重要。本文主要阐述了以下调优点:

2401_85379281的博客 1789

R语言分段回归

1.利用虚拟变量进行线性回归 (MEdata.csv的数据来源:https://github.com/ChenQihome9/优快云-Data-Library/blob/master/MEdata.csv) 问题13:针对TAX~GDP,使用分段回归方法,找到其回归方程。编程,并根据程序结果叙述如下几方面问题:(1)分几段最佳?(不超过5段内)(2)分段位置定在哪儿最佳?(3)写出最佳方...

ChenQihome9的博客 1万+

一文详谈20多种RAG优化方法

以上这些方法就是针对基础RAG在各个环节的优化方法,在实际开发过程中并不是所有方法都是有效的,不同问题有不同的解决方案,针对应用场景选择合适的优化方法组合才能最大限度发挥RAG的作用。

m0_59164304的博客 3796

【网络安全】Centos7安装杀毒软件----ClamAV

Clam AntiVirus是一个Linux系统上使用的反病毒软件包。主要应用于邮件服务器,采用多线程后台操作,可以自动升级病毒库。

你在看屏幕的同时,屏幕也在注视着你 8827

GNSS - PPP软件 - GAMP 在VS2019/2022下完成调试、跑通程序(超详细!)

WIN32;_DEBUG;_CONSOLE;O_WARNINGS;ENAGLO;ENACMP;ENAGAL;ENAQZS;NFREQ=3。

qq_43381998的博客 8246

RAG调优实战:12个让检索增强生成从“能用“到“好用“的关键策略

从数据科学家的视角深度解析RAG系统的12种调优策略,涵盖数据索引和推理两大阶段,帮助你把RAG应用从原型推向生产环境

Cheson的专栏 1059

逆向实战:Soul聊天协议加密与Frida绕过检测技术解析

本文详细解析了Soul聊天协议的逆向工程实战,重点介绍了使用Frida绕过检测技术的具体方法。通过IDA和JADX进行静态分析,结合Frida动态调试,揭示了数据加密与解密的核心逻辑,并提供了完整的逆向工作流和实用技巧,帮助开发者深入理解协议逆向过程。

weixin_29260291的博客 925

RAG应用程序的12种调优策略:使用“超参数”和策略优化来提高检索性能

数据清理:确保数据干净、正确。分块:选择分块技术,块大小(chunk_size)和块重叠(重叠)。嵌入模型:选择嵌入模型,包括维度,以及是否对其进行微调。元数据:是否使用元数据和选择元数据。多索引:决定是否对不同的数据集合使用多个索引。索引算法:人工神经网络和矢量压缩算法的选择和调整可以调整,但通常不是由应用调整。查询转换:尝试改写、HyDE或子查询。检索参数:搜索技术的选择(如果启用了混合搜索,则为alpha)和检索的搜索结果的数量。

deephub 5560

11、牛转录组分析的实用生物信息学流程

本文详细介绍了一套实用的牛转录组分析生物信息学流程,涵盖从数据提取、基因组索引生成、读取比对到单样本表达分析及差异表达分析的完整步骤。使用Angus和Brahman牛的RNA-seq数据作为示例,介绍了HTSEQ、featureCounts和StringTie等工具在基因表达计数中的应用,并结合edgeR和limma进行差异表达分析。文中提供了详细的命令行与R代码示例,包含常见问题解答与关键注意事项,帮助研究人员高效、准确地完成转录组数据分析。

ios99的博客 110

Codex入门19-数据库操作(解放双手:用自然语言写SQL、建表和数据迁移)

写 SQL 是后端开发的日常,但复杂的 JOIN、子查询、窗口函数总让人头疼。本文教你用 Codex CLI 实现:自然语言直接生成 CREATE TABLE、复杂 SQL 查询、数据库迁移脚本(Prisma/Knex/Alembic)、ORM 模型代码(SQLAlchemy/TypeORM)、甚至自动生成数据库文档。重点强调安全红线——永远不要让 AI 直接连接生产数据库。从需求描述到完整数据库层代码,一篇搞定。

yueyeguzhuo的专栏 233

破解RAG开发中的12大痛点与解决方案

本文系统分析了开发RAG管道时常见的12个痛点,包括7个来自学术研究的核心问题和5个实践中的挑战。针对内容缺失、文档检索失败、格式错误等关键问题,文章提出了包括提示优化、参数调优、重排序技术、输出解析等多种解决方案。特别介绍了处理复杂PDF数据、保障LLM安全性的创新方法,如EmbeddedTablesUnstructuredRetrieverPack和LlamaGuardModeratorPack。这些方案通过技术组合(如提示压缩与上下文重排序)和工具集成(如Pydantic程序与OpenAI JSON模

2501_92069919的博客 841

滤波电路Multisim电路仿真实验汇总——硬件工程师笔记

本文系统介绍了滤波电路的基础知识及其应用。首先按频率选择性和实现方式对滤波电路进行分类,详细阐述了低通、高通、带通、带阻滤波器以及无源、有源滤波器的特点。接着重点分析了桥式整流电容滤波、电感滤波、LC滤波和CRπ型滤波四种典型电路的工作原理、应用场景及设计要点。通过理论公式和实际案例,指导如何选择滤波元件参数,考虑寄生效应,并通过仿真验证设计效果。最后提供了硬件工程师笔试面试相关的技术资源链接,包括器件知识、电路仿真及企业真题解析等内容。本文可作为电子电路设计领域工程技术人员的学习参考资料。

XU157303764的博客 2165

【Dify混合RAG召回率优化实战白皮书】:20年NLP架构师首次公开3大源码级调优策略与AB测试数据(含v0.12.3核心补丁)

解决Dify混合RAG召回率偏低难题,基于v0.12.3源码分析,提出分层重排序、查询扩展增强与向量-关键词双路融合三大调优策略,显著提升长尾查询召回效果。适用于企业知识库与多源文档场景,AB测试显示MRR提升27.3%。值得收藏。

VarIsle的博客 227

基于Cesium移动的天空云

天空中的云朵也算是一种天气气候的效果,它能更加逼真的反映当前的天气状况,可以是白云朵朵,也可以是乌云密布,结合其他天气效果,可以组合形成较为真实的三维可视化场景。

星云数海的博客,一个专注GIS十多年的GISer人。 446

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

RAG 系统调优实战:检索、重排与向量库优化全流程复盘

分块策略优先于模型选择。一个精心设计的分块方案,比换用更贵的 Embedding 模型或更大的生成模型带来的提升更显著且更持久。固定 512 Token 分块在 demo 中够用,在生产中是负债。重排是“精度放大器”,但不是“召回拯救者”。Cross-Encoder 重排能显著提升 Top-N 的精度,但它只能对已有的候选项重新排序,无法召回初始检索遗漏的内容。如果粗筛阶段没有召回相关文档,重排也无能为力。高召回率的粗筛 + 高精度的重排,两者缺一不可。向量库选型要匹配查询模式。

2302_79505105的博客 292

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

RAG系统调优实战:提升金融问答准确率的12个技巧

检索增强生成(RAG)技术通过结合传统检索与生成式AI,有效解决大模型问答系统中的知识利用难题。其核心原理是将用户查询与知识库内容进行语义匹配,再基于检索结果生成精准回答。在金融、法律等专业领域,RAG系统能显著提升回答的准确性与可靠性。关键技术环节包括知识库的智能切片、混合检索策略优化以及生成结果的领域适配。特别是在金融场景中,通过文档语义分割、多模态知识增强和动态更新机制,可解决利率计算、产品对比等专业问题。实践表明,合理的RAG调优能使系统准确率提升40%以上,同时降低响应时延,是构建企业级智能问答系

weixin_30340819的博客 385

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

生产级 RAG 召回不准别硬调向量:零代码混合检索提 20% 准确率附检索策略对比表

【摘要】张钧泽基于20多个RAG项目实践经验,指出90%的召回问题无需更换向量模型,提出"混合检索三阶调优法":基础层通过关键词检索补全(零代码实现,提升12%准确率),中间层采用动态权重融合(提升6%),高阶添加轻量重排序(提升2%)。该方法相比更换向量模型成本更低,实测长尾query召回率提升35%,并附检索策略对比表、10行示例代码及调优检查清单。文章强调生产环境中混合检索的必要性,指出纯向量检索难以覆盖精确匹配场景,并提醒避免权重未调、全文搜索噪声两大常见误区。

JBGT2026的博客 237

NebulaGraph属性图索引优化与RAG集成实践

图数据库索引是提升图遍历和属性查询性能的关键技术,其核心原理是通过高效的数据结构(如LSM-Tree、跳表)加速数据访问。在知识图谱和RAG(检索增强生成)技术栈中,合理的索引设计能显著降低查询延迟,从800ms优化到12ms。本文以NebulaGraph为例,详解属性图索引的优化策略,包括复合索引设计、查询重写和内存配置,并展示如何与Data-Processor组件集成,实现实时数据预处理和索引预热。这些实践特别适用于千万级顶点的大规模图数据场景,为RAG框架提供高效的数据支撑。

weixin_42116058的博客 21

LLM应用生产落地实战:RAG与Agent的12个生死点

大型语言模型(LLM)应用开发已从概念验证迈入生产交付阶段,核心挑战在于RAG知识库构建、Agent状态管理、向量数据库调优及安全加固等工程化环节。理解RAG分块策略、Milvus性能参数、Redis状态分片存储等底层原理,是保障召回准确率、响应稳定性与系统可审计性的技术基础。真实场景中,PDF文档切块不当会导致关键故障码丢失,Ollama接口缺失metadata影响可观测性,而Prompt注入、Function越权、向量注入则是开源Agent项目高频安全风险。本文聚焦python + milvus 实现r

weixin_29041767的博客 277

收藏 |小白程序员必看:手把手教你玩转RAG大模型应用与面试通关

Embedding(嵌入)是一种将离散的文本数据映射到连续高维向量空间的技术。在RAG系统中,Embedding模型扮演着"语义翻译官"的角色:它将用户查询和知识库文档统一转换为稠密向量表示,使得语义相似的文本在向量空间中彼此接近,从而支持高效的相似度检索[11]。Embedding模型的质量直接决定了RAG系统的检索精度。一个优秀的Embedding模型需要具备以下能力:准确捕捉文本的语义信息而非仅仅关注表面词汇;在不同领域和语言上保持稳定的表现;具备处理长文本和复杂语境的能力。

weixin_59191169的博客 595

大模型RAG完全指南:Embedding模型选型、向量搜索与重排序核心技术详解,程序员必看收藏!

本文系统解析RAG技术栈三大核心组件:Embedding模型、检索策略与Rerank重排序。对比分析了主流Embedding模型性能与选型策略,整理20个高频面试问题及12种调优策略,深入解析向量搜索与Rerank的本质区别,强调"粗排+精排"两阶段架构的设计智慧,为构建高性能RAG系统提供全面指导。

Android23333的博客 660

RAG知识库搭建实战:从文档切分到12题全过

检索增强生成(RAG)是一种将信息检索与大模型生成相结合的技术,旨在让模型基于给定文档回答问题时更准确、可回溯。其核心原理包括文档切分、向量化、相似度召回和上下文重排等环节。在实际工程中,合理的文本切分策略与混合检索机制往往比单纯更换大模型更能提升知识库效果。本文以一套虚构的手机评测文档为演示数据,从文档加载、切片参数调优、向量检索与关键词召回融合、重排优化到评测集设计,完整呈现了知识库从搭建到多轮排错的过程,最终实现12道业务验收题全部通过。整个流程不依赖私有数据和高配置服务器,可复用于产品问答、制度咨询

weixin_34079177的博客 75

RAG工业级落地:检索、分块与生成三层调优实战

RAG(检索增强生成)是一种将信息检索与大语言模型生成能力协同的技术范式,其核心原理在于通过可控的检索环节为生成提供精准、可信、上下文完备的依据。技术价值不仅在于提升回答准确性,更在于构建可解释、可监控、可迭代的企业级知识服务系统。典型应用场景包括内部知识库问答、产品文档智能助手、合规与风控辅助决策等。然而真实落地中,效果瓶颈往往不在LLM本身,而深藏于检索器的语义对齐能力、分块策略的上下文完整性保障,以及生成器对矛盾/残缺信息的主动甄别机制——这正是本文聚焦的三大关键层及其工程化调优路径。

370

Hybrid RAG实战:混合检索如何解决RAG落地中的符号、术语与模糊匹配难题

混合检索(Hybrid Retrieval)是RAG系统实现高准确率问答的核心技术,其本质是融合语义理解与关键词匹配两种互补范式。语义检索擅长捕捉用户意图和同义表达,但对代码符号(如np.dot)、专业缩写(如BM25)、否定逻辑等高度敏感;关键词检索则天然支持精确字符串匹配与结构化片段定位,却难以处理同义词与形态变化。二者协同可显著提升技术文档、法律条文、医疗指南等高专业度场景的召回质量。本文聚焦Hybrid RAG在真实生产环境中的设计哲学、分词适配、归一化打分、故障域隔离及LLM上下文约束等关键实践,

weixin_30924239的博客 374

Dify农业知识库部署后问答失准?手把手教你用日志埋点+语义相似度阈值调优(附12个真实田间场景case)

Dify农业知识库调试实战指南:解决部署后问答失准问题。通过日志埋点定位响应瓶颈,结合语义相似度阈值动态调优,覆盖病虫害识别、施肥建议等12个真实田间场景。方法轻量、适配边缘设备,效果可量化验证,值得收藏。

ByteGlow的博客 159
上一篇: 2024检索增强生成RAG最新综述
下一篇: 第一批ToB人,已经在用大模型搞钱了!
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值