关于RAG优化的几个小技巧

检索增强生成(RAG) 优化策略篇 本文详细介绍了检索增强生成(RAG)技术的各个优化策略,包括文档块切分、文本嵌入模型、提示工程、大模型迭代、架构优化、索引优化、索引数据优化等多个方面。通过这些优化策略,RAG 技术在处理复杂查询和生成信息丰富回应方面展示了巨大的潜力。未来,RAG 技术将在垂直优化、横向扩展以及生态系统构建等方面继续发展,为多领域应用提供更低的训练成本和更优的性能表现。 阅读详情

一、背景说明

RAG技术为大型语言模型(LLMs)提供了从数据源检索到的信息,以支撑其生成的答案。简而言之,RAG就是搜索加上LLM提示,你让模型在提供的信息上下文中回答问题。查询和检索到的上下文都被注入到发送给LLM的提示中。

传统的建模方式:

典型的RAG向量化应用程序有两个主要组件:

索引:从源中获取数据并对其进行向量化索引。

检索和生成:运行时接受用户查询转化成向量化数据,并从索引中检索相关数据,然后将其传递给LLM,生成内容。

实际使用过程中,上面简单的流程经常效果不能满足业务需求,核心问题在于如何检索并处理好传给LLM的内容,下面介绍几种优化思路以及LangChain的实现。

二、优化方法

2.1 多层索引

多层索引技术主要是针对海量的文档检索的处理策略,对面临需要从海量的文档中搜索、找到相关信息,并将这类信息综合成一个答案,并应用其来源。一般有2种方式建立多层索引来优化这类问题。

一种是为文档建立多级索引,比如建立文档的类别标签,在处理指定业务场景下的问答时,只需要对该类别下的知识库进行检索,如:

处理医疗领域的RAG问答业务时,可能会涉及很多的医学知识库,假设有1000篇文档,包括10个不同的医学研究方向。
当涉及的业务问题范畴只涉及外科相关知识时,可以通过类别标签进行筛选过滤,而无需从1000篇文档中进行全局检索。

第二种是从两个索引——一个是有该文档的摘要组成,一个由文档切片组成。在处理学术论文时,这类方法一般有较好的表现。这类方法的思路是分为两个步骤进行检索,首先通过摘要部分进行召回检索,过滤出可能和当前问题相关的候选文档集,然后再利用切片索引,从候选的文档集中进行检索,召回相关的知识切片。

2.2 假设性问题

首先解释一下什么是假设性问题: 假设性问题是一种提问方式,它基于一个或多个假设的情况或前提来提出问题。在对知识库中文档内容进行切片时,是可以以该切片为假设条件,利用LLM预先设置几个候选的相关性问题的,也就是说,这几个候选的相关性问题是和切片的内容强相关的。

在构建切片索引时,可以将对应的假设性问题进行向量化,并同时存储于向量库中。在RAG中的召回步骤中,对这个问题向量索引进行查询搜索,然后路由到原始文本块,并将它们作为上下文发送给LLM以获取答案。这种方法提高了搜索质量,因为与原始文本块相比,查询和假设问题之间的语义相似性更高。

除此以外,还有一种候选的假设性问题解决方案,和上述策略是对应的,它的核心思想可以表示为:

在要求LLM给定查询信息时,用LLM预先生成一个假设的响应,然后将其向量和查询向量一起使用,进一步提升检索的质量。示例如下:

问题: 感冒了怎么办?
大模型预设响应: 感冒了需要多休息,喝水,必要时就医。
召回时用问题和大模型预设响应进行拼接,形成新的prompt内容进行召回。

2.3 拓展上下文

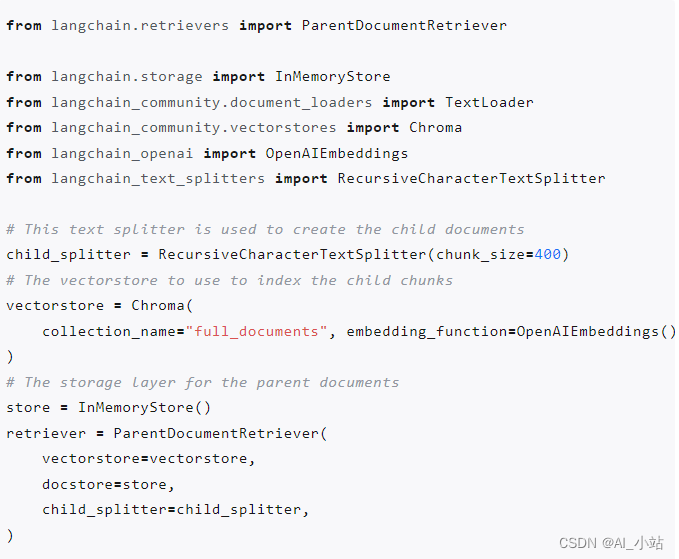
检索较小的块以获得更好的搜索质量,但将周围的上下文一起拼接起来传给LLM推理。当然在索引的时候就要把数据处理好,搜索的时候才能找到周围的上下文。这么做的好处,就是小的文本块可以提升搜索的准确率,而扩展上下文则可以给LLM更丰富的内容。这里有两种拓展上下文的方式可以作为参考:

一种处理的方案是,通过分割和存储小块数据来实现,在检索过程中,它首先获取小块,然后查找这些块的父ID,并返回那些较大的文档。这种方式在langchain里有进行封装。
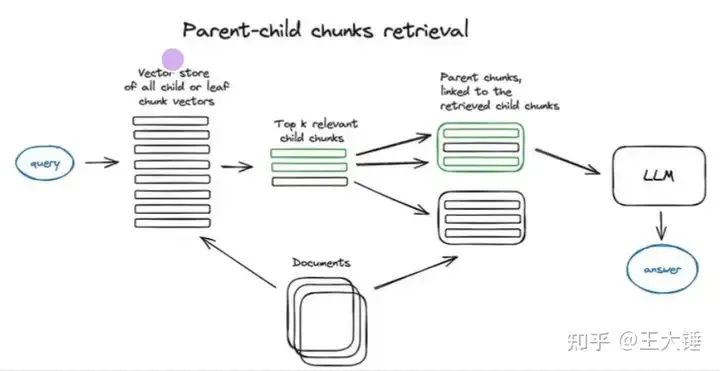
图片
在这里插入图片描述

第二种是对更大的块进行检索,有时,完整文档可能太大而无法按原样检索它们。在这种情况下,我们真正想做的是首先将原始文档分割成更大的块,然后将其分割成更小的块。然后我们索引较小的块,但在检索时我们检索较大的块(但仍然不是完整的文档)。
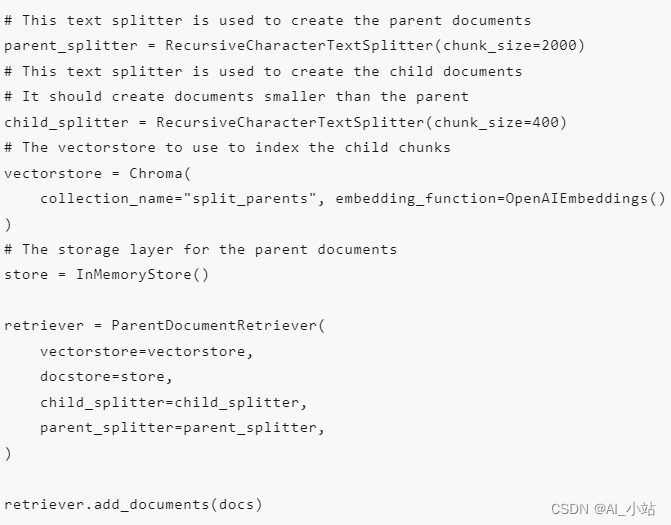
在这里插入图片描述

2.4 融合检索

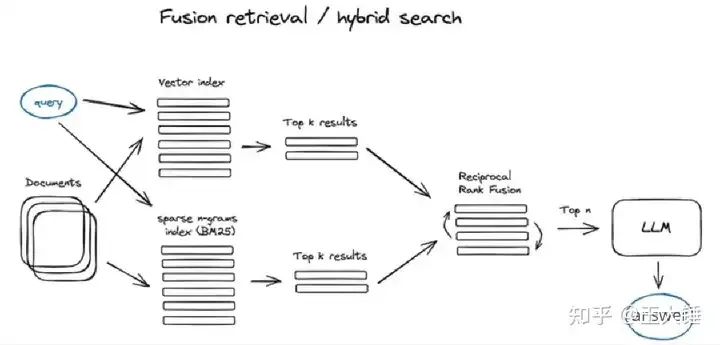
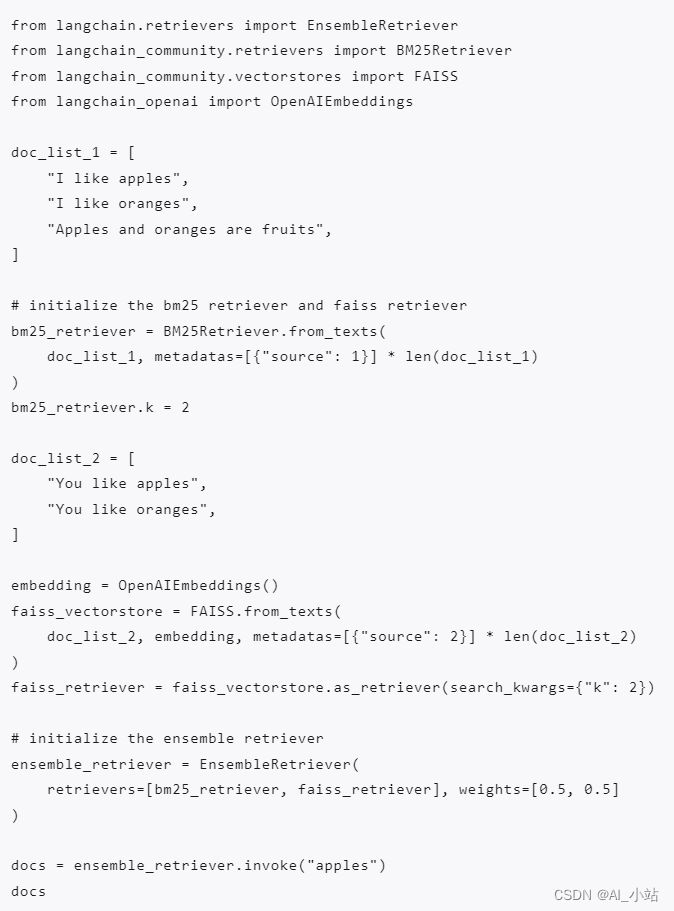
将检索到的结果与不同的相似性分数适当地结合起来——这个问题通常是在倒排融合算法的帮助下解决的,该算法将检索得到的结果重新排序以获得最终输出。在LangChain中,这是在EnsembleRetriever类中实现的,它结合了您定义的检索器列表,例如faiss矢量索引和基于BM25的检索器,并使用RRF进行重新排序。混合或融合搜索通常会提供更好的检索结果,因为两种互补的搜索算法结合在一起,同时考虑了查询和存储文档之间的语义相似性和关键字匹配。
图片
在这里插入图片描述

2.5 过滤与压缩

检索容易遇到的一个问题,当把数据向量化索引到数据库时,不太可能预想到对应的用户问题会是什么。这意味着,与查询最相关的信息可能隐藏在一个包含大量不相关文本的文档中,如果都一股脑传给LLM,不仅费用高(肉疼)而且效果可能也会受影响。

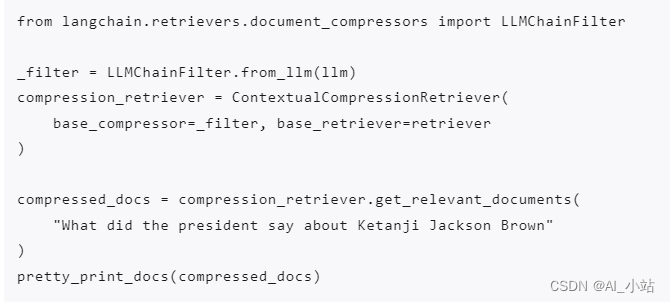
LLMChainFilter是一个简单的压缩器,使用LLM链来决定最初检索到的文档中的哪些要过滤掉,哪些要返回,而无需操作文档内容。嗯。。。这个,我就是因为不想调用LLM费钱处理才采用这个方案的吗?EmbeddingsFilter通过嵌入文档和查询并只返回那些与查询具有足够相似嵌入的文档,提供了一个更便宜、更快的选项。

LLMChainFilter的用法:
在这里插入图片描述

EmbeddingsFilter的用法:

from langchain.retrievers.document_compressors import EmbeddingsFilter
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings()
embeddings_filter = EmbeddingsFilter(embeddings=embeddings, similarity_threshold=0.76)
compression_retriever = ContextualCompressionRetriever(    
    base_compressor=embeddings_filter, base_retriever=retriever
)

compressed_docs = compression_retriever.get_relevant_documents(
    "What did the president say about Ketanji Jackson Brown"
)
pretty_print_docs(compressed_docs)

2.6 元数据过滤

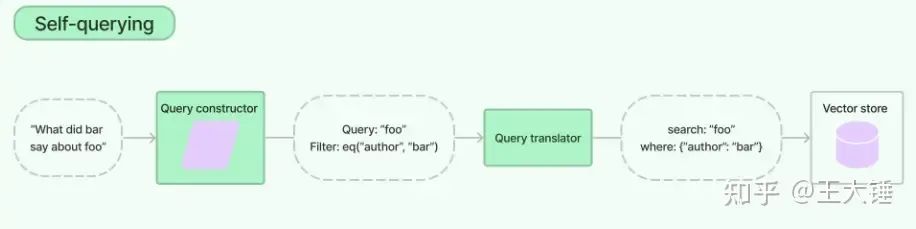
我们已经习惯了SQL查询的时候增加Where的限制条件,这个可以精确查询所需的数据。RAG也不是所有的时候都要通过语义或关键词检索。比如检索“所有评分大于8分的电影”,或者我们公司实际的业务场景,检索的时候只需要明确某个品牌的数据。

通过元数据过滤实现精确过滤,和语义检索配合。在存储数据块到向量数据块时,需要先处理好元数据,在我们公司的场景中,就是把所属的品牌ID一起存储。检索的时候可以利用大模型的理解能力,把自然语言转成元数据过滤。看看LangChain的实现,metadata_field_info是pydantic的格式。
图片

from langchain.llms import OpenAI
from langchain.retrievers.self_query.base import SelfQueryRetriever
from langchain.chains.query_constructor.base import AttributeInfo 

metadata_field_info=[
    AttributeInfo(    
        name="genre",        
        description="The genre of the movie",         
        type="string or list[string]",     
    ),    
    AttributeInfo(    
        name="year",        
        description="The year the movie was released",         
        type="integer",     
    ),    
    AttributeInfo(    
        name="director",        
        description="The name of the movie director",         
        type="string",     
    ),   
     AttributeInfo(    
        name="rating",        
        description="A 1-10 rating for the movie",        
        type="float"    
    ),
]
document_content_description = "Brief summary of a movie"
llm = OpenAI(temperature=0)
retriever = SelfQueryRetriever.from_llm(llm, vectorstore, document_content_description, metadata_field_info, verbose=True)

2.7 时间加权

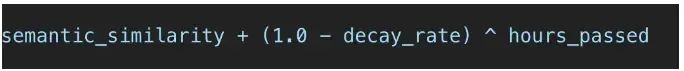
对于一些类似客服FAQ的场景,检索命中越频繁,数据的权重就越高,可以使用了语义相似性和时间衰减的组合。LangChain给出的计算公式是这样的。
图片

hours_passed是指自上次访问检索器中的对象以来(而不是自创建对象以来)经过的小时数。这意味着频繁访问的对象保持“新鲜”。

还有另一种时间权重,比如新闻资讯,创建时间越近权重越高,甚至可以为其设置过期时间。

RAG应用系统中,大家比较关心的因素:准确率、速度、成本。上面讨论的方案基本上都是提升准确率的,同时带来的问题就是速度下降,部分方案会成本上升。

另一方面,在实际的业务场景中,准确率可能是现阶段最重要的问题,业务人员对于应用的要求可能是90分,而LLM目前的能力只能达到60分,如果不能通过其它的方式提升效果,那么应用可能无法在实际场景中使用了。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

传统 RAG 的缺点及 RAG 优化方向 传统RAG中在数据、检索、提示词、模型及评估方面都需要进行全面优化,现在RAG 的应用已逐步从传统的“检索-生成”模式向更广泛的全链路优化演进。通过在训练、微调、检索、推理、语料和知识整合等环节引入创新方法,RAG 系统不断突破传统方法的局限,展现出更强的适应性、准确性和可解释性。 阅读详情

相关推荐

【NLP】RAG 应用中的调优策略

​检索增强生成应用程序的调优策略没有一种放之四海而皆准的算法能够最好地解决所有问题。本文通过数据科学家的视角审视检索增强生成(RAG)管道。它讨论了您可以尝试提高 RAG 管道性能的潜在“超参数”。与深度学习中的实验类似,例如,数据增强技术不是超参数,而是可以调整和实验的旋钮,本文还将介绍您可以应用的不同策略,这些策略本身不是超参数。本文涵盖以下按相关阶段排序的“超参数”。在RAG 管道的请注意,本文涵盖了 RAG 的文本用例。对于多模式 RAG 应用,可能需要考虑不同的因素。

sikh_0529的博客 2190

大模型入门到进阶:什么是 RAG?为什么需要 RAG?RAG 的流程

学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频,免费分享!

star_nwe的博客 3万+

RAG 架构优化(2025 最新)

本文分析了2025年RAG架构优化的最新趋势,主要包括多智能体RAG、自我优化RAG、图增强检索2.0和自适应检索等方向。这些研究与IRAG-Grid的三阶段优化方案高度契合,特别是在扩展查询、混合检索(BM25+BGE)、LLM评分排序和自检机制等方面。文章还阐述了五大核心原理:问题扩展、混合检索、文档筛选、回答自检和四维评价体系,这些创新点与2025年RAG系统的发展趋势一致。最后,作者提出可提供相关研究的详细列表、创新点对比表格或贡献总结段落等补充材料。

ZhangJiqun&191cm&85kg 325

一文彻底搞懂检索增强生成(RAG) 优化策略

本文详细介绍了检索增强生成(RAG)技术的各个优化策略,包括文档块切分、文本嵌入模型、提示工程、大模型迭代、架构优化、索引优化、索引数据优化等多个方面。通过这些优化策略,RAG 技术在处理复杂查询和生成信息丰富回应方面展示了巨大的潜力。未来,RAG 技术将在垂直优化、横向扩展以及生态系统构建等方面继续发展,为多领域应用提供更低的训练成本和更优的性能表现。读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用如果你是零基础小白,想快速入门大模型是可以考虑的。

2401_85379281的博客 5021

【AI大模型应用开发】【RAG优化 / 前沿】0. 综述:盘点当前传统RAG流程中存在的问题及优化方法、研究前沿

10个痛点问题,20+优化方法,8个前沿RAG研究。本文我们从RAG的流水线开始,全面梳理了当前传统RAG存在的问题,同时针对每个问题,总结了优化方法。并且,整理了当前前沿的RAG研究。

同学小张的博客 4673

硅纪元应用测评 | AI搜索引擎大比拼:360AI搜索、秘塔搜索、GenSpark AI和天工AI对比评测

搜索引擎输出的每个段落都有对应的出处,如果有错误,也是信息源的问题,从普通用户的角度来看,这与AI搜索的产品关系不大,能让用户对AI搜索的服务和得到的信息有一个隔离。同时,提供更多的定制选项,允许用户根据自己的偏好调整搜索结果的权重和排序,将使得搜索体验更加个性化和满足用户的具体需求。此外,大部分搜索工具还提供了一个无广告的搜索环境(360AI搜索部分内容会有广告),极大地提升了用户的搜索体验。AI搜索的本质依然是搜索,但它通过AI的逻辑分析和语言重新组织,使用户能够快速得到想要的信息。

guijiyuantech的博客 2013

【RAG优化】rag整体优化建议

rag整体流程优化

weixin_37763484的博客 1961

从零构建C++ Gerber解析器:以PCB缺陷检测为目标的实战指南

本文是一份面向PCB缺陷检测项目的实战指南,详细介绍了如何从零开始使用C++构建高性能的Gerber文件解析器。文章深入剖析了Gerber RS-274X格式,并提供了完整的开发环境搭建、核心数据结构设计、解析步骤实现以及为缺陷检测优化的具体方案,旨在帮助开发者获得对PCB制造数据的深度控制与极致性能。

weixin_29291185的博客 184

一文彻底搞懂检索增强生成(RAG) 优化策略_rag优化

检索增强生成(RAG)通过结合检索模块与生成模型提升大模型输出质量。文章系统介绍了RAG工作流程的四大核心模块:文档块切分(多粒度切分、语义切分等)、文本嵌入模型(微调、动态表征)、提示工程(模板优化、改写)以及大模型迭代(微调、量化训练)。同时提出架构优化策略,如元数据过滤、重排序减少冗余文档块。文末还提供了包含640份行业报告、学习视频等资料的LLM大模型资源包,助力开发者系统掌握RAG技术。

2401_85379281的博客 2229

ubuntu安装hodoop详细步骤

进入到Ubuntu系统中打开桌面,点击鼠标右键打开终端,在终端中输入如下命令这样就可以创建一名为hadoop的新用户。给用户输设置密码输入,输入如下命令,设置密码,按提示输入两次然后为hadoop用户增加管理员全新,这样就可以方便部署完成之后输入重启命令,重启一下Ubuntu系统,然后登录到我们创建的hadoop用户上面reboot。

2301_77603488的博客 9198

手把手教你玩转服务器芯片架构​专栏--​​3.5 实战案例:用SystemC搭建一个多核服务器芯片的NoC模型(含流量分配与延迟仿真)​

通过SystemC搭建多核NoC模型,可深入验证流量分配策略与延迟特性。实际工程中需结合FPGA原型验证(如Xilinx Alveo)进行时序收敛分析,并通过参数化设计适配不同服务器芯片需求。

MHD0815的博客 3042

RAG优化的17种方法

本文系统分析了RAG(检索增强生成)系统中的文档切块技术及其优化策略。首先阐述了传统切块方法存在的三大问题:粒度控制难、上下文缺失和全局视角不足。随后详细介绍了17种优化方案,包括语义分块、上下文增强检索、查询改写、知识图谱等,每种方法都基于不同的技术假设并具有独特优势。文章还对这些方案进行了评分比较,从实现简易度、改进效果等维度评估其适用性。这些优化策略为提升RAG系统的检索精度和信息相关性提供了多元化的技术路径,需要根据具体场景平衡效果与实现成本进行选择。

weixin_55781982的博客 2439

VTK GPU 加速渲染技术

/ 创建颜色工具// 创建立方体数据// 创建OpenGL映射器(注意使用vtkOpenGLPolyDataMapper而不是常规的vtkPolyDataMapper)// 启用VBO(顶点缓冲对象)// 声明几何体是静态的以获得最佳性能// 创建actor// 创建渲染器、渲染窗口和交互器renderWindow->SetWindowName("VTK自定义着色器示例");// 添加actor到渲染器。

深之JohnChen的专栏 1240

RAG优化策略

检索增强这块主要是借鉴了RAG Fusion技术,这个技术原理比较简单,概括起来就是,当接受用户Query时,让大模型生成5-10个相似的Query,然后每个Query去匹配5-10个文本块,接着对所有返回的文本块再做个倒序融合排序,如果有需求就在加一个精排,最后取top k个文本块拼接至Prompt;它是在一个语料库上进行训练的,其中包含由Critic模型预测的检索到的段落和反思字符。因此,可以在检索文档后加一个额外的验证模块,以评估检索到的文档与查询之间的相关性,这样就可以题上RAG的鲁棒性;

cancer_s的博客 1224

【C2000系列DSP的Bootloader详解】实现过程、流程图与示例代码

C2000 Bootloader 的核心逻辑可概括为 “初始化→选模式→加载程序→校验→跳转” 五步。对于小白来说,无需纠结底层寄存器配置(驱动库已封装),重点理解 “启动流程” 和 “数据传输 + 校验” 的核心思想即可。 通过本文的流程图和示例代码,相信你已经掌握了 C2000 Bootloader 的核心原理。实际开发中,可基于 TI 提供的 Bootloader 示例(C2000Ware 中自带)进行修改,快速适配自己的硬件和应用场景。

昔时扬尘处 368

verilog实现步进电机脉冲分配器(三相六拍)基于Nexys4DDR开发板

使用Verilog HDL设计的一个能够自启动、具有正反转功能的三相六拍步进电机脉冲分配器。已经写好Nexy4DDR的管脚约束文件 可以通过Nexys4DDR开发板的PMOD接口连接步进电机进行调试。 使用verilog语言 在vivado2018.2下运行编译下载都正确,(也可在ISE,QuartusII下使用)下面是工程截图: ...

QQ_778132974的博客 2589

RAG介绍及RAG的优化

信息检索和生成语言建模。这种方法旨在为语言模型提供访问外部数据源,来提高其在生成响应时的准确性和相关性,从而增强语言模型的能力。1)检索:用收到的query去库里查到最相关的文档或者上下文2)生成:把以上得到的内容输入给LLM,LLM通过理解和结合,整理回答出问题的答案。参考 https://mp.weixin.qq.com/s/mn0MilYoyV0Df_7SXnuY2g高级检索增强生成(Advanced RAG):对传统RAG增加复杂的检索前 和检索后过程。检索后:增加ReRank。

qq_29837229的博客 1143

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

企业中对RAG的优化方案

通过优化RAG在检索、语义和生成方面的性能,可以显著提升企业在不同业务场景中的数据处理效率和准确性。合理选择检索模式、解决语义问题以及引入先进的生成架构是实现这一目标的关键步骤。

菜鸟毅战 1374

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

检索增强生成RAG系列4--RAG优化之问题优化

方法描述场景通过生成更多角度的问题针对问题模糊时RAG-fusion在Multi-Query基础上,在检索文档结果后增加RRF重排针对问题模糊时HyDE使用大模型生成假设性答案,再使用答案去查询相似度,而不是原始问题用户问题和语义不在一个空间将问题分解为子问题,再通过并行或串行方式获得答案针对复杂问题或者需要逻辑推理问题Step-back使用few-shot方式,让大模型基于原始问题提出更为抽象问题针对复杂问题。

代码让AI扣 4314

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

RAG深入了解P1:从RAG类型出发看优化点

本文系统梳理了RAG(检索增强生成)技术的最新发展与应用。首先介绍了RAG的多种类型:基础RAG(标准检索-生成模式)、迭代RAG(引入反馈循环)、查询优化RAG(优化检索查询)、混合RAG(融合多种检索策略)以及RAG-Agent系统(结合智能代理)。接着探讨了RAG的优化方向,重点在于提升检索相关性和生成质量。文章指出,RAG技术正朝着更智能、自适应和具备多模态能力的方向发展,能够应对日益复杂的知识处理需求。通过分析不同类型RAG的特点和适用场景,为构建高效RAG系统提供了参考框架。

啾啾头号大粉丝打工买粮博客 1105

RAG 索引优化有哪些优化策略?

当我们从检索系统中得到大量的相关文档时,直接将所有内容拼接到提示(prompt)中传递给大语言模型,可能会超过模型的上下文窗口限制,或者导致模型处理效率低下。:RAG(检索增强生成)在检索召回率方面表现较低,尝试过调整块大小(chunk size)和采用混合检索方法,但效果不佳,需要进一步优化。是一种利用假设性文档来改进检索的技术。具体来说,先让模型根据查询生成一个假设的回答,然后将这个回答向量化,用来检索相似的真实文档。:对检索到的文档进行重新排序,优先展示与查询最相关的内容,减少不必要的信息干扰。

zc621_的博客 1404

RAG通用范式:RAG的入门介绍与实践优化

本文详细的介绍了RAG遇到的挑战、通用范式、工程实践、优化实现策略等内容

my_name_is_learn的博客 2065
上一篇: 应对RAG的缺陷!8种你不知道的方式
下一篇: 文档解析与向量化技术加速多模态大模型训练与应用
AI_小站
博客等级 码龄3年 6255粉丝 1151原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值