


继 01 大模型基础能力构建 之后,继续阅读该篇。
完整阅读:
01 大模型基础能力构建
03 大模型核心开发框架
9 LangChain概述与架构
如果是java选手,学习过langchain4j,上手这部分内容应该很快。
先详细看看课程目标
- 建立对 LangChain 的整体认识,知道它是什么、解决什么问题、在 AI 应用开发里处于什么位置。
- 理解 LangChain 在 1.x 时代的产品边界、包结构、版本演进,以及它与 LangGraph、LangSmith、Deep Agents 的关系。
- 建立对 Model I/O、Chains、Memory、Retrieval、Tools/Agents、Callbacks 这六类教学视角的整体认知。
看完第9章建立认知,第10章实践进行熟悉。
1 Langchain简介
LangChain 是一个面向 LLM 应用开发的开源框架。它本身不是大模型,也不是数据库,更不是知识库平台;它更像一层“应用编排层”,负责把模型、提示词、外部知识、工具、记忆、输出解析、调试追踪等能力组织成一个完整、可维护、可扩展的 AI 应用。
Langchain是 用代码把大模型和外部世界连接起来的应用开发框架
Langchain在于把原本零散的东西组织起来,
- 不同厂商的大模型调用方式
- Prompt 与多角色消息
- 结构化输出与解析
- 检索增强生成(RAG)
- 工具调用、Agent、多步任务
- 记忆、会话状态、持久化
- 日志、追踪、调试、评估
直接调API可以,适合简单任务,但是做应用,框架就会越来越有价值。
如下图所示的对比,可以利用框架进一步抽象,隔离,进行统一编排,统一接入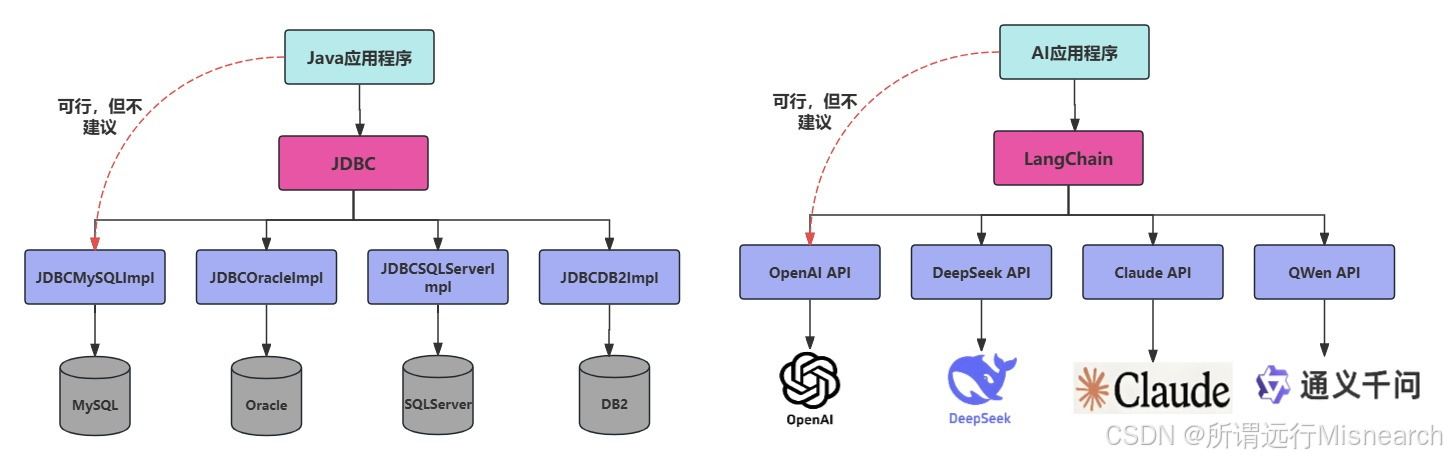
Coze/Dify等平台是低代码平台,受限于平台。
Langchain是代码框架或库,在 Python 或 JS 中以代码方式编排模型、工具、RAG、Agent
实际项目里可以先低代码验证,再代码化落地。
现在版本更稳定,1.x版本,学习入口更清晰,重点放在 create_agent、统一模型初始化、消息、工具、记忆、检索和可观测性上。
LangChain、LangGraph、LangSmith 的分工更明确:你更容易理解“什么时候用高层框架,什么时候用底层图编排,什么时候做调试与评估”
LangChain 的优势很明显,但它也不是银弹。学习时要同时看到它的“能做什么”和“不能替你做什么”。
优势:
- 统一模型接口,降低模型切换和多模型共存成本。
- 提供 Prompt、Message、Parser、Retriever、Tool、Agent 等常用抽象。
- 能把“单次调用”提升为“可维护流程”。
- 与 LangGraph、LangSmith、MCP 等生态衔接紧密,利于走向复杂应用。
- 资料多、案例多、社区活跃,适合建立体系化认知。
边界:
- 它不会替你设计业务逻辑,只是帮你更好地实现。
- 它不会替你训练模型,模型能力强弱仍取决于底层模型。
- 它不会替你存业务数据,向量库、数据库、对象存储仍要你自己选型。
- 它不会天然让效果变好,Prompt、知识质量、工具设计、评估流程依然是关键。
不足与槽点:
- 版本变化快:老教程里的类名、导入路径、写法,很可能在新版本里已经迁移。
- 抽象多,学习成本不低:初学时容易觉得“明明只是调个模型,为什么多了这么多概念”。
- 历史包袱真实存在:很多文章还在讲 LLMChain、ConversationChain、旧版 AgentExecutor,但新项目未必应照搬。
- 文档存在新旧并存现象:官方文档已经比早期稳定很多,但生态广,仍会碰到版本语境不一致的问题。
所以结论很明确:LangChain 适合做 AI 应用,但要用“工程框架”的心态去学,不要把它当成一个简单工具函数库。
2 LangChain定位
2.1 大模型开发体系分类
按照大模型相关工作,从底到顶的一个分类
- 基础模型层
- 模型定制层
- 应用开发层
LangChain 主要服务的,就是第三层:应用开发层。负责如何把模型能力变成一个能工作的应用系统。显然LangChain,LangGraph是服务编排层。
数据流:请求 自上而下(用户 → 服务/链 → 模型 → 存储),结果 自下而上返回用户;LangChain 处在 服务/编排层,串联 UI、模型与存储,而不是替代其中任一层。
2.3 使用场景
真实项目里,LangChain往往会承担下面几件事:
- 统一接模型
- 统一处理输入输出:用PromptTemplate、消息对象、输出解析器来规范请求与结果
- 组织固定流程
- 接入工具与外部系统
- 管理状态与记忆
- 做调试与评估
学习框架,掌握这套思维,再迁移到其他框架会快很多。
这里的简历看一下,
3 LangChain包与版本管理
3.1 版本演进:从链到Agent + 图 + 生态
- 第一阶段:0.0.x/0.1早期版本,特点是链优先
- 第二阶段:0.2,0.3阶段,开始重视生态拆分和工程边界
- 第三阶段:1.x阶段,重点变成精简主包,强化Agent,与LangGraph深度融合
2025年10月20日发布LangChainv1.0.0
3.2 当前官方产品线理解
官方讲一整套出产品线。
- LangChain:高层应用框架,快速构建,屏蔽大量底层细节
- LangGraph:低层图编排与运行时
- LangSmith:可观测性、评估、调试、部署平台,用来追踪、调试、评估和上线应用
- Deep Agents:开箱即用的复杂Agent方法,建立在Langchain/ LangGraph之上
3.3 0.x与1.x的核心差异
如下图所示:
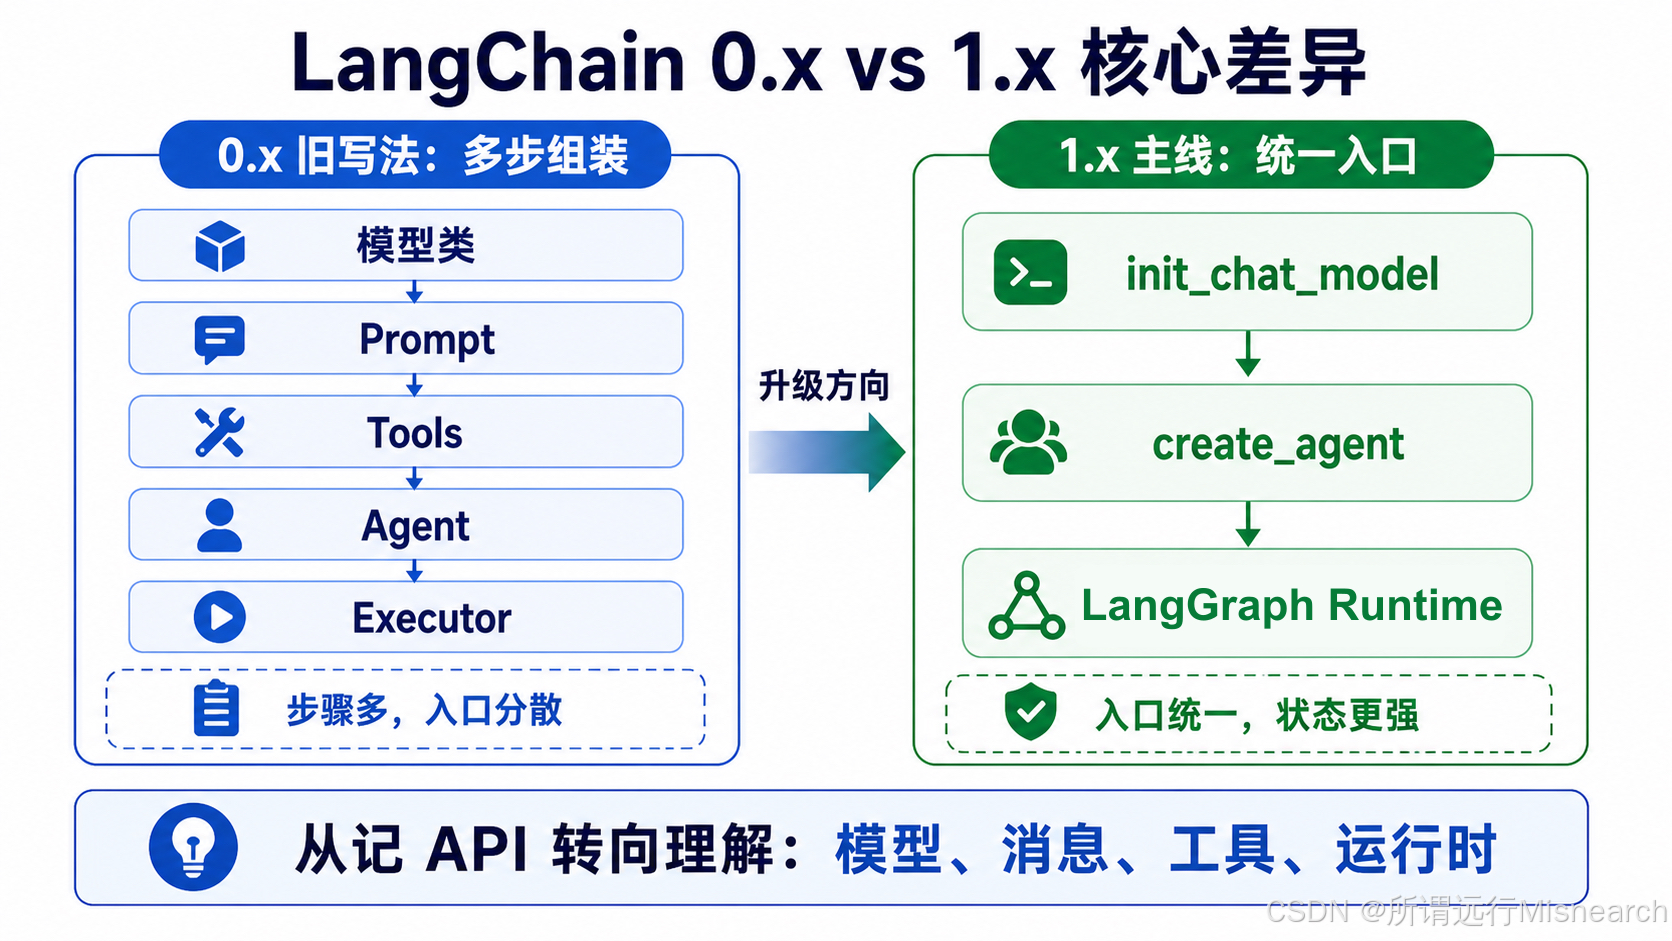
1.x更像精简主包 + 统一入口 + Agent建立在LangGraph之上
下面有一个0.x和1.x版本对比:
| 对比项 | 0.x写法 | 1.x写法 |
|---|---|---|
| Agent 创建 | 常见要手动组装Agent + Executor | 以create_agent为主入口 |
| 模型初始化 | 常见直接记忆具体类或旧导入路径 | 更强调统一入口,如init_chat_model |
| 主包内容 | langchain中内容很多,历史包袱重 | langchain主包被精简,只聚焦核心能力 |
| 旧能力去向 | LLMChain, 老Retriever等混在主包中 | 迁到langchain-classic |
| 底层运行时 | 以前很多人只感受到链 | 现在agent明前建立在langgraph之上 |
| python版本 | 老资料中常见3.8, 3.9 | 官方1.x要求python3.10 |
3.4 LangChain常见包
按照官方主线重新梳理
- langchain-core:核心抽象层,包含消息、Runnable、工具基础、Prompt 基础、模型接口等,是整个生态的底座
- langchain:高级应用框架主包,1.x中聚焦核心高层能力,如Agent,统一模型初始化,消息与工具等
- langchain-openai/ langchain-anthropic/langchain-allama:厂商/provider集成包,每个模型 厂商或平台通常有自己的独立集成包,便于独立版本管理。
- langchain-community:社区集成包,放置大量社区维护的集成,例如某些工具,loader, 向量库等。
- langchain-classic:旧版兼容包,
- langgraph:图编排与运行时,用于构建更复杂、可控、可持久化的Agentic workflow
- langsmith:调试、评估、Tracing SDK,对接LangSmith平台,常用语可观测性与实验评估
- langchain-text-splitters:文本切分组件,RAG常用,负责把 长文本拆分为合适片段。
- langchain-mcp-adpters:MCP适配包,用于在langchain/langgrpah应用中接入MCP工具
4 LangChain核心模块
4.1 全景图
下面这张图展示了完整知识体系,
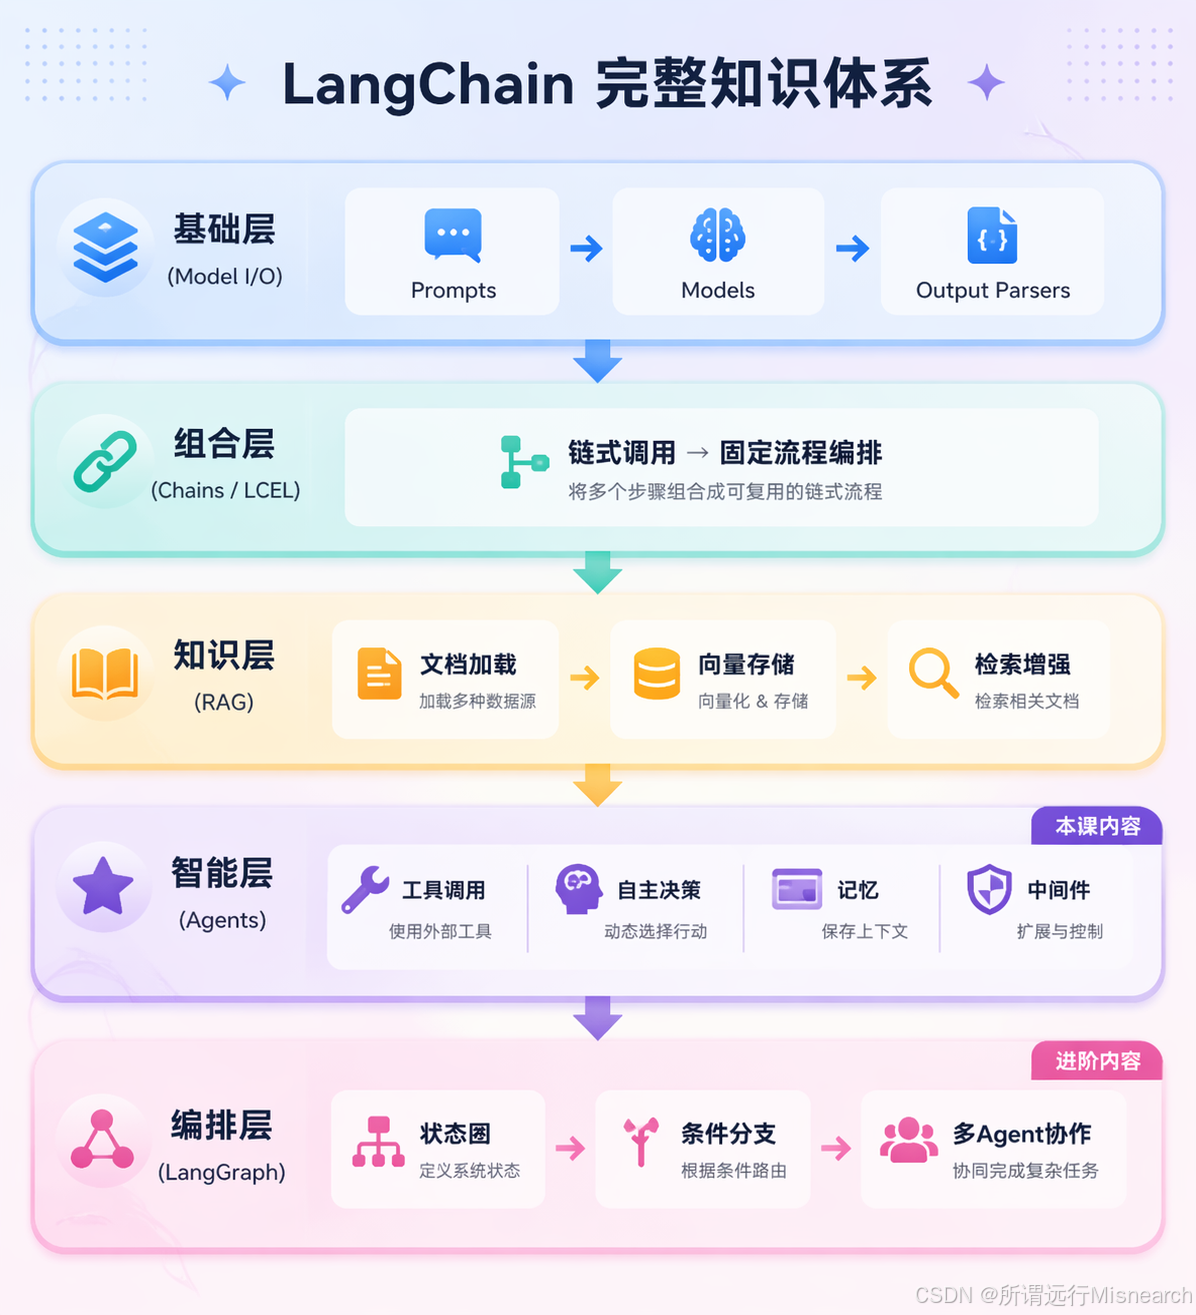
从这个视角看,LangChain 的核心模块其实是在回答六个问题:
- 怎么接模型:Model / Model I/O
- 怎么组织固定流程:Chains / LCEL
- 怎么记住上下文:Memory
- 怎么接外部知识:Retrieval / RAG
- 怎么让模型会做事:Tools / Agents
- 怎么观测与调试:Callbacks / LangSmith
4.2 Model I/O 模型输入输出
该部分是有关模型调用本身的一圈能力,解决的是输入怎么组织、模型怎么调、输出怎么拿的稳。
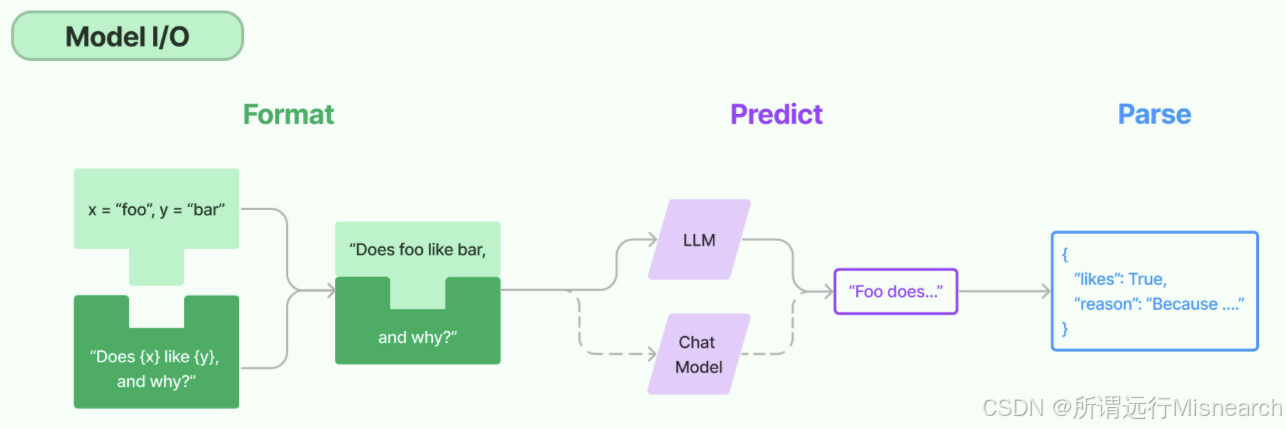
主要包含:
- Format:输入格式化,把原始输入组织成prompt或多角色消息
- Predict:模型调用,用统一接口调用不同厂商模型
- Parse:输出解析,把自然语言输出转成更稳定的结构化结果
4.3 Chains链:固定流程编排
Chain核心思想很简单:把多个步骤按固定顺序串起来。
链式思维仍然是LangChain的基础能力。
固定流程更适合Chain/LCEL。动态决策流程更适合Agent/Graph。
4.4 Memory记忆:记忆与上下文状态
Memory指的是应用如何“记住”过去发生过什么。注意,这里的记忆不是让模型变得更聪明,而是让系统在多轮交互中保留必要上下文。例如历史对话、用户偏好、会话状态、阶段性结果等。
在官方当前语境里,记忆通常会去分为Short-term Memory,和Long term memory。
4.5 Retrieval检索:检索与RAG
Retrieval模块解决的是模型不知道的知识从哪里来的问题。
是RAG的核心组成部分,负责从外部知识源中检索和当前问题相关的信息,再把检索结果交给模型辅助生成答案。
4.6 Tools/Agents:让模型不只是会说,还会做
4.6.1 Tool是什么
Tool本质上是一个可以被模型调用的外部能力
4.6.2 Agent是什么
则是在Tool之上再多一层,不是简单执行固定步骤,而是让模型根据当前任务自主决定下一步该做什么。
在1.x官方语境下,LangChain的Agent已经明确建立在LangGraph运行时之上,即使只是调用 create_agent,底层也不再只是一个松散的“工具循环”,而是带有状态、节点、流转、持久化能力的图式运行逻辑。
4.7 Callbacks回调:日志、调试与可观测性
一个可用的AI应用,不只是能跑,还要能看见他怎么跑。
现在官方更强调的是LangSmith + Tracing + Evaluation这一整套可观测性能力。
AI应用最难排查的问题,通常不是程序报错,而是为什么这次没检索到,为什么调了错误工具,为什么模型理解偏了,为什么这轮成本突然变高,为什么线上效果和本地不一致。
如果没有可观测性,很多问题只能猜。
4.8 六大模块总览
教学视图下的六大模块
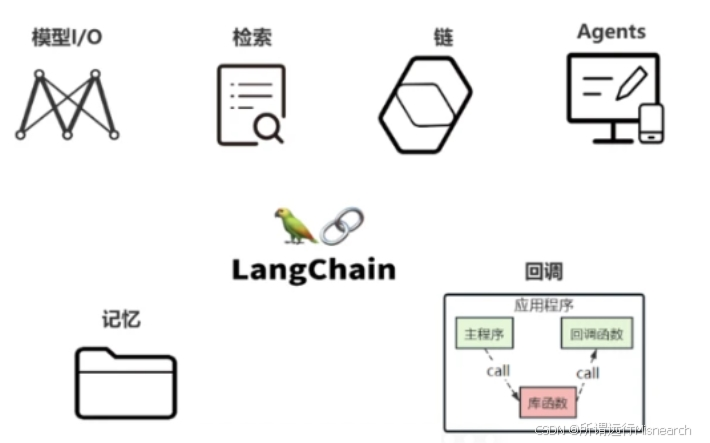
官方 1.x 文档中,你会看到这些能力被拆到 Agents、Models、Messages、Tools、Memory、Retrieval、Streaming、Structured Output、Middleware、Runtime、LangSmith 等更细的栏目里
进一步展开模块:
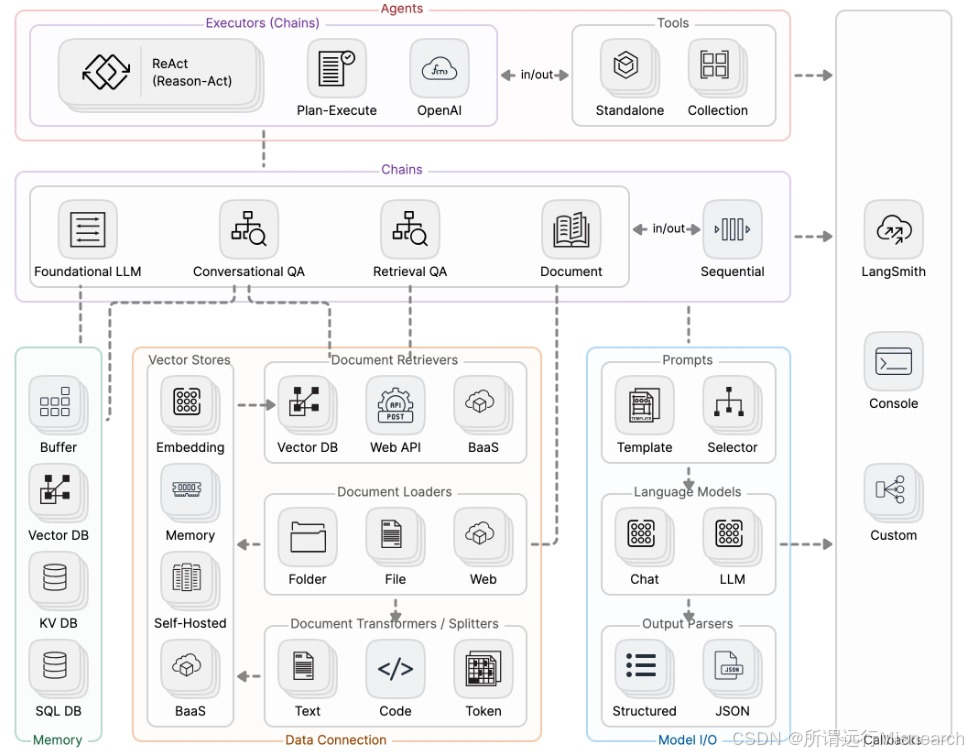
根据图的理解,理解LangChain做的不是某一件事,而是把模型调用、知识接入、流程编排、状态管理、工具执行、调试追踪这些原本分散的环节串成一个工程系统。
4.9 怎么记这套框架
章节思考题
为什么学习LangChain时要同时知道1.x,provider, Langgraph,
A : 1.x是当前主线,provider包负责具体模型接入,LangGraph承担复杂流程和Agent的底层编排
10 LangChain快速上手与HelloWorld
langchain中文文档链接
中文文档都是翻译更新的,可能慢于官方文档的更新速度
这里需要在新电脑按照之前配置环境配置好python3.10的虚拟环境。
这里还是解释一下pip和uv,
- pip:它是 Python 的官方包管理工具(全称 Pip Installs Packages)。开发者使用它来查找、下载、安装、升级和卸载 Python 第三方库和依赖包。例如,使用 pip install requests 就可以安装网络请求库13。
- uv:它是一个用 Rust 编写的、极其快速的 Python 包和项目管理器。你可以把它理解为 pip 的“超级替代品”。它的核心优势是速度极快(比传统 pip 快 10 到 100 倍),并且兼容 pip 的常用命令(如 uv pip install),同时还集成了虚拟环境管理等高级功能
1 LangChain环境与约定
1.1 支持的大模型与课程选用
langchain官方提供了完整的provider列表,将provider理解为封装好各个大模型的api提供者,只需要安装对应包 -》设置模型名称就可以切换各个大模型。
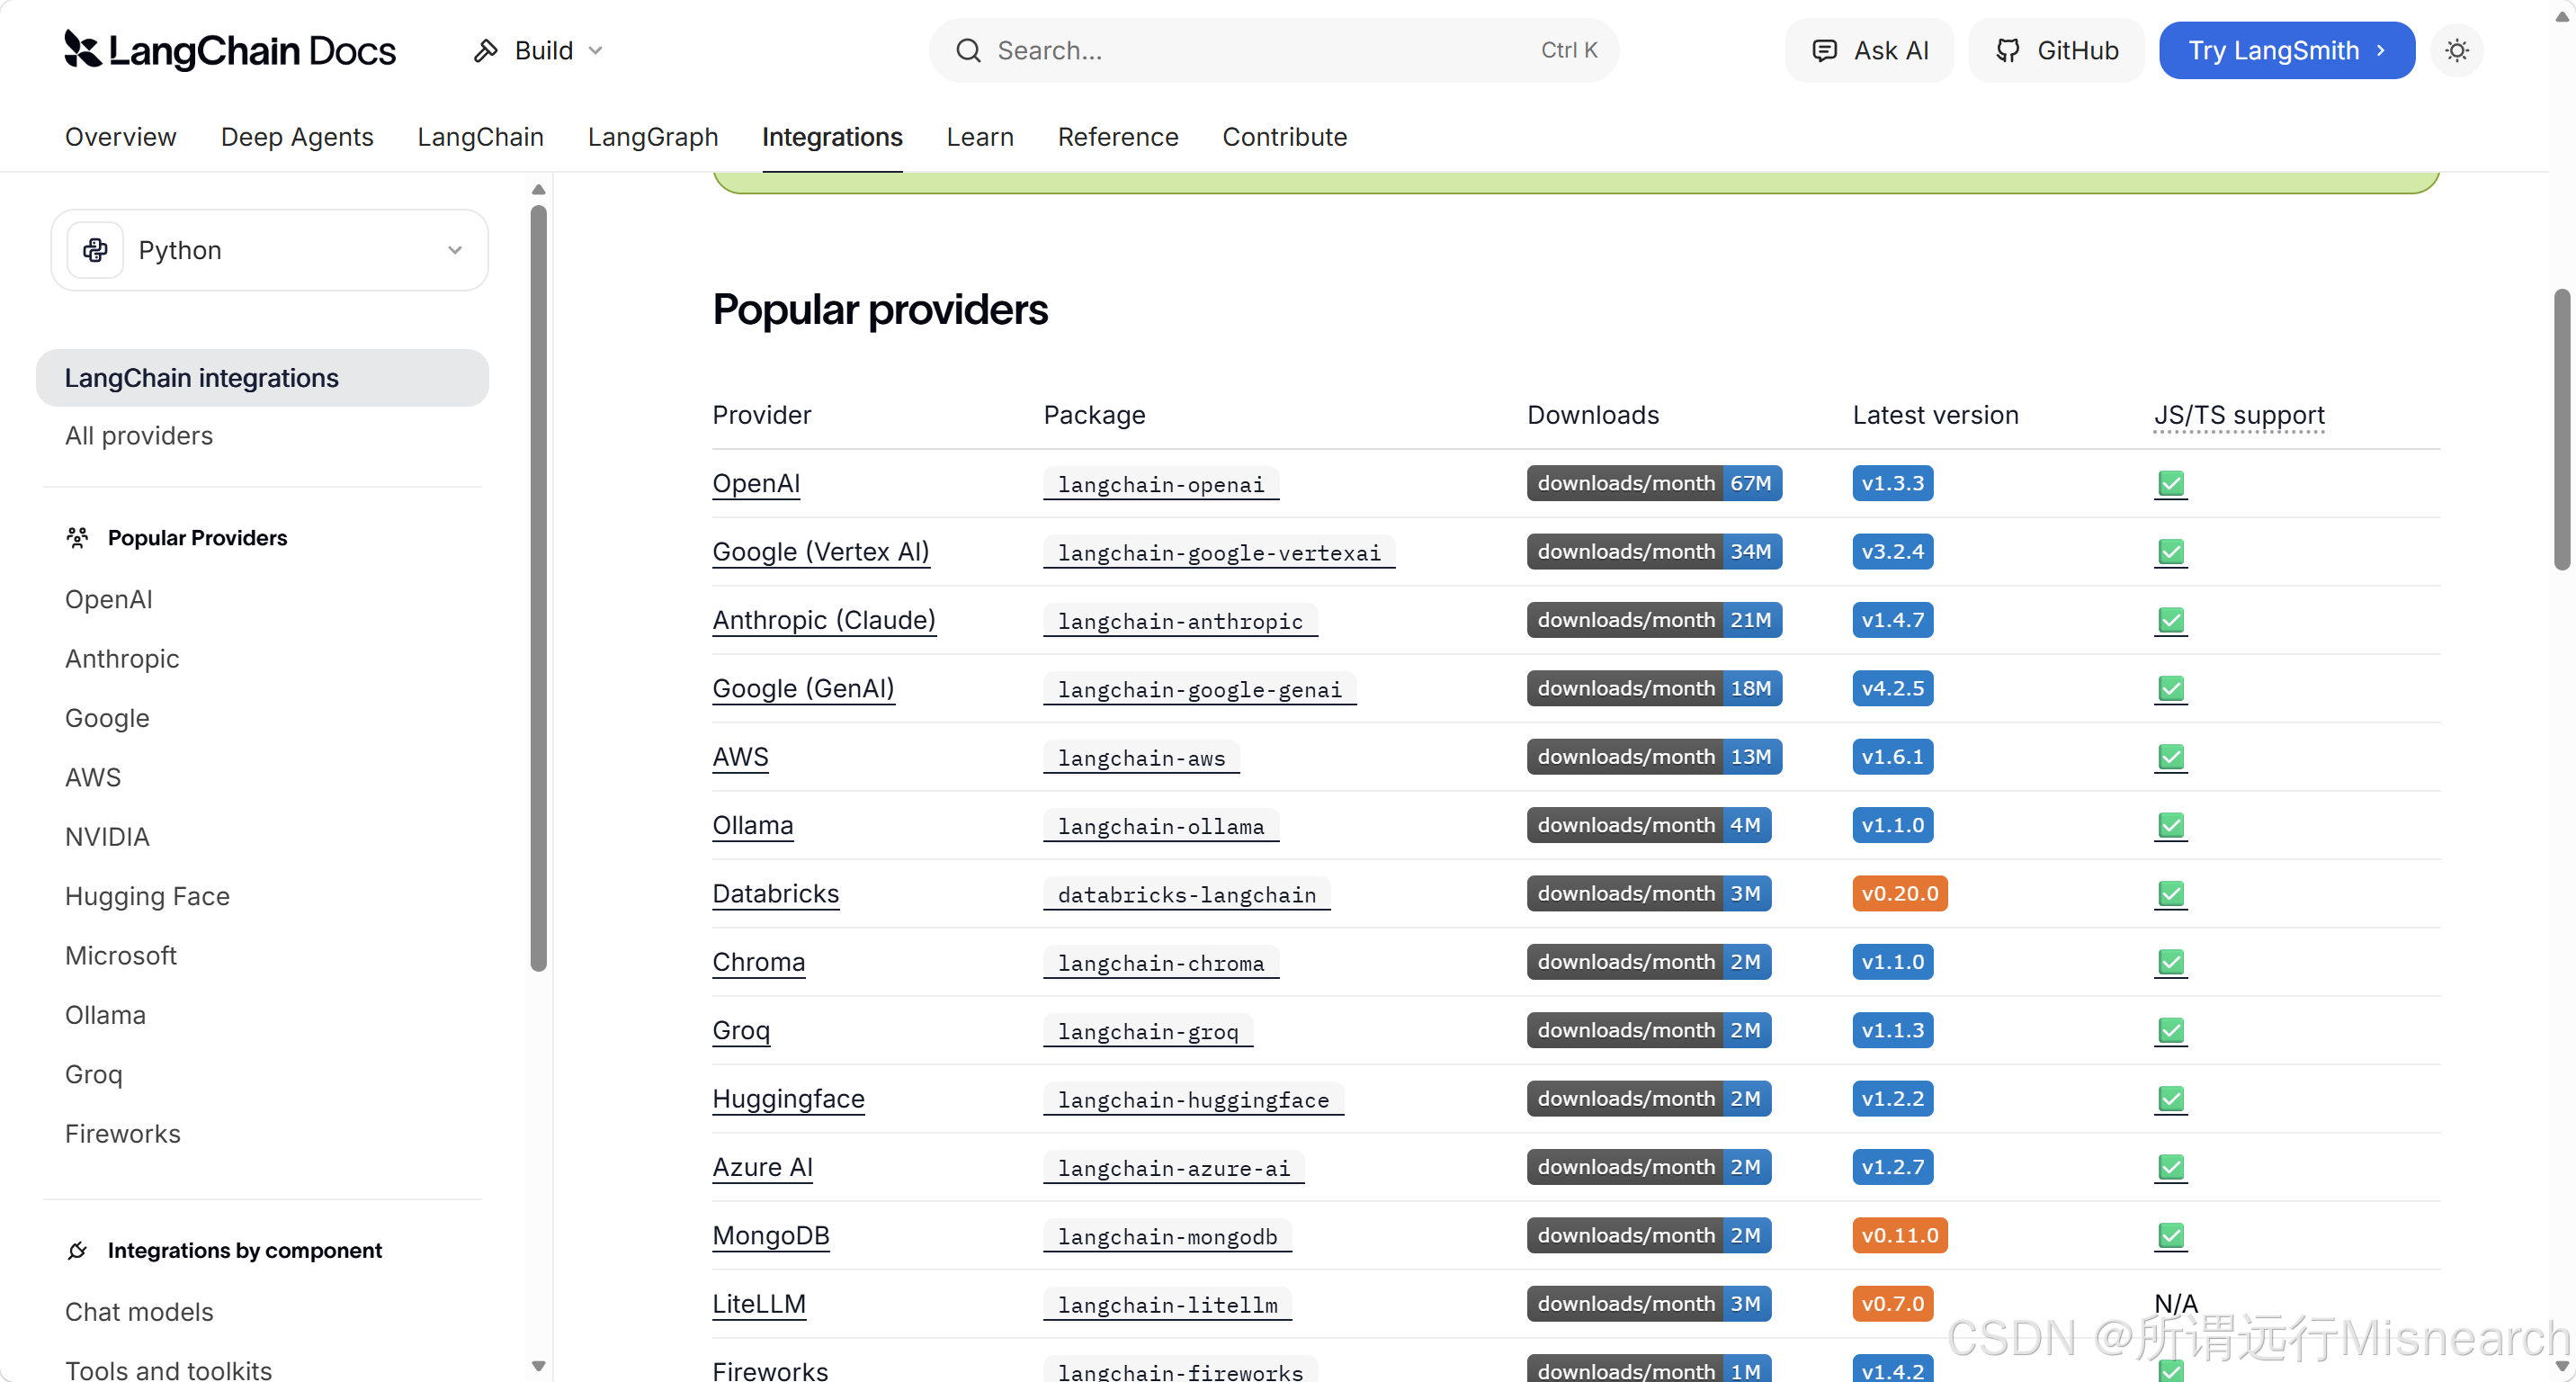
本课程选择阿里云百炼、千问,关键是理解怎么用langchain接模型。
1.2 python版本
langchain1.x推荐python3.10
1.3 运行案例前置注意事项
- 尽量在项目根目录运行案例
- 先配置.env,
2 常见大模型服务平台介绍
2.1 调用三件套
- API KEY
- 模型名
- Base URL
2.2 常见平台
3 安装依赖
将仓库拉到本地,安装依赖,之前已经弄好了。
3.3 验证安装
执行GetEnvInfo.py,检测环境,如图所示:
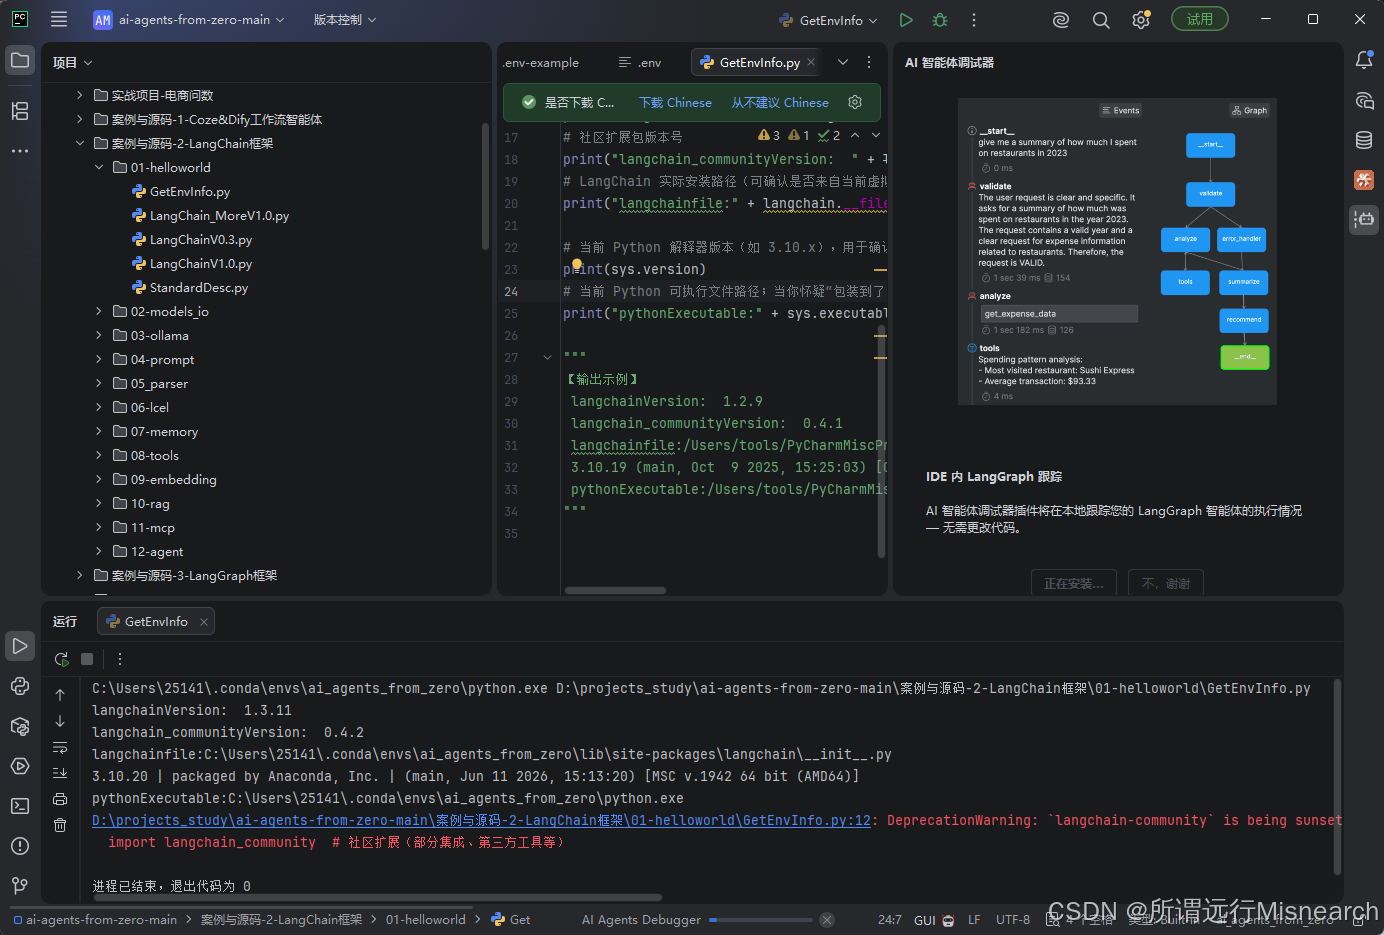
并下载了AI Agents Debugger插件,用于调试langgraph agent。
运行项目时要确保用的同一个python环境。
4 案例:基于百炼的HelloWorld
例如在百炼上找到:
- 模型名:qwen3.6-35b-a3b
- baseUrl:可以在对应模型下面找到OpenAI兼容,https://llm-55uiolr4hol9nlrx.cn-beijing.maas.aliyuncs.com/compatible-mode/v1
- api-key:在.env中声明了
4.2 HelloWorld的最小调用链路
最小链路流程:
准备三件套 → 初始化模型 → invoke("问题") → 读取 response.content
其中关键词:
- invoke:同步调用模型,返回一个消息对象
- .content:取出消息对象里的正文文本
4.3 示例代码
通过阅读代码,掌握这样的习惯,不将api-key硬编码到代码里,而是通过os.getenv()获取
查看langchain1.x写法
- 使用init_chat_model统一入口调用大模型,通过model_provider指定厂商
- 接国内平台(阿里百炼、通义等)时需显式写 model_provider=“openai”,否则会报错无法推断 provider。
- 调用三件套:API Key、模型名、Base URL;invoke(问题) 返回消息对象,.content 取正文。
其中invoke源码定义:
@override
def invoke(
    self,
    input: LanguageModelInput,
    config: RunnableConfig | None = None,
    *,
    stop: list[str] | None = None,
    **kwargs: Any,
) -> AIMessage:
invoke接收用户的输入和运行时配置,调用底层的大语言模型生成响应,并最终将其转换为标准的AIMessage对象返回。
- @Override是python3.12+引入的装饰器,明确表示该方法是对父类中invoke方法的重写
- input用户的输入,可以使字符串,消息列表等
- config:LangChain的运行时配置对象,用于控制执行行为
- stop:可选参数
核心执行与结果转换,嵌套的cast逻辑,从内向外执行以下操作:
# 1. 输入转换与生成请求
self.generate_prompt(
    [self._convert_input(input)],  # 将原始输入转换为模型能理解的格式
    stop=stop,                     # 传入停止词
    callbacks=config.get("callbacks"), # 提取配置中的回调处理器
    tags=config.get("tags"),           # 提取标签
    metadata=config.get("metadata"),   # 提取元数据
    run_name=config.get("run_name"),   # 提取运行名称
    run_id=config.pop("run_id", None), # 提取并移除运行ID
    **kwargs,                          # 其他额外参数
)
# generate_prompt 返回的是一个包含 generations 列表的 LLMResult 对象

# 2. 提取生成结果并转换类型
# .generations 获取了第一个批次中的第一个生成结果(ChatGeneration 对象)
cast("ChatGeneration", ...).message
# 从 ChatGeneration 对象中提取出底层的 message 属性

# 3. 最终类型转换
cast("AIMessage", ...)
# 确保最终返回的对象被明确标记为 AIMessage(AI 消息)类型
这段代码本质上是一个“适配器”。它将 LangChain 标准的 invoke 调用,转化为底层 generate_prompt 的调用,并且通过 config 实现了任务追踪、超时控制、日志记录等运行时控制712。最后,它把大模型返回的复杂嵌套结果(LLMResult -> ChatGeneration -> Message),剥离并强转为标准的 AIMessage,以便在 LangChain 的对话链(Chain)或 Agent 中继续流转
在openAI中的格式调用就是:
# Please install OpenAI SDK first: `pip3 install openai`
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get('DEEPSEEK_API_KEY'),
    base_url="https://api.deepseek.com")

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False,
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}}
)

print(response.choices[0].message.content)
可以发现langchain的invoke就是封装了的,可以理解为response.choices[0].message就是langchaininvoke得到的AIMessage,然后可以通过.content拿到正文,如下图所示:
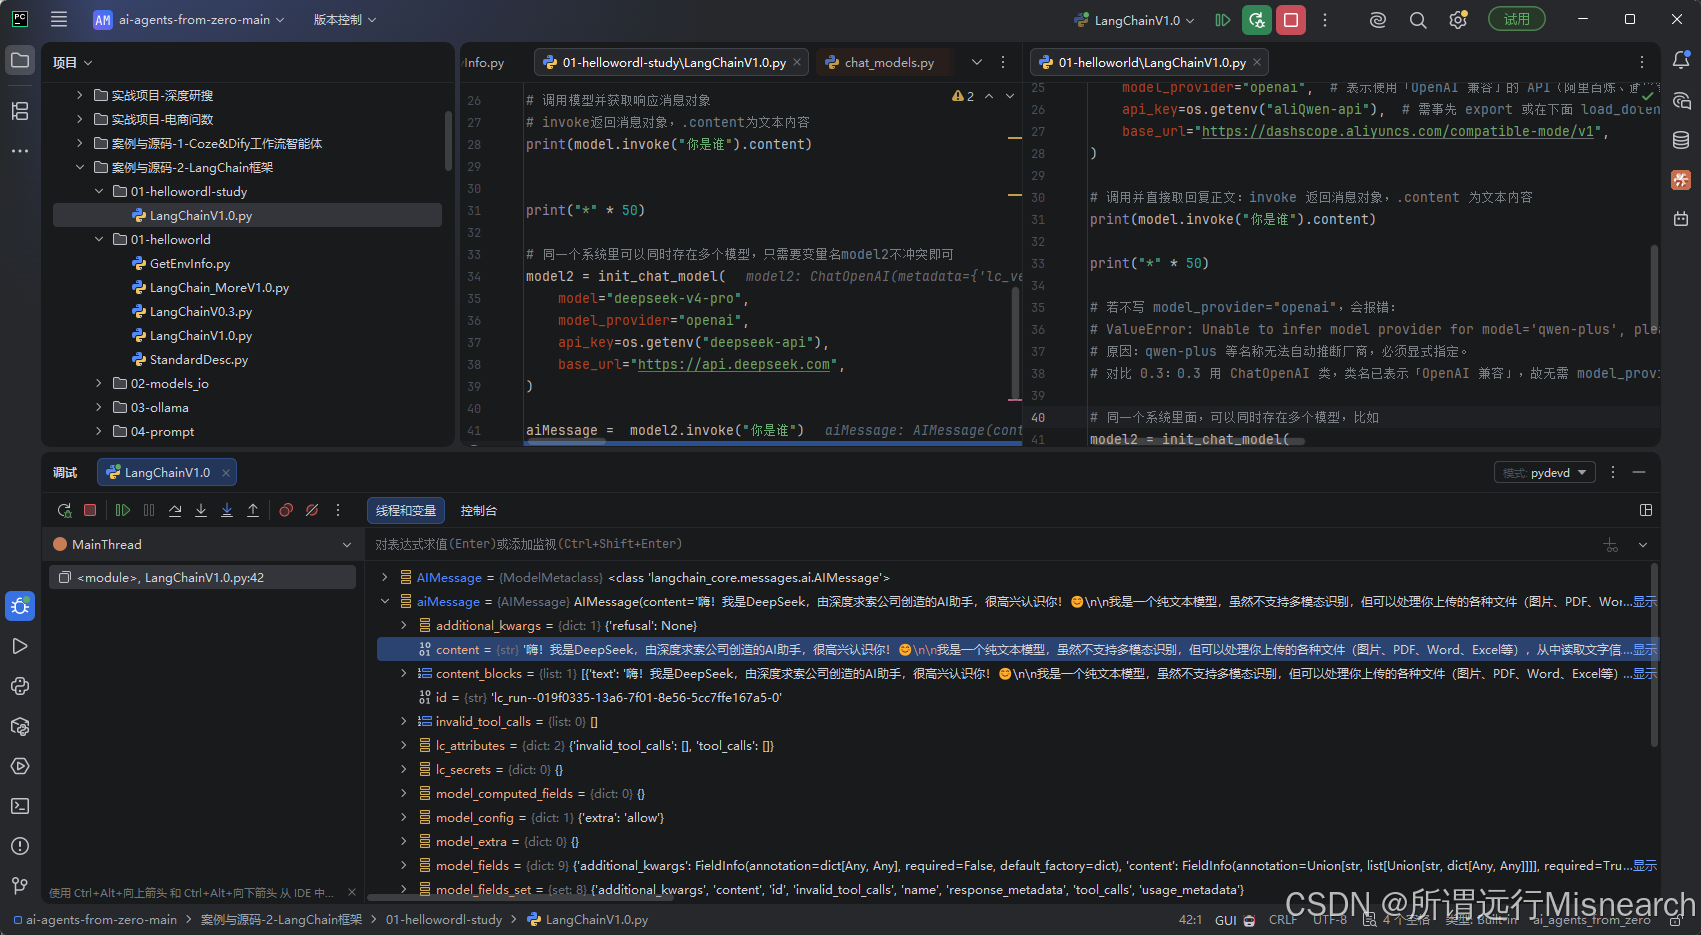
通过init_chat_model统一入口,不需要再为每个模型厂商记一套不同的初始化方式,而是先记住同一套调用骨架,通过参数切换不同模型和provider
4.4 0.3与1.0写法差异
0.3 / 经典写法的思路是:
- 直接从具体集成包导入类,例如 ChatOpenAI
- 类名本身就带有“我是按哪种协议接入”的语义
- 代码非常直观,但不同厂商、不同类名会让项目越写越散
1.x 的思路是:
- 用 init_chat_model 作为统一入口
- 通过 model、model_provider、api_key、base_url 等参数描述“我要接谁”
- 同一套代码骨架更容易迁移、统一与维护
5 多模型共存
5.1 多模型共存场景
存在不同模型的需求
5.2 调用三件套
5.3 多模型共存示例代码
记住就是多个模型使用变量名进行区分。
6 实战:企业级封装与流式输出
6.1 从HelloWorld到项目写法
真实项目里还要那么些就有问题了,因此要了解企业级封装和流式输出。
6.2 invoke()与stream()的区别
invoke()就是一次性返回完整结果。适合简单问答,后台处理,不需要实时展示中间输出的场景。
stream()就是变生成边返回。适合命令行实时输出,聊天界面打字机效果,长文本生成,用户等待体验更敏感的场景。
示例:
for chunk in model.stream("请介绍一下LangGraph"):
	print(chunk.content, end="")
6.3 示例代码
下面是自己按照langchain1.0版本风格写的封装初始化代码
"""
【案例】标准/工程化写法,用LangChain调用大模型invoke或者stream

将初始化模型封装成函数便于复用
    用.env存密钥
    logging打日志
    try/except区分错误

运行前记得在项目根目录配置.env中的api_key
这里直接看LangChainV1.0风格的写法
"""
# 导入环境
import os
import logging
from unittest import loader

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.exceptions import LangChainException

load_dotenv(encoding="utf-8")

# 日志配置
_log_level = os.getenv("LOG_LEVEL", "INFO").upper()
logging.basicConfig(
    level=getattr(logging, _log_level, logging.INFO),
    format="%(asctime)s - %(levelname)s - %(message)s",
)

logger = logging.getLogger(__name__)

# LLM客户端初始化,封装为函数,便于多处复用
def init_llm_client():
    """
    肯定是返回初始化好的模型实例
    """
    api_key = os.getenv("deepseek-api")
    if not api_key:
        raise ValueError("环境变量DEEPSEEK_API_KEY未配置,请检查.env文件")

    return init_chat_model(
        model="deepseek-v4-pro",
        model_provider="openai",
        api_key=api_key,
        base_url="https://api.deepseek.com",
    )


# 主逻辑:invoke或者stream两种调用方式
def main():
    """
    主函数:封装核心逻辑,符合python工程化规范
    """
    try:
        model = init_llm_client()
        logger.info("LLM客户端初始化成功")

        # invoke方式
        question = "你是谁"
        response = model.invoke(question)
        logger.info(f"问题:{question}")
        logger.info(f"回答:{response.content}")

        # stream流式,边生成边输出
        print("============下面是流式输出=============")
        print("*" * 50)

        for chunk in model.stream(question):
            print(chunk.content, end="")

        print()
    except ValueError as e:
        logger.error(f"配置错误:{str(e)}")
    except LangChainException as e:
        logger.error(f"模型调用失败: {str(e)}")
    except Exception as e:
        logger.error(f"未知错误:{str(e)}")


# 注意不要开代理,否则无法正常访问API端点
if __name__ == "__main__":
    main()
上述示例:
- 把模型初始化封装为函数,避免到处重复写配置
- 显式检查环境变量
- 使用日志,这个很重要,
- 区分异常类型,便于排查问题
- 同时演示invoke和stream()
思考题
真实项目里还要处理配置校验、日志、异常、超时、重试、流式输出和敏感信息隐藏
接下来学习11,13,14,掌握完整的输入-》模型-》输出
第11章:Model I/O与模型接入
掌握Modell I/O模块中的输入提示Promot, 调用模型Model, 输出解析Parser三件套
掌握LangChain里最常见的模型分类,标准化参数,返回值结构
1 Model I/O 简介
1.1 定义
该模块关心的是模型的输入、调用和输出。
- Format(输入格式化):把原始业务输入整理成模型更容易理解的形式,例如 Prompt 模板、多角色消息、变量填充等。
- Predict(模型调用):通过 LangChain 的统一接口调用不同模型提供商,例如 OpenAI、DeepSeek、阿里百炼、Ollama 等。
- Parse(输出解析):把模型返回的自然语言结果转成更稳定、程序更好处理的形式,例如字符串、JSON、结构化对象等。
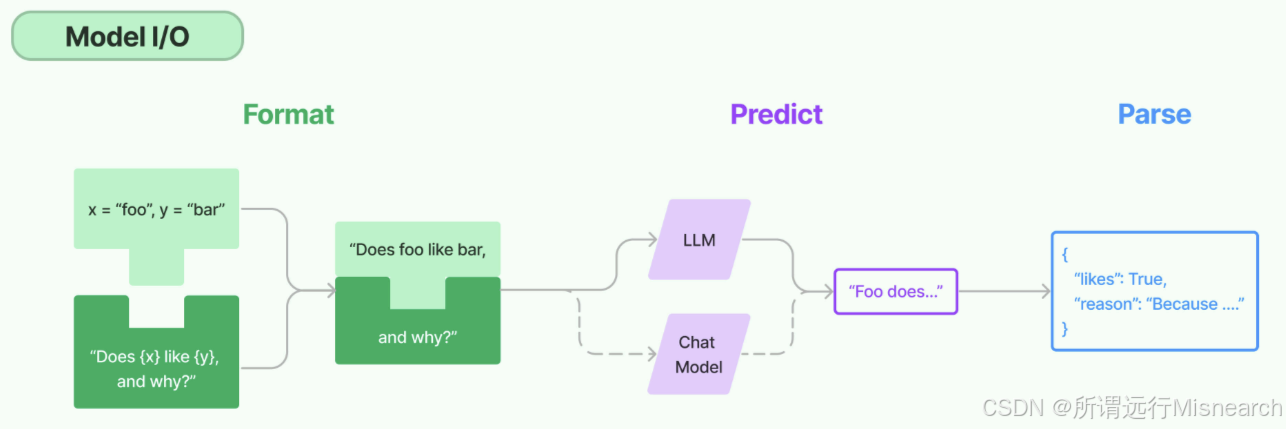
1.2 为什么需要Model I/O
真实项目里,还是需要Model I/O进行解决
2 LangChain模型分类、参数与返回
讲解模型调用Predict,弄清楚:
- LangChain中到底有哪些模型类型
- 调模型时常见参数是什么
- 调完模型后,返回的到底是什么
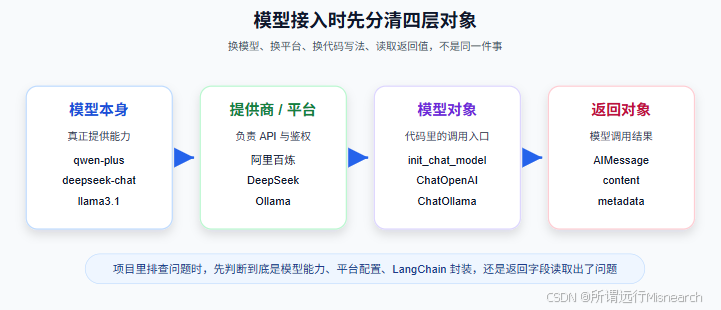
2.1 先分清:模型本身,模型提供商,LangChain模型对象
这个很好理解
2.2 LangChain常见模型分类
这里再次回顾LangChain框架是什么,是为了开发LLM应用程序设计的开源框架。
所以LangChain不提供模型权重本身,提供的是如何接这些模型的统一抽象。
LangChain的核心价值与能力体现在:
- 模块化的组件结构,这在第4章讲了一个概览,有一个印象
- 解决原生API调用的痛点
- 强大的生态与扩展能力
覆盖了AI应用从开发、测试到部署的完整生命周期。
LangChain中实际开发过程中最常用的是聊天对话模型,用于多轮对话、系统角色、用户消息等场景。
最常碰到的三类:
- LLM
- ChatModel
- Embeddings
后面的Prompt, Message, Tools, Agent, Memory本质大多都建立在ChatModel的消息交互之上。
2.3 LLM和Chat Model区别
在LangChain中,LLM和ChatModel,接口思维不一样,
- LLM更像给一段文本,让模型补全或生成下一段
- CahtModel更像给一段对话上下文,让模型按角色回复。
LLM风格就是提供prompt = "这是什么"
而ChatModel风格如下:
messages = [
    {"role": "system", "content": "你是一个技术助教"},
    {"role": "user", "content": "请用一句话解释什么是 LangChain"},
]
2.4 为什么Embedding放在这里
是向量模型
2.5 常用模型参数
LangChain对聊天模型定义了一批标准化参数,名称在不用写发下基本一致
掌握参数:
- model
- model_provider
- api_key
- base_url
- temperature
- max_tokens最大生成长度
- timeout超时时间,请求最长等多久
- max_retries 失败重试次数
- stop停止词,生成到某些位置时强制停止
在项目里最先调temperature 和max_tokens
2.6 Token, max_tokens与计费的关系
用量统计通常都以token数为单位
也有token可视化工具
2.7 参数的选择
根据业务场景选:
- 客服问答 / 规则回答 / 翻译:temperature 往往设低一些,例如 0~0.3
- 知识问答 / 通用助手:可设在 0.2~0.7
- 文案、创意写作、头脑风暴:可适当更高,例如 0.8~1.2
max_tokens 的使用也一样:
如果只是简短问答,可以限制小一点,避免无意义长回答
如果是总结、分析、长文输出,可以适当放大
但有一点要始终记住:
参数只是调味料,底层模型能力、Prompt 设计、上下文质量,通常比单纯调 temperature 更重要。
2.8 基本案例
temperature取值范围在0-2
"""

理解模型参数与返回对象结构
temperature影响输出随机性
max_tokens控制返回长度涉及到成本
使用api_key为deepseek_api


"""
import os
from langchain.chat_models import init_chat_model

from dotenv import load_dotenv

load_dotenv(encoding="utf-8")

# 实例化设置常用参数

model = init_chat_model(
    model="deepseek-v4-flash",
    model_provider="openai",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
    temperature=0.7,  # 0~1,越高越随机;此处略高便于看到多次输出差异
    # max_tokens=256,  # 可选:限制单次回复长度
)

print(model.invoke("写一句关于春天的词,14字以内"))
print(type(model))
print(type(model.invoke("写一个关于春天的词,14字以内").content))
print(type(model.invoke("写一句关于春天的词,14字以内")))
通过上述案例理解模型和返回的类型
2.9 调用后的返回信息
将init_chat_modle理解为模型客户端对象,invoke()返回的是<class 'langchain_core.messages.ai.AIMessage'>
2.10 AIMessage上常见字段
掌握字段:
- content
- response_metadata,厂商返回的原始元数据,用于看模型名、finish_reason, token_usage等
- usage_metadata,这是langchain统一整理后的用量信息,看input/output/total tokens
- tool_calls工具调用信息
- additional_kwargs厂商扩展字段
所以可以看到一个典型的AiMessage:
AIMessage(
  content='《鹧鸪天·春》\n一篙绿涨江南岸,…',   # 用户可见回复
  response_metadata={
    'token_usage': {
      'prompt_tokens': 14,
      'completion_tokens': 109,
      'total_tokens': 123,
      ...
    },
    'model_name': 'deepseek-v4-flash',
    'finish_reason': 'stop',
    ...
  },
  usage_metadata={
    'input_tokens': 14,
    'output_tokens': 109,
    'total_tokens': 123,
    ...
  },
  tool_calls=[],
  ...
)
如图加深理解:
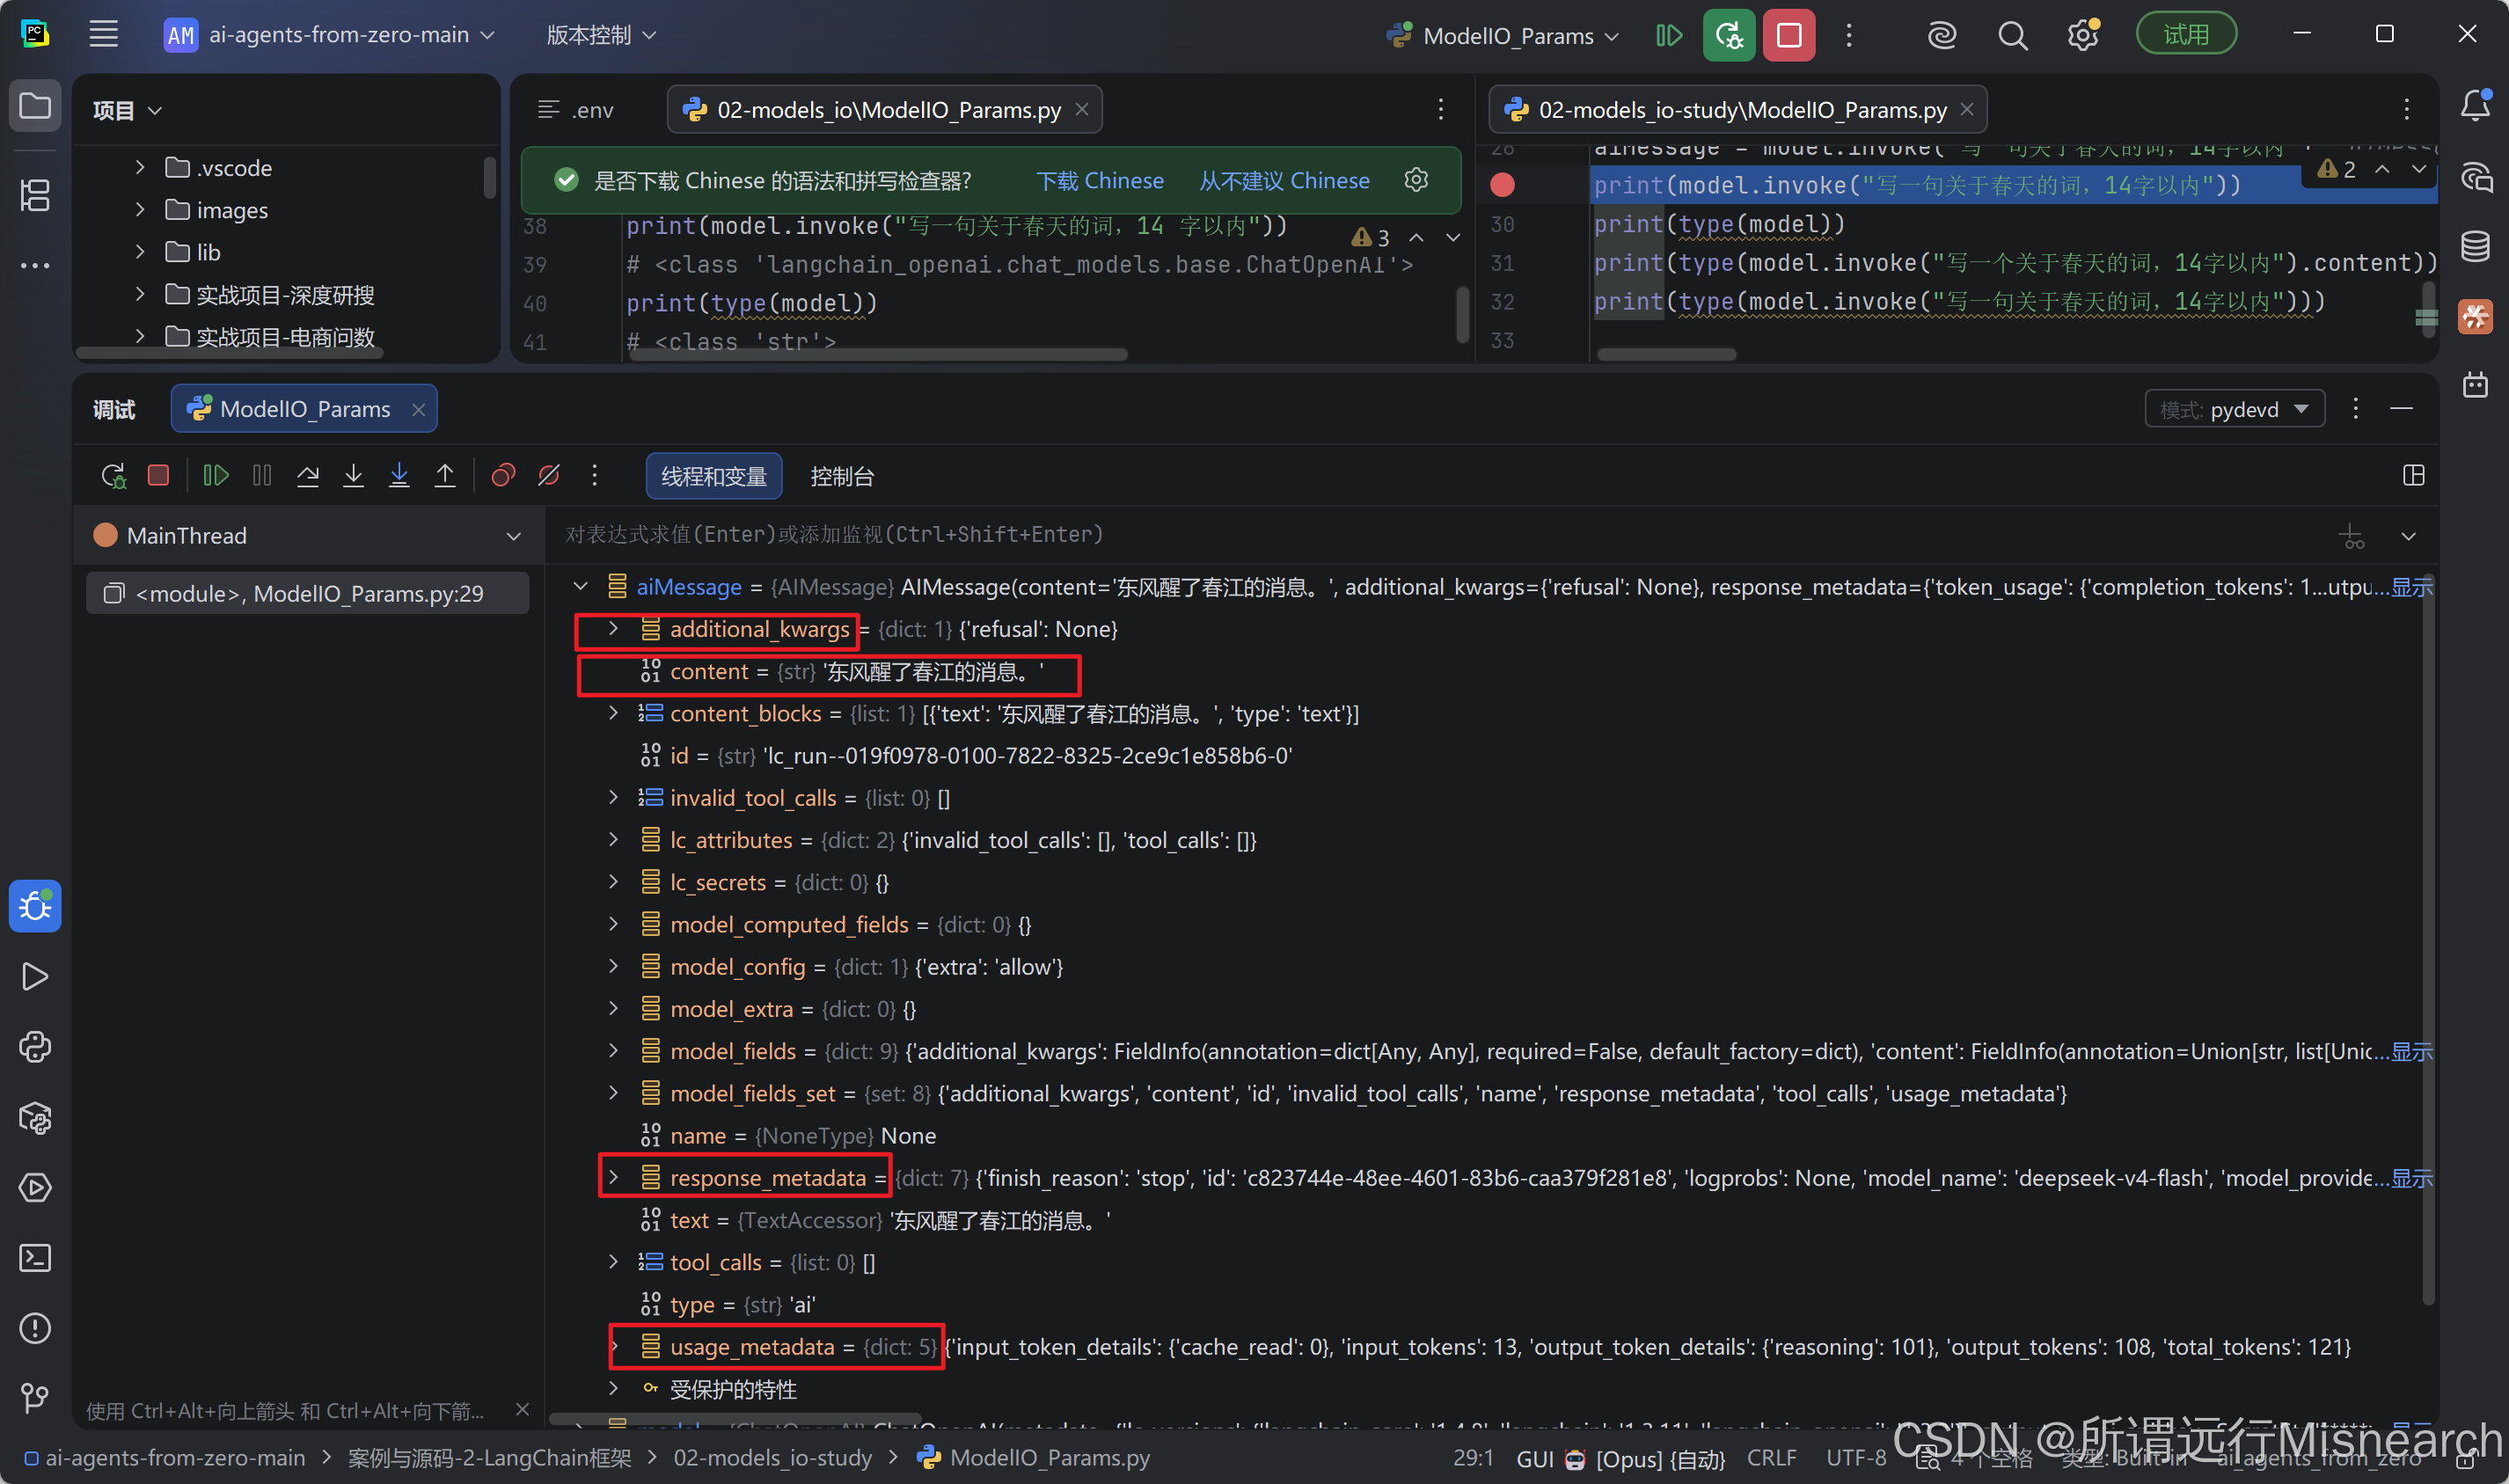
所以看content, response_metadata, usage_metadata
2.11 Messages的作用
ChatModel的输入输出,本质上都是消息Message
例如SystemMessage, HumanMessage, AIMessage, ToolMessage
Prompt只是输入的一种组织方式,Message才是更底层的统一表达
3 接入大模型
怎么把不同模型接进来
3.1 三种常见接入思路
从SDK, provider,到使用init_chat_model
3.2 接入OpenAI及兼容接口
3.2.2 openai.OpenAI与ChatOpenAI的区别
oepnai.OpenAI是官方的pythonSDK,langchain_openai.ChatOpenAI是LangChain生态
显然使用ChatOpenAI方便后续使用
3.2.6 真实项目建议
3.3 接入DeepSeek
3.3.1 常见接法
- 通过OpenAI兼容接口接入
- 通过langchain-deepseek原生provider接入
原生的更贴近deepseek自身集成,某些特性表达更自然
3.3.3 用init_chat_model接入
两种方法
- 按照OpenAI兼容接口接
- 使用deepseek provider包
3.4 接入通义千问
也是同样的方式,兼容接口或原生路线
3.7 模型对象拿到后还要关注什么
模型初始化之后,一个chat Model通常还会继续承担下面这些能力:
- 普通调用
- 流式输出
- 结构化输出with_structured_output(schema)
- 绑定工具model.bind_tools(tools)
- 放入链路
这里的模型也是核心组件
3.8 调用配置与运行时信息
除了初始化时传入的模型参数,LangChain每次调用还需要传入config,这是给LangChain运行时看的信息。
常见配置项:
- tags,给本次调用打标签,用于区分rag, agent, demo等不同链路
- metadata,记录额外上下文
- callback,挂接回调处理器
- configurable,运行时切换配置
示例:
response = model.invoke(
    "用一句话解释 LangChain 的作用",
    config={
        "tags": ["model-io", "demo"],
        "metadata": {"course": "ai-agents-from-zero"},
    },
)
如果后面接入LangSmith,这些tags和metadata会很有用,因为可以在追踪记录里快速筛选某一类调用
还有一种更进阶的用法是运行时切换模型。例如先创建一个可配置的模型对象,再在调用时指定具体模型。
config更偏运行时管理和观测。
第12章 Ollama本地部署与调用
这一章先跳过
第13章 提示词语消息模板
掌握LangChain中与输入组织最相关的三块内容:消息类型Message,模型调用方式invoke, stream,提示词模板PromptTemplate, ChatPromptTemplate。
理解本章全部案例。从模型需要吃进什么,理解提示词模板。
1 Prompt简介
对应了Model I/O中的输入格式化format和模型调用predict
将之前了解的提示词工程,应用到本章就是代码实现版。
将之前提到的角色、任务、上下文、输入、输出和约束,理解在LangChain中以什么形态存在的。
1.1 定义
提示词,从自然语言到带有角色的,再到代码可复用、可维护、可协作,从而把输入写成模板,把会变化的部分改为占位符,这就是从随手提问走向工程化输入管理。
因此Prompt需要把模型输入组织清楚
随着项目复杂度提高,Prompt会从一个字符串逐步演化为多角色消息 + 模板 + 占位符 + 外部配置文件。
1.2 Prompt作用
将输入组织清楚
下面这些真实开发场景,都离不开本章内容:
- 智能客服:需要系统提示词规定语气、身份和拒答策略。
- 企业知识库问答:需要把“检索出来的上下文 + 用户问题”组合成一条清晰提示。
- 多轮聊天:需要把历史对话插回当前输入,而不是每轮都从头问。
- 结构化输出:需要提前在 Prompt 里写清楚输出格式要求,方便后面交给解析器处理(通过提示词就一定能保证按照结构化方式输出吗)。
- 团队协作与 A/B 测试:需要把 Prompt 模板从代码里抽出来,放到 JSON / YAML 中做版本管理。(例如java项目中使用nacos进行统一配置——AI版天机学堂)
模型能力决定上限,Prompt 设计决定你能不能稳定接近这个上限。
1.3 本章在项目中的位置
分为4类:
- invoke,模型调用方式,invoke, stream,batch及异步版本
- prompt_templates,文本模板,
- chat_prompt_tempalte,对话模板
- load_external,外部文件加载
2 调用大模型的入参类型
调用模型可以有多种输入形态
2.1 入参形态总览
- str
- PromptTemplate.format()后的字符串
- 消息对象列表
- (role, content)元组列表
- 字典列表
回顾python的基础知识,元组有序不可变,字典大括号。
示例:
"""

多种输入类型
invoke可以接受消息对象列表
(role, content)元组
{"role": "...", "content": "..."}字典

这样写都是表达这次输入由哪些角色、哪些内容组成,LangChain会在内部转成统一消息表示
可以使用Message类写法
"""

import asyncio
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage, SystemMessage

load_dotenv()

model = init_chat_model(
    model="deepseek-v4-flash",
    model_provider="openai",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

def demo_message_objects():
    """推荐,显式Message对象,角色与字段最清晰"""
    message = [
        SystemMessage(content="你是一个专业的数学助手,回答要简短。"), # 列表
        HumanMessage(content="你好,你是谁?"),
    ]

    resp = model.invoke(message)

    print(type(resp), resp.content[:80] if resp.content else "")

def demo_tuple_list():
    """元组列表:与 ChatPromptTemplate.from_messages 的写法一致。"""
    messages = [
        ("system", "你是一个专业的数学助手,回答要简短。"),
        ("human", "你好,你是谁?"),
    ]
    resp = model.invoke(messages)
    print(type(resp), resp.content[:80] if resp.content else "")


def demo_dict_list():
    """字典列表:与 OpenAI Chat Completions 等 API 的请求体形状接近。"""
    messages = [
        {"role": "system", "content": "你是一个专业的数学助手,回答要简短。"},
        {"role": "user", "content": "你好,你是谁?"},
    ]
    resp = model.invoke(messages)
    print(type(resp), resp.content[:80] if resp.content else "")

async def demo_ainvoke_tuple():
    """异步调用同样支持元组简写。"""
    resp = await model.ainvoke([(
        "user", "用一句话说明什么是素数。"
    )])

if __name__ == "__main__":
    print("--- Message 对象列表 ---")
    demo_message_objects()
    print("--- 元组列表 ---")
    demo_tuple_list()
    print("--- 字典列表 ---")
    demo_dict_list()
    print("--- ainvoke + 元组 ---")
    asyncio.run(demo_ainvoke_tuple())
回顾python中的异步编程语法async与await
- async def: 这是python定义异步函数协程的语法,告诉python解释器,这个函数内部包含需要等待的I/O操作,在等待期间可以释放控制权去执行其他任务。
- await,用于挂起当前协程的执行,等待model.ainvoke()这个异步操作完成并获取返回结果。LangChain中,ainvoke是同步方法invoke的异步版本,专门用于异步环境
2.3 写法二:模板 + 占位符
示例:
from langchain_core.prompts import PromptTemplate

template = PromptTemplate.from_template(
    "用不超过 50 字介绍:{topic} 是什么?"
)
prompt_str = template.format(topic="LangChain")
resp = model.invoke(prompt_str)
print(resp.content)
2.4 写法三:多角色消息列表
构建消息类型列表,可以简化为列表,例如HumanMessage就是"user",SystemMessage可以为"system",Langchain会转换的。
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage

messages = [
    SystemMessage(content="你是只回答技术问题的助手,回答要简短。"),
    HumanMessage(content="什么是 LangChain?"),
    # 多轮示例:
    # AIMessage(content="LangChain 是用于编排 LLM 应用的框架……"),
    # HumanMessage(content="它和直接调 API 有什么区别?"),
]
resp = model.invoke(messages)
print(resp.content)
在实际项目里,这种写法特别常见,
- 系统提示词放在SystemMessage
- 用户问题放在HumanMessage
- 历史回复可放在AIMessage
- 工具执行结果后续可用ToolMessage
后续做多轮对话,Agent, RAG,这种消息列表思维会反复用到。
还有就是ChatPromptValue,链式编排里更常见。
直接构造对象然后转换,ChatPromptValue ->调用to_message()
2.4 写法四:元组列表与字典列表
2.6 Java生态中的多角色
多角色消息并不是某个框架的语法技巧,而是现代聊天模型交互的一种通用抽象。
3 入参的消息类型
知道每种消息类型代表什么
3.1 四类核心消息
- SystemMessage
- HumanMessage
- AIMessage,模型回复消息,保存上一轮回复,支持多轮上下文
- ToolMessage,工具执行结果,
3.3 ToolMessage什么时候会出现
ToolMessage不会在普通问答里频繁出现,更常见于函数调用,工具调用,Agent编排场景
简单示例:
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage, ToolMessage

messages = [
    SystemMessage(content="你是一位乐于助人的智能小助手"),
    HumanMessage(content="你好,请你介绍一下你自己"),
    AIMessage(content="我是一名人工智能助手,请问您有什么想问的吗?"),
    ToolMessage(
        content='{"population": 21540000, "area": "16410平方公里"}',
        tool_call_id="call_abc123",
    ),
]
print(messages)
4 调用大模型的调用方式
LangChain 聊天模型常见的调用方式有四类:普通调用、流式调用、批量调用,以及它们各自的异步版本。
例如:
- invoke/ainvoke:一次发一条
- stream/astream:一边生成一边返回
- batch/abatch:一次发很多条
4.1 普通调用invoke/ ainvoke
- invoke:同步调用,最常用,适合单轮问答与脚本演示。
- ainvoke:异步调用,适合异步 Web 服务、并发任务和高吞吐场景。
实际项目中选择:
- 命令行脚本,教学示例,简单后台任务,优先invoke
- FastAPI, 异步服务,并发请求,优先ainvoke
- 本地开源模型也适用
这里了解ainvoke,
ainvoke是invoke的异步版本,等待模型返回时不会阻塞事件循环。- 它适合异步 Web 服务、并发任务和需要同时处理多条请求的场景。
- 返回结果类型通常仍是
AIMessage;只是调用方式从“直接返回”变成了“await后返回”。
示例:
resp = await model.ainvoke("解释一下你是谁")

if __name__ == "__main__":
	asyncio.run(main())
4.2 流式调用
即:
- stream,同步流式输出
- astream,异步流式输出
流式的最大价值不是“更快算完”,而是更快把正在生成的内容展示给用户。在聊天机器人、报告生成、代码生成等场景里,用户体验会明显更好。
示例:
messages = [
    SystemMessage(content="你叫小问,是一个乐于助人的AI助手"),
    HumanMessage(content="你是谁")
]
for chunk in model.stream(messages):
    print(chunk.content, end="", flush=True)
print()
异步流式,返回的是异步生成器,因此必须用asynch for遍历,循环的每一块通常仍是AIMessageChunk
示例:
# ---------- 3. 异步流式调用(在 async 函数中)----------
async def async_stream_call():
    # astream(messages) 返回的是「异步生成器」,不是 await 一个整体结果
    response = model.astream(messages)
    print(f"响应类型:{type(response)}")  # <class 'async_generator'>

    # 必须用 async for 遍历异步生成器,不能用普通 for
    async for chunk in response:
        print(chunk.content, end="", flush=True)
    print("\n")
5 提示词模板概览
5.1 提示词简介
5.2 提示词模板
之前也提到一点提示词模板,例如PromptTemplate, ChatPromptTemplate,后面的两者可以了解FewShotPromptTemplate, PipelinePrompt
6 文本提示词模板
6.1 简介
适合把文本做成“固定骨架 + 动态变量”的形式,其结果还是字符串,
6.2 参数
- template,模板字符串,可包含{变量名}占位符
- imput_variables,调用时传入变量名列表
- partial_variables,在模板创建阶段就预先固定一部分变量
6.3 常用方法
- format(…)方法,返回str
- invoke(…)方法
- partial(…)方法
示例:
from langchain_core.prompts import PromptTemplate

template = PromptTemplate.from_template(
    "你是一个专业的{role}工程师,请回答我的问题,我的问题是:{question}"
)

# 1)format:得到 str
prompt_str = template.format(role="python开发", question="二分查找怎么写?")

# 2)invoke:得到 PromptValue
prompt_value = template.invoke({"role": "python开发", "question": "冒泡排序怎么写?"})
prompt_value.to_string()
prompt_value.to_messages()

# 3)partial:固定 role,得到新模板
new_template = template.partial(role="python开发")
prompt_str = new_template.format(question="快速排序怎么写?")
format方法示例:
from langchain_core.prompts import PromptTemplate

# 创建模板
template = PromptTemplate.from_template(
    "你是一个专业的{role}工程师,请回答我的问题给出回答,我的问题是:{question}"
)

# format填入变量,得到【最终一条提示词字符串】
prompt = template.format(role="python开发", question="二分查找算法怎么写")

print(prompt)

print(type(prompt))
invoke方法返回PromptValue,更适合衔接LangChain的链式调用,例如后续的LCEL。
# invoke方法
prompt = template.invoke({"role": "python开发",
     "question" :"冒泡排序怎么写"})
print(prompt)
print(type(prompt))
print()
6.4 创建方式
上述示例可以看到PromptTemplate有两种创建方式
- 构造函数,例如PromptTempalte()
- from_template(),由langchain自动推断变量名
示例:
model.invoke(prompt)
7 对话提示词模板
理解为面向多角色消息的模板系统
7.2 常用参数
ChatPromptTemplate核心不是单个template字符串,而是一组消息模板,可以是
- 元组
- 字典
- Message类
- MessagesPlaceHolder
示例:
传入元组
from langchain_core.prompts import ChatPromptTemplate
from numpy import char

# 用[(role, content)]形式的列表定义对话
chatPromptTemplate = ChatPromptTemplate(
    [
        ("system", "你是一个AI开发工程师,你的名字是{name}。"),
        ("human", "你能帮我做什么?"),
        ("ai", "我能开发很多{thing}"),
        ("human", "{user_input}"),
    ]
)

# 传入占位符变量,得到消息列表
prompt = chatPromptTemplate.format_messages(
    name="小谷A", thing="AI", user_input="7 + 5等于多少"
)

print(prompt)
第14章 输出解析器
分清Parser, Structured Output, TypeDict, Pydantic, JSON Schema的边界,
1 输出解析器简介
1.1 定义
对应了Model I/O的输出解析Parse部分,把模型的文本输出转成程序易用的结构化数据。与之前的形成输入-模型-输出解析完整链路。
后续用LCEL管道符将三者串成一条链。
是在模型输出和程序最终要用的数据之间的一层转换器。核心任务时把模型返回的内容,从面向人阅读的文本,转换为面向程序处理的结构化结果。
OutputParser负责把结果转成字符串,JSON或对象,把这份回答整理成程序好用的样子。
输出解析器:
- 格式转换
- 结构约束
- 结果校验
- 工程衔接
1.2 输出解析器的作用
面向程序输出,则需要将大模型的输出转换为一个字符串,JSON,一个字段固定的对象,一个带校验规则的强类型数据结构,所以不能只靠单纯的split(),正则,字符串截取去拆模型输出,代码往往会变得脆弱。
1.3 常见输出解析器分类
- StrOutputParser
- JsonOutputParser,模型返回pytyon dict / list
- PydanticOutputParser, Pydantic对象,需要强类型和运行时校验的时候有用,
1.4 常见结构化输出方案
就需要了解schema代表的含义,事前规定模型应该按什么结构输出。
结构化输出的本质,就是先定义schema,再让模型按这个schema输出结果。
常见的结构化输出方案:
- TypeDict,通过python标准库定义,返回dict,不支持运行时校验,适用于只需要固定字段结构
- Pydantic,通过BaseModel + Field定义,返回Pydantic对象,支持运行时校验,需要强类型、范围、长度、必填项校验
- JSON Schema,标准JSONSchema字典,通常为dict,
可以通过with_sturctured_output(..)实现让模型按照这个结构输出并自动解析
1.5 输出解析器与结构化输出的关系
结构化输出是一种约束,输出解析是后处理
可以进行组合:
- 只用输出解析器
- 只用结构化输出
- 结构化输出 + 额外校验/处理
2 输出解析器常用方法
2.1 动作一:解析输出
解析器的两种使用方式:
- parser.invoke(…),偏向LangChain、Runnable风格
- parser.parse(text),偏已经拿到一段文本了,现在只想解析这段文本
2.2 动作二:给模型“格式说明”
可以事前帮你约束模型输出
常见方法是:
parser.get_format_instructions()
返回一段格式说明文字,告诉模型:应该输出什么结构,有哪些字段,每个字段是什么类型,是否只能返回JSON,是否不能加额外解释文字。
3 常见解析器用法与案例
3.1 StrOutputParser
直接把模型返回内容取出来,当作字符串使用,不做结构化解析,也不关心字段、键名、数据类型,只拿到最终文本。
在LangChain框架中大模型返回拿到的是AIMessage等对象,如果要拿到字符串,就可以用到解析器,StrOutputParser可以从模型返回中拿到content等字段,转成纯字符串,不做JSON等结构解析
StrOutputParser示例:
# 加载环境变量
load_dotenv(encoding="utf-8")

# 构造对话模板
# ChatPromptTemplate构建对话模板,使用列表构建
chat_prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个{role},请简单回答我提出的问题"),
        ("human", "请回答:{question}"),
    ]
)


# 填充占位符,得到消息列表,供模型使用
prompt = chat_prompt.invoke(
    {'role': "AI助手", "question": "什么是LangChain,简洁回答100字以内"}
)
logger.info(prompt)

# 初始化大模型
model = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 调用模型
result = model.invoke(prompt)

logger.info(f"模型原始输出:\n{result}")

# 创建字符串解析器,从result中拿到content转为str

parser = StrOutputParser()

# 使用parser.invoke
response = parser.invoke(result)
logger.info(f"解析后的结构化结果:\n{response}")
logger.info("\n")
logger.info(
    f"结构类型:{type(response)}"
)
输出如下:
2026-07-04 22:06:36.438 | INFO     | __main__:<module>:35 - messages=[SystemMessage(content='你是一个AI助手,请简单回答我提出的问题', additional_kwargs={}, response_metadata={}), HumanMessage(content='请回答:什么是LangChain,简洁回答100字以内', additional_kwargs={}, response_metadata={})]
2026-07-04 22:06:41.007 | INFO     | __main__:<module>:48 - 模型原始输出:
content='LangChain是一个开源框架,用于构建基于大语言模型(LLM)的应用程序。它提供模块化组件(如链、代理、记忆、工具等),支持提示工程、数据连接、多步推理和外部工具调用,简化LLM应用的开发与集成。' additional_kwargs={'refusal': None} response_metadata={'token_usage': {'completion_tokens': 60, 'prompt_tokens': 37, 'total_tokens': 97, 'completion_tokens_details': None, 'prompt_tokens_details': {'audio_tokens': None, 'cached_tokens': 0}}, 'model_provider': 'openai', 'model_name': 'qwen-plus', 'system_fingerprint': None, 'id': 'chatcmpl-6cb20948-2de3-99ca-a8dc-2b7d54eb684b', 'finish_reason': 'stop', 'logprobs': None} id='lc_run--019f2d73-eb63-71c2-b63c-be77a65f3aa3-0' tool_calls=[] invalid_tool_calls=[] usage_metadata={'input_tokens': 37, 'output_tokens': 60, 'total_tokens': 97, 'input_token_details': {'cache_read': 0}, 'output_token_details': {}}
2026-07-04 22:06:41.007 | INFO     | __main__:<module>:56 - 解析后的结构化结果:
LangChain是一个开源框架,用于构建基于大语言模型(LLM)的应用程序。它提供模块化组件(如链、代理、记忆、工具等),支持提示工程、数据连接、多步推理和外部工具调用,简化LLM应用的开发与集成。
2026-07-04 22:06:41.007 | INFO     | __main__:<module>:57 -

2026-07-04 22:06:41.007 | INFO     | __main__:<module>:58 - 结构类型:<class 'langchain_core.messages.base.TextAccessor'>
和直接从result.content拿到content相比,使用解析器是,在后续链式调用中可以直接通过切换不同parser切换不同解析要求。
3.2 JsonOutputParser
JSON解析器,把模型输出中可解析的JSON内容,转换成程序可直接使用的结构化数据。在Python里就是Dict和List
不是任意一段自然语言都能稳定转成JSON的魔法,Prompt仍需要提前说明输出格式,如果模型输出完全偏离JSON,解析依然可能失败。
3.2.1 用法一:直接在提示词手写JSON要求
另外进阶用法就是使用get_format_instructions()生成格式说明再拼进提示词
将JSOn要求写入提示词中
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import ChatPromptTemplate
from loguru import logger
import os
# 加载环境变量
load_dotenv(encoding="utf-8")


# 构建提示词模板,并在系统消息提示词中提出JSON格式要是
chat_prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个{role},请简短回答我提出的问题,结果返回Json格式,q字段标识问题a字段表示答案。"),
        ("human", "请回答:{question}"),
    ]
)

# 传入内容拼接
prompt = chat_prompt.invoke(
    {"role": "AI助手", "question": "什么是LangChain,简洁回答100字以内"}
)

logger.info(prompt)

model = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 获取结果
result = model.invoke(prompt)
logger.info(f"模型原始输出:\n{result}")

print("*" * 60)

# 创建JSON解析器(不绑Pydantic, 解析结果为dict/list)
parser = JsonOutputParser()

response = parser.invoke(result)
logger.info(f"解析后的JSON结果: \n{response}")

logger.info("\n")
logger.info(f"结果类型:{type(response)}")
JSON输出结果为:
解析后的JSON结果:
{'q': '什么是LangChain,简洁回答100字以内', 'a': 'LangChain是一个开源框架,用于构建基于大语言模型的应用程序,支持链式调用、记忆管理、工具集成和数据连接,简化提示工程与应用开发。'}
3.2.2 用法二:用get_format_instructions()自动生成格式说明
让解析器自己自动生成格式说明,在拼进prompt,示例:
get_format_instructions返回一段格式说明字符串,描述希望模型输出成什么样子,例如Json有哪键,类型是什么
将这段说明拼进prompt中的{format_instructions}占位符,模型更容易输出可被解析的JSON,减少格式错误。
流程:定义结构——》创建解析器——》创建提示词模板——》拼接提示词——》模型调用——》输出解析器
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import ChatPromptTemplate
from pydantic import BaseModel, Field
from loguru import logger
import os

load_dotenv(encoding="utf-8")


# 定义结构
class Person(BaseModel):
    """
    定义一条新闻的结构:时间、人物、事件
    用于约束模型输出的JSON
    """
    time: str = Field(description="时间")
    person: str = Field(description="人物")
    event: str = Field(description="事件")


# 绑定pydantic模型,主要驱动get_format_instructions()的schema
# invoke后得到dict

parser = JsonOutputParser(pydantic_object=Person)

# 就可以从get_format_instructions()中获取到schema
format_instructions = parser.get_format_instructions()

# 在human消息里加入{format_instructions},就相当于给模型提供了提示词“请按如下格式输出JSON”
chat_prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个AI助手,你只能输出结构化JSON数据。"),
        ("human", "请生成一个关于{topic}的新闻,{format_instructions}"),
    ]
)

# 往提示词模板中注入变量进行拼接
prompt = chat_prompt.format_messages(
    topic="小米su7跑车", format_instructions=format_instructions
)
logger.info(prompt)

# 构建大模型
model = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)


# 模型进行调用
result = model.invoke(prompt)
logger.info(f"模型原始输出:\n{result}")

# 用同一解析器解析,得到符合Person结构的数据dict或可转成person实例
response = parser.invoke(result)
logger.info(f"解析后的结构化结果:\n{response}")
logger.info(f"结果类型:{type(response)}")
输出内容如下:可以看到使用pydantic定义schema,在提示词中实际上就是JSON格式要求
2026-07-05 11:52:29.166 | INFO     | __main__:<module>:50 - [SystemMessage(content='你是一个AI助手,你只能输出结构化JSON数据。', additional_kwargs={}, response_metadata={}), HumanMessage(content='请生成一个关于小米su7跑车的新闻,**STRICT OUTPUT FORMA**T:\n- Return only the JSON value that conforms to the schema. Do not include any additional text, explanations, headings, or separators.\n- Do not wrap the JSON in Markdown or code fences (no or json).\n- Do not prepend or append any text (e.g., do not write "Here is the JSON:").\n- The response must be a single top-level JSON value exactly as required by the schema (object/array/etc.), with no trailing commas or comments.\n\nThe output should be formatted as a JSON instance that conforms to the JSON schema below.\n\nAs an example, for the schema {"properties": {"foo": {"title": "Foo", "description": "a list of strings", "type": "array", "items": {"type": "string"}}}, "required": ["foo"]} the object {"foo": ["bar", "baz"]} is a well-formatted instance of the schema. The object {"properties": {"foo": ["bar", "baz"]}} is not well-formatted.\n\nHere is the output schema (shown in a code block for readability only — do not include any backticks or Markdown in your output):\n\n{"description": "定义一条新闻的结构:时间、人物、事件\\n用于约束模型输出的JSON", "properties": {"time": {"description": "时间", "title": "Time", "type": "string"}, "person": {"description": "人物", "title": "Person", "type": "string"}, "event": {"description": "事件", "title": "Event", "type": "string"}}, "required": ["time", "person", "event"]}\n', additional_kwargs={}, response_metadata={})]
2026-07-05 11:52:33.616 | INFO     | __main__:<module>:63 - 模型原始输出:
content='{"time": "2024年4月1日", "person": "雷军", "event": "小米正式发布SU7高性能纯电动轿车,定位中大型轿跑,综合续航达800公里,零百加速2.78秒"}' additional_kwargs={'refusal': None} response_metadata={'token_usage': {'completion_tokens': 57, 'prompt_tokens': 379, 'total_tokens': 436, 'completion_tokens_details': None, 'prompt_tokens_details': {'audio_tokens': None, 'cached_tokens': 0}}, 'model_provider': 'openai', 'model_name': 'qwen-plus', 'system_fingerprint': None, 'id': 'chatcmpl-5ce9e140-10d5-92e1-b9aa-651d0e9dbe9e', 'finish_reason': 'stop', 'logprobs': None} id='lc_run--019f3068-089d-71c3-b6fd-57c9f5a0d695-0' tool_calls=[] invalid_tool_calls=[] usage_metadata={'input_tokens': 379, 'output_tokens': 57, 'total_tokens': 436, 'input_token_details': {'cache_read': 0}, 'output_token_details': {}}
2026-07-05 11:52:33.617 | INFO     | __main__:<module>:67 - 解析后的结构化结果:
{'time': '2024年4月1日', 'person': '雷军', 'event': '小米正式发布SU7高性能纯电动轿车,定位中大型轿跑,综合续航达800公里,零百加速2.78秒'}
2026-07-05 11:52:33.617 | INFO     | __main__:<module>:68 - 结果类型:<class 'dict'>
可以看到解析器拿到的是dict,如果想要获取到pydantic实例,则看下一节
4 结构化输出
4.1 定义
结构化输出structured output,不满足模型输出一段json文本,而是进一步要求:
- 输出必须符合某个明确schema
- LangChain直接帮你解析成字典或对象
- 必要时还能做字段验证
模型输出越靠近业务动作,越需要更强约束,现在很多模型也支持原生结构化输出。在支持的模型上优先使用model.with_sturctured_output(),
4.2 常见方式
有了前面的实践,在langchain里,结构化输出常见有三种schema方式:
- TypeDict
- Pydantic
- JSON Schema
给字段补充说明信息,使用该Annotated
5 TypedDict与Annotated
5.1 TypedDict描述这个字典长什么样
TypeDict来自python标准库typing,作用是描述一个字典应该有哪些键,每个键是什么类型,更像是一张结构说明书。用于引导模型输出固定结构,再解析成python字典。
TypeDict不负责真正的运行时校验,
5.2 Annotated:给字段加解释说明
用于在原有类型上附加一段元数据或说明。示例:Annotated[str, "动物名"]
5.3 案例:TypedDict版结构化输出
langchain支持使用TypedDict或者Pydantic定义结构,再由模型按该结构生成并解析
在模型调用with_sturctured_output则会返回一个带结构化输出能力的可调用对象
示例:
from typing import TypedDict, Annotated

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
import os

"""
使用TypeDict定义结构,并添加元信息
"""

load_dotenv(encoding="utf-8")

llm = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 使用TypeDict定义一个动物的结构,
# Annotated的字符串是给模型看的描述,便于生成合适内容
class Animal(TypedDict):
    animal: Annotated[str, "动物"]
    emoji: Annotated[str, "表情"]

# 定义动物列表
class AnimalList(TypedDict):
    animals: Annotated[list[Animal], "动物与表情列表"]

# 普通对话消息
messages = [{"role": "user", "content": "任意生成三种动物,以及他们的emoji表情"}]

# 给模型绑定结构化输出
llm_with_sturctured_output = llm.with_structured_output(AnimalList)
resp = llm_with_sturctured_output.invoke(messages)

print(
    resp
)
输出,应该是大模型自带的结构化输出,返回动物列表,
{'animals': [{'animal': '狮子', 'emoji': '🦁'}, {'animal': '海豚', 'emoji': '🐬'}, {'animal': '熊猫', 'emoji': '🐼'}]}
5.4 案例: Annotated只是描述,不是校验
Annotated提供的只是元数据,Python不会按描述做校验
示例:
from typing import Annotated, TypedDict

# 例如定义一个年龄描述的元数据
Age = Annotated[int, "年龄,范围0-150"]


class Person(TypedDict):
    name: str
    age: int
    age2: Age # 本质上还是int,元数据不参与运行时校验


# 实例化
p = Person(name="张三", age=18, age2=188)
print(p)
输出:
{'name': '张三', 'age': 18, 'age2': 188}
5.5 使用场景
TypeDict适合要稳定结构,但暂时不要求严格数据合法性校验
6 PydanTic: 从结构说明到校验
6.1 定义
TypedDict解决这个字典应该长什么样,pydantic解决的是长什么样并且合法
Pydantic是python生态里很常用的数据校验库,可以在创建对象时对字段做类型检查、范围检查、长度检查、自定义校验等。
6.2 案例: Annotated + Pydantic触发校验
为了进行校验,将Pydantic的Field放在Annotated中,可以进行解析和校验
示例:
from typing import Annotated

from pydantic import Field, BaseModel, ValidationError

# 定义Age
Age = Annotated[int, Field(ge=0, le=150, description="年龄,范围0-150")]

# 定义Person类型
class Person(BaseModel):
    name: str
    age: int
    age2: Age

try:
    # 实例化
    p = Person(name="张三", age=18, age2=188)
    print(p)
except ValidationError as e:
    print("数据校验失败: ")
    print(e)
上述代码中,真正发生校验的是Pydantic中的Field规则,其中Field里面包含了很多参数,例如ge就是greater than or equal,le就是less than or equal。另外还有gt和lt。
6.3 PydanticOutputParser的完整流程
PydanticOutputParser 和 JsonOutputParser 的区别?
- JsonOutputParser:把模型文本解析成「任意」JSON(dict/list),或可绑一个 Pydantic 模型约束形状。
- PydanticOutputParser:专门配合 Pydantic 模型,解析结果会转成** Pydantic 实例**,并可利用 Pydantic 的校验(如字段类型、validator),不合格会抛错。
示例:
from typing import Any

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import ChatPromptTemplate
from typing_extensions import Self

from dotenv import load_dotenv
from pydantic import BaseModel, Field, field_validator
from loguru import logger
import os


load_dotenv(encoding="utf-8")

class Product(BaseModel):
    """
    产品信息:名称,类别,简介,
    简介长度 >= 10,通过validator校验
    """
    name: str = Field(description="产品名称")
    category: str = Field(description="产品类别")
    description: str = Field(description="产品简介")

    # 定义校验字段
    @field_validator("description")
    def validate(cls, value: Any) -> Self:
        """Pydantic校验器"""
        if len(value) < 10:
            raise ValueError("产品简介长度必须 >= 10")
        return value

# 创建Pydantic输出解析器,解析结果会转成Product实例并校验
parser = PydanticOutputParser(pydantic_object=Product)

# 生成格式说明字符串,拼进prompt,
format_instructions = parser.get_format_instructions()

# 在system里放入format_instructions, human里放topic
# 构造提示词模板
prompt_template = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个AI助手,你只能输出结构化的json数据\n{format_instructions}"),
        ("human", "请你输出标题为:{topic}的新闻内容"),
    ]
)


# 拼接提示词
prompt = prompt_template.format_messages(
    topic="小鹏最新车型", format_instructions=format_instructions
)
logger.info(prompt)

model = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)


# 模型调用
result = model.invoke(prompt)
logger.info(f"模型原始输出:\n{result.content}")

# 解析,把result转为Product实例,同时会进行校验
response = parser.invoke(result)
logger.info(f"解析后的结构化结果:\n{response}")
logger.info(f"结果类型:{type(response)}")
其中使用field_validator指定校验字段,通过PydanticOutputParser返回的是Product对象
6.4 使用场景
当你遇到下面的场景:
- 结果写到数据库,不容忍字段类型乱掉
- 要把模型输出接到其他业务系统
- 某些字段必须要求满足一些限制
- 数据不合法就抛出异常
7 JsonSchema和外部协议对齐时很有用
7.1 定义
用于专门用来描述JSON结构和约束规则的标准,特点是语言无关前后端都能理解,别LangChain列表为结构化输出的三种主流方式之一。
7.2 场景
- 后端和前端已经约定了一份 JSON 协议;
- 你的 Python 服务要和 Java、Go、Node 等系统对接;
- 想把数据结构标准化、文档化;
- 不想强依赖 Pydantic 或 Python 类型系统;
那么 JSON Schema 就会比 TypedDict 更通用。
7.3 和TypedDict和Pydantic的区别
- TypedDict:最像 Python 内部的“结构说明书”。
- Pydantic:最像 Python 内部的“结构 + 校验模型”。
- JSON Schema:最像系统之间共享的“协议文档”。
8.4 自定义解析器
继承BaseOutputParser, 实现最关键的parse方法
第15章:LCEL与链式调用
了解管道符背后的链式组合思想
了解顺序链、分支链、多步串行链、并行链、函数链
1 Runnable与统一调用方式
1.1 前置知识点:抽象基类
就是规定这一类对象应该具备哪些共同能力,不着急规定每个对象内部怎么做
这样无论这个对象到底是什么,是Prompt, Model, Parser还是整条Chain,使用者都可以按同一种方式理解和调用。
在LangChain里,把runnable理解为这样一种核心抽象接口,背后的思想就是: Prompt, Model, Parser, Chain是一种可执行组件,属于可执行组件这一大类,应该尽量遵循同一套调用协议,
LangChain 参考文档。Runnable 声明为 class Runnable(ABC, Generic[Input, Output]),描述的是“可被调用、批量处理、流式输出、变换与组合”的工作单元;invoke/ainvoke、batch/abatch、stream/astream 等成对出现,astream_log 还可流式透出部分中间结果。各方法均可传入 config(如标签、元数据)便于追踪与排障;输入/输出/config 的结构信息可通过 input_schema、output_schema、config_schema 等暴露给工具链与 IDE。
1.2 统一接口的意义
把这些能接受输入并产生输出的对象尽量抽象成统一接口,这个统一接口就是Runnable
为什么需要Runnable,这是因为在早期的LangChain中,调用不同组件的命令非常混乱,例如调用LLM用llm(),调用Chain用chain.run(),导致组件之间很难优雅拼接,Runnable协议解决了这个痛点:
- 统一接口与无缝组合,因此可以形成链
- 能力自动继承,只需要拼接成链后,整个链就自动拥有了流式输出、批量并发、异步执行等所有标准能力
- 显式数据校验:每个Runnable组件都内置了输入和输出的类型规范,在组件组合时,系统会自动校验类型匹配性,提前暴露错误。
1.3 定义
Runnable是LangChain最核心的抽象之一,要能够正常区分:
- Runnable 是什么:它表示“这一类对象是可执行组件”,是一种统一抽象标准。
- 统一调用方式是什么:它是 Runnable 带来的结果,也就是这些组件都可以尽量用同一套方式去调用,比如 invoke、batch、stream
Runnable是统一调用方式背后的抽象基础。
只要某个对象实现了Runnable接口,通常就能用统一方式来调用。
1.4 统一调用方式
要实现链式组合,如何才能成立,才能用的更好。
例如提示词模板、模型、解析器三者都可以调用invoke,统一成了同一种风格。
组件之间更容易替换,流程更容易串联,链本身也可以继续被当作一个组件使用;中间结果传递方式更统一,不需要每一步都手写很多适配代码。
1.5 常用方法
回顾之前,我在前面的LangChain的init_model中回顾了invoke方法,其中就是重写的invoke方法,
@override
    def invoke(
        self,
        input: LanguageModelInput,
        config: RunnableConfig | None = None,
        *,
        stop: list[str] | None = None,
        **kwargs: Any,
    ) -> AIMessage:
        config = ensure_config(config)
        return cast(
            "AIMessage",
            cast(
                "ChatGeneration",
                self.generate_prompt(
                    [self._convert_input(input)],
                    stop=stop,
                    callbacks=config.get("callbacks"),
                    tags=config.get("tags"),
                    metadata=config.get("metadata"),
                    run_name=config.get("run_name"),
                    run_id=config.pop("run_id", None),
                    **kwargs,
                ).generations[0][0],
            ).message,
        )
上述的RunnableConfig是控制Runnable组件运行时行为的关键配置字典,是整个LangChain运行时配置的中枢系统,用于在调用时传递各种控制参数。例如这里的model的 invoke,@override 装饰器正是表示该方法**重写了 Runnable 接口中定义的标准 invoke 方法。**通过实现这个标准方法,这个特定的类就正式成为了一个合格的 Runnable 组件,从而可以无缝接入到 LangChain 的 LCEL 组合链路中。
在LangChain中,任何可以被调用、执行、组合的东西,本质上都是一个接受输入经过处理、产生输出的独立任务单元。只要一个对象实现了Runnable协议,就获得了LangChain赋予的一系列开箱即用的强大能力。
Runnable 协议强制规定了所有组件必须统一实现以下核心调用方法,极大简化了代码和学习成本。
- invoke(input)方法,同步调用。传入单个输入,等待并获取单个输出,这是最基础的单次请求方式。
- ainvoke(input)方法,异步调用,用于在异步框架中提高并发性能
- batch(inputs),批量处理。传入一个输入列表,内部自动利用线程池并发处理,返回一组输出,比顺序循环调用效率高得多
- stream(input),流式传输,打字机效果
- abatch/astream,批量处理和流式传输的异步版本
参考文章:
LangChain Runnable类型系统,模式检查与配置管理,从接口规范到运行时控制
文章中提到:
Runnable接口定义了组件交互的标准行为,还通过完善的类型系统和配置机制确保了复杂AI流程的可靠性。
与传统面向对象接口不同,Runnable的类型可以是任意Python对象,由组件自身定义
1.6 在实际项目中的价值
在链式调用中各个组件就像是在拼积木,很多更复杂的高级能力都是在Runnable这层统一抽象之上继续往上搭。
2 LCEL简介
2.1 定义
LCEL, LangChain Expression Language,LangChain表达式语言,作用很直接,用一种声明式、可组合的方式,把多个Runnable连接起来。
示例:
chain = prompt | model | parser
result = chain.invoke({"question": "什么是LangChain?"})
用 | 管道符或其他组合方式,把多个Runnable连接起来的一套表达方法。能够做到:
- 把前一步输出自动传到后一步
- 尽量减少不同节点之间手写适配的样板代码
2.2 LCEL不只是语法糖
LCEL的价值远不止省代码,好处是:
- 表达更清晰
- 更容易组合
- 统一支持同步、异步、批量、流式
2.3 LCEL的核心组合思想
理解几种核心组合思想:
- 顺序组合
- 条件路由
- 并行组合
RunnableSequence和RunnableParallel是两种最核心的组合原语,很多其他Runnable结构,本质上都可以看做是在这两种基础组合能力上的扩展或变体。
LCEL则是LangChain开始让你用数据流编排的方式思考LLM应用。
2.4 LCEL和Chain的关系
- LCEL是构建流程的一种表达方式,expression language
- Chain是通过LCEL或其他组合方式构建出来的可执行流程,重点在于最后得到了什么
3 Chain结构
3.1 定义
Chain链:多个Runnable按照某种规则组合起来后,形成的一段可执行流程。
关键是链本身也是Runnable。这就意味着链不会成为终点对象,依然可以继续被组合。例如一条顺序链可以作为RunnableBranch的分支,一条顺序链可以放进RunnableParallel,并行结果还可以继续交给后面的节点处理。
3.2 典型结构
最典型的一条链就是:
- Prompt
- Model
- Parser
也就是chain = prompt | model | parser,是LangChain里最经典,最基础的组合方式
4 链式调用基础用于与案例
4.1 几种链的选择与对比
- 顺序链,典型写法RunnableSequence
- 分支链,典型写法RunnableBranch(…)
- 多步串行链,多条子链继续串联
- 并行链,RunnableParallel({…})
- 函数链,RunnableLambda(func)
4.2 RunnableSequence顺序链
核心规则:前一个Runnable的输出可以作为后一个Runnable的输入
所以chain = prompt | model | parser本质上就是一个RunnableSequence
也可以显式写成:
from langchain_core.runnables import RunnableSequence
chain = RunnableSequence(first=prompt, second=model, third=parser)
但是最常见的是管道符写法,因为可读性更好。
顺序链示例:
from langchain_classic.chat_models import init_chat_model
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from loguru import logger
import os


# 构建提示词模板
prompt_template = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个{role}, 请简短回答我提出的问题。"),
        ("human", "请回答:{question}"),
    ]
)

# 拼接提示词
# prompt = prompt_template.format_messages(role="AI助手", question="什么是LangChain,简洁回答100字以内")
# 要用管道,就用Runnable接口定义的规则
prompt = prompt_template.invoke({"role": "AI助手", "question": "什么是LangChain,简洁回答100字以内"})
logger.info(prompt)

# 初始化聊天模型
model = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 调用模型
result = model.invoke(prompt)
logger.info(f"****>模型原始输出:\n{result}")

# 这里使用字符串输出解析器
parser = StrOutputParser()
response = parser.invoke(result)
logger.info(f"解析后的结构化结果是:\n{response}")
logger.info(f"结果类型:{type(response)}")

print()
print("*" * 60)
print()

# 使用管道符|构建顺序链,chain才是最终得到的RunnableSequence对象
chain = prompt_template | model | parser
# 调用链
result_chain = chain.invoke(
    {"role": "AI助手", "question": "什么是LangChain,简洁回答100字以内"}
)
logger.info(f"Chain执行结果:\n{result_chain}")
logger.info(f"Chain执行结果类型: {type(result_chain)}")

print()
print(type(chain))
得到输出:
2026-07-05 21:07:21.227 | INFO     | __main__:<module>:29 - messages=[SystemMessage(content='你是一个AI助手, 请简短回答我提出的问题。', additional_kwargs={}, response_metadata={}), HumanMessage(content='请回答:什么是LangChain,简洁回答100字以内', additional_kwargs={}, response_metadata={})]
F:\mycodesF\pycharmprojects\ai-agents-from-zero\案例与源码-2-LangChain框架\06-lcel\study\LCEL_RunnablSequenceDemo.py:32: LangChainDeprecationWarning: The function `init_chat_model` was deprecated in LangChain 1.0.5 and will be removed in 2.0.0. Use `langchain.chat_models.init_chat_model` instead. Maintained in `langchain`; `langchain-classic` retains this entry point for import-compatibility only.
  model = init_chat_model(

************************************************************

2026-07-05 21:07:25.430 | INFO     | __main__:<module>:41 - ****>模型原始输出:
content='LangChain是一个开源框架,用于构建基于大语言模型(LLM)的应用程序。它提供模块化组件(如链、代理、记忆、工具),支持提示工程、数据检索增强(RAG)、多步推理和外部工具调用,简化LLM应用开发与集成。' additional_kwargs={'refusal': None} response_metadata={'token_usage': {'completion_tokens': 62, 'prompt_tokens': 41, 'total_tokens': 103, 'completion_tokens_details': None, 'prompt_tokens_details': {'audio_tokens': None, 'cached_tokens': 0}}, 'model_provider': 'openai', 'model_name': 'qwen-plus', 'system_fingerprint': None, 'id': 'chatcmpl-af16b125-d6c0-9162-9b08-874a37bd5532', 'finish_reason': 'stop', 'logprobs': None} id='lc_run--019f3264-065d-7f12-9479-14caf9c36959-0' tool_calls=[] invalid_tool_calls=[] usage_metadata={'input_tokens': 41, 'output_tokens': 62, 'total_tokens': 103, 'input_token_details': {'cache_read': 0}, 'output_token_details': {}}
2026-07-05 21:07:25.430 | INFO     | __main__:<module>:46 - 解析后的结构化结果是:
LangChain是一个开源框架,用于构建基于大语言模型(LLM)的应用程序。它提供模块化组件(如链、代理、记忆、工具),支持提示工程、数据检索增强(RAG)、多步推理和外部工具调用,简化LLM应用开发与集成。
2026-07-05 21:07:25.430 | INFO     | __main__:<module>:47 - 结果类型:<class 'langchain_core.messages.base.TextAccessor'>

<class 'langchain_core.runnables.base.RunnableSequence'>
2026-07-05 21:07:27.320 | INFO     | __main__:<module>:59 - Chain执行结果:
LangChain 是一个开源框架,用于构建基于大语言模型(LLM)的应用程序。它提供模块化组件(如链、代理、记忆、工具),支持提示管理、数据检索增强(RAG)、多步推理与外部系统集成,简化 LLM 应用的开发与编排。
2026-07-05 21:07:27.321 | INFO     | __main__:<module>:60 - Chain执行结果类型: <class 'langchain_core.messages.base.TextAccessor'>
顺序链从接受输入到最后通过字符串解析器得到字符串内容。
4.3 RunnableBranch分支链
RunnableBranch解决的就是根据输入内容,决定走哪条链。
典型结构:
RunnableBranch(
	(条件1, 链1),
	(条件2, 链2),
	默认链)
例如语言路由的实例:按照顺序判断条件,命中的第一条分支会被执行,最后一个未成对的Runnable就是默认的,分支链可以理解为 外层路由 + 内层子链。
示例:
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
import os

from langchain_core.runnables import RunnableBranch
from loguru import logger


load_dotenv(encoding="utf-8")

# 编写分支提示词模板
english_prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个英语翻译专家,你叫小英"),
        ("human", "{query}")]
)

japanese_prompt = ChatPromptTemplate.from_messages(
    [("system", "你是一个日语翻译专家,你叫小日"), ("human", "{query}")]
)

korean_prompt = ChatPromptTemplate.from_messages(
    [("system", "你是一个韩语翻译专家,你叫小韩"), ("human", "{query}")]
)


model = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

def determine_language(inputs):
    """根据query中的关键词判断语言类型,供分支条件使用"""
    query = inputs["query"]
    if "日语" in query:
        return "japanese"
    elif "韩语" in query:
        return "korean"
    else:
        return "english"

# 解析器
parser = StrOutputParser()

# 构建RunnableBranch
chain = RunnableBranch(
    (lambda x : determine_language(x) == "japanese", japanese_prompt | model | parser),
    (lambda x : determine_language(x) == "korean", korean_prompt | model | parser),
(english_prompt | model | parser), # 默认分支
)

# 测试查询
test_queries = [
    {"query": '请你用韩语翻译这句话"见到你很高兴"'},
    {"query": '请你用日语翻译这句话"见到你很高兴"'},
    {"query": '请你用英语翻译这句话"见到你很高兴"'},
]

# 测试分支
for query_input in test_queries:
    # 语言类型
    lang = determine_language(query_input)
    logger.info(f"检测到语言类型:{lang}")

    # 执行分支
    result = chain.invoke(query_input)
    logger.info(f"输出结果:{result}\n")
4.4 多步串行链
把多条子链首尾串起来,形成多步串行步骤。典型的多步加工。
在多条子链首尾相接,前一步输出会直接流向后一步,如果前后输入输出结构不匹配,就需要插入一次映射,(有点像Java对象之间的封装)理解为进行数据匹配转换。
示例中的两条链,通过lambda进行数据转换,可以理解为数据格式转换器,将chain1给的字符串赋值给content,然后打包成chain2需要的字典格式{“input”: content}
"""
实现多步串行链

"""
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
import os
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from loguru import logger


# 加载系统环境
load_dotenv(encoding="utf-8")

# 定义模型
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 子链1 用中文介绍某主题,输出为str
# 构造提示词
prompt1 = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个知识渊博的计算机专家,请用中文简短回答"),
        ("human", "请简短介绍什么是{topic}"),
    ]
)

# 构造字符串解析器
parser1 = StrOutputParser()

# 构造串行链
chain1 = prompt1 | model | parser1

result1 = chain1.invoke({"topic": "langchain"})
logger.info(result1)


# 子链2 将用户输入翻译为英文,期望入参为{"input": 文本}
# 构造提示词
prompt2 = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个翻译助手,将用户输入内容翻译为英文"),
        ("human", "{input}"),
    ]
)

# 构造字符串解析器
parser2 = StrOutputParser()

# 构造串行链
chain2 = prompt2 | model | parser2

# 串行组合,利用第一条链的中文文本输出作为第二条链的输入
full_chain = chain1 | (lambda content: {"input": content}) | chain2

result = full_chain.invoke({"topic": "langchain"})
logger.info(result)
说明了前后两步的输入输出结构,不一定天然匹配,这也是为什么函数节点和RunnableLambda在LCEL中很实用。
4.5 RunnableParallel并行链
解决的是并行问题,例如同一个输入,要同时交给多条链处理
核心特点就是多条子链共享同一输入,同时执行,最后再把结果按键汇总成一个Dict。
显式调用写法:
parallel_chain = RunnableParallel ({
	"chinese": chain1,
	"english": chain2,
})
LCEL中,直接使用字典表达并行结构,例如:会先并行运行后把结果汇总为一个字典
parallel_then_summary = {
	"paragraph_1": chain1,
	"paragraph_2": chain2,
} | summary_chain
一个完整的示例:
"""
并行链,同时运行多条子链
并行后结果以字典形式汇总返回,键对应并行结构里的键,值对应输出
"""
import os
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableParallel
from loguru import logger

load_dotenv(encoding="utf-8")

# 构造模型
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 子链1,中文简短介绍
prompt1 = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个知识渊博的计算机专家,请用中文简短回答"),
        ("human", "请简短介绍{topic}是什么"),
    ]
)

parser1 = StrOutputParser()
chain1 = prompt1 | model | parser1

# 子链2,英文简短介绍
prompt2 = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个知识渊博的计算机专家,请用英文简短回答"),
        ("human", "请简短介绍{topic}是什么"),
    ]
)

parser2 = StrOutputParser()
chain2 = prompt2 | model | parser2

# 构造并行链
parallel_chain = RunnableParallel({"chinese": chain1, "english": chain2})

# 一次invoke就并行完成后同时返回
result = parallel_chain.invoke({"topic": "langchain"})
logger.info(result)
logger.info("*" * 30)
logger.info(type(result)) # 返回是dict类型
4.6 RunnableLambda 函数链
RunnableLambda价值在于把普通python函数也变成Runnable。
在实际开发里非常实用,因为链式流程经常会遇到以下情况:
- 上一步输出结构不符合下一步输出要求
- 想打印中间结果做调试
- 想做一次字段重命名
- 想插入一点简单业务逻辑
有了函数节点,这些逻辑可以直接放回链内部,不用拆开链。
示例:
from langchain_core.runnable import RunnableLambda

def debug_print(x):
	print(x)
	return {"input": x}

chain = chain1 | RunnableLambda(debug_print) | chain2
或者直接把函数放在|中间即可,框架会自动包装成Runnable。例如chain1 | debug_print | chain2
示例:
"""
函数链
作用,使用RunnableLambda将普通python函数接入LCEL链
原理:将普通函数变成Runnable节点
适合轻量逻辑:例如打印中间结果、字段映射、输入输出结果适配,
"""
import os

from langchain_core.runnables import RunnableLambda
from loguru import logger
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

load_dotenv(encoding="utf-8")

# 构建模型
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 定义一个函数
def debug_print(x):
    """
    打印中间结果,并把文本包装成chain2所需的{"input": 文本}结构

    """
    logger.info(f"中间结果{x}")
    # 包装为字典
    return {"input": x}

# 子链1 中文介绍某主题,输出str
prompt1 = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个知识渊博的计算机专家,请用中文简短回答"),
        ("human", "请简短介绍什么是{topic}")
    ]
)

parser1 = StrOutputParser()

chain1 = prompt1 | model | parser1

# 子链2 将input翻译成英文
prompt2 = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个翻译助手,将用户输入内容翻译为英文"),
        ("human", "{input}")
    ]
)

parser2 = StrOutputParser()

chain2 = prompt2 | model | parser2

# 函数链,两种方式,RunnableLambda或者自动包装
full_chain = chain1 | RunnableLambda(debug_print) | chain2
# 或者
# full_chain = chain1 | debug_print | chain2

result = full_chain.invoke({"topic": "langchain"})
logger.info(f"最终结果:{result}")
注意RunnableLambda是轻量的,如果里面塞了大量业务逻辑,外部副作用和复杂异常处理,就应该拆成明确函数、工具或服务,而不是藏在链里。
4.7 补充:其他常见Runable结构
还有RunnablePassThrough, RunnableWithFallbacks, RunnableBinding。
4.8 重试与兜底
真实项目里,链路不是每次都顺利跑完,LCEL的好处之一在于可以把这类稳定性处理挂在Runnable上,而不是散落在业务代码各处。
最常见的两个动作是:
- with_retry(…),当前Runnable失败后自动重试
- with_fallbacks([…]),主Runnable失败后切到备用Runnable
了解LCEL也负责把重试、兜底、配置这些工程能力放到链上
链路问题很多不是模型错,而是前后节点的数据结构没对上。
学习后续内容理解如何进一步扩展成带状态、带工具、带决策能力的LLM应用。
第16章 记忆与对话历史,含Redis基础
掌握读历史——》拼入提示——》调模型——》写回历史,这条核心实现主线,
1 记忆简介
1.1 为什么需要记忆
这个很好理解,LLM是一个盒子,请求一次调用一次,如果没有携带上次对话信息,就会忘记断片。
记忆是多轮对话系统最基础的能力之一,至少解决三类问题:
- 上下文连续性
- 会话个性化
- 多步任务承接
1.2 定义
记忆,主要指短期记忆或对话历史Chat History
本质不是模型真的记住了,而是程序把之前的消息保存下来,并在下一轮调用之前,再把这些历史消息一并传给模型。
1.3 不是训练模型
记忆只是:
- 把历史消息保存在外部
- 下次调用前重新读出来
- 和当前问题一起发给模型
1.4 本章的记忆能做什么
- 让多轮问答连续起来
- 保存当前会话上下文
- 为链式流程提供上下文:历史消息通过MessagePlaceHolder注入模板,搭配链组合在一起使用
1.5 本章不重点讨论
- 本章不讨论长期知识记忆,例如用户永久画像,长期偏好管理
- 不是RAG检索记忆
- 不是Agent决策状态机
2 无记忆时的演示
一个简单的示例就是一个链,同时提问两次,第二次提问涉及到第一提问给的信息,可以看到没有记忆就不知道信息。
示例:
"""
演示无记忆时的两轮请求
每次Invoke都是相互独立的,模型看不到上次对话,
网页端LLM能够实现记忆是因为前端或者后端实现了历史记忆
本章后续会用RunnableMessageHistory + 记忆组件实现该能力
"""

from dotenv import load_dotenv
import os
from loguru import logger
from langchain.chat_models import init_chat_model
from langchain_core.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser


load_dotenv(encoding="utf-8")

model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 构建提示词
prompt = PromptTemplate.from_template("请回答我的问题:{question}")
parser = StrOutputParser()

# 构建链路
chain = prompt | model | parser

# 第一轮
print(chain.invoke({"question": "我叫张三,你叫什么?"}))

print(chain.invoke({"question": "你知道我是谁吗?"}))
输出结果为:
你好,张三!我是DeepSeek,一个由深度求索公司创造的AI助手。很高兴认识你!有什么我可以帮你的吗?😊
我不知道你是谁。我是DeepSeek,一个由深度求索公司开发的AI助手。我没有访问你的个人身份信息、历史记录或任何能识别你身份的数据的能力。每次对话对我来说都是全新的开始,我只会根据你当前提供的信息来理解和回应你。

如果你愿意告诉我一些关于你自己的信息,我会很乐意根据你分享的内容来帮助你!😊
因此并不是模型天然记住多轮对话的,是程序决定能不能看见历史的。
3 实现原理
3.1 核心主线
理解记忆实现链路,实际上是一个循环的流程
- 读历史
- 将历史拼进当前提示
- 调用模型
- 把本轮输入和输出写回历史
3.2 工程化表达
- 根据会话标识找到对应历史,例如session_id = “user_001”
- 把历史消息插入Prompt
- 把历史 + 当前问题一起交给模型
- 把本轮消息写回历史存储
3.3 MessagePlaceholder与模板的关系
在模板里留一个“历史消息插槽”,运行时再把当前会话历史整块塞进去,
3.4 session_id的意义
标识会话,最常见的就是session_id,表示当前会话的编号。
在RunnableWithMessageHistory,session_id通常通过运行配置传入,例如config = {“configurable”: {“session_id”: “user-0001”}}
3.5 本章和LangGraph官方主线的关系
短期记忆越来越倾向于放在LangGraph persistence/checkpointer/thread这条体系里讲。
历史消息会占用模型上下文窗口,轮数过多时需要做截断、摘要或只保留最近k轮,否则可能触达token上限等。
4 记忆相关实现类
4.1 本章使用哪套写法
先用RunnableWithMessageHistory + BaseChatMessageHistory理解链级对话历史
复杂Agent的状态持久化,后续放到LangGraph的thread/checkpointer / persistence中
4.3 RunnableWithMessageHistory
作用:给一条已有的Runnable / Chain包上一层历史管理能力,也是在Runnable体系上继续工作。
4.4 BaseChatMessageHistory
历史存储接口,
RunnableWithMessageHistory解决的是历史读写时机,
BaseChatMessageHistory解决的就是历史到底存在哪,怎么存。可以看作聊天消息历史的统一抽象接口。
4.5 常见实现类
提供多种聊天实现。
- InMemoryChatMessageHistory,进程内内存
- FileChatMessageHistory,本地文件
- RedisChatMessageHistory,Redis
- 其他后端实现
5 案例代码
5.1 内存版
内存版适合入门,把记忆的本质暴露的最清楚:
- 历史就是一个消息列表
- 每轮都从这份列表里读取
- 每轮结束再把新消息写回去
5.1.1 最基础写法:RunnableWithMessageHistory
示例代码:
"""
内存版本的历史对话
RunnableWithMessageHistory + InMemoryChatMessageHistory

RunnableWithMessageHistory决定什么时候用,
    在每次invoke时,会先从get_session_history(session_id)取历史,
    拼prompt的MessagePlaceHolder,执行链后再把本轮输入与输出写回历史
InMemoryChatMessageHistory决定存哪里怎么存
    InMemory存在内存中

"""

from dotenv import load_dotenv
load_dotenv(encoding="utf-8")

from langchain.chat_models import init_chat_model
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableWithMessageHistory, RunnableConfig
from langchain_core.chat_history import InMemoryChatMessageHistory
from loguru import logger
import os

# 构建模型
llm = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 构造提示词模板
# 其中history占位符用于注入历史消息
prompt = ChatPromptTemplate.from_messages(
    [
        MessagesPlaceholder(variable_name="history"),
        ("human", "{input}"),
    ]
)

parser = StrOutputParser()
chain = prompt | llm | parser

# 记忆组件,内存实现,进程内有效,重启后丢失
history = InMemoryChatMessageHistory()

# 然后将链包装为带历史版本,指定key匹配输入和输出
runnable = RunnableWithMessageHistory(
    chain,
    get_session_history=lambda session_id: history,
    input_messages_key="input",
    history_messages_key="history",
)

history.clear()

# 保留session_id配置,
config = RunnableConfig(configurable={"session_id": "user-001"})

# 第一轮,
logger.info(runnable.invoke({"input": "我叫张三,我爱学习"},config))
# 第二轮
logger.info(runnable.invoke({"input": "我叫什么,我的爱好是什么"}, config))
第一轮完成后在内存记忆中就会存储第一轮对话的用户消息和AI消息,如图所示:

上面的示例中,MessagePlaceholder(“history”)负责接收历史,RunnableWithMessageHistory负责包住整条链,session_id负责告诉系统当前读哪份历史。
5.1.2 多session写法:按照session_id维护多份历史
示例
"""
【案例】内存版带历史对话(多 session):用 store 按 session_id 维护多份 InMemoryChatMessageHistory

对应教程章节:第 16 章 - 记忆与对话历史 → 6、案例代码 → 6.1 内存版(进程内,重启即丢失)

知识点速览:
- 与 Memory_RunnableWithMessageHistory 的区别:本案例用 get_session_history(session_id) 从 store 中按 session 取不同 history,可支持多用户/多会话(每 session 独立历史)。
- MessagesPlaceholder("history") 与 prompt 中的变量名一致,RunnableWithMessageHistory 会把读到的历史注入此处;input_messages_key、history_messages_key 需与 prompt 占位符对应。
- 本案例会同时演示 user-001 与 user-002 两个 session,帮助你直观看到“同一套链逻辑,如何切换到不同历史”。
- 生产环境可将 store 换成 Redis、数据库等,get_session_history 返回 RedisChatMessageHistory(session_id=session_id, ...) 即可实现持久化(见 6.2)。
"""

from dotenv import load_dotenv

load_dotenv(encoding="utf-8")

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.output_parsers import StrOutputParser
import os

llm = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 按 session_id 保存多份历史,便于多用户/多会话;生产可改为 Redis 等
store = {}


def get_session_history(session_id: str):
    """
    根据 session_id 获取对应的历史消息对象。
    如果不存在则创建一个新的 InMemoryChatMessageHistory。
    """
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()
    return store[session_id]


# 定义 Prompt 模板
#     - system: 给模型设定角色
#     - MessagesPlaceholder: 历史消息将注入这里
#     - human: 当前用户输入
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个友好的中文助理,会根据上下文回答问题。"),
        MessagesPlaceholder("history"),
        ("human", "{question}"),
    ]
)
# 构建基本链:Prompt → LLM → 输出解析
memory_chain = prompt | llm | StrOutputParser()

# 包装为带历史链:get_session_history 决定「当前 session 用哪份 history」
with_history = RunnableWithMessageHistory(
    memory_chain,
    get_session_history,
    input_messages_key="question",
    history_messages_key="history",
)

cfg_user_001 = {"configurable": {"session_id": "user-001"}}
cfg_user_002 = {"configurable": {"session_id": "user-002"}}

print("用户A(user-001):我叫张三。")
print("AI:", with_history.invoke({"question": "我叫张三。"}, cfg_user_001))

print("\n用户B(user-002):我叫李四。")
print("AI:", with_history.invoke({"question": "我叫李四。"}, cfg_user_002))

print("\n用户A(user-001):我叫什么?")
print("AI:", with_history.invoke({"question": "我叫什么?"}, cfg_user_001))

print("\n用户B(user-002):我叫什么?")
print("AI:", with_history.invoke({"question": "我叫什么?"}, cfg_user_002))

# ---------- 查看当前存储了哪些历史数据 ----------
# store 的 key 为 session_id,value 为该会话的 InMemoryChatMessageHistory
# 每个 history 的 .messages 为 List[BaseMessage],即该会话至今的全部消息(HumanMessage、AIMessage 等)
print("\n--- 当前 store 中的历史数据 ---")
for sid, history in store.items():
    print(f"[session_id={sid}] 共 {len(history.messages)} 条消息:")
    for i, msg in enumerate(history.messages):
        # msg 有 .type(如 human/ai)、.content(文本内容)
        content = str(msg.content)
        content_preview = (content[:50] + "…") if len(content) > 50 else content
        print(f"  {i+1}. [{msg.type}] {content_preview}")
print("--- 以上 ---\n")

"""
【输出示例】
用户A(user-001):我叫张三。
AI: 你好,张三!很高兴认识你~😊
有什么我可以帮你的吗?

用户B(user-002):我叫李四。
AI: 你好,李四!很高兴认识你~😊
有什么我可以帮你的吗?

用户A(user-001):我叫什么?
AI: 你叫张三!😄
之前你已经告诉过我啦~需要我帮你做点什么吗?

用户B(user-002):我叫什么?
AI: 你叫李四!😄
之前你已经告诉过我啦~需要我帮你做点什么吗?

--- 当前 store 中的历史数据 ---
[session_id=user-001] 共 4 条消息:
  1. [human] 我叫张三。
  2. [ai] 你好,张三!很高兴认识你~😊
有什么我可以帮你的吗?
  3. [human] 我叫什么?
  4. [ai] 你叫张三!😄
之前你已经告诉过我啦~需要我帮你做点什么吗?
[session_id=user-002] 共 4 条消息:
  1. [human] 我叫李四。
  2. [ai] 你好,李四!很高兴认识你~😊
有什么我可以帮你的吗?
  3. [human] 我叫什么?
  4. [ai] 你叫李四!😄
之前你已经告诉过我啦~需要我帮你做点什么吗?
--- 以上 ---

"""
5.1.3 直接操作InMemoryChatMessageHistory
示例:
"""
直接使用InMemoryChatMessageHistory的API,add_message, messages,手动拼历史后调用模型
不通过RunnableWithMessageHistory,手动维护history
手动维护时要自己决定什么时候写消息

"""
from dotenv import load_dotenv

load_dotenv(encoding="utf-8")

import os
from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from loguru import logger

# 构建模型
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 构建内存版历史实例
history = InMemoryChatMessageHistory()

# 手动添加用户消息并调用模型,模型输入为当前全部messages
history.add_user_message("我叫张三,我的爱好是学习")
ai_message = model.invoke(history.messages) # messages方法获取消息
logger.info(f"第一次回答\n{ai_message.content}")
# 手动将ai回复写回history,否则下一轮只看到用户消息,达不到多轮记忆的效果。
history.add_message(ai_message)

# 再追加一轮
history.add_user_message("我叫什么?我的爱好是什么")
ai_message2 = model.invoke(history.messages)
logger.info(f"第二次回答\n{ai_message2.content}")
history.add_message(ai_message2)
可以看见History中存储的消息,

通过上述手动管理,可以理解,记忆就是在维护一份消息历史列表。
想快速搭多轮链,优先用RunnableWithMessageHistory
想完全掌控读写时机,可以直接操作InMemoryChatMessageHistory
5.2 持久化:Redis存储
这里使用Redis是因为适合持久化保存会话历史的存储后端。
5.2.1 设计要求与参考文档
将历史从内存换为持久化存储,这样程序重启后还能恢复历史。
python环境中已经安装redis
5.2.2 Redis与Redis Stack简介
RedisChatMessageHistory存储对话历史依赖redis基础数据结构能力即可。
Redis是高性能键值存储本体,Redis Stack则是在Redis基础上补上更多增强能力并带来更友好的工具链
5.2.3
然后编写一个docker-compose.yml进行部署安装,
5.2.4 Redis基本命令与查看对话历史
LangChain会按session_id写入不同的键,
5.2.5 环境验证
检查python中的redis和电脑redis环境是否能够连上,
例如就只启动docker-redis这个原生redis,
"""
这里只使用原生redis
localhost:6379
"""
import os

try:
    import redis
except ModuleNotFoundError:
    print("未找到redis包,请先执行pip install -r requirements.txt")
    raise SystemExit(1)

REDIS_URL = os.getenv("REDIS_URL", "redis://localhost:6379")

print("redis包导入成功")
print(f"redis包版本:{redis.__version__}")
print(f"正在连接redis:{REDIS_URL}")

# 检查redis服务是否连接成功
client = None

try:
    client = redis.Redis.from_url(REDIS_URL, decode_responses=True)
    print(f"redis连接成功,PING -> {client.ping()}")
except (redis.ConnectionError, redis.TimeoutError, redis.ResponseError) as e:
    print("redis连接失败")
    print(f"REDIS_URL = {REDIS_URL}")
    raise SystemExit(1)
except Exception as e:
    print(f"redis环境校验异常:{e}")
    raise SystemExit(1)
finally:
    if client is not None:
        client.close()
5.2.6 案例:Redis对话历史
上述验证环境成功,就可以使用RedisChatMessageHistory存储历史了。
"""
get_session_history应该是从RedisChatMessageHistory中获取消息的
"""
from dotenv import load_dotenv

load_dotenv(encoding="utf-8")

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import BaseChatMessageHistory
# 控制什么时候写
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnableConfig
import os
import redis
from loguru import logger

try:
    from langchain_redis import RedisChatMessageHistory
    USE_LANGCHAIN_REDIS = True
except ModuleNotFoundError:
    from langchain_community.chat_message_histories import RedisChatMessageHistory
    USE_LANGCHAIN_REDIS = True

# 支持环境变量Redis_URL,
REDIS_URL = os.getenv("REDIS_URL", "redis://localhost:6379")
FORCE_SAVE = os.getenv("REDIS_FORCE_SAVE", "0") == "1"

def _check_redis():
    """启动时检查redis是否可达"""
    try:
        r = redis.Redis.from_url(REDIS_URL, decode_responses=True)
        r.ping()
        r.close()
    except (redis.ConnectionError, redis.ResponseError) as e:
        logger.error(
            "Redis连接失败({}),请先启动redis,"
        )
        raise SystemExit(e)

_check_redis()

# 构建客户端
redis_client = redis.Redis.from_url(REDIS_URL, decode_responses=True)
logger.info(
    "Redis客户端实现"
)

llm = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 构建提示词
prompt = ChatPromptTemplate.from_messages(
    [
        MessagesPlaceholder("history"),
        ("human", "{question}"),
    ]
)


# 获取历史会话
def get_session_history(session_id: str) -> BaseChatMessageHistory:
    """为每个session_id创建/返回对应的redis历史实例,实现持久还存储"""
    if USE_LANGCHAIN_REDIS:
        return RedisChatMessageHistory(
            session_id=session_id,
            redis_url=REDIS_URL,
        )
    return RedisChatMessageHistory(
        session_id=session_id,
        url=REDIS_URL,
    )


# 构建链
chain = RunnableWithMessageHistory(
    prompt | llm,
    get_session_history,
    input_messages_key="question",
    history_messages_key="history",
)

# 配置
config = RunnableConfig(configurable={"session_id":  "user-001"})

print("开始对话(输入quit退出)")

while True:
    question = input("\n输入问题:")
    if question.lower() in ["quit", "exit", "q"]:
        break
    response = chain.invoke({"question": question}, config)

    logger.info(f"AI回答:{response.content}")

    if FORCE_SAVE:
        redis_client.save()
理解这里while循环持续对话并存入redis中这个实现。
进一步理解RunnableWithMessageHistory负责什么时候读写,RedisChatMessageHistory负责历史存到哪里
通过可视化redis数据库,可以看到里面存储的键值就是
chat:user-001:xxxx,值为json格式,

查看RedisChatMessageHistory中的add_message方法,可以看到存储的内容为:
common_data_to_store: Dict[str, Any] = {
            "type": message.type,
            "message_id": message_id,
            "data": {
                "content": message.content,
                "additional_kwargs": message.additional_kwargs,
                "type": message.type,
            },
            "session_id": self.session_id,
            "timestamp": timestamp,
        }
所以存储的值就包含了上述格式:
{
    "type": "human",
    "message_id": "01KXZBP6E6K5Q24V43GVMXX800",
    "data": {
        "content": "你好你是谁",
        "additional_kwargs": {},
        "type": "human"
    },
    "session_id": "user-001",
    "timestamp": 1784537618.886067
}
第二条消息则是:
{
    "type": "ai",
    "message_id": "01KXZBP6EFGEB8DEZPAB08JX99",
    "data": {
        "content": "你好呀!👋 很高兴认识你!\n\n我是 **DeepSeek**,由深度求索公司创造的AI助手。我是一个纯文本模型,可以帮你解答各种问题、处理文字任务、分析信息等等。\n\n**关于我的一些特点:**\n- 📚 知识截止日期:2025年5月\n- 🆓 **完全免费**使用(没错,不收费!)\n- 📄 支持上传文件(图片、PDF、Word、Excel、PPT等)来读取其中的文字信息\n- 🔍 支持联网搜索(需要你在Web/App端手动开启)\n- 💬 上下文长度1M,可以一次性处理超长文本(比如《三体》三部曲那么多内容)\n- 🎙️ App端支持语音输入\n\n虽然我不能识别图片内容(比如看图识物),但可以读取图片里的文字信息哦!\n\n有什么我可以帮你的吗?无论是学习、工作还是日常问题,尽管问我!😊",
        "additional_kwargs": {
            "refusal": null,
            "reasoning_content": "嗯,用户问了一个很常见的开场问题:“你好你是谁”。这是一个简单的自我介绍请求。\n\n用户可能刚接触我,想了解我的身份、能力和基本特点。深层需求是确认我的可靠性和功能范围,以便后续有效互动。\n\n我需要给出清晰、友好、全面的自我介绍。可以包括名称、创造者、核心能力(比如文本处理、文件支持、上下文长度)、知识截止日期、免费属性等关键信息,并以热情开放的态度结尾,邀请用户提出进一步问题。\n\n想到了用热情问候开头,然后分点或段落说明我的身份和主要功能,最后表达乐于助人的态度。"
        },
        "type": "ai"
    },
    "session_id": "user-001",
    "timestamp": 1784537618.895081
}
然后用户再发送一条,redis中再存一条,AI回复一条,AI再存一条,是这样的逻辑
session_id应该和用户,会话,业务租户等隔离策略一起设计,而不是随便写一个字符串
第17章 Tools工具调用
- 建立模型负责决策,程序负责执行这条最核心的分工认知。
- 使用@Tool装饰器定义langchain工具,配合pydantic写参数schema
模型负责判断要不要调用工具和填参数,程序负责真正执行工具并把结果交回去。
1 Tools简介
1.1 定义
工具,给大模型准备的一项外部能力,
本质上就是一个可调用函数,只不过把它包装成模型能理解的形式,让模型知道:
- 这个工具叫什么
- 这个工具是干什么的
- 这个工具接收哪些参数
也就是模型负责决策,要调用工具则会先输出结构化意图,例如“我想调用某个工具,并附带参数”。然后程序负责执行,执行后将结果返回模型。
因此Tool不是模型自己突然学会调用外部系统,而是把外部能力以受控方式开放给模型使用。
1.2 Tools的作用
真正有业务价值的LLM应用,最后都会走到Tools,
- 智能客服要查订单,查物流,查售后状态
- 企业助手要查知识库,查数据库,查工单系统
- 数据分析助手要跑SQL,读报表,调统计接口
- 生活类助手要查天气,查地图,查航班,查日程
1.3 Tool, ToolCalling, Agent三者关系
- Tool,一个被封装好的外部能力,负责做事
- Tool Calling,模型输出结构化调用意图的机制,负责发起调用请求
- Agent,决策
2 工具调用的工作方式
2.1 核心主线
结合泳道图加以理解

ToolCalling不是脱离消息机制另起炉灶,本质上仍然发生在消息流之中。
2.2 模型看到了什么
这是因为给模型传递了工具信息bind_tools(…),这些信息至少包括了:
- 工具名称
- 工具描述
- 参数schema
因此模型不是靠读函数体理解工具。
2.3 程序主要做了什么
模型输出调用意图,程序才是执行工具。
这一步通常包括:
- 读取模型返回的tool_calls
- 找到对应工具
- 取出参数
- 执行代码逻辑
- 把结果重新回填给模型
2.4 tool_calls, AIMessage, ToolMessage三者工具
AIMessage.tool_calls是模型请求
ToolMessage是程序的回执
如果多个工具调用,在ToolMessage还需要通过tool_call_id对应回前面的某一个tool_call,
2.5 什么时候不需要工具
需要实时数据、需要访问外部系统、需要高确定性执行,需要把模型输出落到真实动作上。
3 自定义Tool,从最简单的工具开始
3.1 使用@tool装饰器
装饰器的作用是在不改动函数核心逻辑的前提下,给函数额外加上一层框架可识别的能力。
因此这里@tool装饰器就是:
- 把一个普通python函数包装成LangchainTool
- 让其具备name, description, args等元信息
- 让其能够被模型或agent识别并调用
最简单的创建工具方式,就是使用@tool装饰器,默认情况下,函数docstring会成为工具描述
3.2 基础案例:加法工具
示例:
"""
基础加法工具,使用@tool装饰器将普通函数转换为LangChain Tool
使用@tool,将函数包装为LangChain Tool,使其具备name, description, args等元信息
函数中的docstring会默认成为工具的description,再结合arg_schema补充说明

"""
from langchain_core.tools import tool

# @tool,不写参数,
    # 工具名默认为函数名
    # description取自docstring
@tool
def add_number(a: int, b: int) -> int:
    """两个整数相加"""
    return a + b

# tool.invoke执行工具
# invoke 执行字典参数
result = add_number.invoke({"a": 1, "b": 2})
print(result)

print()

# 查看元信息
print(f"{add_number.name=} \n {add_number.description=} \n {add_number.args=}")
直接使用工具名.invoke表示执行工具,
程序输出结果如下:
3

add_number.name='add_number'
 add_number.description='两个整数相加'
 add_number.args={'a': {'title': 'A', 'type': 'integer'}, 'b': {'title': 'B', 'type': 'integer'}}
tool会自动暴露名称,描述,参数结构。
3.3 Tool常用属性
常见属性:
- name,工具名,模型要调用准,首先看这个名字
- description,工具说明,模型判断什么时候该用这个工具的依据
- args,参数结构,模型知道因该传什么参数,参数是什么类型
- return_direct,是否直接把结果返回给用户

3.4 工具描述的作用
好的工具描述docstring,应该让模型看懂三件事:
- 这个工具是干什么的
- 什么时候应该调用
- 关键参数应该怎么填
Tool描述不是给别人随便看看,本身就是模型决策的重要输入
3.5 真实项目里的工具层
真实项目里,往往是下面这些能力的轻量封装:
- 调第三方API
- 调内部服务
- 查数据库
- 跑检索
- 执行某个稳定的业务动作
所以架构上常见组织方式为:
- Tool层,暴露给模型的工具定义
- Service层,真正的业务实现或API调用封装
- Model层
实现了模型能力和业务解耦
4 参数Schema,为什么要配合Pydantic
4.1 为什么只写函数参数还不够
真实项目里,参数类型和格式不够清晰;参数校验不够严格
除了告诉模型有几个参数,还希望表达:
- 这个参数具体是什么意思
- 有没有取值范围
- 是否允许为空
- 参数传错时怎样更清晰地报错
因此就需要args_schema和pydantic
4.2 Pydantic
是python里非常常用的数据校验库,本质是把“参数结构、参数类型、字段说明、校验规则”统一收敛到一个模型类里。
这里使用pydantic,一是给程序看用作运行时校验,而是给模型看,把参数schem描述清楚
适合用在Tool参数定义里
4.3 入门案例
示例:
"""
理解Pandantic = 类型声明 + 自动校验  + 参数说明
下理解Pandantic
基于类型注解在实例化时做校验与转换,合法则自动转,不合法则抛ValidationError

"""

from pydantic import BaseModel, ValidationError, StrictInt

# 例如定义一个用户模型
class User(BaseModel):
    # id: int # 普通int时,传入"41"也会被自动转成41
    id: StrictInt  # 严格整数,不接受字符串等,必须已是int,否则报错
    name: str
    age: int = 0  # 可选字段,默认0,传入值会被校验并转换

try:
    # 合法示例
    u = User(id=42, name="z3")
except ValidationError as e:
    print(e)

print(u.id, type(u.id))

print()
print()

# 非法示例
try:
    User(id="123", name="z4")
except ValidationError as e:
    print(e)
输出如下:
42 <class 'int'>


1 validation error for User
id
  Input should be a valid integer [type=int_type, input_value='123', input_type=str]
    For further information visit https://errors.pydantic.dev/2.13/v/int_type
由上述示例可以看出,Pydantic会在实例化时做校验,非法输入就会报错,严格类型可以避免模糊转换,放到Tool参数上很有用,避免工具传入参数看起来对,实际上不对
4.4 加法工具的Pydantic
"""
工具结合Pydantic,用args_schema绑定参数模型,让模型看到规范参数说明

arg_schema的价值:除了参数校验,还有能把工具参数的语义说明显式暴露给模型,提升参数生成正确率
tool.args,主要反应参数schema,工具的整体用户说明仍应优先写在函数docstring中
return_direct等参数更偏Agent场景
"""

from langchain_core.tools import tool
from loguru import logger
from pydantic import BaseModel, Field

# 定义Pydantic模型 字段description会进入工具参数schema
class FieldInfo(BaseModel):
    """定义加法运算所需的参数结构"""
    a: int = Field(description="第1个参数")
    b: int = Field(description="第2个参数")


# 利用args_schema将模型绑定到工具,模型会更清楚看到a,b的类型与说明
@tool(args_schema=FieldInfo)
def add_number(a: int, b: int) -> int:
    """计算两个整数之和"""
    return a + b

# 打印工具属性,带有args_schema,时,args中会包含Field的description
logger.info(f"name = {add_number.name}")
logger.info(f"args = {add_number.args}")
logger.info(f"description = {add_number.description}")
logger.info(f"return_direct = {add_number.return_direct}")

# 调用工具,传入字典,pydantic会做类型校验与转换
res = add_number.invoke({"a": 1, "b": 2})
logger.info(res)
可以看见数据模型中的description字段也放在工具参数说明中,

上述示例用到的:
- 用BaseModel定义参数结构
- 用Field(description= )给参数写说明
- 用@tool(args_schema= )把参数模型绑定给工具
4.5 args_schema的实践价值
真实项目中养成写args_schema的习惯。因为能够:更稳定、更安全、更可维护。
与后端写DTO,写请求参数对象,是同一种工程思想,这样是为了让模型更容易调用对,代码更容易排错,团队更容易协作。
5 天气助手实战:把Tool跑成业务闭环
5.1 需求与准备
真正接近业务项目的是:模型 + 工具 + 外部API的组合。
现实里的Tool往往都不是本地纯函数,更像:
调第三方接口
接收JSON
做必要加工
回到消息流或链路中继续生成最终答案
这里申请一个openweather api key,并将key写入.env文件中,
OPENWEATHER_API_KEY= xxx。
5.2 定义天气查询工具
"""
使用@tool定义天气接口工具,请求openweather api并返回json

理解运用把第三方http api封装为一个可被模型理解和调用的tool
工具docstring要写清调用场景和关键参数规则
返回值使用json,是为了方便后续链路进行处理,
真实项目里也可以返回结构化对象
该示例聚焦tool封装,未展开重试,降级,异常兜底等工程细节,这些通常会在真实项目里的service/ client层补齐
"""

from langchain_core.tools import tool
import json
import os
import httpx
from dotenv import load_dotenv
import requests

load_dotenv(encoding="utf-8")

# 函数名作为工具名,docstring会成为模型理解工具的重要依据
@tool
def get_weather(loc: str) -> str:
    """
    查询指定城市的即时天气。

    参数:
        loc:城市名称字符串。为了提高调用成功率,建议优先传英文城市名。例如Beijing, Shanghai

    返回:
        Openweather 当前天气返回的JSON字符串,包含气温、体感温度、湿度、风速、天气描述等信息。
    """
    # url = "http://api.openweathermap.org/data/2.5/weather"
    #
    # # 设置查询参数
    # params = {
    #     "q": loc,
    #     "appid": os.getenv(
    #         "OPENWEATHER_API_KEY",
    #     ),
    #     "units": "metric", # 温度单位metric=摄氏度
    #     "lang": "zh_cn", # 天气语言描述,简体中文
    # }

    # 发送请求
    # response = httpx.get(url, params=params, timeout=30)

    # 换成另一个天气查询接口
    url = "https://uapis.cn/api/v1/misc/weather"

    params = {
        "city": "天津"
    }

    response = requests.get(url, params=params, timeout=10)
    # 解析转换
    data = response.json()
    return json.dumps(data)


# 本地测试
result = get_weather.invoke("tianjin")
print(result)
可以看出来,模型不会帮你发http请求,真正的请求逻辑仍然是工具里写好的。
Tool的意义不是替代业务实现,而是把业务实现包装成模型可调用的接口。
所以说把业务能力封装成一个可复用函数,用tool方式暴露给模型,让模型只决定何时调、怎么调。
5.3 模型绑定工具后,到底会发生什么
tool如何交给模型,通过bind_tools()实现,不是现在就执行工具,而是声明工具给模型。
只有先把工具绑定给模型,后续模型调用时才有机会返回tool_calls。

5.4 案例:天气助手完整链路
示例:
"""
定义好工具之后将工具绑定给模型,
模型发起请求-》解析tool_calls -》执行工具 -》结果回填 -》模型生成自然语言回复


"""

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(encoding="utf-8")

import os
from langchain_core.tools import tool
from langchain_core.prompts import PromptTemplate
from langchain_core.output_parsers import JsonOutputKeyToolsParser, StrOutputParser
from langchain_openai import ChatOpenAI
from loguru import logger
from QueryWeatherTool import get_weather

# 初始化大模型
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

model_with_tools = model.bind_tools([get_weather])

# 解析器,从模型输出中提取命中的天气工具参数,得到可直接传给get_weather的入参
parser = JsonOutputKeyToolsParser(key_name=get_weather.name, first_tool_only=True)

# 天气查询链:用户问题-》模型,可能返回tool_calls -》解析出参数 -》执行get_weather -》得到天气Json字符串
get_weather_chain = model_with_tools | parser | get_weather

# 然后又将工具输出塞进提示词,让模型转换为自然语言描述

output_prompt = PromptTemplate.from_template(
    """你将收到一段 JSON 格式的天气数据{weather_json},请用简洁自然的方式将其转述给用户。
    以下是天气 JSON 数据:
    请将其转换为中文天气描述,例如:
    "北京现在天气:多云,气温 28℃,体感有点闷热(约 32℃),湿度 75%,微风(东南风 2 米/秒),
    能见度很好,大约 10 公里。建议穿短袖短裤。适合做户外运动。"
    """
)

output_parser = StrOutputParser()
output_chain = output_prompt | model | output_parser

full_chain = get_weather_chain | (lambda x : {"weather_json": x}) | output_chain

result = full_chain.invoke("请问北京今天的天气如何?")
logger.info(result)
输出为:
{"province": "\u5929\u6d25\u5e02", "city": "\u5929\u6d25", "adcode": "120000", "weather": "\u591a\u4e91", "weather_icon": "101", "temperature": 29, "wind_direction": "\u897f\u5357\u98ce", "wind_power": "3\u7ea7", "humidity": 55, "report_time": "9 \u5206\u949f\u524d\u53d1\u5e03"}
2026-07-17 15:09:11.626 | INFO     | __main__:<module>:53 - 北京现在天气:晴,气温 29℃,湿度 56%,南风 4 级。建议穿短袖短裤,适合户外活动。
其中JsonOutputKeyToolsParser用于解析模型输出中的工具调用请求中的参数,解析为可执行的python结构。
分成了两段:
前半段:用户问题-》模型判断-》解析工具参数-》调工具-》得到json
后半段:把工具json交给模型-》生成更自然的中文天气描述
5.5 课程案例写法与官方主线的关系
官方主线中,常见的讲解是:
模型返回AIMessage.tool_calls
程序执行工具
结果包装成ToolMessage
再把这组消息送回模型
这两种写法本质一样,模型发起工具调用意图-》程序执行工具-》结果回到模型上下文里
修改为官方讲法:
"""
官方主线写法

"""

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
load_dotenv(encoding="utf-8")

import os
from langchain_core.tools import tool
from langchain_core.messages import ToolMessage
from loguru import logger
from QueryWeatherTool import get_weather

# 初始化模型
model = init_chat_model(
    model="deepseek-v4-flash",
    api_key=os.getenv("deepseek-api"),
    base_url="https://api.deepseek.com",
)

# 模型绑定工具
model_with_tools = model.bind_tools([get_weather])

def execute_tool_calls(tool_calls):
    """执行工具调用,返回toolmessage列表"""
    tool_messages = []
    for tool_call in tool_calls:
        # tool_call是一个字典,包含name, args, id
        tool_name = tool_call["name"]
        tool_args = tool_call["args"]
        tool_call_id = tool_call["id"]

        # 根据工具名执行对应工具
        if tool_name == get_weather.name:
            result = get_weather.invoke(tool_args)
        else:
            result = f"未知工具: {tool_name}"

        # 包装为tool_message
        tool_messages.append(
            ToolMessage(
                content=str(result),
                tool_call_id=tool_call_id
            )
        )

    return tool_messages

# 主流程
def chat_with_tools(user_query):
    """
    完整的工具调用流程
    1 用户提问,模型生成,可能包含tool_calls
    2 如果有tool_calls,执行工具,生成ToolMessage
    3 将ToolMessage回填给模型
    4 模型生成最终自然语言回复
    """
    messages = [{"role": "user", "content": user_query}]

    # 第一步模型发起请求
    response = model_with_tools.invoke(messages)

    # 检查是否有工具调用意图
    if hasattr(response, "tool_calls") and response.tool_calls:
        logger.info(f"检测到工具调用:{response.tool_calls}")
        # 第二步,执行工具
        tool_messages = execute_tool_calls(response.tool_calls)

        # 第三步,将工具结果回填到消息上下文
        messages.append(response)
        messages.extend(tool_messages)

        # 第四步,将完整上下文再次传给模型,生成自然语言回复
        final_response = model.invoke(messages)

        return final_response.content
    else:
        return response.content

if __name__ == "__main__":
    result = chat_with_tools("请问上海今天的天气如何?")
    logger.info(f"最终回复: {result}")
输出如下:
{"province": "\u5929\u6d25\u5e02", "city": "\u5929\u6d25", "adcode": "120000", "weather": "\u591a\u4e91", "weather_icon": "101", "temperature": 30, "wind_direction": "\u5357\u98ce", "wind_power": "2\u7ea7", "humidity": 49, "report_time": "6 \u5206\u949f\u524d\u53d1\u5e03"}
2026-07-17 15:52:44.669 | INFO     | __main__:chat_with_tools:67 - 检测到工具调用:[{'name': 'get_weather', 'args': {'loc': 'Shanghai'}, 'id': 'call_00_iImHk2UhIa8K71MdjNNh8513', 'type': 'tool_call'}]
2026-07-17 15:52:46.808 | INFO     | __main__:<module>:84 - 最终回复: 根据最新气象数据,上海今天(目前)的天气情况如下:

- **天气状况**:多云 ☁️
- **气温**:**37°C**(非常热,需要注意防暑)
- **风向风力**:西南风,2级(微风)
- **湿度**:42%(相对干燥)

**温馨提示**:
- 今天气温较高,紫外线较强,建议减少户外活动时间,注意**防暑降温**,多补充水分。
- 如果外出,请做好防晒措施(帽子、太阳镜、防晒霜),并携带防暑药品。

希望这些信息对您有帮助!
6 从课程案例走向真实项目
6.1 Tool在项目里通常怎么落位
一种比较常见,也比较适合团队协作的组织方式是:
- tool.py/tools,定义给模型看的工具入口
- service.py/ services/,写真实业务逻辑
- client.py/ adapters/,封装第三方API或内部接口访问
- prompt / chain / agent层,决定什么时候调用工具
6.2 设计Tool时,最值得重视的工程原则
职责单一、输入明确、输出稳定、异常可控、幂等与副作用隔离、超时/重试/限流、权限受控、可观测
后续mcp解决的是如何用标准协议把外部能力开放给模型,可以看作是更通用、更标准化的工具接入方式
第18章 向量数据库与Embedding实战
1 向量与向量化
1.1 向量的定义
向量表示了什么,用一组有顺序的数字表示了某个对象在空间中的位置或特征
例如二维向量、三维向量、高维向量。向量可以表示对象的特征。
1.2 向量化的定义
向量化,嵌入。
LangChain中的文本Embedding:Embedding模型会把句子、段落等原始文本转换成固定长度的数字向量,并尽量让语义相近的文本在向量空间里靠的更近。
Embedding常被用在:用于搜索、推荐系统、文本聚类、去重与相似内容识别、RAG检索增强生成
1.3 语义相似与向量相近
嵌入是为了使得语义关系映射成空间关系。语义相近的向量通常也会更近。
1.4 向量维度的定义
不同Embedding模型输出维度可能不同。
即时维度相同,不同模型的向量空间通常也不能直接混用。
因此保证建库时用的Embedding模型,和查询时用的Embedding模型保持一致。
1.5 进一步建立直觉
高维Embedding可理解为更多维度的特征轴,维度与模型设计相关,检索结果依赖模型与索引质量,而非单看维数高低。
2 向量数据库
2.1 定义
可以把向量数据库理解为一种专门面向相似度检索的存储系统。
2.2 与传统数据库的定义
向量检索侧重语义相似,可以相似性搜索,最近邻检索。
2.3 向量数据库里存什么
向量数据库里通常包含了原始内容,向量值,元数据,索引结构。
这个对RAG非常关键,因为检索阶段不仅要拿到最像的向量,还要拿回对应的文本片段和元数据,最后才能交给大模型生成答案。
2.4 稠密向量、稀疏向量、标量字段定义
一个可检索的数据对象,往往同时包含稠密向量、标量字段,某些系统里还会额外使用稀疏向量。
标量字段Scalar Fields,例如source, author, category, created_at, doc_id这类普通字段,不参与语义向量计算,但常用于过滤,排序,权限控制等
以 BGE-M3 这类 Embedding 模型为例,它可以同时支持稠密向量、稀疏向量等多种表示方式。放到检索系统里,就可以形成这样的搭配:
- 稠密向量:用户换一种说法提问时,仍然能按语义找到相关内容
- 稀疏向量:产品型号、错误码、专有名词、精确关键词匹配
- 标量字段:权限、分类、时间、来源、业务标签过滤
所以生产 RAG 里经常会看到“稠密检索 + 稀疏检索 + metadata filter + rerank”的组合。它不是为了把系统做复杂,而是因为单一路径很难同时兼顾语义、关键词和业务约束。
2.5 常见的向量数据库分类
FAISS, Chroma, Milvus, Pgvector, Redis/Redis Stack, ElasticSearch / OpenSearch
2.6 RAG与向量数据库的关系
RAG的原理就不用多说了。
2.7 Redis与Milvus怎么选
把Milvus作为生产级扩展方向
3 用Redis Stack作为向量存储
Redis Stack在Redis基础上集成了搜索与向量检索能力。
4 Embedding文本向量化
把文本变成向量
4.1 定义
距离越小相似度越高,相关性越高;距离越大,相关性越低;
Embeddings的常见应用:
- 搜索
- 聚类
- 推荐
- 异常检测
- 多样性测量
- 分类
LangChain官方进一步强调了两个API:
- embed_query(text),将单条查询文本转成向量
- embed_documents(texts),把多条文档文本批量转成向量
这一组正好对应真实项目里的两个阶段:
- 索引阶段:把文档片段批量向量化,通常用embed_documents
- 查询阶段:把用户问题向量化,通常用embed_query
4.2 重要实践规则
经验:
- Embedding模型输出的是向量,不是自然语言
- 不同Embedding模型的维度可能不同
- 建索引和查询必须使用同一套Embedding模型
- Embedding适合做语义相似度计算,但本身不负责回答问题
- 本章主线是文本Embedding
4.3 案例:DashScope原生调用,先看到向量长什么样
这里就是演示一下文本转成向量是什么样子的。
4.4 案例:OpenAI兼容写法,理解同一能力,不同接法
很多平台有OpenAI兼容接口,使用OpenAI SDK的调用方式,
因此学习通用接入模式
"""
兼容OpenAI格式

"""

import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

input_text = "衣服的质量杠杠的"

# 使用 OpenAI 兼容接口连接阿里百炼:调用方式仍是 OpenAI SDK,只是连接地址改成百炼的兼容网关
client = OpenAI(
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 与 OpenAI Embedding 调用方式一致:model 为百炼模型名,input 为待向量化的文本
completion = client.embeddings.create(model="text-embedding-v4", input=input_text)

print(completion.model_dump_json())
4.5 使用LangChain接口做单条与批量向量化
前面的是原生使用OpenAI格式的,现在使用langchain框架封装的,
例如使用 :
embed_query(text)和embed_documents(texts),分别是单条查询文本向量化,多条文档文本批量向量化;
代码示例:
"""
embed_query(text)更偏查询阶段,常用于把用户问题转成向量
embed_documents(texts)更偏索引阶段,常用于把文档片段批量转成向量

返回值分别是单个向量和向量列表,
"""

import os
from langchain_community.embeddings import DashScopeEmbeddings
from dotenv import load_dotenv

load_dotenv()


# 使用项目统一的aliQwen-api,
embeddings = DashScopeEmbeddings(
    model="text-embedding-v4",
    dashscope_api_key=os.getenv("aliQwen-api"),
)

text = "This is a test document"

# 单条文本 -》 一个向量
query_result = embeddings.embed_query(text)

print("文本向量长度:", len(query_result), sep="")

# 多条文本 -》 多个向量
doc_results = embeddings.embed_documents(
    [
        "Hi there!",
        "Oh, hello!",
        "What's your name?",
        "My friends call me World",

    ]
)

print(doc_results)


print(
    "文本向量数量:", len(doc_results), ", 文本向量长度: ", len(doc_results[0]), sep= ""
)
注意的是单条返回的一个向量,批量返回的是向量列表。
4.6 进阶扩展,多模态Embedding
例如dashscope.MultiModalEmbedding.call()
5 通过向量计算语义相似度
得到向量之后就是比较两段文本在语义上接近程度
5.1 常用余弦相似度
余弦相似度的方式是点积 / 模,结果通常在[-1, 1]范围内,
- 越接近1,表明越相似
- 越接近0,表明相关性较弱
- 越接近-1,表明方向相反
5.2 检索里常见的距离度量
- COSINE,更关注向量方向是否接近,是文本语义检索里最常见,也最容易理解的一类度量
- L2,欧式距离,关注两个点在空间里的直线距离,距离越小,通常表示越接近
- IP,Inner Product,内积,
要确保Embedding模型的特性,索引建立时选择的度量方式,查询时传入的metric,三者必须一致
5.3 精确检索、近似检索与索引
不是所有相似检索,都会老老实实把查询向量和库里每个向量逐一比较。
- 精确检索Exact KNN,FLAT, 把查询向量和库里所有向量都算一遍
- 相似检索ANN, Approximate Nearest Neighbor,通过索引结构加速搜索,只近似的找到最可能接近的一批结果
HNSW,工程里常见的ANN索引,通常能在召回率和延迟之间取得较好平衡。
理解索引:索引的作用不是改变语义相似的定义,而是让找最相似内容这件事在大规模数据下也能跑得动。
5.4 案例:把多句话转成向量,再两两比较
使用numpy计算余弦相似度,两两比较结果。
可以看到如下示例:
"""
拿到向量了进行数学计算,计算相似度
cos(theta) = (A . B) / (|A || B|)
"""
import dashscope
import os
from http import HTTPStatus
import numpy as np
from dotenv import load_dotenv
from langchain_community.embeddings import DashScopeEmbeddings
load_dotenv()

# 准备多句文本,用于观察语义越相近,相似度通常越高
texts = ["我喜欢吃苹果", "苹果是我最喜欢吃的水果", "我喜欢用苹果手机"]

embeddings = []

# 针对每个文本进行向量化
embedding_model = DashScopeEmbeddings(
    model="text-embedding-v4",
    dashscope_api_key=os.getenv("aliQwen-api")
)

embeddings = embedding_model.embed_documents(texts)

print(len(embeddings))

# 计算两个向量的相似度
def cosine_similarity(vec1, vec2):
    """计算两个向量的余弦相似度"""
    dot_product = np.dot(vec1, vec2)
    norm_vec1 = np.linalg.norm(vec1)
    norm_vec2 = np.linalg.norm(vec2)
    return dot_product / (norm_vec1 * norm_vec2)


print("文本相似度比较结果:")
print("=" * 60)

for i in range(len(texts)):
    for j in range(i + 1, len(texts)):
        similarity = cosine_similarity(embeddings[i], embeddings[j])
        print(f"文本{i+1} vs 文本{j+1}: ")
        print(f"  文本{i+1}: {texts[i]}")
        print(f"  文本{j+1}: {texts[j]}")
        print(f"  余弦相似度: {similarity:.4f}")
        print("-" * 40)
输出内容为:
3
文本相似度比较结果:
============================================================
文本1 vs 文本2:
  文本1: 我喜欢吃苹果
  文本2: 苹果是我最喜欢吃的水果
  余弦相似度: 0.8393
----------------------------------------
文本1 vs 文本3:
  文本1: 我喜欢吃苹果
  文本3: 我喜欢用苹果手机
  余弦相似度: 0.7158
----------------------------------------
文本2 vs 文本3:
  文本2: 苹果是我最喜欢吃的水果
  文本3: 我喜欢用苹果手机
  余弦相似度: 0.6866
----------------------------------------
说明了拿到向量如何做相似度计算,当两个主题更接近时,相似度通常会更高
5.5 相似度结果在项目里怎么用
相似度结果可用于:
- 语义检索排序
- 文本去重
- 推荐
- 聚类分析
6 向量库的写入与检索
RAG的底层能力,
需要把文本和向量写入Redis,然后按相似度做检索
这一步先建索引,做相似度检索
6.1 案例:把Document写入Redis,再用检索器取回结果
这里是假设准备好了若干document,然后用dashscopeEmbeddings把page_content向量化
然后使用Redis.from_documents写入redis,
通过as_retriever()生成检索器,对查询文本做相似度检索
"""

redis_url 和 index_name要与本地环境一致,如果要复用已有索引,查询端也必须使用同一个index_name

"""

import os
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.vectorstores import Redis
from langchain_core.documents import Document
from dotenv import load_dotenv

load_dotenv()

# 初始化嵌入模型
embeddings = DashScopeEmbeddings(
    model="text-embedding-v3",
    dashscope_api_key=os.getenv("aliQwen-api")
)

# 构造Document列表,page_content是正文,metadata是附加信息
texts = [
    "通义千问是阿里巴巴研发的大语言模型",
    "Redis是一个高性能的键值存储系统",
    "LangChain可以轻松集成各种大模型和向量数据库"
]

documents = [
    Document(page_content=text, metadata={"source": "manual"}) for text in texts
]

# 一次性写入redis,内部会对每个Document的page_content向量化,并建立可检索索引
vector_store = Redis.from_documents(
    documents=documents,
    embedding=embeddings,
    redis_url="redis://localhost:26379",
    index_name="my_index11",
)

# 检索器,当invoke时,langchain会先把问题向量化,再在库中相似度检索
retriever = vector_store.as_retriever(search_kwargs={"k": 2})
results = retriever.invoke("Langchain和redis怎么结合")
for res in results:
    print(res.page_content)
输出为:
LangChain可以轻松集成各种大模型和向量数据库
Redis是一个高性能的键值存储系统
可以理解向量库不是孤零零的数字而是和Document结构结合起来的内容,检索出来的也不是向量本身,而是对应的Document,这正是RAG后面能把检索结果塞回Prompt的基础。
然后可以在redisinsight里看到如下结构:localhost:8001

可以看到每条内容里存储了content, source元数据, content_vector向量
也就是说redis在这里保存的是一份可检索的语义索引,而不是只存一组浮点数。
6.2 案例:使用langchain_redis的RedisVectorStore写入文本
还可以用更贴近Redis集成包的写法:
- RedisConfig
- RedisVectorStore
- add_texts()
用于理解先创建一个向量库实例,再持续往里面追加文本
"""
示例:先创建RedisVectorStore,再通过add_texts()把字符串列表写入向量库
add_texts()实际上会在内部调用embed_documents,然后再把文本,向量,metadata写入redis

"""
from langchain_redis import RedisConfig, RedisVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
import os
from dotenv import load_dotenv

load_dotenv()

# 初始化嵌入模型
embeddings = DashScopeEmbeddings(
    model="text-embedding-v3",
    dashscope_api_key=os.getenv("aliQwen-api")
)

# 待写入的文本
texts = [
    "我喜欢吃苹果",
    "苹果是我最喜欢吃的水果",
    "我喜欢用苹果手机"
]

# 定义每条文本对应的元数据信息,真实RAG中这些metadata来自Document.metadata,
metadata = [{"segment_id": str(i)} for i in range(1, len(texts) + 1)]

# Redis连接与索引名
config = RedisConfig(
    index_name="newsgroups",
    redis_url="redis://localhost:26379"
)

# 创建redis向量库实例
vector_store = RedisVectorStore(embeddings, config=config)

# 将文本与元数据写入向量库
ids = vector_store.add_texts(texts, metadata)

print(ids[0:5])
可以看见里面的元数据存的就是segment_id,

6.3 案例:连接已有索引,做相似性检索
从redis库中读取数据,进行检索相似的,
核心动作:
- 连接已有的index_name
- 查询文本向量化
- 在redis中找最相近的若干条文本
- 返回(Document, score)结果
6.4 元数据过滤,混合检索与重排序
不能简单理解检索就是把查询转成向量然后直接搜索top-k,这是主线,但是在真实项目里,还会包含:
- 元数据过滤,缩小候选范围,再做向量检索
- 混合检索:同时结合语义向量检索和关键词检索,或者结合不同类型的召回路径
- 重排序:先召回一批候选结果,再用更精细的模型或策略重新排序
6.5 from_documents 和 add_texts怎么理解
from_documents适合手里已经有一批Document对象,想一次性建库,更像一步到位建索引
add_texts,是有字符串列表,或者想持续追加数据,是增量写入
6.6 本章与第19章的关系
第19章则会用加载器把PDF/ Word / Markdown等文档读成Document,
用分割器把长文档切成片段;
把检索结果和用户问题交给大模型生成答案
6.7 生产级扩展方向
上面主要是了解了Redis向量检索,后续可以提升方向:
- 数据线:增量写,删除更新,索引重建,版本管理
- 检索线:元数据过滤,混合检索,rerank,阈值策略
- 平台线:从轻量的Redis, Chroma过渡到Milvus, OpenSearch等更专业的检索平台
相似度高是否代表答案可用?
参考:不一定,相似度只能说明语义接近,可能仍然答非所问,缺少关键条件或不是最新资料。真实RAG还要结合阈值、过滤、Rerank和答案生成约束。
如果查询结果总是不想管,会先排查哪些环节?
参考:查文档是否写入,Embedding模型是否一致,向量维度是否匹配,查询文本是否合理,metadata过滤是否过严,相似度计算和topk是否设置得当
第19章 RAG检索增强生成
从概念理解落地到代码实践
掌握LangChain中构建RAG最常见的几类组件:文档加载器、文本分割器、嵌入模型、向量数据库、检索器、提示词模板与聊天模型
1 RAG简介
1.1 定义
1.2 RAG的作用
主要是解决知识冻结、私有知识缺失、最新信息不可、回答缺少依据这类问题。
代码是哪些环节决定了回答质量:
- 文档是否被正确加载
- 文本是否被合理切块
- Embedding是否稳定
- 检索是否召回了真正相关的片段
- Prompt是否把上下文用对了
RAG使用不是没有代价,可能会带来:
- 响应时延更高
- Token消耗更高
- 效果依赖链路质量
1.3 RAG的标准流程
这里以LangChain代码的视角过一遍RAG的流程。
LangChain官网也把RAG拆成两大阶段:索引,检索与生成
离线阶段进行索引, 在线阶段检索生成。

1.3.1 索引阶段:先把知识库准备好
索引阶段面对的是原始文档,例如word, pdf, md, txt,等文件,目标不是回答问题,而是把这些文档处理成未来方便检索的心态。
通常包括:
- 加载:把原始文件读成LangChain的Document对象
- 分割:切分文档
- 向量化:Embed,转成向量
- 存储
容易忽略的是:
- 索引通常是离线做的,不一定跟用户问答发生在同一时刻
- 索引不只是存文本
理解metadata:是和文档片段绑定的附加信息,例如文件路径source,页码page,标题,作者,日期,分类等
真正参与向量化的是正文page_content,metadata更多用于来源展示,过滤条件,结果解释。
1.3.2 检索与生成阶段:每次提问时动态查资料
1.3.3 管道式RAG与Agent式RAG
本章是介绍的管道式RAG,先检索再生成,流程由代码固定,而非由模型临时决策。
如果要让模型自己决定要不要检索,什么时候检索,检索几次,就更接近Agent式RAG
1.3.4 一个更贴近生产环境的增强版流程
很多 RAG 系统会在“检索与生成”之间再补几步
- 先召回候选片段,检索不一定只有向量检索,也可能是关键词,混合检索
- 再做过滤或重排,按照metadata过滤返回,或用reranker对候选片段重新打分
- 最后再进Prompt
- 生成后保留来源
- 持续做评测与观测:离线看召回命中率,答案质量,线上看检索链路和生成链路谁在调链子
2 RAG文本处理核心知识
2.1 LangChain组件与标准流程
第20章 MCP模型上下文协议
MCP的核心是把外部能力接入模型应用时变得更标准。
暴露能力:Tools / Resources / Prompts
通信角色:Host / Client / Server
传输方式: stdio / Streamable Http
1 为什么需要MCP
1.1 真实项目里的接入痛点
理解不同AI应用怎样用统一方式接入外部工具和上下文
没有MCP的时候:
- 每个AI应用都要重复接一遍外部系统
- 每个框架和宿主都有自己的接法
- 工具很难复用成生态能力
所以会有大家都在写工具,但是缺少一套跨应用、跨框架、跨宿主都能复用的统一连接标准。
1.2 MCP的核心问题
MCP解决的问题是:让外部工具、资源、提示词模板等能力,能够按统一协议被不同AI应用发现和使用
如果一个AI应用需要多个工具能力,不是自己编写,而是支持MCP,就可以统一接入这些服务。
MCP的价值:一次暴露,多处复用,统一schema,降低适配成本,更容易形成工具生态。
1.3 直观类比:AI世界的统一插口
理解成AI世界的USB-C,也像大模型版的OpenFeign / gRPC协议层,本质上承担的是AI应用和外部能力之间的通用适配层
2 MCP简介
2.1 定义
MCP是一套开放的标准协议,用于规范AI应用 / Agent / IDE / 聊天客户端 如何与外部工具,资源和上下文提供方交互。
MCP的关键词是标准协议、统一接入、跨宿主复用。
2.2 和Tool, RAG, Agent有什么区别
3 MCP能做什么
3.1 统一接入与抽象
最直观的价值:把原本分散的外部能力,用统一方式暴露给AI应用。
所以MCP不是替代Tool,而是在Tool之上再向上抽象了一层协议层。
3.2 MCP服务器通常能暴露什么
MCP服务器最核心的三类能力是:
- Tools,工具,模型可触发,
- Resources,资源,可读取内容,例如文件、配置、数据库等,应用或宿主决定如何使用
- Prompts,可复用的提示词模板或工作流模板,用户可显式选择
所以工具只是MCP的一部分, 不是全部。
3.3 容易忽略的另外几类能力
例如:
- Sampling,服务器通过客户端向宿主侧的LLM请求一次生成
- Elictication,服务器通过客户端向用户请求补充信息
- Loggin:服务器向客户端发送结构化日志
- Progress / Notifications:长任务过程中的进度和通知。
这里本次先掌握:
- Tool如何暴露
- 服务器和客户端怎么连
- LangChain / Agent如何拿到MCP工具
3.4 在实际项目的常见用途
- 给现成AI应用接能力
- 给自研Agent平台做统一工具接入层
- 让企业内部能力变成可复用的AI接口层:例如把查工单、查订单、查配置、发通知这些能力封装层MCP服务,供多个AI应用共享
安全与信任边界:MCP Server往往能以较高权限访问本机文件、内网API或密钥,生产环境应控制来源可信,仅安装审计过的服务,最小权限与网络隔离,并记录调用审计。
4 怎么用MCP
4.1 直接使用现成的MCP服务
很多能力无需一开始就写服务端,先学会怎么接,怎么配,怎么调试也很有必要。
4.2 本地自建MCP客户端
如果要接本地文件系统,内部数据库,企业私有API,自己的业务系统,就通常要自己写MCP Server,在这个过程中理解一个MCP服务是如何被暴露、被发现、再被Agent使用的。
4.2.1 什么是FastMCP
FastMCP是MCP官网Python生态里用来快速编写MCP Server的高层封装。可以更接近写Python函数的方式去暴露MCP能力。
FastMCP是Python里的服务端开发工具,解决怎么更方便的把能力按MCP标准暴露出去。
MCP是规则,FastMCP是实现这些规则的一种工具,可以更轻松的写出一个MCP Server
4.2.2 为什么讲FastMCP
自己实现一个MCP服务端,通常两条路线:
- 自己直接按SDK 、协议细节去实现
- 借助FastMCP这种更高层的封装来实现
4.3 在LangChain / Agent里使用MCP
LangChain官方提供了对MCP的适配支持,
- 用MultiServerMCPClient连接一台或多台MCP服务器
- 通过get_tools()取回MCP工具
- 把这些工具交给create_tool_calling_agent或create_agent
- 让Agent在对话中实际调用
MCP负责接入,LangChain则是将接进来的能力用起来。
5 MCP架构知识
5.1 主机、客户端、服务器定义
MCP采用典型的Host - Client - Server架构

Host是主机,Client是MCP客户端,用于将Host和某几个MCP Server建立协议连接的组件,Server则是对外暴露能力的服务,本地、远程资源则是服务器可访问的文件、数据库、API等
Host就是自己本身在用的应用,需要连接Server的应用 ,通过Client连接。所以一个Host可以连多台Server,一个具体Client通常对应一条到某台Server的直接连接。
5.2 MCP协议层面大致什么工作
MCP在协议层有自己的约定,
- Host/ Client发起连接
- Client和Server做初始化
- 双方声明各自支持的capabilities
- 客户端发现服务器提供的tools/ resources / prompts
- 按需调用或读取
- 结果返回给Host, 再由模型, UI使用
MCP底层消息格式基于JSON-RPC2.0,请求-响应-通知,
5.2.1 用5个动作理解一次完整MCP调用
-
握手与能力发现Handshake Discovery
Host启动后,会根据配置连接MCP Server,并完成初始化。此时客户端就能知道,Server提供了哪些Tools, Resources, Prompts以及支持的capabilities -
用户提问与上下文注入Context Injection
用户提问,Host则会把用户问题和已发现的工具、资源等信息一并发给模型或应用逻辑 -
模型或应用做决策Reasoning Decision
模型决定是否需要调用某个Tool,或者应用决定是否读取某个Resource,选用某个Prompt -
路由与执行Routing Execution
Host / Client按协议把请求发给Server,Server在自己的进程中或远端服务中执行, -
结果回传与继续生成
Server将结果返回给Client, Client再把结果交给Host,再让Host继续让模型生成最终回答。
在Agent场景里,MCP尝尝出现在Tool之前一层
5.3 两类常见传输:STDIO, HTTP系列
根据MCP官方传输规范,当前主线传输标准是:
- stdio
- Steamable HTTP:独立服务进程,通过HTTP通信,必要时可配合SSE流式返回
stdio,适合本地、轻量、由客户端拉起服务端进程,
SSE /HTTP兼容教学写法,适合理解历史资料、理解远程服务形态
5.3.1 传输之外,还要注意安全边界
- 写操作要有人确认:删除、外呼、支付、批量修改这类Tool,不要默认让模型静默执行
- HTTP服务要做鉴权和来源校验,要考token, 会话身份,origin / 来源校验,不是能连上就算接入成功
- 本地服务尽量收口暴露范围
- 日志与业务数据要分级处理:进度、错误、调试日志很有用,但不要把敏感配置、私有数据原样暴露给模型或不可信客户端
5.4 FastMCP的基本写法与常用API
5.4.1 创建服务实例
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("Demo")
创建一个MCP Server实例
5.4.2 注册Tool
@mcp.tool()
def add(a : int, b : int) -> int:
	return a + b
把普通python函数暴露成mcp tools。
5.3.4 注册Resource
@mcp.reource("greeting://default")
def get_greeting() -> str:
  return "Hello from static resource!"
这还是服务器对外暴露一个可读资源,客户端可以按URI读取
5.4.4 注册Prompt
@mcp.prompt()
def greet_user(name: str, style: str = "friendly") -> str:
  return f"为{name}生成问候语"
对外暴露一个可复用提示词模板
5.4.5 启动服务
mcp.run(transport=“stdio”)
或者mcp.run(transport=“streamable-http”)
5.4.6 从底层SDK视角看客户端
以官方SDK思路来看,一个MCP客户端的典型动作通常是:
- 建立传输连接
- 创建ClientSession
- 调用initialize
- lsit_tools(), list_resources(), list_prompts()
- call_tools(), read_resources(), get_prompt()
例如Stdio的示例:
import asyncio
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

async def main():
    server_params = StdioServerParameters(
        command="python",
        args=["mcp_server_stdio.py"],
    )
    async with stdio_client(server_params) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()
            tools = await session.list_tools()
            result = await session.call_tool("add", {"a": 1, "b": 2})
            print(tools)
            print(result)

asyncio.run(main())
理解SDK原理实现过程,有哪些步骤。
5.5 完整调用过程理解
在LangChain中,就是:
- MultiServerMCPClient,连接MCP服务
- get_tools获取工具
- Agent拿到工具列表
- 用户提问
- Agent选择工具
- 工具返回结果
- 模型基于结果继续生成最终回答
6 案例实战:本地MCP天气服务与客户端
6.1 本章案例在项目中的位置
6.2 服务端案例区分理解
6.2.1 极简教学版:McpServer.py
"""
FileName:
Author:
Version:
Date: 2026/7/2614:07
Description:
"""
"""
极简实现,无FastMCP依赖
MCP则是在Tool之上增加一层标准协议,让同一套能力更容易被不同宿主,不同AI应用复用

"""
import json
import os
import httpx
from loguru import logger
from dotenv import load_dotenv

load_dotenv()

# ---------极简版MPC服务类,无FastMCP依赖,手写-------------、
# 如果使用FastMCP,则不需要下面这一整段class,直接mcp = FastMCP("名")  + @mcp.tool() + mcp.run()
class MCPWeatherServer:
    """只保留了注册工具,维持进程这两个概念"""

    def __init__(self, name: str, host: str, port: int):
        self.name = name
        self.host = host
        self.port = port
        self._tools = {}

    def tool(self):
        """实现@mcp.tool()装饰器,把普通函数登记到工具注册表中"""
        def decorator(func):
            self._tools[func.__name__] = func # 注册工具函数,key为函数名
            return func

        return decorator

    def run(self, transport: str):
        """模拟 run() 入口;这里只打印监听信息并保持进程存活,不提供完整网络服务。"""
        if transport != "sse":
            logger.warning(f"不支持的传输协议 {transport},默认使用 SSE")
        logger.info(f"启动 MCP SSE 天气服务器,监听 http://{self.host}:{self.port}/sse")
        self._keep_alive()

    def _keep_alive(self):
        """简单保持进程运行,便于从日志层面观察服务端已启动的状态"""
        try:
            while True:
                pass
        except KeyboardInterrupt:
            logger.info("MCP 天气服务已停止")


#---------创建MCP实例并注册工具---------
mcp = MCPWeatherServer("WeatherServerSSE", host="127.0.0.1", port=8000)


# 将get_weather注册为MCP工具
@mcp.tool()
def get_weather(city: str) -> str:
    """
    查询指定城市的及时天气信息

    """
    url = "https://api.openweathermap.org/data/2.5/weather"
    params = {
        "q": city,
        "appid": os.getenv(
            "OPENWEATHER_API_KEY"
        ),
        "units": "metric",
        "lang": "zh_cn",
    }
    resp = httpx.get(url, params=params, timeout=10)
    data = resp.json()
    logger.info(f"查询{city} 天气结果: {data}")
    return json.dumps(data, ensure_ascii=False)


if __name__ == "__main__":
    logger.info("启动MCP SSE天气服务器,监听http://127.0.0.1:8000/sse")
    mcp.run(transport="sse")
理解服务端干了什么:
- 维护一个_tools容器
- 用@mcp.tool()把get_weather注册进去
所以能够理解mcp的思想,服务器如何暴露工具,
6.2.2 标准写法入门版:McpServerByFastMCP.py
"""
FileName:
Author:
Version:
Date: 2026/7/2615:14
Description:
"""
"""
FastMCP通过@mcp.tool, @mcp.resource(), @mcp.prompt()暴露工具,静态资源和提示词模板
本次示例使用transport = \"stdio"\,通过标准输入输出与客户端通信,最适合本地开发,命令行宿主

"""
from mcp.server.fastmcp import FastMCP

# 创建mcp实例,对应了MCP服务器这个角色
mcp = FastMCP("Demo")

# 为MCP实例添加工具,最典型的可执行动作
@mcp.tool()
def add(a: int, b: int) -> int:
    return a + b

# 为mcp实例添加资源,资源更像可读取内容,常由宿主决定是否拿来做上下文
@mcp.resource("greeting://default")
def get_greeting() -> str:
    return "Hello from static resource!"

# 为mcp添加提示词模板,
@mcp.prompt()
def get_user(name: str, style: str = "friendly") -> str:
    styles = {
        "friendly": "写一句友善的问候",
        "formal": "写一句正式的问候",
        "casual": "写一句轻松的问候",
    }
    return f"为{name}{styles.get(style, styles['friendly'])}"

if __name__ == "__main__":
    # 正确用法是由cursor/ Claude等MCP客户端启动本进程并接管stdin, stdout
    mcp.run(transport="stdio")
6.2.3 天气服务端:McpServerWeatherByFastMCP.py
"""
FileName:
Author:
Version:
Date: 2026/7/2615:48
Description:
"""
"""
网络化MCP Tool服务示例,只保留一个天气查询工具,配合同目录的mcp.json
正确写法:
应该先构建实例,mcp = FastMCP("服务名")
再运行,mcp.run(transport="sse", host="127.0.0.1", prot=8000)
"""

import json
import os

# pip install mcp httpx python-dotenv
from dotenv import load_dotenv
from mcp.server.fastmcp import FastMCP
import httpx

load_dotenv()

# 构造函数只接受「服务名」;网络绑定信息在 run() 时再指定
mcp = FastMCP(
    "WeatherServerSSE"
)  # "WeatherServerSSE" 就是你自己起的名,可改成 "MyWeather" 等


@mcp.tool()
def get_weather(city: str) -> str:
    """查询指定城市的即时天气信息。city 为城市英文名,如 Beijing、Shanghai。"""
    url = "https://api.openweathermap.org/data/2.5/weather"
    params = {
        "q": city,
        "appid": os.getenv("OPENWEATHER_API_KEY"),
        "units": "metric",
        "lang": "zh_cn",
    }
    resp = httpx.get(url, params=params, timeout=10)
    data = resp.json()
    return json.dumps(data, ensure_ascii=False)


if __name__ == "__main__":
    # host、port 在 run() 时传入,不是构造函数。
    # 这里启动后,mcp.json 中的 weather 服务就可以按约定地址连到它。
    mcp.run(transport="sse", host="127.0.0.1", port=8000)
6.3 mcp.json简介
这里的json文件结合上面的McpServerWeatherByFastMCP.py来看,
{
  "mcpServers": {
    "weather": {
      "url": "http://127.0.0.1:8000/sse",
      "transport": "sse"
    },
    "fetch": {
      "command": "uvx",
      "args": ["mcp-server-fetch"],
      "transport": "stdio"
    }
  }
}
理解为mcp.json是MCP host / client适配器常用的客户端连接配置文件,
例如Deerflow中的mcp.json配置就是采用这种契约,解决了:
- 要连接哪几台服务器
- 每台服务器用什么transport
- URL, command , args是什么
而不是说明MCP本题如何定义的问题。
例如上面的json示例:
- weather,走sse,指向本地天气服务
- fetch,走stdio,通过命令启动一个本地mcp server
体现出了同一个客户端完全可以同时连接多台MCP Server,而且每台服务器可以用不同传输方式。
6.4 客户端案例怎么区分理解
6.4.1 同进程教学版客户端McpClient.py
"""
FileName:
Author:
Version:
Date: 2026/7/2615:57
Description:
"""
"""
本地MCP天气客户端,直接调用服务端已注册工具
客户端职责:连接服务器,发现能力,发起调用
本案例为:同机,同进程演示,
客户端可通过from McpServer import mcp拿到mcp实例,再调用mcp._tools调用已注册工具,
没有走真实的mcp通信,这样是因为先了解调用原理,后续再理解FastMCP和LangChain客户端案例

"""

import json
from loguru import logger
from McpServer import mcp

class MCPWeatherClient:
    """教学版客户端,直接访问服务端注册表"""
    def __init__(self, mcp_instance):
        self.mcp_instance = mcp_instance
        # 获取工具
        self.available_tools = mcp_instance._tools

    def check_tool_availability(self, tool_name: str) -> bool:
        """检查工具是否在服务端注册,避免调用不存在的工具"""
        is_available = tool_name in self.available_tools
        if is_available:
            logger.info(f"工具 '{tool_name}' 可用")
        else:
            logger.warning(f"工具 '{tool_name} 未在服务端注册'")
        return is_available

    def call_get_weather(self, city: str) -> str or None:
        """调用服务端工具"""
        tool_name = "get_weather"
        if not self.check_tool_availability(tool_name):
            return None
        try:
            # 直接调用工具函数
            weather_result = self.available_tools[tool_name](city)
            logger.info(
                f"成功获取{city} 天气数据,返回结果长度: {len(weather_result)}"
            )
            return weather_result
        except Exception as exc:
            logger.error(f"调用 {tool_name} 工具失败: {str(exc)}")
            return None


def run_client_demo():
    """客户端演示:初始化客户端,依次查询多城市天气并格式化输出"""
    logger.info("初始化 MCP 天气客户端...")
    client = MCPWeatherClient(mcp)

    # 调用天气查询工具(支持 Beijing、Shanghai、Guangzhou 等英文城市名)
    target_cities = ["Beijing", "Shanghai"]
    for city in target_cities:
        logger.info(f"\n========== 查询 {city} 天气 ==========")
        weather_data = client.call_get_weather(city)
        if weather_data:
            # 格式化输出结果(可选,方便阅读)
            formatted_data = json.dumps(
                json.loads(weather_data), indent=4, ensure_ascii=False
            )
            print(f"格式化天气结果:\n{formatted_data}")
        print("-" * 50)
if __name__ == "__main__":
    logger.info("启动 MCP 天气客户端...")
    run_client_demo()
6.4.2 更贴近真实项目的客户端McpClientAgent.py
"""
【案例】基于 mcp.json + LangChain Agent 的 MCP 客户端(LLM + MCP 工具)

对应教程章节:
- 第 20 章 - MCP 模型上下文协议 → 6、案例实战:本地 MCP 天气服务与客户端
- 第 21 章 - Agent 智能体 → 5、实操与案例(5.4 Agent + MCP)

知识点速览:
- 从同目录的 mcp.json 加载 MCP 服务配置,使用 langchain_mcp_adapters 的 MultiServerMCPClient 连接多台
  MCP 服务器并获取工具列表,再交给 LangChain 的 create_tool_calling_agent + AgentExecutor,形成
  「LLM + MCP 工具」的对话 Agent。这也是第 21 章里“外部工具接入 Agent”的代表案例。
- mcp.json 是“客户端侧的连接配置约定”,不是 MCP 协议本身。它描述的是“有哪些服务、分别怎么连”,
  例如本仓库里既有网络方式的 weather 服务,也有 stdio 方式的 fetch 服务。
- 流程:加载 mcp.json → 初始化 MultiServerMCPClient → 异步获取 MCP Tools → 创建 DeepSeek 模型与
  提示模板 → 组装 Agent 与 AgentExecutor → 启动命令行聊天循环(输入 quit 退出)。
- 本案例重点展示“把 MCP Tools 交给 LangChain Agent”;Resources 和 Prompts 虽然也是 MCP 能力,
  但这里没有作为主线展开。
- 这个文件延续了仓库里更容易教学的 classic Agent 路线;如果改走更偏 1.x 的直接路线,也常见
  `await client.get_tools()` 之后把工具交给 `create_agent`,再配合 `ainvoke()` / `astream()` 使用。
- 依赖:pip install langchain-mcp-adapters langchain-openai langchain-classic loguru;部分适配器要求 Python 3.12 及以下。需配置环境变量 deepseek-api(或改用其他兼容 OpenAI 的 api_key/base_url)。
"""

import asyncio
import json
import os
from pathlib import Path

from loguru import logger

# 默认 mcp.json 路径(与本文件同目录)
_MCP_JSON_PATH = Path(__file__).resolve().parent / "mcp.json"


def load_servers(file_path: str | Path | None = None) -> dict:
    """
    加载 MCP 服务器配置。
    :param file_path: 配置文件路径,默认使用同目录下的 mcp.json
    :return: 完整配置字典,如 {"mcpServers": {"weather": {...}, "fetch": {...}}}

    这里读取的是“客户端如何连接服务”的约定配置,而不是协议本体。
    """
    path = Path(file_path) if file_path else _MCP_JSON_PATH
    if not path.exists():
        logger.warning(f"未找到 mcp 配置文件: {path}")
        return {"mcpServers": {}}
    with open(path, "r", encoding="utf-8") as f:
        config = json.load(f)
    logger.info(
        f"已加载 mcp 配置: {path},共 {len(config.get('mcpServers', {}))} 个服务"
    )
    return config


async def run_chat_loop(config_path: str | Path | None = None) -> None:
    """
    启动并运行一个基于 MCP 工具的聊天 Agent 循环。
    该函数会:1)加载 MCP 服务器配置;2)初始化 MCP 客户端并获取工具;
    3)创建基于 DeepSeek 的语言模型和 Agent;4)启动命令行聊天循环;5)退出时清理资源。
    """
    try:
        from langchain_mcp_adapters.client import MultiServerMCPClient
    except ImportError as e:
        logger.error(
            "请先安装 langchain-mcp-adapters: pip install langchain-mcp-adapters(部分环境需 Python 3.12 及以下)"
        )
        raise e

    from langchain_openai import ChatOpenAI
    from langchain_classic.agents import AgentExecutor, create_tool_calling_agent
    from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

    config = load_servers(config_path)
    servers = config.get("mcpServers", {})
    if not servers:
        logger.warning("mcp.json 中未配置任何服务,无法获取 MCP 工具")
        return

    # 初始化 MCP 客户端:connections 就是 mcp.json 中的 mcpServers 字典
    # 每个条目描述一台 MCP 服务该如何连接,例如 stdio 子进程或 HTTP/SSE 地址
    client = MultiServerMCPClient(connections=servers)

    # 按官方默认用法,MultiServerMCPClient 是无状态的;获取工具时使用异步接口即可
    tools = await client.get_tools()
    if not tools:
        logger.warning(
            "未从 MCP 服务获取到任何工具,请确认服务已启动且 mcp.json 配置正确"
        )
        return

    logger.info(f"已获取 {len(tools)} 个 MCP 工具: {[t.name for t in tools]}")

    # 语言模型(DeepSeek,与截图一致;可改为其他 OpenAI 兼容接口)
    llm = ChatOpenAI(
        model="deepseek-v4-flash",
        api_key=os.getenv("deepseek-api"),
        base_url="https://api.deepseek.com",
    )

    # 对话提示:系统提示要求使用工具完成用户请求,agent_scratchpad 供 Executor 填入中间步骤
    prompt = ChatPromptTemplate.from_messages(
        [
            ("system", "你是一个有用的助手,需要使用提供的工具来完成用户请求。"),
            ("human", "{input}"),
            MessagesPlaceholder(variable_name="agent_scratchpad"),
        ]
    )

    agent = create_tool_calling_agent(llm, tools, prompt)
    agent_executor = AgentExecutor(
        agent=agent,
        tools=tools,
        verbose=True,
        handle_parsing_errors="解析用户请求失败,请重新输入清晰的指令",
    )

    logger.info("\n MCP Agent 已启动,请先输入一个提问给(LLM+MCP),输入 'quit' 退出")

    while True:
        try:
            user_input = input("\n您: ").strip()
            if not user_input:
                continue
            if user_input.lower() == "quit":
                logger.info("已退出")
                break
            result = agent_executor.invoke({"input": user_input})
            output = result.get("output", result)
            print(f"\nAgent: {output}")
        except KeyboardInterrupt:
            logger.info("已退出")
            break


def main() -> None:
    asyncio.run(run_chat_loop())


if __name__ == "__main__":
    main()
第21章 Agent智能体
读完本章要能判断一个需求到底该用普通链,工具调用还是agent。
1 Agent简介
1.1 定义
现在(2026.9.24)agent的定义可以从Agent = 模型 + 工具集 + 运行循环 + 当前状态,改变为agent = LLM + harness了。
也要注意,不是所有agent都必须同时具备长期记忆、复杂规划、多智能体协作。
1.2 Agent常见工作方式
React方式,思考与行动的循环方式。
此外还有:
- Plan-and-Execute,
- Router/Supervisor
- Workflow/ Agent混合
- Multi-Agent/ A2A,
- Human in the loop,
1.3 Tool与Agent的关系
Agent负责决策,不负责执行,工具负责执行,
1.4 Agent的使用场景
如果流程路径固定的,优先考虑工作流,链路,而不是Agent。
如果下一步怎么做不固定,则需要模型根据中间结果动态决定,更适合agent。
所以说路径不固定、工具选择依赖上下文、中间结果会影响后续决策,则更适合agent。
很多企业项目实际是:workflow负责固定骨架,agent负责不确定节点的决策。

 1902


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


