


🌐 社群导航
🔗点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群
最新论文解读系列
论文名:Anti-Diffusion: Preventing Abuse of Modifications of Diffusion-Based Models
论文链接:https://arxiv.org/pdf/2503.05595
开源代码:https://github.com/whulizheng/Anti-Diffusion
导读
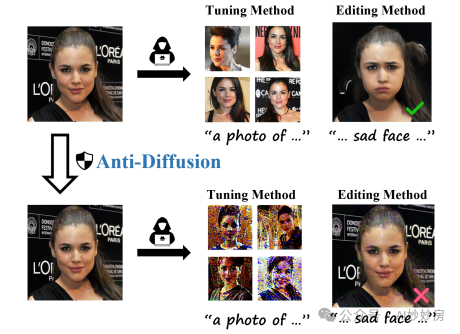
尽管基于扩散的技术在图像生成和编辑任务中取得了显著成功,但它们的滥用可能会导致严重的负面社会影响。最近,一些研究工作已被提出,旨在防范基于扩散方法的滥用。然而,在特定场景下,它们的保护可能会受到手动定义提示词或稳定扩散(Stable Diffusion,SD)版本的限制。此外,这些方法仅专注于微调方法,而忽略了同样可能构成重大威胁的编辑方法。在这项工作中,我们提出了Anti - Diffusion,这是一个为通用的基于扩散的方法设计的隐私保护系统,适用于微调和编辑技术。为了减轻手动定义提示词对防御性能的限制,我们引入了提示词微调(Prompt Tuning,PT)策略,该策略能够精确表达原始图像。为了防范微调和编辑方法,我们提出了语义干扰损失(Semantic Disturbance Loss,SDL),以破坏受保护图像的语义信息。鉴于针对编辑方法防御的研究有限,我们开发了一个名为Defense - Edit的数据集,用于评估各种方法的防御性能。实验表明,我们的Anti - Diffusion在不同场景下的各种基于扩散的技术中都实现了卓越的防御性能。
简介
文本到图像合成领域(李等人,2023年;拉梅什等人,2021年;加夫尼等人,2022年;丁等人,2021年)取得了显著进展,这主要得益于扩散模型(霍、贾因和阿比尔,2020年;宋、孟和埃尔蒙,2020年)。许多扩散模型已证明其能够生成质量卓越的图像,如稳定扩散模型(SD,龙巴赫等人,2022年;杨等人,2023年)、像素艺术模型(陈等人,2023年、2024年)。基于这些扩散模型,还提出了一些可控生成方法(控制网络(Control-Net,张、饶和阿格拉瓦拉,2023年)、文本到图像适配器(T2I-Adapter,牟等人,2023年))和个性化方法(梦境展位(DreamBooth,鲁伊斯等人,2023年)、低秩自适应(LoRA,胡等人,2021年)、文本反转(Textual Inversion,加尔等人,2022年))。随着文本到图像技术的快速发展,许多行业专业人士甚至普通用户都可以根据自己的想法创作图像或训练个性化模型。
预备知识
稳定扩散模型(Stable Diffusion)
稳定扩散模型是一种在大规模数据上进行训练的潜在扩散模型(Latent Diffusion Model,LDM)。潜在扩散模型是一种能够从高斯噪声中合成高质量图像的生成模型。与传统的扩散模型不同,潜在扩散模型的扩散过程发生在潜在空间中。因此,除了扩散模型之外,还需要一个由编码器 和解码器 组成的自动编码器。对于一幅图像 和编码器 ,扩散过程会向编码后的潜在变量 中引入噪声,从而得到一个含噪的潜在变量 ,且噪声水平会随着时间步长 增加。随后,训练一个 U 型网络(UNet),使其在给定文本嵌入指令 的情况下,预测添加到含噪潜在变量 中的噪声。潜在扩散的具体损失函数如下:
表1:不同提示下DreamBooth模型的防御性能。c1(“一个sks人的照片”),c2(“一个sks人的数码单反肖像”)。

交叉注意力机制
注意力机制允许模型在处理一个序列时参考另一个相关序列。它是扩散模型的重要组成部分,在去噪过程中引入条件信息,从而指导生成图像。许多编辑方法,如MasaCtrl和DiffEdit,也使用注意力机制来编辑图像。扩散模型中的交叉注意力可以表示为:
其中和 。这里表示实现的UNet的表示,用于确保softmax层的归一化输入,表示一个可学习的权重矩阵。
方法
在这项工作中,我们旨在通过添加对抗性噪声来保护图像。我们首先详细定义了这个问题。随后,我们介绍了反扩散(Anti-Diffusion)的整体框架,该框架主要包括三个迭代优化阶段。第一阶段涉及预训练(PT),第二阶段专注于对抗性噪声的优化,从而生成对抗性样本。最后阶段则是用这些对抗性样本更新U型网络(UNet)。
1. 问题定义
回顾一下,我们的目标是防止基于扩散的图像生成模型被恶意用于处理私有图像,为此,我们通过向这些图像添加对抗性噪声来实现这一目标。这种对抗性噪声会破坏恶意模型的功能,同时将对图像的视觉影响降至最低。设表示需要保护的图像。添加对抗性噪声后,得到受保护的图像。对抗性噪声的优化可以描述为一个极小 - 极大优化问题。极小化模拟了恶意用户试图克服添加到受保护图像中的对抗性噪声的行为。极大化则旨在在受保护图像的最大扰动约束下,通过添加对抗性噪声来降低恶意模型的性能。这个极小 - 极大问题可以描述为:

图2:jth轮次下反扩散的总体框架。这里xj表示待保护的图像。在阶段(1),文本嵌入fj将与LLDM 进行微调。随后,在阶段(2),将使用投影梯度下降法(PGD)结合我们提出的损失函数LURL和LSDL对对抗噪声进行优化并添加到xj中,以获得对抗样本x^j。在阶段(3),将使用对抗样本x^j和文本嵌入f^j对LUNet 更新UNet网络,以模拟恶意用户的调优过程。这个过程循环重复,在下一轮次回到阶段(1)。
其中 控制对抗噪声 的 范数扰动幅度,是在修改后的图像上训练的该生成模型的损失函数。 衡量基于扩散的生成模型 生成的图像、输入图像和目标提示之间的特征差异。 是输入提示的文本嵌入。我们通过最大化目标函数 来生成对抗噪声。然后,我们按照稳定扩散(Stable Diffusion,SD)的原始训练过程优化模型 以最小化该函数。
总体框架
为了解决最小 - 最大问题,我们需要在多个轮次(epoch)上进行交替优化。在每个轮次中,我们将此优化过程分为三个阶段:(1)提示调优(prompt tuning),(2)对抗性噪声优化,以及(3)UNet更新,如图2所示。具体而言,阶段2对应于的最大化,而阶段3对应于P.1的最小化。鉴于准确的文本嵌入对于至关重要,我们在每个轮次开始时加入阶段1来训练文本嵌入。
图2展示了在轮次下的优化路径。在轮次中,首先将和输入到阶段提示调优(stage prompt tuning)中。此时,图像编码器和UNet的参数是固定的。我们仅对进行优化,以获得与输入图像的语义信息相对应的更好的。随后,将和优化后的纳入对抗噪声优化阶段。在这个阶段,利用带有损失函数和的投影梯度下降(PGD,Projected Gradient Descent)算法不断优化。将对抗样本和输入到下一个UNet更新阶段,以促进UNet参数的更新。在轮次之后,更新后的和将作为和。请注意,在第一阶段,图像用干净图像初始化,文本嵌入是空提示的嵌入。经过轮次后,我们得到最终的受保护图像。
1. 提示调优策略
由于无法预测恶意用户会使用哪些提示来训练他们的模型,反数据库(Anti - DB)很难手动定义一个能在不同指标上提供最佳保护的提示。因此,我们提出了PT策略来解决这个问题。如图2(1)所示,我们在每个训练周期内迭代优化,以获得与相对应的更准确表示。最初,图像经过图像编码器处理后,与噪声图相结合,生成带噪隐变量。然后将这个带噪隐变量输入到U型网络(UNet)中,在其中通过交叉注意力机制与进行交互。我们使用潜在扩散模型的损失函数来优化,以得到。图像编码器和U型网络(UNet)的参数是固定的。通过不断优化文本嵌入,模型可以预测出正确的噪声;期望的语义能逐渐与图像的特征内容对齐。
2. 对抗性噪声优化
根据问题定义中函数 P.1 的最大化要求,我们采用投影梯度下降(PGD)算法(马德里等人,2018 年)来优化对抗性噪声。选择 PGD 算法是因为它方便且高效。我们引入 LURL 和 LSDL 作为 PGD 的损失函数,以干扰稳定扩散(SD)的训练过程并扰乱受保护图像的语义信息。
PGD 优化 PGD 算法用于优化添加到图像中的对抗性噪声。使用两个设计好的损失函数 LURL 和 LSDL,代价函数如下:
(4)C=LURL(x,f^j,ϵθ,E)+LSDL(x,f^j,Mtarget ,ϵθ,E),
用 p 表示当前 PGD 的迭代次数,基于代价方程 C 对当前 xp 的梯度可以计算为:
(5)gp=∇xpC(xp,f^j,Mtarget ,ϵθ,E),
因此,带有对抗性噪声的更新后图像 xp+1 可以按如下方式计算:
(6)xp+1=∏S(xp−|α|⋅sign(gp)),
其中 S={xp∣D(xp,xp+1)≤ϵ} 和 α 表示步长。在进行完投影梯度下降(PGD)攻击的所有迭代后,对抗样本 x^j 由干净图像 x 更新得到,或者从前一时期的对抗样本 x^j−1 更新得到。
UNet 反向损失扩散模型通过从 zt 预测噪声来生成或编辑图像,或者通过从采样的 zt 预测添加的噪声 ϵ 来学习目标的分布。为了干扰模型 ϵθ 对噪声的预测,UNet 反向损失设计如下:
(7)LURL:=Ez∼E(x),f^j,ϵ∼N(0,1),t[−‖ϵ−ϵθ(t,zt,f^j)‖22]
语义干扰损失 如图3所示,交叉注意力图表示图像相关区域与标记之间的相似度。我们设计了语义干扰损失(Semantic Disturbance Loss,SDL)来干扰受保护图像的原始语义信息,使编辑方法对受保护图像无效。LSDL的设计如下:
(8)LSDL:=Ez∼E(x),f^j,ϵ∼N(0,1),t[‖Mtarget −M(ϵθ,t,zt,f^j)‖22],
其中Mtarget 是目标注意力图。在我们的实验中,我们将其设置为与M大小相同的零矩阵。

图3:LSDL工作原理的可视化结果。编辑方法为DiffEdit。
3. UNetUpdate
在问题定义中对函数P.1进行最小化处理后,我们对UNet模型(通用卷积神经网络模型)进行优化,以模拟恶意用户的行为,用于训练他们基于调优的方法。此优化使用LUNet 进行,以进一步提高所提出方法针对这些基于调优方法的防御性能。与LLDM的损失函数类似,我们基于以下损失,使用对抗样本x^j和文本嵌入f^j对UNet ϵθ进行优化:
(9)LUNet :=Ez∼E(x^j),f^j,ϵ∼N(0,1),t[‖ϵ−ϵθ(t,zt,f^j)‖22]
编辑方法基准测试
现有的针对扩散模型防御的研究主要集中在诸如DreamBooth和LoRA等个性化扩散模型上,而忽略了基于扩散的图像编辑方法,如MasaCtrl和DiffEdit。基于扩散的编辑方法在社区中被广泛使用,与个性化调优模型一样引发了隐私保护方面的担忧。因此,我们收集了一个名为Defense - Edit的数据集,以额外评估针对基于扩散的编辑方法的防御性能。Defense - Edit数据集总共包含50对图像和提示,其中30对来自CelebA - HQ、VGGFace2、TEdBench(卡瓦尔等人,2023年),20对由StableDiffusion(SD)生成。关于Defense - Edit的更多详细信息可在补充材料中找到。
表2:不同方法在DreamBooth模型上的防御性能比较。DreamBooth中采用的推理提示为“一张sks人的照片”。每个指标下表现最佳的防御方法用粗体标记。

表3:不同方法在VGGFace2数据集上对LoRA模型的防御性能比较。LoRA中采用的推理提示为“一张sks人的照片”。

实验
1. 实现细节
数据集。为了训练DreamBooth/LoRA模型,我们遵循Anti - DB的数据集使用方式。具体来说,我们使用从VGGFace2(曹等人,2018年)和CelebA - HQ(卡拉斯等人,2017年)数据集中收集的100个唯一标识符(ID)进行实验。对于MasaCtrl/DiffEdit方法,我们基于自己收集的Defense - Edit数据集进行实验。
评估指标。为了衡量在DreamBooth和LoRA模型上的防御性能,与Anti - DB一样,我们也采用以下四个指标:盲/无参考图像空间质量评估器(BRISQUE)(米塔尔(Mittal)、穆尔西(Moorthy)和博维克(Bovik),2012年)、结构熵率全参考图像质量评估器(SER - FQA)(特尔霍斯特(Terhorst)等人,2020年)、特征域保真度率(FDFR)(邓(Deng)等人,2020年)和图像结构度量(ISM)(邓(Deng)等人,2019年)。我们进一步引入了两个额外的图像质量评估(IQA)指标,弗雷歇初始距离(FID)(霍塞尔(Heusel)等人,2017年)和自然图像质量评估器(NIQE)(米塔尔(Mittal)、桑达拉拉扬(Soundararajan)和博维克(Bovik),2012年)。此外,为了衡量添加对抗性噪声对原始图像视觉质量造成的退化,我们采用峰值信噪比(PSNR)指标(科尔霍宁(Korhonen)和尤(You),2012年)。CLIP分数衡量特定图像与其目标文本描述之间的对齐程度。在我们对MasaCtrl和DiffEdit等编辑方法的评估中,CLIP分数(赫塞尔(Hessel)等人,2021年)由编辑后的图像和目标提示计算得出。BRISQUE也用于衡量编辑后图像的质量。在我们的实验中,我们的目标是获得较低的CLIP分数和较高的BRISQUE分数。
2. 与最先进方法的比较
我们将反扩散(Anti-Diffusion)方法与最先进的防御方法进行比较,即照片防护(Photo Guard,萨尔曼等人,2023年)、MIST(梁等人,2023年)、反数据库(Anti-DB)和PID(李等人,2024年)。为确保公平比较,我们遵循反数据库(Anti-DB)的做法,为所有这些方法采用的噪声预算。在评估过程中,对于每个经过训练的梦境展位(Dream-Booth)/低秩自适应(LoRA)模型,我们在5种不同的随机种子下生成16张图像,总共生成80张图像,以评估相应的结果,从而消除与单个随机种子相关的可变性。对于像MasaCtrl/DiffEdit这样不可训练的基于扩散的图像编辑方法,我们根据我们的防御编辑(Defense-Edit)数据集评估其防御性能。
DreamBooth/LoRA对比。DreamBooth模型的量化结果如表2所示。可以观察到,当使用各种方法向干净图像中引入噪声时,DreamBooth的个性化效果在一定程度上会受到干扰。在这些方法中,由反扩散(Anti-Diffusion)保护的图像在视觉上更接近原始图像,这可以从最高的峰值信噪比(PSNR)指标看出。此外,反扩散(Anti-Diffusion)对DreamBooth实现了最佳的防御性能。它使DreamBooth生成更多无意义的图像(最高的虚假检测率(FDFR)值和最低的结构误差率 - 全参考质量评估(SER-FQA)值),并干扰了DreamBooth学习图像身份标识(ID)的能力(最低的图像相似度度量(ISM)值)。此外,当使用由反扩散(Anti-Diffusion)保护的图像训练DreamBooth时,它倾向于生成质量最低的图像(最高的盲/无参考图像空间质量评估器(BRISQUE)、弗雷歇 inception 距离(FID)和自然图像质量评估(NIQE)值)。总之,对于VGGFace2和CelebA - HQ上的人脸身份标识,反扩散(Anti-Diffusion)提供了卓越的防御性能。图4中的定性结果进一步支持了这一结论。虽然像照片卫士(Photo Guard)、MIST、PID和反DreamBooth(Anti - DB)等方法通过降低生成图像的视觉质量提供了一定程度的保护,但反扩散(Anti-Diffusion)显著降低了受干扰的DreamBooth模型生成的图像质量,并且还干扰了它们的身份标识。如表3所示,我们还展示了不同方法对低秩自适应(LoRA)的量化防御结果。反扩散(Anti-Diffusion)在所有指标上都取得了最佳结果。这有效地证明了反扩散(Anti-Diffusion)对不同微调方法具有良好的泛化能力。

图4:不同方法在DreamBooth模型上的定性防御结果。DreamBooth中采用的具体提示词是“一个sks人的照片”。实例来自VGGFace2(视觉几何组人脸数据库2)。
表4:在Defense-Edit数据集上比较针对Mas-aCtrl和DiffEdit的防御性能。“Photo”和“Anti-DF”分别表示Photo Guard(照片防护)和Anti-Diffusion(反扩散)。“BRI”和“CLI”分别是BRISQUE(盲/无参考图像空间质量评估器)和CLIP Score(对比语言-图像预训练分数)。

在MasaCtrl/DiffEdit上的比较。我们还比较了不同方法在MasaCtrl和DiffEdit上的防御性能。定量结果如表4所示,其中反扩散(Anti-Diffusion)在所有三个指标上都取得了最佳性能。具体而言,反扩散在CLIP得分上的值最低,这表明当图像受到反扩散保护时,MasaCtrl和DiffEdit都无法根据指令对其进行修改。图5中的定性结果进一步验证了这一点。具体来说,对于“狗”的图像,在不添加噪声的情况下,MasaCtrl可以成功地将其从站立姿势改为跳跃姿势。对于从照片卫士(Photo Guard)、MIST、PID和反DreamBooth(Anti-dreamBooth)获得的受保护图像,MasaCtrl仍然可以成功地对其进行编辑。只有受反扩散保护的图像才能有效阻止MasaCtrl进行编辑。在DiffEdit上也观察到了相同的现象,即反扩散可以有效阻止DiffEdit将图像中的“苹果”改为“橙子”。
3. 消融研究
表5:比较有无预训练(PT)和时Dream-Booth的防御性能。

表6:不同注意力目标下的防御性能对比。这里,“噪声”指将随机噪声图作为目标注意力图,“对角”指对角元素设为1的对角矩阵。

为验证PT(Prompt Tuning,提示调优)和SDL(Self-Distillation Learning,自蒸馏学习)的有效性,我们基于DreamBooth开展了对比实验。具体内容见表5。第一个实验是使用固定提示(即“一张人的照片”)的基线实验,未采用PT和。第二行中,我们用PT替换了固定提示。第三行中,我们在第一行的基础上添加了。第四行是同时配备PT和的最终反扩散模型。这些实验的量化结果表明,PT和在提升防御性能方面起到了互补作用。

图5:不同防御方法在MasaCtrl和DiffEdit上的定性防御结果。该实例来自我们提出的数据集Defense - Edit。
在实验中,我们使用零映射作为的目标注意力映射。由于交叉注意力表示语义相似性,零注意力映射会导致扰动图像和原始图像之间的语义不相似。我们还探索了使用随机矩阵或对角矩阵作为目标。从表6可以看出,它们在防御性能方面不如零注意力映射有效。
4. Unexpected Scenarios
在实际场景中,恶意用户对稳定扩散(Stable Diffusion,SD)模型的具体使用方式是不可预测的。因此,在本节中,我们评估了反扩散(Anti - Diffusion)在各种意外场景下的防御能力。更多意外场景的结果可在补充材料中找到。
意外版本:为了评估反扩散(Anti - Diffusion)在不同版本的稳定扩散(SD)模型中的鲁棒性,我们将其应用于VGGFace2数据集,并使用了包括v2.1和v1.5在内的各种版本的SD模型。如表7所示,即使SD模型的版本不匹配,反扩散(Anti - Diffusion)也能提供足够的保护。
表7:比较不同版本的SD(StableDiffusion,稳定扩散模型)的防御性能。术语“Def.”和“Test”分别指使用反扩散(Anti-Diffusion)进行防御的SD版本以及恶意用户用于训练DreamBooth的SD版本。

DreamBooth的意外提示词,不同的提示词可用于生成各种内容。如表8所示,我们引入了三个额外的提示词p1、p2和p3,分别是“一张sks人悲伤表情的照片”、“sks人的面部特写”和“一张sks人在演讲中打哈欠的照片”来评估性能。我们可以看到,反扩散(Anti-Diffusion)也能在各种场景中针对不同的提示词提供防御。
表8:不同提示下的防御性能比较。“P”和“Def.”分别指提示和防御。

总结
综上所述,本文提出了Anti - Diffusion(反扩散)防御系统,旨在防止图像被基于微调(tuning - based)和基于编辑(editing - based)的方法滥用。在生成受保护图像的过程中,我们采用了PT策略来提高防御性能,无需手动定义提示。此外,我们引入了SDL(语义破坏层)来扰乱受保护图像的语义信息,增强了对基于微调(tuning - based)和基于编辑(editing - based)方法的防御性能。我们还引入了Defense - Edit数据集,以评估当前防御方法对基于扩散的编辑方法的防御性能。通过大量实验表明,Anti - Diffusion在不同场景下处理各种基于扩散的技术时,防御性能表现出色。
 5872


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


