


1、提示工程VS RAG VS 微调,什么时候使用?

2、什么场景下应该选择RAG 而不是Fine-tuning?
- 知识需要频繁更新:如产品文档、FAQ,用RAG 只需更新向量库;
- 需要引用来源:如客服系统需要告诉用户答案来自哪个文档;
- 数据量有限:Fine-tuning 需要大量高质量数据,RAG 门槛更低;
- 需要实时信息:新闻、股票等实时数据无法通过训练固化到模型;
- 预算有限:RAG 的实现成本远低于微调。
三种模式不是互斥的,实际项目中常常组合使用。 比如:RAG + Fine-tuning (微调模型,让它可以更好地利用检索结果) 或者RAG + Prompt Engineering (优化检索后的提示词模板)。
3、文档分块策略有哪些?
文档分块(Chunking) 是RAG 系统的基础环节,分块质量直接影响检索效果。

4、项目中用什么分块策略?为什么选它?
如果项目知识库是产品FQA,在项目中使用滑动窗口+ 句子边界的混合策略:
- 首先按句子边界切分,保证每个块语义完整;
- 然后使用滑动窗口,设置20%重叠(window=512, step=100) ;
- 重叠确保跨块的信息不会丢失。
选择原因:
- 知识库是产品FAQ,段落之间有上下文依赖;
- 用户问题可能涉及多个连续段落的信息;
- 20%重叠在存储开销和检索质量间取得平衡;
分块大小经验值:
- 一般推荐256-1024 tokens;
- 小块: 检索精度高,但可能丢失上下文;
- 大块: 上下文完整,但噪声多,检索精度下降;
- 常见配置: chunk_size=512, overlap=50-100。
5、RAG系统的流程
RAG的步骤:
Indexing => 如何更好地把知识存起来。
Retrieval => 如何在大量的知识中,找到一小部分有用的,给到模型参考。
Generation => 如何结合用户的提问和检索到的知识,让模型生成有用的答案。
这三个步骤虽然看似简单,但在RAG应用从构建到落地实施的整个过程中,涉及较多复杂的工作内容。

6、RAG系统详细的步骤都有哪些?

关键步骤:
Step1,文档解析
将PDF、Word、HTML等格式转换为纯文本。工具: PyPDF2, docx, BeautifulSoup。注意处理表格、图片等特 殊内容。
Step2,文档分块(Chunking)
将长文档切分为适合检索的小块。需要平衡块大小、上下文完整性、检索精度。
Step3,向量化(Embedding)
使用Embedding模型将文本块转换为向量。常用模型: text-embedding-v4等。
Step4,向量存储
将向量存入向量数据库。FAISS (本地)、Milvus (分布式)、 Pinecone (云服务)。同时存储元数据用于过滤和展示。
Step5,Query 改写 (可选)
处理模糊问题、补充上下文。使用LLM改写或扩展用户问题,提高检索召回率。
Step6,向量检索
计算Query向量与文档块向量的相似度,返回Top-K结果。距离度量: 余弦相似度、L2距离、内积。
Step7,重排序(Rerank)
使用Cross-Encoder对Top-K结果精排,选出最相关的Top N。显著提升最终效果。
Step8,Prompt 构建
将检索到的文档块拼接到Prompt中,作为LLM的上下文。注意控制总长度,避免超过模型上下文窗口。
Step9,LLM 生成
LLM基于Prompt生成最终答案。可以要求模型引用来源,提高可信度。

7、Embedding模型有哪些选择?

8、Embedding模型选择都有哪些考虑因素?
语言支持
- 中文场景:BGE、text-embedding-v4
- 英文场景:OpenAI系列
- 多语言:bge-m3
部署方式
- API调用:OpenAI、通义
- 私有化部署:BGE、M3E
- 混合:都支持
性能指标
- 延迟:本地部署< API调用
- 吞吐:取决于硬件/并发
- 精度:需要在自己数据上测试
成本考量
- API按量付费,初期低
- 私有部署需GPU,长期划算
- 维度影响存储成本
9、如果RAG 效果很差,可以从哪几个方面去调试?
会按照RAG 的流程,逐步排查问题:

Step1,检索阶段调试

Step2,生成阶段调试

Step3,调试工具与方法
# 调试检索效果的方法
def debug_retrieval(query, index, metadata, k=10):
"""打印检索详情,帮助调试"""
query_vec= get_embedding(query)
distances, indices = index.search(
np.array([query_vec]).astype('float32'), k
)
print(f"Query: {query}")
print("-" * 80)
for rank, (idx, dist) in enumerate(zip(indices[0],
distances[0])):
if idx== -1:
continue
doc = metadata[idx]
similarity = 1 / (1 + dist)  # L2距离转相似度
print(f"Rank{rank+1} | 相似度: {similarity:.4f} | 距离: {dist:.4f}")
print(f"来源: {doc.get('source', 'N/A')}")
print(f"内容: {doc['text'][:100]}...")
print("-" * 40)
return indices, distances
- 先用debug_retrieval检查检索结果是否正确;
- 如果检索结果好但生成差,优化Prompt;
- 如果检索结果差,从分块/Embedding/Query改写入手;
- 记录Bad Case,建立评估数据集持续改进。
10、当用户的问题很模糊,或者依赖上一轮对话时,RAG 怎么优化?
Step1,问题类型分析

Step2,Query 改写技术

Step3,多轮对话RAG 架构

实践建议:
- 对话历史不宜过长,一般保留最近3-5轮;
- 可以用LLM判断是否需要改写,避免每次都改写;
- 改写模型可以用较小的模型,降低延迟;
- 记录改写前后的Query,便于调试。
11、只用向量检索吗?它有什么缺点?什么是混合检索?
向量检索的缺点:
- 对精确关键词匹配不敏感(如产品型号、人名) ;
- 可能漏掉字面完全匹配的内容;
- Embedding模型对领域专有词理解可能不准。
混合检索:结合向量检索和关键词检索(BM25),取长补短。


12、检索召回了20 条文档,怎么确保喂给LLM 的是最好的3条?
使用Rerank (重排序) 技术,对初步召回的结果进行精排。Rerank流程如下:

Bi-Encoder (向量检索) :Query和Document分别编码,计算向量相似度。
- 速度快,适合大规模召回;
- Query和Doc独立编码,交互信息少;
- 精度相对较低。
Cross-Encoder (Rerank) :Query和Document拼接后一起编码,直接输出相关性分数。
- 精度高,能捕捉细粒度交互;
- 速度慢,只能处理少量候选;
- 适合对Top-K精排。
Rerank 实践建议:
- 召回数量(recall_k) 一般设置为最终需要数量的5-10倍;
- Rerank模型选择:中文推荐bge-reranker,多语言用Cohere;
- Rerank会增加延迟,需要在效果和速度间权衡;
- 可以设置分数阈值,过滤低相关性结果。
13、系统上线后,怎么维护和迭代知识库?
知识库维护是一个持续的过程,包括以下几个方面:

14、维护知识库能否通过Agent RL
Agent RL的核心思路:让Agent从环境反馈中学习改进策略。 关键是定义好:状态、动作、奖励。

对于企业场景,推荐方案A + 选择性微调的组合。
维护最佳实践:
- 定期审核:每周/月审核Bad Case,识别系统性问题;
- 增量更新:避免全量重建,使用增量方式更新索引;
- 版本控制:保留历史版本索引,支持快速回滚;
- 文档生命周期:设置过期时间,自动标记/清理过期内容;
- 监控告警:检索空结果率、用户负反馈率等指标超阈值时告警。
15、如何评估一个RAG 系统的好坏?
RAG系统的评估需要从检索质量和生成质量两个维度进行:


16、什么是RAGAS?
RAGAS (Retrieval Augmented Generation Assessment) 是一个专门用于评估 RAG 系统的开源框架,由Exploding Gradients 团队开发。
核心特点:
- 无需人工标注: 使用LLM 自动评估,大幅降低评估成本;
- 端到端评估: 同时评估检索质量和生成质量;
- 指标全面: 提供Faithfulness、Answer Relevancy、Context Precision 等核心指标;
- 易于集成: 与LangChain、LlamaIndex 等主流框架无缝对接。
安装: pip install ragas
GitHub: https://github.com/explodinggradients/ragas
生成质量指标(RAGAS框架)
- Faithfulness (忠实度)
答案是否基于检索到的内容,而非幻觉。评估方法: 用LLM判断答案中的每个声明是否能在上下文中找到支撑。
- Answer Relevance (答案相关性)
答案是否回答了用户的问题。评估方法: 用LLM根据答案反向生成问题,与原问题比较相似度。
- Context Relevance (上下文相关性)
检索到的内容是否与问题相关。评估方法: 计算上下文中与问题相关的句子比例。
- Context Recall (上下文召回)
检索是否召回了回答问题所需的所有信息。评估方法: 对比标准答案,检查所需信息是否被检索到。
评估建议:
- 构建包含50-100个样本的评估集,覆盖各类问题;
- 定期运行评估,监控系统质量变化;
- 重点关注Faithfulness,这是RAG的核心价值;
- 结合定量指标和人工抽检。
17、什么是GraphRAG,与传统RAG的区别?
GraphRAG 是微软提出的增强型RAG架构,通过构建知识图谱来增强检索和推理能力。


GraphRAG 使用建议:
- 构建成本高,适合高价值、复杂的知识库;
- 对于简单FAQ,传统RAG已足够;
- 可以与传统RAG结合: 简单问题用传统RAG,复杂问题用GraphRAG。
18、GraphRAG 中的核心概念都是什么?
Entity (实体):从文档中抽取的关键对象。例: 人名、地名、产品名、概念;
Relationship (关系):实体之间的联系。例: “属于”、“制造”、“位于”;
Community (社区):图中紧密相连的实体群组,通过社区检测算法发现;
Community Summary:每个社区的LLM生成摘要,用于回答全局性问题。
19、GraphRAG 中的两种查询模式都是什么?
- Local Search (局部搜索)
适合:“XXX公司的CEO是谁?” 这类精确问题。
流程:Query -> 找到相关实体-> 沿关系扩展-> 收集上下文-> 生成答案。
- Global Search (全局搜索)
适合:“这篇文档的主要观点是什么?” 这类总结性问题。
流程:Query -> 遍历社区摘要-> Map-Reduce聚合-> 生成综合答案。
20、RAG 和Fine-tuning 怎么选?
选RAG:知识更新频繁、需要引用来源、数据量小、预算有限。
选Fine-tuning:需要改变模型风格/格式、领域术语复杂、追求推理速度。
组合使用:先微调让模型更好地遵循检索结果,再用RAG注入知识。
21、如何处理知识库中的矛盾信息?
- 为文档添加时间戳元数据,优先使用最新的;
- 为文档添加权威度标签,优先使用官方来源;
- 检索时同时返回多个来源,让LLM综合判断;
- 在Prompt中要求LLM指出信息冲突。
22、RAG 系统的延迟优化有哪些方法?
- 向量检索:使用ANN索引(HNSW, IVF),降低精确度换速度;
- Embedding:使用本地小模型,或异步预计算;
- Rerank:减少候选数量,或使用蒸馏小模型;
- LLM:使用流式输出,选择更快的模型;
- 缓存:相似Query复用检索结果。
23、如何处理超长文档?
- 分层索引:先检索摘要,再检索详细段落;
- 滑动窗口:保留上下文的分块策略;
- 长上下文模型:使用支持128K+的模型(如Qwen, Claude);
- 迭代检索:先检索一部分,根据LLM判断是否需要更多,
24、如何防止LLM幻觉?
- Prompt 明确指令:“仅基于提供的信息回答,不确定时说不知道”;
- 要求引用:让LLM标注答案来源于哪个文档;
- 降低temperature:减少随机性;
- 答案验证:用另一个LLM检查答案是否有上下文支撑;
- Rerank 精选:确保上下文高度相关;
25、多模态RAG 怎么做?
- 图片:使用多模态Embedding模型(如CLIP, 通义VL) 将图片向量化;
- 表格:转换为Markdown或JSON,保持结构信息;
- PDF:OCR提取文字+ 图表单独处理;
- 视频:抽帧+ 语音转文字,分别建索引;
- 统一使用多模态Embedding,实现跨模态检索。
26、如何保证RAG 系统的安全性?
- Prompt 注入防护:过滤用户输入中的指令;
- 权限控制:根据用户角色过滤可检索的文档;
- 敏感信息处理:脱敏后入库,或标记敏感级别;
- 输出过滤:检查生成内容是否包含敏感信息;
- 审计日志:记录所有查询和检索内容。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
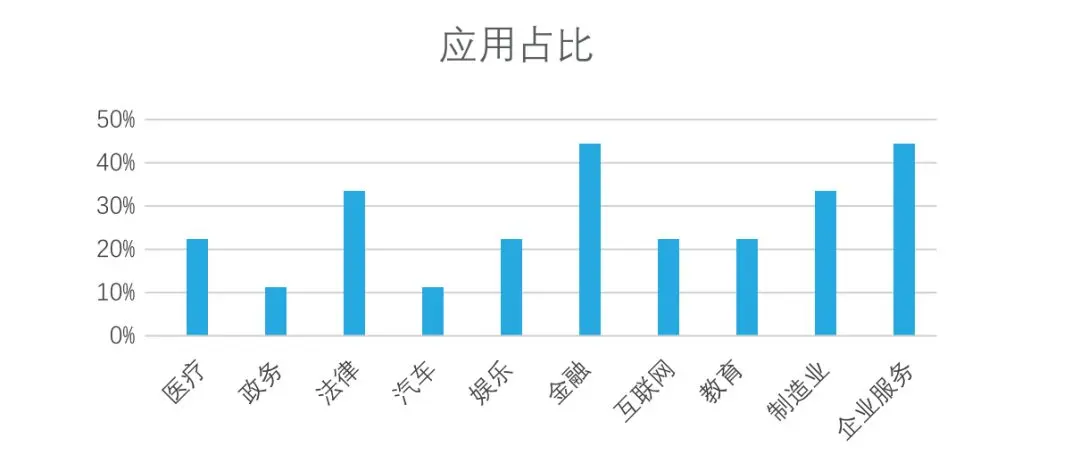
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
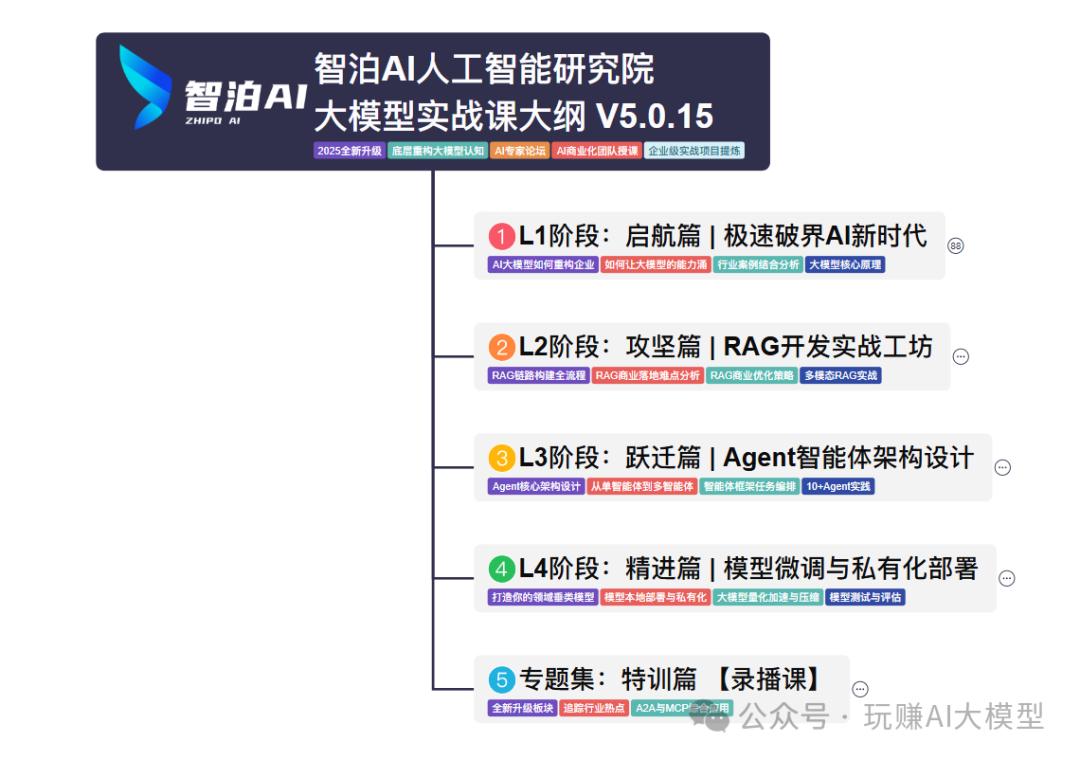
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


