


我们是不是都踩过同一个坑:花数周搭建的RAG系统,上线后用户反馈“答非所问”“信息造假”;调整了chunk大小、换了向量模型,却说不清效果提升了多少;生产环境幻觉率忽高忽低,却找不到问题根源。这些问题的关键,是缺少那种有系统、能实施的RAG评估体系。
RAG的效果从来不是靠“感觉”判断的,而是靠“数据”量化的。从指标体系、工具挑选、落地流程、问题排查这四个维度,本文结合一线实战经验,一步步教你搭建RAG评估闭环,内容都经过生产环境验证,读者能够直接应用到"ragflow"、“LangChain”、"LlamaIndex"等主流框架项目里面。
核心认知:RAG评估,绝不能只看最终答案
RAG是“检索+生成”的双模块系统,评估的核心逻辑是“模块拆解+指标量化+端到端验证”,而非单纯看LLM生成的答案好不好。
很多开发者用“人工看几个案例”判断效果,这种方式有三个致命问题:主观性强、覆盖面窄、无法定位问题。比如看到“答案错误”,你根本分不清是“检索漏了关键信息”还是“LLM生成幻觉”。
真正的RAG评估,必须拆解到每个环节
- 检索层:判断“有没有找到正确信息”,核心是召回率和精确率;
- 生成层:判断“有没有用找到的信息正确回答”,核心是忠实度和相关性;
- 端到端:判断“整体是否解决用户问题”,核心是幻觉率和问题解决率;
业务层面来看,判断“是不是创造了实际价值”,关键所在就是人工转接率以及用户满意度。像调试程序那样精准找到问题,有针对性地优化,只有这样才可以科学的判断RAG的效果。
指标体系:4大维度12个核心指标,直接套用
一套完整的RAG评估指标体系,要兼顾技术可行性和业务价值。下面这些指标,带着计算方式、通用阈值还有优化方向,是经过生产环境验证的“黄金指标集”,可直接复制到你项目里。
2.1 检索层指标:找对信息,决定了答案的基础
检索是RAG的“地基”,地基不稳,生成再优秀也会出问题。这一层核心看“找全”和“找准”。
| 指标 | 核心定义 | 计算方式(没标准答案的版本) | 通用阈值 | 低分情况优化方向 |
|---|---|---|---|---|
| ContextRecall(上下文召回率) | 检索上下文包含问题关键信息的比例 | RAGAS用LLM提取问题关键信息点,计算“包含数总数” | ≥0.75 | 1.调大检索topk;2.优化chunk策略(拆分更小、保留上下文);3.更换更优embedding模型;4.启用混合检索(关键词+向量) |
| ContextPrecision(上下文精确率) | 检索上下文中相关内容的占比 | RAGAS用LLM判断每个片段相关性,计算“相关数总数” | ≥0.80 | 1.调小检索topk;2.提高向量库相似度阈值;3.对检索结果二次过滤(关键词匹配) |
| MRR(平均倒数排名) | 就是正确信息出现在检索结果前几位的概率 | 计算“1正确信息最高排名”的平均值 | 要是≥0.70 | 1.优化检索排序算法;2.对embedding模型微调适配业务场景 |
2.2 生成层指标:用好信息,决定了答案的质量
生成层的核心是“不编造”与“答对点”,是在检索到正确信息之后,且这一层直接关乎用户信任度。
| 指标 | 核心定义 | 计算方式(没有标准答案的那个版本) | 普遍适用的阈值 | 低分数要优化的方向 |
|---|---|---|---|---|
| Faithfulness(忠实度) | 答案陈述是否能在上下文中找到依据(防幻觉) | RAGAS逐句检查答案,计算“有依据陈述数总数” | ≥0.80 | 1.优化prompt,强制LLM仅基于上下文回答;2.降低LLM的temperature;3.更换更严谨的LLM(如GPT-4、Claude3) |
| AnswerRelevance(答案相关性) | 答案是否解决用户核心诉求 | RAGAS从“相关性、完整性、简洁性”三维度打分 | ≥0.80 | 1.优化prompt,明确回答要求,像“针对核心问题,简洁作答”;2.对生成结果进行处理,把无关内容删掉 |
| AnswerCorrectness(答案正确性) | 答案与真实答案的匹配度 | 有标准答案用EMF1,无标准答案用LLM综合打分 | ≥0.75 | 先优化检索召回率,再优化生成忠实度 |
2.3 端到端指标:整体好不好用,衔接技术与业务
端到端指标是对检索和生成的综合验证,是判断RAG系统是否“可用”的关键。
| 指标 | "它"的核心定义 | 计算的办法 | 平常的阈值 | 优化的方向 |
|---|---|---|---|---|
| 幻觉率 | 答案中无依据陈述的占比 | 1-Faithfulness | ≤0.05 | 优先优化Faithfulness,其次优化检索召回率 |
| 响应一致性 | 相同问题多次回答的语义相似度 | 计算多次生成答案的BERTScore均值 | ≥0.90 | 1.固定prompt和生成参数;2.降低LLM随机性 |
| 问题解决率 | 不用人工转接的问题所占的比例 | 自动解决问题的数量和总问题数量的比例 | ≥0.80 | 全面优化所有技术方面的指标,重点解决高频未解决的问题 |
| 平均响应时间 | 从提问到生成答案的总耗时 | 统计多次请求的平均耗时 | ≤2 | 1.优化向量库索引;2.减少检索topk;3.使用更快的LLM (如 Groq) |
2.4 业务层指标:有没有价值,决定了系统的生死
技术指标最终要服务于业务,这一层是向业务方汇报的核心依据。
| 指标 | 核心定义 | 计算方式 | 业务目标 | 优化方向 |
|---|---|---|---|---|
| 人工转接率 | 转人工处理的请求占比 | 转人工数总请求数 | ≤10% | 提升问题解决率,优化长尾问题处理能力 |
| 用户满意 | 用户对答案的满意程度 | 它通过问卷调查(1-5分)或者用户反馈 | ≥4分(5分制) | 提升答案相关性与正确性,优化语言表达 |
| 成本效益比 | 业务收益和投入成本的比例 | (人工成本节约加上效率提升)除以(开发、算力和维护成本) | ≥3:1 | 1.用本地大语言模型来降低算力成本;2.提高自动化解决的比率 |
指标使用原则:
- 阶段化聚焦:在原型阶段,就看看检索召回率、忠实度还有相关性;到了生产阶段就瞅瞅幻觉率和人工转接率;
- 阈值定制化:在核心场景(金融医疗)里把阈值调高,而通用问答倒是可以适当地放宽一点儿;
- 数据驱动:所有指标都要量化,不要用那种“感觉还挺好”的模糊判断。
工具选型:按项目阶段选择,效率提升10倍
选合适的评估工具,能让RAG评估从“繁琐耗时”变成“简单又高效”。结合项目阶段和规模,把工具分成开源轻量型、开源深度型、商用企业型,每类工具都附上实战集成代码,能直接拿来用。
3.1 首选工具:RAGAS(全阶段可用,集成成本低)

核心定位:RAG领域事实上的标准评估框架,GitHub5000+星标,月均PyPI下载10万+,是ragflow、LangChain的官方推荐工具,无参考评估能力是其核心优势。
适用场景: 就是原型验证、迭代优化、自动化测试还有中小规模生产监控。
核心优势:不用标注标准答案,就只要“问题+上下文+答案”三元组就能评估,能降低80%的评估成本;指标全都涵盖了,集成起来比较简单,还支持本地LLM部署来满足数据隐私方面的要求。
实战集成(以ragflow为例)
# 1. 安装依赖pip install ragflow ragas datasets openai# 2. 初始化ragflow客户端from ragflow import RagFlowClientrf_client = RagFlowClient( api_key="your_api_key", base_url="http://localhost:8100")KB_ID = "your_knowledge_base_id"# 3. 构造测试数据(真实业务问题)TEST_QUESTIONS = [ "ragflow支持哪些文档格式?", "如何优化ragflow的检索召回率?"]eval_data = []for question in TEST_QUESTIONS: # 检索上下文 retrieve_res = rf_client.retrieve(query=question, kb_id=KB_ID, top_k=5) contexts = [doc["content"] for doc in retrieve_res["documents"]] # 生成答案 generate_res = rf_client.generate(query=question, kb_id=KB_ID, contexts=contexts) answer = generate_res["answer"] # 组装评估数据 eval_data.append({"question": question, "contexts": contexts, "answer": answer})# 4. RAGAS评估from ragas import evaluatefrom ragas.metrics import context_recall, faithfulness, answer_relevancefrom datasets import Datasetimport osos.environ["OPENAI_API_KEY"] = "your_openai_key"dataset = Dataset.from_list(eval_data)result = evaluate( dataset=dataset, metrics=[context_recall, faithfulness, answer_relevance], raise_exceptions=False# 输出详细判断理由)# 5. 分析结果print("整体评估结果:", result)df = result.to_pandas()print("详细结果:\n", df[["question", "context_recall", "faithfulness"]])# 导出报告df.to_csv("ragflow_evaluation_report.csv", index=False)
要是涉及到数据隐私的话,把OpenAI换成Llama3、Qwen这类本地LLM就可以,仅仅是改改RAGAS的LLM配置罢了,核心评估逻辑依旧是相同的。
3.2 深度诊断:TruLens(调优阶段必备)
核心定位: 就是一个深度诊断型的开源框架,专门搞RAG全链路追踪还有根因分析,还和LangSmith、MLflow生态整合在一起。
适用场景: 就是迭代优化、版本AB测试、复杂RAG架构诊断。
核心优势: 全链路去追踪每一步的输入和输出,借此能精准找到问题的根源,像“召回率低导致答案错误”这类情况便是例证;并且还能提供可视化的仪表盘,以支持模块级的评估。
集成思路:将ragflow的检索+生成流程封装为TruLens可监控的流水线,定义评估指标后,通过仪表盘分析根因,代码可参考前文RAGAS集成基础上,增加TruLens的反馈函数和流水线包装即可。
3.3 工程化测试:DeepEval(测试发布阶段)
核心定位: 就是单元测试式的开源框架,和pytest深度融合,把RAG评估放到CICD流程里。
适用场景: 就是版本发布前拿来验证、持续集成还有合规性检查。
核心优势: 用pytest语法来写评估用例,并且还能够支持自定义断言,像“答案必须包含某关键词”就是一个例子,而且还能无缝接入GitHubActions或者GitLabCI。
实战用例
# test_ragflow.pyfrom deepeval import assert_testfrom deepeval.test_case import LLMTestCasefrom deepeval.metrics import FaithfulnessMetric, AnswerRelevanceMetricfrom ragflow import RagFlowClientrf_client = RagFlowClient(api_key="your_key", base_url="http://localhost:8100")KB_ID = "your_kb_id"defget_ragflow_result(question): retrieve_res = rf_client.retrieve(query=question, kb_id=KB_ID, top_k=5) contexts = [doc["content"] for doc in retrieve_res["documents"]] answer = rf_client.generate(query=question, kb_id=KB_ID, contexts=contexts)["answer"] return answer, contexts# 测试用例deftest_ragflow_faithfulness(): question = "ragflow支持哪些向量库?" answer, contexts = get_ragflow_result(question) test_case = LLMTestCase(input=question, actual_output=answer, retrieval_context=contexts) # 评估指标 faithfulness_metric = FaithfulnessMetric(min_score=0.8) relevance_metric = AnswerRelevanceMetric(min_score=0.8) assert_test(test_case, [faithfulness_metric, relevance_metric])# 运行:pytest test_ragflow.py -v
3.4 商用工具:LangSmith/TruEra(大规模生产)
当RAG系统到了大规模生产的时候,开源工具就不能满足团队协作、实时监控、合规保障这些需求,这时候可以考虑用商用工具:
-
LangSmith:和LangChain/ragflow深度整合,全程链路追踪、生产流量分析、团队一起协作,整合成本比较低;
-
TruEra:企业级AI质量监控平台,支持大规模测试、实时告警、合规性保障,适合金融医疗等高合规场景;
-
Vectara:一个托管式的RAG平台,有现成能用的评估工具链,不用自己搭建基础设施。
3.5 工具选型决策树
- 原型验证→RAGAS
- 迭代调优→RAGAS+TruLens;
- 测试发布→RAGAS+DeepEval;
- 生产监控→RAGAS+LangSmith/ArizePhoenix;
- 企业级落地→TruEra/Vectara。
落地全流程:形成评估闭环的5个步骤,不断优化
掌握了指标和工具之后,最关键的就是把评估融入到RAG项目的整个生命周期里,形成“评估→优化→再评估”的闭环。下面这5步流程都有具体的操作方法和交付物,能直接套用。
步骤1:构建测试集,这可是评估的基础,得真实又全面
测试集质量决定评估可不可信,核心要求是真实(来自用户日志)、全面(覆盖核心、边缘还有易错的场景)、能复用(固化成文件),规模建议原型阶段有50到100个问题,生产阶段是200到500个。
构建方法就是从用户日志里提取高频问题,再加上业务方访谈收集核心问题,接下来用工具合成边缘问题,最后输出个标准化的CSV文件,里面有questionid、question、scene、priority这些字段。
步骤2:基线测试,也就是确定最初的水平,并且弄清楚优化方向
- 用RAGAS跑测试集,得到各指标基线分数;
- 结合行业里的标准和业务上的需求,设定个“及格线”和“优秀线;
- 按低分数指标分类问题,如“召回率低”“忠实度低”;
- 按照“问题出现的频率加上业务方面受到的影响”来排序确定优化的优先级。
交付物:基线评估报告,里面有整体分数、问题分类、优化优先级、阈值设定。
步骤3:迭代优化——数据驱动,精准调优
核心原则:单一变量(每次只改一个配置)、小步快跑(优化后立即评估)、重点突破(先解决高优先级易优化问题)。
常见的优化方向已然列于指标体系之中,比如说“召回率低”便把topk调大、优化chunk策略;“幻觉多”那就优化prompt、降低LLM温度。每一次优化完之后,用同样的测试集来做评估,要是效果好就保留下来,要是效果不好就退回原来的状态。
交付物:迭代优化报告,这里面有优化的内容、指标对比还有问题解决的情况。
步骤4:自动化测试——把自动化测试融入到CICD里,保证版本质量
- 用DeepEval来编写pytest评估用例,把核心场景固定下来;
- 接入GitHubActions/GitLabCI,每次代码提交自动运行评估;
- 设定指标门禁,像“核心指标平均分不低于基线的90%”,要是没通过就不让发布;
- 自动生成测试报告,及时同步团队
步骤5:生产监控——实时看着,尽快发现问题
- 核心监控的指标,就是幻觉率、召回率、人工转接率、响应时间;
- 工具选择:开源用RAGAS+ArizePhoenix,商用用LangSmith/TruEra;
- 操作方法:在RAG系统关键节点埋点,采集“问题-上下文-答案-指标”数据,接入监控工具配置可视化面板;
- 告警规则:像“幻觉率超过0.1”“人工转接率超过15%”的时候就会触发告警,每周或者每月复盘指标的趋势。
闭环形成:测试集构建→基线测试→迭代优化→自动化测试→生产监控,循环往复,让 RAG 效果持续提升。
避坑指南:实战中最常见的10个问题与解决方案
- RAGAS分数波动大:扩大测试集(≥50个问题)、将裁判LLM温度设为0、多次评估取平均值;
- 评估结果和人工判断不一样:随机抽样人工验证(准确率达到80%就可以)、微调裁判LLM、多种工具交叉验证;
- 大规模评估耗时成本高:分批评估、用本地LLM、抽样评估(20%样本)、开启多线程;
- 指标达标但用户反馈差:补充真实用户问题到测试集、增加用户体验指标(简洁性自然度)、开展用户调研;
- ragflow集成接口失败:核对一下API文档里的参数、加上数据格式校验还有重试机制、加入官方社区去获取支持;
- 多模态RAG评估难:用RAGAS多模态功能、自定义图片表格评估指标、结合人工评估;
- 本地LLM评估准确性比较低:可以考虑选择更大的模型(Llama3-70B)、对本地LLM进行微调、采用“本地初筛+商用精评”来平衡成本;
- 向业务方汇报难:将技术指标转业务指标(如“幻觉率降5%,人工成本省10万”)、用案例对比展示效果、制作可视化报告;
- 知识库更新之后要快速评估:得去构建更新相关的测试集、配置自动化评估任务,还要重点关注召回率和正确性;
- 效果和性能跟成本之间的平衡:建立权重模型、用量化或者缓存来优化性能、分不同场景施策(核心场景保证效果,非核心的就保证成本。
总结
“数据驱动,持续迭代”是RAG评估的核心。没有评估的RAG系统,就好比没有仪表盘的汽车,完全不晓得自身处在什么样的状况。
本文里说的指标体系、工具选型还有落地流程,能直接用到你的RAG项目里。从原型验证到生产监控,从技术指标到业务价值,有一整套完整的评估体系能让你的RAG系统从“能用”变成“好用”,实实在在给业务创造价值。
最后,再提醒一下:RAG技术始终处于快速发展之中,评估方法以及工具也在不断迭代,不过,“量化、优化、闭环”的核心思想可绝对不会改变。期望这篇文章能够助力你搭建起你自身的RAG评估体系,让检索增强生成系统切实能够落地并见到成效。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
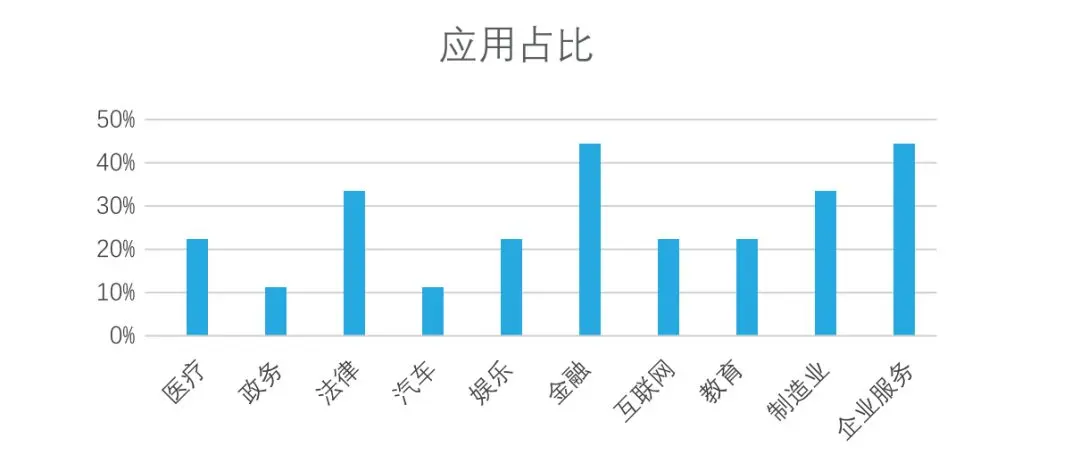
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
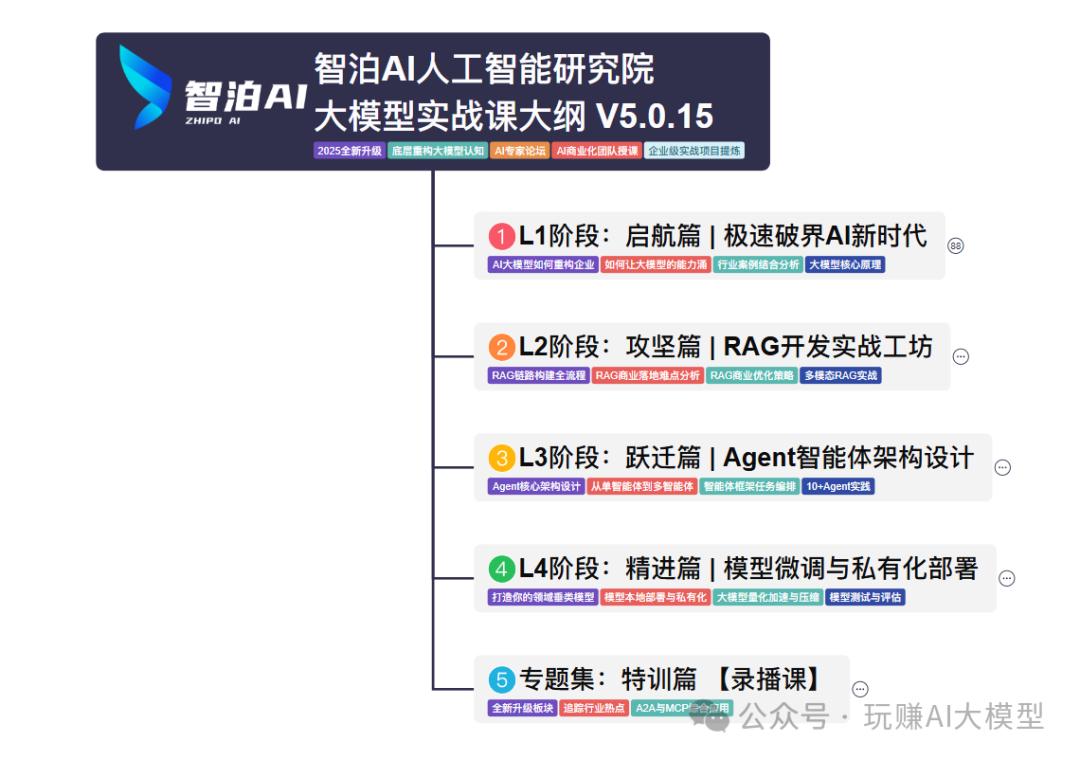
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 6833


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


