



目录
Kafka系列:
kafka管理监控系统 CMAK(yahoo的kafka-manager)部署及使用
Kafka系列(三)、生产者分区策略、ISR、ACK机制、一致性语义
Kafka系列(四)、消费者策略、Rebalance机制、Offset存储机制
Kafka系列(五)、开启SASL安全认证以及配置ACL权限控制
Kafka系列(六)、Kafka开发套件kafka lenses 安装及使用(带WebUI)
简介
Confluent 由kafka的核心成员成立,目前最新版Confluent为v5.5.1版本,对应的kafka版本为Apache Kafka_v2.5.0,在Confluent中不仅包含了kafka,还有下面几个组件,增强了kafka的功能也大大提升了kafka的易用性。
- KSQL:通过SQL查询topic内的数据;
- Confluent Connetors:支持配置HDFS,Cassandra,MySQL,Oracle,Postgre,MongoDB,Kudu等数据源的source和sink;
- Confluent clients:支持Java,Python,C/C++,Go,.Net等客户端;
- Schema Registry:统一消息格式,提前将topic内的数据注册到schema目录表内,消费端无需判断消息内的数据类型,只需要从目录表内找到该主题对应的schema即可;
- REST Proxy:允许以RESTful api方式直接访问kafka;
- Confluent Control Center:提供WebUI可视化监控、运维以及开发,简化配置方式;(商业版的功能,试用期30天)
官方网址:Confluent | Apache Kafka® Reinvented for the Cloud
下载地址:Try Free Confluent: Managed Kafka on Any Cloud
单机部署
本次我们安装的是最新版的v5.5.1版本,单机版的安装非常简单,安装步骤如下:
0. JDK1.8(略)
1. 解压tar包
tar -zxvf confluent-5.5.1-2.11.tar.gz -C /opt/app/

2. 配置环境变量
vim /etc/profile
----------------
export CONFLUENT_HOME=/opt/app/confluent-5.5.1
export PATH=$PATH:$CONFLUENT_HOME/bin
----------------

3. 刷新环境变量
source /etc/profile

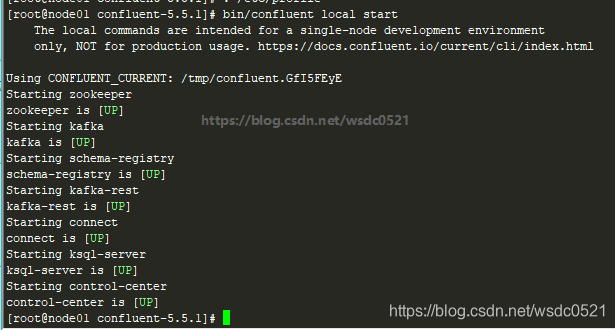
4. 启动单机confluent
$CONFLUENT_HOME/bin/confluent local start


# ------其他命令-------
# 关闭单机confluent
$CONFLUENT_HOME/bin/confluent local stop

# 清空当前confluent下的数据
$CONFLUENT_HOME/bin/confluent local destroy
启动成功如图:
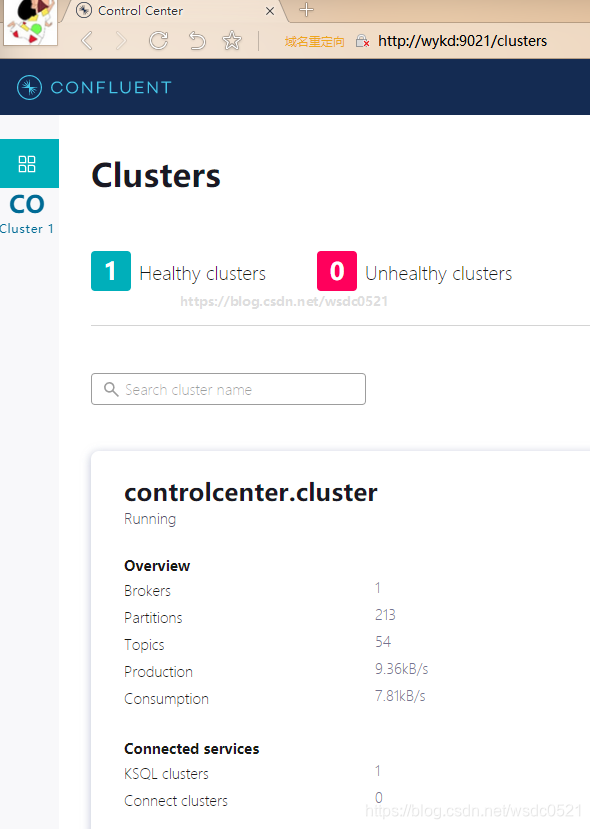
在浏览器中输入 ip:9021 即可打开Confluent Control Center界面:
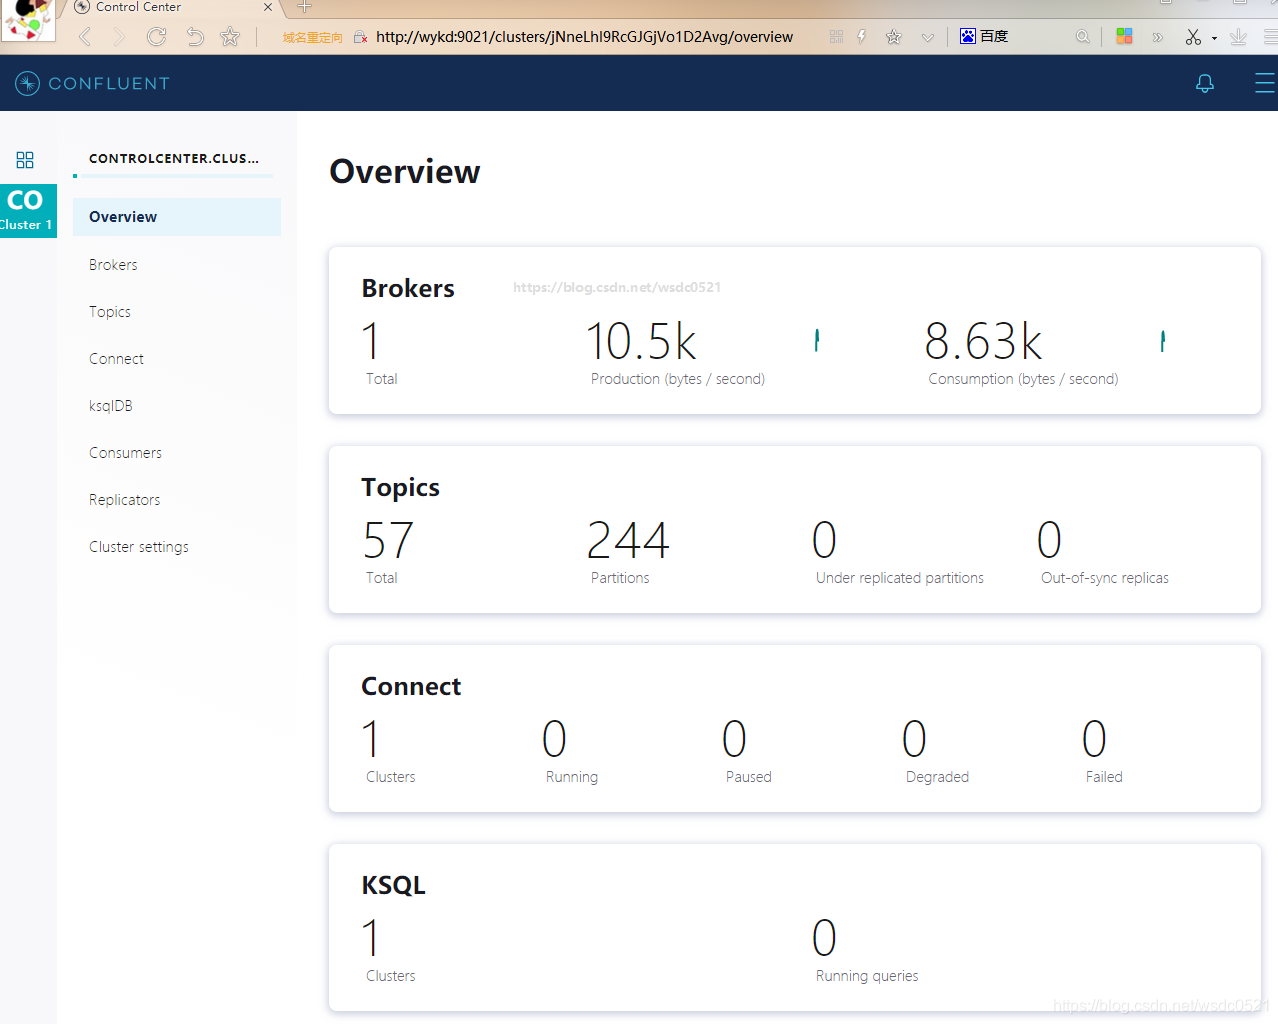
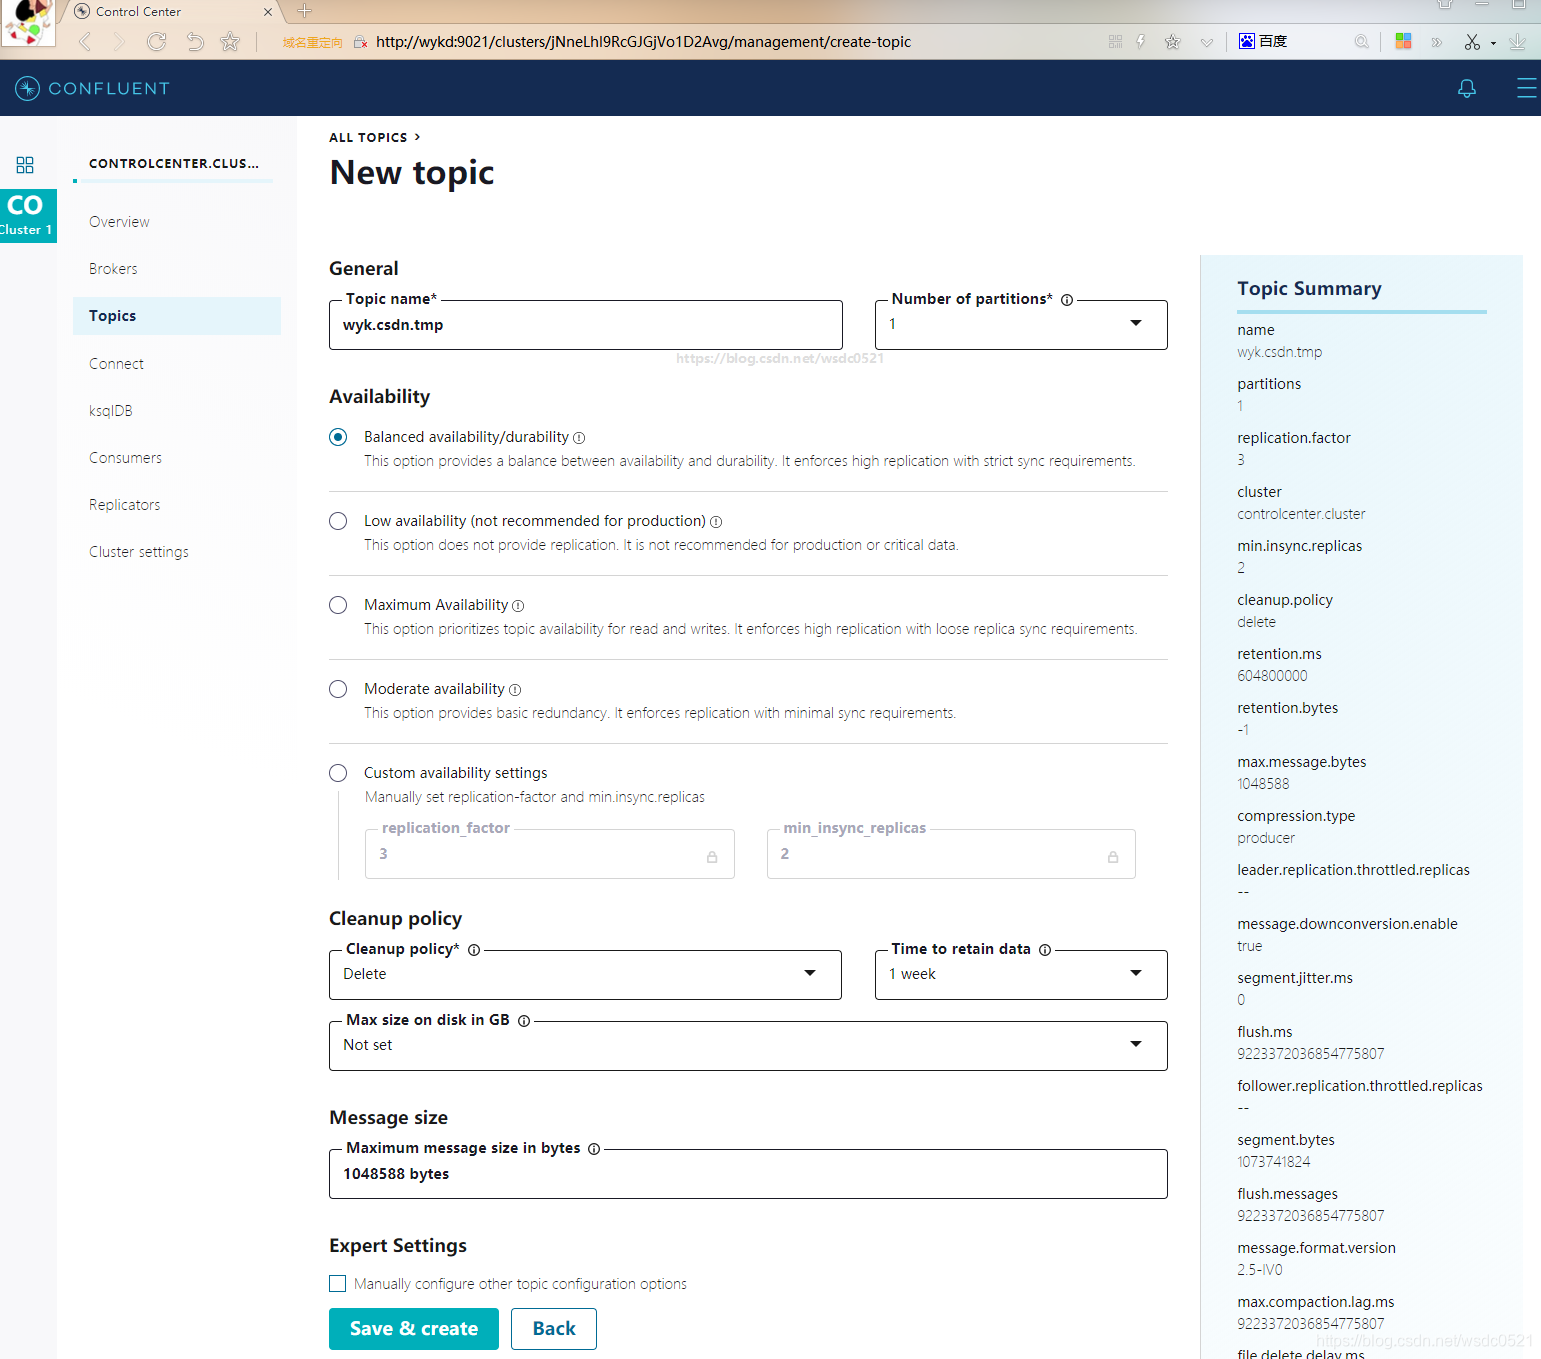
Control Center 还有很多其他功能,非常方便,如果公司不差钱的话可以考虑一下。
集群部署
Confluent套件中除了control center以及部分connector以外的组件都是免费的,比apache kafka 更方便,因此接下来我们来部署集群版的Confluent,对于有部署zookeeper 及kafka 经验的人来说 稍微修改一下配置文件也可以将Confluent部署在已有的zk和kafka之上,这里我就使用之前部署好的zk和kafka了,如果要使用confluent中的zk和kafka也是一样的配置,只是配置文件路径在$CONFLUENT_HOME/etc/kafka 内。
可参考的配置:
0. 集群规划:
| 机器 | 角色 | 端口 |
| wyk01 & wyk02 & wyk03 | kafka | 9092 |
| wyk01 & wyk02 & wyk03 | zookeeper | 2181 |
| wyk01 & wyk02 & wyk03 | confluent control center | 9021 |
| wyk01 & wyk02 & wyk03 | schema registry | 8081 |
| wyk01 & wyk02 & wyk03 | kafka rest proxy | 8082 |
| wyk01 & wyk02 & wyk03 | confluent connector | 8083 |
| wyk01 & wyk02 & wyk03 | ksql | 8088 |
1. wyk01:解压tar包 并配置环境变量
0. JDK1.8(略)
1. 解压tar包
tar -zxvf confluent-5.5.1-2.11.tar.gz -C /opt/app/

2. 配置环境变量
vim /etc/profile
----------------
export CONFLUENT_HOME=/opt/app/confluent-5.5.1
export PATH=$PATH:$CONFLUENT_HOME/bin
----------------

3. 刷新环境变量
source /etc/profile
2. wyk01:配置zookeeper和kafka
cd $CONFLUENT_HOME/etc/kafka
# 备份confluent的配置文件
mv zookeeper.properties zookeeper.properties.bak
mv server.properties server.properties.bak

# 将已有的kafka和zookeeper集群的配置文件复制过来
cp /opt/app/kafka/config/server.properties .
cp /opt/app/zookeeper/conf/zoo.cfg zookeeper.properties

# 修改kafka配置,新增下列confluent参数
vim $CONFLUENT_HOME/etc/kafka/server.properties
--------------------------------------------
metric.reporters=io.confluent.metrics.reporter.ConfluentMetricsReporter
confluent.metrics.reporter.bootstrap.servers=wyk01:9092,wyk02:9092,wyk03:9092
confluent.metrics.reporter.topic.replicas=2
confluent.support.metrics.enable=true
confluent.support.customer.id=anonymous
delete.topic.enable=true

# 如果使用confluent自带的zk和kafka的话,只需要参考kafka和zookeeper集群的方式修改刚才备份的那两个配置文件即可
3. wyk01:配置schema-registry
vim $CONFLUENT_HOME/etc/kafka-rest/kafka-rest.properties
---------------------------------
#修改下面的参数,其他参数保持不变
kafkastore.bootstrap.servers=PLAINTEXT://wyk01:9092,wyk02:9092,wyk03:9092
4. wyk01:配置ksql
vim $CONFLUENT_HOME/etc/ksqldb/ksql-server.properties
---------------------------------
#修改下面的参数,其他参数保持不变
bootstrap.servers=wyk01:9092,wyk02:9092,wyk03:9092
ksql.schema.registry.url=http://wyk01:8081,http://wyk02:8081,http://wyk03:8081
5. wyk01:配置kafka rest
vim $CONFLUENT_HOME/etc/kafka-rest/kafka-rest.properties
---------------------------------
#修改下面的参数,其他参数保持不变
schema.registry.url=http://wyk01:8081,http://wyk02:8081,http://wyk03:8081
zookeeper.connect=wyk01:2181,wyk02:2181,wyk03:2181
bootstrap.servers=PLAINTEXT://wyk01:9092,wyk02:9092,wyk03:9092
listeners=http://0.0.0.0:8082
consumer.interceptor.classes=io.confluent.monitoring.clients.interceptor.MonitoringConsumerInterceptor
producer.interceptor.classes=io.confluent.monitoring.clients.interceptor.MonitoringProducerInterceptor
6. wyk01:配置confluent connectors
vim $CONFLUENT_HOME/etc/schema-registry/connect-avro-distributed.properties
---------------------------------
#修改下面的参数,其他参数保持不变
bootstrap.servers=wyk01:9092,wyk02:9092,wyk03:9092
key.converter.schema.registry.url==http://wyk01:8081,http://wyk02:8081,http://wyk03:8081
value.converter.schema.registry.url=http://wyk01:8081,http://wyk02:8081,http://wyk03:8081
config.storage.replication.factor=3
offset.storage.replication.factor=3
status.storage.replication.factor=3
rest.port=8083
rest.advertised.port=8083
plugin.path=$CONFLUENT_HOME/share/java
7. wyk01:配置control center
vim $CONFLUENT_HOME/etc/confluent-control-center/control-center-dev.properties
---------------------------------
#修改下面的参数,其他参数保持不变
bootstrap.servers=wyk01:9092,wyk02:9092,wyk03:9092
zookeeper.connect=wyk01:2181,wyk02:2181,wyk03:2181
confluent.controlcenter.rest.listeners=http://0.0.0.0:9021
confluent.controlcenter.id=1    # 每台confluent机器的ID不能有重复
confluent.controlcenter.ksql.ksqlDB.url=http://wyk01:8088  # 每台confluent机器配置各自的IP
confluent.controlcenter.connect.cluster=http://wyk01:8083,http://wyk02:8083,http://wyk03:8083
confluent.controlcenter.schema.registry.url=http://wyk01:8081,http://wyk02:8081,http://wyk03:8081
confluent.controlcenter.internal.topics.replication=2
confluent.controlcenter.command.topic.replication=2
confluent.monitoring.interceptor.topic.replication=2
confluent.metrics.topic.replication=3
8. wyk01:将confluent 分发到wyk02,wyk03节点,并在wyk02,wyk03也配置环境变量
1. wyk01:分发confluent 文件夹
scp -r /opt/app/confluent-5.5.1 root@wyk02:/opt/app/
scp -r /opt/app/confluent-5.5.1 root@wyk03:/opt/app/

2. wyk02 & wyk03:配置环境变量
vim /etc/profile
----------------
export CONFLUENT_HOME=/opt/app/confluent-5.5.1
export PATH=$PATH:$CONFLUENT_HOME/bin
----------------

3. wyk02 & wyk03:刷新环境变量
source /etc/profile
9. wyk02 & wyk03:修改配置文件中的ID
# wyk02: 修改kafka和 control center中的id
vim $CONFLUENT_HOME/etc/kafka/server.properties
---------------------------------
#修改下面的参数,其他参数保持不变
broker.id=2

vim $CONFLUENT_HOME/etc/confluent-control-center/control-center-dev.properties
---------------------------------
#修改下面的参数,其他参数保持不变
confluent.controlcenter.id=2    # 每台confluent机器的ID不能有重复
confluent.controlcenter.ksql.ksqlDB.url=http://wyk02:8088  # 每台confluent机器配置各自的IP

-------------------------------------------------------

# wyk03: 修改kafka和 control center中的id
vim $CONFLUENT_HOME/etc/kafka/server.properties
---------------------------------
#修改下面的参数,其他参数保持不变
broker.id=3

vim $CONFLUENT_HOME/etc/confluent-control-center/control-center-dev.properties
---------------------------------
#修改下面的参数,其他参数保持不变
confluent.controlcenter.id=3    # 每台confluent机器的ID不能有重复
confluent.controlcenter.ksql.ksqlDB.url=http://wyk03:8088  # 每台confluent机器配置各自的IP
10. 在三台机器上分别启动下列服务:(xcall是我自己写的shell脚本,表示在三台机器同时执行命令)
# 1. 启动 zookeeper
xcall.sh '/opt/app/zookeeper/bin/zkServer.sh start'

# 2. 启动 kafka
xcall.sh '/opt/app/confluent-5.5.1/bin/kafka-server-start -daemon /opt/app/confluent-5.5.1/etc/kafka/server.properties'

# 3. 启动 schema registry
xcall.sh '/opt/app/confluent-5.5.1/bin/schema-registry-start -daemon /opt/app/confluent-5.5.1/etc/schema-registry/schema-registry.properties'

# 4. 启动 kafka rest proxy
xcall.sh '/opt/app/confluent-5.5.1/bin/kafka-rest-start -daemon /opt/app/confluent-5.5.1/etc/kafka-rest/kafka-rest.properties'

# 5. 启动 confluent connect
xcall.sh '/opt/app/confluent-5.5.1/bin/connect-distributed -daemon /opt/app/confluent-5.5.1/etc/schema-registry/connect-avro-distributed.properties'

# 6. 启动 ksql
xcall.sh '/opt/app/confluent-5.5.1/bin/ksql-server-start -daemon /opt/app/confluent-5.5.1/etc/ksqldb/ksql-server.properties'

# 7. 启动 control center
xcall.sh '/opt/app/confluent-5.5.1/bin/control-center-start -daemon /opt/app/confluent-5.5.1/etc/confluent-control-center/control-center-dev.properties'
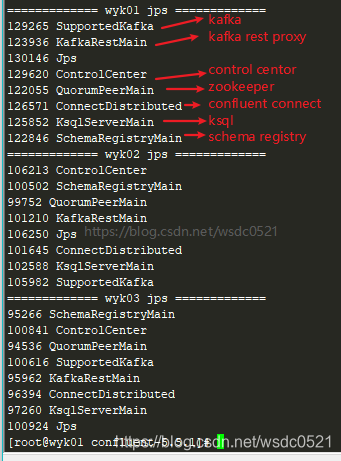
11. 启动成功的话,jps进程应该如下图
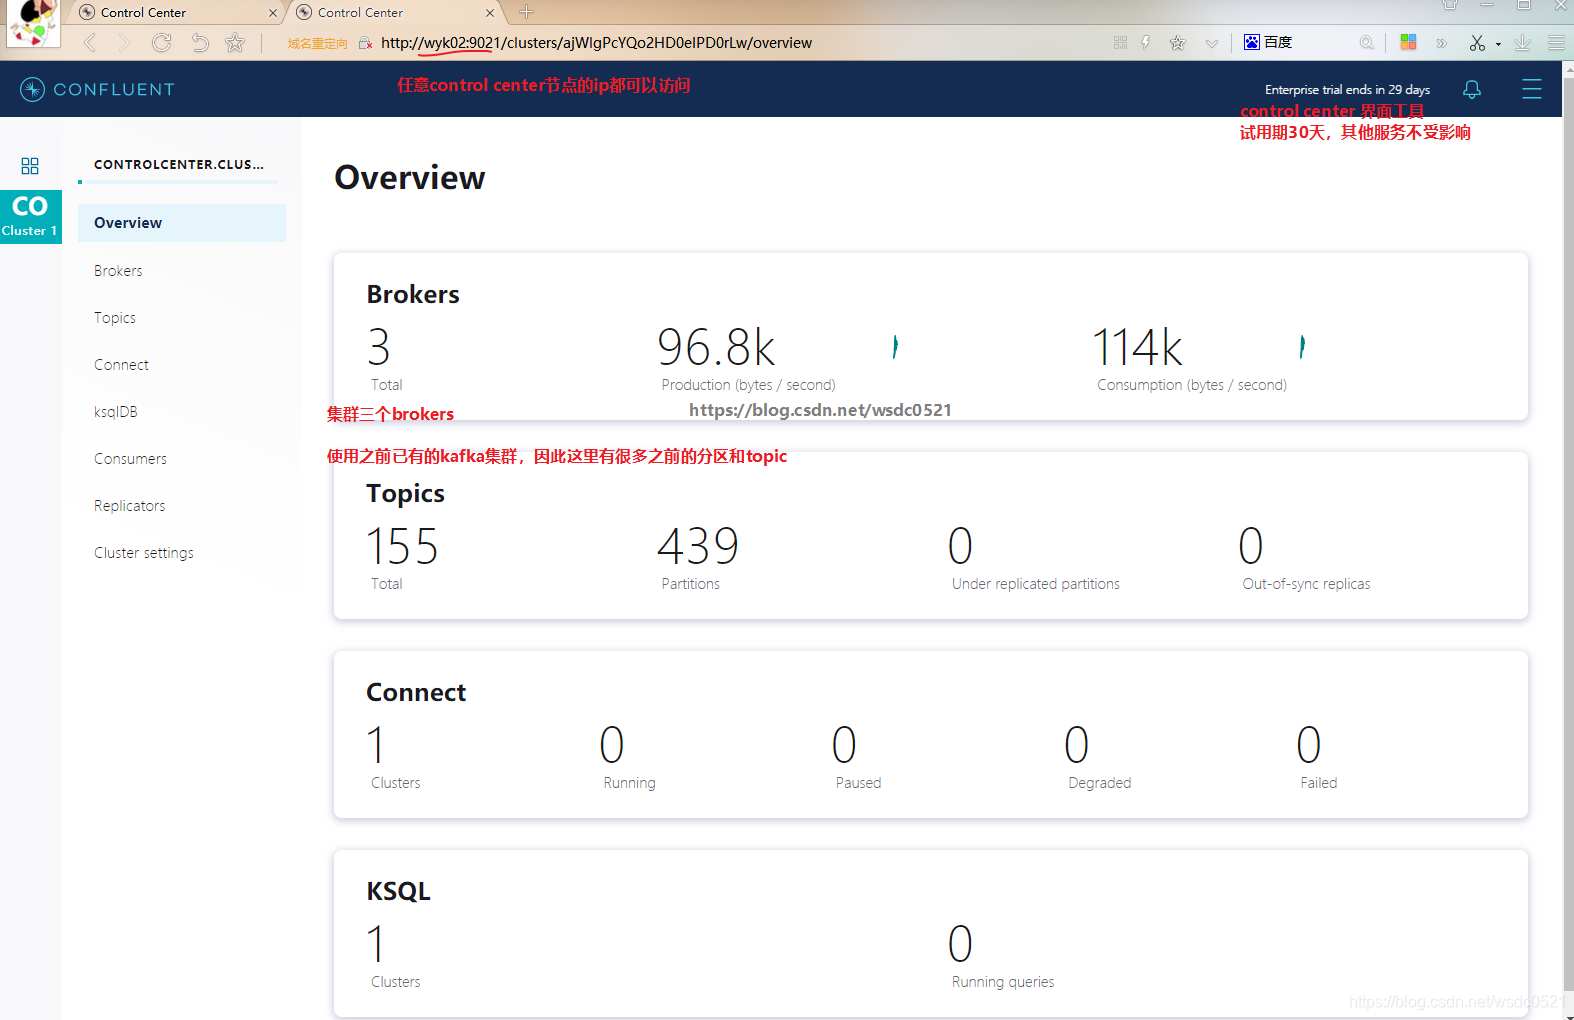
全部启动成功后,在浏览器中输入任意control center节点的ip:9021 即可进入管理界面:

尾巴
Confluent 推出的kafka connect, schema registry, ksql, rest proxy 让kafka变得更加好用和强大(目前apache kafka 也有kafka connect,但confluent提供了更多了connector),control center提供了web界面对集群进行管理和使用(试用期30天),极大的降低了开发运维成本。
希望本文对你有帮助,请点个赞鼓励一下作者吧~ 谢谢!

 6874


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


